Archivo de la etiqueta: Gestión de datos de investigación

Recomedaciones de PLOS para repositorios de datos

39725125515_db0ffa23f1_o_d

La selección de un repositorio apropiado permite a los investigadores maximizar la visibilidad de sus datos al tiempo que garantiza que los datos y metadatos relacionados cumplen con los estándares específicos de campo dentro de su comunidad de investigación.

En conmemoración del Open Data Day 2018, PLOS ha considerado un conjunto de criterios para evaluar los repositorios para su inclusión en la lista de repositorios recomendados. Estos criterios siguen los Principios de FAIR sobre apertura de datos, que se recomienda a los gestores de repositorios que deben cumplir cuando diseñen y configuren sus repositorios.


2018-03-01-11_17_11-plos-one_v2-300x237


Criterios:

1) Las presentaciones de conjuntos de datos de un repositorio deben estar abiertas a todos los investigadores cuya investigación se ajuste al alcance científico del repositorio. La lista de PLOS no incluye repositorios que establcen restricciones geográficas o de afiliación para el envío de conjuntos de datos.

2) Los repositorios deben asignar un identificador persistente estable (PID) para cada conjunto de datos, como un identificador de objetos digitales (DOI) o un número de acceso.

Los identificadores persistentes garantizan que el conjunto de datos se almacenará permanentemente en una ubicación determinada. PLOS busca evitar situaciones en las que los enlaces no actualizados o rotos hacen que los datos sean inaccesibles. Del mismo modo, el identificador debe hacer referencia al conjunto de datos específico, y no simplemente a una colección más amplia de datos. El uso de un identificador único facilita un registro de reutilización y garantiza que los investigadores que generaron los datos reciban crédito por su trabajo.

3) Los repositorios deben proporcionar la opción de que los datos estén disponibles bajo las licencias CC-0 o CC-BY (o equivalentes que sean lo menos restrictivas posible). Específicamente, no debe haber restricciones en trabajos derivados o uso comercial.

Todos los artículos de PLOS se publican bajo estas licencias, y PLOS requiere que los conjuntos de datos acompañantes estén disponibles de manera igualmente libre a menos que las restricciones legales o éticas impidan el intercambio de datos abiertos. Estas licencias permiten a los lectores interesados ​​utilizar, reutilizar y volver a analizar los datos, una cuestión fundamental para promover la reproducibilidad.

4) Los repositorios deben poner los conjuntos de datos a disposición de los lectores interesados ​​sin costo y sin requisitos de registro que restrinjan innecesariamente el acceso a los datos. PLOS no recomendará repositorios que cobren a los lectores por el acceso o que tengan tarifas de suscripción.

De acuerdo con la misión de PLOS de hacer que los resultados de la investigación científica estén disponibles de manera abierta e inmediata en el momento de la publicación, los conjuntos de datos correspondientes deben estar disponibles públicamente cuando sea posible, sin restricciones relacionadas con el costo.

5) Los repositorios deben tener un plan de gestión de datos a largo plazo (incluidos los fondos) para garantizar que los conjuntos de datos se preserven en el futuro.

Es necesario planificar el mantenimiento de los repositorios para garantizar que todos los conjuntos de datos permanezcan en línea y estén disponibles indefinidamente. Sería contraproducente que los datos dejaran de estar disponibles debido a una caducidad de los fondos o si la infraestructura del repositorio no se hubiera mantenido adecuadamente.

6) Los repositorios deben demostrar la aceptación y el uso dentro de una comunidad de investigación relevante, por ejemplo, a través del uso del repositorio para el depósito de datos para múltiples artículos publicados. Este criterio está destinado a ayudar a garantizar que los datos tengan el alcance más amplio posible.

7) Los repositorios deben tener una entrada en FAIRsharing.org , para permitir el enlace a la entrada PLOS .

El uso de un servicio como FAIRsharing.org permite que la información sobre repositorios se estandarice y coteje en una ubicación de fácil acceso. Esto permite a los autores comparar repositorios para elegir dónde depositar sus datos.


Plan Estratégico de la Biblioteca Nacional de Medicina 2017-2027

40567164112_700ee6d490_o_d

National Library of Medicine Strategic Plan 2017–2027. Rockville Pike, Bethesda: National Library of Medicine (NLM), 2018

Texto completo

El informe se llevó a cabo con el asesoramiento de 750 miembros del personal de National Library of Medicine (NLM), bibliotecarios nacionales e internacionales, profesionales de la informática, científicos biomédicos, científicos de datos, médicos clínicos, especialistas en salud pública y otras partes interesadas.

Entre las cuestiones clave que tendrán impacto en los próximos años estarían las siguientes:

  1. Descubrimiento basado en datos. Lo primero y más importante es la promesa de un descubrimiento basado en datos. El descubrimiento basado en datos requiere una biblioteca sofisticada para abrir la puerta a nuevas y emocionantes perspectivas de mejora de la salud pública, así como la capacidad para ofrecer perspectivas y soluciones adecuadas al nuevo entorno .
  2. Migración de la atención clínica. La atención clínica está migrando rápidamente de un hospital a otro. Esta migración desafía la capacidad de llegar a estos lugares donde se produce la salud, no sólo donde se presta la atención, que son menos formales y están menos controlados.
  3. Ciencia abierta. El espíritu de la ciencia  abierta lidera el paisaje del descubrimiento. Las fuerzas gubernamentales y científicas se están alineando bajo la filosofía de que la innovación se acelera si los datos fluyen libremente, para ello, los resultados de la investigación patrocinada por el gobierno deben estar abiertos al público lo antes posible, lo que conlleva implicar en esta perspectiva a los científicos, los ciudadanos y la industria con el objetivo de obtener mejores  beneficios sociales.
  4. La naturaleza de las bibliotecas está cambiando. Las bibliotecas siguen siendo lugares esenciales para los depósitos de conocimientos y las reuniones comunitarias, pero la aparición de la búsqueda autodirigida, la publicación electrónica y la consolidación de los servicios bibliotecarios de los hospitales desafía a los bibliotecarios y bibliotecas a idear nuevos servicios y soluciones.


Del Big Data al Smart Data. Planeta Biblioteca 2018/02/28

39825367284_de4d32641c_b_d

ESCUCHAR EL PROGRAMA

Ir a descargar


Nos ha acompañado en este programa la doctora e investigadora mexicana Lourdes Feria Basurto, consultora Internacional en Gestión del conocimiento, con un amplio currículo ha trabajado en la Unesco, ONU en la Embajada de México en Washington y en otras organizaciones internacionales. Lourdes nos ha venido a hablar sobre Big Data, Smart Data y Gestión de datos de investigación. Con ella hemos hablado de que son los Big Data, que implicaciones tienen, que son los datos inteligentes, la privacidad de los datos, la ética y el ciclo de vida de los datos. Un programa de máxima actualidad para cualquier profesional de la información.

Ciudades impulsadas por datos: 20 historias de innovación


captura-11

Data Driven Cities: 20 Stories of Innovation. [e-Book] Cologny, Switzerland, World Economic Forum, 2017.

Texto completo


La Cuarta Revolución Industrial llegará en ciudades de todo el mundo. Los bits están encontrándose con ladrillos a medida que el Internet entra en los espacios donde vivimos, convirtiéndose en el «Internet de las Cosas». Los resultados impactarán en la mayoría de los aspectos de nuestras vidas, planteando cuestiones de interés urgente. ¿Qué dimensiones de las ciudades se verán más afectadas? ¿Cuál será el impacto en los ciudadanos? ¿Cómo debería cambiar la política urbana?

En el mundo se generan datos de manera continua, cada vez que enviamos un mensaje, hacemos una llamada o completamos una transacción, dejamos rastros digitales. Los “datos generados por el usuario” provienen de la participación de personas, por ejemplo, a través de plataformas de medios sociales o crowdsourcing. Cada tweet, publicación en Facebook o carga de Flickr puede proporcionar información valiosa para comprender mejor las ciudades y la sociedad actual. Nos estamos acercando rápidamente a lo que el escritor italiano Italo Calvino conscientemente  llamó la “memoria del mundo“, una copia digital completa de nuestro universo físico. Los datos ya son un componente clave para las empresas, pero hoy en día han entrado en la esfera pública y se están trasladando a nuestras ciudades. Esto ha hecho que sea más importante que nunca entender las consecuencias de los datos, especialmente cómo afecta a la vida de las personas. Estos datos se recopilan para un propósito y luego se utilizan para otro: piense en los datos que pertenecen a las compañías de teléfonos celulares para manejar sus operaciones, y los utilizan las compañías de transporte para entender mejor la movilidad urbana.

La necesidad de que las ciudades aprovechen plenamente el potencial de los datos que fluyen constantemente a través de ellas nunca ha sido tan urgente. Ciudades impulsadas por datos: 20 historias de innovación, destaca ejemplos de todo el mundo sobre cómo las ciudades están haciendo exactamente esto: utilizando nuevas tecnologías, recopilación y análisis de datos para mejorar los servicios y la calidad de vida de sus ciudadanos. El informe es parte de una iniciativa más amplia del Foro Económico Mundial para empoderar al liderazgo de la ciudad en el uso de la tecnología 4IR para mejorar la experiencia urbana y utilizar datos para definir y medir su preparación para la transformación de la 4ª Revolución Industrial.

Los Big Data o “datos masivos” son mucho más que una simple cuestión de cantidad; son una “gran promesa” para nuestras ciudades, ya que se enfrentan a los retos y oportunidades que la Cuarta Revolución Industrial está generando. Para ampliar algunas de las oportunidades esbozadas en este informe, es crucial que un número cada vez mayor de personas tengan acceso a los datos y participen en un debate de múltiples partes interesadas sobre su uso. En la medida de lo posible, los grandes datos deberían convertirse en “datos abiertos” para tener un verdadero y profundo impacto en nuestras ciudades. Si esto puede lograrse, entonces la gente de las ciudades de todo el mundo tendrá la oportunidad de inventar historias de datos cada vez más convincentes.

Las siguientes páginas presentan historias de ciudades de todo el mundo, seleccionadas desde diversos puntos de vista – desde el mundo académico hasta la industria y el gobierno-. Se trata de historias de innovación que están ocurriendo en el mundo desarrollado y en el emergente, desde arriba hacia abajo y de abajo hacia arriba, esfuerzos orientados por el diseño y nuevas iniciativas de políticas. El hilo conductor común que los une: los retos a los que se enfrentan las ciudades al acercarse a la Cuarta Revolución Industrial. Las historias ilustran cómo se pueden utilizar los datos para mejorar la experiencia del entorno construido, ya sea por parte de entidades públicas, grandes corporaciones, empresas nuevas o ciudadanos privados.

Usando datos, podemos entender mejor el mundo digital de maneras que nos permitan transformar el espacio físico. Podemos desarrollar soluciones para abordar algunas de las cuestiones más urgentes, desde la energía a los residuos, desde el agua a la movilidad, desde el diseño urbano a la participación ciudadana.  Las historias presentadas en este informe se clasifican en cinco temas: personas, gobierno, infraestructura, economía y medio ambiente. Brindan una visión general del impacto de la Cuarta Revolución Industrial en las ciudades a través de la lente sin precedentes de los datos.

Publicaciones en UA relacionadas:


¿Qué es la minería de textos, cómo funciona y por qué es útil?

text-mining-101-v2-300x211

TEXT MINING 101
WRITTEN BY OPENMINTED COMMUNICATIONS ON FEBRUARY 21, 2018

Original


Este artículo le ayudará a entender lo básico en sólo unos minutos.


¿QUÉ ES LA MINERÍA DE TEXTOS?

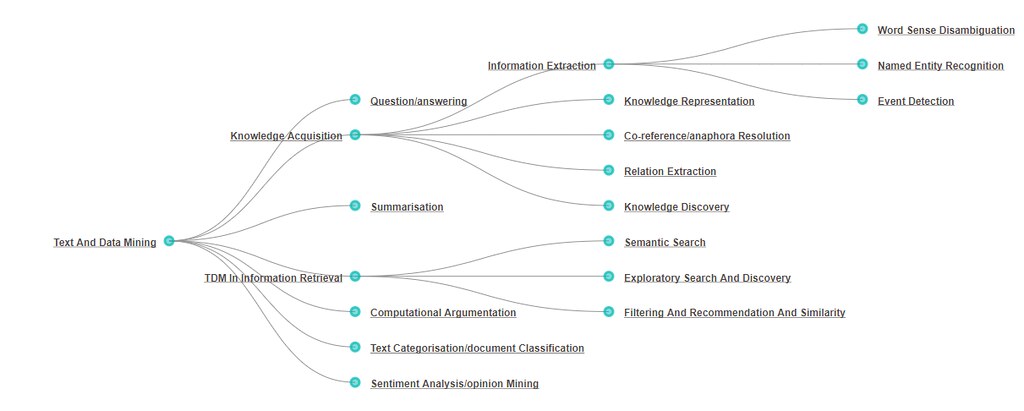
La minería de textos busca extraer información útil e importante de formatos de documentos heterogéneos, tales como páginas web, correos electrónicos, medios sociales, artículos de revistas, etc. Esto se hace mediante la identificación de patrones dentro de los textos, tales como tendencias en el uso de palabras, estructura sintáctica, etc.

La gente a menudo habla de «minería de texto y datos (TDM)» al mismo tiempo, pero estrictamente hablando la minería de texto es una forma específica de minería de datos que se relaciona con el texto.

¿POR QUÉ LO NECESITAMOS?

La minería de textos tiene muchas aplicaciones. Por ejemplo, la minería de textos puede ayudar a encontrar tecnologías nuevas e innovadoras dentro de ciertos dominios. Es un método muy eficiente para generar nueva información y conocimiento. Esta práctica permite a las empresas reducir el tiempo dedicado a la lectura de textos extensos y extractos literarios. Esto significa que los recursos clave se pueden encontrar con mayor rapidez y eficacia. También permite a los usuarios obtener nueva información que de otro modo sería difícil de encontrar.

¿QUÉ CLASE DE GENTE HACE MINERÍA DE TEXTOS?

La tecnología de la minería de textos es actualmente ampliamente aplicada por una extensa variedad de usuarios, desde organizaciones gubernamentales, instituciones de investigación y empresas para sus necesidades diarias. Estos son algunos ejemplos de uso en diferentes campos:

Investigación: por ejemplo, el descubrimiento de conocimientos, la atención médica y sanitaria: en el pasado, a un investigador humano le lleva mucho tiempo analizar y obtener información relevante. En algunos casos, esta información ni siquiera era accesible. La minería de textos permite a los investigadores encontrar más información y de forma más rápida y eficiente.

Negocios: por ejemplo, las grandes empresas utilizan la minería de textos para ayudar en la toma de decisiones y responder rápidamente a las consultas de los clientes en procesos tales como la gestión de riesgos o el filtrado de currículos

Seguridad: En anti-terrorismo, el análisis de los blogs y otras fuentes de texto en línea se utiliza para prevenir delitos en Internet y luchar contra el fraude.

Diariamente, La minería de texto es usada por los sitios web de correo electrónico para crear métodos de filtrado más confiables y efectivos, para el filtrado de spam, análisis de datos de medios sociales, etc. También para identificar las relaciones entre los usuarios y ciertos productos o para determinar las opiniones de los usuarios sobre temas particulares

¿ES ÚTIL LA MINERÍA DE TEXTOS PARA LA CIENCIA?

Los usos de la minería de textos son virtualmente interminables, pero vamos a centrarnos más en que manera es útil para la ciencia y la investigación. Los científicos se comunican a través de publicaciones científicas y se estima que existen más de 50 millones de revistas (JINHA, A. E. (2010), po lo cual cada vez es más difícil para los investigadores hacer un seguimiento de lo que se publica en su propio campo. Además, hay una enorme afluencia de otros tipos de datos en todas las ciencias, como páginas web, informes de organizaciones públicas (por ejemplo, transcripciones judiciales, actas de reuniones), libros, etc. La minería de textos puede ayudar a resolver este problema y a encontrar nueva información.

ESPERA UN MINUTO, ¿ASÍ ES COMO OBTENGO ESOS ANUNCIOS PERSONALIZADOS?

Como se ha dicho antes, las tecnologías de minería de texto tienen muchas aplicaciones. Entre ellas, se puede utilizar para establecer vínculos entre clientes potenciales y productos con fines de marketing o de otro tipo.

¿CUÁL ES LA DIFERENCIA ENTRE MINERÍA DE TEXTO Y GOOGLE?

Los motores de búsqueda como Google, recuperan todos los documentos que contienen las palabras clave que has especificado. No hay valor añadido a los datos. La minería de textos lleva las cosas un paso más allá al extraer información precisa basada en mucho más que palabras clave. En su lugar, busca entidades o conceptos, relaciones, frases y/o oraciones. Intenta determinar el significado real basado en algoritmos de Procesamiento del Lenguaje Natural (NLP), que le permiten reconocer conceptos similares. Una búsqueda utilizando la minería de texto puede identificar hechos, relaciones e inferencias que no son del todo obvios.

¿CÓMO FUNCIONA, ESTA MINERÍA DE TEXTO Y DATOS?
La extracción de textos puede dividirse en cinco pasos:


1. Recolección: Recopilación de datos de diferentes recursos, tales como sitio web, correos electrónicos, comentarios de clientes, archivo de documentos. Dependiendo de la aplicación, este proceso puede ser completamente automatizado o guiado por una persona encargada de realizar este proceso.

2. Preprocesamiento: La identificación del contenido y la extracción de características representativas

3. Limpieza de textos: eliminación de cualquier información innecesaria o no deseada, como los anuncios de las páginas.

4. Tokenización: un ordenador sólo «ve» una cadena de caracteres, sin poder identificar, por ejemplo, párrafos, frases o palabras. La Tokenización divide el texto en entidades significativas (palabras, oraciones, etc.) dados los espacios en blanco presentes y las puntuaciones.

5. Extracción de características (también llamada selección de atributos): es el proceso de caracterización.

Un ejemplo puede ilustrar estos cinco pasos:

Imagina que estás vendiendo calendarios de animales. Si deseas saber si es una buena inversión para que  se anuncie en los sitios web de blogs, y por lo tanto, te gustaría conocerqué porcentaje de las entradas en el blog están hablando de los animales.

En primer lugar, es necesario reunir todos los textos de todas las entradas de blog que puedas encontrar. Dado que puede haber cientos de miles de estos textos en Internet, probablemente no quieras descargarlos manualmente, uno por uno. Así que necesitas software para rastrear la web, descargar los artículos que encuentre y organizarlos en una base de datos apropiada.

En segundo lugar, querrás preprocesar el material recolectado para que las siguientes herramientas (discutidas en los pasos 3 a 5) puedan trabajar más eficientemente. Por ejemplo, querrás eliminar anuncios, menús de páginas web, código fuente de las páginas web HTML, etc. A continuación, es posible que desees calcular algunas características (extracción de características) para tu colección de textos. Por ejemplo, es posible que desees conocer el número de palabras de cada mensaje, de modo que pueda rechazar las que son demasiado pequeñas (por ejemplo, 10 palabras) o demasiado grandes (por ejemplo, 10 000 palabras). Tales entradas en su base de datos probablemente no son representativas y pueden ser errores generados por su software utilizado en el primer paso. Para obtener estos recuentos de palabras, primero tendrás que dividir los textos (serie de caracteres) en palabras (tokenización).

En el tercer paso, es posible que desees crear índices. Por ejemplo, para enumerar qué palabras se han encontrado en qué textos. Puedes pensar en esto como el índice de un libro. Sin un índice, es muy difícil localizar la información sobre un tema específico. Pero con un índice, es mucho más fácil y rápido encontrar lo que está buscando. Esto también es cierto para el software que busca palabras en su enorme base de datos blog.

Luego, en el cuarto paso, querrás extraer los textos para extraer alguna información que le ayudará a contestar sus preguntas. En este caso, querrás identificar palabras que se refieran a animales. Un nombre de entidad reconocedora de animales tratará de reconocer cada palabra que se refiera a un animal, como perro, gato, gatito, felino, mamífero, petirrojo americano, Turdus migratorius, etc. También es posible que desees ejecutar lo que se conoce como’ algoritmos sintácticos‘ para identificar qué palabras son sustantivos y cuáles verbos. Se necesitan muchos algoritmos para distinguir, por ejemplo, el uso de cat en «Tengo un gato hermoso» y que «ejecute cat file. txt en su línea de comandos para mostrar el texto.o rechazar «Se movió como una araña» Evidentemente, se necesita mucha inteligencia para llevar a cabo esta tarea con precisión.

A continuación, en el quinto paso, se desea realizar análisis y trazar gráficos. Por ejemplo, puedes requerir una gráfica de barra que muestre el porcentaje de artículos del blog que hablan sobre los animales para cada uno de los diez sitios web de alojamiento de blog más importantes. Con esta información, por ejemplo, puedes convencer a tus colaboradores de que es una buena idea invertir dinero en publicidad para calendarios de animales en whatablog. com.
 

Este artículo fue escrito como parte del proyecto OpenMinTeD por: Jiakang Chang (EMBL-EBI), Christian O’ Reilly (EPFL), Nancy Pontika (Open University) Gareth Owen (EMBL-EBI), Kenneth Haug (EMBL-EBI), Martine Oudenhoven (LIBER)


Archivos y archivística. Planeta biblioteca 2018/02/21.

40395582251_7abc8257c9_b_d

Escuchar Podcast

Ir a descargar


Ha visitado nuestro Planeta, el profesor de la Universidad de Salamanca, Luis Hernández Olivera, especialista en Archivos y también director de la Asociación de Archiveros de Castilla y León (ACAL), con luis hemos charlado amigablemente sobre que es la archivistica, que interés tiene para el presente y para el futuro, oportunidades profesionales de trabajo en este campo, que comparte la archivistica con la información y documentación, la labor del archivero en la preservación digital, las humanidades digital y en la intervención sobre el ciclo vital de los datos en ese futuro profesional relacionado con la gestión de datos de investigación. Una charla entrañable, distendida y agradable.


Principios DC1 sobre citación de datos de investigación

data20citation20logo20-20small1

Data Citation Synthesis Group: Joint Declaration of Data Citation Principles. Martone M. (ed.) San Diego CA: FORCE11; 2014 https://doi.org/10.25490/a97f-egyk

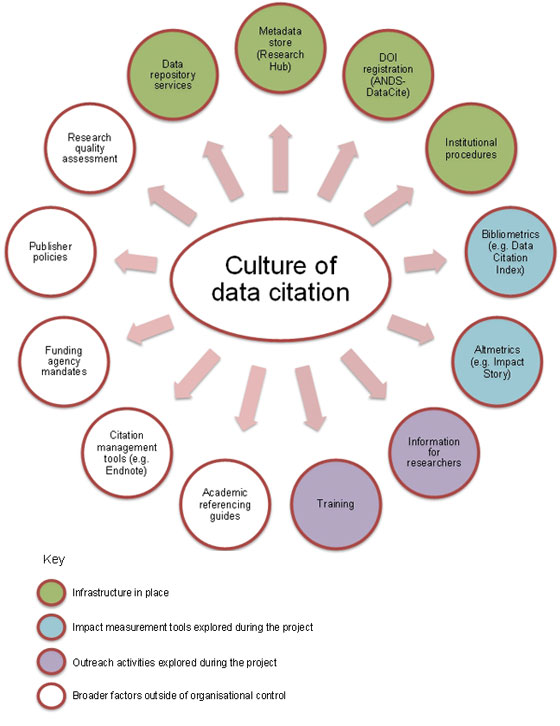
Cualquier investigación sólida y reproducible descansa sobre una base de datos sólidos y accesibles. Para que esto sea así tanto en la práctica como en la teoría, los datos deben tener la debida importancia en la práctica de la erudición y estar depositados en un registro académico duradero. En otras palabras, los datos deben considerarse productos legítimos y citables de la investigación. La citación de datos, al igual que la de otras evidencias y fuentes, es una buena práctica de investigación y forma parte del ecosistema académico que apoya la reutilización de datos.

Aqui exponemos los principios DC1 Data citation principles de FORCEE 11:


1. Importancia. Los datos deben considerarse productos legítimos y citables de la investigación. Las citas de datos deben tener la misma importancia en el expediente académico que las citas de otros objetos de investigación, tales como publicaciones.

2. Crédito y Atribución. Las citas de datos deben facilitar la atribución de créditos académicos y atribuciones normativas y legales a todos los contribuyentes a los datos, reconociendo que un único estilo o mecanismo de atribución puede no ser aplicable a todos los datos

3. Pruebas. En la literatura académica, cuando y dondequiera que una reivindicación se base en datos, los datos correspondientes deben citarse

4. Identificación Única. Una citación de datos debe incluir un método persistente de identificación que sea automáticamente procesable, globalmente único y ampliamente utilizado por una comunidad (DOI).

5. Acceso al acceso. Las citas de datos deben facilitar el acceso a los propios datos y a los metadatos, documentación, código y otros materiales asociados, según sea necesario para que tanto los seres humanos como las máquinas puedan hacer un uso informado de los datos referenciados

6. Persistencia. Deberían persistir identificadores y metadatos únicos que describan los datos y su disposición, incluso más allá de la vida útil de los datos que describen

7. Especificidad y verificabilidad. Las citas de datos deben facilitar la identificación, el acceso y la verificación de los datos específicos que respaldan una declaración. Las citaciones o metadatos de citación deben incluir información sobre la procedencia y la fijación suficiente para facilitar la verificación de que el corte temporal específico, la versión y/o la parte granular de los datos recuperados posteriormente es la misma que se citó originalmente.

8. Interoperabilidad y flexibilidad. Los métodos de citación de datos deben ser lo suficientemente flexibles para acomodar las prácticas variadas entre comunidades, pero no deben diferir tanto que comprometan la interoperabilidad de las prácticas de citación de datos entre comunidades.


Taylor & Francis apuesta por las políticas de intercambio de datos

understanding-our-data-sharing-policies

Ver imagen ampliada

Esta semana Taylor & Francis anunció que aplicará una política básica que fomentará el intercambio de datos a todos los títulos de revistas de su propiedad, con el objetivo de que sus publicaciones trabajen con políticas de intercambio de datos más progresivas durante 2018.

Ver anuncio

Data sharing policies

A partir de 2018, Taylor & Francis introducirá nuevas políticas sobre el intercambio de datos. La política básica de intercambio de datos, que se aplica en muchas revistas, animará a los autores a depositar los datos en un repositorio adecuado, citarlos e incluir una declaración de disponibilidad de datos que explique dónde otros que pueden acceder a los datos.

Los datos son un producto clave en y para la investigación, por lo tanto, compartirlos presenta una multitud de oportunidades para la investigación y los investigadores. Las nuevas políticas tienen por objeto promover un mayor intercambio de datos para mejorar la solidez de todo el proceso de investigación, respaldando la transparencia, la reproducibilidad y la replicabilidad de los resultados.

Además posibilita la capacidad de cita no sólo del resultado final de la investigación, si no también de los datos aportados, lo que permitirá a los investigadores obtener y dar crédito adicional a sus investigaciones por sus valiosos hallazgos de datos. Cuando los autores compartan datos, se les pedirá que incluyan una declaración de disponibilidad de datos, lo que mejorará la posibilidad de descubrir su investigación. Las políticas abarcan desde el fomento del intercambio de datos hasta la apertura de los mismos con una licencia, ofreciendo flexibilidad y garantizando al mismo tiempo la satisfacción de las necesidades de los diferentes campos y disciplinas.

¿Por qué compartir datos?

  • Algunos proveedores de fondos exigen ahora que se compartan los datos (puede comprobarlo utilizando esta práctica herramienta Sherpa-Juliet), y cada vez es más común que algunas áreas temáticas pongan los datos a disposición de todos. Hay varios beneficios al compartir datos
  • Compartir públicamente los datos mejora la solidez del proceso de investigación, apoyando la validación, la transparencia de la investigación, la reproducibilidad y la replicabilidad de los resultados. Esto puede a su vez, hacer avanzar el descubrimiento y el conocimiento.
  • Compartir datos puede conducir a la reutilización y el descubrimiento, con mayores oportunidades para realizar metanálisis y extraer nuevos conocimientos.
  • Depositar los datos en un repositorio que ofrece un identificador permanente como un DOI, permite a los autores y a otros citar el conjunto de datos, lo que permite a los investigadores obtener el crédito apropiado para su trabajo.
  • La deposición de datos apoyan la preservación de datos a largo plazo.
  • Una mayor disponibilidad pública de los datos de investigación apoya consecución de la investigación en la práctica.


Cualquier investigación sólida y reproducible descansa sobre una base de datos sólidos y accesibles. Para que esto sea así tanto en la práctica como en la teoría, los datos deben tener la debida importancia en la práctica de la erudición y estar depositados en un registro académico duradero. En otras palabras, los datos deben considerarse productos legítimos y citables de la investigación. La citación de datos, al igual que la de otras evidencias y fuentes, es una buena práctica de investigación y forma parte del ecosistema académico que apoya la reutilización de datos. Por ello Taylor & Francis sigue los principios DC1 Data citation principles de FORCEE 11:


Las universidades en la frontera de la privacidad: datos abiertos, datos grises y gestión de datos

d7646a50fa560fa9e62ddee023edc97c

Borgman, C. L. «Open Data, Grey Data, and Stewardship: Universities at the Privacy Frontier.» Forthcoming in Berkeley Technology Law Journal vol. 33, n. 2 (2018). URL.: https://arxiv.org/ftp/arxiv/papers/1802/1802.02953.pdf


Este documento explora los valores en competencia inherentes a la administración de datos y hace recomendaciones para la práctica, basándose en el trabajo pionero de la Universidad de California en materia de privacidad y seguridad de la información, gobernanza de datos y riesgo cibernético.


A medida que las universidades reconocen el valor inherente de los datos que recopilan y mantienen, encuentran desafíos imprevistos al administrar esos datos de manera que equilibren la rendición de cuentas, la transparencia y la protección de la privacidad, la libertad académica y la propiedad intelectual.

Dos desarrollos paralelos en la recopilación de datos académicos son convergentes:

(1) los requisitos de acceso abierto, en virtud de los cuales los investigadores deben proporcionar acceso a sus datos como condición para obtener financiamiento de becas o publicar resultados en revistas;

(2) la vasta acumulación de «datos grises» sobre individuos en sus actividades diarias de investigación, enseñanza, aprendizaje, servicios y administración.

Los límites entre la investigación y los datos grises se están difuminando, lo que dificulta la evaluación de los riesgos y responsabilidades asociados con cualquier recopilación de datos. Muchos conjuntos de datos, tanto de investigación como grises, quedan fuera de las regulaciones de privacidad como HIPAA, FERPA y PII. Las universidades están explotando estos datos para la investigación, análisis de aprendizaje, evaluación del profesorado, decisiones estratégicas y otros asuntos sensibles. Las entidades comerciales están asediando a las universidades con solicitudes de acceso a los datos o de asociaciones para extraerlos.

La frontera de la privacidad a la que se enfrentan las universidades de investigación abarca las prácticas de acceso abierto, los usos y usos indebidos de datos, las solicitudes de registros públicos, el riesgo cibernético y la conservación de datos para la protección de la privacidad.

Teoría y práctica de la citación de datos de investigación


simons-fig3

Silvello, G. «Theory and practice of data citation.» Journal of the Association for Information Science and Technology vol. 69, n. 1 (2018). pp. 6-20. http://dx.doi.org/10.1002/asi.23917


Las citas son la piedra angular de la propagación del conocimiento y el medio principal para evaluar la calidad de la investigación, así como para dirigir las inversiones en ciencia. La ciencia se está haciendo cada vez más «intensiva en datos», donde se recogen y analizan grandes volúmenes de datos para descubrir patrones complejos mediante simulaciones y experimentos, y la mayoría de las obras científicas de referencia están siendo reemplazadas por conjuntos de datos curados en línea. Sin embargo, dado un conjunto de datos, no existe una forma cuantitativa, consistente y establecida de saber cómo se ha utilizado a lo largo del tiempo, quién contribuyó a su curación, qué resultados se han obtenido o qué valor tiene.

El desarrollo de una teoría y práctica de la citación de datos es fundamental para considerar los datos como objetos de investigación de primera clase con la misma relevancia y centralidad de los productos científicos tradicionales. Muchos trabajos en los últimos años han discutido la citación de datos desde diferentes puntos de vista: ilustrando por qué se necesita la citación de datos, definiendo los principios y esbozando recomendaciones para los sistemas de citación de datos, y proporcionando métodos computacionales para abordar temas específicos de la citación de datos. El panorama actual es polifacético y falta todavía una visión global que reúna diversos aspectos de este tema.