Archivo de la etiqueta: Plagio

Enseñanza e inteligencia artificial. Planeta Biblioteca 2026/10/28

Enseñanza e inteligencia artificial.

Planeta Biblioteca 2026/10/28

Ver en Youtube

ESCUCHAR

Descargar

La inteligencia artificial generativa representa una transformación profunda en el ámbito educativo al actuar como tutor personal y facilitar la creación o personalización de contenidos, aunque también plantea retos urgentes frente al plagio, la dependencia cognitiva y la pérdida del pensamiento crítico. En lugar de optar por prohibiciones, los consensos globales y educativos coinciden en la necesidad de incorporar la IA de forma responsable y ética. Para afrontar esta realidad, se requiere replantear las evaluaciones, formar adecuadamente al profesorado y garantizar la equidad en el acceso. Tanto docentes como estudiantes y bibliotecas deben asumir nuevos roles: los educadores pasan de ser meros transmisores de información a diseñadores de experiencias formativas, mientras que los alumnos deben cultivar la verificación de fuentes y el juicio propio. Finalmente, iniciativas internacionales como los marcos de alfabetización en IA y la inclusión de estas competencias en PISA 2029 consolidan el camino hacia un futuro educativo sinérgico, donde la IA automatiza procesos pero la educación potencia valores humanos esenciales como la creatividad y la ética.

Las universidades británicas abandonan Turnitin ante las dudas sobre la privacidad de los datos y la eficacia de sus detectores de IA

Luckhurst, G. (2026, 9 de octubre). More universities end Turnitin contracts as concerns mount. Times Higher Education. https://www.timeshighereducation.com/news/more-universities-end-turnitin-contracts-concerns-mount

Se analiza el creciente distanciamiento de varias universidades británicas respecto a Turnitin, una de las plataformas más extendidas para la detección de similitudes textuales y el apoyo a la integridad académica. Las universidades de Newcastle y Westminster han anunciado que no renovarán sus contratos cuando finalicen sus acuerdos actuales, sumándose a la Universidad de Southampton, que ya había comunicado una decisión similar. Estas medidas reflejan un cambio de actitud hacia herramientas que durante años han ocupado un lugar central en los procedimientos universitarios para detectar el plagio, pero cuya utilidad, coste y condiciones de tratamiento de los datos están siendo objeto de un examen más crítico.

Una de las principales razones de esta controversia son los cambios propuestos por Turnitin en su acuerdo de licencia de usuario final. Las modificaciones suscitaron preocupación porque podían abrir la posibilidad de utilizar trabajos y datos de estudiantes y personal universitario con fines relacionados con la inteligencia artificial. La Universidad de Newcastle ha señalado expresamente sus dudas sobre el posible uso de estos datos, mientras que Southampton decidió iniciar la retirada progresiva del servicio. Tras las críticas de distintas instituciones y organizaciones del sector, Turnitin aplazó la aplicación de los cambios hasta septiembre de 2027 y aceptó dialogar con representantes universitarios para abordar las inquietudes planteadas. La empresa sostiene que actualmente no utiliza los trabajos de los estudiantes para entrenar modelos de inteligencia artificial generativa o grandes modelos de lenguaje (LLM), aunque distingue este supuesto del entrenamiento de clasificadores destinados a identificar textos que probablemente hayan sido generados por IA.

El caso de la Universidad de Westminster introduce una segunda cuestión fundamental: la eficacia real de estas tecnologías frente a las nuevas formas de producción textual. La institución considera que el detector de similitudes tradicional resulta poco eficaz ante uno de los principales desafíos actuales para la integridad académica: los trabajos elaborados mediante inteligencia artificial generativa. Asimismo, cuestiona la fiabilidad de los detectores de IA, puesto que sus resultados son probabilísticos y pueden producir falsos positivos. Esto significa que un texto redactado por una persona podría ser señalado erróneamente como generado por IA. La controversia pone de manifiesto una limitación esencial de estos sistemas: la detección automática no constituye una prueba concluyente de fraude académico y sus resultados deben interpretarse con prudencia, atendiendo al contexto y a otras evidencias disponibles.

El factor económico también desempeña un papel importante en las decisiones de las universidades. Según los datos recogidos por el artículo, la Universidad de Southampton pagó 87.621 libras esterlinas por los servicios de Turnitin entre septiembre de 2024 y septiembre de 2025, mientras que la Universidad de East Anglia desembolsó 50.892 libras durante el periodo comprendido entre abril de 2024 y marzo de 2025. Aunque estos importes corresponden a instituciones de distinto tamaño y no permiten establecer una comparación directa de costes por estudiante, ilustran la dimensión presupuestaria de estos contratos. Algunos especialistas consideran que la preocupación por la privacidad y la inteligencia artificial es legítima, pero que también puede estar favoreciendo una revisión más amplia del gasto en plataformas educativas. Las universidades se preguntan si necesitan contratar un paquete completo de servicios cuando sus entornos virtuales de aprendizaje ya permiten gestionar entregas, calificaciones y comentarios, y pueden complementarse con herramientas alternativas de comprobación de originalidad.

La situación, sin embargo, no representa todavía un abandono generalizado de Turnitin. Algunas instituciones continúan utilizando la plataforma mientras revisan sus condiciones contractuales y estudian otras soluciones. La Universidad de Cambridge, por ejemplo, ha manifestado que no aceptará cambios en el acuerdo que afecten a la privacidad de los datos o a la propiedad intelectual, aunque mantiene el servicio por el momento. Aberdeen está revisando su utilización, mientras que otras universidades exploran alternativas para gestionar la entrega y evaluación de trabajos académicos. El debate se extiende así más allá de la elección de un programa concreto y alcanza cuestiones estratégicas relacionadas con la contratación tecnológica, la protección de la información y la autonomía institucional.

La expansión de la inteligencia artificial generativa está obligando a las universidades a reconsiderar sus mecanismos tradicionales de control de la integridad académica. La decisión de abandonar Turnitin no responde exclusivamente a las dudas sobre el uso de los datos estudiantiles: también intervienen el precio de las licencias, las limitaciones de los detectores y la necesidad de revisar los métodos de evaluación. Algunos especialistas proponen replantear el diseño de las actividades académicas, en lugar de confiar principalmente en herramientas automáticas para identificar posibles irregularidades. Desde esta perspectiva, resulta más adecuado combinar normas transparentes sobre el uso de la IA, evaluación crítica de los trabajos, seguimiento del proceso de aprendizaje y conversaciones pedagógicas con el alumnado. La cuestión central ya no es solamente cómo detectar textos generados por inteligencia artificial, sino cómo garantizar una evaluación justa, proteger los derechos de los estudiantes y promover una cultura de integridad académica adaptada a las nuevas tecnologías.

Una empresa llamada Springer, que no es la editorial, está ofreciendo la autoría a la venta.

Chawla, Dalmeet Singh. (2026, 12 de octubre). A company named Springer that isn’t the publisher is offering authorship for sale. Retraction Watch. Enlace al artículo original: https://retractionwatch.com/2026/10/12/springer-journals-online-authorship-for-sale/

Una empresa llamada Springer Journals Online que ofrece puestos de coautoría en artículos científicos a cambio de dinero, utilizando una denominación que puede confundirse con la editorial Springer Nature. El caso evidencia el crecimiento de las fábricas de artículos científicos (paper mills), una amenaza para la integridad académica que distorsiona la evaluación investigadora y pone en riesgo la fiabilidad de las publicaciones científicas.

La comercialización de autoría en artículos destinados a revistas académicas de prestigio. El caso gira en torno a una empresa denominada Springer Journals Online, que ofrece a investigadores la posibilidad de incorporarse como coautores a manuscritos supuestamente próximos a su publicación en revistas internacionales. La organización solicita una contribución económica para cubrir parte de los costes de publicación y presenta oportunidades vinculadas a editoriales reconocidas, como Elsevier, Springer Nature, Taylor & Francis, Wiley y SAGE. La oferta resulta especialmente preocupante porque utiliza una denominación muy similar a la de Springer Nature, una editorial científica consolidada, lo que puede inducir a confusión y transmitir una apariencia de legitimidad. Sin embargo, según la investigación periodística, esta empresa no tiene relación con Springer Nature ni con la actividad editorial legítima que desarrolla esta compañía.

La investigación comienza cuando Richard Fateman, profesor emérito de informática de la Universidad de California en Berkeley, recibe un correo electrónico inesperado en el que se le propone participar como coautor en publicaciones científicas a cambio de asumir una parte de los costes. Fateman considera que la propuesta puede constituir una estafa y, además, plantea un problema ético fundamental: aceptar la inclusión de su nombre en un trabajo en cuya elaboración no ha participado. El mensaje comercial ofrece diferentes manuscritos, plazos estimados de publicación, revistas de destino y posiciones disponibles en la lista de autores. Aunque la empresa responde posteriormente que los participantes deberían intervenir en la investigación, revisar el manuscrito y aportar comentarios sustanciales desde su especialidad, la forma inicial de presentar la oferta suscita serias dudas sobre la naturaleza real de estas colaboraciones y sobre la posibilidad de comprar reconocimiento académico.

Uno de los aspectos más llamativos es la utilización de elementos que parecen diseñados para generar confianza. La página web de Springer Journals Online anuncia una tasa de aceptación del 95 % en las revistas objetivo y afirma haber publicado más de 500 revistas. Sin embargo, la investigación identifica varias señales de alerta: la dirección que figura en la web corresponde a una calle que no existe, el teléfono publicado utiliza un prefijo del Reino Unido y el perfil de Instagram de la organización está vinculado a Pakistán. Además, uno de los testimonios comerciales aparece atribuido a «Dr. Aris Thorne», un nombre ficticio conocido por su frecuente aparición en contenidos generados mediante modelos de lenguaje. Retraction Watch intentó obtener explicaciones de la empresa por correo electrónico y teléfono, sin conseguir una respuesta satisfactoria. Por su parte, un portavoz de Springer Nature confirmó que su centro de operaciones contra la piratería y los problemas de seguridad ya conocía la existencia de esta organización y estaba trabajando con las autoridades competentes.
El caso se inscribe en un fenómeno más amplio conocido como paper mills, o fábricas de artículos científicos: redes comerciales que producen, distribuyen o manipulan manuscritos académicos y ofrecen servicios que pueden incluir la venta de puestos de autoría. Estas prácticas convierten la publicación científica en una mercancía y permiten que algunas personas obtengan méritos curriculares sin haber contribuido de manera real a la investigación. El artículo recuerda que un estudio de 2024 estimó que estas fábricas podrían representar alrededor del 2 % de los envíos de manuscritos a revistas científicas en distintas disciplinas. También establece paralelismos con otros casos en los que organizaciones han creado páginas que imitan revistas legítimas o han comercializado posiciones de autoría vinculadas a publicaciones de editoriales reconocidas.

Las consecuencias van mucho más allá del incumplimiento de las normas de publicación. La autoría científica implica responsabilidad sobre la metodología, los datos, los resultados y las conclusiones de un trabajo. Cuando se incorporan autores que no han contribuido de forma significativa, se dificulta la identificación de quienes deben responder por los posibles errores o irregularidades. Además, estas prácticas distorsionan la evaluación de la actividad investigadora, perjudican a quienes desarrollan su trabajo de manera rigurosa y pueden facilitar que resultados poco fiables entren en la literatura científica y sean utilizados posteriormente por otros investigadores. La advertencia de Fateman es especialmente relevante: cuando una publicación acumula autores sin una contribución claramente identificable, la responsabilidad individual puede diluirse y aumentar el riesgo de que los errores pasen inadvertidos.

El problema de la «validez sintética» en la investigación de IA.

Retraction Watch Staff, “AI research’s ‘synthetic validity’ problem”, Retraction Watch, 19 de septiembre de 2026. Artículo original en Retraction Watch

El problema ya no consiste únicamente en detectar artículos falsos o textos generados por IA. El reto es garantizar que los datos, métodos, referencias y evidencias que sustentan la investigación sean verificables y tengan validez respecto al fenómeno real que pretenden estudiar. La expansión de la IA hace que esta tarea sea todavía más importante.

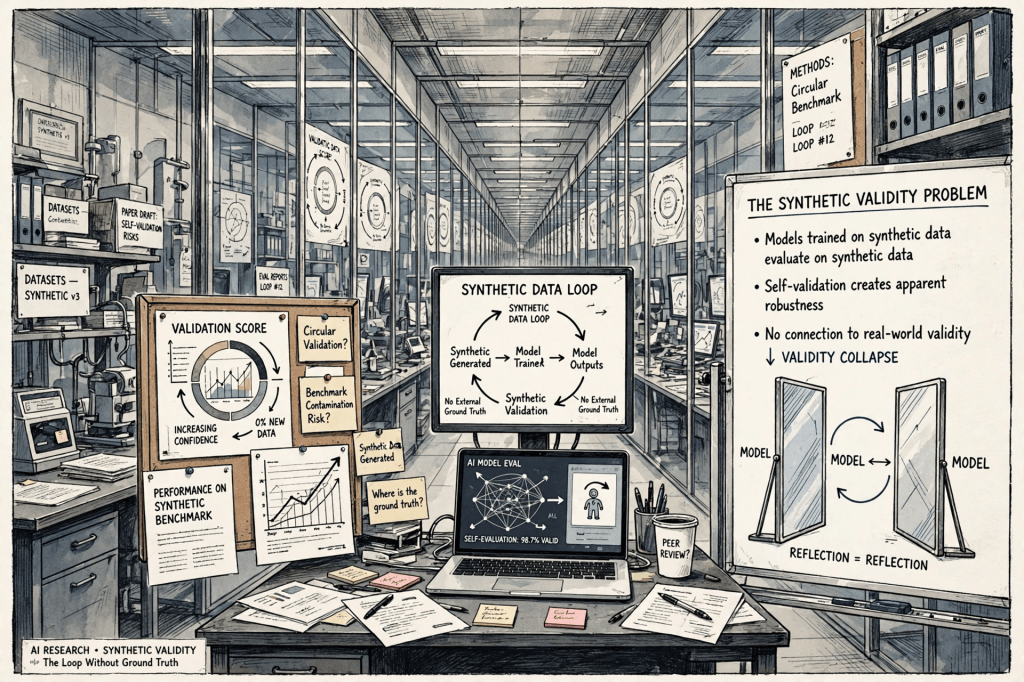
Especialmente relevante para el ámbito de la IA y la comunicación científica es la referencia al problema de la “synthetic validity”. El concepto alude a una dificultad creciente: los investigadores pueden utilizar modelos generativos para producir datos, participantes simulados, respuestas, textos u otros materiales que presentan una apariencia estadísticamente plausible, pero cuya correspondencia con el mundo real puede ser limitada. El problema no es solamente si los datos sintéticos son técnicamente coherentes, sino hasta qué punto permiten extraer conclusiones válidas sobre personas, comportamientos o fenómenos reales.

Esta cuestión adquiere especial importancia a medida que la IA generativa se incorpora a experimentos, encuestas, simulaciones y procesos de investigación. Una investigación puede obtener resultados internamente consistentes utilizando datos artificiales y, sin embargo, presentar una validez externa limitada. La posibilidad de generar grandes cantidades de respuestas sintéticas también puede facilitar estudios rápidos y baratos, pero introduce la necesidad de demostrar que los resultados no son simplemente un reflejo de los patrones incorporados en los propios modelos de IA.

La integridad científica depende de toda una cadena de controles, desde el diseño de la investigación y la recogida de datos hasta la revisión por pares, la publicación, las citaciones y la posterior corrección del registro científico. La aparición de la IA añade nuevas dificultades, pero no sustituye problemas tradicionales como las autorías fraudulentas, los datos inconsistentes, las referencias incorrectas o la ausencia de aprobación ética.

La IA introduce un nuevo problema: datos plausibles pero artificiales. La cuestión de la synthetic validity resulta particularmente importante para la alfabetización en IA. Un modelo generativo puede producir miles de respuestas aparentemente humanas y coherentes; sin embargo, que una respuesta sea verosímil no significa que represente a una población real. Esto obliga a los investigadores a diferenciar entre precisión estadística, coherencia interna y validez empírica.

Existe además el riesgo de crear un círculo de retroalimentación: los modelos se entrenan con datos producidos por seres humanos; posteriormente generan nuevos datos sintéticos; esos datos pueden utilizarse para entrenar, evaluar o alimentar otros modelos; y finalmente los resultados artificiales pueden volver a incorporarse al ecosistema científico. Si este proceso no se controla, la investigación podría terminar utilizando datos derivados de otros datos sintéticos sin una conexión suficientemente sólida con la realidad empírica original.

En investigación social, educativa o bibliométrica, por ejemplo, utilizar participantes sintéticos podría generar resultados que parecen convincentes pero que no necesariamente reproducen las características, sesgos y comportamientos de personas reales. El riesgo aumenta si los resultados generados artificialmente se utilizan posteriormente como evidencia para nuevas investigaciones. De este modo puede aparecer un círculo de retroalimentación en el que los modelos entrenados con información humana generan nuevos datos que posteriormente se utilizan para entrenar o evaluar otros modelos.

El artículo resulta especialmente útil porque conecta tres problemas que normalmente se analizan por separado: la integridad de las publicaciones, la creciente utilización de IA y la necesidad de preservar la confianza en el registro científico. Retraction Watch recuerda además que su base de datos ya supera las 67.000 retractaciones, una cifra que refleja la dimensión acumulativa de los mecanismos de corrección de la literatura científica.

El uso de la IA en la comunicación científica: transparencia, detectores y nuevos sesgos

David Crotty, “AI Use in The Scholarly Kitchen”, The Scholarly Kitchen, 27 de agosto de 2026. Publicado por la Society for Scholarly Publishing (SSP). Artículo original en The Scholarly Kitchen

El artículo parte de una experiencia concreta de The Scholarly Kitchen para analizar uno de los debates más controvertidos de la comunicación científica actual: cómo utilizar la inteligencia artificial en la escritura y edición sin convertir su uso en un problema de confianza, autoría o integridad editorial. El autor explica que el blog ha recibido un número creciente de mensajes de lectores que sospechan que determinados textos han sido escritos por IA, muchas veces basándose exclusivamente en la apariencia del estilo o en el resultado de herramientas automáticas de detección.

Una de las cuestiones centrales del artículo es la limitación de los detectores de IA. Crotty señala que herramientas como Pangram o GPTZero han mejorado su precisión, pero todavía presentan importantes limitaciones. Sobre todo, no distinguen adecuadamente entre un texto completamente generado por IA y un texto escrito por una persona que posteriormente ha sido traducido, corregido, revisado o mejorado mediante IA. Desde el punto de vista editorial, son situaciones muy diferentes, pero un detector puede clasificarlas de manera similar. Por ello, la detección de participación de IA no permite determinar automáticamente cómo se utilizó la herramienta ni si ese uso fue éticamente aceptable.

El problema se agrava con los falsos positivos. El autor relata que algunos textos de The Scholarly Kitchen acusados de haber sido generados íntegramente por IA habían sido realmente escritos, editados y ampliados por miembros del equipo editorial. Incluso menciona el caso de un informe humano que, al pasar por Pangram, fue clasificado como un 9 % generado por IA, pero el sistema identificó incorrectamente qué fragmentos procedían de la IA y cuáles habían sido escritos por una persona. Esto muestra que un porcentaje obtenido mediante un detector no debería interpretarse como una prueba concluyente de autoría artificial.

La política de The Scholarly Kitchen

La IA no puede aparecer como autora de un artículo, y las imágenes generadas por IA no se admiten salvo que exista una razón específica relacionada con el contenido del artículo. Sin embargo, sí se permite utilizar herramientas de IA para redacción y edición, tanto por parte de los autores como de editores y revisores, siempre que exista transparencia y se documente su utilización. Crotty señala que inicialmente la publicación confiaba en la responsabilidad individual de los autores, pero recientemente ha decidido adoptar una posición más activa para exigir la declaración del uso de IA.

Esta postura plantea una cuestión interesante para las publicaciones académicas: prohibir completamente la IA puede ser menos eficaz que establecer reglas claras de utilización y declaración. Crotty considera que, en un espacio editorial de opinión y análisis como The Scholarly Kitchen, existe margen para experimentar y aprender. Su planteamiento es que la transparencia puede resultar más útil que una prohibición absoluta, especialmente mientras las comunidades académicas y editoriales siguen intentando determinar qué usos son aceptables en diferentes contextos.

El riesgo de crear un nuevo sesgo

Uno de los argumentos más interesantes del artículo es que la reacción contra la IA puede generar un nuevo tipo de sesgo editorial y académico. Crotty observa que algunos lectores utilizan la sospecha de utilización de IA como una forma de descalificar contenidos con los que no están de acuerdo. En lugar de analizar los argumentos, las evidencias o la calidad de la investigación, basta con afirmar que el texto «parece escrito por IA» para cuestionarlo.

Esto tiene especial importancia en la comunicación científica. Tradicionalmente, los textos de investigadores que escriben en una lengua que no es la suya pueden recibir una valoración negativa debido a errores gramaticales o estilísticos, incluso cuando la investigación que contienen es sólida. Una de las posibles aportaciones de la IA es precisamente ayudar a superar esta barrera lingüística. Sin embargo, si la comunidad empieza a penalizar automáticamente cualquier texto que parezca haber sido mejorado mediante IA, podría sustituirse un sesgo lingüístico por un nuevo sesgo tecnológico.

“Escribir es pensar”

La parte más personal del artículo aparece cuando Crotty explica su propia relación con estas herramientas. Afirma que para él escribir constituye una forma de pensar: redactar le obliga a organizar las ideas, construir argumentos y comprender mejor aquello sobre lo que quiere escribir. Desde esta perspectiva, delegar la elaboración del texto en una IA supone también, en cierta medida, delegar una parte del proceso intelectual.

Crotty expresa además preocupación por la posibilidad de que los modelos de lenguaje conduzcan hacia una homogeneización de la escritura. Los modelos tienden a producir respuestas estadísticamente plausibles y, según su argumento, esto puede llevar a que los textos se parezcan cada vez más entre sí. La IA puede ayudar a una persona con dificultades de escritura a mejorar su expresión, pero también podría hacer que un escritor experimentado pierda parte de su estilo, originalidad o capacidad para producir ideas alejadas de los patrones habituales.

Una cuestión especialmente relevante para la ciencia

El artículo resulta particularmente interesante porque desplaza el debate desde la pregunta “¿ha utilizado IA este texto?” hacia otra mucho más útil: “¿para qué se utilizó la IA y qué responsabilidad conserva el autor?”. Esta distinción es fundamental en el ámbito académico. Utilizar IA para corregir gramática, traducir un párrafo, generar alternativas de redacción, resumir información o desarrollar una primera estructura no equivale necesariamente a delegar en ella la producción intelectual de una investigación.

Por ello, el texto apunta hacia un modelo basado en transparencia, responsabilidad humana y evaluación del contenido, en lugar de confiar exclusivamente en detectores automáticos. Un detector puede constituir una señal para investigar, pero no debería convertirse por sí mismo en una prueba de mala conducta académica. El propio artículo insiste en que incluso los mejores sistemas de detección no pueden determinar por sí solos qué uso de IA se produjo ni si ese uso resulta éticamente aceptable.

Relevancia para bibliotecas y alfabetización en IA

Para las bibliotecas universitarias y los servicios de apoyo a la investigación, el artículo ofrece una idea especialmente importante: la alfabetización en IA no debería reducirse a enseñar a detectar textos generados artificialmente. También debe enseñar a comprender los diferentes usos de estas herramientas, evaluar críticamente sus resultados, documentar cuándo y cómo se han utilizado y mantener la responsabilidad intelectual sobre el producto final.

En este sentido, el artículo puede relacionarse directamente con la integridad científica, la alfabetización informacional y la formación de investigadores. El objetivo no debería ser identificar mecánicamente si «hay IA» en un documento, sino ayudar a estudiantes, investigadores, autores, revisores y editores a establecer criterios razonables sobre autoría, contribución intelectual, transparencia, verificación de información y responsabilidad.
La denuncia contra una experta en IA se archiva tras las acusaciones sobre el uso de inteligencia artificial en su libro

Retraction Watch. (21 de septiembre de 2026). Misconduct case dropped against AI expert after claims of AI use in recent book. Retraction Watch. Artículo original en Retraction Watch

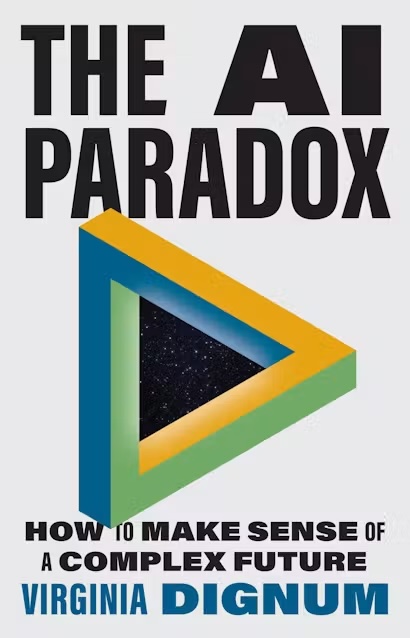
El caso afecta a Virginia Dignum, profesora de inteligencia artificial responsable en la Universidad de Umeå (Suecia) y especialista en las dimensiones sociales de la IA. Una persona anónima presentó una denuncia por posible mala conducta investigadora relacionada con su libro The AI Paradox, publicado por Princeton University Press en febrero de 2026. Las acusaciones se centraban principalmente en dos cuestiones: la supuesta utilización de inteligencia artificial para generar partes del texto y la existencia de referencias bibliográficas que presentaban errores o que, según la denuncia, podían haber sido inventadas.

La Universidad de Umeå recibió la denuncia el 6 de julio de 2026 y remitió el asunto al National Board for Assessment of Research Misconduct (NPOF), organismo sueco encargado de evaluar determinados casos de mala conducta científica. Sin embargo, el 4 de septiembre el organismo decidió cerrar el expediente sin iniciar una investigación, al considerar que las acusaciones quedaban fuera de su ámbito de competencia. El motivo fundamental fue la naturaleza del libro: según la información proporcionada al organismo, The AI Paradox es una obra de divulgación dirigida al público general y no una investigación científica ni un trabajo realizado en el marco de financiación para investigación.

El NPOF concluyó que el libro no constituye investigación científica a efectos de la normativa sueca sobre mala conducta investigadora. El organismo señaló que Dignum considera la obra un libro de divulgación científica, que no formula afirmaciones propias de una investigación y que fue escrita durante su tiempo libre, fuera del ámbito de proyectos financiados. La Universidad de Umeå tampoco encontró elementos que contradijeran esta descripción. Por ello, una vez archivado el expediente, la universidad indicó que no adoptaría medidas específicas contra la investigadora en relación con esta denuncia.

Un elemento particularmente interesante del caso son las referencias bibliográficas cuestionadas. Dignum negó que hubiera fuentes inventadas y explicó que las seis referencias señaladas por la denuncia correspondían a fuentes reales. Reconoció, no obstante, que algunas referencias contenían errores y que determinados problemas se produjeron al utilizar una herramienta de IA para transformar las citas a formato BibTeX. Según su explicación, se trató de errores de edición y no de fabricación deliberada de referencias. Princeton University Press publicó posteriormente una versión electrónica actualizada del libro con correcciones en varias referencias y anunció que las correcciones también se incorporarían a futuras ediciones impresas.

Dignum también reconoció haber utilizado herramientas de inteligencia artificial durante la elaboración del libro para comprobar formulaciones y proponer alternativas de redacción. Según su explicación, el contenido intelectual y el texto final son de su autoría y ella asume la responsabilidad por ellos. El caso vuelve a poner sobre la mesa una cuestión todavía poco definida en el ámbito académico: qué usos de la IA en la escritura son aceptables y cuáles deberían considerarse problemáticos desde el punto de vista de la integridad académica.

Otro aspecto relevante es la utilización de detectores de IA como elemento de prueba. Una de las acusaciones se apoyaba en herramientas que supuestamente habían identificado determinados fragmentos del libro como generados por inteligencia artificial. Dignum cuestionó este tipo de evidencia y sostuvo que no es posible demostrar de manera concluyente que un texto no haya sido generado por IA únicamente mediante herramientas de detección. El caso ilustra así una de las principales dificultades actuales de los detectores: una señal algorítmica de posible generación automática no equivale necesariamente a una prueba de autoría mediante IA.

El bioeticista David Resnik, citado por Retraction Watch, considera que todavía existe una zona de incertidumbre ética respecto al nivel de utilización de IA aceptable en la escritura académica. También advierte sobre la compleja posición de los denunciantes o whistleblowers: pueden contribuir a descubrir auténticas prácticas irregulares, pero también pueden generar investigaciones institucionales costosas cuando las irregularidades denunciadas son menores o no constituyen realmente mala conducta científica.

El caso resulta especialmente significativo para el debate sobre IA e integridad científica porque diferencia tres cuestiones que con frecuencia se mezclan: el uso legítimo o declarado de herramientas de IA durante la redacción, los errores bibliográficos producidos durante procesos asistidos por IA y la verdadera fabricación o falsificación de información. El archivo de la denuncia no significa que todos los problemas señalados en el libro fueran inexistentes: la propia autora reconoció errores bibliográficos que fueron posteriormente corregidos. Lo que determinó el cierre del procedimiento fue, fundamentalmente, que la obra no entraba dentro de la definición de investigación científica sometida a la jurisdicción del organismo sueco.

La investigación fraudulenta no desaparece cuando se publica, sigue siendo citada

Retraction Watch, “Paper mill studies get cited by clinical guidelines, policy docs and more, analysis finds”, 17 de septiembre de 2026. El artículo analiza un estudio de Federica Silvi y Leslie D. McIntosh, de Digital Science, publicado como preprint en arXiv el 31 de agosto de 2026 https://retractionwatch.com/2026/09/17/paper-mill-studies-get-cited-by-clinical-guidelines-policy-docs-and-more-analysis-finds/

Según un nuevo análisis, los estudios producidos por una presunta «fábrica de artículos» (paper mill) aparecen citados con frecuencia en patentes, guías clínicas y documentos de políticas públicas.

El estudio analiza qué ocurre con artículos científicos vinculados a una “paper mill”, es decir, una empresa o red que comercializa manuscritos científicos, autorías o servicios destinados a introducir trabajos de dudosa procedencia en el sistema de publicación académica. El caso estudiado procede de la Pharmakon Neuroscience Network (PNN), una supuesta red científica que, según investigaciones anteriores, funcionaba como un sistema de venta de autorías. Los primeros artículos que incluían PNN entre sus afiliaciones comenzaron a aparecer en 2019 y presentaban algunas características habituales de las publicaciones sospechosas: grupos de autores de diferentes países sin antecedentes claros de colaboración, investigadores de campos muy distintos y combinaciones de autorías difíciles de explicar por una trayectoria científica convencional. 

Silvi y McIntosh estudiaron 1.975 artículos asociados a autores que habían utilizado PNN como afiliación y utilizaron la base de datos Dimensions para seguir las citas que recibieron posteriormente. El objetivo no era simplemente contar cuántos de esos artículos habían sido retractados, sino determinar hasta dónde había llegado su influencia dentro del ecosistema científico y académico. El resultado resulta especialmente relevante: 480 artículos fueron citados en patentes, 57 aparecieron citados en documentos de política pública y 12 fueron citados en guías clínicas.

El principal hallazgo del estudio es que una investigación cuestionable puede seguir circulando y adquiriendo influencia mucho después de haber sido producida. Una vez que un artículo entra en una base de datos bibliográfica, recibe citas y forma parte del corpus de literatura científica disponible, puede ser utilizado por investigadores que desconocen completamente su procedencia.

Esto crea un problema especialmente importante porque las citas pueden actuar como una especie de mecanismo de legitimación acumulativa. Un artículo puede ser citado porque parece relevante, después aparecer en una revisión de literatura, posteriormente ser utilizado por otro investigador y finalmente llegar a un documento normativo o una guía. En cada paso puede perderse información sobre la calidad o procedencia original de la investigación.

El estudio demuestra precisamente que la contaminación del registro científico no se limita a llenar las revistas de artículos problemáticos. Puede alcanzar productos derivados de la ciencia: patentes, documentos de política científica y sanitaria, guías clínicas y eventualmente decisiones relacionadas con financiación.

El problema adquiere una dimensión adicional con la expansión de la IA generativa. Las paper mills ya pueden utilizar herramientas automatizadas para producir textos, modificar manuscritos, generar imágenes o acelerar procesos de publicación. Investigaciones recientes sobre el mercado de venta de autorías muestran precisamente que el modelo de negocio está evolucionando y que la IA puede facilitar algunas de estas operaciones.

Esto puede crear un escenario especialmente complejo: más producción científica aparente, más velocidad de publicación y más dificultad para distinguir entre investigación auténtica y contenido fabricado.

Por ello, la integridad científica futura probablemente dependerá cada vez más de una combinación de revisión humana, análisis bibliométrico, detección de patrones de autoría, verificación de datos, transparencia sobre contribuciones y sistemas capaces de rastrear cambios en el estado de una publicación.

Microsoft y OpenAI ante el conflicto por el uso de contenidos periodísticos para entrenar la IA

“Microsoft exec called AI scraping the ‘largest theft of labor in human history’”, Ars Technica, 17 de septiembre de 2026.
Artículo original en Ars Technica

Se analiza nuevos documentos judiciales que han salido a la luz en el litigio por derechos de autor entre The New York Times y otras organizaciones periodísticas frente a Microsoft y OpenAI. Los documentos, que permanecieron confidenciales durante buena parte del proceso, muestran que dentro de Microsoft y OpenAI existían importantes preocupaciones acerca de las consecuencias económicas y legales de utilizar grandes cantidades de contenidos periodísticos para entrenar modelos de inteligencia artificial.

Uno de los elementos más llamativos es que Brent Hecht, director de Applied Science de Microsoft, llegó a describir internamente el scraping de noticias como “un robo asombroso de proporciones sin precedentes” y como “el mayor robo de trabajo de la historia de la humanidad”.

La cuestión central no es solamente si los modelos de IA pueden utilizar contenidos protegidos por derechos de autor durante su entrenamiento, sino qué ocurre cuando esos modelos terminan sustituyendo económicamente a las fuentes de las que obtienen la información. Los documentos citados en el proceso judicial muestran que algunos responsables de Microsoft y OpenAI eran conscientes de este problema. Un documento interno de Microsoft hablaba de un posible “doom loop” —círculo vicioso—, según el cual la IA podía reducir el tráfico hacia las organizaciones periodísticas, deteriorar sus ingresos y, finalmente, debilitar la producción de nuevos contenidos de calidad que los propios modelos de IA necesitan para seguir funcionando.

El problema adquiere especial importancia porque los buscadores y los chatbots están modificando la manera en que las personas acceden a la información. Tradicionalmente, un buscador mostraba un enlace y el usuario visitaba posteriormente la página del periódico. En cambio, un chatbot puede leer, sintetizar y presentar directamente la información, reduciendo la necesidad de acceder a la fuente original. En documentos internos citados por los demandantes aparecen estimaciones de Microsoft según las cuales determinados productos de IA habrían provocado descensos muy importantes en las tasas de clic hacia algunos medios: entre un 83 % y un 93 % en determinados casos, y entre un 51 % y un 94 % en otros.

Uno de los aspectos jurídicamente relevantes es precisamente este posible efecto de sustitución. La defensa de Microsoft y OpenAI sostiene que el entrenamiento de modelos de IA constituye un uso transformador de las obras y que puede estar protegido por la doctrina estadounidense de fair use (uso legítimo). Sin embargo, los demandantes intentan demostrar que el problema cambia cuando los sistemas no solo utilizan las obras para aprender, sino que pueden proporcionar al usuario fragmentos extensos o incluso reproducciones muy próximas al contenido original, evitando que este visite el medio que produjo la información. Para los demandantes, esto perjudica directamente el mercado de las publicaciones originales.

Los documentos también revelan una tensión entre las posiciones públicas y algunas conversaciones internas. Por ejemplo, Nick Turley, responsable de ChatGPT, habría escrito que los editores se enfrentaban a una “amenaza existencial” derivada de productos comerciales entrenados con contenidos periodísticos. En otra comunicación interna, Turley describió los chatbots como “largamente sustitutivos” y anticipó que serían todavía más sustitutivos a medida que mejorasen. El propio CEO de Microsoft, Satya Nadella, reconoció en una declaración que los chatbots pueden quitar clics a los sitios de noticias porque proporcionan directamente al usuario la información que antes obtenía visitando la fuente.

Otro elemento especialmente significativo es el acceso a contenidos protegidos por sistemas de pago (paywalls). Según los documentos presentados por los demandantes, un empleado de OpenAI informó a Greg Brockman, presidente de la compañía, de que se había encontrado un método para sortear el muro de pago de The New York Times. La respuesta atribuida a Brockman fue positiva. Las organizaciones periodísticas utilizan este episodio para argumentar que las empresas conocían las restricciones existentes sobre determinados contenidos y, aun así, desarrollaron mecanismos para obtenerlos. Estas afirmaciones forman parte de los argumentos de los demandantes y deberán valorarse dentro del proceso judicial.

La escala de la utilización de contenidos también resulta relevante. Según la información incorporada a los documentos judiciales, determinados conjuntos de datos empleados durante el desarrollo de los modelos contenían decenas de miles de copias de trabajos publicados por The New York Times, Daily News y Center for Investigative Reporting. TechCrunch, al informar sobre los mismos documentos, señala además que uno de los conjuntos derivados de Common Crawl contenía más de dos millones de documentos procedentes de nytimes.com, mientras que otro conjunto relacionado con el denominado Project Mango habría reunido copias de más de de 160.000 obras diferentes de organizaciones periodísticas.

Los documentos plantean además otra cuestión importante: la eliminación o pérdida de información sobre derechos de autor dentro de los conjuntos de entrenamiento. Según los demandantes, determinados procesos de preparación de los datos habrían eliminado avisos de copyright porque los investigadores no querían que los modelos reprodujeran posteriormente esas indicaciones. De demostrarse las conductas descritas y su relevancia jurídica, podrían ser importantes para evaluar no solo cómo se recopilaron los contenidos, sino también cómo fueron preparados para el entrenamiento.

Microsoft, sin embargo, ha respondido que las declaraciones de Hecht representan la opinión individual de un empleado y que no constituyen un análisis jurídico ni la posición oficial de la compañía. La empresa mantiene que sus productos de IA realizan un uso transformador de los contenidos y que no sustituyen a los medios de comunicación. En consecuencia, las declaraciones internas no deben confundirse automáticamente con hechos jurídicamente establecidos: proceden en buena medida de documentos y argumentos presentados por los demandantes en el litigio.

Los documentos revelados no demuestran por sí mismos que Microsoft u OpenAI hayan cometido una infracción de copyright; eso corresponde determinarlo al proceso judicial. Pero sí muestran que dentro de las propias empresas existía una conciencia bastante clara del posible conflicto entre el desarrollo de modelos de IA y la sostenibilidad económica de las industrias que producen los contenidos utilizados por esos modelos. El caso constituye, por tanto, un episodio especialmente relevante del debate sobre el futuro del periodismo, el copyright y la inteligencia artificial.

Los detectores de IA se están utilizando para sancionar a los estudiantes: ¿son realmente fiables?

CNET. “AI Detectors Are Being Used to Discipline Students. I Tested Whether They Should Be.” CNET, 2026. Artículo original en CNET

Los detectores de IA pueden proporcionar indicios, pero no deberían considerarse una prueba concluyente de autoría ni constituir, por sí solos, la base para sancionar a un estudiante. La cuestión fundamental no es solamente si podemos detectar IA, sino cómo garantizar procesos de evaluación académica justos y fiables en un contexto en el que humanos e inteligencia artificial colaboran cada vez más en la producción de textos.

Se aborda un problema cada vez más controvertido en el ámbito educativo: el uso de detectores de inteligencia artificial para determinar si un estudiante ha utilizado ChatGPT u otras herramientas generativas en la elaboración de un trabajo. La cuestión adquiere especial importancia porque algunas instituciones educativas están utilizando estas herramientas como elemento de prueba para investigar o incluso sancionar a estudiantes, pese a que la detección de textos generados por IA no ofrece una certeza equivalente a la de una prueba objetiva de autoría.

La experiencia descrita en el artículo pone de manifiesto una de las principales debilidades de estos sistemas: los detectores pueden equivocarse tanto al identificar textos humanos como textos generados por IA. El problema de los falsos positivos resulta especialmente preocupante en contextos académicos, ya que un texto redactado íntegramente por un estudiante puede ser clasificado como producido por inteligencia artificial. Del mismo modo, pequeñas modificaciones o procesos de edición pueden alterar considerablemente el resultado de la detección.

El artículo también cuestiona la idea de que exista una especie de “huella digital” inequívoca de la IA en un texto. Los modelos de detección trabajan mediante estimaciones probabilísticas relacionadas con características lingüísticas y patrones estadísticos, pero no pueden demostrar por sí mismos quién ha escrito un documento. Por ello, un porcentaje elevado de probabilidad de utilización de IA no debería interpretarse como una prueba definitiva de que un estudiante ha cometido una infracción académica.

Una cuestión particularmente relevante es la asimetría entre el poder de estas herramientas y las consecuencias de sus errores. Cuando un detector se emplea simplemente como instrumento orientativo para iniciar una conversación con el estudiante, sus limitaciones pueden resultar manejables. Sin embargo, cuando el resultado se transforma directamente en una acusación o en una sanción académica, un falso positivo puede tener consecuencias importantes para la trayectoria educativa de una persona. El artículo invita, por tanto, a diferenciar claramente entre detectar una anomalía estadística y demostrar una conducta académicamente deshonesta.

El texto resulta especialmente pertinente para el debate sobre integridad académica en la era de la IA generativa. La aparición de ChatGPT y de otras herramientas similares obliga a las universidades a replantearse no solamente cómo detectar posibles usos indebidos de IA, sino también qué significa actualmente escribir, investigar, aprender y demostrar competencias. En lugar de depositar una confianza excesiva en los detectores, parece más razonable combinar diferentes evidencias: proceso de elaboración del trabajo, versiones anteriores, referencias utilizadas, capacidad del estudiante para explicar sus argumentos y diálogo con el docente.

En este sentido, el artículo plantea indirectamente un cambio de enfoque: la respuesta a la IA generativa no debería basarse exclusivamente en una tecnología destinada a “policiar” los textos, sino en estrategias educativas que permitan enseñar un uso responsable, transparente y crítico de estas herramientas. Para las bibliotecas universitarias y los programas de alfabetización informacional, esto supone una oportunidad para incorporar nuevas competencias relacionadas con la IA, la evaluación crítica de sus resultados, la transparencia en su utilización y la comprensión de sus limitaciones.

Oxford University Press reclama una mayor claridad para declarar el uso de inteligencia artificial en la investigación

Oxford University Press (OUP). (2026, 10 de septiembre). Supporting researchers to disclose AI use with confidence. Oxford University Press. https://fdslive.oup.com/www.oup.com/Group_comms/pdf/Disclosing_AI_use_in_academic_research.pdf

Oxford University Press ha actualizado sus directrices para autores y editores sobre el uso responsable, apropiado y transparente de la inteligencia artificial, con el objetivo de ayudar a los investigadores a declarar con mayor seguridad cuándo y cómo han utilizado herramientas de IA durante sus procesos de investigación y publicación.

El informe muestra que la IA ya forma parte habitual del trabajo investigador. El 64 % de los investigadores afirma haberse beneficiado de su utilización, aunque únicamente el 20 % confía en los resultados generados por las herramientas de IA. Existe, por tanto, una actitud bastante pragmática: los investigadores encuentran utilidad en estas tecnologías, pero mantienen una considerable cautela respecto a su fiabilidad. Esta prudencia se refleja en que el 83 % comprueba las fuentes de las citas y el 80 % contrasta los resultados proporcionados por la IA, mientras que solo alrededor del 36 % conserva un registro de cómo ha utilizado estas herramientas durante su investigación.

Uno de los principales problemas identificados es precisamente la falta de claridad sobre qué usos de la IA deben declararse. El 74 % de los investigadores considera que existe una falta general de claridad sobre las situaciones que requieren divulgación, y un 44 % teme que declarar el uso de IA pueda afectar negativamente a la percepción que otros investigadores tengan de su trabajo. El informe señala así una tensión entre el creciente uso cotidiano de estas tecnologías y unas normas de transparencia que todavía están evolucionando. Algunos investigadores reclaman una declaración obligatoria y exhaustiva, mientras que otros prefieren distinguir entre usos aceptables e inaceptables o normalizar la IA como una herramienta más del proceso investigador.

La utilización de IA se concentra especialmente en determinadas fases de la investigación. Los usos más frecuentes son descubrir investigaciones existentes (55 %), resumir literatura científica (46 %) y editar los textos de investigación (45 %). También se emplea para generar ideas, diseñar investigaciones, analizar datos, programar, traducir, corregir textos y preparar solicitudes de financiación. En cuanto a las herramientas, los chatbots de IA disponibles en la web abierta son utilizados por el 68 % de los investigadores que emplean IA, mientras que la traducción automática alcanza aproximadamente al 49 %.

El estudio identifica además una importante infra-declaración del uso de IA en la comunicación científica. El 46 % de los autores de artículos de revista y el 39 % de los autores de libros reconocen que no habían declarado completamente el empleo de IA durante la preparación de sus manuscritos, especialmente cuando se utilizó para redactar textos. La situación también afecta a otros procesos: el 48 % de quienes prepararon solicitudes de financiación no había declarado completamente su utilización de IA, particularmente en redacción narrativa, traducción/edición y elaboración de resúmenes en lenguaje sencillo. Entre los revisores por pares, el 25 % tampoco había declarado completamente su uso, especialmente cuando recurrieron a IA para la edición lingüística.

El informe resulta especialmente interesante porque muestra que los investigadores no constituyen un grupo homogéneo frente a la IA. OUP identifica cinco perfiles: escépticos persistentes, que confían muy poco en la IA; conversos cautelosos, preocupados sobre todo por la falta de claridad de las normas; usuarios despreocupados, que utilizan las herramientas sin prestar demasiada atención a sus implicaciones; entusiastas comprometidos, que confían más en sus resultados y conocen mejor las herramientas disponibles; y pioneros frustrados, que obtienen importantes beneficios de la IA pero encuentran obstáculos relacionados con costes, créditos y carga administrativa.

Otro aspecto relevante es que una parte importante de los investigadores no utiliza IA deliberadamente. Entre quienes no la emplean, el principal motivo son las dudas sobre su exactitud, sesgos y fiabilidad (37 %). También aparecen preocupaciones éticas, morales y sociales (24 %), cuestiones relacionadas con la integridad académica (22 %), falta de utilidad para determinadas áreas de investigación (22 %) y preocupaciones medioambientales (20 %). Un 18 % expresa además temor a que la IA perjudique el pensamiento crítico y la calidad de la investigación.

En conjunto, el estudio plantea que el problema ya no consiste simplemente en si los investigadores utilizan IA, sino en cómo la utilizan, cómo verifican sus resultados y cómo documentan y comunican ese uso. La IA está modificando los procesos de búsqueda, análisis, escritura, traducción y revisión, pero las políticas institucionales y editoriales todavía no ofrecen siempre respuestas suficientemente claras. De hecho, el 45 % considera que la posición de su institución ante la IA es «mixta o poco clara», frente a un 43 % que percibe una actitud al menos parcialmente facilitadora.