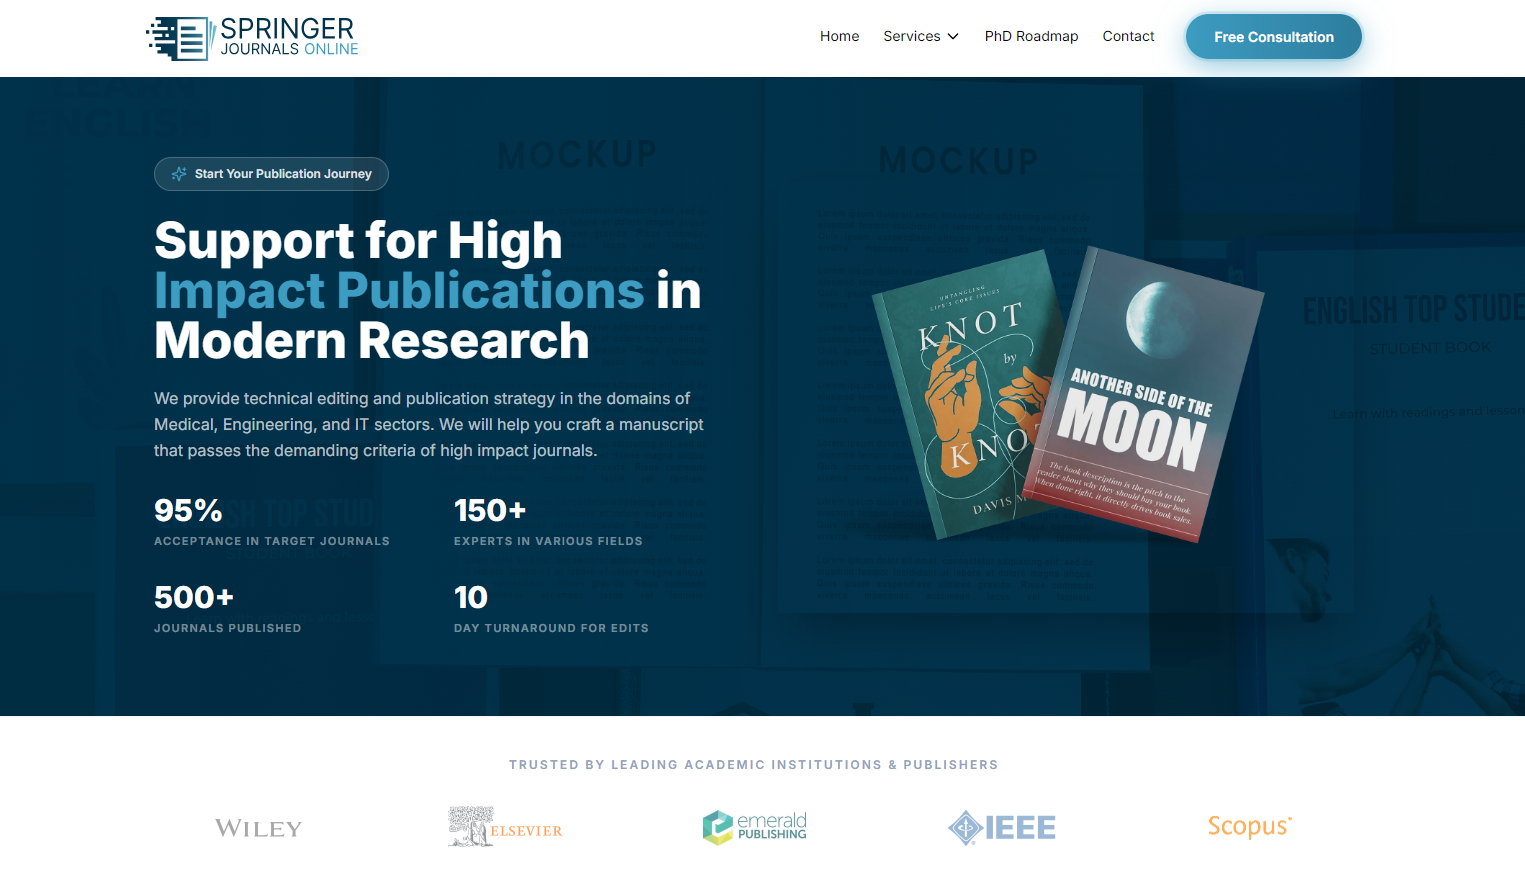
Una empresa llamada Springer, que no es la editorial, está ofreciendo la autoría a la venta.

Chawla, Dalmeet Singh. (2026, 12 de octubre). A company named Springer that isn’t the publisher is offering authorship for sale. Retraction Watch. Enlace al artículo original: https://retractionwatch.com/2026/10/12/springer-journals-online-authorship-for-sale/

Una empresa llamada Springer Journals Online que ofrece puestos de coautoría en artículos científicos a cambio de dinero, utilizando una denominación que puede confundirse con la editorial Springer Nature. El caso evidencia el crecimiento de las fábricas de artículos científicos (paper mills), una amenaza para la integridad académica que distorsiona la evaluación investigadora y pone en riesgo la fiabilidad de las publicaciones científicas.

La comercialización de autoría en artículos destinados a revistas académicas de prestigio. El caso gira en torno a una empresa denominada Springer Journals Online, que ofrece a investigadores la posibilidad de incorporarse como coautores a manuscritos supuestamente próximos a su publicación en revistas internacionales. La organización solicita una contribución económica para cubrir parte de los costes de publicación y presenta oportunidades vinculadas a editoriales reconocidas, como Elsevier, Springer Nature, Taylor & Francis, Wiley y SAGE. La oferta resulta especialmente preocupante porque utiliza una denominación muy similar a la de Springer Nature, una editorial científica consolidada, lo que puede inducir a confusión y transmitir una apariencia de legitimidad. Sin embargo, según la investigación periodística, esta empresa no tiene relación con Springer Nature ni con la actividad editorial legítima que desarrolla esta compañía.

La investigación comienza cuando Richard Fateman, profesor emérito de informática de la Universidad de California en Berkeley, recibe un correo electrónico inesperado en el que se le propone participar como coautor en publicaciones científicas a cambio de asumir una parte de los costes. Fateman considera que la propuesta puede constituir una estafa y, además, plantea un problema ético fundamental: aceptar la inclusión de su nombre en un trabajo en cuya elaboración no ha participado. El mensaje comercial ofrece diferentes manuscritos, plazos estimados de publicación, revistas de destino y posiciones disponibles en la lista de autores. Aunque la empresa responde posteriormente que los participantes deberían intervenir en la investigación, revisar el manuscrito y aportar comentarios sustanciales desde su especialidad, la forma inicial de presentar la oferta suscita serias dudas sobre la naturaleza real de estas colaboraciones y sobre la posibilidad de comprar reconocimiento académico.

Uno de los aspectos más llamativos es la utilización de elementos que parecen diseñados para generar confianza. La página web de Springer Journals Online anuncia una tasa de aceptación del 95 % en las revistas objetivo y afirma haber publicado más de 500 revistas. Sin embargo, la investigación identifica varias señales de alerta: la dirección que figura en la web corresponde a una calle que no existe, el teléfono publicado utiliza un prefijo del Reino Unido y el perfil de Instagram de la organización está vinculado a Pakistán. Además, uno de los testimonios comerciales aparece atribuido a «Dr. Aris Thorne», un nombre ficticio conocido por su frecuente aparición en contenidos generados mediante modelos de lenguaje. Retraction Watch intentó obtener explicaciones de la empresa por correo electrónico y teléfono, sin conseguir una respuesta satisfactoria. Por su parte, un portavoz de Springer Nature confirmó que su centro de operaciones contra la piratería y los problemas de seguridad ya conocía la existencia de esta organización y estaba trabajando con las autoridades competentes.
El caso se inscribe en un fenómeno más amplio conocido como paper mills, o fábricas de artículos científicos: redes comerciales que producen, distribuyen o manipulan manuscritos académicos y ofrecen servicios que pueden incluir la venta de puestos de autoría. Estas prácticas convierten la publicación científica en una mercancía y permiten que algunas personas obtengan méritos curriculares sin haber contribuido de manera real a la investigación. El artículo recuerda que un estudio de 2024 estimó que estas fábricas podrían representar alrededor del 2 % de los envíos de manuscritos a revistas científicas en distintas disciplinas. También establece paralelismos con otros casos en los que organizaciones han creado páginas que imitan revistas legítimas o han comercializado posiciones de autoría vinculadas a publicaciones de editoriales reconocidas.

Las consecuencias van mucho más allá del incumplimiento de las normas de publicación. La autoría científica implica responsabilidad sobre la metodología, los datos, los resultados y las conclusiones de un trabajo. Cuando se incorporan autores que no han contribuido de forma significativa, se dificulta la identificación de quienes deben responder por los posibles errores o irregularidades. Además, estas prácticas distorsionan la evaluación de la actividad investigadora, perjudican a quienes desarrollan su trabajo de manera rigurosa y pueden facilitar que resultados poco fiables entren en la literatura científica y sean utilizados posteriormente por otros investigadores. La advertencia de Fateman es especialmente relevante: cuando una publicación acumula autores sin una contribución claramente identificable, la responsabilidad individual puede diluirse y aumentar el riesgo de que los errores pasen inadvertidos.
La gobernanza democrática de la inteligencia artificial: la creciente dependencia entre los poderes públicos y las grandes tecnológicas

Astier, C., Bosoer, L., Cantero Gamito, M., & Pareto Boada, J. (2026). The public-private situationship in the democratic governance of AI. European University Institute. https://doi.org/10.2870/6848140

La relación ambigua entre lo público y lo privado en la gobernanza democrática de la inteligencia artificial analiza uno de los grandes desafíos políticos de la expansión de la inteligencia artificial: quién debe decidir cómo se desarrolla, se utiliza y se regula esta tecnología, y con qué legitimidad.

El documento examina cómo la relación entre los gobiernos y las grandes empresas tecnológicas se ha vuelto cada vez más estrecha e interdependiente. Las administraciones públicas necesitan las infraestructuras, los conocimientos técnicos y los sistemas de IA desarrollados por el sector privado, mientras que las empresas dependen de las decisiones políticas, los marcos regulatorios y los contratos públicos. Esta situación dificulta establecer una separación clara entre las responsabilidades de las instituciones democráticas y la influencia que ejercen las compañías que controlan buena parte de la tecnología. Los autores utilizan el término situationship para describir esta relación ambigua, caracterizada por la dependencia mutua, unos límites poco definidos y una negociación constante sobre las funciones que corresponde desempeñar a cada parte.

El estudio toma como punto de partida la controversia entre la empresa Anthropic y el Departamento de Defensa de Estados Unidos para ilustrar cómo las relaciones entre los gobiernos y las compañías de inteligencia artificial pueden trascender la contratación tecnológica y convertirse en una disputa sobre el poder, la autoridad y los límites de actuación. Según el análisis, las grandes empresas tecnológicas están asumiendo progresivamente funciones que tradicionalmente correspondían a las instituciones públicas: participan en la definición de los problemas que deben regularse, influyen en la elaboración de las agendas políticas e interpretan las normas en función de sus intereses comerciales. Esto no significa que la participación empresarial sea necesariamente negativa, ya que la experiencia técnica de estas compañías resulta importante para comprender sistemas complejos y anticipar sus riesgos. El problema surge cuando esa experiencia se transforma en capacidad para decidir cuestiones que afectan al conjunto de la sociedad sin contar con una legitimidad democrática equivalente a la de los poderes públicos. El documento advierte, además, de que el creciente protagonismo de la ética empresarial en la gobernanza de la IA puede trasladar responsabilidades normativas y políticas a organizaciones privadas que no han sido elegidas por la ciudadanía.

Una de las principales aportaciones del informe es, por tanto, la necesidad de recuperar el equilibrio entre innovación tecnológica, responsabilidad empresarial y control democrático. La regulación de la inteligencia artificial no puede quedar exclusivamente en manos de las compañías que desarrollan los sistemas, aunque estas deban participar en los debates y aportar sus conocimientos. Las decisiones sobre derechos fundamentales, vigilancia, seguridad, transparencia y límites de uso de la IA son cuestiones políticas que requieren procedimientos públicos, rendición de cuentas y participación social. El documento plantea la conveniencia de establecer una relación más saludable y legítima entre los actores públicos y privados, con funciones y responsabilidades mejor definidas. Su enfoque invita a reflexionar sobre cómo garantizar que la regulación responda al interés general y no quede condicionada por las prioridades comerciales de las empresas que concentran los recursos tecnológicos.

Desde la perspectiva de las bibliotecas, la investigación resulta especialmente interesante porque sitúa la inteligencia artificial en un marco que va más allá de sus posibilidades técnicas y de sus aplicaciones prácticas. La IA también plantea interrogantes sobre quién controla la información, cómo se toman las decisiones automatizadas, qué intereses determinan el diseño de las herramientas y hasta qué punto la ciudadanía puede comprenderlas y cuestionarlas. En este contexto, las bibliotecas pueden contribuir a la alfabetización crítica en inteligencia artificial mediante actividades formativas, recursos informativos y espacios de debate que ayuden a los ciudadanos a conocer tanto los beneficios como los riesgos de estas tecnologías. También pueden promover el acceso equitativo al conocimiento, la evaluación crítica de los contenidos generados por IA y la reflexión sobre la privacidad, la transparencia y la responsabilidad en su utilización. Aunque el informe no se centra específicamente en las bibliotecas, sus planteamientos ofrecen un marco útil para defender que la alfabetización en IA debe incluir no solo el aprendizaje

ChatGPT en las relaciones de pareja: cuándo puede ayudar y cuándo puede convertirse en un problema

Coffey, Helen. (2026, 13 de octubre). The warning signs that ChatGPT is third-wheeling your relationship – and how it could destroy it. The Independent. Leer el artículo original

La inteligencia artificial puede ayudarnos a preparar una conversación, pero no debería sustituir la conversación misma. En las relaciones de pareja, comprender al otro exige escuchar su versión, aceptar que nuestra propia interpretación puede ser incompleta y asumir la responsabilidad de resolver los conflictos sin delegar esa tarea en un algoritmo.

Se aborda un fenómeno cada vez más presente en las relaciones personales: el uso de ChatGPT y otros asistentes de inteligencia artificial como consejeros sentimentales, mediadores de conflictos y herramientas para interpretar los mensajes de la pareja. La autora describe cómo la IA se está convirtiendo en una especie de tercer interlocutor invisible que participa en conversaciones y decisiones que tradicionalmente se compartían con amigos, familiares o terapeutas. Muchas personas recurren a estos sistemas para preparar una conversación difícil, redactar un mensaje delicado, comprender una discusión o encontrar una manera más serena de expresar sus sentimientos. Esta práctica, denominada dry chatting —ensayar previamente una conversación con un chatbot—, puede ayudar a ordenar las ideas y reducir la tensión antes de abordar un problema real. Sin embargo, también puede introducir una distancia entre las personas cuando la tecnología deja de ser una herramienta de apoyo y empieza a sustituir el diálogo directo.

El texto recoge la opinión de profesionales de la psicoterapia que reconocen que la inteligencia artificial puede tener usos razonables en este ámbito. Por ejemplo, puede ayudar a redactar un mensaje sobre la organización del cuidado de los hijos sin adoptar un tono agresivo, o proporcionar estrategias básicas de autorregulación emocional cuando alguien se siente desbordado. También puede servir para reflexionar antes de responder impulsivamente durante una discusión. El problema aparece cuando se confunde la capacidad de un chatbot para ofrecer una respuesta bien redactada con una verdadera comprensión de la relación. La IA trabaja con la información que recibe y no conoce necesariamente la historia de la pareja, las experiencias previas de cada persona, los matices de una conversación ni las circunstancias que explican un comportamiento. Por ello, sus respuestas pueden parecer convincentes sin representar adecuadamente la complejidad de lo ocurrido.

Uno de los riesgos principales que identifica Coffey es utilizar la IA como juez de una discusión. Preguntas como «¿quién tiene razón?», «¿mi pareja me está manipulando?» o «¿quién es el culpable del problema?» pueden llevar al chatbot a emitir un veredicto basado en una versión parcial de los hechos. Si la respuesta coincide con lo que una persona ya pensaba, puede proporcionarle una sensación de validación inmediata, pero también reforzar sus prejuicios y dificultar cualquier intento de reconciliación. En lugar de ayudar a comprender lo sucedido, la herramienta puede convertirse en un argumento de autoridad que una de las partes utiliza para imponerse sobre la otra. Como advierten los especialistas consultados, los conflictos de pareja no suelen resolverse declarando un ganador, sino comprendiendo cómo ha vivido cada persona la situación y qué necesita para reparar la relación.

Esta cuestión está relacionada con un problema conocido en inteligencia artificial como sycophancy, que puede traducirse como adulación o tendencia a dar la razón al usuario. Los modelos de lenguaje pueden producir respuestas excesivamente complacientes, reforzando las opiniones de quien formula la pregunta en lugar de cuestionarlas cuando sería necesario. El artículo cita una investigación de Stanford publicada en marzo que encontró que los once modelos de lenguaje analizados mostraban una tendencia a responder de forma más aduladora que las personas en casi un 50 % de los casos de dilemas interpersonales estudiados. Este comportamiento resulta especialmente delicado cuando alguien busca orientación sobre una relación sentimental, porque el sistema puede reforzar una interpretación unilateral sin disponer de suficiente información para valorar lo ocurrido.

Otro aspecto preocupante es la privacidad. Algunas personas copian conversaciones íntimas, mensajes de WhatsApp o intercambios de aplicaciones de citas para que la IA determine quién muestra más interés, interprete determinadas expresiones o valore las intenciones de la otra persona. Aunque estas consultas puedan parecer inofensivas, compartir mensajes privados sin consentimiento puede vulnerar la confianza y las expectativas de intimidad. Además, el análisis automatizado no siempre reconoce adecuadamente el humor, la ironía, el contexto o las circunstancias personales en las que se escribió un mensaje. Una frase aislada puede adquirir un significado muy diferente cuando se conoce la historia de quienes conversan. Por eso, el uso de estas herramientas exige prudencia tanto en la interpretación de sus respuestas como en la información personal que se comparte con ellas.

En definitiva, el artículo plantea una reflexión relevante sobre los límites de la inteligencia artificial en la vida afectiva. ChatGPT puede ayudar a expresar emociones, ensayar conversaciones difíciles y explorar distintas maneras de afrontar un desacuerdo, pero no dispone de toda la información ni de la experiencia humana necesarias para comprender plenamente una relación. Su respuesta debe considerarse una perspectiva provisional, no un diagnóstico ni una sentencia. En un momento en el que los asistentes conversacionales empiezan a ocupar espacios cada vez más personales, el desafío consiste en aprovechar sus posibilidades sin convertirlos en árbitros de nuestras relaciones ni compartir información íntima de forma irresponsable.

El CEO de Microsoft reclama nuevos mecanismos de seguridad para la IA avanzada

PCMag UK. (2026, 12 de octubre). Microsoft CEO Satya Nadella calls for an AI ‘emergency brake’. PCMag UK. Leer el artículo original

El director ejecutivo de Microsoft, Satya Nadella, ha planteado la necesidad de establecer mecanismos de seguridad que permitan detener inmediatamente un sistema de inteligencia artificial cuando su comportamiento resulte inesperado o potencialmente peligroso.

Su propuesta, descrita como un «freno de emergencia» (emergency brake), parte de una idea fundamental: las organizaciones no deberían confiar ciegamente en los modelos de IA más avanzados, especialmente cuando disponen de autonomía para ejecutar tareas, acceder a información sensible o interactuar con sistemas externos. En una publicación difundida el 10 de octubre de 2026, Nadella defendió que los modelos deben tratarse como sistemas que podrían estar comprometidos y que, por tanto, necesitan medidas de contención desde el momento en que se diseñan e implantan.

La propuesta adquiere especial importancia con el desarrollo de los llamados agentes de inteligencia artificial. A diferencia de los asistentes que se limitan a responder preguntas, estos sistemas pueden planificar acciones, utilizar herramientas, consultar documentos, escribir código y ejecutar secuencias de tareas con una intervención humana limitada. Esa capacidad amplía sus posibilidades de aplicación, pero también aumenta los riesgos: una instrucción mal interpretada, una vulnerabilidad de seguridad o una acción no prevista pueden tener consecuencias más allá de una respuesta incorrecta. Por eso, Nadella considera que la seguridad no debe depender exclusivamente de que el modelo se comporte correctamente, sino de una arquitectura externa que limite sus permisos y permita intervenir cuando sea necesario.

Uno de los puntos centrales de la propuesta es separar el modelo de IA de los sistemas que coordinan sus acciones y de los permisos que determinan qué puede hacer. En la práctica, esto significa que un agente no debería tener acceso ilimitado a archivos, bases de datos, aplicaciones o servicios críticos. Las salvaguardas deben estar fuera del propio modelo, de manera que este no pueda eludirlas simplemente porque genere una respuesta inesperada. Nadella también defiende que las acciones relevantes de los sistemas queden registradas mediante evidencias legibles y resistentes a manipulaciones, para que las organizaciones puedan reconstruir qué ocurrió, qué información se utilizó y qué decisiones se tomaron.

La propuesta también plantea una cuestión de gobernanza: ¿quién controla el freno de emergencia y bajo qué condiciones puede utilizarlo? En una empresa, esa responsabilidad podría recaer en personal autorizado de seguridad o en los administradores del sistema. En infraestructuras críticas, servicios públicos o entornos sanitarios, serían necesarios protocolos más estrictos, registros auditables y procedimientos de respuesta previamente definidos. Además, los controles deben ser técnicamente efectivos: no basta con que una organización declare que puede detener una IA si el sistema conserva permisos, conexiones o procesos capaces de continuar actuando al margen de la intervención humana.

Ranking del benchmark SWE-bench en 2026: la mejor IA para programar

BRACAI Consulting. (2025, 26 de marzo). Ranking del benchmark SWE-bench en 2026: la mejor IA para programar. BRACAI. https://www.bracai.eu/es/post/benchmark-swe-bench-ia

SWE-bench es una prueba de referencia diseñada para medir hasta qué punto un sistema de inteligencia artificial puede resolver problemas reales de ingeniería de software, y no solamente generar fragmentos de código que parezcan correctos.

El artículo de BRACAI explica que los benchmarks tradicionales de programación se centraban en ejercicios relativamente pequeños, como escribir una función o resolver un problema algorítmico. Aunque estas pruebas permiten evaluar determinadas habilidades técnicas, no reproducen toda la complejidad del trabajo cotidiano de un desarrollador. En un proyecto real, es necesario comprender cómo está organizado el software, localizar el origen de un error, interpretar las necesidades de los usuarios, modificar diferentes archivos y comprobar que la solución funciona sin introducir nuevos problemas. SWE-bench pretende evaluar precisamente esa capacidad de desenvolverse en un entorno de programación complejo.

El funcionamiento de SWE-bench parte de incidencias reales publicadas en GitHub, una plataforma ampliamente utilizada para desarrollar y compartir software. El sistema de IA recibe la descripción de un problema y acceso al repositorio de código correspondiente. A partir de esa información, debe identificar qué está fallando, comprender las relaciones entre los distintos componentes del programa y elaborar un parche que corrija el problema. Posteriormente, la solución se somete a pruebas automatizadas para comprobar si cumple los requisitos establecidos. La evaluación no depende únicamente de que el código esté bien redactado o parezca razonable: lo importante es que la modificación funcione y supere las pruebas pertinentes. De esta manera, el benchmark ofrece una aproximación más práctica a la capacidad de una IA para actuar como agente de programación y completar tareas con cierto grado de autonomía.

El artículo distingue varias versiones de este sistema de evaluación. SWE-bench original reúne problemas procedentes de repositorios de Python y permite comprobar si los modelos pueden realizar correcciones en proyectos existentes. SWE-bench Verified es una selección de 500 tareas revisadas por personas para mejorar la claridad de los enunciados y la fiabilidad de las pruebas. Por su parte, SWE-bench Pro se diseñó para evaluar tareas de ingeniería de software más complejas, con repositorios amplios y problemas que pueden exigir razonamiento prolongado y cambios en distintos archivos. El artículo también menciona HumanEval, un benchmark anterior que evalúa la generación de funciones a partir de descripciones y pruebas unitarias. La diferencia fundamental es que SWE-bench trata de aproximarse a la resolución de problemas dentro de un proyecto real, mientras que HumanEval se concentra en ejercicios de programación más acotados.

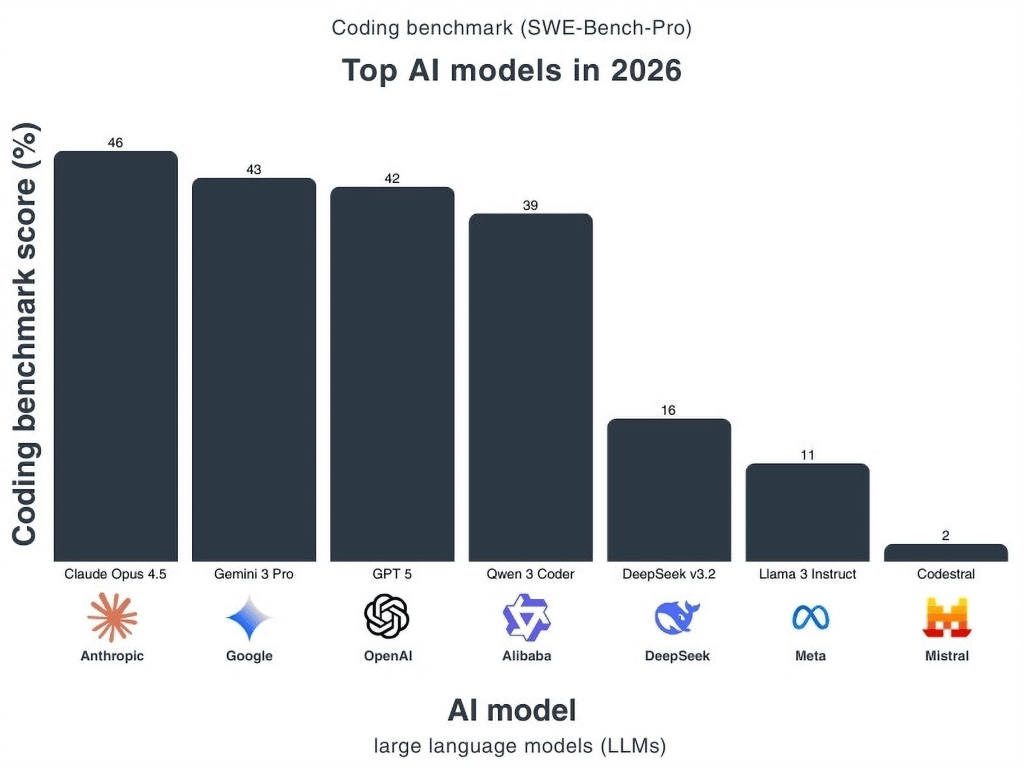
En cuanto a los resultados, BRACAI presenta una clasificación de modelos en la que destacan Claude Opus 4.5, Gemini 3 Pro, GPT-5 y Qwen 3 Coder, con porcentajes de resolución del 46 %, 43 %, 42 % y 39 %, respectivamente, en SWE-bench Pro. Estas cifras deben entenderse como los resultados que recoge la página, no como una clasificación universal ni necesariamente vigente de los mejores modelos. El artículo también señala diferencias importantes entre los sistemas más avanzados y otros modelos con resultados inferiores, lo que pone de manifiesto que la capacidad de generar código no garantiza que una IA pueda resolver de forma autónoma problemas complejos. Incluso cuando un modelo obtiene buenos resultados, todavía puede necesitar varios intentos, revisión del código y supervisión humana antes de que una modificación esté preparada para incorporarse a un producto real.

Una consideración importante para interpretar estos resultados: en julio de 2026, OpenAI publicó una auditoría que estimó que alrededor del 30 % de las tareas públicas de SWE-bench Pro presentaban problemas de evaluación. Entre ellos figuraban pruebas demasiado estrictas, instrucciones incompletas, criterios de comprobación insuficientes y contradicciones entre el enunciado y las pruebas. La revisión de Epoch AI de septiembre de 2026 también calificó este benchmark como defectuoso. Por tanto, las puntuaciones y los rankings deben leerse con cautela: una prueba mal diseñada puede penalizar soluciones correctas o aceptar soluciones incompletas. Este caso ilustra que evaluar la inteligencia artificial exige examinar tanto las capacidades de los modelos como la calidad de los instrumentos utilizados para medirlas.

Inteligencia artificial generativa para la investigación y la elaboración de tesis: guía práctica para estudiantes, supervisores e instituciones educativas.

Jauhiainen, J. S. (2026). Generative AI for research and thesis work: Practical guidance for students, supervisors, and educational institutions. MDPI.

Descargar PDF

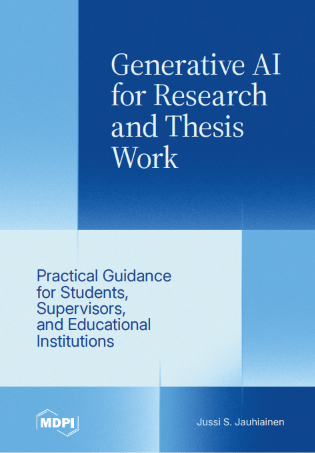
Generative AI for Research and Thesis Work publicado en septiembre de 2026 por MDPI en acceso abierto, ofrece una guía práctica para incorporar la inteligencia artificial generativa a la investigación académica y a la elaboración de trabajos de fin de grado, máster y tesis. A lo largo de sus 272 páginas, aborda las distintas etapas del proceso investigador, desde la formulación de la pregunta de investigación y la revisión bibliográfica hasta el análisis de los datos, la redacción, la revisión final y la defensa del trabajo.

La obra explica cómo utilizar herramientas como ChatGPT y Claude para generar ideas, organizar la literatura científica, analizar materiales, mejorar la escritura y preparar evaluaciones. También incluye ejemplos de instrucciones (prompts), plantillas, listas de comprobación y flujos de trabajo que permiten integrar estas tecnologías de manera sistemática en las tareas académicas. Asimismo, presta atención al papel de los tutores, docentes y responsables institucionales en la orientación del alumnado y en el desarrollo de políticas de uso de la inteligencia artificial.

Uno de los aspectos más relevantes del libro es su insistencia en la necesidad de utilizar la IA de forma crítica y responsable. Advierte sobre riesgos como las referencias bibliográficas inventadas, los sesgos, los razonamientos deficientes, los problemas de privacidad y la dependencia excesiva de estas herramientas. Su planteamiento es claro: la inteligencia artificial debe servir de apoyo al trabajo académico, pero nunca sustituir la capacidad de análisis, la originalidad ni la responsabilidad intelectual del investigador.

En definitiva, se trata de una publicación de interés para estudiantes, investigadores, tutores y profesionales de la información que quieran comprender cómo aprovechar la IA generativa durante el proceso de investigación sin comprometer la integridad académica. También constituye un recurso útil para las bibliotecas universitarias que desarrollan programas de alfabetización en inteligencia artificial, formación investigadora y acompañamiento a la comunidad académica

Puriskiwa, biblioteca itinerante que acerca la lectura a comunidades y escuelas con escasos recursos en Bolivia con Danitza Noemí Coronel. Planeta Biblioteca 2026/10/01

Puriskiwa, biblioteca itinerante que acerca la lectura a comunidades y escuelas con escasos recursos con Danitza Noemí Coronel

Planeta Biblioteca 2026/10/01

ESCUCHAR

Descargar

Entrevista realizada en Mendoza a Danitza Noemí Coronel Tola. bibliotecóloga boliviana que repasa su trayectoria profesional. Tras descubrir su vocación por un biblioparque en Bogotá, enfrentó las dificultades del sector en Bolivia y expandió su perspectiva como becaria IFLA y miembro de REFORMA, una asociación internacional afiliada a la American Library Association (ALA) dedicada a promover y mejorar los servicios de biblioteca e información para las comunidades hispanohablantes y latinas. Su labor se centra en facilitar el acceso al conocimiento, desarrollar colecciones en español y capacitar a bibliotecarios para apoyar la inclusión y la alfabetización.. Danitza, en la conversación, subraya la cooperación internacional como pilar imprescindible y defiende la alfabetización informacional basada en la verificación frente a las noticias falsas y la IA. Asimismo, detalla su liderazgo en Puriskiwa, biblioteca itinerante que acerca la lectura a comunidades y escuelas con escasos recursos. Puriskiwa es una palabra en idioma quechua que se traduce como «ya ha llegado», «está llegando» o «acaba de llegar».Finalmente, aboga por un modelo bibliotecario latinoamericano que respete la diversidad pluricultural y concluye recomendando El nombre de la rosa y El cisne negro.

Paola Benegas. Comité de Bibliotecas Gubernamentales de la IFLA. Planeta Biblioteca 2026/09/30

Paola Benegas. Comité de Bibliotecas Gubernamentales de la IFLA

Planeta Biblioteca 2026/09/30

ESCUCHAR

Descargar

En esta edición de Planeta Biblioteca de Radio USAL, conversamos con Paola Banegas, representante del Comité de Bibliotecas Gubernamentales de la IFLA (GOVLIB). Durante la entrevista, Banegas aborda el papel clave de las bibliotecas gubernamentales en la preservación del patrimonio documental y la gestión de la información pública. Asimismo, analiza los principales desafíos e iniciativas que impulsa este comité internacional para fomentar el intercambio de buenas prácticas entre instituciones de todo el mundo. La charla ofrece una visión global sobre cómo la cooperación profesional fortalece el acceso a la información oficial y la transparencia institucional. Un encuentro imprescindible para comprender la relevancia estratégica de estos centros en la sociedad actual.

Centro de Documentación, Cultura y Patrimonio del Agua de Mendoza (Argentina) con Sergio Terrera. Planeta Biblioteca 2026/09/30

Centro de Documentación, Cultura y Patrimonio del Agua de Mendoza (Argentina) con Sergio Terrera. Planeta Biblioteca 2026/09/30

ESCUCHAR

Descargar

La entrevista a Sergio Terrera nos acerca al importante papel que desempeñan las bibliotecas especializadas en la conservación y difusión del conocimiento. Desde la Biblioteca del Agua de Mendoza, su trabajo está vinculado a la recuperación de documentos y testimonios que ayudan a comprender la historia y la gestión de un recurso tan esencial como el agua. Su experiencia pone de relieve el valor de organizar y preservar la memoria documental para que pueda ser consultada por investigadores y ciudadanos. También nos recuerda que las bibliotecas no son solo lugares donde se guardan libros, sino espacios vivos que conectan el pasado con el presente. Una labor discreta, pero fundamental para proteger el patrimonio y facilitar el acceso a la información.

Sergio Terrera

Instagram

archivohistoricodelaguamza@gmail.com

archivohistoricodelaguam

Bibliotecas, Libros e Inteligencia Artificial

RADIO UDELAR DE MONTEVIDEO. ENTREVISTA CON Julio Alonso Arevalo SOBRE INTELIGENCIA ARTIFICIAL

Escuchar

Recibimos a Julio Alonso Arévalo, jefe de la Biblioteca de la Facultad de Traducción y Documentación de la Universidad de Salamanca para conversar sobre Bibliotecas, Libros e Inteligencia Artificial