Archivo de la etiqueta: Investigación

Principios de transparencia y buenas prácticas en la publicación científica: criterios para garantizar la calidad y la integridad editorial

Committee on Publication Ethics (COPE), Directory of Open Access Journals (DOAJ), Open Access Scholarly Publishing Association (OASPA), & World Association of Medical Editors (WAME). (2022). Principles of Transparency and Best Practice in Scholarly Publishing (Version 4.0). https://doi.org/10.24318/cope.2019.1.12

Los Principios de transparencia y buenas prácticas en la publicación científica establecen criterios internacionales para garantizar la calidad, la integridad y la credibilidad de las revistas académicas. Abordan aspectos como la evaluación por pares, la ética editorial, los conflictos de intereses, los derechos de autor, los costes de publicación y la transparencia financiera. Constituyen una herramienta esencial para investigadores, bibliotecarios y editores a la hora de identificar publicaciones fiables y prevenir prácticas editoriales engañosas.

Los Principios de transparencia y buenas prácticas en la publicación científica constituyen un marco internacional de referencia para promover la calidad editorial, la integridad académica y la confianza en las publicaciones científicas. Fueron elaborados conjuntamente por cuatro organizaciones de referencia: el Committee on Publication Ethics (COPE), el Directory of Open Access Journals (DOAJ), la Open Access Scholarly Publishing Association (OASPA) y la World Association of Medical Editors (WAME). Su finalidad es establecer criterios que permitan distinguir las revistas y editoriales académicas legítimas de aquellas que presentan prácticas poco transparentes o engañosas, incluidas las publicaciones depredadoras.

El documento reúne 16 principios organizados en torno a la transparencia de las publicaciones, las prácticas editoriales y los modelos de negocio. Entre ellos se encuentran la identificación inequívoca de la revista, la calidad y seguridad de su sitio web, la periodicidad de publicación, la conservación digital de los contenidos y la información clara sobre derechos de autor y licencias. También exige que las revistas expliquen sus objetivos, alcance temático, público destinatario, tipos de manuscritos aceptados y criterios de autoría, de manera que los investigadores puedan evaluar adecuadamente dónde presentar sus trabajos.

Principios de transparencia

1. Proceso de revisión por pares: Todo el contenido de una revista, salvo los materiales editoriales claramente identificados como tales, deberá someterse a revisión por pares. Esta consiste en obtener valoraciones sobre manuscritos individuales de especialistas en la materia que no formen parte del equipo editorial de la revista. El proceso y las políticas relacionadas con la revisión por pares deberán describirse claramente en el sitio web de la revista.

2. Órgano de gobierno: Las revistas deberán contar con consejos editoriales u otros órganos de gobierno cuyos miembros sean expertos reconocidos en las áreas temáticas que abarca la publicación. En el sitio web deberán figurar los nombres completos y las afiliaciones de sus editores.

3. Equipo editorial e información de contacto: Las revistas deberán proporcionar en su sitio web los nombres completos y las afiliaciones de sus editores, así como los datos de contacto de la oficina editorial.

4. Tarifas para los autores: Cualquier tarifa o cargo relacionado con la gestión de los manuscritos o la publicación de los materiales deberá indicarse claramente en un lugar fácilmente accesible para los posibles autores antes de que envíen sus trabajos a revisión. También podrá comunicarse a los autores antes de que comiencen a preparar sus manuscritos para su presentación.

5. Derechos de autor: La información sobre derechos de autor y licencias deberá describirse claramente en el sitio web de la revista. Las condiciones de las licencias deberán indicarse en todos los artículos publicados, tanto en formato HTML como en PDF.

6. Identificación y gestión de las denuncias de mala conducta en la investigación: Las editoriales y los editores deberán adoptar medidas razonables para identificar y evitar la publicación de trabajos en los que se hayan producido conductas indebidas en la investigación, como el plagio, la manipulación de citas o la falsificación y fabricación de datos, entre otras. En ningún caso una revista o sus editores deberán fomentar estas prácticas ni permitirlas deliberadamente. Si la editorial o los editores tienen conocimiento de una denuncia de mala conducta relacionada con un artículo publicado, deberán seguir las directrices del Committee on Publication Ethics (COPE) o las normas equivalentes para gestionar dicha denuncia.

7. Propiedad y gestión: La información sobre la propiedad y la gestión de la revista deberá indicarse claramente en su sitio web. Las editoriales no deberán utilizar nombres de organizaciones que puedan inducir a error a los posibles autores y editores sobre la naturaleza de la entidad propietaria de la revista.

8. Sitio web: El sitio web de la revista, incluidos los textos que contiene, deberá demostrar que se han adoptado las precauciones necesarias para garantizar unos estándares éticos y profesionales elevados.

9. Nombre de la revista: El nombre de la revista deberá ser único y no confundirse fácilmente con el de otra publicación. Tampoco deberá inducir a error a los posibles autores o lectores sobre su procedencia o su relación con otras revistas.

10. Conflictos de intereses: La revista deberá disponer de políticas claras para gestionar los posibles conflictos de intereses de editores, autores y revisores. Estas políticas deberán estar expresamente publicadas.

11. Acceso: Deberá especificarse cómo pueden acceder los lectores a la revista y a sus artículos individuales, así como si existen cuotas de suscripción o tarifas por la consulta de cada artículo.

12. Fuentes de ingresos: Los modelos de negocio o las fuentes de ingresos —por ejemplo, las tarifas a los autores, las suscripciones, la publicidad, las separatas, el apoyo institucional o la financiación de organizaciones— deberán indicarse claramente o resultar evidentes en el sitio web de la revista.

13. Publicidad: Cuando corresponda, las revistas deberán publicar su política publicitaria, especificando qué tipos de anuncios aceptan, quién decide su admisión y si los anuncios están vinculados al contenido o al comportamiento de los lectores —en el caso de la publicidad en línea— o si se muestran de manera aleatoria.

14. Periodicidad de publicación: La frecuencia con la que se publica la revista deberá indicarse claramente.

15. Archivo y preservación: La revista deberá indicar claramente su plan de copias de seguridad electrónicas y de preservación del acceso a sus contenidos en caso de que deje de publicarse. Entre los ejemplos de sistemas de preservación se encuentran CLOCKSS y PubMed Central.

16. Marketing directo: Todas las actividades de marketing directo realizadas en nombre de la revista, incluida la solicitud de manuscritos, deberán ser apropiadas, estar dirigidas a los destinatarios pertinentes y llevarse a cabo de manera discreta y no intrusiva.

Un aspecto esencial es la transparencia del proceso de evaluación por pares. Las revistas deben especificar si los contenidos se someten a revisión, qué modalidad utilizan, quiénes participan en la evaluación y cómo se toman las decisiones editoriales. Asimismo, deben publicar información sobre sus órganos de dirección, la identidad y afiliación de los responsables editoriales y los procedimientos para gestionar conflictos de intereses, reclamaciones, correcciones y retractaciones. Estas medidas contribuyen a reforzar la credibilidad de los resultados científicos y la responsabilidad de quienes participan en su publicación.

Los principios también prestan especial atención a la ética de la investigación y a la prevención de malas prácticas, como el plagio, la manipulación de citas y la fabricación o falsificación de datos. Las revistas y editoriales deben disponer de políticas públicas para abordar estas situaciones y actuar conforme a procedimientos reconocidos. Además, deben informar claramente sobre las tarifas que cobran a los autores, las posibles exenciones, sus fuentes de financiación, la publicidad y otras vías de ingresos, evitando que los intereses económicos condicionen las decisiones editoriales.

Por último, el documento incorpora criterios de inclusión, diversidad, equidad y accesibilidad. Las decisiones editoriales deben basarse en el mérito académico y no en la nacionalidad, el origen, las creencias políticas o la religión de los autores. En conjunto, estos principios constituyen una herramienta práctica para editores, investigadores, bibliotecarios y gestores de información científica, tanto para evaluar revistas como para mejorar las políticas editoriales y orientar a los investigadores en la selección de canales de publicación fiables.
El efecto cocodrilo: cómo afrontar la amenaza de las búsquedas sin clic (zero-click search) y los resúmenes generados por inteligencia artificial en la publicación científica

Charlie Rapple. (4 de febrero de 2026). “Responding to the Threat of Zero-Click Search and AI Summaries: How Do We Tame the Crocodile?”. The Scholarly Kitchen. https://scholarlykitchen.sspnet.org/2026/02/04/responding-to-the-threat-of-zero-click-search-and-ai-summaries-how-do-we-tame-the-crocodile/

La visibilidad de una publicación ya no garantiza que los usuarios accedan a ella. En la era de los resúmenes generados por IA, las editoriales y las instituciones científicas necesitan nuevas formas de medir el impacto, preservar la atribución y mantener la confianza en las fuentes originales. Este fenómeno obliga a reconsiderar cómo se evalúa el uso de los recursos electrónicos, cómo se enseña a verificar las fuentes citadas por sistemas de IA y cómo se mantiene el acceso a los documentos originales. Para las bibliotecas, resulta fundamental fomentar una alfabetización informacional que enseñe a distinguir entre una respuesta sintetizada y la consulta directa de la evidencia científica que la sustenta.

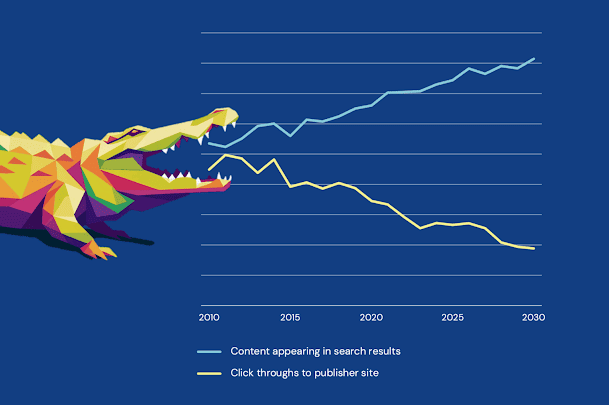
Se analiza una transformación que afecta directamente a la publicación científica: el crecimiento de las búsquedas sin clic (zero-click search), en las que los usuarios obtienen respuestas directamente en la página de resultados de un buscador, sin acceder al sitio web que contiene la información original. Esta tendencia se ha intensificado con los resúmenes generados mediante inteligencia artificial, los paneles de respuestas y los navegadores que sintetizan información procedente de múltiples fuentes. La autora denomina a este fenómeno Crocodile Effect o «efecto cocodrilo», una metáfora que describe la separación creciente entre las veces que un contenido aparece en los resultados de búsqueda y las visitas que recibe la página original. Aunque los contenidos continúan teniendo visibilidad, cada vez menos usuarios pueden llegar a consultarlos directamente.

El fenómeno supone un desafío económico para las editoriales académicas. Las visitas y las descargas se utilizan habitualmente para demostrar el valor de las publicaciones, justificar renovaciones de suscripciones y acreditar el interés de los lectores. Si los usuarios reciben respuestas resumidas sin visitar las páginas originales, disminuye el tráfico y puede debilitarse la capacidad de las editoriales para demostrar el impacto de sus contenidos. La autora menciona como ejemplo las declaraciones de John Campbell, de Oxford University Press, quien atribuyó a las búsquedas sin clic una reducción del 19 % en las visitas a sus contenidos de referencia académica. También recoge un estudio publicado en octubre de 2025 según el cual más de la mitad de las búsquedas en Google terminaban sin que el usuario abandonara la página de resultados. Estas cifras ilustran la magnitud potencial del cambio, aunque no deben interpretarse como una medida uniforme aplicable a todos los sitios o disciplinas.

Más allá de la cuestión económica, Rapple advierte de las consecuencias para la integridad científica y la transparencia informativa. Los resúmenes generados por IA pueden combinar publicaciones revisadas por pares con fuentes de calidad desigual, informaciones incorrectas o contenidos engañosos. Al reformular la información y eliminar parte de su contexto, estas respuestas pueden hacer que afirmaciones discutibles parezcan tan fiables como los resultados científicos contrastados. Además, las referencias a las fuentes originales pueden aparecer de manera poco visible o incompleta. En algunos casos, los sistemas pueden ofrecer citas imprecisas o inexistentes, dificultando que el lector compruebe la procedencia de una afirmación y evalúe la calidad de la evidencia. La autora considera que esta pérdida de contexto y atribución amenaza la confianza en la comunicación científica.

El artículo plantea que las editoriales corren el riesgo de convertirse en proveedores invisibles de contenidos para plataformas de inteligencia artificial. Sus publicaciones aportan información valiosa a los sistemas que generan respuestas, pero las organizaciones responsables de producirlas pueden perder el contacto directo con sus lectores y una parte de los beneficios económicos y reputacionales derivados de su utilización. Rapple compara esta relación con la de un organismo que alimenta a otro hasta poner en peligro su propia supervivencia: los sistemas de IA necesitan fuentes fiables, pero si el uso de esas fuentes reduce los incentivos para mantenerlas, se puede comprometer la sostenibilidad del ecosistema de conocimiento.

Para responder a este desafío, la autora propone varias líneas de actuación. Una consiste en desarrollar estándares para medir y comunicar el uso de contenidos que se produce fuera de las plataformas editoriales tradicionales. Otra pasa por revisar la manera en que autores e instituciones valoran las publicaciones, de modo que las métricas convencionales de visitas y descargas no sean los únicos indicadores de impacto. También plantea explorar modelos de licencias y remuneración para los contenidos derivados, así como establecer estándares que permitan a las herramientas de IA identificar, clasificar y atribuir correctamente las publicaciones revisadas por pares. Estas medidas requerirían colaboración entre editoriales, plataformas tecnológicas, bibliotecas y organizaciones de normalización, dado que ninguna institución puede resolver el problema de forma aislada.

Una estrategia adicional consiste en mejorar la optimización para motores de respuesta y sistemas generativos, conocida como Answer Engine Optimization (AEO) o Generative Engine Optimization (GEO). Se trata de adaptar los contenidos, sus metadatos y su estructura para facilitar que los sistemas de IA los localicen, interpreten y citen adecuadamente. Las editoriales pueden experimentar con resúmenes estructurados, información contextual más clara, metadatos de calidad y mecanismos que faciliten el acceso desde las respuestas automatizadas hasta las publicaciones completas. Sin embargo, la autora considera necesario investigar qué prácticas funcionan realmente y analizar el comportamiento de los usuarios: en qué circunstancias deciden consultar la fuente original, qué confianza depositan en las respuestas generadas y qué características favorecen una visita posterior al sitio editorial.

Rapple sostiene que el efecto cocodrilo no es únicamente un problema de posicionamiento web o de pérdida de tráfico, sino una transformación de la manera en que se descubre, distribuye y consume el conocimiento. La respuesta exige nuevas métricas, mecanismos de atribución más sólidos, modelos de relación con las plataformas de IA y estrategias de visibilidad adaptadas a los buscadores generativos. El objetivo debería ser construir una relación sostenible entre los productores de conocimiento y los sistemas que lo reutilizan, evitando que la facilidad de obtener respuestas termine debilitando las fuentes que las hacen posibles.

Guía para la elaboración de un trabajo académico: orientaciones para la planificación, redacción y presentación de un TFG

Durán Martínez, R., Gómez Gonçalves, A., & Elías Sánchez Sánchez, M. (Coords.). (2017). Guía didáctica para la elaboración de un trabajo académico. Universidad de Salamanca, Escuela Universitaria de Magisterio de Zamora. ISBN: 978-84-617-9681-6.

Texto completo

La obra constituye un recurso didáctico de utilidad para estudiantes universitarios que necesitan afrontar un TFG, un TFM u otro trabajo académico con rigor y autonomía. Su principal aportación consiste en presentar el proceso de elaboración de forma estructurada y accesible, desde la elección del tema y la búsqueda documental hasta la redacción, la citación, la evaluación y la defensa. Además de ofrecer pautas prácticas, fomenta competencias esenciales para la formación universitaria, como el pensamiento crítico, la gestión responsable de la información, la organización del trabajo y la comunicación científica. Aunque algunos recursos tecnológicos y ejemplos bibliográficos corresponden al contexto de 2017, los principios metodológicos que desarrolla siguen siendo útiles como orientación general, siempre que se complementen con la normativa y los requisitos vigentes de cada universidad.

La Guía didáctica para la elaboración de un trabajo académico es una publicación coordinada por Ramiro Durán Martínez, Alejandro Gómez Gonçalves y Miguel Elías Sánchez Sánchez, elaborada por un equipo de profesores de la Universidad de Salamanca y publicada en 2017. Su objetivo es orientar al alumnado universitario en la preparación de trabajos académicos, especialmente los trabajos de fin de grado (TFG) y de fin de máster (TFM). La obra surge de un proyecto de innovación docente desarrollado durante el curso 2015-2016 y pretende reunir, en un único documento, las principales pautas necesarias para planificar, investigar, redactar y presentar un trabajo universitario. Su principal característica es el empleo de mapas visuales e infografías que complementan las explicaciones escritas, facilitan la comprensión de los contenidos y permiten identificar rápidamente las distintas fases del proceso.

La guía comienza explicando los fundamentos generales del trabajo académico. Subraya que debe ser una investigación original, inédita y personal, realizada por el estudiante bajo la orientación de un tutor, cuya función es acompañar el proceso y ayudar a resolver dudas, sin sustituir la responsabilidad del autor. Antes de empezar, recomienda consultar la normativa de la universidad y del centro correspondiente, conocer los requisitos de extensión, estructura, presentación y entrega, y elegir un tema de interés que pueda abordarse de forma realista. Distingue tres modalidades principales de trabajo: la investigación, orientada a estudiar un problema mediante una metodología científica; la intervención profesional, destinada a diseñar propuestas para resolver problemas o mejorar prácticas; y la revisión bibliográfica, que exige analizar críticamente las publicaciones existentes y relacionarlas entre sí, en lugar de limitarse a resumirlas de manera aislada.

La planificación constituye otro de los aspectos fundamentales. La obra aconseja definir los objetivos, acordar con el tutor la estructura del documento, establecer un calendario de tareas y prever los recursos humanos, técnicos y documentales necesarios. En cuanto a la búsqueda de información, insiste en la importancia de utilizar palabras clave precisas, seleccionar fuentes académicas fiables y consultar bases de datos, catálogos bibliotecarios, revistas científicas y repositorios especializados. Entre los recursos mencionados se encuentran Google Académico, Scopus, Web of Science, Latindex, las bases de datos del CSIC y REBIUN, además de bases especializadas como ERIC, MEDLINE y PsycINFO. La guía también destaca la necesidad de valorar la autoría, la autoridad de las instituciones responsables, la actualidad de los contenidos, la calidad de las referencias y la evidencia que respalda las afirmaciones. Asimismo, recomienda registrar desde el principio las fuentes consultadas y utilizar gestores bibliográficos para organizar la documentación y elaborar las referencias finales.

El segundo capítulo aborda la estructura y el desarrollo del trabajo académico. La introducción debe presentar el tema, explicar su relevancia y justificar la aportación que se pretende realizar. Los objetivos han de formularse de manera clara, precisa y concisa, preferentemente mediante verbos en infinitivo, distinguiendo entre objetivos generales y específicos. El estado de la cuestión debe revisar los antecedentes, las principales aportaciones científicas, las limitaciones de los estudios previos y las lagunas de conocimiento que justifican el trabajo. La metodología, por su parte, explica cómo se pretende alcanzar los objetivos y puede adoptar un enfoque cuantitativo, cualitativo o mixto, según la naturaleza de la investigación. Cuando corresponda, debe detallar los participantes o la muestra, las variables, los instrumentos utilizados, el procedimiento de recogida de datos y las técnicas de análisis.

En relación con los resultados y las conclusiones, la guía propone presentar los hallazgos de forma ordenada y vinculada a los objetivos planteados. Los resultados pueden acompañarse de tablas, gráficos y otros recursos visuales cuando estos ayuden a comprender la información. No basta con exponer los datos: es necesario interpretarlos, relacionarlos con las investigaciones anteriores y discutir su significado. Las conclusiones deben sintetizar los resultados más relevantes, explicar las aportaciones del trabajo, valorar el grado de cumplimiento de los objetivos e identificar las limitaciones encontradas. También resulta conveniente señalar posibles líneas de investigación futuras y formular recomendaciones para la práctica profesional cuando proceda.

El tercer capítulo se centra en la redacción y presentación formal. La guía considera esenciales el índice, el resumen y las palabras clave, elementos que ayudan a organizar el documento y facilitan su recuperación por parte de otros lectores. Recomienda elaborar el resumen definitivo una vez terminado el trabajo, incluyendo los objetivos, la metodología y los resultados principales, así como seleccionar entre cuatro y ocho palabras clave representativas del tema. Las tablas, figuras y anexos deben incorporarse únicamente cuando aporten información útil, estar numerados y titulados, indicar su procedencia y aparecer referenciados en el texto. La obra presta especial atención a las citas y referencias bibliográficas como mecanismos de reconocimiento de la autoría y prevención del plagio. Diferencia entre citas textuales e indirectas, recomienda expresar las ideas ajenas con palabras propias cuando no se trate de una transcripción literal y presenta el sistema Harvard como una opción de citación. Asimismo, explica que las referencias finales deben permitir identificar las fuentes utilizadas y organizarse alfabéticamente por autor.

La publicación ofrece orientaciones para cuidar el estilo académico, cumplir los requisitos formales de entrega y preparar la defensa oral. La exposición debe ser clara, ordenada y ajustada al tiempo disponible, con una presentación visual sencilla que destaque los objetivos, los contenidos más relevantes y las conclusiones, evitando diapositivas excesivamente cargadas de texto. Se aconseja ensayar previamente, emplear un lenguaje natural y riguroso, mantener el contacto visual con el tribunal y responder a las preguntas con serenidad y argumentos fundamentados. La guía se completa con un apartado de recursos adicionales y un mapa visual que sintetiza las principales fases del proceso.

Repensar la evaluación científica: adecuar el rigor al propósito de la investigación

Ghildiyal, Ashutosh, Mathïs Fédérico y Maria Machado. (2026, 17 de septiembre). “Rethinking Scholarly Evaluation: Matching Rigor to Purpose”. The Scholarly Kitchen. Society for Scholarly Publishing. Enlace al artículo: https://scholarlykitchen.sspnet.org/2026/09/17/rethinking-scholarly-evaluation-matching-rigor-to-purpose/

Se plantea la necesidad de adaptar los criterios de evaluación científica a la naturaleza y los objetivos de cada investigación. Los autores distinguen entre trabajos orientados a validar resultados mediante evidencias empíricas y aquellos que buscan explorar nuevas ideas, formular hipótesis o desarrollar marcos conceptuales. Aunque ambos requieren rigor, no deben evaluarse necesariamente con los mismos criterios.

El texto advierte que una aplicación demasiado uniforme de la revisión por pares puede dificultar el reconocimiento de propuestas innovadoras que cuestionan conocimientos establecidos. Por ello, propone que las revistas científicas definan criterios específicos según el tipo de contribución, sin renunciar a la transparencia, la coherencia argumentativa y la calidad metodológica.

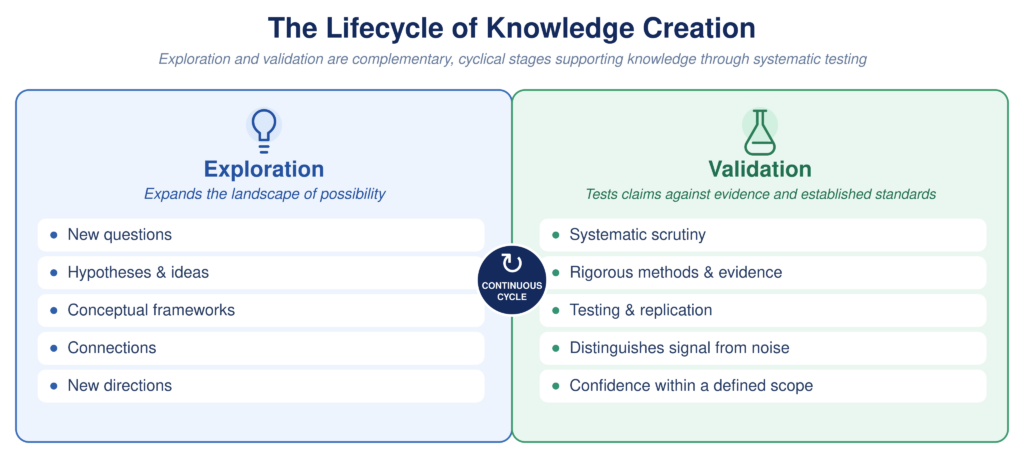
Para comprender esta limitación, el texto distingue dos actividades complementarias: la exploración y la validación. La exploración permite formular nuevas preguntas, desarrollar hipótesis, construir marcos conceptuales y establecer relaciones novedosas entre ideas. La validación, por su parte, somete las afirmaciones a una comprobación sistemática mediante evidencias, métodos adecuados y, cuando corresponde, procedimientos de reproducción de resultados. Ambas actividades son imprescindibles para el progreso científico, pero no persiguen exactamente los mismos objetivos. Por ello, los autores defienden que la evaluación académica debe adaptarse a la naturaleza de cada contribución, sin renunciar a la exigencia de rigor que caracteriza a la investigación científica.

Asimismo, destaca que la inteligencia artificial generativa obliga a prestar mayor atención al valor intelectual de los trabajos, ya que una redacción correcta no garantiza originalidad ni solidez científica. En conclusión, los autores defienden una evaluación más flexible y adaptada a cada investigación, capaz de mantener el rigor académico y, al mismo tiempo, favorecer la innovación y el avance del conocimiento.

TRACE: una iniciativa para mejorar la interoperabilidad y la confianza en la inteligencia artificial aplicada a la comunicación científica

Carpenter, Todd A. (2026, 7 de octubre). “TRACE Project Launches to Advance AI Interoperability”. The Scholarly Kitchen. Society for Scholarly Publishing. Enlace al artículo original: https://scholarlykitchen.sspnet.org/2026/10/07/trace-project-launches-to-advance-ai-interoperability/

TRACE representa un paso hacia una infraestructura científica preparada para la inteligencia artificial. Su éxito dependerá de que los estándares desarrollados sean interoperables, suficientemente flexibles para funcionar con diferentes arquitecturas tecnológicas y adoptados por los principales actores del ecosistema. Aunque la iniciativa no pretende resolver por sí sola todos los problemas relacionados con los derechos de autor, el control de acceso o la atribución dentro de los modelos de IA, sí busca establecer una base común para que la recuperación y reutilización de información científica sean más transparentes, medibles y fiables.

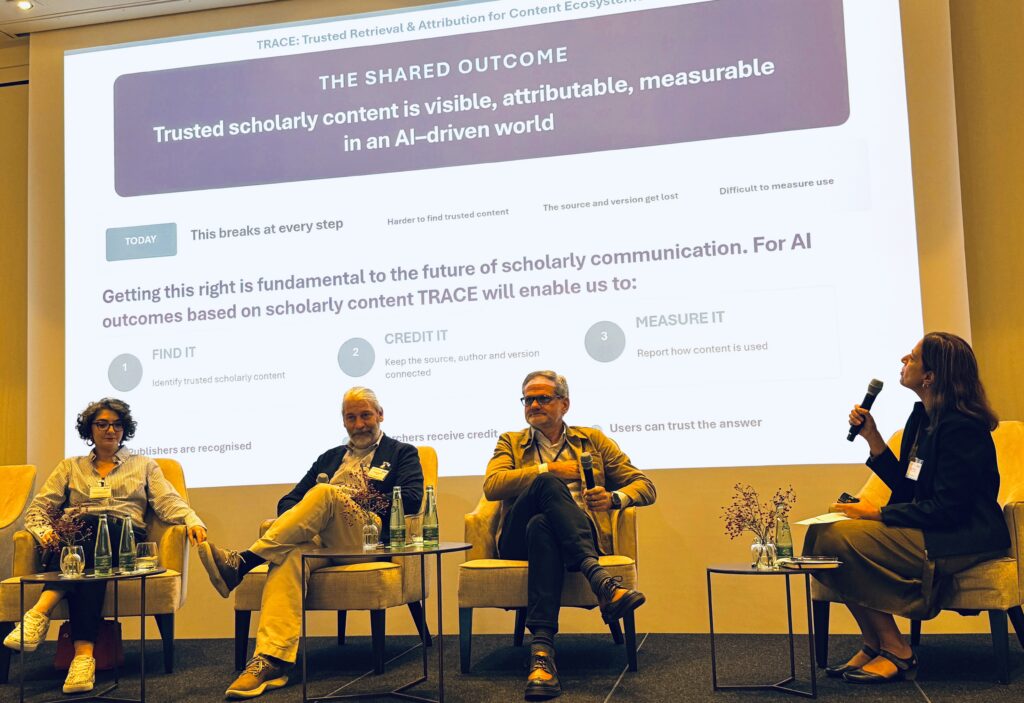
TRACE (Trusted Retrieval & Attribution for Content Ecosystems), una iniciativa internacional impulsada por diferentes organizaciones del ámbito de la comunicación científica para mejorar la interoperabilidad, la transparencia y la fiabilidad de los sistemas de inteligencia artificial que utilizan publicaciones académicas. Su objetivo es desarrollar una infraestructura técnica compartida que permita identificar las fuentes utilizadas por la IA, preservar la atribución de los contenidos y medir de forma coherente cómo los sistemas automatizados acceden a la información científica y la reutilizan. La iniciativa responde a una transformación profunda de la comunicación académica: los investigadores recurren cada vez más a asistentes inteligentes capaces de recuperar, resumir, comparar y sintetizar documentos, sin necesidad de consultar directamente las publicaciones originales.

TRACE comienza con tres líneas de trabajo complementarias. La primera, vinculada a COUNTER, busca mejorar las métricas de uso de los contenidos científicos en entornos de inteligencia artificial, incluyendo las consultas y recuperaciones realizadas por agentes automatizados. La segunda, coordinada por NISO (National Information Standards Organization), se centra en desarrollar un modelo mínimo de metadatos que permita conservar la procedencia de los documentos y fragmentos utilizados por los sistemas de IA. La tercera, impulsada por STM e Ithaka S+R, estudia cómo los agentes de inteligencia artificial descubren las publicaciones científicas, acceden a ellas mediante los permisos correspondientes y registran su utilización de manera verificable.

Uno de los principales problemas que aborda la iniciativa es la dificultad de comprobar el origen de las afirmaciones generadas por la IA. Los modelos pueden producir referencias inexistentes, atribuir información a fuentes equivocadas o elaborar respuestas sin establecer una conexión verificable entre sus afirmaciones y los documentos originales. Para afrontar esta situación, TRACE pretende favorecer el desarrollo de estándares que mantengan vinculados los contenidos recuperados con sus fuentes, sus metadatos y las condiciones de utilización. No se trata únicamente de reducir errores, sino también de reforzar la integridad científica, facilitar la verificación de los resultados y garantizar el reconocimiento del trabajo de autores y editores.

El proyecto también plantea la necesidad de adaptar los sistemas tradicionales de evaluación y gestión de recursos electrónicos a un escenario en el que parte del consumo de información se produce a través de agentes automatizados. Las bibliotecas universitarias y los editores necesitan conocer cómo se utilizan sus colecciones, qué contenidos recuperan los asistentes inteligentes y qué repercusiones tiene este uso en los modelos de suscripción, acceso abierto y financiación de la comunicación científica. Para ello, TRACE promueve una mayor coordinación entre editoriales, repositorios, proveedores tecnológicos, desarrolladores de IA y organizaciones responsables de los estándares de información.

OpenAlex incorpora listas de revistas científicas de confianza para mejorar la evaluación y la búsqueda de publicaciones académicas

Jason. (2026, 15 de octubre). Trusted journal lists come to OpenAlex. OpenAlex Blog. https://blog.openalex.org/trusted-journal-lists-come-to-openalex/

El proyecto OpenAlex anuncia la incorporación de listas de revistas científicas reconocidas por distintas instituciones y organismos especializados, con el propósito de facilitar la identificación y selección de publicaciones académicas fiables. La iniciativa responde a un contexto en el que la integridad de la comunicación científica se enfrenta a problemas crecientes, como las fábricas de artículos (paper mills), las revistas secuestradas, los anillos de citas y la proliferación de manuscritos generados mediante inteligencia artificial. En este escenario, investigadores, bibliotecarios, evaluadores y universidades necesitan herramientas que les permitan identificar las revistas incluidas en repertorios de confianza y aplicar criterios de selección más transparentes a sus búsquedas bibliográficas.

La propuesta de OpenAlex se distancia de las tradicionales listas negras de revistas depredadoras, como la conocida lista de Beall, y apuesta por un modelo basado en listas positivas o listas de inclusión (whitelists o allow lists). En lugar de excluir publicaciones consideradas problemáticas mediante un listado único, permite seleccionar aquellas que figuran en repertorios mantenidos por instituciones especializadas. Este enfoque pretende evitar algunos de los inconvenientes de las listas negras, como la falta de transparencia, su rápida obsolescencia y el riesgo de perjudicar injustamente a revistas pequeñas, emergentes, publicadas en idiomas distintos del inglés o procedentes de países del Sur Global. La idea central es que cada comunidad académica pueda elegir los criterios y las fuentes más adecuados para sus necesidades, sin delegar toda la decisión en un único índice comercial o sistema de clasificación.

Uno de los principales avances de esta iniciativa es su amplitud y diversidad. Según la publicación, OpenAlex ha pasado de las 22 listas iniciales a 61 repertorios de revistas. Entre ellos se encuentran DOAJ, para revistas de acceso abierto; MEDLINE, en ciencias de la salud; ERIH PLUS, en humanidades y ciencias sociales; y los repertorios nacionales de evaluación de Noruega y Finlandia. También se incluyen Latindex, SciELO, Publindex de Colombia, el Núcleo Básico de Argentina y el sello de calidad de la FECYT en España. La presencia de estos recursos permite adaptar las búsquedas a las características de cada disciplina, país o sistema de evaluación.

Desde el punto de vista técnico, OpenAlex incorpora el campo listed_in, que identifica las listas externas en las que figura cada revista. Este dato puede utilizarse tanto desde la interfaz web como mediante la API para filtrar publicaciones, recuperar trabajos publicados en revistas incluidas en determinados repertorios o analizar la distribución de documentos según las listas de referencia. Por ejemplo, un investigador puede limitar una búsqueda a revistas incluidas en DOAJ, mientras que una revisión sistemática en ciencias de la salud puede utilizar MEDLINE. La plataforma también contempla clasificaciones por niveles, como las de Noruega, Finlandia o el sistema JPPS, lo que permite realizar análisis más matizados que una simple distinción entre revistas aceptadas y excluidas.

La iniciativa tiene especial relevancia para las revistas del Sur Global, muchas de las cuales han quedado históricamente al margen de los grandes índices internacionales. La integración de repertorios como Latindex, SciELO y los criterios de evaluación de revistas africanas y de otras regiones contribuye a que estas publicaciones sean más visibles y puedan analizarse en condiciones más equitativas. Además, OpenAlex aclara que incorporar una revista a una lista no equivale a certificar directamente su calidad: la plataforma registra la pertenencia al repertorio y remite a la entidad responsable, que conserva la autoridad sobre sus criterios y evaluaciones.

Esta propuesta constituye un recurso de interés para bibliotecarios, investigadores y responsables de evaluación científica, ya que facilita la selección de fuentes y aporta nuevas posibilidades para estudiar la calidad y la diversidad de la comunicación académica. Para las bibliotecas universitarias, puede resultar especialmente útil en la formación de investigadores, el asesoramiento sobre dónde publicar y el diseño de estrategias de búsqueda bibliográfica. No obstante, figurar en una lista de confianza no debe interpretarse como una garantía absoluta de calidad ni como un sustituto de la evaluación crítica de cada revista y artículo. La principal aportación de OpenAlex es hacer más accesibles y combinables los criterios de distintos repertorios, favoreciendo decisiones documentadas y adaptadas a cada contexto.

Compilatio: software antiplagio y detección de Inteligencia Artificial con Pilar Torres. Planeta Biblioteca 2026/10/01

Compilatio: software antiplagio y detección de Inteligencia Artificial con Pilar Torres.

Planeta Biblioteca 2026/10/01

ESCUCHAR

Descargar

En esta entrevista, Pilar Torres (ITMS Group) presenta Compilatio (Magister+), un software web diseñado para analizar la similitud de textos y detectar contenidos generados por inteligencia artificial. Con una fiabilidad del 70% al 90%, el sistema identifica frases típicas, faltas de cohesión y referencias bibliográficas falsas. Más allá de un enfoque punitivo, la herramienta busca ser un aliado pedagógico que apoya la curaduría del docente y fomenta la integridad académica en el alumnado. Se integra fácilmente en entornos como Moodle o Canvas y destaca por ser una alternativa eficaz y sustancialmente más económica frente a opciones como Turnitin.

Una empresa llamada Springer, que no es la editorial, está ofreciendo la autoría a la venta.

Chawla, Dalmeet Singh. (2026, 12 de octubre). A company named Springer that isn’t the publisher is offering authorship for sale. Retraction Watch. Enlace al artículo original: https://retractionwatch.com/2026/10/12/springer-journals-online-authorship-for-sale/

Una empresa llamada Springer Journals Online que ofrece puestos de coautoría en artículos científicos a cambio de dinero, utilizando una denominación que puede confundirse con la editorial Springer Nature. El caso evidencia el crecimiento de las fábricas de artículos científicos (paper mills), una amenaza para la integridad académica que distorsiona la evaluación investigadora y pone en riesgo la fiabilidad de las publicaciones científicas.

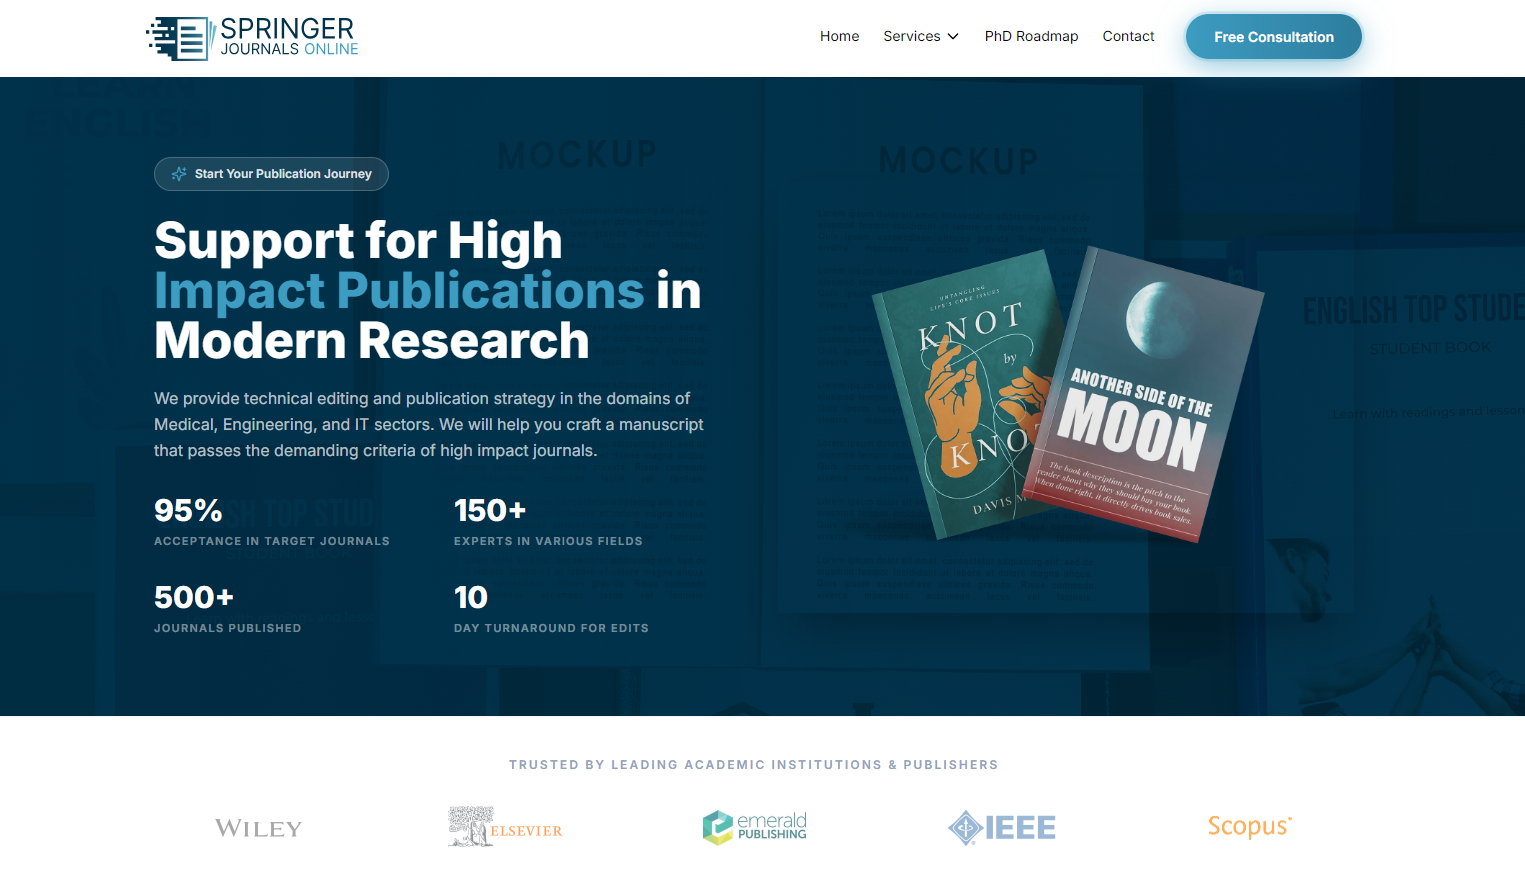
La comercialización de autoría en artículos destinados a revistas académicas de prestigio. El caso gira en torno a una empresa denominada Springer Journals Online, que ofrece a investigadores la posibilidad de incorporarse como coautores a manuscritos supuestamente próximos a su publicación en revistas internacionales. La organización solicita una contribución económica para cubrir parte de los costes de publicación y presenta oportunidades vinculadas a editoriales reconocidas, como Elsevier, Springer Nature, Taylor & Francis, Wiley y SAGE. La oferta resulta especialmente preocupante porque utiliza una denominación muy similar a la de Springer Nature, una editorial científica consolidada, lo que puede inducir a confusión y transmitir una apariencia de legitimidad. Sin embargo, según la investigación periodística, esta empresa no tiene relación con Springer Nature ni con la actividad editorial legítima que desarrolla esta compañía.

La investigación comienza cuando Richard Fateman, profesor emérito de informática de la Universidad de California en Berkeley, recibe un correo electrónico inesperado en el que se le propone participar como coautor en publicaciones científicas a cambio de asumir una parte de los costes. Fateman considera que la propuesta puede constituir una estafa y, además, plantea un problema ético fundamental: aceptar la inclusión de su nombre en un trabajo en cuya elaboración no ha participado. El mensaje comercial ofrece diferentes manuscritos, plazos estimados de publicación, revistas de destino y posiciones disponibles en la lista de autores. Aunque la empresa responde posteriormente que los participantes deberían intervenir en la investigación, revisar el manuscrito y aportar comentarios sustanciales desde su especialidad, la forma inicial de presentar la oferta suscita serias dudas sobre la naturaleza real de estas colaboraciones y sobre la posibilidad de comprar reconocimiento académico.

Uno de los aspectos más llamativos es la utilización de elementos que parecen diseñados para generar confianza. La página web de Springer Journals Online anuncia una tasa de aceptación del 95 % en las revistas objetivo y afirma haber publicado más de 500 revistas. Sin embargo, la investigación identifica varias señales de alerta: la dirección que figura en la web corresponde a una calle que no existe, el teléfono publicado utiliza un prefijo del Reino Unido y el perfil de Instagram de la organización está vinculado a Pakistán. Además, uno de los testimonios comerciales aparece atribuido a «Dr. Aris Thorne», un nombre ficticio conocido por su frecuente aparición en contenidos generados mediante modelos de lenguaje. Retraction Watch intentó obtener explicaciones de la empresa por correo electrónico y teléfono, sin conseguir una respuesta satisfactoria. Por su parte, un portavoz de Springer Nature confirmó que su centro de operaciones contra la piratería y los problemas de seguridad ya conocía la existencia de esta organización y estaba trabajando con las autoridades competentes.
El caso se inscribe en un fenómeno más amplio conocido como paper mills, o fábricas de artículos científicos: redes comerciales que producen, distribuyen o manipulan manuscritos académicos y ofrecen servicios que pueden incluir la venta de puestos de autoría. Estas prácticas convierten la publicación científica en una mercancía y permiten que algunas personas obtengan méritos curriculares sin haber contribuido de manera real a la investigación. El artículo recuerda que un estudio de 2024 estimó que estas fábricas podrían representar alrededor del 2 % de los envíos de manuscritos a revistas científicas en distintas disciplinas. También establece paralelismos con otros casos en los que organizaciones han creado páginas que imitan revistas legítimas o han comercializado posiciones de autoría vinculadas a publicaciones de editoriales reconocidas.

Las consecuencias van mucho más allá del incumplimiento de las normas de publicación. La autoría científica implica responsabilidad sobre la metodología, los datos, los resultados y las conclusiones de un trabajo. Cuando se incorporan autores que no han contribuido de forma significativa, se dificulta la identificación de quienes deben responder por los posibles errores o irregularidades. Además, estas prácticas distorsionan la evaluación de la actividad investigadora, perjudican a quienes desarrollan su trabajo de manera rigurosa y pueden facilitar que resultados poco fiables entren en la literatura científica y sean utilizados posteriormente por otros investigadores. La advertencia de Fateman es especialmente relevante: cuando una publicación acumula autores sin una contribución claramente identificable, la responsabilidad individual puede diluirse y aumentar el riesgo de que los errores pasen inadvertidos.

El uso de la IA en la comunicación científica: transparencia, detectores y nuevos sesgos

David Crotty, “AI Use in The Scholarly Kitchen”, The Scholarly Kitchen, 27 de agosto de 2026. Publicado por la Society for Scholarly Publishing (SSP). Artículo original en The Scholarly Kitchen

El artículo parte de una experiencia concreta de The Scholarly Kitchen para analizar uno de los debates más controvertidos de la comunicación científica actual: cómo utilizar la inteligencia artificial en la escritura y edición sin convertir su uso en un problema de confianza, autoría o integridad editorial. El autor explica que el blog ha recibido un número creciente de mensajes de lectores que sospechan que determinados textos han sido escritos por IA, muchas veces basándose exclusivamente en la apariencia del estilo o en el resultado de herramientas automáticas de detección.

Una de las cuestiones centrales del artículo es la limitación de los detectores de IA. Crotty señala que herramientas como Pangram o GPTZero han mejorado su precisión, pero todavía presentan importantes limitaciones. Sobre todo, no distinguen adecuadamente entre un texto completamente generado por IA y un texto escrito por una persona que posteriormente ha sido traducido, corregido, revisado o mejorado mediante IA. Desde el punto de vista editorial, son situaciones muy diferentes, pero un detector puede clasificarlas de manera similar. Por ello, la detección de participación de IA no permite determinar automáticamente cómo se utilizó la herramienta ni si ese uso fue éticamente aceptable.

El problema se agrava con los falsos positivos. El autor relata que algunos textos de The Scholarly Kitchen acusados de haber sido generados íntegramente por IA habían sido realmente escritos, editados y ampliados por miembros del equipo editorial. Incluso menciona el caso de un informe humano que, al pasar por Pangram, fue clasificado como un 9 % generado por IA, pero el sistema identificó incorrectamente qué fragmentos procedían de la IA y cuáles habían sido escritos por una persona. Esto muestra que un porcentaje obtenido mediante un detector no debería interpretarse como una prueba concluyente de autoría artificial.

La política de The Scholarly Kitchen

La IA no puede aparecer como autora de un artículo, y las imágenes generadas por IA no se admiten salvo que exista una razón específica relacionada con el contenido del artículo. Sin embargo, sí se permite utilizar herramientas de IA para redacción y edición, tanto por parte de los autores como de editores y revisores, siempre que exista transparencia y se documente su utilización. Crotty señala que inicialmente la publicación confiaba en la responsabilidad individual de los autores, pero recientemente ha decidido adoptar una posición más activa para exigir la declaración del uso de IA.

Esta postura plantea una cuestión interesante para las publicaciones académicas: prohibir completamente la IA puede ser menos eficaz que establecer reglas claras de utilización y declaración. Crotty considera que, en un espacio editorial de opinión y análisis como The Scholarly Kitchen, existe margen para experimentar y aprender. Su planteamiento es que la transparencia puede resultar más útil que una prohibición absoluta, especialmente mientras las comunidades académicas y editoriales siguen intentando determinar qué usos son aceptables en diferentes contextos.

El riesgo de crear un nuevo sesgo

Uno de los argumentos más interesantes del artículo es que la reacción contra la IA puede generar un nuevo tipo de sesgo editorial y académico. Crotty observa que algunos lectores utilizan la sospecha de utilización de IA como una forma de descalificar contenidos con los que no están de acuerdo. En lugar de analizar los argumentos, las evidencias o la calidad de la investigación, basta con afirmar que el texto «parece escrito por IA» para cuestionarlo.

Esto tiene especial importancia en la comunicación científica. Tradicionalmente, los textos de investigadores que escriben en una lengua que no es la suya pueden recibir una valoración negativa debido a errores gramaticales o estilísticos, incluso cuando la investigación que contienen es sólida. Una de las posibles aportaciones de la IA es precisamente ayudar a superar esta barrera lingüística. Sin embargo, si la comunidad empieza a penalizar automáticamente cualquier texto que parezca haber sido mejorado mediante IA, podría sustituirse un sesgo lingüístico por un nuevo sesgo tecnológico.

“Escribir es pensar”

La parte más personal del artículo aparece cuando Crotty explica su propia relación con estas herramientas. Afirma que para él escribir constituye una forma de pensar: redactar le obliga a organizar las ideas, construir argumentos y comprender mejor aquello sobre lo que quiere escribir. Desde esta perspectiva, delegar la elaboración del texto en una IA supone también, en cierta medida, delegar una parte del proceso intelectual.

Crotty expresa además preocupación por la posibilidad de que los modelos de lenguaje conduzcan hacia una homogeneización de la escritura. Los modelos tienden a producir respuestas estadísticamente plausibles y, según su argumento, esto puede llevar a que los textos se parezcan cada vez más entre sí. La IA puede ayudar a una persona con dificultades de escritura a mejorar su expresión, pero también podría hacer que un escritor experimentado pierda parte de su estilo, originalidad o capacidad para producir ideas alejadas de los patrones habituales.

Una cuestión especialmente relevante para la ciencia

El artículo resulta particularmente interesante porque desplaza el debate desde la pregunta “¿ha utilizado IA este texto?” hacia otra mucho más útil: “¿para qué se utilizó la IA y qué responsabilidad conserva el autor?”. Esta distinción es fundamental en el ámbito académico. Utilizar IA para corregir gramática, traducir un párrafo, generar alternativas de redacción, resumir información o desarrollar una primera estructura no equivale necesariamente a delegar en ella la producción intelectual de una investigación.

Por ello, el texto apunta hacia un modelo basado en transparencia, responsabilidad humana y evaluación del contenido, en lugar de confiar exclusivamente en detectores automáticos. Un detector puede constituir una señal para investigar, pero no debería convertirse por sí mismo en una prueba de mala conducta académica. El propio artículo insiste en que incluso los mejores sistemas de detección no pueden determinar por sí solos qué uso de IA se produjo ni si ese uso resulta éticamente aceptable.

Relevancia para bibliotecas y alfabetización en IA

Para las bibliotecas universitarias y los servicios de apoyo a la investigación, el artículo ofrece una idea especialmente importante: la alfabetización en IA no debería reducirse a enseñar a detectar textos generados artificialmente. También debe enseñar a comprender los diferentes usos de estas herramientas, evaluar críticamente sus resultados, documentar cuándo y cómo se han utilizado y mantener la responsabilidad intelectual sobre el producto final.

En este sentido, el artículo puede relacionarse directamente con la integridad científica, la alfabetización informacional y la formación de investigadores. El objetivo no debería ser identificar mecánicamente si «hay IA» en un documento, sino ayudar a estudiantes, investigadores, autores, revisores y editores a establecer criterios razonables sobre autoría, contribución intelectual, transparencia, verificación de información y responsabilidad.

Inteligencia artificial para la investigación científica autónoma: implicaciones para las bibliotecas de investigación

Display reading “ARTIFICIAL RESEARCH INTELLIGENCE” and “AUTONOMOUSLY AI-GENERATED SCIENCE AND THE IMPLICATIONS FOR RESEARCH LIBRARIES,” surrounded by charts and researchers.
Researchers explore AI-generated science and digital tools in a vibrant library setting.

Ridley, Michael. “Artificial Research Intelligence: Autonomously AI-Generated Science and the Implications for Research Libraries.” Information Technology and Libraries 45, no. 3 (2026). DOI: 10.5860/ital.v45i3.17706

El artículo plantea un cambio de gran alcance: si la IA comienza a realizar de manera autónoma partes sustanciales del proceso científico, la biblioteca de investigación tendrá que evolucionar desde la gestión de colecciones hacia la gestión, preservación, evaluación y mediación de sistemas dinámicos de producción de conocimiento. La IA puede realizar gran parte del procesamiento y la exploración, pero el juicio científico, ético e intelectual sigue siendo una responsabilidad humana fundamental.

La aparición de lo que denomina Artificial Research Intelligence (ARI), o inteligencia artificial para la investigación, entendida como sistemas de IA capaces de realizar de manera prácticamente autónoma un proceso científico completo: desde la generación de una idea de investigación hasta la elaboración del manuscrito final. El concepto va más allá del uso convencional de la IA como herramienta auxiliar para buscar información, analizar datos o redactar textos, ya que plantea la utilización coordinada de múltiples modelos y agentes capaces de asumir diferentes etapas del método científico.

Una de las ideas centrales del artículo es que estos sistemas podrían representar una transformación profunda de la forma en que se produce conocimiento científico. Ridley señala que la combinación de modelos de IA agénticos, capacidad de computación y procedimientos propios del método científico podría configurar lo que algunos investigadores han denominado un posible “quinto paradigma de investigación científica”. En este modelo, la IA podría encargarse de tareas de cálculo, exploración de hipótesis, búsqueda de patrones, generación de propuestas y producción de resultados, mientras que las personas conservarían una función esencial relacionada con la interpretación, el juicio científico y la supervisión ética.

El autor, sin embargo, subraya que la investigación científica autónoma todavía presenta limitaciones importantes. Entre ellas aparecen las alucinaciones, la insuficiente especialización profunda en determinados dominios científicos y la tendencia de algunos sistemas a presentar conclusiones más contundentes de lo que permiten realmente las evidencias. Por ello, el hecho de que un sistema sea capaz de generar de forma autónoma un artículo o una hipótesis no significa necesariamente que haya producido conocimiento científico fiable. La automatización de las diferentes fases del proceso investigador introduce, por tanto, nuevos problemas relacionados con la reproducibilidad, la validación, la atribución de responsabilidad y la evaluación de la evidencia.

Otro concepto especialmente interesante es el de “captura epistémica” (epistemic capture). Ridley advierte de que, si las infraestructuras necesarias para desarrollar investigación científica autónoma quedan concentradas en grandes empresas privadas de inteligencia artificial, podría producirse un desplazamiento de parte de la producción de conocimiento desde las universidades y las instituciones públicas hacia las corporaciones tecnológicas que controlan los modelos, los datos y la capacidad de computación. El problema no sería solamente tecnológico o económico, sino también institucional: quién controla las infraestructuras de conocimiento puede acabar teniendo una influencia considerable sobre qué preguntas se investigan, qué resultados se producen y cómo circula el conocimiento científico.

En este contexto, el artículo plantea una redefinición del papel de las bibliotecas de investigación. Si tradicionalmente las bibliotecas universitarias han gestionado colecciones relativamente estáticas —libros, revistas, bases de datos, repositorios y otros recursos documentales—, la expansión de la investigación asistida o generada por IA exigiría avanzar hacia la gestión y custodia de sistemas dinámicos de conocimiento impulsados por inteligencia artificial. Esto supone pasar de administrar únicamente documentos y colecciones a participar también en los ecosistemas tecnológicos, datos, modelos, agentes y procesos mediante los cuales se genera nuevo conocimiento.

Ridley identifica varias áreas en las que las bibliotecas pueden asumir un papel activo. Una de ellas es la comunicación científica, donde los bibliotecarios podrían contribuir al desarrollo de nuevos procesos para documentar, preservar y hacer trazable la investigación producida con sistemas autónomos. También adquiere importancia la formación en competencias de inteligencia artificial para investigadores y profesionales de la información. El artículo plantea, además, la posibilidad de crear laboratorios de IA vinculados a las bibliotecas, desde los cuales experimentar con estas tecnologías y desarrollar investigaciones aplicadas sobre sus posibilidades y riesgos.

La propuesta implica, por tanto, una evolución de la biblioteca como intermediaria de información hacia una biblioteca como infraestructura de conocimiento. En lugar de limitarse a proporcionar acceso a la literatura científica existente, las bibliotecas podrían participar en las nuevas cadenas de producción, validación, preservación y comunicación del conocimiento. Esto conecta directamente con cuestiones que ya están transformando la comunicación científica: artículos generados parcialmente por IA, revisión por pares asistida por algoritmos, agentes capaces de realizar búsquedas y síntesis, generación automática de hipótesis y nuevas formas de publicación científica.