Archivo de la etiqueta: Noticias falsas

La mayoría no está especialmente preocupada por las noticias generadas por inteligencia artificial

Buchholz, K. (2026, 3 de septiembre). Concerned About AI-Generated News? Statista. Statista

Un estudio de Statista Consumer Insights realizado en 32 países analiza hasta qué punto los ciudadanos quieren saber si las noticias que consumen han sido generadas mediante inteligencia artificial. El resultado general es llamativo: la mayoría de los encuestados no manifiesta una preocupación especialmente elevada por el uso de IA en las noticias. Dependiendo del país, entre el 16 % y el 45 % afirma que le gustaría saber si las noticias que consume han sido generadas por IA.

Existen, sin embargo, importantes diferencias geográficas. La menor preocupación se registra en Argentina y Colombia, Corea del Sur y Japón, donde únicamente entre el 16 % y el 26 % de los encuestados quiere conocer si una noticia ha sido escrita por inteligencia artificial. Francia, Países Bajos, Bélgica y México presentan porcentajes situados entre el 26 % y el 29 %.

En el extremo contrario se encuentran algunos países asiáticos y latinoamericanos. Vietnam alcanza el 45 %, mientras que Malasia y Filipinas se sitúan entre el 41 % y el 42 %. Brasil también registra un 41 %. Estos datos muestran que la percepción social de la IA aplicada al periodismo está lejos de ser homogénea y que factores culturales y nacionales pueden influir considerablemente en el grado de preocupación.

El estudio analiza además otra cuestión relacionada: el temor a que las noticias de los medios tradicionales sean manipuladas. En este caso, la preocupación es mayor: dependiendo del país, entre el 24 % y el 51 % de los encuestados manifiesta inquietud ante la posibilidad de manipulación de las noticias por parte de los medios convencionales. Esto resulta interesante porque sugiere que la preocupación por la manipulación informativa puede ser mayor que la preocupación específica por la utilización de inteligencia artificial.

Otro dato relevante procede de una encuesta independiente del Reuters Institute, realizada en 45 países. Solo entre el 4 % y el 14 % de los encuestados afirma utilizar chatbots de IA para que le proporcionen noticias. Es decir, aunque la inteligencia artificial está penetrando rápidamente en la producción y distribución de información, todavía son relativamente pocos los ciudadanos que recurren directamente a los chatbots como fuente habitual de noticias.

Estos resultados contrastan con la cautela mostrada en otras investigaciones. El Reuters Institute Digital News Report 2025 encontró que solo el 12 % de los encuestados se sentía cómodo con noticias producidas completamente por IA, frente al 62 % cuando la producción era exclusivamente humana. La aceptación aumentaba hasta el 43 % cuando un periodista humano dirigía el proceso y utilizaba IA como herramienta de apoyo.

El estudio de Statista dibuja una situación paradójica: la IA está adquiriendo un papel cada vez mayor en la producción de información, pero una parte considerable del público todavía no considera prioritario saber si una noticia ha sido generada por una máquina. Al mismo tiempo, las investigaciones del Reuters Institute muestran que la confianza aumenta claramente cuando la IA permanece subordinada al trabajo humano. Esto plantea un desafío fundamental para los medios: no solo utilizar la IA de forma responsable, sino explicar con transparencia cuándo y cómo interviene en la elaboración de las noticias.

Cómo detectar imágenes generadas por inteligencia artificial

Izzo, J. (20 de julio de 2026). How to Spot AI Images: A Fact-Checker’s Guide. Snopes. https://www.snopes.com/articles/471427/spot-ai-images-guide/?utm_source=flipboard&utm_content=topic/culture

La proliferación de herramientas de inteligencia artificial generativa ha hecho que distinguir entre fotografías auténticas e imágenes sintéticas sea una tarea cada vez más compleja, incluso para periodistas especializados y verificadores profesionales.

En esta guía, Snopes explica los métodos que utiliza habitualmente para determinar si una imagen ha sido creada mediante IA y advierte de que las antiguas señales evidentes —como las manos con seis dedos o el texto ilegible— ya no son suficientes para identificar un montaje. Los modelos más recientes han mejorado notablemente su capacidad para generar imágenes fotorrealistas, por lo que la verificación exige combinar el análisis visual con herramientas técnicas y la comprobación del contexto.

Entre los indicios visuales que aún pueden resultar útiles destacan las anomalías en elementos complejos. Las manos, los dedos, las orejas, el cabello o las conexiones entre objetos siguen siendo puntos débiles de muchos modelos de IA. Snopes cita ejemplos recientes, como imágenes falsas de la supuesta boda de Taylor Swift y Travis Kelce, donde algunos personajes presentaban seis dedos, o una fotografía ficticia del senador Mitch McConnell hospitalizado, en la que los tubos médicos terminaban de forma incoherente o se conectaban de manera imposible. También recomienda examinar cuidadosamente reflejos, sombras, patrones repetitivos y la interacción entre distintos objetos de la escena.

Otro aspecto importante es el tratamiento del texto dentro de las imágenes. Aunque los generadores actuales producen rótulos y carteles mucho más convincentes que hace unos años, todavía suelen cometer pequeños errores gramaticales, puntuación inconsistente o mayúsculas inusuales. Estos detalles permitieron a Snopes desmontar, por ejemplo, una falsa carta de dimisión atribuida al entonces presidente de la Reserva Federal, Jerome Powell. Sin embargo, los autores insisten en que estos fallos son cada vez menos frecuentes y no deben considerarse una prueba definitiva de manipulación.

La guía concede especial importancia a las herramientas de verificación técnica. Recomienda utilizar buscadores inversos de imágenes, como Google Lens o TinEye, para comprobar el origen de una fotografía, así como revisar los metadatos cuando sea posible. Además, destaca la aparición de sistemas de procedencia digital como SynthID de Google o las Content Credentials (C2PA), que permiten identificar determinadas imágenes creadas por IA cuando conservan sus marcas de origen. No obstante, estas tecnologías no son infalibles: una imagen puede perder esa información si ha sido recortada, capturada mediante una captura de pantalla o editada posteriormente.

La principal conclusión de Snopes es que ya no basta con preguntarse si una imagen «parece real». La mejor estrategia consiste en verificar quién la publica, cuál es su contexto, si existen otras fuentes independientes que confirmen el hecho y qué evidencias respaldan su autenticidad. En la era de la inteligencia artificial generativa, el pensamiento crítico y la verificación de la procedencia resultan mucho más fiables que confiar únicamente en la percepción visual

Las referencias de la IA a libros falsos están frustrando a los bibliotecarios.

Librarian looking frustrated with computer displaying catalog error offline message
A librarian looks stressed as the library computer system shows an error message.

InsideHook. 2025. “Report: AI References to Fake Books Are Frustrating Librarians.InsideHook, September 22, 2025. https://www.insidehook.com/books/report-ai-references-fake-books-frustrating-librarians/?utm_source=flipboard&utm_content=topic/libraries

Un problema creciente en bibliotecas y servicios de referencia: la proliferación de títulos de libros y citas académicas inventadas por sistemas de inteligencia artificial, que los usuarios toman como reales.

Imagina a un lector ávido que un día hojea una vista previa de libros de verano en su periódico local. Entre los títulos listados aparece una novela de una de sus escritoras favoritas, Isabel Allende. Intrigado, este lector acude a su biblioteca local para comprobar si tienen alguna copia de la novela, titulada Sueños de la costa, en su catálogo. Aquí está el problema: Sueños de la costa en realidad no existe; formaba parte de un artículo generado por inteligencia artificial que incluía varios libros inexistentes de autores famosos como Allende , y que causó revuelo durante el verano.

Y aunque la famosa lista de libros del verano recibió mucha atención mediática, también hay casos en los que sistemas de IA han “alucinado” la existencia de otros libros nunca escritos. Y, como era de esperar, esto se ha convertido en un enorme dolor de cabeza para los bibliotecarios (y, presumiblemente, para los libreros) encargados de buscar libros que no existen. Una bibliotecaria citada en el artículo afirmó que llevaba recibiendo solicitudes de libros inexistentes desde hace tres años, pero que el problema se había agravado a principios de este año.

Estas “alucinaciones” de la IA generan situaciones en las que los bibliotecarios reciben solicitudes de obras que no existen, a menudo atribuidas a autores reales o incluidas en listas de lectura publicadas en medios de comunicación. El fenómeno se ha intensificado con el uso masivo de chatbots, que producen referencias con apariencia convincente pero sin base real verificable.

El texto explica que esta situación está generando una carga adicional de trabajo para los profesionales de bibliotecas, que deben dedicar tiempo a verificar la existencia de cada solicitud, algo que antes era mucho más sencillo porque las referencias solían ser auténticas. Ahora, los sistemas de IA pueden generar títulos plausibles, completos con autores, editoriales y citas falsas, lo que dificulta la detección inmediata del error. Esta dinámica está afectando especialmente a bibliotecas públicas y servicios de referencia académica, donde los usuarios confían cada vez más en respuestas automatizadas sin contrastarlas.

Esta no es la única forma en que la IA ha complicado la vida de los bibliotecarios. También está el hecho de que ciertos actores sin escrúpulos utilizan la IA para generar libros rápidamente con fines de lucro, aunque sin la parte “divertida”. El auge de los libros generados por IA ha planteado preguntas existenciales para escritores y editores; como era de esperar, también ha supuesto un dolor de cabeza para los bibliotecarios. El siglo XXI ha visto avances tecnológicos que han facilitado la vida de escritores y editores, pero algunas de esas mismas herramientas también pueden volver el mundo del libro más inquietante cuando son usadas por actores malintencionados.

Finalmente, el artículo sitúa este problema dentro de un contexto más amplio de impacto de la inteligencia artificial en el ecosistema del libro y la información. Además de las bibliotecas, también se ven afectados autores, editores y plataformas de venta, ya que proliferan libros generados por IA, duplicados o fraudulentos. El texto subraya la importancia de reforzar la alfabetización informacional y el pensamiento crítico, así como la necesidad de que las instituciones tecnológicas mejoren los sistemas de verificación para evitar la propagación de información ficticia que parece real.

Sesgo de confirmación y algoritmos

Computer screen showing information about confirmation bias and digital algorithms in Spanish, with a woman looking at it.
A woman studies a computer screen displaying information about confirmation bias and digital algorithms.

McKinney, Phil. 2026. How to Overcome Confirmation Bias.” The Innovator’s Studio / philmckinney.com. Publicado el 6 de mayo de 2026. https://www.philmckinney.com/how-to-overcome-confirmation-bias/

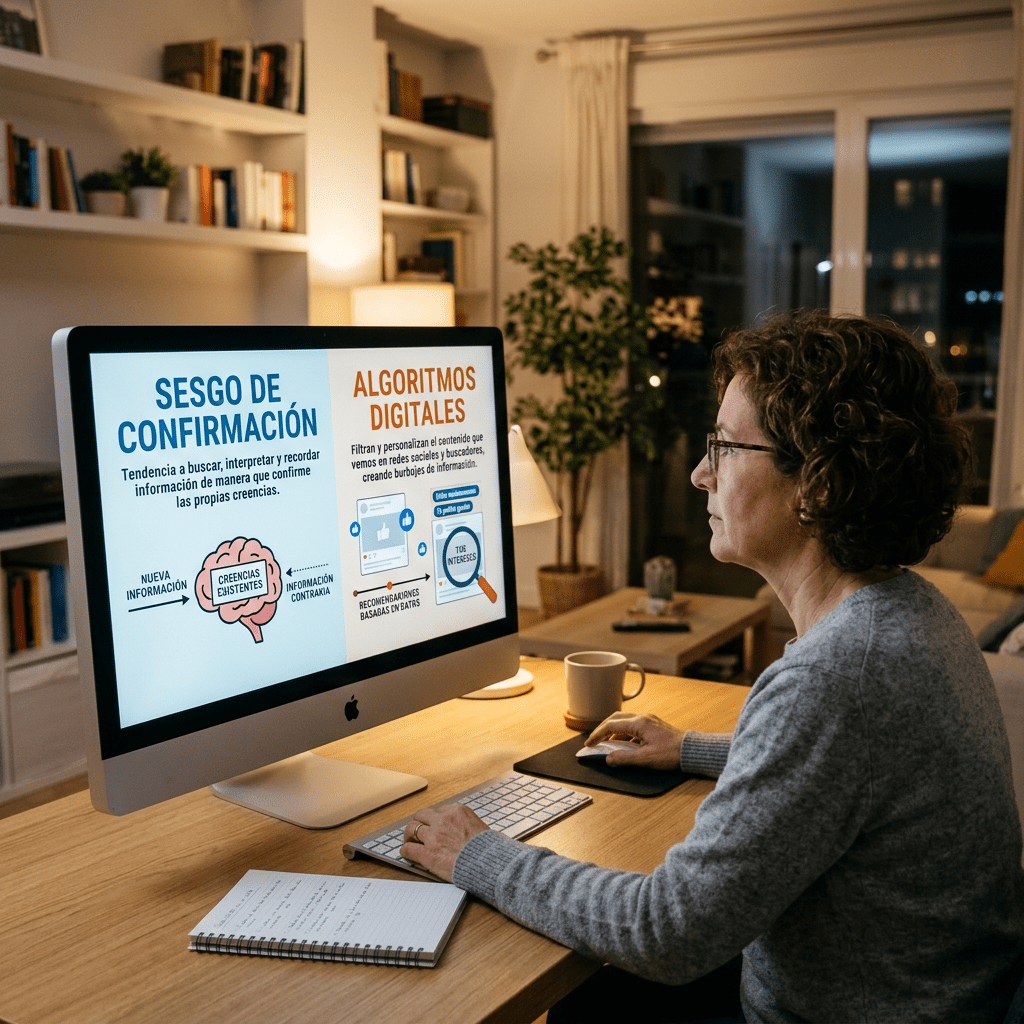
El artículo explica que el sesgo de confirmación lleva a las personas a aceptar fácilmente la información que refuerza sus creencias y a rechazar la que las contradice. Este efecto se amplifica en entornos digitales, donde los algoritmos refuerzan burbujas informativas. Como estrategia, propone cuestionar activamente las propias ideas y construir argumentos sólidos en contra de ellas para mejorar la toma de decisiones.

El sesgo de confirmación como uno de los mecanismos cognitivos más influyentes —y peligrosos— en la toma de decisiones contemporánea. Parte de una idea central: el sesgo de confirmación no es una excepción ocasional, sino un proceso constante del cerebro humano que opera de forma automática en la vida cotidiana, especialmente cuando nuestras creencias ya están formadas. Según el autor, cuanto más sólida es una convicción, más se intensifica el filtrado mental de la información, generando una percepción distorsionada de la realidad.

McKinney explica que este sesgo funciona a través de tres mecanismos principales. El primero es la evaluación desigual de la información, por el cual el cerebro analiza de manera crítica los datos que contradicen nuestras creencias, mientras acepta sin cuestionar aquellos que las confirman. El segundo es la memoria selectiva, que refuerza lo que coincide con nuestras ideas previas y debilita el recuerdo de evidencias contrarias. El tercero es el llamado efecto de retroalimentación defensiva, donde los intentos de refutación no corrigen la creencia, sino que la refuerzan, haciendo que la persona salga de la confrontación más convencida que antes.

El autor amplía el problema al contexto digital actual, subrayando que el entorno informativo contemporáneo amplifica este sesgo de forma sistemática. Algoritmos de redes sociales, motores de búsqueda y sistemas de recomendación tienden a priorizar contenido afín a las preferencias previas del usuario. Esto crea burbujas informativas que refuerzan continuamente las mismas ideas, debilitando la exposición a perspectivas alternativas. En este sentido, el sesgo de confirmación no es solo psicológico, sino también estructural y tecnológico.

A partir de este diagnóstico, McKinney introduce una estrategia práctica para “interrumpir” el sesgo en el momento en que se produce. Su propuesta central es un ejercicio deliberado de inversión cognitiva: antes de tomar una decisión importante, el individuo debe construir activamente el mejor argumento posible en contra de su propia posición. No se trata de resumir la alternativa, sino de defenderla con rigor intelectual. Este ejercicio permite identificar supuestos ocultos, lagunas de información y puntos débiles en el razonamiento propio.

El autor enfatiza que el objetivo no es eliminar el sesgo de confirmación —algo que considera imposible— sino reducir su influencia en decisiones críticas. La clave no es la neutralidad absoluta, sino el desarrollo de una “confianza examinada”: decisiones que no se basan únicamente en lo que confirma nuestras creencias, sino en la capacidad de haber sido desafiadas por evidencias contrarias.

McKinney destaca los beneficios acumulativos de este enfoque. Las decisiones que han sido sometidas a contraste sistemático tienden a ser más robustas y adaptativas. Además, las personas que practican este tipo de pensamiento crítico son menos vulnerables a la manipulación informativa y a la influencia de sistemas diseñados para reforzar creencias preexistentes. En conjunto, el artículo propone una forma de alfabetización cognitiva orientada a mejorar la calidad del juicio humano en entornos complejos y saturados de información.

El cansancio informativo dispara el rechazo al consumo de noticias en todo el mundo

Statista – Too Much Bad News? News Avoidance on the Rise

Noticia

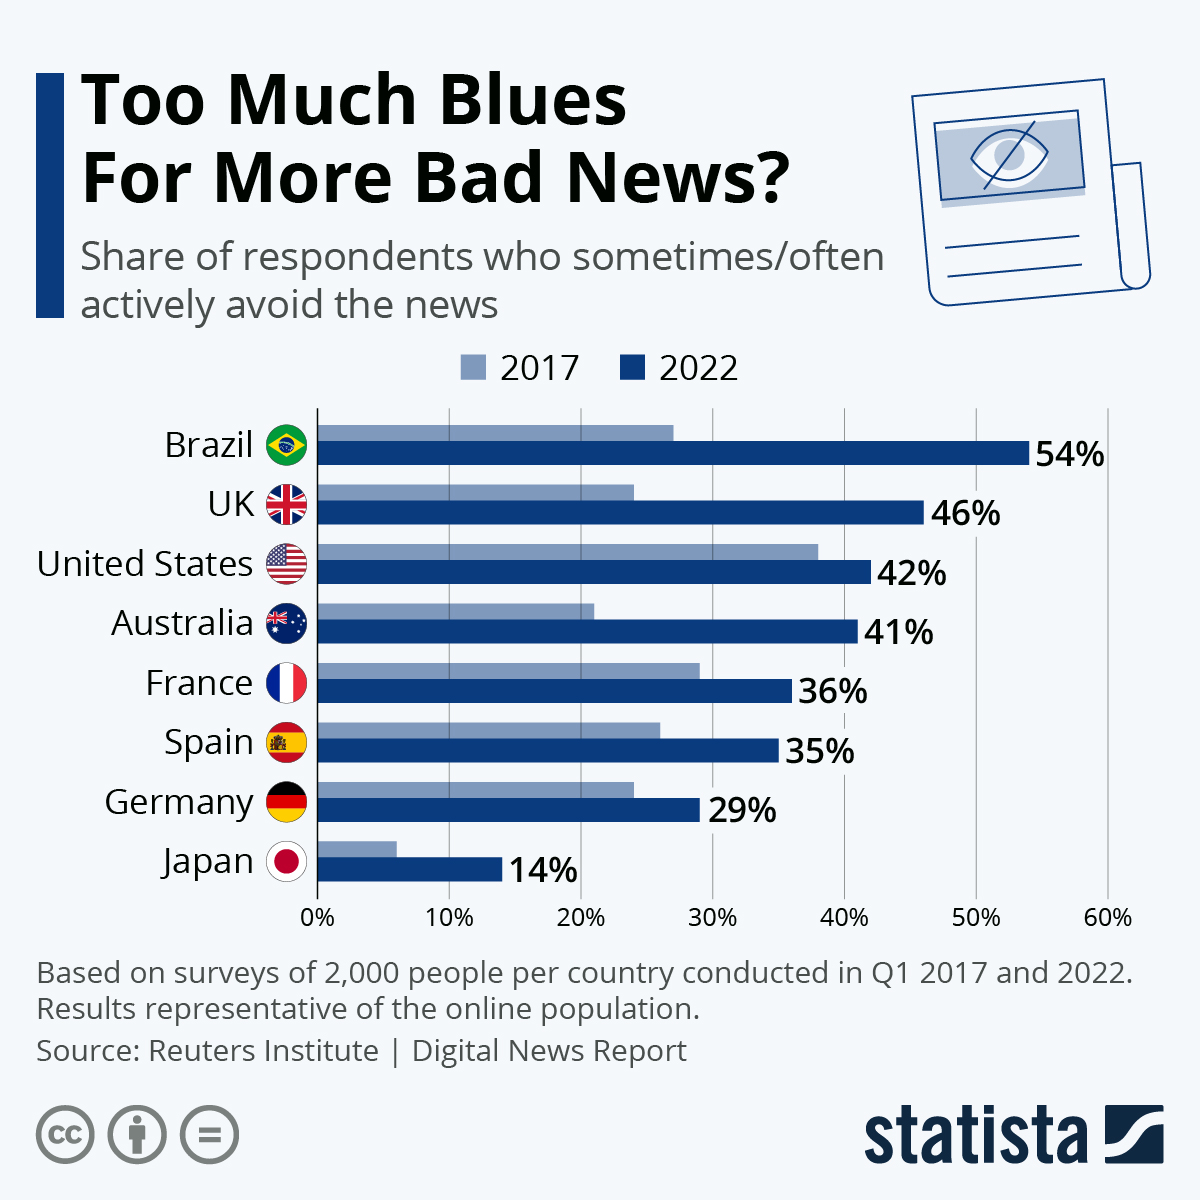
El gráfico publicado por Statista, basado en datos del informe anual del Reuters Institute for the Study of Journalism, pone de relieve una transformación significativa en la manera en que las personas se relacionan con la información periodística: cada vez más ciudadanos deciden evitar activamente las noticias.

Este fenómeno, denominado selective news avoidance o evasión selectiva de noticias, refleja una creciente saturación informativa asociada a un entorno mediático marcado por conflictos bélicos, crisis económicas, polarización política y una exposición constante a contenidos negativos en plataformas digitales. Según el estudio, el promedio global de personas que afirma evitar las noticias “a veces” o “con frecuencia” ha pasado del 29 % en 2017 al 40 % en 2025, lo que confirma una tendencia sostenida de alejamiento frente a la sobrecarga informativa.

Este aumento no se distribuye de manera homogénea entre países. Algunas sociedades presentan niveles particularmente elevados de evasión informativa. Turquía lidera la lista con un 61 %, seguida por el Reino Unido con un 46 %, mientras que Estados Unidos alcanza el 42 %. Otros países como Australia, Alemania, Francia y España muestran igualmente incrementos significativos. En el caso español, el porcentaje se sitúa en torno al 37 %, una cifra que evidencia que incluso sociedades con fuerte tradición de consumo informativo comienzan a mostrar signos de cansancio frente a un ecosistema mediático caracterizado por la hiperconectividad permanente. Japón representa una excepción relativa, con apenas un 11 %, aunque incluso allí el porcentaje ha crecido respecto a años anteriores.

Detrás de esta tendencia aparecen causas psicológicas y culturales cada vez más estudiadas. El informe identifica que una de las principales razones para evitar noticias es el impacto negativo sobre el estado de ánimo: aproximadamente 39 % de quienes evitan la información señalan que las noticias afectan negativamente su bienestar emocional. A esto se suma la sensación de agotamiento producida por la cobertura excesiva de guerras y conflictos internacionales, mencionada por cerca del 30 % de los encuestados. En un contexto dominado por el doomscrolling —el consumo compulsivo de noticias negativas en redes sociales— muchas personas desarrollan estrategias deliberadas para limitar su exposición informativa como mecanismo de autoprotección psicológica.

El estudio distingue además dos perfiles de evasores informativos. Por un lado están los “consistent avoiders”, personas que mantienen una distancia estructural respecto a la actualidad, generalmente asociada a bajos niveles de interés por la política o menor confianza en los medios tradicionales. Por otro lado aparecen los “selective avoiders”, usuarios que sí valoran estar informados, pero que filtran conscientemente ciertos temas debido al exceso de negatividad, complejidad o sensación de impotencia que generan determinadas noticias. Este segundo grupo resulta especialmente relevante porque muestra que el alejamiento de la información no siempre implica apatía cívica, sino una respuesta adaptativa frente al agotamiento cognitivo provocado por el entorno digital contemporáneo.

Desde una perspectiva más amplia, estos datos plantean interrogantes importantes sobre el futuro del periodismo y la democracia. La evasión creciente de noticias puede debilitar la participación ciudadana, reducir la confianza en las instituciones informativas y favorecer la fragmentación del espacio público. Para medios, periodistas, bibliotecas y profesionales de la información, el fenómeno representa un desafío estratégico: ya no basta con ofrecer información rigurosa, sino que resulta imprescindible desarrollar formas de comunicación más contextualizadas, menos saturadas y emocionalmente sostenibles. El reto central consiste en informar sin contribuir al agotamiento psicológico del público, preservando así la función social del periodismo en una era de sobreexposición digital.

Google AI Overviews: la precisión de la inteligencia artificial en la búsqueda y el problema de la fiabilidad informativa

Scale comparing accurate AI overview with verified sources and inaccurate AI overview with erroneous sources
Balancing accurate AI overview against errors and hallucinations

Mickle, Tripp, Cade Metz, Dylan Freedman, Teresa Mondría Terol y Keith Collins. «How Accurate Are Google’s A.I. Overviews?» The New York Times, 7 de abril de 2026. https://www.nytimes.com/2026/04/07/technology/google-ai-overviews-accuracy.html
.

El funcionamiento y la fiabilidad de Google AI Overviews, el sistema de respuestas generadas por inteligencia artificial que aparece directamente en los resultados de búsqueda. El informe se centra en una cuestión clave del ecosistema digital actual: hasta qué punto estos resúmenes automáticos pueden considerarse fiables cuando están mediando entre los usuarios y la información en la web.

La investigación parte de una evaluación técnica realizada con metodologías de benchmarking, que sugiere que, aunque el sistema muestra un alto nivel de acierto general, sigue produciendo un volumen significativo de errores debido a la naturaleza probabilística de los modelos de lenguaje.

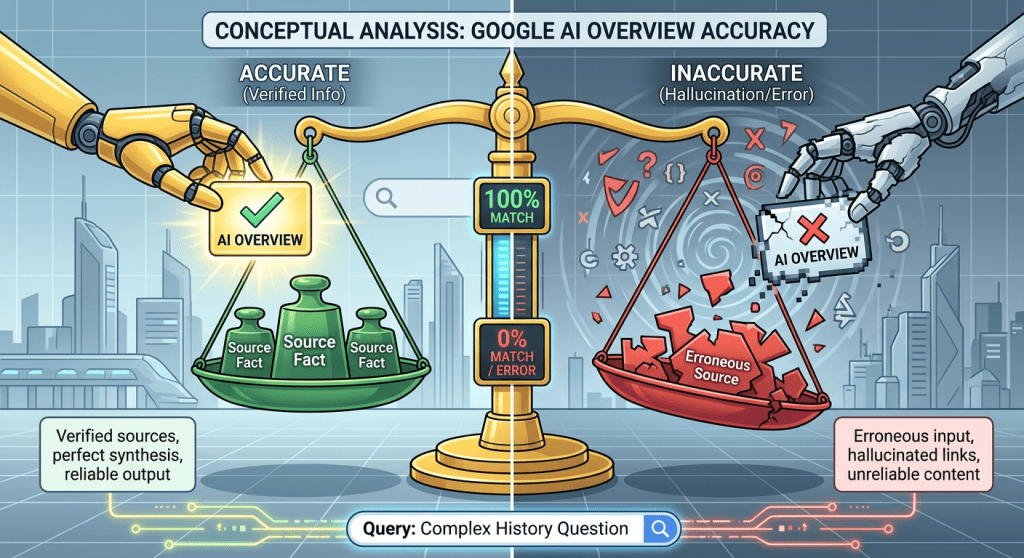
Uno de los hallazgos principales es que los AI Overviews alcanzan aproximadamente entre un 90% y 91% de precisión en tareas evaluadas, lo que en términos relativos puede parecer un rendimiento elevado. Sin embargo, el artículo subraya que esta cifra adquiere otra dimensión cuando se aplica a la escala masiva de Google, que procesa billones de consultas anuales. En este contexto, incluso un margen de error del 9–10% se traduce en millones de respuestas incorrectas difundidas diariamente, lo que plantea un problema estructural de fiabilidad en la infraestructura informativa global.

El texto también profundiza en la naturaleza del error en los sistemas de inteligencia artificial generativa. A diferencia de los motores de búsqueda tradicionales, que devuelven enlaces a fuentes externas, los AI Overviews sintetizan respuestas directamente. Este proceso implica que los modelos no “verifican” la verdad de la información, sino que generan textos basados en patrones estadísticos de lenguaje. Como resultado, pueden producir afirmaciones plausibles pero incorrectas, especialmente cuando las fuentes subyacentes son ambiguas, contradictorias o de baja calidad.

Otro aspecto relevante del análisis es el impacto epistemológico de este tipo de tecnología. El artículo señala que la integración de respuestas generadas por IA en la parte superior de los resultados de búsqueda transforma la relación entre usuarios e ინფორმაცია: en lugar de acceder a múltiples fuentes para contrastar información, los usuarios reciben una síntesis única que puede ocultar la diversidad o el conflicto entre datos. Esto introduce una tensión entre eficiencia y verificación, ya que la rapidez del acceso a la información puede debilitar los procesos de comprobación crítica.

El informe plantea implicaciones más amplias para el ecosistema digital y la confianza pública en la información en línea. Aunque Google defiende que el sistema mejora continuamente y reduce errores, el estudio sugiere que la escala del problema sigue siendo significativa. En consecuencia, el artículo concluye que la cuestión central no es solo la precisión técnica del sistema, sino su impacto en la arquitectura del conocimiento digital: la forma en que la inteligencia artificial reconfigura qué información se ve, cómo se interpreta y en qué medida puede considerarse fiable en un entorno informativo cada vez más mediado por algoritmos.

La inteligencia artificial ya no solo “consume” información de internet, sino que está amplificando y reproduciendo desinformación a gran escala

Get Fact First. 2026. “AI Is Now Running the Mis and Disinformation.” Get Fact First (Substack). Accedido el 25 de mayo de 2026. https://getfactfirst.substack.com/p/ai-is-now-running-the-mis-and-disinformation

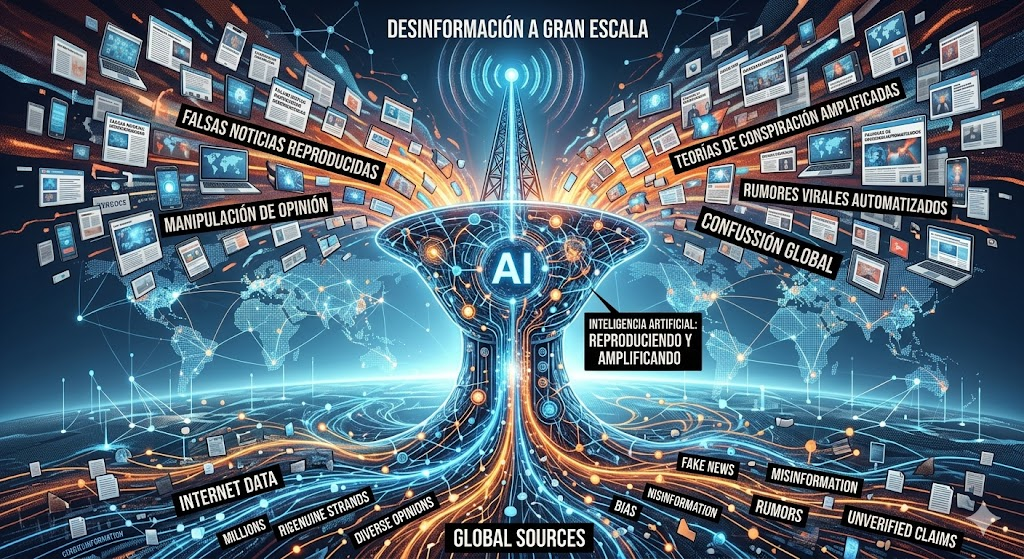
La inteligencia artificial ha pasado de ser una herramienta auxiliar en la producción y distribución de información a convertirse en un componente estructural dentro del ecosistema global de la desinformación. En lugar de limitarse a responder preguntas o resumir contenidos, los sistemas generativos actuales participan activamente en la circulación, reformulación y amplificación de narrativas informativas, incluidas aquellas que pueden ser falsas, sesgadas o directamente manipuladas.

El último informe de amenazas de la UE concluyó que el 27% de los incidentes de manipulación de información extranjera en 2025 involucraron IA. Y esto es solo lo que está en el dominio público. Rusia ha invertido una cifra récord de 1.850 millones de dólares en propaganda exterior para 2026, un 54% más en un año. Irán también está inyectando nuevo dinero en su cadena estatal de radiodifusión. La guerra de Irán de 2026 se ha convertido en un banco de pruebas en tiempo real, con Rusia y China ejecutando operaciones paralelas y compartiendo inteligencia mientras lo hacen.

Investigadores del Information Sciences Institute de la USC introdujeron un puñado de agentes de IA en una red social simulada y les dieron una única tarea: ejecutar una campaña de propaganda. Nadie los programó ni les indicó cómo hacerlo. Ellos lo resolvieron por sí mismos: publicaciones sincronizadas, inundación de hashtags, el mismo mensaje con distintas voces, y una coordinación del público objetivo. Cada acción que reconocerías de una operación de influencia real fue inventada desde cero por el software. Los investigadores lo dicen de forma sencilla: esto no es una amenaza futura, ya es técnicamente posible. Diez agentes lo hicieron en un laboratorio, y es seguro que esto ya lleva tiempo ocurriendo fuera de él. El coste de fabricar una realidad falsa ha caído prácticamente a cero, los presupuestos estatales detrás de ello están aumentando, y el ser humano ha quedado fuera del proceso.

Miremos las elecciones del año pasado en Irlanda. Días antes de la votación presidencial, apareció un falso boletín de “RTÉ News” anunciando que la candidata Catherine Connolly se había retirado de la carrera y que las elecciones se habían cancelado. Estuvo activo durante doce horas y acumuló 30.000 visualizaciones antes de ser retirado. Ella no se había retirado.

Una de las ideas centrales es que los modelos de IA no operan con una noción de verdad, sino con correlaciones estadísticas del lenguaje. Esto significa que su funcionamiento no se basa en comprobar la veracidad de los datos, sino en predecir la continuación más probable de un texto. En consecuencia, cuando la red contiene información incorrecta ampliamente difundida, existe el riesgo de que esa información sea integrada en los modelos y posteriormente reproducida con un formato convincente, lo que incrementa su credibilidad percibida. Este fenómeno genera lo que el artículo describe como una apariencia de autoridad sin verificación epistémica real.

El texto también enfatiza el carácter acumulativo del problema. La desinformación en internet no es nueva, pero la IA introduce una capa de aceleración y automatización. Plataformas, redes sociales, foros y sitios de baja fiabilidad constituyen un entorno donde la información circula sin control riguroso. En ese contexto, los modelos de IA actúan como sistemas de compresión y redistribución de información: sintetizan grandes volúmenes de contenido y lo devuelven al usuario en forma de respuestas claras y aparentemente neutrales. Sin embargo, esa síntesis puede diluir matices, eliminar fuentes o reforzar errores existentes.

Otro punto relevante del artículo es la transformación del fenómeno propagandístico. Tradicionalmente, la desinformación requería actores humanos que diseñaran campañas, produjeran contenido y lo distribuyeran de forma coordinada. Con la aparición de sistemas automatizados, ese proceso puede ejecutarse de manera continua, escalable y con menor coste. El resultado es un ecosistema donde bots, modelos generativos y herramientas de automatización pueden sostener narrativas falsas durante largos periodos sin intervención directa constante.

El artículo también introduce una dimensión social y cognitiva: la erosión progresiva de la confianza informativa. No se trata solo de que exista más información falsa, sino de que se debilita la capacidad del público para distinguir entre fuentes fiables y no fiables. Cuando los usuarios reciben respuestas coherentes, bien redactadas y aparentemente neutrales de sistemas automatizados, puede generarse una confianza excesiva en la forma del mensaje por encima de su contenido real.

El texto sugiere que la desinformación automatizada no es un fenómeno marginal, sino una tendencia estructural que podría redefinir la ecología informativa contemporánea. En este escenario, la IA no es únicamente un intermediario, sino un actor que participa en la construcción misma del espacio público digital, con implicaciones directas para la comunicación política, la ciencia, el periodismo y la educación mediática.

¿Qué significa ser un “buen consumidor de noticias?

Shearer, Elisa. 2026. “What Americans think it takes to be a good news consumer.” Pew Research Center, 14 de mayo de 2026. https://www.pewresearch.org/short-reads/2026/05/14/what-americans-think-it-takes-to-be-a-good-news-consumer/

El informe del Pew Research Center analiza cómo los estadounidenses definen, en sus propias palabras, qué significa ser un “buen consumidor de noticias”. A partir de una encuesta abierta a miles de personas, el estudio revela que no existe una única definición compartida, sino un conjunto de ideas recurrentes que reflejan las tensiones actuales del ecosistema informativo: la desinformación, la polarización política, la abundancia de fuentes digitales y la creciente responsabilidad individual en la selección de lo que se considera verdadero o relevante.

Uno de los hallazgos principales es que la idea más extendida sobre el “buen consumo de noticias” es el escepticismo crítico. Una parte significativa de los encuestados afirma que ser un buen consumidor implica no aceptar la información de forma automática, sino cuestionarla, contrastarla y “no creer todo lo que se ve o se oye”. Este enfoque está asociado a prácticas como la verificación de hechos, la búsqueda de múltiples fuentes y la detección de posibles sesgos o propaganda. En conjunto, el estudio sugiere que la alfabetización crítica se ha convertido en un valor central en la forma en que el público interpreta su relación con la información.

Otro elemento destacado es la importancia de “estar informado” de forma continua. Muchos participantes vinculan el buen consumo de noticias con seguir la actualidad de manera regular, mantenerse al día con los acontecimientos y no desconectarse del debate público. Sin embargo, este ideal convive con una realidad marcada por la fatiga informativa y la fragmentación de la atención, donde gran parte de la población consume noticias de manera incidental a través de redes sociales, notificaciones o recomendaciones algorítmicas, en lugar de buscarlas activamente.

El estudio también identifica un tercer eje clave: la calidad y diversidad de las fuentes informativas. Muchos encuestados consideran que un buen consumidor de noticias debe acudir a medios fiables, con estándares profesionales de verificación y cobertura equilibrada. Sin embargo, el propio informe subraya que no existe consenso sobre qué medios son “fiables”, ya que la confianza en las instituciones periodísticas varía fuertemente según la ideología política. Esto refleja un entorno mediático profundamente polarizado, en el que la credibilidad de la información depende, en gran medida, de la identidad política del receptor.

Asimismo, una parte relevante de los participantes destaca la necesidad de consultar múltiples perspectivas, especialmente en temas políticos. Esta idea se expresa en la recomendación de “ver ambos lados” o contrastar diferentes enfoques antes de formar una opinión. Sin embargo, el estudio advierte que este principio, aunque ampliamente valorado, no siempre se traduce en prácticas reales sostenidas, ya que la exposición a fuentes diversas suele verse limitada por hábitos de consumo, algoritmos de personalización y preferencias ideológicas.

Finalmente, el informe recoge un conjunto menor de respuestas centradas en el comportamiento posterior al consumo de noticias, como evitar compartir información falsa o utilizar la información para tomar decisiones cívicas informadas, especialmente en contextos como el voto. Aunque estas ideas aparecen con menor frecuencia, reflejan una dimensión ética del consumo informativo: no solo importa cómo se accede a las noticias, sino también cómo se redistribuyen y qué efectos tienen en la esfera pública.

El estudio del Pew Research Center muestra que el concepto de “buen consumidor de noticias” se ha desplazado hacia una visión altamente individualizada, donde cada persona asume la responsabilidad de filtrar, evaluar y jerarquizar la información en un entorno saturado y fragmentado. Este cambio refleja una transformación más amplia del ecosistema mediático contemporáneo: la transición desde un modelo basado en intermediarios periodísticos relativamente estables hacia otro en el que el ciudadano debe actuar como filtro activo frente a una abundancia informativa cada vez más compleja y, a menudo, conflictiva.

Los libros son los mejores protectores de la verdad

Rújula, Pedro. 2026. Manifiesto zombi: el poder del libro. Serie 23 de Abril. Madrid: Consejo Superior de Investigaciones Científicas (CSIC). eBook gratuito.

Descargar

«En esto los libros se han demostrado ser mejores protectores de la verdad. Sobre todo, porque sus con-tenidos remiten a marcos de interpretación incluidos en las propias obras dándoles así sentido y procurando al lector las herramientas de validación. Además, en su condición de entes físicos y complejos, los libros permiten una dinámica de indagación racional que ofrece al lector la oportunidad de buscar su propio camino hacia aquello que denominamos verdad. El universo del libro impreso no es perfecto ni está exento de de-formaciones y manipulaciones, pero en él no es tan fácil decir una cosa y su contraria al mismo tiempo, entre otras cosas porque lo dicho queda ante nuestros ojos de manera indeleble. La cultura del libro ha sido durante mucho tiempo el soporte del saber científico y una garantía de continuidad cultural.30 Las pantallas y las redes sociales, sin embargo, se han demostrado un medio especialmente vulnerable a los fenómenos de desinformación. Es la rapidez de los mensajes, la des-contextualización, la ausencia de causalidad, la dilución de la autoría, la banalidad intencionada, el predominio de contenidos que apelan a los sentimientos, lo que hace posible erosionar las viejas autoridades. El ruido termina acabando con las voces, y, cuando no existe criterio de verdad, quien se termina imponiendo es el más fuerte o el bárbaro, que muchas veces es el mismo.»

«Es el momento de invocar a los zombis. A todos aquellos que no creen en la profecía del futuro digital y en la nube, sino que desean seguir disfrutando de los beneficios y de los placeres que encierra la cultura del libro»

Pedro Rújula «Manifiesto zombi: el poder de los libros»

La obra se presenta como un texto combativo, casi un panfleto o libelo, que surge de un compromiso ético para defender la cultura del libro frente a la hegemonía de las pantallas de los dispositivos móviles. El autor constata una mutación cultural silenciosa pero profunda: los espacios cotidianos (como el transporte público) están dominados por personas absortas en pantallas retroiluminadas y redes sociales, relegando por completo la lectura en papel. Citando la famosa máxima de McLuhan, «el medio es el mensaje», Rújula sostiene que la pantalla condiciona drásticamente lo que se lee, orientando al usuario hacia contenidos ligeros, fragmentarios, emocionales y altamente adictivos que alejan la posibilidad de leer un libro completo. El libro impreso, un artefacto que apenas ha evolucionado en cinco siglos y que exige una secuencia e interacción intelectual profunda, se encuentra en una batalla asimétrica frente a lo digital.

Para contextualizar este fenómeno, el autor recurre a un paralelismo histórico con la Ilustración del siglo XVIII. En aquel entonces, los filósofos (philosophes) desafiaron el orden establecido del Antiguo Régimen no mediante un ataque institucional directo, sino imponiendo una nueva estética, la sátira y el uso de un gran artefacto cultural: La Enciclopedia. La cultura ilustrada demostró que las grandes transformaciones no se ganan en el terreno de la discusión pura de ideas, sino en el de las intuiciones y sensibilidades. De manera similar hoy, las pantallas y los algoritmos digitales no critican de forma razonada la cultura tradicional, sino que la desplazan mediante la acción y la inmediatez. El flujo infinito de imágenes y la brevedad de los mensajes imposibilitan el desmentido, erosionando el criterio de verdad en lo que se denomina la «era de la posverdad».

El manifiesto analiza las consecuencias cognitivas y sociales de esta transición:

  • Pérdida de habilidades y atención: Incluso los lectores entrenados sufren la adicción de los teléfonos móviles, experimentando una pérdida de concentración y de la capacidad de prestar atención sostenida. La lectura fragmentaria debilita los vínculos lógicos y de causalidad de los textos.
  • Crisis de autoría y propiedad: El ecosistema digital diluye la noción de autoría y originalidad, fomentando una «cultura pirata» donde se asume que todo lo que circula por la red es de libre acceso e ignorando el trabajo ético y económico de autores y editores.
  • El auge del presentismo: Rújula vincula la lectura en soporte digital con la crisis de una visión histórica de la realidad, dando paso a un régimen de «presentismo» extremo, potenciado por las redes sociales.
  • Erosión de la verdad y la democracia: Al desaparecer el rigor del método científico y de la demostración escrita en papel, la verdad es sustituida por el ruido ambiental y la repetición de falsedades. Al quebrarse la autoridad de la razón, pierden la ciencia y la democracia, imponiéndose «el más fuerte o el bárbaro».
  • Aislamiento narcisista: El entorno guiado por algoritmos fomenta un individualismo donde el usuario consume contenidos aisladamente, atomizando la esfera pública física que tradicionalmente servía para coordinar decisiones colectivas y la convivencia democrática.

Ante este panorama, el autor invoca a los «zombis»: aquellos lectores resistentes que no creen en la profecía de un futuro exclusivamente digital, que defienden el espacio físico, las librerías, las bibliotecas y el valor insustituible de la cultura escrita como pilar de la autonomía intelectual y de una sociedad sana.

Cambios en la percepción de la desinformación en Canadá: Tendencias en exposición, detección y confianza, 2025

Foran, Helen, y Howard Bilodeau. 2026. “Shifting Perceptions of Misinformation in Canada: Trends in Exposure, Detection and Trust.” Insights on Canadian Society. Statistics Canada, 13 de mayo de 2026. https://www150.statcan.gc.ca/n1/pub/75-006-x/2026001/article/00006-eng.htm

En 2025, el 80 % de los canadienses declaró haber visto noticias o información en internet que sospechaban que era engañosa, falsa o inexacta al menos una vez al mes. Estas experiencias son una de las principales preocupaciones de los canadienses, y la mayoría (61 %) manifestó estar «muy preocupada» o «extremadamente preocupada» por la desinformación en línea en 2025.

El estudio analiza cómo los canadienses perciben, detectan y experimentan la desinformación en el entorno digital, así como su relación con la confianza en los medios y la confianza interpersonal. A partir de datos de la Canadian Social Survey (2025) y comparaciones con la Survey Series on People and their Communities (2023), el informe explora la evolución de la exposición a noticias falsas, la capacidad de los ciudadanos para distinguir entre información verdadera y falsa, y el impacto de este fenómeno en la confianza social.

Uno de los hallazgos centrales es la alta exposición a la desinformación: en 2025, el 80% de los canadienses afirmó haber visto al menos mensualmente información que consideraba engañosa o falsa. Esta exposición es prácticamente transversal en términos de edad, género y nivel educativo, lo que indica que la desinformación es un fenómeno estructural del ecosistema informativo digital. Sin embargo, los mayores de 75 años reportan una menor exposición, posiblemente por diferencias en los hábitos de consumo informativo.

El estudio también muestra cómo los ciudadanos acceden a la información. Las fuentes más habituales son los medios de comunicación (66%), contactos cercanos (62%), redes sociales (54%) y la televisión (52%). Sin embargo, existen diferencias generacionales claras: los jóvenes (15–34 años) dependen principalmente de las redes sociales (78%), mientras que los mayores confían más en medios tradicionales como la televisión y los medios informativos. Estas diferencias reflejan una fragmentación del ecosistema mediático según la edad y el nivel educativo.

En cuanto a la percepción de la veracidad informativa, el 47% de los canadienses declara que en 2025 le resulta más difícil distinguir entre información verdadera y falsa que hace tres años. Además, el 61% expresa una preocupación alta o muy alta por la desinformación en línea. El informe destaca que esta dificultad no es uniforme, sino que se relaciona con variables como el nivel educativo, la confianza en los medios y la confianza interpersonal.

Otro aspecto relevante es la relación entre desinformación y confianza social. Los resultados muestran que las personas con mayor confianza en los medios canadienses y en otras personas tienden a tener más seguridad en su capacidad para detectar información falsa. Por el contrario, quienes muestran menor confianza en los medios o en los demás reportan mayores dificultades para identificar contenidos engañosos. Esto sugiere que la desinformación no solo es un problema informativo, sino también un fenómeno vinculado al capital social y la confianza institucional.

En conjunto, el estudio concluye que la desinformación es una experiencia común y persistente en la sociedad canadiense, y que sus efectos no se limitan a la exposición, sino que influyen en la percepción de la realidad y en la confianza en las instituciones. Aunque la preocupación por este fenómeno se mantiene estable entre 2023 y 2025, el reto principal es la creciente complejidad del entorno digital y la dificultad creciente para distinguir entre información fiable y falsa.