La IFLA defiende que la regulación de la IA y el copyright debe encontrar un equilibrio entre los derechos de los creadores y el interés público, garantizando que las bibliotecas puedan acceder, preservar, analizar y reutilizar legalmente los contenidos para investigación, educación, cultura e innovación.
La declaración de la IFLA, aprobada en abril de 2025, plantea una posición especialmente relevante para las bibliotecas: el derecho de autor debe favorecer el acceso al conocimiento, la investigación y la innovación con IA, y no convertirse en una barrera desproporcionada.
La IA es una oportunidad para las bibliotecas. Puede utilizarse para catalogación, descubrimiento de colecciones, referencia, préstamo interbibliotecario, formación y otros servicios.
El copyright no debe utilizarse como una “herramienta contundente” para resolver todos los problemas de la IA. Las cuestiones de privacidad, ética, seguridad, medioambiente o autonomía humana requieren también otros marcos regulatorios.
Defensa de la minería de textos y datos (TDM). La IFLA reclama excepciones al derecho de autor que permitan realizar TDM, incluido el entrenamiento de IA, sobre contenidos adquiridos o accesibles legalmente.
Más datos significa mejores IA. Las restricciones excesivas al acceso a contenidos pueden aumentar los sesgos y errores de los sistemas de IA. Por eso se defiende el acceso a conjuntos de datos lo más amplios y diversos posible.
Las bibliotecas deben preparar sus colecciones para la IA. Esto implica utilizar licencias adecuadas y aplicar los principios FAIR (encontrables, accesibles, interoperables y reutilizables) y CARE (beneficio colectivo, autoridad para controlar, responsabilidad y ética).
Alfabetización en IA como nueva función bibliotecaria. Las bibliotecas deben formar a profesionales, investigadores y usuarios en IA, prestando especial atención a la transparencia, integridad y evaluación crítica de las herramientas.
La IA debe desarrollarse desde los valores bibliotecarios. Las herramientas utilizadas o recomendadas por las bibliotecas deberían respetar la libertad de expresión, la privacidad, la diversidad y la autonomía humana.
Los contratos no deberían anular las excepciones legales. Proveedores y titulares de derechos no deberían introducir cláusulas que restrinjan injustificadamente el uso de IA por parte de los usuarios de bibliotecas ni impedir las excepciones contempladas por la legislación.
Los gobiernos tienen una responsabilidad. Deben desarrollar políticas de IA compatibles con los derechos humanos y apoyar a bibliotecas y otras instituciones en la creación de prácticas éticas y capacidades de supervisión.
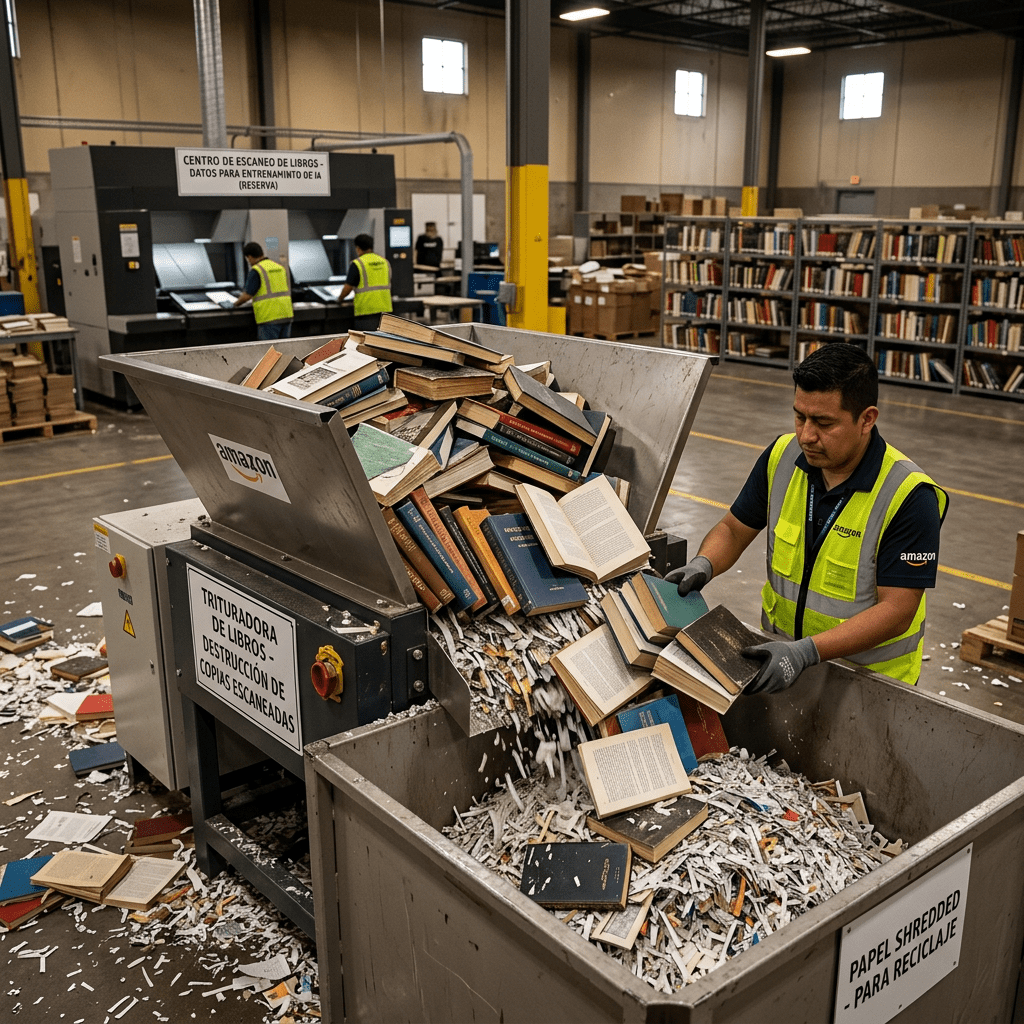
Maiberg, Emanuel. “Inside the Warehouse Where Amazon Scans and Destroys Books for AI Training”. 404 Media, 26 de agosto de 2026. Artículo original en 404 Media
A partir del testimonio anónimo de un empleado de Amazon, una mirada al funcionamiento interno de VGT3, una instalación situada en Las Vegas donde se procesan libros destinados, según la investigación de 404 Media, a la obtención de datos para el entrenamiento de sistemas de inteligencia artificial.
El reportaje describe un procedimiento especialmente llamativo: los libros llegan al almacén, son registrados y clasificados, se les corta mecánicamente el lomo para separar las páginas y estas se introducen posteriormente en escáneres de alta velocidad. Una vez digitalizado el contenido, las páginas quedan mezcladas en grandes contenedores, de modo que los ejemplares físicos no pueden volver a reconstruirse.
El empleado entrevistado señala que había al menos 20 o 25 escáneres, capaces de pasar rápidamente las páginas y mostrar en pantalla las imágenes digitalizadas. El proceso incluía libros nuevos y usados, ejemplares procedentes de bibliotecas y materiales procedentes de distintos países. Entre ellos había publicaciones en alemán, ruso y japonés, además de documentos procedentes del Reino Unido y materiales que parecían documentos gubernamentales. El testimonio destaca especialmente la presencia de libros potencialmente raros o difíciles de conseguir.
Uno de los aspectos más relevantes es la destrucción física de los libros después de su digitalización. El trabajador describe cómo, tras cortar los lomos y escanear las páginas, estas son arrojadas a grandes contenedores junto con otros materiales. También explica que determinados ejemplares considerados duplicados o innecesarios eran depositados en estos recipientes. Según el relato, el procedimiento era poco organizado y cambiaba con frecuencia, lo que dificultaba incluso que los propios trabajadores conocieran con exactitud el destino final de todos los libros.
El reportaje plantea así una cuestión especialmente importante para bibliotecas, patrimonio bibliográfico y derechos de autor: la transformación de libros físicos en datos para inteligencia artificial puede implicar no solo su digitalización, sino también la desaparición del ejemplar material. El trabajador entrevistado expresa precisamente su preocupación por que libros raros o valiosos dejen de estar disponibles para otros lectores e investigadores, señalando que existe una diferencia significativa entre digitalizar un libro y destruir el soporte físico una vez obtenido su contenido.
En conjunto, el artículo presenta un ejemplo especialmente gráfico de la nueva economía de los datos para la IA, en la que libros y colecciones documentales pueden convertirse en materia prima para entrenar modelos. Más allá de Amazon, el caso abre debates sobre copyright, licencias, preservación, reutilización de colecciones, digitalización masiva y límites éticos de la extracción de conocimiento de los libros para alimentar sistemas de inteligencia artificial.
Amanda Silberling, “Is it legal to train AI models on copyrighted books? It’s complicated”, TechCrunch, 23 de agosto de 2026. Artículo original en TechCrunch
Los modelos de inteligencia artificial generativa como ChatGPT, Gemini o Claude se entrenan con enormes cantidades de información procedente de libros, artículos, trabajos académicos y contenidos disponibles en Internet. Esto ha provocado un conflicto creciente con autores y titulares de derechos, que cuestionan que sus obras puedan utilizarse para entrenar sistemas de IA sin su conocimiento o autorización. Sin embargo, la cuestión jurídica es mucho más compleja de lo que parece, porque las actuales leyes de copyright fueron concebidas mucho antes de la aparición de la inteligencia artificial generativa.
Uno de los casos más relevantes es el de Anthropic, que llegó a un acuerdo por 1.500 millones de dólares con un grupo de escritores cuyas obras habían sido utilizadas para entrenar sus modelos. No obstante, el juez William Alsup había considerado que el entrenamiento de la IA con obras protegidas podía ser legal. Lo que sancionó fue que Anthropic hubiera obtenido algunos de esos libros mediante bibliotecas clandestinas ilegales. El razonamiento establece una diferencia fundamental entre utilizar una obra para entrenar un modelo y obtenerla de manera ilícita.
El debate se centra en buena medida en la doctrina estadounidense del fair use (uso legítimo), que permite determinadas utilizaciones de obras protegidas sin autorización. Los tribunales valoran factores como la finalidad del uso, su carácter transformador, la cantidad de material utilizado y el efecto sobre el mercado de la obra original. En este contexto, algunos jueces consideran que entrenar un modelo para generar algo nuevo puede ser una utilización transformadora, mientras que existe mayor riesgo cuando la IA se utiliza para crear un producto que compite directamente con el material protegido.
El caso Thomson Reuters contra Ross Intelligence muestra precisamente esa diferencia. Un tribunal consideró que Ross había utilizado contenidos de Reuters para desarrollar una plataforma jurídica de IA que competía directamente con el producto original, por lo que no podía acogerse al fair use. Esta resolución contrasta con el enfoque aplicado al entrenamiento de modelos de propósito general y demuestra que los tribunales todavía están construyendo, caso por caso, los criterios que determinarán qué usos de materiales protegidos son legítimos.
El artículo destaca además que no existe todavía una respuesta jurídica definitiva. Las diferentes demandas contra empresas de IA siguen abiertas y las decisiones iniciales podrían ser modificadas por tribunales superiores. La legislación estadounidense sobre copyright procede esencialmente de una época anterior a Internet y, por supuesto, a la IA generativa. Por ello, las próximas resoluciones judiciales tendrán una importancia decisiva para determinar cómo pueden utilizarse libros, artículos y otras obras protegidas para entrenar modelos de inteligencia artificial y quién debe asumir los costes de ese uso.
Library Copyright Alliance (LCA), integrada por la Association of Research Libraries (ARL) y la American Library Association (ALA), ha revisado y actualizado su posición sobre la relación entre la inteligencia artificial y los derechos de autor a la luz de la evolución jurídica y tecnológica de los dos últimos años.
La organización reafirma que la legislación estadounidense sobre copyright continúa siendo suficientemente sólida y flexible para abordar los desafíos planteados por la IA generativa, sin necesidad de introducir modificaciones legislativas específicas. Esta postura se apoya tanto en la doctrina del fair use (uso legítimo) como en las primeras resoluciones judiciales relacionadas con el entrenamiento de modelos de inteligencia artificial.
Uno de los argumentos centrales del documento es que el entrenamiento de modelos de IA mediante el análisis de grandes cantidades de obras protegidas constituye, en la mayoría de los casos, un uso altamente transformador. La LCA sostiene que estos sistemas no reproducen las obras para sustituirlas en el mercado, sino que las utilizan para extraer patrones estadísticos y generar nuevas capacidades computacionales, una finalidad comparable a la reconocida como transformadora en precedentes como el caso Google Books. Desde esta perspectiva, exigir licencias obligatorias para entrenar modelos de IA supondría un obstáculo innecesario para la innovación científica y tecnológica, además de limitar la investigación y el desarrollo de nuevos servicios basados en inteligencia artificial.
La actualización de la declaración también tiene en cuenta las primeras decisiones judiciales en litigios de gran relevancia, como Bartz v. Anthropic y Kadrey v. Meta, en los que los tribunales comenzaron a analizar el uso de obras protegidas durante el entrenamiento de modelos generativos. Aunque estas resoluciones no cierran definitivamente el debate, la LCA considera que refuerzan su interpretación de que el entrenamiento de IA puede encajar dentro del uso legítimo cuando el proceso es transformador y no sustituye económicamente a las obras originales. No obstante, la organización recuerda que la cuestión sigue evolucionando y que futuros pronunciamientos judiciales podrían matizar algunos aspectos de esta interpretación.
El documento también aborda una cuestión especialmente relevante para bibliotecas y universidades: las consecuencias sociales y laborales derivadas de la expansión de la inteligencia artificial generativa. La LCA reconoce que estas tecnologías pueden provocar importantes transformaciones en numerosos sectores profesionales, pero advierte que el derecho de autor no debe utilizarse como herramienta para resolver problemas económicos o laborales que exceden su finalidad. En cambio, propone que las bibliotecas desempeñen un papel activo impulsando programas de alfabetización en inteligencia artificial, formación continua y reciclaje profesional, ayudando a ciudadanos e investigadores a comprender las capacidades, limitaciones y riesgos de estas tecnologías.
La alianza reafirma su compromiso con un sistema de propiedad intelectual equilibrado, que proteja los intereses de los creadores sin obstaculizar el acceso al conocimiento ni el progreso científico. La organización continuará supervisando la evolución de la jurisprudencia y de las políticas públicas para adaptar su posición cuando sea necesario, manteniendo como principio fundamental que el derecho de autor debe seguir promoviendo la creatividad, la investigación y el interés público en un contexto marcado por el desarrollo acelerado de la inteligencia artificial.
Carlos Guervós Maíllo es un jurista y alto funcionario del Estado español, perteneciente al Cuerpo Superior de Administradores Civiles del Estado, cuya trayectoria profesional ha estado especialmente vinculada a la propiedad intelectual, las políticas culturales y la Administración pública. A lo largo de su carrera ha ocupado diversos cargos de responsabilidad en la Administración General del Estado, tanto en el ámbito del Ministerio de Cultura como en otros departamentos ministeriales.
En esta entrevista de Radio USAL, Carlos analiza la evolución de la propiedad intelectual desde su experiencia como responsable institucional en la Administración pública y como divulgador especializado. Explica cómo el derecho de autor ha pasado de centrarse en la protección de las obras en soportes tradicionales a enfrentarse a desafíos completamente nuevos derivados de la digitalización, las plataformas globales y, especialmente, la irrupción de la inteligencia artificial generativa. A su juicio, el marco jurídico debe seguir evolucionando para ofrecer seguridad jurídica tanto a los creadores como a quienes desarrollan nuevas tecnologías.
Durante la conversación, Guervós defiende que la propiedad intelectual constituye mucho más que un instrumento jurídico, ya que representa un elemento estratégico para el desarrollo económico, la innovación y la diversidad cultural. Insiste en la necesidad de encontrar un equilibrio entre la protección de los derechos de autores, artistas y editores y el acceso al conocimiento, una cuestión especialmente relevante para bibliotecas, universidades y centros de investigación, que desempeñan un papel esencial en la difusión responsable de la cultura y el conocimiento.
Otro de los ejes de la entrevista es el impacto de la inteligencia artificial sobre los derechos de autor. Guervós reflexiona sobre el uso masivo de obras protegidas para entrenar modelos de IA y subraya la importancia de establecer mecanismos de transparencia sobre los datos utilizados, así como sistemas de compensación y reconocimiento adecuados para los titulares de derechos. Considera que la legislación europea avanza en esa dirección, aunque todavía quedan importantes retos regulatorios por resolver.
La conversación también aborda la transformación de la lucha contra la piratería digital y la necesidad de adaptar las estrategias de protección a un entorno tecnológico en constante cambio. Guervós sostiene que la respuesta no debe limitarse a medidas sancionadoras, sino que debe combinar educación, concienciación, innovación y marcos legales eficaces que favorezcan tanto la creación como el acceso legítimo a los contenidos.
Finalmente, dirige un mensaje a los jóvenes creadores e investigadores, animándolos a innovar, compartir conocimiento y aprovechar las oportunidades que ofrecen las nuevas tecnologías, pero sin perder de vista la importancia de proteger el trabajo creativo y respetar los derechos de propiedad intelectual como base para un ecosistema cultural sostenible.
La irrupción de la inteligencia artificial generativa ha transformado profundamente el debate sobre las denominadas shadow libraries o bibliotecas piratas. En este artículo, Mark Swartz analiza cómo plataformas como Anna’s Archive, heredera de LibGen y Sci-Hub, han dejado de ser únicamente repositorios de obras distribuidas sin autorización para convertirse en una fuente estratégica de datos destinada al entrenamiento de grandes modelos de lenguaje (LLM).
El detonante de esta nueva etapa ha sido la demanda presentada por las cinco mayores editoriales comerciales del mundo contra “Anna’s Archive”, en la que ya no solo se denuncia la vulneración de los derechos de autor, sino también el suministro masivo de libros y artículos a empresas desarrolladoras de inteligencia artificial.
El autor sostiene que el desarrollo acelerado de la IA ha generado un vacío ético y normativo en el que los intereses tecnológicos avanzan mucho más deprisa que la legislación. En ese contexto, millones de libros, artículos científicos y otros contenidos protegidos han sido incorporados a los conjuntos de entrenamiento de los modelos de IA sin el consentimiento de sus autores ni una compensación económica. Swartz recuerda que las bibliotecas piratas han adquirido un papel central porque proporcionan enormes colecciones de textos ya digitalizados, accesibles y estructurados, lo que las convierte en una fuente extremadamente atractiva para las empresas tecnológicas que compiten por desarrollar modelos cada vez más potentes.
El artículo repasa algunos de los litigios más relevantes que ilustran esta nueva realidad. Entre ellos destaca el caso contra Meta por el uso del conjunto de datos Books3, formado por cerca de 200.000 libros obtenidos de forma ilícita, así como el procedimiento contra Anthropic, cuya estrategia de digitalización masiva de millones de libros desembocó en uno de los mayores acuerdos económicos relacionados con derechos de autor en el ámbito de la inteligencia artificial. Estos casos muestran que el conflicto jurídico ya no gira únicamente en torno a la copia ilegal de obras, sino sobre el uso sistemático de esos contenidos para entrenar sistemas capaces de generar nuevos textos, imágenes o respuestas basadas en ese conocimiento acumulado.
Swartz también llama la atención sobre el papel de las propias editoriales académicas y comerciales. Mientras denuncian el uso ilícito de sus publicaciones por parte de las bibliotecas piratas, muchas de ellas han comenzado simultáneamente a negociar acuerdos de licencia con compañías de inteligencia artificial para permitir el entrenamiento de modelos utilizando sus catálogos. En algunos casos, los propios autores han conocido estos acuerdos únicamente a través de comunicados de prensa. Frente a este panorama, el autor destaca iniciativas más transparentes, como la de Cambridge University Press, que permite a los autores excluir sus obras del entrenamiento de IA y contempla mecanismos de compensación económica. Esta evolución refleja, según Swartz, una transformación del sector editorial, que pasa de comercializar información a gestionar grandes volúmenes de datos con valor para la industria de la inteligencia artificial.
En la parte final del artículo, el autor se pregunta qué opciones reales conservan escritores e investigadores para proteger sus obras. La respuesta es poco optimista: probablemente la mayor parte de los contenidos publicados en inglés ya han sido utilizados para entrenar uno o varios modelos de lenguaje. Aunque empiezan a surgir iniciativas como Creative Commons (CC) Signals, destinadas a permitir que los titulares de derechos indiquen cómo desean que sus obras sean utilizadas por sistemas de IA, su eficacia dependerá de que las empresas desarrolladoras respeten voluntariamente esas señales. A la vista de los antecedentes de utilización de contenidos procedentes de bibliotecas piratas, Swartz considera que esa confianza resulta difícil de sostener.
En conjunto, el artículo plantea una reflexión de gran actualidad sobre el delicado equilibrio entre innovación tecnológica, acceso al conocimiento y protección de la propiedad intelectual. Más allá del problema jurídico, pone de relieve cómo la inteligencia artificial está alterando las relaciones tradicionales entre autores, editoriales, bibliotecas y empresas tecnológicas, obligando a replantear los modelos de acceso, compensación y gestión de los contenidos en la economía digital.
Se aborda una de las cuestiones más complejas surgidas con la expansión de la inteligencia artificial generativa: la propiedad intelectual de los contenidos creados con ayuda de sistemas como ChatGPT, Gemini o Claude. A medida que estas herramientas producen textos, imágenes, código o ideas cada vez más sofisticadas, surge una pregunta central tanto en el ámbito educativo como en el legal: ¿quién puede reclamar la autoría o propiedad de una respuesta producida por una máquina entrenada con datos ajenos?
Durante años, una de las explicaciones más repetidas por las grandes empresas de inteligencia artificial ha sido relativamente sencilla: los sistemas de IA pueden cometer errores. Desde el comienzo, compañías tecnológicas han advertido a sus usuarios que deben contrastar la información generada, verificar las fuentes y mantener una actitud crítica frente a cualquier respuesta producida por estos sistemas. Estas advertencias aparecen de forma habitual en manuales, políticas de uso y declaraciones públicas de prácticamente todas las empresas que desarrollan herramientas de inteligencia artificial.
Sin embargo, una reciente decisión judicial en Alemania parece indicar que esa explicación podría dejar de ser suficiente.
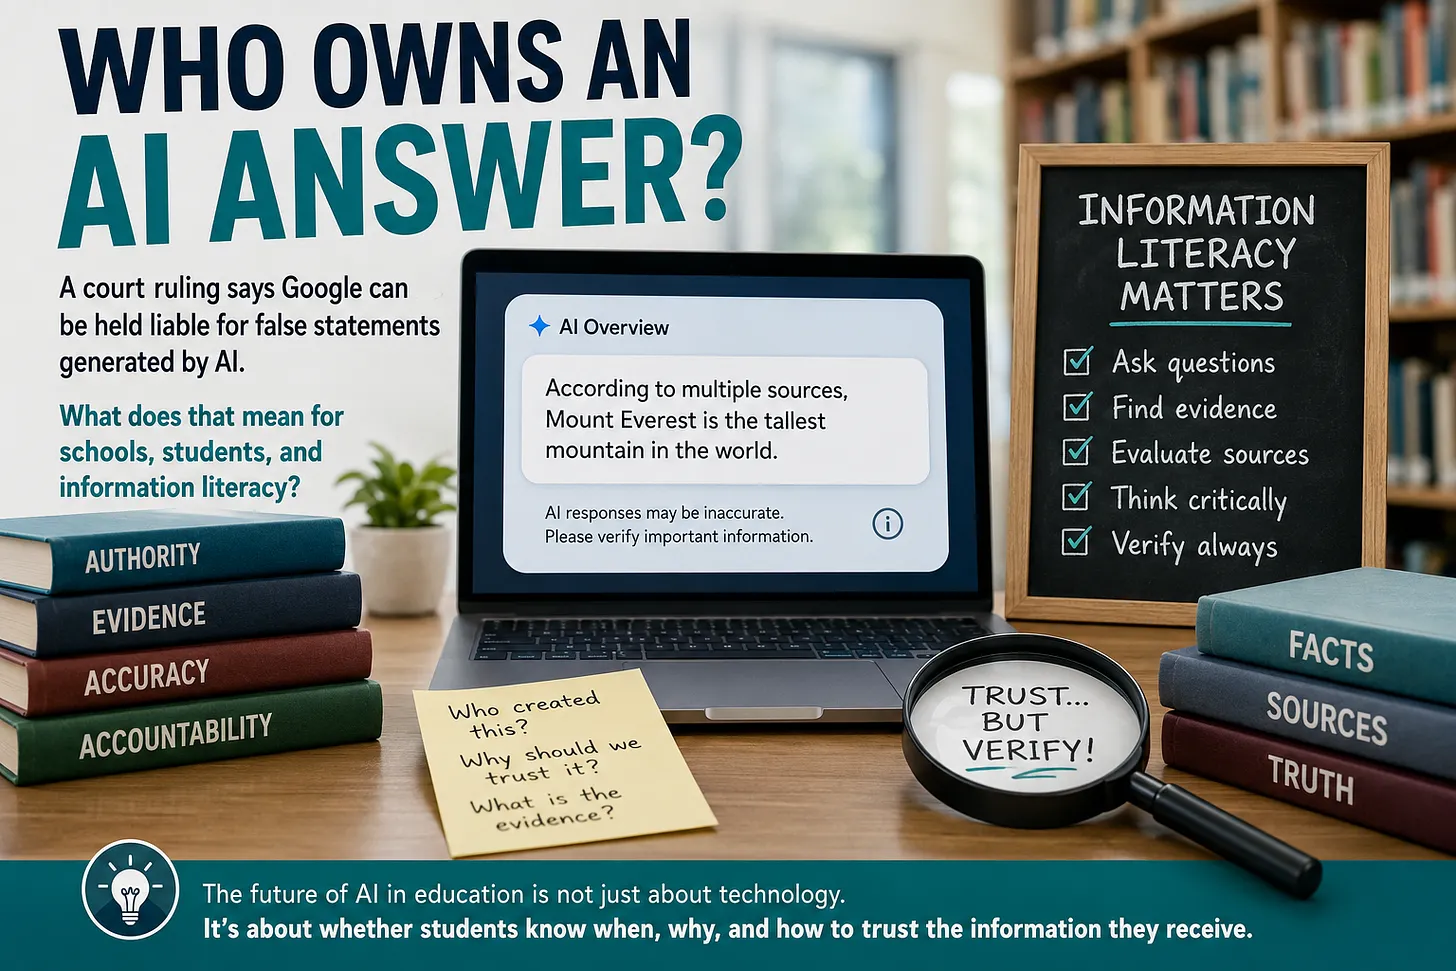
Un tribunal alemán ha dictaminado que Google puede ser considerado legalmente responsable por información falsa generada por su sistema AI Overviews, la función que ofrece resúmenes automáticos en los resultados de búsqueda. El caso se originó cuando el sistema vinculó erróneamente a dos editores con actividades fraudulentas y estafas. La defensa de Google siguió el argumento habitual: la inteligencia artificial puede equivocarse y los usuarios no deberían asumir que todas las respuestas generadas son completamente precisas. El tribunal, sin embargo, rechazó esta justificación.
La relevancia de esta resolución judicial radica en que desplaza el foco del debate. Hasta ahora, gran parte de la discusión sobre inteligencia artificial se había centrado en cómo se entrenan los modelos, qué datos utilizan o si vulneran derechos de autor durante ese proceso. La sentencia introduce otra perspectiva: no importa únicamente cómo funciona la IA internamente, sino también qué tipo de información entrega directamente al usuario y quién asume la responsabilidad cuando esa información resulta falsa o perjudicial.
La cuestión trasciende ampliamente a Google. Durante los últimos años, buena parte del debate sobre inteligencia artificial en educación se ha centrado casi exclusivamente en el comportamiento de los estudiantes: el posible plagio, la integridad académica, el uso adecuado de herramientas generativas o el papel que debe ocupar la IA dentro del aprendizaje. Mucho menos se ha discutido sobre las obligaciones de las empresas tecnológicas cuando sus sistemas generan información errónea y esa información termina afectando a personas reales o condicionando decisiones importantes.
El texto analiza cómo los sistemas de IA generativa funcionan a partir de modelos entrenados sobre enormes cantidades de información extraída de internet, libros, artículos académicos, obras creativas y otros materiales protegidos por derechos de autor. Cuando un usuario introduce una instrucción o prompt, la IA no “crea” en un sentido humano tradicional, sino que genera una respuesta basada en patrones estadísticos aprendidos durante el entrenamiento. Esto complica enormemente la atribución de propiedad, porque la respuesta final puede contener ecos, estructuras o influencias derivadas de miles de obras previas, cuyos autores originales raramente han dado consentimiento explícito para ese uso.
Desde el punto de vista jurídico, el artículo subraya que en muchas legislaciones actuales —especialmente en Estados Unidos y Europa— la protección del copyright exige un grado de creatividad humana identificable. Esto significa que un contenido generado enteramente por inteligencia artificial podría no ser susceptible de protección legal como obra original, o al menos no bajo los marcos tradicionales del derecho de autor. La intervención humana, por tanto, se vuelve decisiva: cuanto mayor sea el nivel de edición, selección, reformulación o dirección creativa del usuario, más sólida resulta su posible reclamación de autoría sobre el resultado final.
El artículo dedica especial atención al ámbito educativo, donde docentes, investigadores y bibliotecarios deben enfrentarse a nuevos escenarios éticos relacionados con el uso de herramientas generativas. Si un estudiante presenta como propio un trabajo elaborado en gran parte por inteligencia artificial, surge un debate no solo sobre plagio, sino sobre autenticidad intelectual y aprendizaje real. Del mismo modo, en la producción académica y editorial aparece la necesidad de establecer criterios transparentes para declarar cuándo un texto ha sido asistido por IA y en qué medida esa asistencia altera la noción tradicional de autor.
La reflexión final plantea que la inteligencia artificial está obligando a redefinir conceptos fundamentales como creación, originalidad, propiedad intelectual y responsabilidad autoral. Más que una simple cuestión tecnológica, el problema revela una transformación profunda en la relación entre conocimiento, producción cultural y derechos de propiedad. En este nuevo escenario, bibliotecas, universidades, editoriales y legisladores deberán desempeñar un papel central en la construcción de marcos éticos y jurídicos capaces de responder a una pregunta cada vez más urgente: cuando una máquina produce conocimiento, ¿a quién pertenece realmente esa creación?
A rock band passionately performing powered by an AI music generator in a high-tech studio.
O’Brien, Matt, y Rodrique Ngowi. “AI Song Generator Startups Suno and Udio Angered the Music Industry. Now They’re Hoping to Join It.” Associated Press, 25 de febrero de 2026. Associated Press
Las plataformas de generación musical por inteligencia artificial Suno y Udio se han convertido en dos de los actores más controvertidos del ecosistema tecnológico y cultural contemporáneo. Ambas empresas irrumpieron con herramientas capaces de crear canciones completas —incluyendo voz, instrumentación, arreglos y estilos específicos— a partir de simples instrucciones de texto, democratizando aparentemente la producción musical pero abriendo simultáneamente un profundo conflicto legal y ético con la industria discográfica tradicional.
El principal problema surgió cuando grandes sellos como Universal Music Group, Warner Music Group y Sony Music Entertainment demandaron a ambas compañías alegando que habían entrenado sus modelos utilizando grabaciones protegidas por derechos de autor sin autorización previa. La acusación sostiene que millones de canciones pertenecientes a catálogos comerciales fueron incorporadas a los sistemas de entrenamiento algorítmico, permitiendo a estas herramientas reproducir patrones estilísticos extremadamente similares a artistas reales, sin compensar a compositores, intérpretes o productores originales.
A partir de estas demandas, ambas compañías tomaron caminos parcialmente distintos. Udio optó por una estrategia de conciliación y alcanzó acuerdos de licencia con varios grandes sellos, transformándose progresivamente en una plataforma más integrada dentro del negocio musical tradicional. Suno, por el contrario, mantuvo durante más tiempo una estrategia jurídica basada en defender que el entrenamiento algorítmico constituye un caso de fair use (uso legítimo), una posición que podría tener consecuencias judiciales decisivas para toda la industria de inteligencia artificial generativa.
Sin embargo, la controversia no terminó con los acuerdos entre empresas tecnológicas y discográficas. En junio de 2026, la American Federation of Musicians presentó una nueva demanda contra Universal y Warner alegando que los acuerdos alcanzados con Suno y Udio beneficiaron económicamente a las grandes compañías discográficas, pero excluyeron a miles de músicos de sesión cuyas interpretaciones originales fueron utilizadas para entrenar los sistemas. El sindicato sostiene que los artistas no recibieron compensación ni reconocimiento por un uso comercial completamente nuevo de sus grabaciones.
GEMA, la entidad alemana encargada de gestionar y recaudar derechos de autor musicales, también demandó a Suno, acusándola de generar composiciones demasiado similares a canciones conocidas como Mambo No. 5 de Lou Bega y Forever Young del grupo Alphaville.
Más de mil músicos, entre ellos Kate Bush, Annie Lennox y Damon Albarn, publicaron un álbum en silencio como forma de protesta contra los cambios propuestos en la legislación del United Kingdom sobre inteligencia artificial, al considerar que estas modificaciones podrían debilitar su control creativo sobre sus propias obras.
Al mismo tiempo, otros artistas como will.i.am, Timbaland e Imogen Heap han mostrado una postura favorable y han adoptado esta tecnología como una nueva herramienta de creación musical.
El caso ilustra una transformación estructural en la industria musical. La inteligencia artificial ya no aparece solamente como una herramienta experimental, sino como un agente capaz de alterar profundamente la creación artística, los modelos de negocio y la propia definición de autoría. Mientras algunos músicos consideran estas plataformas una amenaza directa al trabajo creativo humano, otros defienden que pueden convertirse en instrumentos complementarios de producción musical, del mismo modo que en el pasado lo fueron los sintetizadores, las cajas de ritmos o los programas de edición digital.
En un plano más amplio, el conflicto Suno-Udio representa uno de los primeros grandes laboratorios jurídicos donde se está definiendo el futuro de la relación entre creatividad humana e inteligencia artificial. Lo que decidan los tribunales sobre estas compañías probablemente sentará precedentes para otros sectores culturales como la literatura, el cine, el periodismo o la ilustración digital, donde el debate sobre entrenamiento algorítmico, copyright y compensación a los creadores se encuentra igualmente abierto. La música, una vez más, está funcionando como campo de prueba de las tensiones culturales que acompañan la revolución algorítmica contemporánea.
La emergencia de la inteligencia artificial generativa está reconfigurando de forma profunda el ecosistema del acceso al conocimiento, especialmente en relación con las llamadas shadow libraries (bibliotecas sombra) como Anna’s Archive, LibGen o Sci-Hub. El autor parte del contexto de una nueva oleada de litigios impulsados por grandes editoriales internacionales contra estas plataformas, que históricamente han sido vistas como espacios de acceso no autorizado a libros y artículos académicos. Sin embargo, el debate actual no se limita a la infracción de derechos de autor, sino que incorpora un elemento decisivo: su uso como fuentes de entrenamiento para modelos de lenguaje de gran escala (LLM).
El 6 de marzo, un importante grupo de editoriales, incluidas las cinco más grandes del mundo (Hachette, Penguin Random House, HarperCollins, Macmillan y Simon & Schuster), presentó una demanda ante un tribunal federal de Nueva York para intentar cerrar la biblioteca clandestina «Anna’s Archive». Décadas atrás, John Willinsky describió la publicación académica como su «momento Napster» con la aparición de sitios piratas como LibGen y Sci-Hub. La carrera por entrenar grandes modelos de lenguaje utilizando sitios como Anna’s Archive (sucesor de LibGen/Sci-Hub) se asemeja a una segunda etapa, donde estos sitios no solo sirven como canales para libros y artículos pirateados, sino también como fuentes de datos de entrenamiento para grandes modelos de lenguaje (LLM). Esto también se limita a las editoriales comerciales; HathiTrust informó recientemente que una gran parte de su colección fue obtenida y redistribuida en Anna’s Archive.
Las demandas contra bibliotecas clandestinas no son nuevas: editores y creadores llevan intentando eliminar obras creativas pirateadas de internet desde sus inicios, como lo demuestra la interminable lista de demandas publicadas en el blog Torrentfreak. En los últimos años, estas demandas han puesto de relieve el papel que desempeñan sitios como Anna’s Archive en el entrenamiento de grandes modelos de lenguaje (LLM), ya que «la actuación de los editores es ahora especialmente crucial a la luz de los informes que indican que Anna’s Archive anuncia activamente que proporcionará acceso de alta velocidad —y de hecho ya ha proporcionado— obras de autores robadas a desarrolladores de grandes sistemas de IA de modelos de lenguaje (LLM) y a intermediarios de datos»
El rápido ritmo del progreso tecnológico, sumado a la feroz competencia entre las empresas que desarrollan modelos de IA, ha generado un vacío ético, y países de todo el mundo se apresuran a desarrollar políticas para ponerse al día. Una de las muchas víctimas de este vacío son los autores y creadores, cuyas obras publicadas se han convertido en el principal material de entrenamiento para modelos de IA, frecuentemente sin recibir compensación alguna. Y dado que las grandes empresas tecnológicas detrás del desarrollo de la IA han adoptado un enfoque de entrenamiento similar al de Trump, han recurrido al pirateo de sitios web y bibliotecas clandestinas como Anna’s Archive para obtener datos de entrenamiento.
Esto, naturalmente, ha dado lugar a un sinfín de demandas y acusaciones. Por ejemplo, en el caso Kadrey contra Meta, se alegó que Meta entrenó su modelo de aprendizaje automático (LLM) con Books3, un conjunto de datos que incluía el texto completo de casi 200.000 libros pirateados. En esta decisión, Meta obtuvo una ajustada victoria, al determinarse que el uso de este conjunto de datos constituía un uso legítimo. Por otro lado, el caso Bartz et al. contra Anthropic PBC culminó en el mayor acuerdo de demanda colectiva por derechos de autor en la historia de Estados Unidos (1.500 millones de dólares). Los documentos judiciales de este caso ofrecen el ejemplo más claro del insaciable apetito de la IA por los datos de entrenamiento: además de contenido de bibliotecas clandestinas, Anthropic contrató a Tom Turvey, exdirector de alianzas del proyecto de digitalización de libros de Google, y le encargó obtener «todos los libros del mundo». Anthropic compró, digitalizó y destruyó millones de los libros impresos más utilizados y creó un gigantesco corpus electrónico que se planeaba que continuara indefinidamente. La liquidación de Anthropic se debió en gran medida al uso de una «biblioteca central» de obras pirateadas, a pesar de la sentencia del juez Alsup que dictaminó que el entrenamiento con libros adquiridos legalmente constituía un uso legítimo. Además, muchas otras empresas tecnológicas líderes, como Nvidia, Salesforce y Apple, han estado utilizando una estrategia similar para la formación de másteres en derecho (LLM).
Por supuesto, no son solo las grandes tecnológicas las que se benefician de esta situación. Grandes editoriales, incluidas algunas de las editoriales académicas más destacadas como Taylor & Francis y Wiley, han firmado importantes acuerdos de licencia para que grandes empresas tecnológicas utilicen sus publicaciones en el entrenamiento de IA. Los autores solo se enteran de estos acuerdos a través de artículos o comunicados de prensa. Cambridge University Press adoptó un modelo más progresista que permite a los autores optar por no permitir que su trabajo se utilice para entrenamiento, pagando además regalías. Estos son solo algunos ejemplos; para una lista más extensa, consulte el rastreador de acuerdos de licencia de IA generativa de Ithaka S+R. Esto refleja un cambio de perspectiva: las grandes editoriales se están convirtiendo menos en proveedoras de información y más en intermediarias de datos, al tiempo que investigan el desarrollo de sus propias herramientas y plataformas de IA que utilizan el contenido que poseen y licencian.
¿Qué implica esto para los autores y creadores? En este punto, es probable que muchas publicaciones en inglés, entradas de blog o publicaciones en internet se hayan utilizado como datos de entrenamiento para múltiples másteres en Derecho (LLM). Los autores que no desean que su contenido se utilice para entrenamiento tienen pocas opciones. Pueden publicar en plataformas que permiten a los autores optar por no participar, aunque esta opción no tiene mucho sentido si los datos de entrenamiento se obtienen de bibliotecas no oficiales. También pueden analizar los modelos de licenciamiento emergentes.
En este escenario, el artículo subraya que las bibliotecas piratas han pasado de ser únicamente mecanismos de distribución paralela de contenidos a convertirse en infraestructuras invisibles dentro de la economía de datos de la IA. Esta transformación intensifica el conflicto entre acceso abierto y propiedad intelectual, ya que las obras de autores y académicos no solo se consumen por lectores humanos, sino que también son absorbidas masivamente por sistemas automatizados sin compensación ni control efectivo. El texto destaca cómo esta dinámica ha generado una “zona gris ética y legal”, donde las fronteras entre uso legítimo, reutilización y explotación se vuelven cada vez más difusas.
Finalmente, el artículo plantea un problema de fondo para los autores contemporáneos: la pérdida de capacidad de control sobre sus obras en un entorno donde prácticamente todo contenido publicado puede haber sido ya incorporado a múltiples sistemas de IA. Frente a ello, se mencionan respuestas emergentes como nuevos modelos de licencia, mecanismos de “opt-out” y proyectos como Creative Commons Signals, aunque el autor se muestra escéptico respecto a su efectividad real frente a la escala y opacidad del entrenamiento de modelos de IA por parte de grandes empresas tecnológicas.
La cadena de noticias CNN ha presentado una demanda judicial contra la empresa de inteligencia artificial Perplexity AI, acusándola de infringir sistemáticamente los derechos de autor mediante la copia y redistribución de contenidos periodísticos. La demanda sostiene que Perplexity habría rastreado, extraído y reutilizado miles de artículos, vídeos e imágenes de CNN para alimentar sus sistemas de búsqueda y generación de respuestas basadas en inteligencia artificial.
Según la documentación judicial, CNN afirma haber identificado más de 17.000 ejemplos de contenido supuestamente utilizado sin autorización. La acusación no se limita al empleo de esos materiales para entrenar modelos de IA, sino que sostiene que las respuestas ofrecidas a los usuarios contienen fragmentos idénticos o sustancialmente similares a los artículos originales. En algunos casos, bastaría con introducir el título de una noticia para que el sistema devolviera extensos pasajes muy próximos al texto publicado por CNN, incluyendo contenidos protegidos por suscripción.
CNN argumenta que esta práctica socava el modelo económico del periodismo profesional. La cadena señala que sus noticias son fruto del trabajo de periodistas, investigadores, editores y productores que invierten recursos significativos en la creación de información original. Desde esta perspectiva, permitir que una plataforma de IA reproduzca esos contenidos sin licencia ni compensación económica equivaldría a apropiarse del valor generado por los medios de comunicación tradicionales.
Otro aspecto relevante del caso es que CNN asegura haber intentado previamente negociar con Perplexity un acuerdo de licencia para regular el uso de sus contenidos. Sin embargo, las conversaciones habrían terminado sin acuerdo a finales de 2025. Tras la ruptura de las negociaciones, CNN sostiene que la empresa continuó utilizando sus materiales y que incluso ignoró requerimientos formales para cesar dichas actividades.
Por su parte, Perplexity rechaza las acusaciones. La compañía mantiene que los hechos y la información en sí mismos no están protegidos por derechos de autor y que su tecnología se limita a recopilar, sintetizar y presentar información procedente de múltiples fuentes. Esta línea de defensa coincide con la utilizada por diversas empresas de inteligencia artificial que sostienen que existe una diferencia jurídica entre copiar una obra protegida y extraer hechos o conocimientos contenidos en ella.
La demanda de CNN se inscribe en un contexto más amplio de conflictos legales entre medios de comunicación y empresas de IA. En los últimos años, organizaciones como The New York Times, Reddit, Dow Jones, Merriam-Webster y Encyclopaedia Britannica han emprendido acciones similares, denunciando el uso no autorizado de sus contenidos para entrenar o alimentar sistemas de inteligencia artificial.
Más allá del caso concreto, el litigio plantea una cuestión fundamental para el futuro de la inteligencia artificial generativa: dónde se encuentra el límite entre el uso legítimo de información pública y la reproducción indebida de obras protegidas. El resultado de este y otros procedimientos judiciales podría definir las reglas de juego para la relación entre las empresas tecnológicas y los productores de contenido durante los próximos años, afectando tanto a la sostenibilidad económica del periodismo como al desarrollo de los sistemas avanzados de IA.