Archivo de la etiqueta: Ética de la información

El problema de la «validez sintética» en la investigación de IA.

Retraction Watch Staff, “AI research’s ‘synthetic validity’ problem”, Retraction Watch, 19 de septiembre de 2026. Artículo original en Retraction Watch

El problema ya no consiste únicamente en detectar artículos falsos o textos generados por IA. El reto es garantizar que los datos, métodos, referencias y evidencias que sustentan la investigación sean verificables y tengan validez respecto al fenómeno real que pretenden estudiar. La expansión de la IA hace que esta tarea sea todavía más importante.

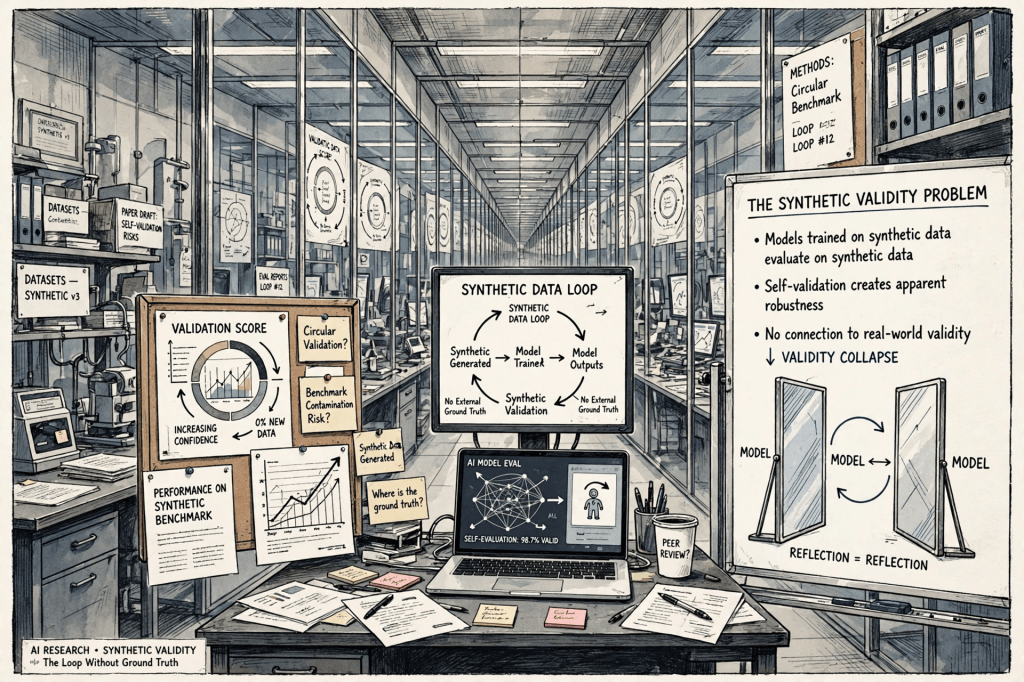
Especialmente relevante para el ámbito de la IA y la comunicación científica es la referencia al problema de la “synthetic validity”. El concepto alude a una dificultad creciente: los investigadores pueden utilizar modelos generativos para producir datos, participantes simulados, respuestas, textos u otros materiales que presentan una apariencia estadísticamente plausible, pero cuya correspondencia con el mundo real puede ser limitada. El problema no es solamente si los datos sintéticos son técnicamente coherentes, sino hasta qué punto permiten extraer conclusiones válidas sobre personas, comportamientos o fenómenos reales.

Esta cuestión adquiere especial importancia a medida que la IA generativa se incorpora a experimentos, encuestas, simulaciones y procesos de investigación. Una investigación puede obtener resultados internamente consistentes utilizando datos artificiales y, sin embargo, presentar una validez externa limitada. La posibilidad de generar grandes cantidades de respuestas sintéticas también puede facilitar estudios rápidos y baratos, pero introduce la necesidad de demostrar que los resultados no son simplemente un reflejo de los patrones incorporados en los propios modelos de IA.

La integridad científica depende de toda una cadena de controles, desde el diseño de la investigación y la recogida de datos hasta la revisión por pares, la publicación, las citaciones y la posterior corrección del registro científico. La aparición de la IA añade nuevas dificultades, pero no sustituye problemas tradicionales como las autorías fraudulentas, los datos inconsistentes, las referencias incorrectas o la ausencia de aprobación ética.

La IA introduce un nuevo problema: datos plausibles pero artificiales. La cuestión de la synthetic validity resulta particularmente importante para la alfabetización en IA. Un modelo generativo puede producir miles de respuestas aparentemente humanas y coherentes; sin embargo, que una respuesta sea verosímil no significa que represente a una población real. Esto obliga a los investigadores a diferenciar entre precisión estadística, coherencia interna y validez empírica.

Existe además el riesgo de crear un círculo de retroalimentación: los modelos se entrenan con datos producidos por seres humanos; posteriormente generan nuevos datos sintéticos; esos datos pueden utilizarse para entrenar, evaluar o alimentar otros modelos; y finalmente los resultados artificiales pueden volver a incorporarse al ecosistema científico. Si este proceso no se controla, la investigación podría terminar utilizando datos derivados de otros datos sintéticos sin una conexión suficientemente sólida con la realidad empírica original.

En investigación social, educativa o bibliométrica, por ejemplo, utilizar participantes sintéticos podría generar resultados que parecen convincentes pero que no necesariamente reproducen las características, sesgos y comportamientos de personas reales. El riesgo aumenta si los resultados generados artificialmente se utilizan posteriormente como evidencia para nuevas investigaciones. De este modo puede aparecer un círculo de retroalimentación en el que los modelos entrenados con información humana generan nuevos datos que posteriormente se utilizan para entrenar o evaluar otros modelos.

El artículo resulta especialmente útil porque conecta tres problemas que normalmente se analizan por separado: la integridad de las publicaciones, la creciente utilización de IA y la necesidad de preservar la confianza en el registro científico. Retraction Watch recuerda además que su base de datos ya supera las 67.000 retractaciones, una cifra que refleja la dimensión acumulativa de los mecanismos de corrección de la literatura científica.
La investigación fraudulenta no desaparece cuando se publica, sigue siendo citada

Retraction Watch, “Paper mill studies get cited by clinical guidelines, policy docs and more, analysis finds”, 17 de septiembre de 2026. El artículo analiza un estudio de Federica Silvi y Leslie D. McIntosh, de Digital Science, publicado como preprint en arXiv el 31 de agosto de 2026 https://retractionwatch.com/2026/09/17/paper-mill-studies-get-cited-by-clinical-guidelines-policy-docs-and-more-analysis-finds/

Según un nuevo análisis, los estudios producidos por una presunta «fábrica de artículos» (paper mill) aparecen citados con frecuencia en patentes, guías clínicas y documentos de políticas públicas.

El estudio analiza qué ocurre con artículos científicos vinculados a una “paper mill”, es decir, una empresa o red que comercializa manuscritos científicos, autorías o servicios destinados a introducir trabajos de dudosa procedencia en el sistema de publicación académica. El caso estudiado procede de la Pharmakon Neuroscience Network (PNN), una supuesta red científica que, según investigaciones anteriores, funcionaba como un sistema de venta de autorías. Los primeros artículos que incluían PNN entre sus afiliaciones comenzaron a aparecer en 2019 y presentaban algunas características habituales de las publicaciones sospechosas: grupos de autores de diferentes países sin antecedentes claros de colaboración, investigadores de campos muy distintos y combinaciones de autorías difíciles de explicar por una trayectoria científica convencional. 

Silvi y McIntosh estudiaron 1.975 artículos asociados a autores que habían utilizado PNN como afiliación y utilizaron la base de datos Dimensions para seguir las citas que recibieron posteriormente. El objetivo no era simplemente contar cuántos de esos artículos habían sido retractados, sino determinar hasta dónde había llegado su influencia dentro del ecosistema científico y académico. El resultado resulta especialmente relevante: 480 artículos fueron citados en patentes, 57 aparecieron citados en documentos de política pública y 12 fueron citados en guías clínicas.

El principal hallazgo del estudio es que una investigación cuestionable puede seguir circulando y adquiriendo influencia mucho después de haber sido producida. Una vez que un artículo entra en una base de datos bibliográfica, recibe citas y forma parte del corpus de literatura científica disponible, puede ser utilizado por investigadores que desconocen completamente su procedencia.

Esto crea un problema especialmente importante porque las citas pueden actuar como una especie de mecanismo de legitimación acumulativa. Un artículo puede ser citado porque parece relevante, después aparecer en una revisión de literatura, posteriormente ser utilizado por otro investigador y finalmente llegar a un documento normativo o una guía. En cada paso puede perderse información sobre la calidad o procedencia original de la investigación.

El estudio demuestra precisamente que la contaminación del registro científico no se limita a llenar las revistas de artículos problemáticos. Puede alcanzar productos derivados de la ciencia: patentes, documentos de política científica y sanitaria, guías clínicas y eventualmente decisiones relacionadas con financiación.

El problema adquiere una dimensión adicional con la expansión de la IA generativa. Las paper mills ya pueden utilizar herramientas automatizadas para producir textos, modificar manuscritos, generar imágenes o acelerar procesos de publicación. Investigaciones recientes sobre el mercado de venta de autorías muestran precisamente que el modelo de negocio está evolucionando y que la IA puede facilitar algunas de estas operaciones.

Esto puede crear un escenario especialmente complejo: más producción científica aparente, más velocidad de publicación y más dificultad para distinguir entre investigación auténtica y contenido fabricado.

Por ello, la integridad científica futura probablemente dependerá cada vez más de una combinación de revisión humana, análisis bibliométrico, detección de patrones de autoría, verificación de datos, transparencia sobre contribuciones y sistemas capaces de rastrear cambios en el estado de una publicación.

Hacia un estándar global para declarar el uso de la inteligencia artificial en la investigación científica

Weaver, Kari D.; Seghers, Bert; McNeice, Kiera; Perkins, Mike; Santamarina, Sergio; Lingard, Lorelei; Tsybuliak, Natalia; Dijstal, Felix. «Guest Post — Research Needs a Shared Standard for AI Disclosure.» The Scholarly Kitchen, 13 de julio de 2026. The Scholarly Kitchen (artículo original)

El artículo sostiene que la investigación científica necesita con urgencia un estándar internacional y compartido para declarar el uso de herramientas de inteligencia artificial (IA) durante todo el ciclo de investigación.

Los autores argumentan que la aparición de modelos generativos como ChatGPT ha modificado profundamente la forma en que los investigadores redactan textos, analizan datos, revisan literatura, programan o traducen documentos. Sin embargo, mientras la adopción de estas herramientas se ha generalizado, las normas para informar sobre su utilización continúan siendo fragmentarias, inconsistentes y, en muchos casos, inexistentes. Esta falta de uniformidad genera incertidumbre entre autores, revisores, editores e instituciones y pone en riesgo principios esenciales de la integridad científica, como la transparencia, la reproducibilidad y la responsabilidad sobre los resultados publicados.

Los autores defienden que la declaración del uso de la IA debe entenderse como una práctica equiparable a la divulgación de las fuentes de financiación, los conflictos de interés o las contribuciones de terceros. En su opinión, informar sobre la utilización de herramientas de IA no debe interpretarse como una admisión de debilidad o una sospecha de mala conducta, sino como una manifestación de buenas prácticas científicas. No obstante, diversos estudios muestran que muchos investigadores evitan revelar el uso de estas tecnologías por temor a que disminuya la credibilidad de sus trabajos o influya negativamente en los procesos de evaluación editorial. Este fenómeno ha creado una importante «brecha de divulgación»: aunque la IA ya forma parte de las prácticas habituales de investigación, una proporción significativa de autores nunca informa sobre su utilización al publicar sus resultados.

Para afrontar este problema, el artículo describe la iniciativa impulsada desde la World Conferences on Research Integrity (WCRI), que ha creado un grupo de trabajo internacional con el apoyo de organizaciones como el International Science Council (ISC), COPE, STM y la Global Young Academy. El objetivo consiste en desarrollar un estándar de referencia mundial para la declaración del uso de IA, inspirado en modelos ampliamente aceptados como las normas de Vancouver para publicaciones biomédicas. El proceso se basa en varias rondas de consulta internacional dirigidas a investigadores, editores, responsables de integridad científica y otros actores del ecosistema académico, con el propósito de construir un consenso amplio antes de proponer un marco definitivo.

Los resultados preliminares de la primera consulta muestran que existe un amplio consenso sobre la necesidad de establecer reglas claras, aunque también revelan importantes desafíos. Los participantes coinciden en que cualquier sistema de declaración debe ser suficientemente flexible para adaptarse a disciplinas muy diversas y evitar imponer cargas administrativas excesivas a los investigadores. Asimismo, consideran fundamental determinar con precisión qué aspectos deben declararse, cuál debe ser el nivel adecuado de detalle y cómo integrar esa información en los manuscritos y en las infraestructuras editoriales existentes. También se debatió ampliamente cuál debe ser el verdadero propósito de estas declaraciones: facilitar la reproducibilidad de la investigación, reforzar la transparencia ética, mejorar la rendición de cuentas o combinar todos estos objetivos simultáneamente.

Otro de los mensajes centrales del artículo es que el uso de la inteligencia artificial no debe ser estigmatizado. Los autores sostienen que las herramientas de IA representan una nueva generación de tecnologías avanzadas, pero que los principios clásicos de la integridad científica siguen siendo plenamente aplicables. La responsabilidad última sobre el contenido científico continúa recayendo en los investigadores humanos, independientemente de las herramientas empleadas durante el proceso. Por ello, las declaraciones sobre IA deberían proporcionar únicamente la información necesaria para que revisores y lectores puedan valorar si las contribuciones de estas herramientas podrían haber influido en la fiabilidad de los métodos, los resultados o las conclusiones del estudio, evitando exigir una documentación innecesariamente detallada que dificulte la investigación.

Finalmente, los autores anuncian la apertura de nuevas rondas de consulta durante la segunda mitad de 2026 y principios de 2027 con el objetivo de perfeccionar una propuesta de estándar global. Subrayan que el éxito de esta iniciativa dependerá de la participación activa de investigadores, universidades, editoriales, financiadores y organismos de integridad científica de todo el mundo. Solo mediante un consenso internacional será posible establecer un sistema de divulgación que promueva la confianza en la investigación, facilite la evaluación de los trabajos científicos y permita integrar la inteligencia artificial en la ciencia de forma responsable, transparente y compatible con los principios fundamentales de la investigación académica.

La compraventa de autorías científicas: un análisis de Nature destapa el mercado global del fraude académico

Research Information. 2026. “Paper Mills Expose Global Market for Authorship Fraud, Nature Analysis Finds.” Research Information, 27 de abril de 2026. https://www.researchinformation.info/news/paper-mills-expose-global-market-for-authorship-fraud-nature-analysis-finds

Un análisis publicado por Nature revela la existencia de un mercado internacional altamente organizado dedicado a la venta de autorías científicas, una de las manifestaciones más preocupantes del fraude en la comunicación académica. La investigación recopiló una base de datos con más de 18.700 anuncios publicados entre marzo de 2020 y abril de 2026 por siete grandes paper mills —empresas que producen artículos científicos fraudulentos o de escasa calidad y comercializan puestos de autoría—, poniendo de manifiesto que estas prácticas se han convertido en una industria transnacional con un elevado volumen económico.

El estudio muestra que el precio por ocupar la posición de primer autor oscila desde 57 dólares hasta más de 5.600 dólares, con una mediana cercana a los 800 dólares. Las ofertas se difundían principalmente mediante canales de Telegram y páginas web especializadas, dirigidas especialmente a investigadores sometidos a fuertes presiones para publicar, procedentes de regiones como Oriente Medio, Asia Central, Europa del Este e India. Además de artículos científicos, algunas organizaciones ofrecían también autorías en libros, patentes, premios académicos e incluso otros servicios destinados a mejorar artificialmente el prestigio profesional de los clientes.

Los investigadores sostienen que estos negocios van mucho más allá de la producción de manuscritos falsificados. En realidad, operan como empresas especializadas en la manipulación de la reputación científica, aprovechando un sistema académico donde las publicaciones siguen siendo el principal indicador para acceder a promociones, financiación y reconocimiento profesional. Esta dinámica alimenta un mercado que responde directamente a la presión del modelo de «publicar o perecer».

La investigación también demuestra que una parte de estos trabajos fraudulentos consigue superar los procesos editoriales y llegar a revistas científicas de prestigio. Al comparar cientos de anuncios con publicaciones reales, los autores identificaron 53 artículos publicados cuyos títulos coincidían con las ofertas de venta de autoría; únicamente cinco habían sido retractados. Entre las revistas afectadas aparecen publicaciones de grandes editoriales internacionales como Springer Nature, Wiley, Elsevier, Frontiers y Taylor & Francis, además de actas de congresos del IEEE, lo que evidencia que incluso los sistemas editoriales más consolidados siguen siendo vulnerables a estas prácticas.

El estudio concluyó que ocupar la posición de primer autor tiene un coste medio cercano a los 800 dólares, con precios que oscilan entre 57 y más de 5.600 dólares. Los resultados se describen en un preprint enviado al repositorio arXiv. La base de datos también pone de manifiesto el alcance internacional de las paper mills. Los investigadores localizaron anuncios en Telegram relacionados con operaciones en India, Irak y Uzbekistán, además de miles de anuncios procedentes de sitios web vinculados a empresas establecidas en Rusia, Letonia, Kazajistán y Ucrania. Las siete paper mills analizadas anunciaban la venta de puestos de autoría en artículos científicos, mientras que algunas también ofrecían la posibilidad de figurar como autores de libros de texto, patentes y otros productos académicos, además de servicio relacionados con la obtención de premios y reconocimientos académicos.

El análisis también sugiere que algunos manuscritos producidos por estas organizaciones llegan a publicarse. Los periodistas de Nature revisaron más de 600 anuncios vinculados a unos 400 artículos e identificaron 53 trabajos publicados cuyos títulos coincidían con los de los anuncios. Solo cinco de ellos habían sido retractados.

Los autores consideran que la base de datos recopilada puede convertirse en una herramienta valiosa para editores y editoriales científicas. El análisis de los anuncios permitirá desarrollar mecanismos automáticos para detectar manuscritos sospechosos, identificar revistas especialmente expuestas y comprender mejor las estrategias comerciales empleadas por estas organizaciones. En un contexto donde el fraude científico evoluciona rápidamente y se beneficia de nuevas tecnologías y plataformas digitales, disponer de este tipo de información resulta esencial para reforzar la integridad de la investigación y proteger la credibilidad de la literatura científica.

Declaración del uso de inteligencia artificial en la redacción de artículos académicos y tesis

Cabrera Huaycochea, Daril. 2025. Declaración del uso de inteligencia artificial en la redacción de artículos académicos y tesis: Hacia un estándar ético y transparente para la producción científica en la era de los modelos de lenguaje de gran escala. ResearchGate. Consultado el 30 de mayo de 2026.

Texto completo

La expansión de los modelos de lenguaje de gran escala, como GPT, Claude o Gemini, ha transformado profundamente la producción académica, facilitando tareas como la redacción, la síntesis bibliográfica y la revisión textual. Sin embargo, este avance tecnológico no ha ido acompañado de normas homogéneas para declarar su utilización, generando importantes desafíos éticos relacionados con la transparencia, la autoría y la evaluación del mérito académico. El artículo de analiza esta problemática y propone un marco estandarizado para la declaración del uso de inteligencia artificial en artículos científicos y tesis.

El autor examina las políticas adoptadas por algunas de las principales instituciones y editoriales científicas internacionales, entre ellas arXiv, Elsevier, Nature y el Comité de Ética en Publicaciones (COPE). Aunque existen diferencias en los procedimientos, todas coinciden en dos principios fundamentales: las herramientas de inteligencia artificial no pueden ser consideradas autoras de trabajos académicos y cualquier utilización relevante debe ser declarada de manera explícita. Estas organizaciones subrayan que la responsabilidad sobre la exactitud, integridad y ética de los contenidos recae siempre en los autores humanos.

Uno de los principales aportes del trabajo es la formulación de una taxonomía de cuatro niveles de declaración. El Nivel 1 corresponde a trabajos elaborados sin IA generativa; el Nivel 2 contempla el uso de herramientas para corrección gramatical y estilística; el Nivel 3 incluye la generación de borradores, síntesis o análisis supervisados por los autores; y el Nivel 4 se refiere a aquellos casos en los que la IA participa de forma sustancial en la estructura argumentativa o conceptual del trabajo. El objetivo de esta clasificación no es juzgar moralmente los distintos usos de la tecnología, sino ofrecer un marco de transparencia que permita comprender el grado de intervención tecnológica en cada investigación.

El artículo también proporciona modelos prácticos de declaración para revistas científicas y tesis universitarias. Estas plantillas buscan facilitar la adopción de estándares comunes que permitan describir qué herramientas se utilizaron, en qué fases del proceso participaron y qué mecanismos de revisión humana se aplicaron posteriormente. Según el autor, la normalización de estas declaraciones contribuiría a reducir la ambigüedad normativa y fomentaría una cultura de integridad académica basada en la transparencia y la responsabilidad.

Se presta especial atención al contexto latinoamericano, donde identifica importantes desafíos relacionados con la desigualdad en el acceso a tecnologías avanzadas, la obsolescencia de los reglamentos universitarios y los sesgos lingüísticos de los modelos entrenados principalmente en inglés. Ante esta situación, propone que las universidades actualicen sus normativas y distingan claramente entre el uso declarado de la inteligencia artificial y el fraude académico por ocultamiento u omisión. La conclusión central del trabajo es que el verdadero debate no debe centrarse en prohibir o permitir la IA, sino en garantizar que su utilización sea transparente, verificable y compatible con los principios fundamentales de la integridad científica.

Los envíos de artículos científicos crecen un 33 %: ¿auge de la investigación o invasión de textos generados por IA?

Humanoid robot writing notes on scientific papers about AI and genomics at a desk

Dahl, Josh. “Guest Post — Is Growth Always Good News? 2026 Article Submission Surges.” The Scholarly Kitchen, 13 de mayo de 2026. The Scholarly Kitchen

Se analiza el extraordinario aumento de manuscritos enviados a revistas científicas durante el primer trimestre de 2026 y plantea una cuestión fundamental para el ecosistema académico: si este crecimiento representa una expansión saludable de la investigación mundial o, por el contrario, una señal de deterioro estructural provocada por el uso masivo de herramientas de inteligencia artificial generativa.

El texto parte de un dato especialmente significativo: la plataforma ScholarOne Manuscripts registró un incremento del 33 % en los envíos de artículos respecto al mismo periodo de 2025. Lo más preocupante no es únicamente el volumen absoluto, sino la aceleración del crecimiento, ya que el aumento interanual prácticamente se duplicó respecto al año anterior, pasando del 17 % al 33 %. Dahl interpreta este fenómeno como un indicador de tensión extrema en el sistema editorial científico, especialmente en aquellas revistas con menos recursos para detectar trabajos problemáticos o de baja calidad.

Uno de los aspectos centrales del análisis es la relación entre el auge de la inteligencia artificial y el incremento de manuscritos enviados. El autor sostiene que los datos por sí solos no permiten demostrar que el crecimiento proceda directamente de textos generados mediante IA, pero sí revelan patrones compatibles con ello. Según Dahl, muchas revistas están recibiendo trabajos elaborados parcialmente con herramientas generativas, lo que multiplica la producción textual y reduce las barreras técnicas para redactar artículos académicos. Este fenómeno estaría alterando profundamente la economía de la publicación científica y la dinámica tradicional de la autoría académica.

El artículo destaca además un incremento notable de los “desk rejections” o rechazos editoriales preliminares. Entre 2022 y 2025 estos rechazos crecieron un 72 %, muy por encima del crecimiento total de decisiones editoriales. Esto significa que los equipos editoriales están dedicando cada vez más tiempo a filtrar trabajos que consideran insuficientes, irrelevantes o problemáticos antes incluso de enviarlos a revisión por pares. Para Dahl, este dato evidencia que el sistema de control de calidad está sometido a una presión creciente y que la carga de trabajo editorial se está desplazando hacia fases previas del proceso de evaluación.

Otro elemento especialmente relevante es la reflexión sobre el “contrato social” de la revisión por pares. El autor sostiene que el problema principal no es tecnológico, sino epistemológico y ético. Tradicionalmente, el sistema científico se basaba en la idea de que el investigador era plenamente responsable del contenido que enviaba: conocía las fuentes, defendía los argumentos y comprendía la metodología empleada. Sin embargo, con la IA generativa esa relación entre autor y texto se vuelve difusa. Dahl plantea que actualmente no existe un consenso claro sobre qué nivel de asistencia artificial resulta aceptable y cuál compromete la integridad académica.

El texto utiliza como ejemplo el problema de las referencias bibliográficas inventadas por modelos de lenguaje. Un investigador puede generar un borrador mediante IA y no detectar que algunas citas son ficticias. En este caso, el autor no falsifica deliberadamente la información, pero termina enviando un manuscrito con errores graves. Dahl argumenta que las declaraciones tradicionales de autoría y responsabilidad no están preparadas para afrontar este nuevo escenario, donde los límites entre asistencia técnica y creación intelectual son cada vez más ambiguos.

La reflexión conecta con un debate más amplio sobre la sostenibilidad de la revisión por pares en un contexto de crecimiento acelerado de publicaciones. El artículo se relaciona con otras discusiones recientes de The Scholarly Kitchen sobre la saturación editorial y la capacidad del sistema científico para absorber el volumen actual de investigación. En textos complementarios publicados en 2026 se insiste en que la revisión por pares atraviesa una crisis de capacidad, con revisores agotados, plazos más cortos y expectativas cada vez más difíciles de cumplir.

Asimismo, Dahl sugiere que el fenómeno no puede entenderse únicamente desde la tecnología. El crecimiento de manuscritos también refleja las presiones estructurales del modelo académico contemporáneo: la lógica del “publish or perish”, la evaluación basada en métricas, la expansión global de la investigación y la creciente competencia por financiación y reconocimiento profesional. En este contexto, la IA actúa como acelerador de dinámicas ya existentes más que como causa exclusiva del problema.

En conjunto, el artículo ofrece una mirada crítica y muy actual sobre la transformación del ecosistema editorial científico. Más que condenar la inteligencia artificial, plantea la necesidad urgente de redefinir las normas de autoría, responsabilidad y validación del conocimiento académico. Dahl concluye implícitamente que el desafío fundamental no consiste solo en detectar textos generados por IA, sino en reconstruir la confianza y los mecanismos de legitimación sobre los que históricamente se ha sostenido la comunicación científica.

Uno de cada 277 artículos indexados en PubMed en 2026 muestra referencias fabricadas por una IA

Retraction Watch. “One in 277 PubMed-indexed Papers in 2026 Shows Fabricated References, Says Analysis.” Retraction Watch, 7 de mayo de 2026. https://retractionwatch.com/2026/05/07/one-in-277-pubmed-indexed-papers-in-2026-shows-fabricated-references-says-analysis/

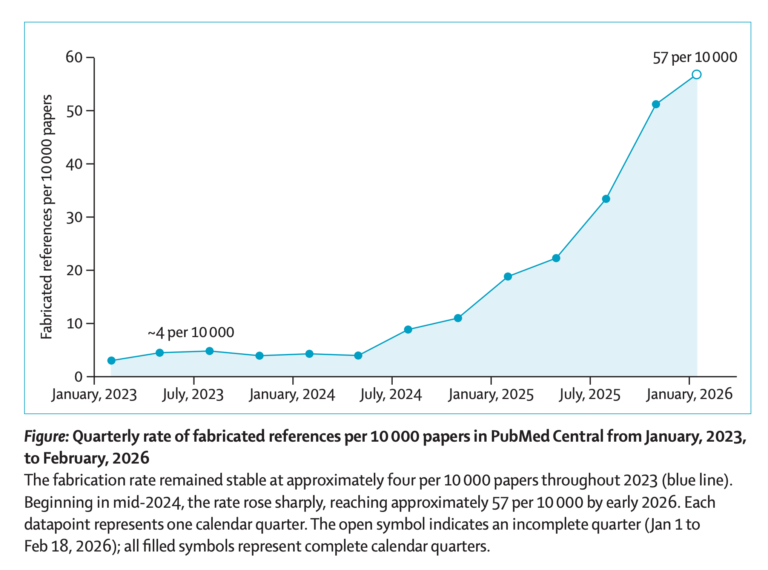
Un análisis reciente difundido por Retraction Watch advierte de un crecimiento muy acusado de las referencias bibliográficas falsas dentro de la literatura biomédica indexada en PubMed. El estudio, presentado en forma de carta en The Lancet, examinó cerca de 2,5 millones de artículos científicos y concluyó que las citas inventadas se han multiplicado por doce en apenas dos años.

Los investigadores detectaron que aproximadamente uno de cada 277 artículos publicados en las primeras siete semanas de 2026 incluía al menos una referencia a un trabajo inexistente. La comparación histórica muestra una escalada preocupante: en 2025 la proporción era de uno entre 458, mientras que en 2023 era de uno entre 2.828. Esto sugiere que el fenómeno no es marginal, sino creciente y sistemático.

El equipo estuvo liderado por Maxim Topaz, del Data Science Institute de la Universidad de Columbia. Para separar errores tipográficos o abreviaturas irregulares de verdaderas invenciones bibliográficas, los autores emplearon herramientas de inteligencia artificial capaces de contrastar títulos y registros reales. Esto permitió identificar con mayor precisión qué citas eran simplemente incorrectas y cuáles correspondían a documentos inexistentes.

Según el informe, el aumento más brusco comenzó a mediados de 2024, coincidiendo con la expansión masiva de herramientas de escritura asistida por IA generativa. El artículo relaciona este crecimiento con el uso inadecuado de modelos de lenguaje capaces de producir referencias aparentemente verosímiles, aunque inexistentes, si no se supervisan correctamente.

Las implicaciones son profundas para la comunicación científica. Las referencias falsas contaminan revisiones bibliográficas, dificultan la verificación de fuentes y erosionan la confianza en el sistema académico. El caso refuerza la necesidad de controles editoriales más estrictos, verificadores automáticos de citas y formación ética en el uso de IA para la redacción científica.

Publicación académica en la era de la IA: del valor del contenido a valor de la confianza como nuevo eje del sistema científico

“Academic Publishing in the Age of AI: From Content to Trust.” The Scholarly Kitchen, 22 de abril de 2026. https://scholarlykitchen.sspnet.org/2026/04/22/academic-publishing-in-the-age-of-ai-from-content-to-trust/.

La inteligencia artificial no debe entenderse simplemente como una herramienta que mejora la productividad en la publicación académica, sino como un cambio estructural profundo en la forma en que circula el conocimiento. Este cambio afecta directamente a cómo se construye, valida y percibe la autoridad científica. En otras palabras, la IA no solo acelera procesos, sino que transforma los mecanismos mediante los cuales se genera credibilidad en la ciencia.

Tradicionalmente, el sistema de publicación académica ha estado centrado en el contenido: artículos, libros o datasets evaluados mediante revisión por pares. Sin embargo, en un entorno donde la IA puede generar textos científicos, resumir investigaciones o incluso producir resultados plausibles a gran escala, el contenido en sí mismo deja de ser un indicador suficiente de calidad. El artículo sostiene que estamos transitando hacia un modelo donde lo fundamental ya no es tanto “qué se publica”, sino “en quién confiar” y “cómo se valida” lo publicado.

La IA se integrará en el flujo de trabajo de la investigación. Lo más importante de la IA no es que los científicos la «usen»; La IA se integrará en la infraestructura científica misma. Ya observamos indicios tempranos: automatización del flujo de trabajo de investigación, herramientas de selección de manuscritos, controles de integridad de la investigación, herramientas de redacción científica y revisión por pares asistida por IA. Estos sistemas y herramientas se integrarán cada vez más y será más difícil separarlos de los flujos de trabajo que respaldan.

Con el tiempo, la IA estará presente en todo el ciclo de vida de la investigación, ayudando en la planificación de experimentos, la optimización de protocolos, el análisis de datos, la detección de anomalías y el reconocimiento de patrones. La IA ya se está integrando en la mayoría de las plataformas de publicación, sistemas de revisión por pares e interfaces de descubrimiento, aunque el proceso aún es incipiente. Editores, revisores y autores inevitablemente utilizarán la IA cada vez más para mejorar la productividad, pulir manuscritos e informes de revisión, así como para seleccionar y preparar manuscritos en las diferentes etapas del flujo de trabajo de publicación.

De ello se deduce que, a medida que el contenido se vuelve barato, el escepticismo es esencial, pero costoso.

  • La gente dejará de preguntarse: «¿Está bien escrito?». y comenzarán a preguntarse: «¿Es esto real?».
  • Dejarán de preguntar «¿Está publicado?» y empezarán a preguntarse «¿Está manipulado?».
  • La pregunta cambia de «¿Es convincente?» a «¿Puedo confiar en ello?».

En este nuevo escenario, los marcadores tradicionales de confianza —como la autoría, la afiliación institucional o la revisión por pares— se ven tensionados. La facilidad con la que la IA puede generar textos convincentes introduce riesgos de saturación informativa, manipulación o pérdida de integridad científica. Por ello, los sistemas de publicación deben evolucionar para reforzar nuevas formas de señalización de credibilidad, incluyendo mayor transparencia en los procesos, trazabilidad de los contenidos y mecanismos más robustos de validación.

El texto también sugiere que el papel de los editores, revisores y plataformas de publicación podría transformarse profundamente. Más que simples intermediarios del contenido, pasarán a ser garantes de confianza, responsables de establecer y mantener estándares que permitan distinguir conocimiento fiable en un entorno saturado de producción automatizada. Esto implica repensar infraestructuras, políticas editoriales y modelos de evaluación científica.

El artículo apunta a una reconfiguración del ecosistema académico en su conjunto. La IA desplaza el foco desde la producción hacia la curación, la validación y la gobernanza del conocimiento, lo que podría redefinir el valor de instituciones como universidades, editoriales y bibliotecas. En este contexto, el desafío central no será generar más información —algo que la IA ya hace con gran eficiencia—, sino asegurar que esa información sea fiable, verificable y socialmente legítima.

La divulgación del uso de inteligencia artificial en la publicación académica: hacia estándares de transparencia disciplinar

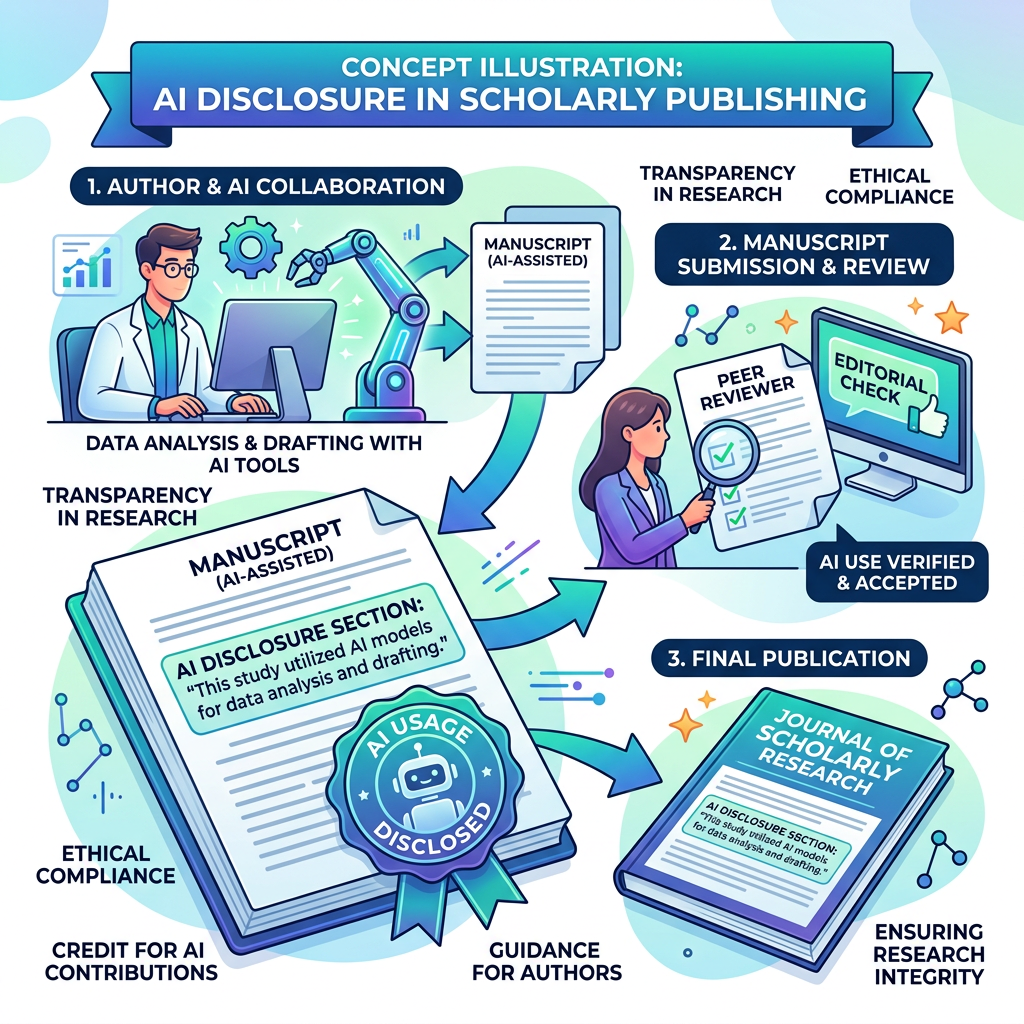
Flowchart of AI disclosure in scholarly publishing including author collaboration, manuscript review, and final publication.
Illustration showing AI disclosure steps for ethical scholarly publishing.

LaFlamme, Marcel, y Natalie Meyers. Enacting AI Disclosure in Scholarly Publishing. Preprint, Open Anthropology Research Repository (OARR), 2025.

Acceso al documento

El artículo aborda un fenómeno emergente en la comunicación científica contemporánea: la creciente exigencia de que los autores académicos declaren si han utilizado inteligencia artificial generativa (IA) y de qué manera en la elaboración de sus trabajos. Los autores sitúan esta cuestión en un contexto de rápida expansión de herramientas de IA en la investigación y la escritura académica, lo que ha generado nuevas tensiones en torno a la transparencia, la autoría y la responsabilidad intelectual. En este escenario, la divulgación del uso de IA se perfila como una práctica clave para mantener la integridad del sistema científico, aunque todavía carece de estándares homogéneos y plenamente consolidados.

El texto ofrece un mapa del panorama actual de prácticas de divulgación y atribución de la IA, mostrando que estas se encuentran en una fase incipiente, caracterizada por la diversidad de enfoques entre editoriales, disciplinas y organismos reguladores. Los autores destacan que, aunque existe un consenso general en torno a la necesidad de transparencia, las formas concretas de declarar el uso de IA —qué se debe declarar, cómo hacerlo y en qué parte del artículo— siguen siendo objeto de debate. Esta falta de estandarización genera incertidumbre tanto para autores como para editores, y dificulta la comparabilidad entre publicaciones.

Un aspecto central del artículo es su enfoque disciplinar, particularmente en relación con la antropología. Los autores sostienen que cualquier modelo de divulgación de IA debe adaptarse a los compromisos epistemológicos y éticos específicos de cada campo, en lugar de aplicarse de manera uniforme. En disciplinas como la antropología, donde la interpretación, la reflexividad y la relación con los sujetos de estudio son fundamentales, el uso de IA plantea cuestiones adicionales sobre la mediación tecnológica en la producción de conocimiento. Por ello, la divulgación no debe entenderse solo como un requisito técnico, sino como una práctica situada que refleja valores disciplinares.

El artículo también propone recomendaciones concretas para implementar la divulgación de IA, basadas en prácticas ya existentes en la publicación académica. Entre ellas, se sugiere integrar la información sobre el uso de IA en secciones ya consolidadas, como la metodología o los agradecimientos, así como desarrollar descripciones claras del tipo de uso realizado (por ejemplo, edición lingüística, generación de texto o análisis de datos). Estas recomendaciones buscan evitar soluciones completamente nuevas y, en su lugar, aprovechar infraestructuras editoriales ya establecidas para facilitar la adopción de la transparencia.

Además, el trabajo amplía su perspectiva más allá del ámbito editorial para analizar cómo la exigencia de divulgar el uso de IA está siendo codificada en distintos niveles —profesionales, institucionales y regulatorios—. Esto permite entender la divulgación no solo como una práctica académica, sino como parte de una tendencia más amplia hacia la rendición de cuentas en el uso de tecnologías automatizadas. En este sentido, las decisiones que tomen las disciplinas individuales deben interpretarse dentro de un ecosistema global en el que la transparencia tecnológica se está convirtiendo en un principio normativo transversal.

En conjunto, el artículo defiende que la divulgación del uso de IA no es simplemente una cuestión administrativa, sino un elemento crucial para preservar la confianza en la investigación, clarificar la autoría humana y hacer visibles los procesos de producción del conocimiento. Sin embargo, advierte que el desafío no radica únicamente en exigir transparencia, sino en diseñar modelos de divulgación que sean significativos, consistentes y sensibles a las particularidades de cada disciplina.

Las humanidades y la humanidad en un mundo de IA: un manifiesto para educadores

Real Discussion. “Humanities and Humanity in an AI World: An Educator’s Manifesto.” Real Discussion. Accedido abril de 2026.

Texto completo

El manifiesto se articula como una llamada a la acción: recuperar el valor de lo humano en un entorno tecnológico acelerado. Propone que la educación del futuro debe centrarse en formar ciudadanos capaces de convivir con la inteligencia artificial sin perder su capacidad de juicio, su sensibilidad ética y su creatividad. En última instancia, sostiene que el objetivo no es competir con las máquinas, sino reafirmar aquello que nos hace irreductiblemente humanos: la capacidad de pensar, sentir, interpretar y dar sentido al mundo.

El manifiesto plantea una defensa firme del papel de las humanidades en un mundo cada vez más dominado por la inteligencia artificial, subrayando que el verdadero desafío no es tecnológico, sino profundamente humano. En este contexto, la educación se convierte en el principal campo de batalla donde se decide si la IA será una herramienta al servicio del desarrollo humano o un sustituto de capacidades esenciales como el pensamiento crítico, la creatividad y la reflexión ética. El texto advierte que el riesgo no reside únicamente en la automatización, sino en la posible delegación de procesos cognitivos fundamentales a sistemas algorítmicos, lo que podría empobrecer la experiencia educativa y reducir la autonomía intelectual de los estudiantes.

El documento insiste en que las humanidades —filosofía, literatura, historia, artes— no son disciplinas accesorias, sino el núcleo que permite interpretar el mundo, cuestionarlo y dotarlo de significado. Frente a una IA capaz de generar respuestas rápidas y aparentemente coherentes, el manifiesto reivindica la lentitud del pensamiento crítico, la ambigüedad como espacio de aprendizaje y el error como parte indispensable del proceso educativo. En este sentido, alerta sobre el peligro de que los estudiantes utilicen la inteligencia artificial como sustituto del esfuerzo intelectual, debilitando su capacidad para argumentar, analizar y crear conocimiento propio.

Asimismo, el manifiesto propone una pedagogía renovada que no rechaza la inteligencia artificial, pero sí exige una integración consciente y crítica. La IA debe ser utilizada como apoyo, nunca como reemplazo del pensamiento humano. Esto implica rediseñar las metodologías educativas para priorizar habilidades que las máquinas no pueden replicar plenamente, como la empatía, el juicio ético, la interpretación contextual y la imaginación. En esta línea, coincide con otros enfoques humanistas que subrayan que la educación no puede reducirse a eficiencia o productividad, sino que debe cultivar la dimensión moral y relacional del ser humano.

Otro eje fundamental del texto es la defensa de la autonomía del profesorado. Los docentes no deben convertirse en meros supervisores de herramientas tecnológicas, sino seguir siendo guías intelectuales capaces de orientar el aprendizaje desde una perspectiva crítica. El manifiesto advierte que una adopción acrítica de la IA en el aula puede desplazar la autoridad pedagógica hacia sistemas automatizados diseñados por grandes corporaciones, lo que plantea riesgos no solo educativos, sino también políticos y culturales.