Archivo de la etiqueta: Visibilidad

Las máquinas también son audiencia: cómo adaptar la comunicación institucional a la inteligencia artificial

Speaker presenting artificial intelligence communication strategies beside humanoid robots
A speaker presents institutional communication strategies for artificial intelligence to an audience alongside humanoid robots.

Pew Research Center. (2026, 1 de octubre). Welcoming machines as audience: A guide for nonprofit communicators thinking about AI. Pew Research Center. Consultar artículo original

PDF

La idea fundamental es que la visibilidad institucional está cambiando: ya no basta con estar presente en Internet, también hay que ser comprensible, recuperable y reconocible para la inteligencia artificial. Las bibliotecas tienen aquí una nueva responsabilidad como intermediarias entre el conocimiento publicado, los sistemas inteligentes y los ciudadanos.

Se presenta una guía del Pew Research Center dirigida a profesionales de la comunicación de organizaciones sin ánimo de lucro, con recomendaciones para adaptar sus estrategias a un escenario en el que la inteligencia artificial se ha convertido en intermediaria entre las fuentes de información y los ciudadanos. Los usuarios recurren cada vez más a herramientas como ChatGPT y otros asistentes inteligentes para buscar información, resolver dudas y conocer el trabajo de diferentes instituciones. Este cambio está modificando la manera en que las personas descubren, interpretan y confían en los contenidos publicados en Internet.

La idea central es que las organizaciones ya no deben pensar exclusivamente en las personas como destinatarias de sus contenidos, sino también en los sistemas de inteligencia artificial que rastrean, interpretan, seleccionan y presentan esa información. Esto significa que las instituciones deben aprender a comunicar simultáneamente para dos públicos: los lectores humanos y las máquinas que procesan sus contenidos. La presencia de una organización en los resultados de los buscadores tradicionales ya no garantiza que también aparezca en las respuestas generadas por los asistentes de IA.

El documento propone una estrategia estructurada en tres líneas de actuación: aceptar, adaptar y avanzar (Accept, Adapt, Advance).

– Aceptar (Accept): reconocer que la inteligencia artificial ha llegado para quedarse y que una parte de los usuarios ya utiliza estos sistemas para acceder a la información. Las organizaciones deben asumir que este comportamiento puede afectar al tráfico directo hacia sus páginas web y a la manera en que se distribuyen sus contenidos.

– Adaptar (Adapt): analizar cómo aparecen actualmente los contenidos institucionales en las respuestas de los sistemas de IA. Se recomienda realizar pruebas con preguntas reales relacionadas con la actividad de la organización, utilizando diferentes plataformas. Es importante comprobar si la institución aparece mencionada, si sus documentos son citados y si se incluyen enlaces que permitan acceder a las fuentes originales.

– Avanzar (Advance): incorporar los resultados de estas evaluaciones a las futuras estrategias de comunicación. Esto implica mejorar la estructura, los metadatos y la accesibilidad de los contenidos para facilitar su interpretación por parte de los sistemas automatizados, sin descuidar las necesidades de los lectores humanos.

La guía incluye una lista de comprobación con recomendaciones prácticas. En primer lugar, propone decidir si interesa que los chatbots de inteligencia artificial utilicen y difundan los contenidos de la organización. Esta decisión debe estar vinculada a sus objetivos institucionales, identificando qué investigaciones, servicios, productos y públicos interesa hacer más visibles. También se debe definir qué resultados se esperan: respuestas precisas, atribución correcta de la autoría y enlaces que conduzcan a la fuente original.

En segundo lugar, recomienda evaluar la visibilidad institucional en los sistemas de IA mediante entre 10 y 20 preguntas reales que deberían permitir localizar los conocimientos, investigaciones o datos de la organización. Estas consultas deben probarse en distintas plataformas, registrando si la institución aparece, si recibe citas y enlaces y si la información recuperada es actual, correcta y completa. También conviene identificar errores, referencias desactualizadas, omisiones y problemas de atribución, repitiendo periódicamente las pruebas para observar la evolución.

Otro aspecto fundamental es la denominada legibilidad para las máquinas (machine readability). Pew Research Center recomienda que los datos representados en gráficos estén disponibles también como texto, que los metadatos describan claramente los temas, autores, periodos temporales y conjuntos de datos, y que los informes importantes dispongan de versiones en texto plano o Markdown. Asimismo, aconseja revisar las páginas web para detectar elementos que puedan dificultar el rastreo, la interpretación o la recuperación de la información por parte de los sistemas automatizados.

Finalmente, el documento propone medir los resultados mediante tres indicadores principales: visibilidad, precisión y generación de tráfico. No basta con que una herramienta de IA mencione una institución; también debe representar correctamente su información y facilitar el acceso a sus contenidos originales. Para ello, recomienda establecer responsables de seguimiento y realizar evaluaciones periódicas en las principales plataformas.

Lista de comprobación práctica para profesionales de organizaciones sin ánimo de lucro

1. ¿Quieres que las personas utilicen chatbots de inteligencia artificial para encontrar y conocer el trabajo de tu organización?

  • Analiza cómo la visibilidad en los sistemas de IA contribuye a la misión y a los objetivos de comunicación de tu organización.
  • Decide si quieres que los sistemas de inteligencia artificial accedan a tus contenidos y los muestren en sus respuestas.
  • Identifica los temas, productos y públicos para los que resulta más importante tener visibilidad en la IA.
  • Define los resultados que deseas conseguir: respuestas precisas, atribución clara de la autoría y enlaces que permitan regresar a tu organización y consultar sus fuentes originales.

2. ¿Cómo aparece actualmente tu trabajo en los sistemas de IA? ¿Es esa la visibilidad que deseas?

  • Selecciona entre 10 y 20 preguntas o instrucciones reales (prompts) que deberían permitir localizar tus conocimientos especializados, investigaciones o datos.
  • Prueba las mismas preguntas en diferentes plataformas de inteligencia artificial.
  • Registra si tu organización aparece mencionada, citada y enlazada.
  • Pide a un experto en la materia que evalúe si cada respuesta está actualizada y es precisa y completa.
  • Identifica patrones y problemas, como información desactualizada, atribuciones poco claras, enlaces ausentes o datos que los sistemas no consiguen recuperar.
  • Repite las pruebas periódicamente para comprobar qué aspectos cambian con el tiempo.

3. ¿Cómo puedes conseguir que tus contenidos sean legibles para las máquinas?

  • Adopta un flujo de trabajo simultáneo: continúa ofreciendo contenidos y servicios a las personas mientras preparas también la información para que pueda ser procesada por las máquinas.
  • Facilita que los datos y la información que aparecen en gráficos estén disponibles en formato de texto legible, y no únicamente como imágenes estáticas.
  • Mejora los metadatos para que los sistemas puedan identificar elementos como el tema, la población estudiada, los años que abarca la información, los informes, los conjuntos de datos y los autores.
  • Crea versiones en texto plano o Markdown de los principales informes para facilitar que las máquinas recuperen sus contenidos esenciales.
  • Audita tu sitio web para detectar cualquier elemento que pueda dificultar que los sistemas automatizados rastreen, interpreten o relacionen la información.

4. ¿Cómo puedes saber si estás teniendo éxito?

  • Comprueba que los motores de inteligencia artificial recuperan tu información (visibilidad), la representan correctamente (precisión) y generan tráfico hacia tu organización (enlaces).
  • Utiliza diferentes indicadores para evaluar los resultados, entre ellos pruebas basadas en preguntas (prompts), actividad de los rastreadores de IA, menciones, citas y tráfico procedente de referencias externas.
  • Designa a una persona responsable de realizar pruebas periódicas en las plataformas y modelos de inteligencia artificial más utilizados.
El efecto cocodrilo: cómo afrontar la amenaza de las búsquedas sin clic (zero-click search) y los resúmenes generados por inteligencia artificial en la publicación científica

Charlie Rapple. (4 de febrero de 2026). “Responding to the Threat of Zero-Click Search and AI Summaries: How Do We Tame the Crocodile?”. The Scholarly Kitchen. https://scholarlykitchen.sspnet.org/2026/02/04/responding-to-the-threat-of-zero-click-search-and-ai-summaries-how-do-we-tame-the-crocodile/

La visibilidad de una publicación ya no garantiza que los usuarios accedan a ella. En la era de los resúmenes generados por IA, las editoriales y las instituciones científicas necesitan nuevas formas de medir el impacto, preservar la atribución y mantener la confianza en las fuentes originales. Este fenómeno obliga a reconsiderar cómo se evalúa el uso de los recursos electrónicos, cómo se enseña a verificar las fuentes citadas por sistemas de IA y cómo se mantiene el acceso a los documentos originales. Para las bibliotecas, resulta fundamental fomentar una alfabetización informacional que enseñe a distinguir entre una respuesta sintetizada y la consulta directa de la evidencia científica que la sustenta.

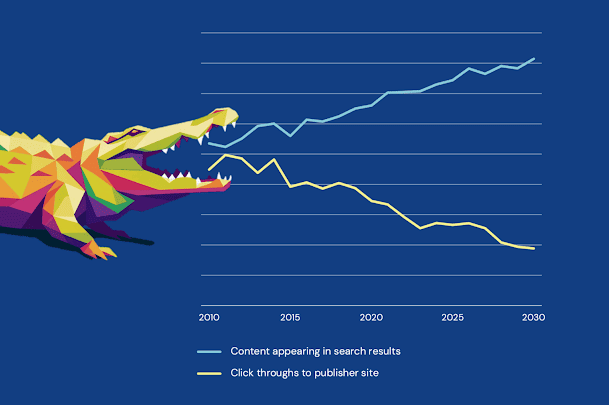
Se analiza una transformación que afecta directamente a la publicación científica: el crecimiento de las búsquedas sin clic (zero-click search), en las que los usuarios obtienen respuestas directamente en la página de resultados de un buscador, sin acceder al sitio web que contiene la información original. Esta tendencia se ha intensificado con los resúmenes generados mediante inteligencia artificial, los paneles de respuestas y los navegadores que sintetizan información procedente de múltiples fuentes. La autora denomina a este fenómeno Crocodile Effect o «efecto cocodrilo», una metáfora que describe la separación creciente entre las veces que un contenido aparece en los resultados de búsqueda y las visitas que recibe la página original. Aunque los contenidos continúan teniendo visibilidad, cada vez menos usuarios pueden llegar a consultarlos directamente.

El fenómeno supone un desafío económico para las editoriales académicas. Las visitas y las descargas se utilizan habitualmente para demostrar el valor de las publicaciones, justificar renovaciones de suscripciones y acreditar el interés de los lectores. Si los usuarios reciben respuestas resumidas sin visitar las páginas originales, disminuye el tráfico y puede debilitarse la capacidad de las editoriales para demostrar el impacto de sus contenidos. La autora menciona como ejemplo las declaraciones de John Campbell, de Oxford University Press, quien atribuyó a las búsquedas sin clic una reducción del 19 % en las visitas a sus contenidos de referencia académica. También recoge un estudio publicado en octubre de 2025 según el cual más de la mitad de las búsquedas en Google terminaban sin que el usuario abandonara la página de resultados. Estas cifras ilustran la magnitud potencial del cambio, aunque no deben interpretarse como una medida uniforme aplicable a todos los sitios o disciplinas.

Más allá de la cuestión económica, Rapple advierte de las consecuencias para la integridad científica y la transparencia informativa. Los resúmenes generados por IA pueden combinar publicaciones revisadas por pares con fuentes de calidad desigual, informaciones incorrectas o contenidos engañosos. Al reformular la información y eliminar parte de su contexto, estas respuestas pueden hacer que afirmaciones discutibles parezcan tan fiables como los resultados científicos contrastados. Además, las referencias a las fuentes originales pueden aparecer de manera poco visible o incompleta. En algunos casos, los sistemas pueden ofrecer citas imprecisas o inexistentes, dificultando que el lector compruebe la procedencia de una afirmación y evalúe la calidad de la evidencia. La autora considera que esta pérdida de contexto y atribución amenaza la confianza en la comunicación científica.

El artículo plantea que las editoriales corren el riesgo de convertirse en proveedores invisibles de contenidos para plataformas de inteligencia artificial. Sus publicaciones aportan información valiosa a los sistemas que generan respuestas, pero las organizaciones responsables de producirlas pueden perder el contacto directo con sus lectores y una parte de los beneficios económicos y reputacionales derivados de su utilización. Rapple compara esta relación con la de un organismo que alimenta a otro hasta poner en peligro su propia supervivencia: los sistemas de IA necesitan fuentes fiables, pero si el uso de esas fuentes reduce los incentivos para mantenerlas, se puede comprometer la sostenibilidad del ecosistema de conocimiento.

Para responder a este desafío, la autora propone varias líneas de actuación. Una consiste en desarrollar estándares para medir y comunicar el uso de contenidos que se produce fuera de las plataformas editoriales tradicionales. Otra pasa por revisar la manera en que autores e instituciones valoran las publicaciones, de modo que las métricas convencionales de visitas y descargas no sean los únicos indicadores de impacto. También plantea explorar modelos de licencias y remuneración para los contenidos derivados, así como establecer estándares que permitan a las herramientas de IA identificar, clasificar y atribuir correctamente las publicaciones revisadas por pares. Estas medidas requerirían colaboración entre editoriales, plataformas tecnológicas, bibliotecas y organizaciones de normalización, dado que ninguna institución puede resolver el problema de forma aislada.

Una estrategia adicional consiste en mejorar la optimización para motores de respuesta y sistemas generativos, conocida como Answer Engine Optimization (AEO) o Generative Engine Optimization (GEO). Se trata de adaptar los contenidos, sus metadatos y su estructura para facilitar que los sistemas de IA los localicen, interpreten y citen adecuadamente. Las editoriales pueden experimentar con resúmenes estructurados, información contextual más clara, metadatos de calidad y mecanismos que faciliten el acceso desde las respuestas automatizadas hasta las publicaciones completas. Sin embargo, la autora considera necesario investigar qué prácticas funcionan realmente y analizar el comportamiento de los usuarios: en qué circunstancias deciden consultar la fuente original, qué confianza depositan en las respuestas generadas y qué características favorecen una visita posterior al sitio editorial.

Rapple sostiene que el efecto cocodrilo no es únicamente un problema de posicionamiento web o de pérdida de tráfico, sino una transformación de la manera en que se descubre, distribuye y consume el conocimiento. La respuesta exige nuevas métricas, mecanismos de atribución más sólidos, modelos de relación con las plataformas de IA y estrategias de visibilidad adaptadas a los buscadores generativos. El objetivo debería ser construir una relación sostenible entre los productores de conocimiento y los sistemas que lo reutilizan, evitando que la facilidad de obtener respuestas termine debilitando las fuentes que las hacen posibles.

La IA ayuda a visibilizar colecciones digitales ocultas

Clarivate. “Responsible AI in Digital Collections: Part 1. How AI Helps Reveal Hidden Digital Collections”. Clarivate, 17 de agosto de 2026.

Se plantea un cambio interesante en la concepción de la digitalización bibliotecaria: el objetivo ya no debería limitarse a convertir documentos físicos en archivos digitales y ponerlos en línea, sino conseguir que todo el conocimiento contenido en ellos pueda ser descubierto y relacionado. La IA puede actuar como una herramienta de enriquecimiento de metadatos capaz de sacar a la luz conexiones que permanecían invisibles, mejorar la recuperación de información y facilitar nuevas formas de investigación. El reto para las bibliotecas será desarrollar estos sistemas de manera responsable, manteniendo al bibliotecario y al archivero en el centro del proceso de validación y descripción

Las bibliotecas, archivos e instituciones de patrimonio cultural han realizado durante años importantes inversiones en digitalización de fotografías, manuscritos, periódicos, grabaciones audiovisuales y documentos históricos. Sin embargo, digitalizar una colección no garantiza que sus contenidos sean fácilmente localizables. El artículo señala que una parte importante del conocimiento contenido en estos fondos permanece «oculto» porque no aparece reflejado en los metadatos. Una fotografía puede contener personajes relevantes cuyos nombres no figuran en su descripción, mientras que un manuscrito puede mencionar personas, lugares, organizaciones o acontecimientos que tampoco han sido identificados documentalmente.

En este contexto, la inteligencia artificial puede utilizarse para enriquecer automáticamente los metadatos y mejorar las posibilidades de descubrimiento. Una de las aplicaciones destacadas es la extracción de entidades, mediante la cual los sistemas de IA identifican en los contenidos elementos significativos como personas, lugares y organizaciones. En lugar de obligar al personal bibliotecario o archivístico a revisar manualmente cada documento para localizar estas entidades, la IA genera propuestas que posteriormente son examinadas, corregidas o rechazadas por los profesionales. De este modo, se pretende combinar la capacidad de procesamiento de grandes volúmenes de información de la IA con el conocimiento especializado y el control de calidad de los bibliotecarios y archiveros.

El beneficio más importante, por tanto, no sería únicamente ahorrar tiempo en la catalogación, sino transformar la manera en que los usuarios descubren las colecciones. Un investigador podría encontrar materiales relacionados con una determinada persona, institución o lugar aunque esos elementos no hubieran sido incluidos originalmente en los registros bibliográficos. La extracción y vinculación de entidades permite establecer relaciones entre diferentes documentos y colecciones, ofreciendo un contexto más rico y abriendo nuevas vías de investigación que resultarían difíciles de encontrar mediante una búsqueda tradicional basada exclusivamente en palabras clave.

El artículo insiste además en la importancia de un enfoque de IA responsable y supervisada por profesionales. Las sugerencias generadas automáticamente no deberían incorporarse sin control a los registros: los bibliotecarios y archiveros mantienen la capacidad de aceptar, modificar o rechazar las entidades y metadatos propuestos. Esta supervisión permite aprovechar la automatización sin renunciar a la precisión, la normalización y el criterio profesional. En el caso presentado de la University of Texas at Dallas Libraries, la herramienta de IA detecta personas, objetos y lugares en los archivos digitales y propone su vinculación con entidades de vocabularios controlados, dejando la decisión final en manos de los especialistas en metadatos.

Las cinco dimensiones de la visibilidad y el impacto de la investigación

Ebrahim, Nader Ale. “Measure What Matters: The Five Dimensions of Research Visibility & Impact”. LinkedIn, 2026. Artículo original en LinkedIn

El artículo plantea la necesidad de superar una concepción excesivamente limitada del impacto de la investigación científica, tradicionalmente vinculada al número de citas, el índice h, el factor de impacto de las revistas o la posición de una publicación dentro de determinados rankings bibliométricos. Aunque estos indicadores continúan siendo útiles para conocer la influencia académica de un trabajo, el autor sostiene que no permiten captar por sí solos todas las formas en que una investigación puede generar valor.

Un artículo puede recibir pocas citas y, sin embargo, ser ampliamente leído, descargado, compartido en redes académicas, utilizado por profesionales, incorporado a documentos institucionales o contribuir a una determinada política pública. Del mismo modo, una investigación puede alcanzar una elevada visibilidad antes de que su impacto bibliométrico sea apreciable, debido al tiempo que normalmente transcurre entre la publicación de un trabajo, su lectura, su utilización por otros investigadores y la aparición de nuevas citas. Por ello, la evaluación de la investigación debería contemplar un conjunto más amplio de evidencias que permita observar tanto su influencia académica como su circulación, visibilidad, utilización y repercusión social.

La propuesta se articula en torno a cinco dimensiones que permiten construir una imagen más completa del impacto de la investigación: las citas, la visibilidad, la calidad o relevancia del canal de publicación, el impacto social y la colaboración.

La primera dimensión continúa siendo el impacto bibliométrico, que puede analizarse mediante indicadores como las citas totales, el índice h, el Field-Weighted Citation Impact (FWCI) y la proporción de trabajos que se sitúan entre los artículos más citados de su campo. La importancia del FWCI reside especialmente en que permite contextualizar las citas en función de la disciplina, el año de publicación y otros factores que influyen en los patrones de citación. Esto resulta fundamental porque no todas las áreas científicas tienen las mismas prácticas de citación y, por tanto, no resulta adecuado comparar directamente el número de citas de investigadores pertenecientes a disciplinas muy diferentes. El artículo defiende así una utilización más contextualizada de los indicadores bibliométricos, evitando convertir una métrica aislada en una representación completa del valor de una investigación.

La segunda dimensión corresponde a la visibilidad. Una investigación difícilmente puede generar impacto si sus potenciales lectores no pueden descubrirla. En un sistema científico caracterizado por un crecimiento constante de la producción académica, publicar un artículo ya no garantiza que este sea encontrado y leído por las personas que podrían beneficiarse de sus resultados. La visibilidad depende de factores como la presencia en bases de datos, repositorios institucionales, perfiles académicos, identificadores persistentes, buscadores especializados y plataformas de comunicación científica. También adquieren importancia las descargas, las visualizaciones y otras evidencias de uso. Desde esta perspectiva, la publicación es solamente el comienzo del proceso de impacto: primero es necesario que el trabajo sea descubrible, después que sea leído y utilizado y, finalmente, que pueda generar nuevas investigaciones, colaboraciones o aplicaciones. La visibilidad se convierte, por tanto, en una condición previa para muchas de las demás formas de impacto.

La tercera dimensión está relacionada con la calidad y relevancia del canal de publicación. El prestigio de una revista, su posición dentro de una determinada categoría científica y los indicadores bibliométricos asociados a ella continúan teniendo importancia en el ecosistema académico, aunque el autor advierte implícitamente frente a la tendencia de utilizar el prestigio de la revista como sustituto de la evaluación del propio artículo. Un trabajo científico no adquiere automáticamente una determinada calidad por el simple hecho de aparecer en una revista prestigiosa, del mismo modo que una investigación relevante no debería quedar infravalorada exclusivamente porque haya sido publicada en un canal con menor impacto bibliométrico. La evaluación responsable requiere distinguir entre las características del vehículo de comunicación y las evidencias concretas de influencia de cada investigación. Esta distinción resulta especialmente importante en un contexto en el que las políticas de evaluación científica están avanzando hacia modelos que intentan valorar los resultados y contribuciones de los investigadores de una manera más amplia.

La cuarta dimensión corresponde al impacto social, una cuestión cada vez más relevante dentro de las políticas contemporáneas de investigación. El conocimiento científico no produce necesariamente su principal efecto dentro de las universidades o centros de investigación. Puede influir en políticas públicas, organizaciones, empresas, profesionales, instituciones educativas, medios de comunicación y ciudadanos. Las altmétricas pueden aportar información complementaria para observar parte de esta circulación, especialmente cuando un trabajo recibe atención en redes sociales, medios digitales, blogs, plataformas académicas o espacios de comunicación científica. Sin embargo, la mera acumulación de menciones no debería confundirse automáticamente con impacto. Una gran cantidad de atención puede indicar visibilidad, pero el impacto requiere evidencias de utilización, influencia o transformación. La cuestión esencial consiste, por tanto, en identificar qué ocurre con el conocimiento una vez que abandona el circuito estrictamente académico y llega a otros públicos y contextos de aplicación.

La quinta dimensión se refiere a la colaboración, especialmente a la colaboración internacional. La investigación contemporánea se desarrolla cada vez con mayor frecuencia mediante redes que conectan investigadores, universidades, centros de investigación y países diferentes. La colaboración puede ampliar la circulación de los resultados, facilitar el intercambio de conocimientos, favorecer nuevos proyectos y aumentar las posibilidades de que una investigación sea conocida y utilizada en contextos diferentes. La tasa de colaboración internacional constituye, por ello, un indicador que ayuda a comprender la dimensión relacional de la investigación. No se trata únicamente de contabilizar cuántos autores participan en un artículo, sino de observar hasta qué punto la investigación forma parte de redes científicas amplias y diversas. La colaboración puede convertirse además en un mecanismo para incrementar tanto la visibilidad como la influencia posterior de los resultados.

A partir de estas dimensiones, el autor propone considerar un conjunto de indicadores que combina bibliometría tradicional, datos de uso, visibilidad digital, acceso abierto, altmétricas y colaboración. Entre ellos aparecen el FWCI, las citas totales, el índice h, la proporción de trabajos situados entre el 10 % más citado, la identificación de trabajos altamente citados, el porcentaje de publicaciones en acceso abierto, las descargas y visualizaciones, el Altmetric Attention Score, la colaboración internacional y el crecimiento de las citas. La importancia de esta combinación reside precisamente en que ningún indicador individual pretende explicar por sí solo el impacto de una investigación. El objetivo es construir un perfil multidimensional que permita responder a preguntas diferentes: cuánto se cita un trabajo, quién lo encuentra, quién lo lee, dónde circula, qué atención recibe, con quién se conecta y qué utilización puede tener más allá del ámbito académico.

Esta perspectiva resulta especialmente coherente con la evolución de la ciencia abierta y con los cambios que está experimentando la comunicación científica. El acceso abierto, los repositorios institucionales, los identificadores persistentes como ORCID y la disponibilidad de metadatos estructurados facilitan que las investigaciones puedan ser descubiertas y utilizadas por comunidades mucho más amplias. La publicación deja de ser así un acontecimiento aislado para convertirse en una etapa dentro de un ciclo de comunicación que incluye producción, publicación, descubrimiento, lectura, reutilización, citación, difusión y aplicación. En este contexto, la visibilidad adquiere un valor estratégico porque permite que los resultados lleguen a públicos que probablemente nunca habrían encontrado el artículo a través de los canales tradicionales.

Para las bibliotecas universitarias, esta propuesta tiene importantes implicaciones. Los servicios bibliotecarios pueden desempeñar un papel activo en la mejora de la visibilidad y el impacto de la investigación mediante el asesoramiento sobre repositorios, acceso abierto, ORCID, perfiles académicos, metadatos, identificadores persistentes y estrategias de difusión. También pueden ayudar a los investigadores a interpretar correctamente los indicadores bibliométricos y altmétricos, evitando usos simplistas o inadecuados de las métricas. De esta manera, la biblioteca se convierte no solo en un servicio de acceso a la información científica, sino también en un agente de apoyo a la comunicación, evaluación y difusión de la investigación. La alfabetización bibliométrica y la formación en ciencia abierta adquieren así una importancia creciente dentro de los servicios de apoyo a la investigación.

La aparición de la inteligencia artificial introduce además una nueva dimensión en esta cuestión. Los investigadores dependen cada vez más de sistemas automatizados para descubrir literatura, resumir documentos, identificar conexiones entre trabajos y localizar información relevante. Esto significa que la descubribilidad de una investigación ya no depende exclusivamente de que aparezca bien posicionada en una base de datos tradicional. Los metadatos de calidad, los identificadores persistentes, la accesibilidad del texto completo y una adecuada estructuración de la información pueden influir también en la capacidad de los sistemas digitales y de IA para localizar y recomendar determinados trabajos. La visibilidad científica empieza, por tanto, a adquirir una dimensión algorítmica: una investigación debe ser no solo visible para los investigadores, sino también suficientemente accesible y estructurada para los sistemas que participan cada vez más en los procesos de descubrimiento científico.

El artículo propone pasar de una visión de la investigación basada fundamentalmente en la pregunta “¿cuántas citas ha recibido?” a una perspectiva mucho más amplia: “¿cómo circula, quién la descubre, quién la utiliza, con quién se conecta y qué efectos produce?”. Las cinco dimensiones —impacto de las citas, visibilidad, calidad del canal de publicación, impacto social y colaboración— permiten construir una imagen más rica y equilibrada del valor de la actividad científica. La principal aportación de este enfoque consiste en recordar que el impacto no comienza cuando aparece una cita ni termina cuando se publica un artículo. Se desarrolla a través de un proceso en el que la investigación debe ser descubierta, leída, compartida, conectada con otros trabajos, incorporada a nuevas investigaciones y, cuando sea posible, utilizada para generar conocimiento, innovación o beneficios sociales.

La biblioteca más allá de la biblioteca: reformulando la propuesta de valor de la biblioteca para lograr visibilidad e impacto.

Lavoie, Brian y Rebecca Bryant. The Library Beyond the Library. Hanging Together (OCLC Research Blog), 5 de junio de 2024. Proyecto ampliado posteriormente en el informe de OCLC Research – The Library Beyond the Library (abril de 2026)

Texto completo

Durante décadas, las bibliotecas universitarias han desempeñado un papel claramente definido dentro de las universidades: gestionar colecciones físicas y digitales, organizar recursos documentales y facilitar el acceso a información adquirida externamente para estudiantes, docentes e investigadores. Este modelo tradicional, centrado en la gestión de colecciones y servicios bibliográficos, permitió que las bibliotecas funcionaran de forma relativamente autónoma, siendo percibidas como espacios dedicados principalmente a custodiar conocimiento y proporcionar acceso a materiales académicos. Sin embargo, los profundos cambios experimentados por la investigación científica, la digitalización y las nuevas dinámicas institucionales han provocado una transformación sustancial de este paradigma.

El informe desarrollado por OCLC Research introduce el concepto “The Library Beyond the Library” (“La biblioteca más allá de la biblioteca”), una idea que refleja cómo las bibliotecas universitarias están expandiendo su radio de acción mucho más allá de sus funciones históricas. Ya no se limitan a administrar colecciones o proporcionar servicios de préstamo, sino que participan activamente en áreas estratégicas vinculadas al ecosistema global de investigación institucional. Esto incluye la gestión de datos científicos, repositorios institucionales, apoyo a políticas de ciencia abierta, análisis bibliométricos, visibilidad académica, gestión de perfiles de investigadores, preservación digital, apoyo a la publicación científica y desarrollo de infraestructuras de información para la toma de decisiones universitarias.

Uno de los hallazgos centrales del estudio es que esta evolución está obligando a las bibliotecas a establecer alianzas transversales con otras unidades universitarias. Servicios antes exclusivamente bibliotecarios ahora requieren colaboración con oficinas de investigación, departamentos de tecnologías de la información, unidades de innovación educativa, áreas de gestión institucional y oficinas dedicadas a la captación de fondos o al cumplimiento de políticas científicas internacionales. Estas colaboraciones generan nuevos modelos organizativos en los que la biblioteca deja de ser una unidad aislada para convertirse en una pieza integrada dentro de la infraestructura estratégica de la universidad. El conocimiento especializado de los bibliotecarios comienza así a insertarse en procesos institucionales mucho más amplios relacionados con la producción científica y la reputación académica.

Los investigadores Brian Lavoie y Rebecca Bryant subrayan que este cambio no consiste únicamente en ampliar servicios, sino en redefinir la propuesta de valor de la biblioteca. Tradicionalmente, el valor de la biblioteca se medía por indicadores visibles como número de préstamos, tamaño de la colección o afluencia de usuarios. En el nuevo escenario, buena parte del trabajo bibliotecario ocurre “detrás del escenario”, influyendo en procesos complejos que muchos actores universitarios no identifican inmediatamente como parte del trabajo bibliotecario. Esto genera un desafío importante: cuanto más estratégica se vuelve la biblioteca, más invisible puede parecer su contribución si no se comunica adecuadamente su impacto dentro de la institución. La percepción pública continúa asociando a menudo la biblioteca únicamente con libros, salas de estudio o acceso a recursos electrónicos, ignorando funciones emergentes de enorme relevancia institucional.

El estudio presenta varios casos concretos que ilustran esta transición. En la University of Manchester, por ejemplo, la biblioteca lidera una nueva oficina institucional dedicada a la investigación abierta, centralizando servicios que involucran a múltiples departamentos universitarios. En la Montana State University se creó una alianza de investigación donde unidades bibliotecarias y no bibliotecarias trabajan conjuntamente desde un mismo espacio operativo, posicionando a la biblioteca como nodo central del ecosistema investigador. En la University of Illinois Urbana-Champaign, la biblioteca administra sistemas institucionales de gestión de información científica financiados por el vicerrectorado de investigación, extendiendo su experiencia en metadatos hacia la construcción de infraestructuras que apoyan la planificación estratégica universitaria. Estos ejemplos muestran cómo la biblioteca puede asumir un rol de liderazgo en estructuras institucionales antes alejadas de su ámbito tradicional.

Otro concepto clave asociado al informe es el de interoperabilidad social, entendido como la capacidad de crear relaciones funcionales sostenibles entre personas, departamentos e instituciones distintas para facilitar colaboración efectiva. Las bibliotecas necesitan hoy no solo competencias técnicas en organización del conocimiento o gestión documental, sino también habilidades para negociar, coordinar proyectos interdisciplinarios, liderar redes institucionales y construir puentes entre comunidades académicas diversas. El bibliotecario contemporáneo evoluciona así hacia un perfil híbrido donde conviven capacidades tecnológicas, analíticas, comunicativas y estratégicas. La gestión de información sigue siendo central, pero ahora inserta dentro de un ecosistema mucho más interdependiente y colaborativo.

En última instancia, el informe advierte que las bibliotecas que no logren adaptarse a esta transformación corren el riesgo de perder relevancia institucional, recursos económicos e influencia dentro de sus organizaciones. A medida que universidades y centros de investigación priorizan productividad científica, ciencia abierta, colaboración interdisciplinaria y financiación competitiva, las bibliotecas deben demostrar de manera clara cómo contribuyen directamente a estos objetivos estratégicos. El futuro bibliotecario ya no depende únicamente de preservar colecciones o garantizar acceso a información, sino de posicionarse como un actor imprescindible dentro de la infraestructura intelectual y científica de la institución. “La biblioteca más allá de la biblioteca” representa precisamente esta transición: pasar de ser un espacio de servicios tradicionales a convertirse en un socio estratégico esencial para la creación, gestión y circulación del conocimiento en la universidad del siglo XXI.

La búsqueda en IA para la ciencia aún depende de los metadatos

Man searching academic articles with AI software on computer in library
A man uses AI-powered research software in a library setting.

Hansen, Stephanie Lovegrove. 2026. “Scholarly AI Search Shortcomings and the Need for Better Metadata.” The Scholarly Kitchen, 29 de mayo de 2026. https://scholarlykitchen.sspnet.org/2026/05/29/guest-post-scholarly-ai-search-shortcomings-and-the-need-for-better-metadata

El artículo defiende que el futuro de la búsqueda académica no será una sustitución de los sistemas actuales, sino un modelo híbrido en el que coexistan la búsqueda por palabras clave, la IA generativa y los sistemas de metadatos enriquecidos. En este escenario, la calidad, estandarización y estructura de los metadatos se convierten en un elemento clave: sin ellos, incluso los sistemas de IA más avanzados no pueden ofrecer resultados fiables ni plenamente utilizables en entornos científicos.

Se analiza las limitaciones actuales de los sistemas de búsqueda académica basados en inteligencia artificial y sostiene que su rendimiento depende de forma crítica de la calidad de los metadatos subyacentes. A partir de la evaluación de herramientas de descubrimiento científico impulsadas por IA, la autora argumenta que estos sistemas aún no logran sustituir de manera fiable a la búsqueda tradicional basada en palabras clave, especialmente cuando se trata de consultas precisas, técnicas o altamente estructuradas.

Uno de los problemas centrales es la dificultad de las herramientas de IA para manejar con precisión información exacta como fórmulas, datos químicos, identificadores o referencias bibliográficas específicas. Aunque la IA destaca en tareas de síntesis y en la exploración de preguntas abiertas en lenguaje natural, tiende a fallar en escenarios donde la exactitud, la reproducibilidad y la trazabilidad son esenciales. Esto genera una tensión entre dos modelos de descubrimiento: el tradicional, basado en control y precisión, y el emergente, centrado en interpretación y síntesis automática.

El texto subraya además la opacidad de muchos sistemas de IA, que dificulta comprender por qué un resultado es recuperado o no. Esta falta de transparencia afecta directamente a la confianza de los usuarios y complica su uso en contextos académicos formales, como revisiones sistemáticas o investigación regulatoria.

Google publica una guía oficial para optimizar contenidos en la búsqueda generativa basada en IA

Two people at a table reviewing a guide titled Optimizing for Generative AI, with a screen showing structured data concepts
Two Google employees discuss strategies for optimizing generative AI using a detailed guide

Google Developers. “Optimizing Your Website for Generative AI Features on Google Search.” Google Search Central. Consultado el 24 de mayo de 2026.

Google ha publicado una nueva guía oficial destinada a explicar cómo deben adaptarse los sitios web al nuevo ecosistema de búsqueda impulsado por inteligencia artificial. El documento forma parte de la documentación de Google Search Central y está centrado en las funciones generativas de búsqueda, especialmente los denominados “AI Overviews” y el “AI Mode”, sistemas que utilizan modelos de IA para sintetizar respuestas directamente en el buscador.

La guía representa uno de los posicionamientos más claros de Google sobre el futuro del SEO en la era de la IA generativa y busca desmontar muchas prácticas especulativas que habían proliferado en torno al llamado GEO (Generative Engine Optimization) o AEO (Answer Engine Optimization).

El mensaje central del documento es que la optimización para la IA no constituye una disciplina independiente del SEO tradicional. Google insiste en que las funciones generativas continúan utilizando los mismos sistemas de indexación, calidad y clasificación que alimentan la búsqueda convencional. Según la compañía, no existe un “índice especial para IA” ni un algoritmo paralelo destinado exclusivamente a las respuestas generadas automáticamente. En consecuencia, las prácticas fundamentales del SEO —como la creación de contenido útil, original, fiable y técnicamente accesible— siguen siendo el núcleo de la visibilidad digital en los nuevos entornos de búsqueda asistida por IA.

La guía también dedica un espacio importante a desmontar ciertos mitos que se habían popularizado entre consultores y empresas de marketing digital. Google afirma explícitamente que no son necesarias estrategias específicas como el uso de archivos “llms.txt”, la creación de marcado estructurado exclusivo para IA, la fragmentación artificial de contenidos (“chunking”) o la reescritura de textos para adaptarlos a supuestos patrones de lectura de modelos generativos. La empresa considera que muchas de estas prácticas no aportan beneficios reales y, en algunos casos, pueden derivar en estrategias artificiales o spam.

Otro aspecto relevante del documento es la importancia que Google concede al contenido “no commodity”, es decir, a la información original, experiencial y difícilmente replicable por sistemas automáticos. La guía sugiere que la IA tenderá a valorar especialmente testimonios, experiencias directas, análisis especializados y contenidos elaborados desde una perspectiva humana auténtica. Esto implica que los materiales genéricos, fácilmente reproducibles por herramientas de IA, podrían perder visibilidad frente a contenidos con mayor profundidad contextual y autoridad temática.

La publicación de esta guía se enmarca dentro de una transformación mucho más amplia del buscador de Google. En los últimos meses, la compañía ha anunciado cambios profundos en Search mediante la integración de modelos Gemini y nuevas experiencias conversacionales capaces de interpretar consultas complejas, imágenes, documentos y contextos personalizados. Estas funciones convierten progresivamente el buscador en una plataforma híbrida entre motor de búsqueda y asistente conversacional inteligente.

El debate generado alrededor de estas tecnologías también ha despertado preocupación en el ámbito académico y editorial. Investigaciones recientes advierten de que las respuestas generadas por IA modifican profundamente la relación entre usuarios, buscadores y medios de comunicación, ya que el sistema sintetiza información procedente de múltiples fuentes reduciendo potencialmente el tráfico hacia los sitios originales. Algunos estudios señalan además que una parte significativa de las afirmaciones generadas por los sistemas AI Overviews pueden contener omisiones o referencias insuficientemente respaldadas.

En conjunto, la nueva guía de Google supone un intento de estabilizar el ecosistema SEO frente a la proliferación de tácticas oportunistas surgidas con el auge de la IA generativa. La empresa reafirma que la calidad del contenido, la experiencia del usuario, la autoridad temática y la accesibilidad técnica continúan siendo los pilares fundamentales de la visibilidad digital, incluso en una etapa en la que las respuestas automatizadas y los agentes inteligentes están redefiniendo el funcionamiento tradicional de la web.

Google publica una guía clave para optimizar contenidos en la era de la búsqueda generativa

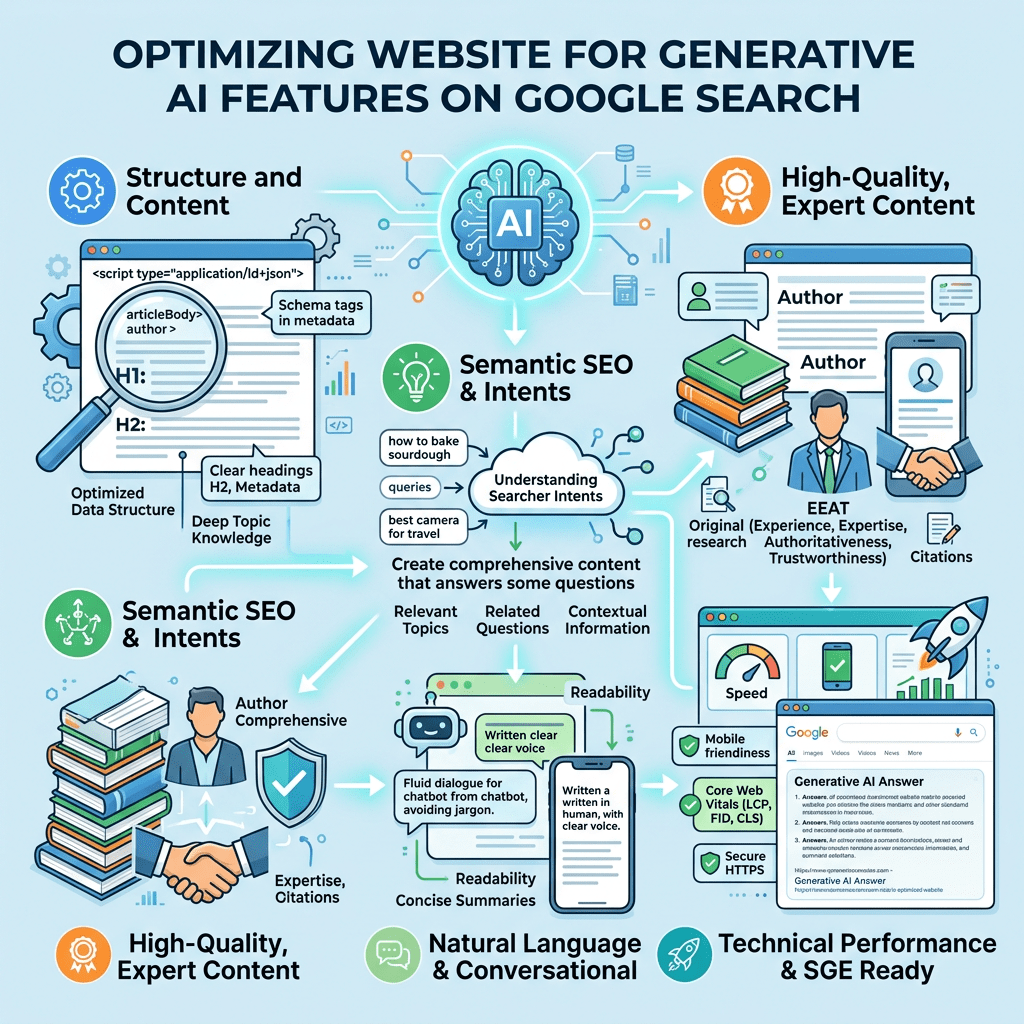
Infographic on optimizing website for generative AI features on Google Search
A detailed infographic explaining optimization strategies for generative AI features on Google Search.

Google Search Central. “Optimizing Your Website for Generative AI Features on Google Search.” Search Engine Land (cobertura periodística del documento oficial de Google). https://searchengineland.com/google-publishes-guide-on-optimizing-for-generative-ai-features-477671

Google acaba de publicar una nueva guía oficial destinada a ayudar a editores, responsables de SEO y creadores de contenido a optimizar sus sitios web para las nuevas funciones de búsqueda generativa, como las AI Overviews y el AI Mode. Este documento representa un paso importante en la consolidación del ecosistema de búsqueda impulsado por inteligencia artificial, ya que por primera vez Google ofrece directrices unificadas sobre cómo debe estructurarse y publicarse el contenido para aparecer de forma efectiva en resultados generativos. La guía no plantea una ruptura con el SEO tradicional, sino que lo reinterpreta dentro del nuevo contexto de la inteligencia artificial aplicada a la búsqueda.

Uno de los elementos centrales del documento es la afirmación de que las prácticas clásicas de optimización para buscadores siguen siendo plenamente válidas. Google subraya que los sistemas de IA generativa se apoyan en los mismos mecanismos de indexación, clasificación y recuperación de información que el buscador tradicional. En este sentido, conceptos emergentes como AEO (Answer Engine Optimization) o GEO (Generative Engine Optimization) no constituyen disciplinas independientes, sino extensiones del SEO convencional. El objetivo sigue siendo el mismo: producir contenido útil, accesible, bien estructurado y orientado a las necesidades reales de los usuarios, más que a la manipulación de los sistemas algorítmicos.

La guía también aclara varias ideas erróneas que se habían extendido en el sector del marketing digital durante los últimos años. Google señala explícitamente que no es necesario crear archivos especiales como llms.txt, ni desarrollar versiones del contenido pensadas exclusivamente para modelos de lenguaje. Tampoco es obligatorio introducir marcado estructurado adicional para “optimizar” la visibilidad en sistemas de IA generativa. Según la compañía, estos elementos no influyen directamente en la aparición del contenido en las respuestas generadas por IA, ya que los sistemas se basan principalmente en la comprensión del contenido visible y en señales de calidad general del sitio web.

Otro aspecto relevante es la insistencia en la calidad y utilidad del contenido como factor decisivo. Google destaca que los sistemas generativos están diseñados para identificar información fiable, clara y relevante, priorizando páginas que aporten valor real frente a aquellas que simplemente repiten información genérica. Esto refuerza la idea de que la estrategia más efectiva no es técnica, sino editorial: crear contenidos originales, con estructura clara, autoridad temática y utilidad demostrable para el usuario final.

Finalmente, el artículo subraya que esta guía supone una consolidación del enfoque de Google hacia la integración de la inteligencia artificial en la búsqueda. Lejos de sustituir el SEO, la búsqueda generativa lo amplía y lo redefine dentro de un marco más complejo, donde la calidad del contenido, la intención del usuario y la comprensión semántica juegan un papel más relevante que nunca. En conjunto, el documento marca un punto de referencia importante para entender cómo evolucionará la visibilidad en la web en la era de la inteligencia artificial aplicada a los motores de búsqueda.

Un estudio cuestiona el impacto del marcado en las citas y visibilidad de las páginas en la IA generativa

Diagram showing schema markup flow leading to AI citation and attribution with terms like JSON-LD, knowledge transfer, and algorithms.
Visual diagram illustrating schema markup and AI citation integration processes.

Schwartz, Barry. “Study: Adding Schema Did Not Improve AI Citations On Google, ChatGPT & More.” Search Engine Roundtable. Publicado el 13 de mayo de 2026. Consultado el 19 de mayo de 2026.

El artículo recoge los resultados de un estudio realizado por Ahrefs que cuestiona una de las creencias más extendidas dentro del SEO y del emergente ámbito del GEO (Generative Engine Optimization): la idea de que añadir marcado Schema o datos estructurados mejora la probabilidad de que una página web sea citada por sistemas de inteligencia artificial como Google AI Overviews, Google AI Mode o ChatGPT.

La investigación analizó 1.885 páginas web que incorporaron marcado JSON-LD Schema entre agosto de 2025 y marzo de 2026 y las comparó con un grupo de control formado por unas 4.000 páginas similares que no añadieron este tipo de marcado. El objetivo era determinar si existía una relación causal entre el uso de Schema y la frecuencia con la que las plataformas de IA citaban esos contenidos en sus respuestas generadas automáticamente. Según el estudio, los resultados no mostraron mejoras estadísticamente significativas en ninguna de las plataformas analizadas.

Los datos obtenidos fueron especialmente llamativos porque contradicen gran parte del discurso dominante en el sector SEO. En Google AI Overviews, las páginas que añadieron Schema incluso mostraron una ligera disminución del 4,6 % en las citas respecto al grupo de control. En Google AI Mode se registró un aumento del 2,4 %, mientras que en ChatGPT el incremento fue del 2,2 %, aunque ambos valores fueron considerados estadísticamente irrelevantes y posiblemente atribuibles al azar. Los investigadores concluyeron que no puede afirmarse que el Schema produzca un aumento real de visibilidad en sistemas de IA generativa.

El estudio también introduce una distinción importante entre correlación y causalidad. Ahrefs observó inicialmente que las páginas citadas por sistemas de IA tenían casi tres veces más probabilidades de incluir marcado Schema que las páginas no citadas. Sin embargo, los autores sostienen que esto probablemente se debe a que los sitios web técnicamente mejor mantenidos suelen aplicar simultáneamente buenas prácticas SEO, contenido de calidad, autoridad de dominio y estrategias de enlazado más sólidas. En otras palabras, el Schema sería un indicador indirecto de calidad técnica general, pero no el factor que impulsa directamente las citas de la IA.

Otro aspecto relevante es que algunos experimentos citados dentro del informe mostraron que varios sistemas de IA no utilizan directamente el marcado JSON-LD durante la extracción inmediata de información, sino que priorizan el contenido HTML visible de la página. Esto cuestiona la idea de que los modelos generativos “lean” o dependan necesariamente del Schema para interpretar el contenido web.

La noticia tuvo una fuerte repercusión dentro de la comunidad SEO y GEO. En diversos debates en Reddit y redes profesionales, numerosos especialistas interpretaron el estudio como un golpe a ciertas estrategias de “optimización para IA” que se habían popularizado rápidamente durante 2025 y 2026. Algunos comentarios destacan que muchas recomendaciones sobre Schema y visibilidad en IA se habían difundido más como hipótesis comerciales que como conclusiones respaldadas por evidencia empírica sólida.

No obstante, el estudio no concluye que el Schema carezca completamente de utilidad. Los autores recuerdan que los datos estructurados siguen siendo importantes para otros contextos: resultados enriquecidos en buscadores, interoperabilidad semántica, organización de contenidos, accesibilidad de datos y construcción de knowledge graphs. Además, reconocen que la investigación se centró únicamente en páginas ya visibles para los sistemas de IA y no pudo determinar si el Schema podría ayudar a páginas nuevas o menos visibles a ser descubiertas inicialmente.

En conjunto, el informe refleja una transformación profunda del SEO tradicional hacia un entorno dominado por motores generativos y asistentes conversacionales. La principal conclusión es que las estrategias centradas exclusivamente en optimizaciones técnicas aisladas parecen perder peso frente a factores más amplios como la autoridad temática, la calidad del contenido, la claridad informativa y la confianza del dominio. El debate abierto por este estudio muestra que el ecosistema GEO todavía se encuentra en una fase experimental, donde muchas prácticas consideradas “buenas estrategias” aún carecen de validación científica robusta.

Redefinir la publicación científica: por qué avanzamos más allá del artículo

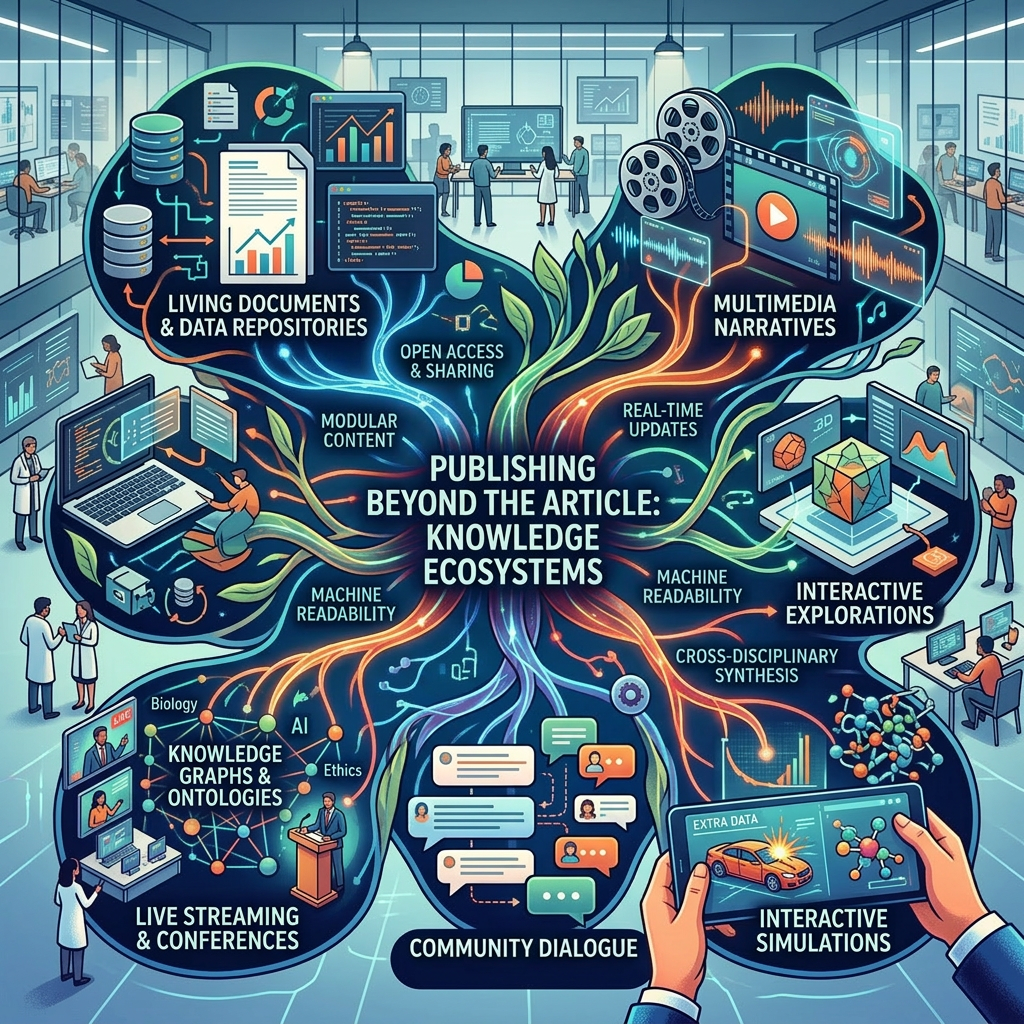
Diagram showing knowledge ecosystems including living documents, multimedia narratives, augmented reality overlays, interactive explorations, and community dialogue.
Visualization of interconnected knowledge ecosystems transforming publishing beyond traditional articles.

Hrynaszkiewicz, Iain. “Redefining Publishing: Why We’re Moving Beyond the Article.” Research Information, October 2, 2025. Research Information

El artículo de Iain Hrynaszkiewicz plantea una crítica de fondo al modelo tradicional de comunicación científica, centrado casi exclusivamente en el artículo académico y en el prestigio de la revista donde se publica. Según el autor, este sistema ya no refleja cómo se produce realmente la ciencia contemporánea ni cómo debería evaluarse. La investigación actual es más colaborativa, abierta, interdisciplinar y distribuida en múltiples fases, mientras que los mecanismos de reconocimiento siguen premiando sobre todo el resultado final: el paper. Esta desconexión genera incentivos distorsionados y dificulta valorar contribuciones esenciales como los datos, el código, los protocolos, la mentoría o la ciencia en etapas tempranas.

Para explicar que el cambio es posible, el texto recuerda innovaciones previas que transformaron la comunicación académica. Entre ellas destacan los identificadores persistentes como el DOI, que estabilizaron las citas digitales; ORCID, que permite identificar autores de forma inequívoca; la taxonomía CRediT, que reconoce distintos tipos de contribución; y el auge de los preprints y de la compartición de datos. Todas estas herramientas surgieron para resolver carencias del sistema y prosperaron gracias a la cooperación entre editoriales, universidades, financiadores e infraestructuras técnicas. El mensaje central es que la evolución de la ciencia depende menos de actores aislados y más de consensos colectivos sostenidos en el tiempo.

En ese contexto, el autor presenta la iniciativa de PLOS para replantear el ecosistema editorial mediante un proyecto de dieciocho meses financiado por fundaciones filantrópicas. Su propuesta principal es el denominado knowledge stack o “pila de conocimiento”: un sistema donde los distintos productos de investigación —datos, software, métodos, hipótesis, resultados parciales, revisiones y artículos finales— sean visibles, enlazables, atribuibles y evaluables como partes de un mismo proceso. Esto supone pasar de una lógica centrada en un único documento final a otra basada en un registro completo y continuo de la actividad científica.

El artículo también subraya que la ciencia abierta no debe entenderse solo como una obligación normativa impuesta por agencias financiadoras, sino como una oportunidad estratégica para universidades y centros de investigación. Compartir métodos, datos y resultados mejora la transparencia, facilita la reproducibilidad y fortalece la integridad científica. Además, puede aumentar la visibilidad institucional, acelerar descubrimientos y favorecer la competitividad internacional. Desde esta perspectiva, abrir la ciencia no es solo una cuestión ética, sino también una ventaja organizativa y reputacional.

Otro aspecto relevante del texto es su mirada comparada sobre distintas regiones del mundo. El autor observa que Europa y Reino Unido avanzan más rápidamente en políticas de evaluación responsable y ciencia abierta, mientras que Asia y Norteamérica muestran progresos más desiguales o descentralizados. Aun así, en casi todos los contextos persiste la dependencia del artículo de revista como medida principal del mérito académico. Las inercias culturales, la presión competitiva por financiación y la dificultad de comparar disciplinas frenan reformas más profundas. Incluso quienes desean cambiar el sistema temen perjudicar a investigadores jóvenes si se apartan demasiado pronto de las reglas vigentes.

Finalmente, Hrynaszkiewicz concluye que el futuro de la publicación científica pasa por reconocer el conjunto del ciclo investigador y no solo su desenlace editorial. Un sistema más rico en metadatos, señales de impacto, trazabilidad de contribuciones y conexiones entre outputs permitiría premiar la colaboración, el riesgo intelectual, los resultados negativos y las prácticas responsables. No obstante, advierte que para lograr un cambio real se necesita adopción masiva: no basta con que una editorial innove, sino que deben sumarse financiadores, instituciones, infraestructuras y comunidades científicas de todo el mundo. En suma, el artículo defiende una transformación estructural del modelo académico, desde la cultura del paper hacia una ecología más abierta, justa y representativa del trabajo científico real.