Archivo de la categoría: Noticias

Entrevista a María Isabel «Beli» Morales sobre el valor de los clubes de lectura. Planeta Biblioteca 2026/11/13

Entrevista a María Isabel «Beli» Morales sobre el valor de los clubes de lectura

Planeta Biblioteca 2026/11/13

ESCUCHAR

Descargar

En esta edición de Planeta Biblioteca conversamos con María Isabel «Beli» Morales Reyes, archivera y bibliotecaria del Ayuntamiento de Cantillana (Sevilla), donde desarrolla su labor profesional desde 1990. A lo largo de la entrevista abordamos el papel de los clubes de lectura como espacios de encuentro, participación ciudadana y dinamización cultural desde las bibliotecas públicas. Beli comparte su experiencia en la creación y organización de estos grupos, las estrategias para fomentar la participación de los lectores, la selección de obras y la importancia de generar comunidades en torno a la lectura. También reflexionamos sobre el potencial de los clubes para favorecer la inclusión social, combatir la soledad, estrechar vínculos entre personas y promover el intercambio de ideas y el pensamiento crítico. Asimismo, exploramos la incorporación de nuevas modalidades de lectura y actividades complementarias, como los encuentros con autores y las visitas culturales. Una conversación que pone de manifiesto cómo las bibliotecas, además de ofrecer acceso a la información y la cultura, pueden convertirse en auténticos espacios de convivencia, aprendizaje compartido y cohesión social.

VI Jornadas «Inspirados por la MusSa» (Música en Salamanca). Viviendo en la era pop 2026/11/12

VI Jornadas «Inspirados por la MusSa» (Música creada en Salamanca).

Viviendo en la era pop 2026/11/12

ESCUCHAR

Descargar

Las VI Jornadas «Inspirados por la MusSa» (Música en Salamanca) se celebran del 11 de noviembre al 11 de diciembre de 2026 con el objetivo de promover, difundir y reivindicar la calidad y diversidad de la creación musical salmantina, especialmente la música original de sus compositores e intérpretes. Organizadas por los programas A Nuestro Ritmo (Radio Oeste, ZOES) y Viviendo en la Era Pop (Radio USAL), incluyen cinco actividades abiertas al público y de entrada gratuita. El programa comienza con el estreno del videoclip «Mi Otra Orilla (RapAncestral)», una fusión de rap, rock, folclore charro y flamenco. También contempla una conferencia-homenaje al veterano músico Gabi Sánchez, pionero del pop y el rock en Salamanca, conducida por el periodista musical Víctor G. Villarroel. Se celebrará además la quinta Kedada Ñam+Jam, un encuentro de fraternidad entre músicos con comida, homenaje y actuaciones musicales. Otra actividad será una mesa redonda con realizadores salmantinos de videoclips, que abordará la relación entre música e imagen y la situación del sector audiovisual. Finalmente, las jornadas concluirán con la presentación del disco recopilatorio «Horizonte Electrónico A Nuestro Ritmo», que reúne 20 canciones de diez proyectos de música electrónica local. Esta iniciativa constituye un espacio de encuentro, reconocimiento y visibilidad para los creadores musicales de Salamanca, poniendo en valor el talento y la riqueza de su escena cultural.

Artículos basura generados por inteligencia artificial aparecen publicados bajo los nombres de destacados investigadores

Asaf, S. (2026, 9 de noviembre). ‘AI slop’ papers published under prominent academics’ names. Times Higher Education. https://www.timeshighereducation.com/news/ai-slop-papers-published-under-prominent-academics-names

Denuncia una nueva modalidad de fraude en la comunicación científica: la publicación de artículos aparentemente generados mediante inteligencia artificial que utilizan, sin autorización, los nombres de investigadores de reconocido prestigio.

Una investigación periodística ha descubierto que varias revistas académicas poco conocidas están difundiendo trabajos de escasa calidad, con contenidos aparentemente automatizados y referencias bibliográficas cuestionables, atribuyéndolos a profesores e investigadores que aseguran no haber participado en su elaboración ni haber autorizado el uso de su identidad. El caso pone de manifiesto cómo la inteligencia artificial puede utilizarse para fabricar publicaciones científicas y, simultáneamente, apropiarse de la reputación académica de terceros.

La investigación comenzó cuando Alan Said, profesor de Informática de la Universidad de Gotemburgo, recibió una notificación de Google Scholar sobre un artículo titulado Intelligence Systems Supporting Sustainable Global Development, supuestamente publicado bajo su nombre en la revista American International Journal of Research and Innovation (AIJRI). Aunque la temática guardaba cierta relación con sus líneas de investigación sobre inteligencia artificial y sostenibilidad, el profesor comprobó que no había escrito el trabajo y que su contenido parecía generado artificialmente, con escasa consistencia científica. Tras denunciar el caso, el artículo fue supuestamente retirado, pero continuó apareciendo en línea con modificaciones en la identidad de su autor. En apenas dos días se detectaron tres versiones del mismo documento atribuidas a personas diferentes.

El análisis identificó otras dos publicaciones con características similares: American Journal of Advanced Multidisciplinary Research and Innovation (AJAMRI) y American Journal for Multidisciplinary Research (AJFMR). Las tres revistas presentan elementos comunes en sus páginas web, comparten director editorial y miembros de sus consejos científicos y utilizan una apariencia editorial que puede transmitir una falsa impresión de legitimidad. Entre los investigadores cuyos nombres aparecen asociados a sus artículos figuran personalidades destacadas de la informática y la inteligencia artificial, como Fei-Fei Li y Christopher Manning, de Stanford, y Michael I. Jordan y Stuart Russell, de Berkeley. Varios de estos académicos han confirmado que nunca escribieron los trabajos ni autorizaron su publicación.

Uno de los aspectos más preocupantes es que las revistas también utilizan nombres de investigadores para construir artificialmente sus consejos editoriales. Kanakaraju Manupati, investigador posdoctoral de Virginia Commonwealth University, manifestó que desconocía completamente la existencia de la revista en cuyo comité editorial aparecía incluido. Esta práctica plantea dudas sobre la autenticidad de los procesos de revisión por pares y sobre la utilización fraudulenta de la reputación de científicos e instituciones para generar confianza entre posibles autores y lectores.

El artículo también llama la atención sobre el modelo económico de estas publicaciones. Las revistas anuncian tarifas por publicar artículos que varían según el número y la procedencia de los autores. En uno de los casos, las cantidades oscilan entre 80 y 200 dólares, mientras que otra publicación anuncia tarifas considerablemente inferiores. Esta estructura, unida a la publicación de contenidos aparentemente generados de manera automática y a la utilización de identidades académicas sin consentimiento, apunta a un modelo editorial que podría aprovecharse de la presión existente en el ámbito universitario por publicar y acumular méritos científicos.

Las consecuencias van más allá del perjuicio reputacional para los investigadores afectados. La presencia de estos trabajos en Google Scholar puede contaminar los perfiles académicos, introducir referencias falsas en los sistemas de recuperación de información y dificultar la evaluación de la producción científica. También existe el riesgo de que estudiantes de doctorado e investigadores jóvenes interpreten estas revistas como publicaciones legítimas al encontrar en ellas los nombres de científicos reconocidos, y terminen enviando sus propios trabajos o pagando por publicar.

El caso evidencia que la inteligencia artificial generativa está ampliando las posibilidades de producción masiva de contenidos científicos fraudulentos, pero también está facilitando nuevas formas de suplantación de identidad académica. El problema no reside únicamente en la generación automática de artículos de baja calidad, sino en la creación de una apariencia de legitimidad mediante nombres de investigadores reales, consejos editoriales ficticios y plataformas de publicación que simulan cumplir los estándares de la comunicación científica.

Cómo organizar un club de lectura verde con Marta García Rodríguez. Planeta Biblioteca 2026/11/06

Cómo organizar un club de lectura verde con Marta García Rodríguez.

Planeta Biblioteca 2026/11/06

ESCUCHAR

Descargar

En esta edición de Planeta Biblioteca entrevistamos a la bibliotecaria Marta García, durante el I Encuentro de Clubes de Lectura en Jerez de la Frontera. La invitada comparte los orígenes y la dinámica del club de lectura especializado «Página Verde» de la Biblioteca Elena Fortún en Madrid, el cual promueve la concienciación ambiental mediante la literatura y la lectura crítica. Explica que el perfil de los participantes es diverso, abordando obras que generan debate sobre el cambio climático y la sostenibilidad. A mitad del programa, Marta recomienda la canción «Laxus» del grupo Ultraligera y prosigue la conversación destacando la importancia de las bibliotecas como pilares en la educación ambiental. Asimismo, detalla cómo el club trasciende las lecturas tradicionales mediante actividades teatralizadas, meriendas literarias y salidas culturales. Para finalizar, recomienda la lectura del libro Árbol de Aya Koda y anima a la audiencia a sumarse a estas iniciativas verdes a través de las redes y la web de RECIDA

Presentación del libro «Alfabetización en datos» con Yolanda Martín, Críspulo Travieso y José Carlos Toro. Planeta Biblioteca 2026/11/09

Presentación del libro «Alfabetización en datos» con Yolanda Martín, Críspulo Travieso y José Carlos Toro

Planeta Biblioteca 2026/11/09

ESCUCHAR

Descargar

LIBRO:

MARTÍN GONZÁLEZ, Y., e IGLESIAS RODRÍGUEZ, A. (Coords.). (2026). Alfabetización en datos: Fundamentos, competencias y aplicaciones prácticas. Editorial Síntesis. https://www.sintesis.com/libro/alfabetizacion-en-datos-fundamentos-competencias-y-aplicaciones-practicas

La entrevista con Yolanda Martín González, Críspulo Travieso y José Carlos Toro, profesores de la Facultad de Traducción y Documentación de la Universidad de Salamanca, aborda la importancia de la alfabetización en datos en la sociedad actual, a partir de su libro «Alfabetización en datos: fundamentos, competencias y aplicaciones prácticas», coordinado por Yolanda Martín González y Ana Iglesias Rodríguez. Los autores explican la necesidad de desarrollar competencias para localizar, evaluar, interpretar y utilizar datos de forma crítica, tanto en el ámbito académico como en la vida cotidiana. Se analizan modelos de formación como ALFADATAUniv, la integración de estas habilidades en los planes de estudio, la búsqueda de fuentes fiables, los datos abiertos, la visualización y la gestión de datos de investigación. También se reflexiona sobre la ciencia abierta, la protección de datos personales y las implicaciones éticas de su reutilización. La entrevista destaca el papel de las bibliotecas universitarias como agentes de formación y asesoramiento en competencias relacionadas con los datos y concluye examinando los desafíos que plantean la inteligencia artificial, los sesgos algorítmicos y la necesidad de formar ciudadanos capaces de interpretar la información con espíritu crítico.

Lectura fácil con Laia Vidal Serrano y Judit Castelles Pagá. Planeta Biblioteca 2026/11/04

Lectura fácil con Laia Vidal Serrano y Judit Castelles Pagá

Planeta Biblioteca 2026/11/04

ESCUCHAR

Descargar

La entrevista con Laia Vidal Serrano y Judit Castelles Pagá, de la Asociación Lectura Fácil de Barcelona, aborda la lectura fácil como una herramienta fundamental para democratizar el acceso a la lectura, la información y la cultura, garantizando que todas las personas puedan comprender y participar en la sociedad en condiciones de igualdad. Las ponentes explican que esta metodología no se dirige únicamente a personas con dificultades de comprensión lectora, sino también a colectivos diversos que, por distintas circunstancias, necesitan contenidos más claros y accesibles. A lo largo de la conversación se analizan los criterios para adaptar textos sin perder su rigor ni su significado original, la importancia de la validación por parte de los propios lectores y el papel de las bibliotecas en la incorporación de materiales y servicios accesibles. También se aborda la aplicación de la lectura fácil a documentos administrativos, información sanitaria, páginas web y entornos digitales, así como las posibilidades y los riesgos que plantea la inteligencia artificial en la adaptación de contenidos. Finalmente, se reflexiona sobre los retos para extender esta práctica a las instituciones, centros educativos y administraciones públicas, destacando la necesidad de sensibilizar, formar profesionales y fomentar la colaboración con las personas destinatarias. La entrevista concluye con recomendaciones prácticas para que cualquier biblioteca pueda comenzar a incorporar la lectura fácil y avanzar hacia un modelo de información más inclusivo, comprensible y verdaderamente universal.

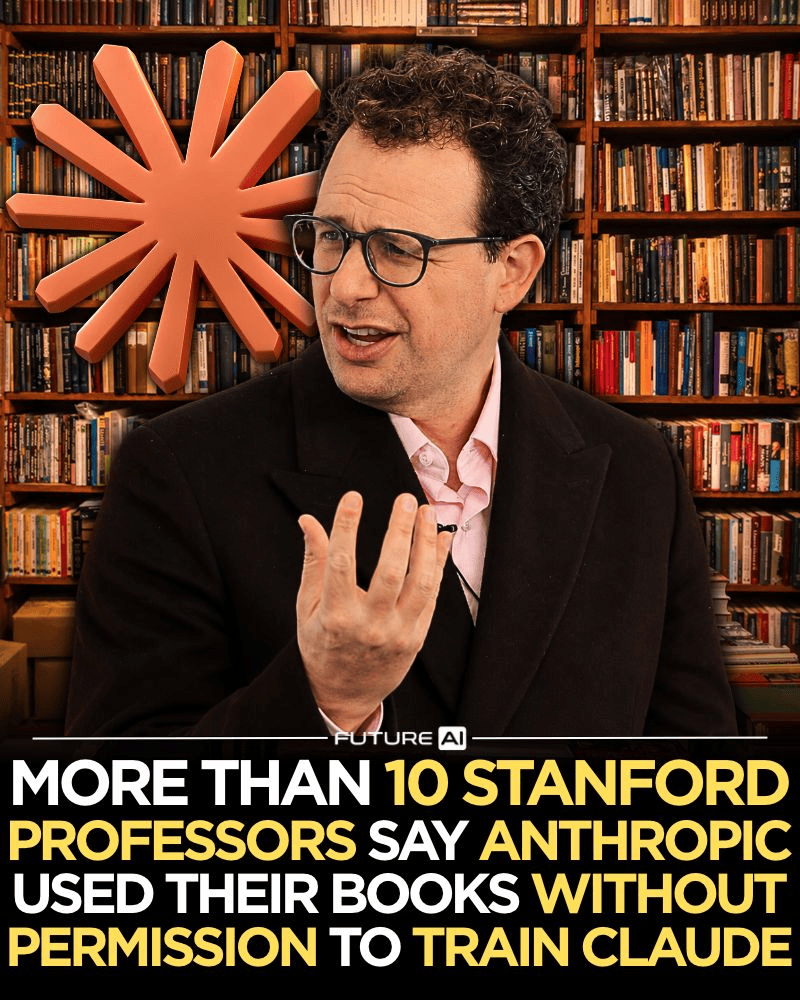
Anthropic utilizó libros pirateados de profesores de Stanford para entrenar su inteligencia artificial Claude

Yu, A. (2026, 27 de octubre). Anthropic illegally trained Claude with Stanford professors’ books. The Stanford Daily. Consultar artículo original

Se informa sobre el conflicto judicial entre Anthropic, empresa desarrolladora del modelo de inteligencia artificial Claude, y un grupo de escritores y profesores de la Universidad de Stanford cuyos libros habrían sido descargados ilegalmente y utilizados para entrenar sus modelos de inteligencia artificial.

Entre los autores afectados figuran Tobias Wolff, Abraham Verghese, Chang-Rae Lee, Daniel Mason, Hayagreeva Rao y Myra Strober. La controversia pone de manifiesto uno de los principales problemas jurídicos y éticos de la inteligencia artificial generativa: el uso de obras protegidas por derechos de autor para alimentar sistemas comerciales sin autorización de sus creadores.

El caso se relaciona con el procedimiento judicial Bartz v. Anthropic, en el que el juez federal William Alsup estableció una distinción importante entre el entrenamiento de modelos de IA y la obtención de las obras utilizadas para ese propósito. El magistrado consideró que entrenar modelos lingüísticos con libros adquiridos legalmente podía constituir un uso legítimo (fair use), al entender que el sistema aprende patrones, temas y estilos para producir contenidos diferentes. Sin embargo, rechazó que la empresa pudiera descargar libros pirateados y almacenarlos en una biblioteca central permanente para alimentar sus modelos.

El acuerdo judicial alcanzó los 1.500 millones de dólares y contempló compensaciones para autores y editoriales por casi 500.000 obras registradas. No obstante, algunos escritores consideran que esta solución resulta insuficiente. Tobias Wolff y otros 27 autores decidieron apartarse del acuerdo y presentar una demanda independiente, denominada Cruz v. Anthropic, en mayo de 2026. Reclaman indemnizaciones legales de hasta 150.000 dólares por cada obra infringida, frente a los aproximadamente 3.000 dólares por título previstos en el acuerdo colectivo. Además, buscan impedir que sus obras se utilicen para entrenar Claude sin autorización.

La demanda sostiene que Anthropic habría obtenido libros protegidos mediante bibliotecas digitales clandestinas, entre ellas LibGen y PiLiMi, descargando, reproduciendo y almacenando los archivos sin consentimiento de sus titulares. Wolff señala que diez de sus publicaciones fueron utilizadas para el entrenamiento de la IA sin permiso. El escritor expresa su preocupación por las consecuencias económicas que esta práctica puede tener para los autores, especialmente para las nuevas generaciones de escritores que dependen de los ingresos derivados de sus publicaciones.

El artículo también recoge la perspectiva de Paul Goldstein, especialista en propiedad intelectual de Stanford y participante en el litigio. Goldstein señala que uno de los grandes problemas para regular el entrenamiento de la inteligencia artificial es la dificultad de gestionar licencias individuales para millones de obras protegidas. Los costes de transacción hacen especialmente complejo obtener autorización de cada titular de derechos. Por su parte, la directora ejecutiva de Authors Guild, Mary Rasenberger, defiende que las empresas de IA deben establecer sistemas de licencias que permitan remunerar a escritores y editores y controlar cómo se utilizan sus obras.

La controversia no se limita a Anthropic. El artículo recuerda que autores, artistas visuales y medios de comunicación han presentado más de 70 demandas contra empresas de inteligencia artificial por presuntas infracciones de derechos de autor. Entre los litigios más conocidos se encuentran los promovidos por The New York Times y Getty Images. También se destaca la importancia del reconocimiento de la autoría: Paul Goldstein recuerda que muchos países reconocen derechos morales de atribución, mientras que Estados Unidos carece de una protección equivalente de carácter general.

«Bye Bye AI»: una bibliotecaria de un pequeño pueblo ofrece un curso para deshacerte de la IA en tu teléfono.

Notopoulos, K. (2026, 27 de septiembre). This small town librarian offers a ‘Bye, Bye AI’ class to take AI off your phone. Now everyone wants in. Business Insider. Leer artículo original

La biblioteca pública North Chatham Free Library, situada en una pequeña localidad del estado de Nueva York (Estados Unidos), ha conseguido repercusión internacional con una iniciativa poco habitual: un taller denominado «Bye Bye AI», destinado a enseñar a los ciudadanos cómo desactivar las funciones de inteligencia artificial incorporadas en sus teléfonos móviles, ordenadores y servicios digitales.

La iniciativa fue impulsada por Shea Wert, la única bibliotecaria a tiempo completo del centro, después de observar que numerosos usuarios manifestaban su malestar ante la incorporación automática de herramientas de inteligencia artificial en servicios que utilizaban habitualmente. Entre las quejas más frecuentes figuraban las respuestas automáticas y las sugerencias de escritura de Gmail, así como otras funcionalidades que aparecen sin que los usuarios las hayan solicitado expresamente.

La propuesta tuvo una acogida extraordinaria. El cartel anunciador del taller se difundió en Facebook y consiguió más de 8.000 reacciones y cientos de comentarios. La repercusión trascendió el ámbito local y comenzaron a llegar solicitudes de personas de otros estados e incluso de otros países interesadas en asistir, recibir una grabación o disponer de materiales para organizar actividades similares en sus propias bibliotecas.

La experiencia está relacionada con el trabajo de otra bibliotecaria, Hannah Cyrus, que había desarrollado talleres gratuitos bajo el título «Avoiding AI» (Evitar la inteligencia artificial). Su planteamiento parte de una idea especialmente interesante: las bibliotecas deben ayudar a los ciudadanos tanto a adoptar las nuevas tecnologías como a rechazarlas cuando así lo deseen. Cyrus publicó esta reflexión en una revista profesional y ha recibido solicitudes de cientos de bibliotecarios de diferentes partes del mundo interesados en utilizar sus materiales y reproducir la experiencia.

Un aspecto significativo es que la iniciativa no responde necesariamente a una postura contraria a la inteligencia artificial. Shea Wert reconoce que utiliza herramientas de IA en determinadas tareas profesionales, por ejemplo, para elaborar esquemas o redactar documentos complejos. También ayuda a los usuarios que desean aprender a utilizar modelos de lenguaje y mejorar sus instrucciones. Sin embargo, observa que una parte importante de las consultas procede de personas mayores que no quieren incorporar estas funcionalidades a sus dispositivos y necesitan recuperar el control sobre sus herramientas digitales.

La experiencia pone de manifiesto una nueva dimensión del trabajo bibliotecario: el derecho de los ciudadanos a decidir cómo, cuándo y para qué utilizan la inteligencia artificial. Las bibliotecas no deben limitarse a promover la alfabetización en IA, enseñar a utilizar herramientas o explicar sus posibilidades. También deben proporcionar conocimientos para desactivar funcionalidades, proteger la privacidad, comprender los mecanismos de automatización y ejercer una elección tecnológica consciente.

Francia crea el Premio Pascal, un galardón literario para obras escritas en colaboración con inteligencia artificial

Mouriquand, D. (2026, 22 de octubre). Prix Pascal: New French literature prize launched for books co-written with AI. Euronews. Consultar artículo original

Web: https://prixpascal.fr/index.html

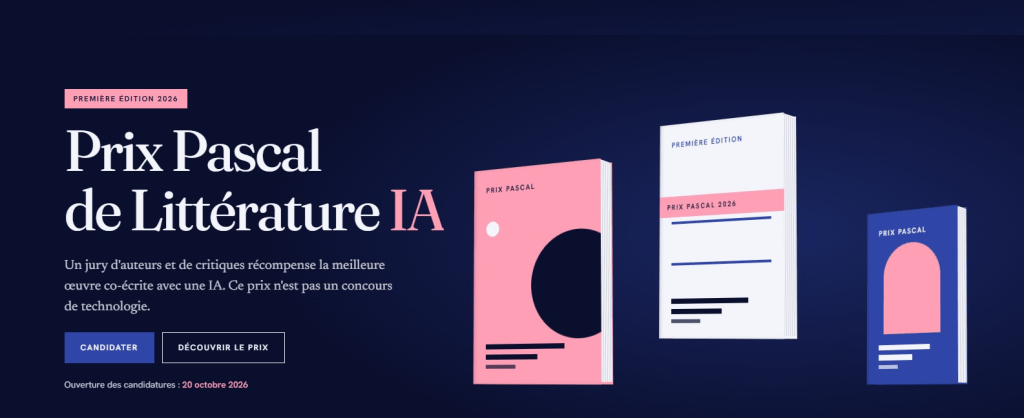
Francia ha puesto en marcha el Premio Pascal de Literatura IA (Prix Pascal de Littérature IA), un nuevo certamen literario que pretende reconocer obras creadas mediante la colaboración entre escritores e inteligencia artificial. La iniciativa supone un cambio de perspectiva en el debate sobre la relación entre literatura y tecnología: en lugar de considerar la utilización de herramientas de IA como un motivo de exclusión, propone reconocer abiertamente su participación en el proceso creativo y evaluar los resultados literarios.

El premio ha sido impulsado por tres empresarios vinculados al ámbito tecnológico: Philippe Rodriguez, Albin Serviant y Gilles Mentré. Su nacimiento se produce en un momento especialmente controvertido para el mundo editorial francés, después de varias polémicas relacionadas con la utilización de inteligencia artificial en obras que concurrían a importantes premios literarios. Los promotores consideran que la IA ya está presente en los procesos de escritura, aunque muchas veces su utilización no se declara, y que ha llegado el momento de debatir públicamente qué significa ser autor cuando una persona y una máquina participan en la creación de una obra.

El certamen lleva el nombre de Blaise Pascal, matemático, filósofo y escritor francés del siglo XVII, cuya figura representa la conexión entre pensamiento, ciencia y lenguaje. La iniciativa pretende explorar nuevas formas de creación literaria y comprobar qué posibilidades ofrece la colaboración entre la inteligencia humana y los modelos de lenguaje.

Una de las características más relevantes es su apuesta por la transparencia. Los participantes deberán presentar no solamente el manuscrito, sino también un expediente técnico que detalle los modelos de inteligencia artificial utilizados, los agentes empleados y las instrucciones o prompts que han intervenido en el proceso. Se admiten herramientas como ChatGPT, Claude, Gemini, Mistral y LLaMA. También deberán explicar la idea inicial o «semilla» (graine) de la obra, es decir, el concepto, frase o elemento que dio origen al proyecto creativo.

El premio está abierto a cualquier persona que escriba en francés, independientemente de su nacionalidad, lugar de residencia o trayectoria editorial. No es necesario haber publicado anteriormente ni contar con el respaldo de una editorial. Se exige una obra inédita de aproximadamente 300.000 caracteres, incluidos los espacios, acompañada de la documentación sobre el proceso de creación. La convocatoria contempla tanto ficción como no ficción, con especial interés por obras que aporten ideas originales o contribuyan a reflexionar sobre problemas sociales, éticos y medioambientales.

La primera edición abrió sus candidaturas el 20 de octubre de 2026 y establece el 30 de noviembre como fecha límite de presentación. El jurado seleccionará diez finalistas y anunciará el ganador en diciembre. El proyecto contempla la publicación de la obra premiada y su difusión pública. La presidencia del jurado corresponde al ensayista y escritor Jacques Attali. Entre los perfiles vinculados al jurado figuran especialistas en literatura, filosofía, crítica y propiedad intelectual.

La IA y las bibliotecas: por qué los bibliotecarios podrían convertirse en árbitros de la realidad

Friedman, Jane. (2026, 20 de abril). AI and Libraries: Why Librarians May Become Arbiters of Reality. Jane Friedman. https://janefriedman.com/ai-and-libraries-why-theyre-like-canaries-in-the-coal-mine/

Jane Friedman analiza el impacto de la inteligencia artificial generativa en las bibliotecas y en el ecosistema editorial, y plantea que los bibliotecarios podrían desempeñar una función decisiva en la defensa de la información fiable. El artículo parte de un seminario del Book Industry Study Group (BISG), en el que se presentaron datos sobre la adopción de la IA en el sector editorial y se debatió sobre sus consecuencias con el especialista en bibliotecas R. David Lankes.

La idea central es que las bibliotecas no se enfrentan a un riesgo meramente hipotético: ya están experimentando las consecuencias de la proliferación de contenidos generados automáticamente, la desinformación y la dificultad de distinguir entre materiales rigurosos y publicaciones de escasa calidad. Por ello, las bibliotecas pueden funcionar como un sistema de alerta temprana que permita identificar los problemas antes de que deterioren aún más la confianza en los recursos de información.

Uno de los resultados destacados de la encuesta del BISG es la resistencia relativamente elevada de los profesionales de las bibliotecas a la adopción de la IA. Aproximadamente un tercio de los bibliotecarios encuestados afirmó que no utilizaba estas herramientas y que tampoco tenía intención de hacerlo, frente al 20 % del conjunto de participantes de los distintos sectores analizados. Además, alrededor del 34 % manifestó una oposición ética a su utilización. Menos de la mitad señaló que su institución empleaba activamente IA, mientras que un 31 % desconocía si se estaba utilizando. La ausencia de políticas institucionales claras también aparecía como un problema relevante.

Friedman subraya que esta actitud crítica no debe interpretarse simplemente como miedo al cambio o falta de formación. Según las investigaciones de Lankes, algunos de los profesionales más reticentes conocen los modelos de lenguaje, comprenden cómo funcionan y pueden explicar técnicamente sus limitaciones. Sus objeciones se relacionan con la fiabilidad de los resultados, la calidad de los contenidos y la posibilidad de que la incorporación indiscriminada de estas tecnologías contradiga la misión fundamental de la biblioteca. La cuestión, por tanto, no consiste únicamente en aprender a utilizar la IA, sino en determinar cuándo su uso está justificado, qué valores debe respetar y qué consecuencias tiene para la calidad de los servicios bibliotecarios.

La autora evita adoptar una posición exclusivamente negativa y presenta un ejemplo que ilustra cómo la inteligencia artificial puede resolver problemas que, de otro modo, quedarían sin solución. En la Universidad de Texas existía una colección de miles de discos y grabaciones musicales que resultaba prácticamente invisible para los usuarios porque no se había podido catalogar por completo debido a la falta de recursos humanos. El equipo responsable recurrió a la IA para generar registros catalográficos preliminares, acompañados de indicadores de confianza que permitían estimar la fiabilidad de cada identificación. Los registros menos seguros podían reservarse para una revisión humana posterior, mientras que los materiales más utilizados se priorizaban para recibir una catalogación completa realizada por profesionales.

Este caso demuestra que el debate no debería reducirse a elegir entre utilizar o rechazar la inteligencia artificial. La pregunta relevante es si la tecnología permite ofrecer un servicio que, sin ella, no podría prestarse adecuadamente. Friedman establece un paralelismo con la accesibilidad editorial: las herramientas de IA pueden ayudar a producir descripciones de imágenes, mejorar metadatos y adaptar publicaciones para lectores con discapacidad cuando los recursos disponibles no permiten abordar todo ese trabajo de forma manual. La tecnología puede ampliar el acceso a la información, pero su incorporación debe estar acompañada de criterios de calidad, supervisión profesional y evaluación de resultados.

Uno de los argumentos más importantes del artículo se refiere a la dificultad de mantener los mecanismos tradicionales de evaluación y validación frente al crecimiento exponencial de los contenidos generados mediante IA. El sistema de revisión por pares, fundamental para la publicación científica, se ha desarrollado sobre la premisa de que la producción de conocimiento y la capacidad humana para revisarlo mantienen cierto equilibrio. Sin embargo, la IA permite generar textos, informes y publicaciones a una velocidad que supera ampliamente la capacidad de evaluación de los expertos.

El problema no consiste solo en que puedan producirse documentos incorrectos, sino en que resulta cada vez más difícil comprobar su calidad, procedencia y credibilidad. Tampoco basta con utilizar herramientas de inteligencia artificial para revisar automáticamente los contenidos generados por otras herramientas, puesto que la evaluación requiere criterios fiables y una capacidad de verificación independiente. Si la producción de información crece mucho más deprisa que los mecanismos para validarla, se debilitan las estructuras sobre las que se construye la confianza en el conocimiento científico y editorial.

La autora relaciona esta situación con la saturación del mercado de libros, donde el aumento de publicaciones generadas o asistidas por IA puede dificultar que los lectores encuentren obras de calidad. Cuando resulta más complicado confiar en materiales desconocidos, los usuarios pueden refugiarse en autores, fuentes y publicaciones que ya conocen. Esta tendencia reduce la visibilidad de nuevas voces y puede empobrecer la diversidad informativa y cultural.

El concepto más sugerente del artículo es la posibilidad de que los bibliotecarios se conviertan en arbiters of reality, expresión que puede traducirse como «árbitros de la realidad». La idea, vinculada a las reflexiones de R. David Lankes, no significa que los bibliotecarios deban decidir unilateralmente qué es verdadero o falso, sino que pueden ayudar a las personas a distinguir entre información documentada, afirmaciones dudosas y contenidos cuya procedencia no puede verificarse.

La biblioteca dispone de una ventaja fundamental frente a los sistemas automatizados: la mediación de profesionales que conocen las fuentes, comprenden los procesos de selección y organización documental y pueden explicar por qué un recurso resulta pertinente y fiable. Un bibliotecario puede identificar la procedencia de un documento, localizar la publicación original, contrastar distintas versiones y orientar al usuario hacia evidencias verificables. La confianza que las comunidades han depositado históricamente en las bibliotecas constituye, en este contexto, un recurso social de gran valor.

Friedman destaca una diferencia significativa entre recibir una respuesta generada por una IA y obtener orientación de un profesional bibliotecario. En el primer caso, el usuario necesita comprobar la exactitud de la respuesta y la validez de sus fuentes; en el segundo, puede contar con una persona capaz de explicar el proceso de búsqueda, contextualizar los resultados y asumir la responsabilidad profesional de la orientación ofrecida. La biblioteca puede convertirse así en un espacio de referencia y confianza en un entorno informativo donde la apariencia de seguridad de una respuesta ya no garantiza su veracidad.