Archivo de la etiqueta: Evaluación

Medir el uso de la información científica en la era de la inteligencia artificial

Investigadora frente a panel sobre medir el uso de información científica en IA
Una investigadora examina visualizaciones sobre el impacto de la inteligencia artificial en la ciencia.

Mellins-Cohen, Tasha. “Measuring Usage in the Age of AI”. Research Information, 21 de abril de 2026. Artículo original en Research Information

La expansión de la inteligencia artificial generativa y, especialmente, de los sistemas de IA capaces de actuar como agentes está transformando profundamente la manera en que los investigadores descubren, consultan y utilizan la información científica. Tasha Mellins-Cohen, directora ejecutiva de COUNTER Metrics, explica que durante más de dos décadas el estándar COUNTER ha permitido a bibliotecas, editores e instituciones disponer de estadísticas normalizadas y comparables sobre el uso de los contenidos académicos. Sin embargo, el modelo tradicional se enfrenta ahora a un fenómeno que la autora denomina “zero-click”: los investigadores pueden obtener información procedente de artículos científicos a través de buscadores, asistentes y herramientas de IA sin visitar directamente la plataforma del editor.

De este modo, un contenido puede generar un elevado valor para el investigador, su institución y su financiador sin producir ninguna visita registrada en la web de la editorial. Los datos de uso de 2025 comenzaron a mostrar precisamente esta transformación: mientras algunos editores observaban incrementos importantes en las cifras brutas de actividad, las estadísticas COUNTER registraban descensos apreciables en el uso humano tradicional. Una posible explicación es el crecimiento de la actividad automatizada y de los agentes de IA, especialmente en instituciones que han incorporado herramientas como asistentes de investigación basados en IA.

Ante esta situación, COUNTER considera que las métricas normalizadas no han perdido relevancia, sino que son más necesarias que nunca. La aparición de la IA plantea nuevas preguntas para bibliotecas y editores: ¿debe una biblioteca seguir invirtiendo en contenidos cuando buena parte de su utilización está mediada por un agente de IA?, ¿cómo debe calcularse el retorno de la inversión?, ¿cómo se compara el uso de diferentes servicios de IA?, ¿cómo se distingue la actividad de investigadores reales de los procesos automatizados? y ¿cómo se evita que el volumen de actividad de los agentes termine ocultando el comportamiento humano? La respuesta de COUNTER ha sido adaptar sus estándares para diferenciar los distintos tipos de acceso. La versión 5.1 del COUNTER Code of Practice había sido aprobada antes de la aparición de ChatGPT y, por tanto, no podía anticipar la magnitud del cambio. Después de un proceso de consulta con bibliotecas, editoriales, proveedores tecnológicos y desarrolladores de IA, COUNTER publicó en abril de 2026 nuevas buenas prácticas específicas para medir el uso asociado a la IA generativa y agéntica.

Uno de los principales cambios consiste en introducir el nuevo método de acceso “Agent”, que permite diferenciar la actividad de los sistemas de IA de la utilización humana convencional y de las operaciones de text and data mining (TDM). No todos los bots deben considerarse iguales: los rastreadores maliciosos o los crawlers continúan excluyéndose de las estadísticas, mientras que los agentes que actúan legítimamente a petición de un usuario deben poder contabilizarse. Esta distinción es fundamental porque la IA no utiliza necesariamente un artículo completo como lo haría una persona. Los sistemas de IA suelen trabajar con fragmentos o chunks de contenido, de aproximadamente 100-300 palabras, que son procesados para generar una respuesta. Por ello, COUNTER introduce nuevas métricas específicamente orientadas a la actividad de IA, diferenciando entre el acceso a metadatos y el acceso al texto completo. Entre ellas aparecen Total y Unique AI Investigations, que contabilizan el uso de fragmentos de metadatos, Total y Unique AI Requests, que registran el acceso autorizado al texto completo, y AI Responses Generated, destinado a medir las ocasiones en que una herramienta de IA genera una respuesta a partir de una consulta del usuario.

El cambio tiene importantes implicaciones para las bibliotecas universitarias y de investigación. Las estadísticas tradicionales ya no serán suficientes para comprender el verdadero impacto de las colecciones digitales, porque una parte creciente del consumo de información puede producirse fuera de las plataformas editoriales mediante asistentes de IA. Esto obliga a reconsiderar cómo se evalúa el valor de las suscripciones, las colecciones y los servicios de información. Al mismo tiempo, COUNTER advierte de que las nuevas métricas todavía se encuentran en una fase inicial. Su implantación por parte de los editores probablemente no será generalizada antes de finales de 2026 y es previsible que las primeras experiencias permitan detectar problemas y realizar modificaciones. Además, las actuales recomendaciones se concentran fundamentalmente en las herramientas de IA integradas en las plataformas de los propios editores, mientras que todavía resulta más difícil medir el uso realizado mediante servicios externos como Google Gemini u otras herramientas que acceden a contenidos de múltiples fuentes. Una segunda fase del proyecto pretende abordar precisamente estos escenarios y desarrollar mecanismos de medición para herramientas de terceros y contenidos distribuidos.

Un aspecto especialmente relevante es que el problema no se limita a contar accesos, sino que afecta a la propia concepción del valor y del impacto de la información científica. COUNTER señala que será necesario avanzar también en estándares de atribución, procedencia y metadatos, de modo que cuando una IA utilice un fragmento de un artículo pueda establecerse una relación clara con el documento original. Esto resulta particularmente importante para preservar la trazabilidad de la información, identificar correctamente las fuentes y evitar que contenidos retractados o desactualizados sean incorporados sin advertencia a las respuestas generadas por IA. La mejora de los metadatos puede contribuir simultáneamente a mejorar la inteligencia artificial, la recuperación de información y la accesibilidad. En este sentido, el desafío de medir el uso de la IA forma parte de una transformación más amplia de la comunicación científica: si la IA está cambiando la forma en que se descubren y consumen los contenidos, también será necesario reconsiderar qué significan las citas, las métricas de impacto y otras formas tradicionales de evaluación.

En definitiva, el artículo plantea que la IA no hace innecesarias las métricas de uso; las convierte en una infraestructura todavía más importante. En un entorno en el que los contenidos científicos pueden ser consultados directamente por personas, procesados por sistemas de IA, fragmentados en pequeñas unidades o reutilizados por agentes que trabajan en nombre de los investigadores, disponer de estándares comunes será esencial para que bibliotecas, editoriales y proveedores puedan comparar datos y tomar decisiones fundamentadas. El reto será conseguir que las nuevas métricas distingan adecuadamente entre actividad humana, automatización legítima y rastreo, sin perder de vista cuestiones de privacidad, atribución y procedencia. COUNTER apuesta así por evolucionar sus estándares en lugar de abandonarlos, entendiendo que precisamente cuando la tecnología cambia rápidamente es cuando más necesaria resulta una terminología y una metodología compartida.

La evaluación en la era de la inteligencia artificial: el próximo gran cambio que necesita la educación

Richards-Hill, Jaye. Assessment in the Age of AI: The Next Great Education Reform. LinkedIn, 2026.

La irrupción de la inteligencia artificial generativa está obligando a replantear uno de los pilares fundamentales del sistema educativo: la evaluación. En su reflexión, Jaye Richards-Hill sostiene que el verdadero desafío no consiste en impedir que el alumnado utilice herramientas como ChatGPT, Claude o Gemini, sino en reconocer que los métodos tradicionales de evaluación han dejado de ser suficientes para medir el aprendizaje auténtico.

La facilidad con la que la IA puede producir ensayos, resolver problemas o generar proyectos cuestiona la validez de pruebas diseñadas para evaluar únicamente el producto final, impulsando una transformación profunda del modo en que se certifican los conocimientos y las competencias.

El artículo plantea que la educación debe abandonar un modelo centrado en la reproducción de contenidos y avanzar hacia evaluaciones que valoren procesos cognitivos complejos. En este nuevo escenario adquieren especial relevancia competencias difícilmente automatizables, como el pensamiento crítico, la creatividad, la capacidad de argumentación, el juicio ético, la resolución de problemas abiertos, la comunicación y la reflexión metacognitiva. Más que comprobar si un estudiante puede producir un texto, el objetivo pasa a ser comprender cómo llega a sus conclusiones, cómo utiliza la IA de manera responsable y qué valor intelectual aporta al resultado final.

Richards-Hill también subraya que esta transformación exige un cambio cultural dentro de las instituciones educativas. Los docentes deberán diseñar experiencias de aprendizaje más auténticas, incorporar evaluaciones continuas, presentaciones orales, proyectos colaborativos, portafolios digitales y actividades que hagan visible el proceso de aprendizaje. En lugar de perseguir un imposible «examen a prueba de IA», la propuesta consiste en integrar estas tecnologías de forma transparente, estableciendo normas claras sobre su uso y evaluando la capacidad del alumnado para trabajar conjuntamente con ellas de manera crítica y ética.

Finalmente, el autor defiende que la inteligencia artificial representa una oportunidad histórica para impulsar la mayor reforma educativa de las últimas décadas. Igual que en otros momentos la llegada de Internet o de las tecnologías digitales obligó a redefinir la enseñanza, la IA invita ahora a revisar los fundamentos de la evaluación. El éxito de esta transición dependerá de que universidades y centros educativos dejen de considerar la IA únicamente como un riesgo para la integridad académica y comiencen a utilizarla como catalizador para construir modelos de evaluación más relevantes, flexibles y alineados con las competencias que demandará la sociedad del conocimiento en el futuro.

Modelo Europeo de Gestión de Calidad. Guía para la Autoevaluación: una herramienta para la mejora continua de las organizaciones educativas

Modelo Europeo de Gestión de Calidad. Guía para la Autoevaluación: una herramienta para la mejora continua de las organizaciones educativas Dirección General de Centros Educativos 1997 https://www.libreria.educacion.gob.es/ebook/180544/free_download/

La Guía para la Autoevaluación constituye el documento de referencia para la implantación del Modelo Europeo de Gestión de Calidad (EFQM) en centros educativos. Su propósito es ofrecer una metodología sistemática que permita a las instituciones analizar de manera objetiva su funcionamiento, identificar fortalezas y detectar áreas de mejora, impulsando un proceso continuo de innovación y excelencia organizativa. La guía parte de la premisa de que la calidad educativa no depende únicamente de los resultados académicos, sino también de la eficacia del liderazgo, la planificación, la gestión de las personas, los recursos y los procesos que sustentan la actividad del centro.

El mayor escándalo de fraude académico con IA en la Ivy League reabre el debate sobre la evaluación universitaria

Tangermann, V. (2026). Brown University Professor Horrified to Discover Largest AI Cheating Scandal in Ivy League History. Futurism, 30 de junio de 2026. https://futurism.com/artificial-intelligence/brown-university-professor-cheating-scandal-ivy-league?utm_source=flipboard&utm_content=other

El artículo analiza el que podría convertirse en el mayor caso documentado de fraude académico relacionado con inteligencia artificial en una universidad de la Ivy League. El protagonista es Roberto Serrano, profesor de Economía en Brown University, quien sostiene haber reunido pruebas concluyentes de un uso masivo de herramientas como ChatGPT durante un examen de evaluación continua. El caso ha despertado una intensa discusión sobre la eficacia de los actuales sistemas de evaluación y sobre el impacto que la inteligencia artificial generativa está teniendo en la educación superior.

Las sospechas surgieron tras corregir un examen parcial de una asignatura avanzada de Economía Matemática. De los 86 estudiantes matriculados, 40 obtuvieron la máxima calificación (100 sobre 100) y la nota media alcanzó los 96 puntos, unos resultados extraordinariamente inusuales para una prueba de ese nivel. Intrigado por estos datos, Serrano comparó varias respuestas con las generadas por ChatGPT y detectó coincidencias llamativas, incluyendo expresiones poco habituales y razonamientos prácticamente idénticos a los producidos por el modelo de inteligencia artificial. Según el profesor, la evidencia acumulada apuntaba claramente a un uso indebido de herramientas de IA durante un examen que debía resolverse de forma individual y bajo el código de honor de la universidad.

Las sospechas se reforzaron cuando llegó el examen final presencial. En esa prueba, que representaba una parte importante de la calificación definitiva, la nota media descendió hasta 48 puntos sobre 100, una diferencia difícil de explicar únicamente por la distinta naturaleza de los exámenes. Además, 27 estudiantes ni siquiera acudieron al examen final, entre ellos 22 que habían obtenido previamente una puntuación perfecta en la prueba domiciliaria. Para Serrano, esta enorme discrepancia constituye una evidencia empírica muy sólida de que una parte significativa de los estudiantes recurrió a la inteligencia artificial para resolver el examen realizado fuera del aula.

El artículo también pone el foco en la respuesta institucional. Según explica el profesor, la reacción inicial de la dirección universitaria fue muy limitada y no reflejó, a su juicio, la gravedad de los hechos. Aunque el caso terminó siendo remitido al comité encargado de velar por la integridad académica, Serrano lamenta la falta de una respuesta contundente por parte de las autoridades universitarias y advierte de que la defensa de la honestidad académica no puede recaer únicamente sobre el profesorado. Considera que las universidades necesitan políticas más claras y mecanismos de actuación mucho más ágiles para afrontar este nuevo escenario marcado por la inteligencia artificial generativa.

Más allá del episodio concreto, el artículo plantea una reflexión de alcance mucho mayor sobre el futuro de la evaluación universitaria. La aparición de modelos de lenguaje capaces de resolver problemas complejos, redactar ensayos o generar explicaciones de alta calidad cuestiona la validez de muchas formas tradicionales de examen, especialmente aquellas realizadas a distancia o sin supervisión. La experiencia descrita en Brown sugiere que los sistemas basados exclusivamente en la confianza o en el tradicional «Honor Code» pueden resultar insuficientes cuando los estudiantes tienen acceso inmediato a herramientas de IA extremadamente potentes.

En conjunto, el caso ilustra uno de los mayores desafíos que afronta actualmente la educación superior. Más que confiar en la detección del fraude mediante herramientas tecnológicas, el episodio refuerza la necesidad de rediseñar los métodos de evaluación para valorar competencias difíciles de delegar en una IA, como el razonamiento crítico, la argumentación, la resolución de problemas en contextos auténticos o la defensa oral del trabajo realizado. El escándalo de Brown evidencia que la irrupción de la inteligencia artificial no solo obliga a replantear las normas de integridad académica, sino también el propio modelo de enseñanza y evaluación sobre el que se ha sustentado la universidad durante décadas.

Por qué las emociones también importan en la comunicación académica

Irfanullah, H. (2026). The Emotional Rollercoaster of Scholarly Publishing. The Scholarly Kitchen, 6 de julio de 2026. The Scholarly Kitchen

La publicación científica suele analizarse desde una perspectiva centrada en los procesos editoriales, la revisión por pares, los indicadores bibliométricos o la integridad de la investigación. Sin embargo, Haseeb Irfanullah propone un enfoque diferente: situar las emociones de quienes participan en este ecosistema en el centro del debate.

El autor sostiene que autores, revisores y editores experimentan una auténtica «montaña rusa emocional» a lo largo del ciclo de publicación, marcada por la incertidumbre, la frustración, la esperanza, la satisfacción o el agotamiento. A pesar de que estas emociones influyen directamente en la calidad del trabajo científico y en el bienestar de sus protagonistas, rara vez son consideradas en el diseño de las políticas editoriales o en la gestión de las revistas.

El artículo parte de una experiencia personal del propio autor para mostrar cómo la relación entre investigadores y revistas puede evolucionar de maneras muy distintas según las respuestas emocionales que generan los procesos editoriales. La larga espera para recibir una decisión, las revisiones contradictorias, el rechazo de un manuscrito o la falta de comunicación por parte de las revistas provocan sentimientos de ansiedad, desmotivación e incluso pérdida de confianza. Estas experiencias no afectan únicamente a quienes publican; también repercuten en su disposición futura para aceptar invitaciones como revisores o colaborar con determinadas publicaciones. Irfanullah recuerda que detrás de cada manuscrito hay personas cuya trayectoria profesional y estado emocional pueden verse profundamente condicionados por la forma en que se gestionan estos procesos.

El autor amplía posteriormente la reflexión al conjunto del sistema de comunicación científica. Se pregunta cómo se sienten los propios editores cuando son conscientes de que determinadas políticas editoriales o retrasos perjudican a los autores, y si las estructuras actuales favorecen realmente relaciones más humanas entre todos los actores implicados. Esta mirada invita a reconsiderar los desequilibrios de poder existentes en la publicación académica, donde los autores suelen ocupar la posición más vulnerable mientras dependen de decisiones tomadas por editores, revisores y editoriales. Incorporar la dimensión emocional permitiría construir procesos editoriales más empáticos, transparentes y respetuosos, sin renunciar al rigor científico.

Otro de los aspectos destacados del artículo es la relación entre las emociones y las profundas transformaciones que atraviesa la comunicación científica. Irfanullah aborda cuestiones como el crecimiento descontrolado del número de publicaciones, la presión constante por publicar, la dependencia de indicadores bibliométricos y los problemas de integridad científica derivados de este modelo. También analiza el papel emergente de los servidores de preprints y de la inteligencia artificial aplicada a la revisión científica, preguntándose si estos cambios acabarán modificando o incluso sustituyendo el modelo tradicional de revista académica, vigente desde 1665. Frente a estas incertidumbres, el autor invita a reflexionar no solo sobre las implicaciones técnicas o económicas de estas innovaciones, sino también sobre las emociones que generan entre quienes participan en el sistema científico.

En la parte final, el artículo plantea una llamada a humanizar la publicación académica. Para Irfanullah, las decisiones que toman investigadores, revisores, editores y editoriales no responden únicamente a criterios racionales, sino que están profundamente influidas por emociones como la confianza, el miedo, la ilusión o el cansancio. Reconocer explícitamente esta dimensión permitiría diseñar políticas editoriales más sensibles al bienestar de la comunidad investigadora y favorecer una cultura científica menos dominada por la presión de publicar y más orientada a la colaboración, la calidad y el impacto social del conocimiento. La comunicación científica, concluye el autor, no puede entenderse únicamente como un proceso técnico; es, ante todo, una actividad profundamente humana.

Por qué el impacto científico es más que una simple cuestión de números

Banino, Yehonatan. “Guest Post — Beyond the Prestige: Why Scientific Impact is More Than a Numbers Game”. En The Scholarly Kitchen, 1 de julio de 2026. Publicado por la Society for Scholarly Publishing.

El autor plantea una crítica profunda al modo en que tradicionalmente se evalúa el impacto de la investigación científica. Durante décadas, la academia ha utilizado métricas cuantitativas simples, especialmente el número bruto de citas recibidas por un artículo o el prestigio de la revista donde se publica, como indicadores casi absolutos del valor de una investigación. Sin embargo, Banino argumenta que esta visión resulta limitada e incluso engañosa, ya que reduce la complejidad del conocimiento científico a cifras descontextualizadas que no reflejan adecuadamente la verdadera influencia de un trabajo académico.

Uno de los argumentos centrales del texto es que las citas, por sí solas, carecen de significado cuando no se interpretan dentro de un contexto comparativo adecuado. Un artículo que ha recibido veinticinco citas puede parecer exitoso, pero ese número solo adquiere sentido cuando se analiza en relación con otros trabajos publicados en la misma disciplina, en el mismo periodo temporal y dentro de comunidades científicas similares. El autor utiliza una analogía pedagógica: dos estudiantes pueden obtener exactamente la misma nota en un examen, pero el valor real de esa calificación cambia radicalmente dependiendo del promedio general del grupo. De igual manera, una cifra aislada en ciencia no representa necesariamente impacto o calidad.

Banino propone superar esta visión tradicional mediante herramientas de evaluación más sofisticadas, centradas en métricas relativas en lugar de métricas absolutas. En este contexto presenta el llamado YCR-index, un sistema que busca medir la influencia científica tomando en cuenta factores comparativos como el área temática, el año de publicación y el comportamiento general de trabajos equivalentes. Según esta perspectiva, el verdadero valor científico no debe medirse simplemente contando citas, sino analizando cómo una investigación destaca dentro de su ecosistema académico específico. La propuesta intenta corregir lo que denomina la “trampa de la citación bruta”, es decir, la falsa idea de que más citas equivalen automáticamente a mayor relevancia científica.

El artículo también se inserta dentro de un debate cada vez más amplio en la comunicación académica contemporánea sobre las limitaciones de indicadores tradicionales como el Impact Factor, el h-index y otros sistemas bibliométricos. Diversos sectores de la comunidad científica han advertido que estas métricas han terminado incentivando prácticas problemáticas: presión excesiva por publicar en revistas prestigiosas, priorización del volumen sobre la calidad, estrategias editoriales diseñadas para aumentar artificialmente las citas y desigualdades estructurales que perjudican especialmente a investigadores jóvenes o pertenecientes a regiones periféricas del sistema científico global.

En el fondo, la reflexión de Banino invita a reconsiderar qué significa realmente “impacto científico”. La ciencia, sostiene implícitamente el autor, no puede evaluarse únicamente mediante indicadores cuantitativos porque su verdadero valor reside también en factores más difíciles de medir: la originalidad de una idea, su capacidad de transformar paradigmas, su utilidad social, su influencia a largo plazo y su contribución al avance colectivo del conocimiento. En una época marcada por debates sobre ciencia abierta, inteligencia artificial, transparencia editorial y nuevas formas de evaluación académica, este texto representa una defensa de modelos más justos, contextualizados y humanizados para valorar la producción científica.

El artículo constituye una llamada a abandonar la dependencia excesiva de los indicadores numéricos y avanzar hacia una cultura científica donde el valor de la investigación no quede determinado exclusivamente por el prestigio editorial o por estadísticas de citación, sino por la auténtica contribución intelectual y social que cada trabajo aporta al ecosistema global del conocimiento.

Clarivate publica el Journal Citation Reports 2026

Research Information. “Clarivate Releases Journal Citation Reports 2026”. Junio de 2026. Basado en el anuncio oficial de Clarivate Analytics

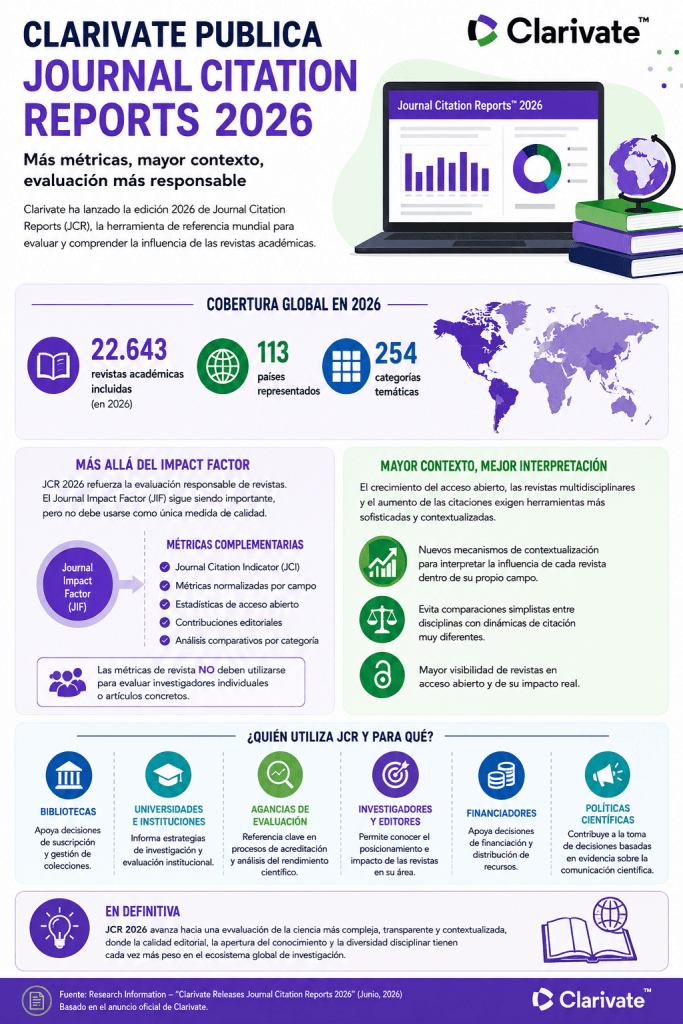
Clarivate ha presentado la edición 2026 de su influyente informe Journal Citation Reports (JCR), una de las herramientas bibliométricas más utilizadas en el mundo académico para evaluar el impacto y la influencia de las revistas científicas. Esta nueva edición refuerza la apuesta por una evaluación más responsable, contextualizada y multidimensional de las publicaciones científicas, en un momento en que la comunidad investigadora cuestiona cada vez más la dependencia exclusiva del tradicional Impact Factor.

El informe, integrado en la plataforma Journal Citation Reports de Clarivate, amplía significativamente su cobertura global. La edición 2026 incorpora 22.643 revistas académicas procedentes de 113 países y distribuidas en 254 categorías temáticas, consolidando a JCR como uno de los repertorios de referencia para universidades, bibliotecas, agencias de evaluación e instituciones científicas. La metodología mantiene un enfoque estable que permite comparaciones longitudinales entre disciplinas y seguimiento de tendencias de publicación a escala internacional.

Una de las principales líneas de evolución del JCR 2026 es el énfasis en la evaluación responsable de revistas, reduciendo la centralidad histórica del Journal Impact Factor (JIF) como único indicador de calidad. Clarivate insiste en que las métricas de revista no deben utilizarse para evaluar directamente investigadores individuales o artículos concretos. En este sentido, la plataforma complementa el JIF con indicadores adicionales como el Journal Citation Indicator (JCI), métricas normalizadas por campo disciplinar, estadísticas de acceso abierto, datos sobre contribuciones editoriales y análisis comparativos por categoría científica.

El lanzamiento refleja también cambios más amplios en el ecosistema de la comunicación científica. Según Clarivate, el crecimiento de modelos de publicación en acceso abierto, la expansión de revistas multidisciplinares y el aumento global del volumen de citación exigen herramientas analíticas más sofisticadas. Por ello, JCR 2026 incorpora nuevos mecanismos de contextualización que permiten interpretar mejor la influencia de una revista dentro de su propio campo, evitando comparaciones simplistas entre disciplinas con dinámicas de citación muy diferentes.

Para bibliotecarios, gestores de colecciones y responsables universitarios, esta actualización resulta especialmente relevante porque influye directamente en políticas de suscripción, estrategias de adquisición, decisiones de financiación y evaluación institucional de la investigación. El sistema sigue funcionando como referencia central en numerosos procesos de acreditación académica y análisis del rendimiento científico internacional, aunque en paralelo continúa creciendo el debate sobre alternativas más abiertas y menos dependientes de métricas cuantitativas tradicionales.

La inteligencia artificial busca artículos científicos, pero ¿Cómo evaluar sus resultados?

Aaron Tay. “AI Academic Search and the Missing Benchmark Problem”. Aaron Tay’s Musings about Librarianship, 2026.

Uno de los problemas más importantes en la evaluación de los sistemas de búsqueda académica basados en inteligencia artificial: la ausencia de estándares de referencia sólidos y compartidos. Mientras proliferan herramientas como Elicit, Consensus, Scite, Scopus AI o los sistemas de “Deep Research”, existe una gran dificultad para determinar objetivamente cuál de ellas ofrece mejores resultados, ya que no disponemos de benchmarks ampliamente aceptados que permitan comparar su rendimiento de forma rigurosa.

Tay señala que la situación recuerda a los primeros años de otros campos de la inteligencia artificial, donde los avances tecnológicos fueron más rápidos que los mecanismos de evaluación. Muchas plataformas promocionan capacidades como la búsqueda semántica, la recuperación aumentada por generación (RAG), la identificación automática de literatura relevante o la elaboración de revisiones bibliográficas asistidas por IA. Sin embargo, los usuarios suelen disponer únicamente de demostraciones comerciales o ejemplos seleccionados por los propios desarrolladores, lo que dificulta conocer el rendimiento real de estas herramientas en contextos de investigación auténticos.

Uno de los argumentos centrales del autor es que la búsqueda académica constituye un problema mucho más complejo que responder preguntas generales. No basta con recuperar documentos relacionados; también es necesario encontrar trabajos relevantes aunque utilicen terminología diferente, identificar literatura seminal, reconocer relaciones de citación y ofrecer resultados adecuados para distintas etapas del proceso investigador. Debido a ello, evaluar únicamente la precisión de una respuesta generada por IA resulta insuficiente.

El artículo destaca además que muchas pruebas actuales se centran en tareas demasiado simples. Un sistema puede responder correctamente a preguntas factuales concretas y aun así fracasar cuando se enfrenta a necesidades reales de investigación, como localizar artículos fundamentales omitidos en una revisión bibliográfica, detectar debates emergentes o construir estrategias de búsqueda exhaustivas. Tay sostiene que los escenarios de evaluación deberían reflejar mejor las tareas cotidianas de investigadores, estudiantes y bibliotecarios.

Otro problema importante es la falta de transparencia. Muchas herramientas académicas basadas en IA funcionan mediante modelos propietarios cuyos índices documentales, algoritmos de recuperación y mecanismos de clasificación no son públicos. Como consecuencia, resulta difícil reproducir experimentos o comprender por qué dos sistemas ofrecen resultados distintos ante la misma consulta. Esta opacidad limita la posibilidad de desarrollar evaluaciones comparables y acumulativas.

Tay también subraya que la calidad de un sistema RAG depende de dos componentes distintos: la recuperación de información y la generación de respuestas. Un modelo puede producir un texto aparentemente convincente pero basado en documentos poco relevantes, o bien recuperar excelentes artículos y resumirlos de forma deficiente. Por ello, propone evaluar por separado la capacidad de recuperación y la fidelidad de la síntesis generada.

En sus análisis previos sobre herramientas de búsqueda académica, el autor ha mostrado que algunos sistemas especializados fracasan en tareas relativamente sencillas para un investigador humano, mientras que modelos generales pueden resolverlas con más eficacia. Estos resultados sugieren que muchas plataformas funcionan mediante flujos de trabajo predefinidos que son muy eficaces en determinados escenarios, pero menos flexibles cuando la consulta se aparta de los casos previstos por sus diseñadores.

El texto conecta además con una cuestión más amplia dentro de la inteligencia artificial: la importancia de los benchmarks. Históricamente, disciplinas como el procesamiento del lenguaje natural o la visión artificial han avanzado gracias a conjuntos de pruebas estandarizados que permiten comparar sistemas bajo condiciones comunes. Sin estándares equivalentes para la búsqueda académica asistida por IA, resulta difícil distinguir entre mejoras reales y simples estrategias de marketing.

Aaron Tay defiende la necesidad de construir marcos de evaluación abiertos, transparentes y orientados a tareas reales de investigación. Solo mediante benchmarks compartidos será posible determinar qué herramientas mejoran verdaderamente el descubrimiento académico y cuáles simplemente generan respuestas convincentes. Para bibliotecarios, investigadores y responsables institucionales, esta cuestión resulta especialmente relevante en un momento en que las plataformas de búsqueda basadas en IA comienzan a integrarse en bases de datos científicas, catálogos bibliotecarios y servicios de apoyo a la investigación.

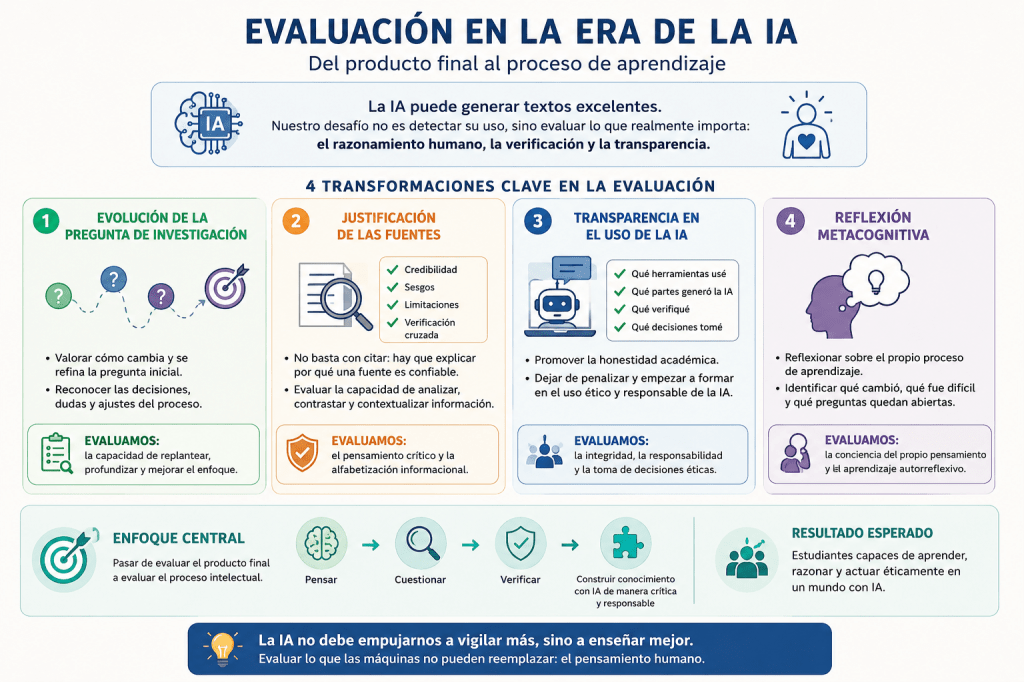
Repensar la evaluación en tiempos de inteligencia artificial: del producto final al proceso de aprendizaje

The AI School Librarian. “Grading in the AI Era: Research Literacy in the Age of AI, Week 13: How to Assess Reasoning, Verification, and Transparency.” The AI School Librarians Newsletter, 20 de abril de 2026. Substack. The AI School Librarians Newsletter

Se plantea una reflexión profunda sobre la crisis actual de los sistemas de evaluación educativa en un contexto marcado por la expansión de la inteligencia artificial generativa. El texto parte de una premisa contundente: si las rúbricas y modelos de calificación continúan premiando principalmente el acabado formal, la corrección gramatical o la apariencia de sofisticación textual, las herramientas de IA superarán fácilmente los criterios tradicionales de evaluación. Según el artículo, el problema central ya no consiste en “detectar trampas” o descubrir cuándo un estudiante ha utilizado IA, sino en replantear qué significa realmente aprender y qué aspectos del proceso intelectual merecen ser valorados.

La autora sostiene que gran parte de los sistemas educativos siguen fundamentándose en una lógica de evaluación heredada de la era pre-IA, centrada casi exclusivamente en el producto final: ensayos terminados, trabajos perfectamente estructurados, citas formateadas correctamente y redacciones libres de errores. Sin embargo, la inteligencia artificial es capaz de generar con rapidez precisamente ese tipo de productos. En consecuencia, la escuela se enfrenta a una disyuntiva fundamental: continuar evaluando elementos superficiales que las máquinas pueden imitar fácilmente o desplazar el foco hacia procesos cognitivos más complejos y genuinamente humanos. El texto insiste en que la verdadera evidencia del aprendizaje no reside únicamente en el resultado visible, sino en el recorrido intelectual que conduce hasta él: las dudas, revisiones, decisiones, errores, verificaciones y transformaciones del pensamiento.

Uno de los aspectos más relevantes del artículo es la idea de que la IA obliga a redefinir el concepto mismo de “autoría intelectual”. Tradicionalmente, muchos modelos de evaluación asumían que el texto presentado reflejaba directamente el pensamiento del estudiante. Sin embargo, en un escenario donde una herramienta puede redactar párrafos coherentes, producir tesis convincentes o incluso estructurar investigaciones completas, el profesorado necesita nuevas estrategias para distinguir entre producción automática y apropiación auténtica del conocimiento. El artículo argumenta que la clave no está en prohibir la IA, sino en diseñar evaluaciones capaces de hacer visible el razonamiento humano que hay detrás del trabajo.

Para responder a este desafío, el texto propone cuatro transformaciones estructurales en la evaluación. La primera consiste en calificar la evolución de la pregunta de investigación. En lugar de valorar únicamente la tesis final, se recomienda que el alumnado entregue también la pregunta inicial, las modificaciones posteriores y una explicación de cómo y por qué cambió su enfoque. Esta estrategia busca reconocer el refinamiento intelectual y la capacidad de replantear problemas, algo que constituye una parte esencial del pensamiento crítico. El aprendizaje deja así de verse como un acto instantáneo y pasa a entenderse como un proceso dinámico de exploración y reconstrucción conceptual.

La segunda transformación se centra en la justificación de las fuentes. El artículo subraya que, en una época saturada de información y contenido generado algorítmicamente, ya no basta con citar fuentes; es necesario demostrar por qué una fuente merece confianza. El alumnado debería explicar la credibilidad de los materiales utilizados, detectar sesgos, identificar limitaciones y contrastar datos mediante verificación cruzada. Esta orientación conecta directamente con las competencias de alfabetización informacional y mediática que tradicionalmente han promovido bibliotecarios y especialistas en documentación. La evaluación, por tanto, se desplaza desde la mera acumulación de referencias hacia la capacidad crítica para analizarlas y contextualizarlas.

La tercera propuesta del artículo es incorporar la transparencia como criterio explícito de evaluación. La autora defiende que los estudiantes deberían informar abiertamente sobre cómo utilizaron herramientas de IA, qué partes verificaron y qué decisiones éticas tomaron durante el proceso. Este enfoque intenta sustituir los modelos punitivos basados en vigilancia y sospecha por una cultura académica de honestidad y reflexión. En vez de criminalizar el uso de la inteligencia artificial, el sistema educativo debería enseñar a utilizarla de manera responsable, crítica y documentada. Según el texto, normalizar la transparencia reduce la dependencia de detectores automáticos de IA, cuya fiabilidad es limitada y cuya aplicación puede generar injusticias y desconfianza institucional.

La cuarta transformación aborda la importancia de la reflexión metacognitiva. El artículo propone que los estudiantes respondan preguntas relacionadas con la evolución de su pensamiento: qué cambió durante la investigación, qué evidencias resultaron más débiles o qué interrogantes quedaron sin resolver. Estas actividades buscan que el alumnado tome conciencia de sus propios procesos intelectuales y convierta el aprendizaje en una experiencia autorreflexiva. Además, la metacognición resulta especialmente difícil de automatizar, ya que implica conectar experiencias personales, decisiones contextuales y procesos internos de razonamiento.

Otro aspecto significativo del artículo es su crítica implícita a la cultura educativa basada exclusivamente en resultados cuantificables y estandarizados. La IA pone en evidencia las limitaciones de sistemas que privilegian la eficiencia, la apariencia formal y la producción rápida de textos. Frente a ello, la autora defiende modelos de evaluación más lentos, procesuales y centrados en la construcción del pensamiento. En esta visión, el aula deja de ser un espacio donde únicamente se “entregan productos” para convertirse en un entorno donde se documenta el desarrollo intelectual.

El texto también se relaciona con debates más amplios sobre alfabetización digital y ciudadanía crítica. La capacidad para verificar información, justificar decisiones y reflexionar sobre el uso ético de herramientas tecnológicas se presenta como una competencia esencial del siglo XXI. De este modo, la evaluación deja de ser solamente un mecanismo de medición académica y se transforma en un espacio de formación ética e intelectual. El artículo sugiere que la irrupción de la IA puede convertirse en una oportunidad para corregir debilidades estructurales que ya existían en los sistemas educativos mucho antes de la aparición de ChatGPT y otras plataformas generativas.

“Grading in the AI Era” propone una visión educativa basada en la autenticidad del pensamiento, la trazabilidad del aprendizaje y la centralidad del razonamiento humano. El artículo concluye que la inteligencia artificial no debería obligar a las instituciones educativas a reforzar modelos de vigilancia, sino a rediseñar profundamente sus prácticas pedagógicas. La verdadera cuestión ya no es si los estudiantes utilizan IA, sino si las escuelas son capaces de evaluar aquello que realmente importa: la capacidad de pensar, cuestionar, verificar, interpretar y construir conocimiento propio en colaboración crítica con las tecnologías emergentes

Guía de evaluación de sistemas de IA en entornos bibliotecarios

Cox, Andrew, y Maria De Brasdefer. IFLA Entry Point to Libraries and AI. International Federation of Library Associations and Institutions (IFLA), 2025. https://repository.ifla.org/items/f197f327-dc49-4743-bb57-0a373505da8b

Entry Point for Libraries and AI

Licensing an AI service from a publisher

La Inteligencia Artificial (IA) ofrece un gran potencial para apoyar los valores fundamentales de las bibliotecas, como el acceso equitativo a la información y la creación de conocimiento. Sin embargo, también es una tecnología controvertida, cuyos avances actuales suscitan inquietudes éticas y sociales. Las bibliotecas desempeñan un papel clave en la promoción de usos responsables, inclusivos y sostenibles de la IA. Sus valores —libertad de expresión, privacidad, transparencia y rendición de cuentas— proporcionan una perspectiva ética para interactuar con las herramientas y prácticas de la IA. Este documento define la IA en un sentido amplio y ofrece un conjunto práctico de preguntas para la reflexión que ayudan a los profesionales de las bibliotecas a evaluar las oportunidades y los riesgos.

El texto plantea un escenario de reflexión sobre la incorporación de herramientas de inteligencia artificial en los servicios de bibliotecas, concretamente en el caso de la posible licitación de un sistema de búsqueda potenciado por IA ofrecido por una editorial científica. Este sistema promete mejorar significativamente la recuperación de información mediante resúmenes automáticos de publicaciones, lo que obliga a los profesionales de la biblioteca a evaluar críticamente su pertinencia, utilidad y riesgos antes de su adopción.

Para ello, se propone la creación de un equipo interdisciplinar formado por especialistas en sistemas bibliotecarios, biblioteconomía, alfabetización informacional y derechos de autor. Este grupo debe elaborar una lista de preguntas clave para analizar la herramienta desde múltiples perspectivas: ética, funcionalidad, impacto institucional, fiabilidad, transparencia y adecuación a las necesidades reales de los usuarios. El objetivo no es solo valorar la innovación tecnológica, sino determinar si realmente aporta beneficios significativos frente a otras soluciones existentes y si su coste está justificado dentro de las prioridades de la biblioteca.

El documento se estructura a partir de un marco de 14 preguntas que sirven como guía de evaluación de sistemas de IA en entornos bibliotecarios. Estas cuestiones abordan aspectos como la calidad y precisión de la información generada por la IA, los posibles sesgos, la protección de la diversidad cultural y lingüística, la equidad en el acceso, la privacidad de los datos de los usuarios y la transparencia del funcionamiento del sistema. También se examina quién es responsable de los posibles errores del sistema y cómo se comunican sus limitaciones a los usuarios.

Asimismo, se subraya la importancia de garantizar que los datos utilizados por la IA no provengan de fuentes obtenidas de manera ilegítima y que se respeten los derechos de autor y la soberanía de los datos culturales. Otro eje central es la necesidad de mantener la agencia del usuario, es decir, que las personas puedan seguir controlando su interacción con la tecnología sin que esta sustituya sus habilidades críticas o de aprendizaje.

Las 14 preguntas funcionan como un marco de evaluación crítica para que las bibliotecas analicen la incorporación de sistemas de inteligencia artificial, especialmente en servicios de información y descubrimiento. No son un checklist técnico cerrado, sino una guía amplia que permite valorar tanto el impacto funcional como las implicaciones éticas, sociales y organizativas de estas herramientas.

  1. Valor y pertinencia del servicio. La pregunta inicial obliga a la biblioteca a identificar qué tipo de beneficio real aporta la IA en términos de acceso al conocimiento y creación de información. No se trata solo de si la herramienta es innovadora, sino de si mejora de forma significativa la experiencia del usuario frente a alternativas más simples o económicas. Aquí se introduce también el concepto de “coste de oportunidad”: invertir en IA implica renunciar a otros posibles servicios o mejoras.

2, Calidad de la información generada por la IA, especialmente su precisión, actualización e imparcialidad. En entornos bibliotecarios esto es crucial, ya que los sistemas de IA pueden generar resúmenes o síntesis que parecen fiables pero contienen errores, sesgos o simplificaciones. Además, se plantea la necesidad de monitorización continua, ya que estos sistemas pueden cambiar su rendimiento con el tiempo.

3. Sesgos . Se evalúa si la IA reproduce estereotipos o excluye perspectivas culturales y lingüísticas. Esto es especialmente relevante en bibliotecas, cuyo objetivo tradicional es garantizar el acceso equitativo a la información.

4. Diversidad del conocimiento. También se analiza si el sistema favorece únicamente contenido en inglés o si integra fuentes multilingües y diversas.

5. Mal uso del sistema, especialmente en relación con la desinformación o la censura. Aunque menos desarrollada en el texto, apunta a un problema creciente: la posibilidad de que herramientas avanzadas de IA sean utilizadas para manipular o distorsionar información académica o científica.

6. Equidad y accesibilidad, considerando si todos los usuarios pueden beneficiarse del sistema en igualdad de condiciones. Aquí se incluyen aspectos como la accesibilidad digital (cumplimiento de estándares como WCAG), la brecha tecnológica y la posible exclusión de determinados colectivos.

7. Transparencia, uno de los más complejos en IA. Se analiza hasta qué punto el usuario entiende qué está haciendo el sistema, cómo genera los resultados y cuáles son sus límites. También se plantea la cuestión de la responsabilidad: quién responde cuando la IA comete errores, la empresa, la biblioteca o el usuario.

8. Privacidad y gestión de datos, un tema crítico en entornos académicos. Se evalúa cómo se recogen, almacenan y utilizan los datos de los usuarios, incluyendo sus consultas, patrones de búsqueda y posibles datos personales, así como el cumplimiento de normativas como el GDPR.

9. Legalidad y ética de los datos utilizados para entrenar la IA, así como en el respeto a los derechos de autor. También introduce una preocupación emergente: la carga que la IA puede generar sobre repositorios abiertos y sistemas de acceso libre.

10. Participación social y la soberanía de los datos, es decir, si las comunidades afectadas han sido tenidas en cuenta en el desarrollo del sistema y si mantienen control sobre su información cultural.

11. Agencia del usuario y el impacto en el aprendizaje. Se analiza si la IA fortalece las competencias del usuario o si, por el contrario, fomenta la dependencia y la pérdida de habilidades críticas. También se considera la necesidad de formación para un uso responsable.

12. Empleo y la estructura laboral, tanto en bibliotecas como en el ecosistema editorial y tecnológico. Se plantea si la IA sustituye funciones humanas o si reconfigura los roles profesionales.

13. Impacto ambiental, un aspecto cada vez más relevante. El uso de modelos de IA implica consumo energético, infraestructura de servidores y uso de agua, lo que obliga a considerar la sostenibilidad del servicio en su ciclo completo.

14. Modelo de negocio y la gobernanza del proveedor, es decir, quién desarrolla la herramienta, bajo qué principios opera y si su estrategia es sostenible y alineada con valores públicos. También se abre la reflexión sobre posibles vínculos con intereses comerciales o incluso militares.

En conjunto, estas 14 preguntas no buscan una respuesta única, sino fomentar una evaluación crítica y multidimensional de la inteligencia artificial en bibliotecas, equilibrando innovación tecnológica con responsabilidad ética, social y profesional.

El texto también amplía la reflexión hacia dimensiones sociales más amplias, como el impacto laboral de estas tecnologías, su huella ambiental y el modelo de negocio de las empresas proveedoras. En conjunto, se propone una evaluación integral que no se limite a lo técnico, sino que integre criterios éticos, educativos, sociales y sostenibles, con el fin de orientar la toma de decisiones en las bibliotecas ante la creciente incorporación de la inteligencia artificial.