Archivo de la etiqueta: Búsquedas

La búsqueda con inteligencia artificial no está sustituyendo a Google: se está superponiendo al buscador tradicional

Jarboe, Greg. “AI Search Isn’t Replacing Google, It’s Layering On Top – Similarweb Data.” Search Engine Journal, 30 de julio de 2026.

El artículo analiza datos del informe 2026 Generative AI Landscape: The Evolution of AI Search, elaborado por Similarweb.

La expansión de ChatGPT y otros sistemas de IA generativa no está suponiendo, al menos por ahora, el abandono de Google, sino la incorporación de una nueva capa de búsqueda y descubrimiento que convive con los buscadores tradicionales. El análisis cuestiona tanto la idea de que la IA ya haya sustituido a los buscadores como la posición contraria de que la búsqueda generativa sea simplemente una moda pasajera. Los datos muestran un escenario mucho más complejo, en el que los usuarios combinan diferentes herramientas dependiendo de la tarea que quieren realizar.

Uno de los datos más significativos procede del análisis del solapamiento de audiencias entre ChatGPT y Google realizado por Similarweb entre marzo y mayo de 2026. De los 494 millones de usuarios de ChatGPT considerados en ese periodo, 461 millones —el 95 %— también utilizaron Google. Esto indica que la utilización de ChatGPT no implica necesariamente abandonar Google. El usuario puede recurrir a ChatGPT para determinadas consultas y continuar utilizando Google para otras. En paralelo, Similarweb calcula que los buscadores tradicionales alcanzaron aproximadamente 3.300 millones de visitantes únicos mensuales, frente a unos 655 millones para el conjunto de los chatbots de IA, aunque estos últimos registraron un crecimiento interanual del 57 %. Por tanto, el ecosistema de búsqueda sigue siendo mucho mayor que el de los chatbots, pero estos están creciendo con rapidez.

El artículo destaca asimismo la evolución de las citas y enlaces incluidos en las respuestas de ChatGPT. En mayo de 2026, aproximadamente el 6,8 % de las respuestas de ChatGPT en Estados Unidos incluían un enlace externo, frente a alrededor del 1 % un año antes. El crecimiento es considerable, pero todavía significa que la gran mayoría de las respuestas no generan directamente una visita hacia una página externa. Esto tiene importantes consecuencias para editores, medios de comunicación, bibliotecas, universidades y organizaciones que tradicionalmente han medido su visibilidad digital mediante visitas procedentes de buscadores. La visibilidad dentro de una respuesta de IA puede convertirse en un indicador relevante aunque no produzca inmediatamente un clic.

Al mismo tiempo, los datos muestran que la IA generativa está creciendo rápidamente. Las plataformas de IA generativa registraron alrededor de 9.500 millones de visitas web mensuales promedio entre junio de 2025 y mayo de 2026, un 70 % más que el año anterior. Las descargas mundiales de aplicaciones alcanzaron los 2.700 millones, con un crecimiento del 134 %. Además, aproximadamente la mitad de los usuarios de IA generativa ya tienen 35 años o más, frente a una concentración mucho mayor de usuarios jóvenes dos años antes. Estos datos sugieren una progresiva extensión de estas herramientas hacia públicos más amplios y hacia usos profesionales, educativos y cotidianos.

Un aspecto particularmente interesante para el estudio de la visibilidad científica y documental es la diferencia entre las páginas que una IA cita y las páginas a las que finalmente llegan los usuarios. Según los datos recogidos en el artículo, el 65 % de las URL citadas por ChatGPT se encuentran a dos o tres niveles de profundidad dentro de un sitio web, es decir, no son necesariamente las páginas principales. Sin embargo, el 58,8 % del tráfico procedente de IA llega finalmente a la página de inicio de los sitios. Esto significa que la página utilizada por el sistema de IA como fuente y la página que visita posteriormente el usuario pueden ser diferentes. La distinción es importante porque obliga a separar la medición de la visibilidad o citación en IA de la medición del tráfico de referencia y de las conversiones.

Esta cuestión modifica también la manera de entender el SEO en la era de la IA. El posicionamiento ya no consiste únicamente en aparecer entre los primeros resultados de Google. Una organización puede tener contenidos que sean utilizados como fuentes por un sistema de IA aunque esos contenidos no reciban directamente una visita. En consecuencia, comienzan a adquirir importancia conceptos como AI visibility, AI citations, share of voice, referral traffic y citation rate. El artículo propone que estos indicadores no se mezclen en una única métrica, sino que se analicen por separado: por una parte, hay que conocer con qué frecuencia y profundidad aparece nuestro contenido como fuente; por otra, qué tráfico llega efectivamente desde las plataformas de IA y qué hacen posteriormente esos usuarios.

Otro elemento destacado es que no todos los sistemas de IA tienen el mismo público ni los mismos patrones de utilización. Los datos de afinidad de Similarweb muestran diferencias entre ChatGPT, Claude y Gemini. ChatGPT presenta una mayor afinidad con usuarios que buscan información relacionada con ámbitos cotidianos como restaurantes, salud o moda; los usuarios de Claude presentan una relación especialmente elevada con sitios universitarios y perfiles profesionales y estudiantiles; mientras que Gemini muestra una mayor afinidad con contenidos relacionados con gráficos, seguridad y hardware. Esto plantea una cuestión importante para la producción de contenidos: no parece suficiente hablar genéricamente de “optimización para IA”, porque cada plataforma puede presentar audiencias, contextos de utilización y mecanismos de descubrimiento diferentes.

El artículo también introduce una idea especialmente relevante para bibliotecas, repositorios institucionales y publicaciones científicas: la aparición de la IA está cambiando el concepto tradicional de descubrimiento de información. En el modelo clásico, el usuario formula una consulta en un buscador, recibe una lista de resultados, selecciona una página y accede al documento. En el nuevo modelo, el usuario puede formular una pregunta directamente a un sistema generativo, recibir una síntesis y consultar solamente algunas de las fuentes citadas. Esto desplaza parte del proceso desde la recuperación de documentos hacia la recuperación y síntesis de conocimiento. Para las instituciones que producen información de calidad, ser una fuente reconocible y citable por los sistemas de IA puede adquirir tanta importancia como conseguir una buena posición en los resultados tradicionales.

Sin embargo, el propio artículo advierte contra las interpretaciones excesivamente simples. Que el 95 % de los usuarios de ChatGPT también utilice Google no significa que todas sus búsquedas se realicen en Google. El dato mide solapamiento de audiencias, no frecuencia de consultas. El hecho de que una persona utilice Google al menos una vez durante el periodo analizado no permite saber qué proporción de sus consultas informativas ha trasladado a ChatGPT. Por ello, el porcentaje del 95 % debe interpretarse como una medida de coincidencia entre públicos, no como una demostración de que la IA no esté sustituyendo determinadas búsquedas. Esta distinción es importante para comprender correctamente los datos.

El artículo llega así a una conclusión más matizada: la transformación de la búsqueda parece estar produciéndose mediante una convivencia y superposición de sistemas. Google continúa siendo una infraestructura fundamental de búsqueda, mientras que los sistemas de IA están introduciendo nuevas formas de formular preguntas, sintetizar información, comparar fuentes y descubrir contenidos. Además, Google está incorporando sus propias funciones de IA, por lo que la frontera entre “buscador tradicional” y “buscador con inteligencia artificial” se vuelve cada vez menos nítida. En consecuencia, el futuro de la recuperación de información no parece consistir simplemente en sustituir una herramienta por otra, sino en una progresiva integración de diferentes capas de búsqueda, síntesis y recomendación.
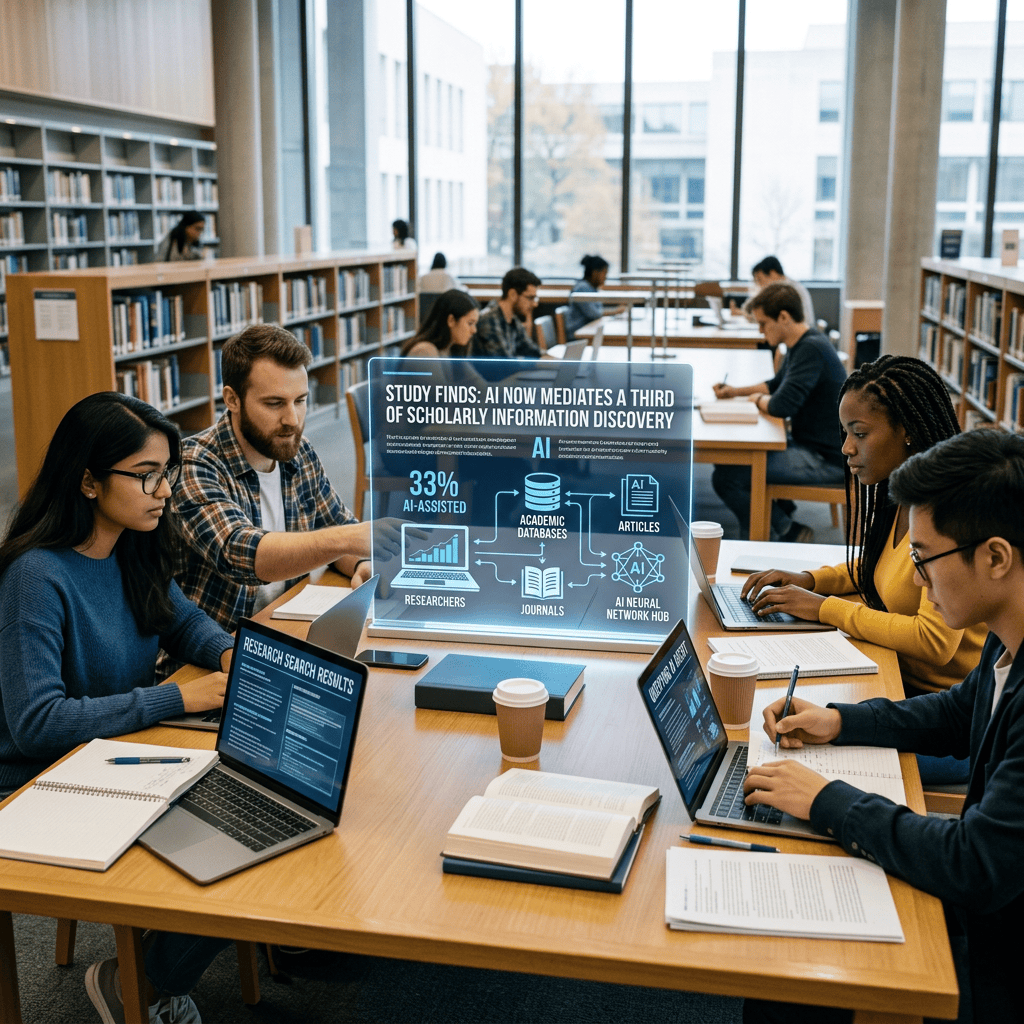
La inteligencia artificial ya interviene en un tercio del descubrimiento de información científica

Students studying in a library beside graphic reading “STUDY FINDS: AI NOW MEDIATES A THIRD OF SCHOLARLY INFORMATION DISCOVERY,” “33% AI-ASSISTED,” and labels for academic databases, articles, researchers, journals, and an AI neural network hub.

AI now mediates a third of scholarly information discovery, study finds”. Research Information (16 de julio de 2026), https://www.researchinformation.info/news/ai-now-mediates-a-third-of-scholarly-information-discovery-study-finds/

El artículo recoge los resultados de la primera fase del estudio Taming the Crocodile, impulsado por Kudos, que analiza cómo está cambiando la forma en que investigadores, estudiantes y bibliotecarios descubren información científica en un entorno cada vez más mediado por herramientas de inteligencia artificial.

El estudio revela un cambio profundo en las prácticas de búsqueda de información académica: aproximadamente un tercio del descubrimiento de información científica ya está mediado por la inteligencia artificial. La investigación combina encuestas realizadas a 11.500 investigadores y 200 bibliotecarios, además de un análisis de más de 300 fuentes. Uno de los datos más significativos es que uno de cada diez investigadores comienza directamente sus búsquedas en herramientas de IA, mientras que otro 25 % utiliza buscadores generales en los que las respuestas generadas por inteligencia artificial están cada vez más integradas. El fenómeno es todavía más intenso entre los investigadores que se encuentran en las primeras etapas de su carrera y entre quienes trabajan en organizaciones empresariales, donde el porcentaje que inicia sus búsquedas directamente mediante IA llega a duplicarse.

El problema no es únicamente que cambien los instrumentos de búsqueda, sino que muchos investigadores no son plenamente conscientes del papel que desempeña la IA en los resultados que reciben. El estudio señala que un 40 % de los investigadores cree que los resúmenes generados por IA que aparecen en los buscadores han sido elaborados o seleccionados por personas; entre los estudiantes esta percepción asciende al 46 %. Esta falta de comprensión tiene consecuencias prácticas: los bibliotecarios están observando que algunos usuarios solicitan artículos que en realidad no existen porque han recibido referencias bibliográficas alucinadas por sistemas de inteligencia artificial. Por tanto, la alfabetización en IA se convierte también en una cuestión de alfabetización informacional y científica: no basta con saber formular preguntas a un chatbot, sino que es necesario comprender cómo se generan las respuestas, de dónde proceden las fuentes y cómo comprobar su existencia y fiabilidad.

Otro aspecto especialmente relevante para las bibliotecas es que esta transformación puede estar modificando las propias formas de acceso y utilización de la literatura científica. Los bibliotecarios participantes en el estudio señalan una posible disminución del uso de las fuentes primarias, ya que los investigadores pueden quedarse con la síntesis o respuesta proporcionada por un sistema de IA sin llegar necesariamente al artículo original. Esto introduce una tensión importante porque las estadísticas tradicionales de uso continúan teniendo un peso considerable en decisiones como la renovación de suscripciones. Si los investigadores encuentran información a través de interfaces de IA y dejan de acceder directamente a los documentos originales, las métricas tradicionales podrían dejar de reflejar adecuadamente el verdadero impacto o valor de una colección científica.

El estudio también plantea una nueva responsabilidad para editores y proveedores de información científica. Los bibliotecarios reclaman mayor transparencia sobre la forma en que los contenidos editoriales son incorporados y representados por los sistemas de IA, así como criterios claros para la utilización de contenidos en el entrenamiento de modelos y en las nuevas formas de consulta mediante agentes de inteligencia artificial. En este escenario, ya no es suficiente con que un artículo esté correctamente indexado en una base de datos o sea recuperable mediante un buscador tradicional: las editoriales tendrán que conseguir que sus contenidos sean legibles, interpretables, atribuibles y correctamente representados por los sistemas de IA.

Una de las principales recomendaciones del informe es precisamente desarrollar contenidos “answer-ready”, es decir, preparados para ser comprendidos y utilizados por sistemas de inteligencia artificial. Esto implica utilizar estructuras claras, lenguaje comprensible, metadatos adecuados y mecanismos que permitan identificar inequívocamente autores, artículos, instituciones, resultados y fuentes. La segunda fase del proyecto se centrará precisamente en establecer buenas prácticas relacionadas con esquemas, metadatos y marcado estructurado, con el objetivo de mejorar la visibilidad de la investigación en los entornos de IA y, sobre todo, garantizar una correcta atribución.

Para las bibliotecas, el informe tiene una implicación especialmente importante: la alfabetización informacional debe evolucionar hacia una alfabetización crítica en inteligencia artificial. Los profesionales no solo tendrán que enseñar a localizar información en bases de datos, catálogos y buscadores, sino también a comprender cómo los sistemas de IA seleccionan, resumen y presentan el conocimiento. Esto incluye aprender a verificar referencias, rastrear una afirmación hasta su fuente original, distinguir entre una respuesta generada y una evidencia científica, reconocer posibles sesgos y comprender que una respuesta aparentemente convincente puede contener información falsa. El propio estudio recomienda desarrollar materiales educativos específicos para bibliotecarios e investigadores y establecer métodos para evaluar la visibilidad de los contenidos científicos en los sistemas de IA.

En definitiva, la IA está pasando de ser una herramienta complementaria para buscar información a convertirse en una nueva capa de intermediación del conocimiento científico. El cambio afecta simultáneamente a investigadores, bibliotecas, editoriales, autores y proveedores de información. La cuestión ya no es únicamente cómo conseguir que un artículo aparezca en Google Scholar, Scopus o Web of Science, sino también cómo conseguir que sea encontrado, interpretado y citado correctamente por los sistemas de inteligencia artificial. El estudio Taming the Crocodile apunta así hacia un nuevo escenario de comunicación científica en el que los metadatos, la trazabilidad, la atribución, la transparencia y la calidad de las fuentes adquieren una importancia todavía mayor.

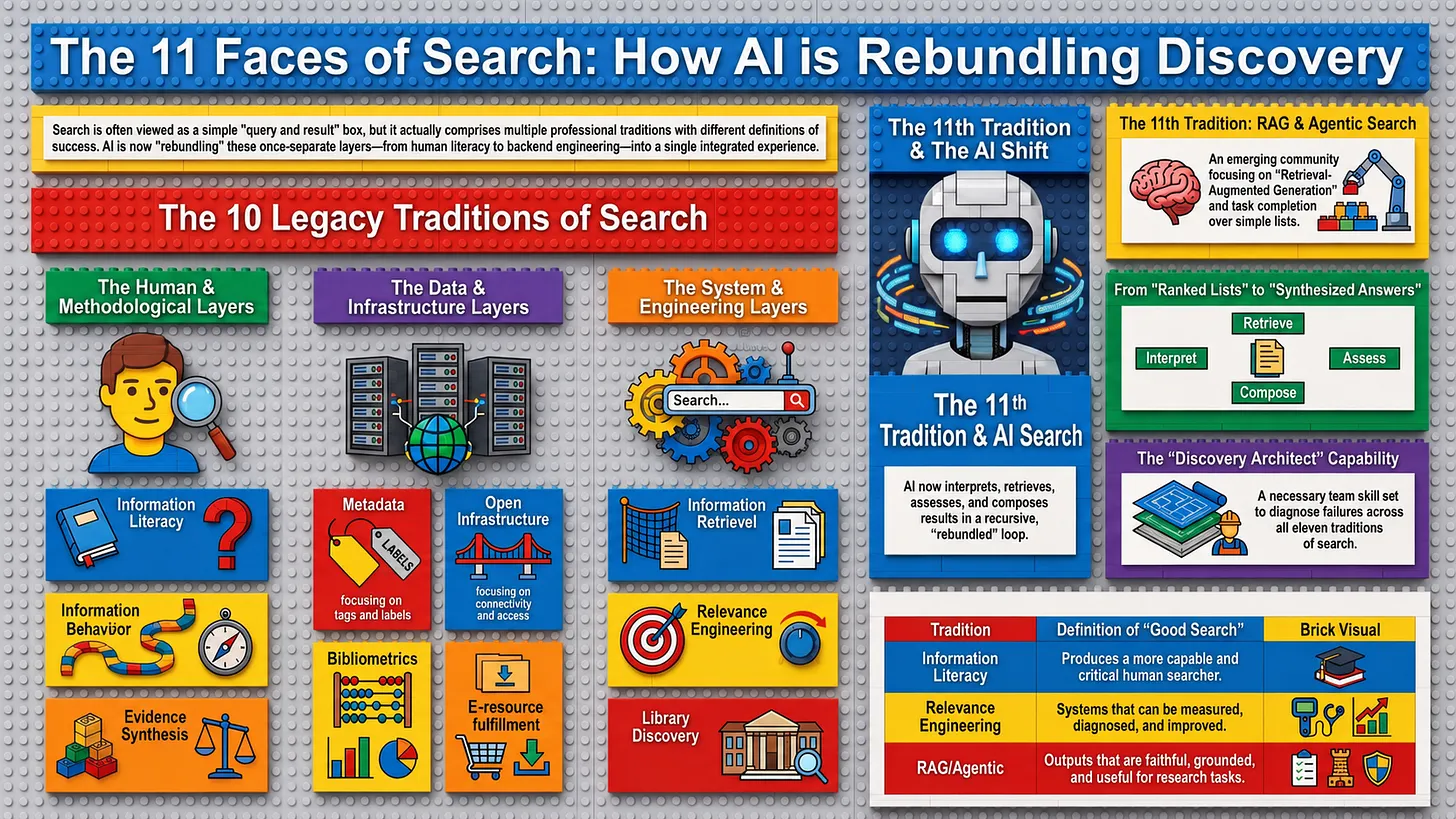
La IA está cambiando la forma en que los usuarios buscan y descubren recursos en las bibliotecas.

Tay, Aaron. AI Search Is Rebundling Everything Libraries Know About Discovery: Ten established traditions, an emerging eleventh, and why libraries need to have a more holistic view of discovery. Aaron Tay’s Musings about Librarianship (Substack), 18 de julio de 2026. https://aarontay.substack.com/p/eleven-ways-of-looking-at-academic

Aaron Tay plantea que la búsqueda académica nunca ha sido una actividad única y homogénea, sino un conjunto de perspectivas desarrolladas por comunidades profesionales y de investigación diferentes. Inspirándose en el conocido ensayo de Lorcan Dempsey Thirteen Ways of Looking at Libraries, Discovery, and the Catalog, el autor propone que la búsqueda científica puede entenderse desde diez tradiciones consolidadas y una undécima emergente.

Cada una de ellas interpreta el mismo proceso de búsqueda desde objetivos distintos: unas priorizan la alfabetización informacional, otras el comportamiento de los usuarios, la recuperación de información, la bibliometría, la infraestructura científica, la organización del conocimiento o la ingeniería de relevancia. El problema, sostiene Tay, no es la ausencia de conocimiento sobre la búsqueda académica, sino la fragmentación de ese conocimiento entre comunidades que apenas comparten lenguaje, métodos de evaluación o marcos conceptuales.

El autor describe cómo cada tradición aporta una pieza esencial del ecosistema de descubrimiento. Los especialistas en alfabetización informacional consideran que una buena búsqueda es aquella que forma usuarios críticos capaces de evaluar fuentes y detectar sesgos, especialmente en un contexto donde las respuestas generadas por IA pueden parecer convincentes sin ser necesariamente fiables. Los investigadores del comportamiento informacional, por su parte, entienden la búsqueda como un proceso dinámico en el que las necesidades del usuario evolucionan mientras explora información, reformula consultas y redefine sus objetivos. Los expertos en revisiones sistemáticas y síntesis de evidencia ponen el énfasis en la exhaustividad, la transparencia y la reproducibilidad de las estrategias de búsqueda, considerando que estas forman parte del propio método científico y deben ser documentadas y auditadas rigurosamente.

Uno de los argumentos centrales del artículo es que la irrupción de la inteligencia artificial está desdibujando las fronteras tradicionales entre estas disciplinas. En los sistemas clásicos existían capas relativamente independientes: los metadatos, la recuperación de documentos, el ordenamiento de resultados, el acceso al texto completo o la evaluación crítica podían estudiarse por separado. Los sistemas de búsqueda basados en IA, en cambio, integran continuamente interpretación de preguntas, recuperación de información, selección de evidencias, generación de respuestas y razonamiento automatizado. La IA no elimina estas capas, sino que las reorganiza en arquitecturas mucho más complejas donde interactúan de forma constante. Como consecuencia, comprender cómo funciona realmente un sistema de búsqueda requiere conocimientos que hasta ahora estaban distribuidos entre comunidades muy distintas.

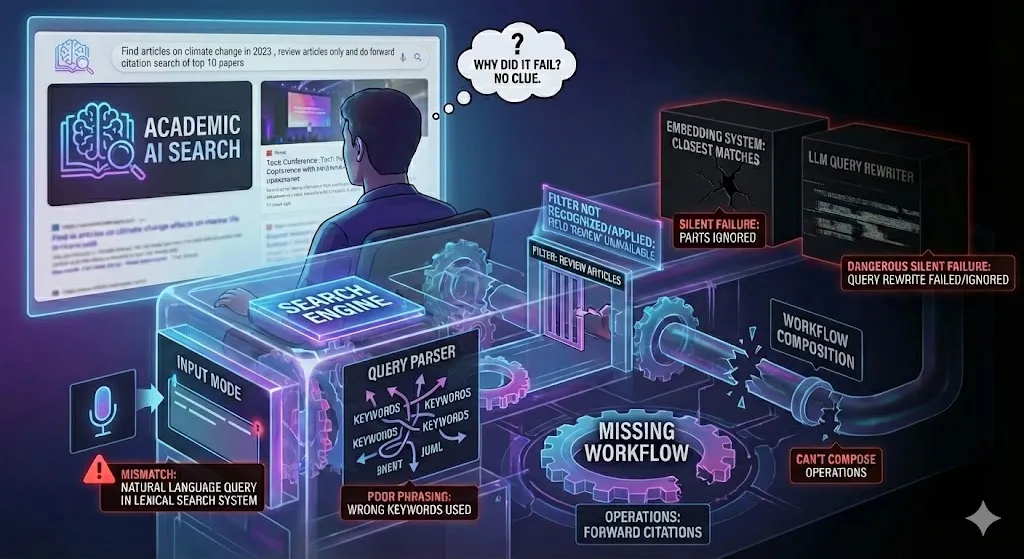
Ante esta nueva realidad, Tay propone el surgimiento de una nueva capacidad organizativa que denomina «discovery architect» o arquitecto del descubrimiento, aunque insiste en que no debe entenderse necesariamente como un nuevo puesto de trabajo, sino como una competencia colectiva que deberían desarrollar las bibliotecas académicas. Este equipo tendría una visión transversal del ecosistema completo de búsqueda científica, capaz de comprender metadatos, infraestructuras abiertas, algoritmos de recuperación, modelos de IA, sistemas de acceso, grafos de conocimiento y herramientas de descubrimiento. Su función consistiría en diagnosticar correctamente por qué un sistema de búsqueda falla: si el problema reside en la cobertura documental, en los metadatos, en la desambiguación de entidades, en el algoritmo de recuperación, en el ranking, en la selección de evidencias o en la generación de respuestas por parte del modelo. Más que resolver directamente todos esos problemas, debería ser capaz de identificar qué tipo de conocimiento especializado resulta necesario en cada caso.

Según Aaron Tay, las once maneras de entender la búsqueda académica representan diferentes disciplinas y comunidades profesionales que analizan el descubrimiento de información desde perspectivas complementarias. Son las siguientes:

  1. Alfabetización informacional (Information Literacy)
    Considera la búsqueda como una competencia que debe aprenderse y desarrollarse. El objetivo es que los usuarios sepan formular preguntas, elegir fuentes adecuadas, evaluar críticamente la información y utilizarla de forma ética.
  2. Comportamiento informacional (Information Behaviour)
    Estudia cómo las personas buscan información en situaciones reales. Analiza las necesidades de información, las estrategias de búsqueda, la incertidumbre, la exploración y cómo evolucionan las consultas durante el proceso.
  3. Recuperación de información (Information Retrieval – IR)
    Se centra en los algoritmos y modelos que permiten localizar los documentos más relevantes para una consulta. Incluye aspectos como la indexación, el ranking, la relevancia, la recuperación semántica y la evaluación de los sistemas de búsqueda.
  4. Recuperación interactiva de información (Interactive Information Retrieval – IIR)
    Examina la interacción entre el usuario y el sistema de búsqueda. Estudia cómo las interfaces, la reformulación de consultas y la retroalimentación mejoran los resultados obtenidos.
  5. Revisiones sistemáticas y síntesis de evidencia (Systematic Searching / Evidence Synthesis)
    Concibe la búsqueda como un componente esencial del método científico. Da prioridad a la exhaustividad, la reproducibilidad, la transparencia y la documentación detallada de las estrategias de búsqueda.
  6. Bibliometría y cienciometría (Bibliometrics / Scientometrics)
    Utiliza la búsqueda para analizar la producción científica, las citas, las redes de colaboración, el impacto de las publicaciones y la evolución de las disciplinas.
  7. Organización del conocimiento (Knowledge Organization)
    Se ocupa de cómo se describen y estructuran los recursos mediante metadatos, vocabularios controlados, tesauros, clasificaciones, ontologías y grafos de conocimiento para facilitar su descubrimiento.
  8. Bibliotecas y sistemas de descubrimiento (Library Discovery Systems)
    Analiza las plataformas que integran catálogos, bases de datos, repositorios y recursos electrónicos, así como las decisiones sobre cobertura, relevancia y experiencia de usuario en los servicios bibliotecarios.
  9. Infraestructura de comunicación científica (Scholarly Communication Infrastructure)
    Observa la búsqueda desde el punto de vista de las infraestructuras que hacen posible el descubrimiento: identificadores persistentes (DOI, ORCID), índices, repositorios, bases de datos, acceso abierto y metadatos interoperables.
  10. Motores de búsqueda académicos y plataformas comerciales (Academic Search Engines and Discovery Platforms)
    Estudia cómo servicios como Google Scholar, Scopus, Web of Science, Semantic Scholar o Dimensions construyen sus índices, seleccionan contenidos y ordenan los resultados mediante algoritmos propios.
  11. Arquitectura del descubrimiento impulsada por IA (Discovery Architecture / AI Discovery) (la perspectiva emergente propuesta por Tay)

El autor advierte que esta capacidad de diagnóstico será insuficiente si las bibliotecas no exigen mayor transparencia a los proveedores de plataformas de búsqueda basadas en IA. Reclama acceso a registros de consultas, información sobre la cobertura de los índices, documentación de los criterios de clasificación, mecanismos para evaluar la relevancia de los resultados y posibilidades de auditar las distintas fases del proceso de recuperación y generación de respuestas. Sin esa apertura, afirma Tay, incluso reuniendo a especialistas de todas las disciplinas implicadas, cualquier análisis sobre el funcionamiento de estos sistemas seguirá siendo en gran medida especulativo. El artículo concluye anunciando una segunda parte dedicada a analizar dónde reside realmente la inteligencia de los nuevos sistemas de búsqueda: en los grandes modelos de lenguaje, en los mecanismos de recuperación documental o en la combinación de ambos mediante arquitecturas híbridas.

Google anuncia cambios en la Búsqueda

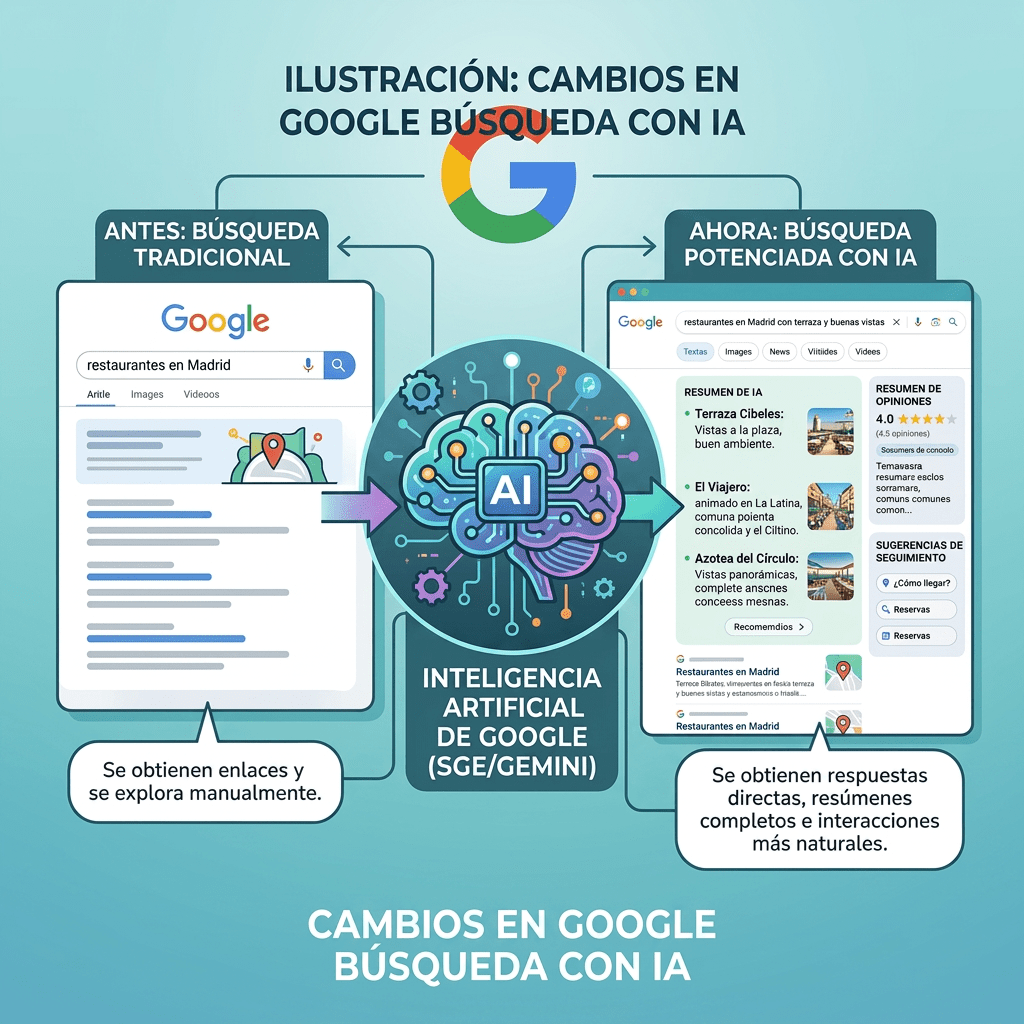
Comparación visual de búsquedas en Google tradicional y con inteligencia artificial mostrando diferencias en resultados para restaurantes en Madrid.
Comparación entre búsqueda tradicional y búsqueda potenciada con IA en Google para restaurantes en Madrid.

Perez, Sarah. “Google Search as You Know It Is Over”. TechCrunch, 19 de mayo de 2026. https://techcrunch.com/2026/05/19/google-search-as-you-know-it-is-over/

Google está realizando cambios importantes en su experiencia de búsqueda. En lugar de ofrecer la lista de enlaces habitual que ha existido durante décadas, las consultas a veces dirigirán a los usuarios a una interfaz interactiva con IA donde podrán interactuar directamente con las respuestas y hacer preguntas adicionales. Estas actualizaciones también implementarán nuevos formatos publicitarios, incluyendo anuncios con funciones de IA que permiten a los usuarios interactuar con ellos.

Muchos estadounidenses ya encuentran resúmenes generados por IA en sus resultados de búsqueda, pero las opiniones sobre su utilidad son diversas. En agosto pasado, una encuesta del Pew Research Center reveló que el 65% de los adultos estadounidenses (incluida una mayoría aún mayor de adultos jóvenes) afirmó haber visto estos resúmenes al menos en alguna ocasión. Entre quienes habían visto resúmenes de búsqueda con IA, uno de cada cinco afirmó que los consideraba extremadamente o muy útiles, y el 6% dijo confiar mucho en la información de estos resúmenes.

Los motores de búsqueda como Google son una forma común en que muchos estadounidenses se informan: el 63% de los adultos estadounidenses afirma informarse de esta manera al menos en ocasiones.

Google anunció en su conferencia anual Google I/O 2026 la mayor transformación de su buscador desde su lanzamiento hace más de veinticinco años. Según la compañía, la era de los tradicionales “diez enlaces azules” está llegando a su fin para dar paso a una experiencia impulsada por inteligencia artificial, donde las respuestas, las interacciones y las acciones ocuparán un lugar mucho más importante que la simple lista de resultados web.

El cambio gira en torno a una nueva “caja de búsqueda inteligente”, diseñada para que los usuarios formulen preguntas largas y complejas de manera conversacional. En lugar de obligar a las personas a buscar mediante palabras clave, el sistema interpreta intenciones, sugiere consultas más sofisticadas y mantiene conversaciones de seguimiento sin que el usuario tenga que reformular constantemente su pregunta. La búsqueda se convierte así en un diálogo continuo con la inteligencia artificial.

Uno de los aspectos más innovadores es la incorporación de agentes de información. Estos asistentes pueden trabajar en segundo plano las veinticuatro horas del día, rastreando cambios en la web, recopilando datos y notificando al usuario cuando se cumplen determinadas condiciones. Por ejemplo, podrán vigilar movimientos financieros, seguir la evolución de un mercado específico o monitorizar cualquier tema de interés para proporcionar actualizaciones sintetizadas y contextualizadas. Esta funcionalidad supone una evolución significativa respecto a herramientas anteriores como Google Alerts.

La inteligencia artificial también permitirá que los resultados de búsqueda adopten la forma de experiencias interactivas. Gracias a técnicas de interfaz generativa, Search podrá construir visualizaciones, simulaciones, paneles de información y herramientas personalizadas adaptadas a cada consulta. Una búsqueda sobre agujeros negros, por ejemplo, podría convertirse en una representación gráfica interactiva que responda dinámicamente a nuevas preguntas formuladas por el usuario.

Otra novedad destacada es la posibilidad de crear pequeñas aplicaciones personalizadas directamente desde el buscador. Mediante instrucciones en lenguaje natural, los usuarios podrán desarrollar herramientas adaptadas a sus necesidades concretas, como planificadores de comidas, aplicaciones de seguimiento deportivo o gestores de proyectos personales. Google deja entrever una visión en la que la búsqueda deja de ser únicamente una herramienta para encontrar información y pasa a convertirse en una plataforma para realizar tareas y tomar decisiones.

Esta transformación se apoya en la integración de los modelos Gemini y de la plataforma Antigravity, desarrollada por Google para aplicaciones autónomas basadas en IA. La compañía afirma que la nueva experiencia será gratuita para todos los usuarios, aunque algunas funciones avanzadas relacionadas con agentes inteligentes y aplicaciones personalizadas llegarán inicialmente a los suscriptores de los planes Google AI Pro y Ultra.

Sin embargo, el anuncio también ha despertado preocupación entre medios de comunicación, creadores de contenidos y editores digitales. Al proporcionar respuestas completas dentro del propio buscador, los usuarios tendrán menos necesidad de visitar las páginas originales donde se encuentra la información. Diversos analistas advierten de que esta tendencia podría reducir aún más el tráfico web hacia los sitios de noticias, blogs y otros recursos en línea, agravando un problema que ya comenzó con la introducción de los resúmenes automáticos AI Overviews.

Las reacciones en comunidades tecnológicas han sido encontradas. Mientras algunos usuarios valoran la rapidez y comodidad de obtener respuestas directas, otros temen una creciente concentración del control de la información en manos de una única empresa. También se plantean interrogantes sobre la sostenibilidad económica de la web abierta, ya que muchos sitios dependen de las visitas generadas por los motores de búsqueda tradicionales.

La inteligencia artificial busca artículos científicos, pero ¿Cómo evaluar sus resultados?

Aaron Tay. “AI Academic Search and the Missing Benchmark Problem”. Aaron Tay’s Musings about Librarianship, 2026.

Uno de los problemas más importantes en la evaluación de los sistemas de búsqueda académica basados en inteligencia artificial: la ausencia de estándares de referencia sólidos y compartidos. Mientras proliferan herramientas como Elicit, Consensus, Scite, Scopus AI o los sistemas de “Deep Research”, existe una gran dificultad para determinar objetivamente cuál de ellas ofrece mejores resultados, ya que no disponemos de benchmarks ampliamente aceptados que permitan comparar su rendimiento de forma rigurosa.

Tay señala que la situación recuerda a los primeros años de otros campos de la inteligencia artificial, donde los avances tecnológicos fueron más rápidos que los mecanismos de evaluación. Muchas plataformas promocionan capacidades como la búsqueda semántica, la recuperación aumentada por generación (RAG), la identificación automática de literatura relevante o la elaboración de revisiones bibliográficas asistidas por IA. Sin embargo, los usuarios suelen disponer únicamente de demostraciones comerciales o ejemplos seleccionados por los propios desarrolladores, lo que dificulta conocer el rendimiento real de estas herramientas en contextos de investigación auténticos.

Uno de los argumentos centrales del autor es que la búsqueda académica constituye un problema mucho más complejo que responder preguntas generales. No basta con recuperar documentos relacionados; también es necesario encontrar trabajos relevantes aunque utilicen terminología diferente, identificar literatura seminal, reconocer relaciones de citación y ofrecer resultados adecuados para distintas etapas del proceso investigador. Debido a ello, evaluar únicamente la precisión de una respuesta generada por IA resulta insuficiente.

El artículo destaca además que muchas pruebas actuales se centran en tareas demasiado simples. Un sistema puede responder correctamente a preguntas factuales concretas y aun así fracasar cuando se enfrenta a necesidades reales de investigación, como localizar artículos fundamentales omitidos en una revisión bibliográfica, detectar debates emergentes o construir estrategias de búsqueda exhaustivas. Tay sostiene que los escenarios de evaluación deberían reflejar mejor las tareas cotidianas de investigadores, estudiantes y bibliotecarios.

Otro problema importante es la falta de transparencia. Muchas herramientas académicas basadas en IA funcionan mediante modelos propietarios cuyos índices documentales, algoritmos de recuperación y mecanismos de clasificación no son públicos. Como consecuencia, resulta difícil reproducir experimentos o comprender por qué dos sistemas ofrecen resultados distintos ante la misma consulta. Esta opacidad limita la posibilidad de desarrollar evaluaciones comparables y acumulativas.

Tay también subraya que la calidad de un sistema RAG depende de dos componentes distintos: la recuperación de información y la generación de respuestas. Un modelo puede producir un texto aparentemente convincente pero basado en documentos poco relevantes, o bien recuperar excelentes artículos y resumirlos de forma deficiente. Por ello, propone evaluar por separado la capacidad de recuperación y la fidelidad de la síntesis generada.

En sus análisis previos sobre herramientas de búsqueda académica, el autor ha mostrado que algunos sistemas especializados fracasan en tareas relativamente sencillas para un investigador humano, mientras que modelos generales pueden resolverlas con más eficacia. Estos resultados sugieren que muchas plataformas funcionan mediante flujos de trabajo predefinidos que son muy eficaces en determinados escenarios, pero menos flexibles cuando la consulta se aparta de los casos previstos por sus diseñadores.

El texto conecta además con una cuestión más amplia dentro de la inteligencia artificial: la importancia de los benchmarks. Históricamente, disciplinas como el procesamiento del lenguaje natural o la visión artificial han avanzado gracias a conjuntos de pruebas estandarizados que permiten comparar sistemas bajo condiciones comunes. Sin estándares equivalentes para la búsqueda académica asistida por IA, resulta difícil distinguir entre mejoras reales y simples estrategias de marketing.

Aaron Tay defiende la necesidad de construir marcos de evaluación abiertos, transparentes y orientados a tareas reales de investigación. Solo mediante benchmarks compartidos será posible determinar qué herramientas mejoran verdaderamente el descubrimiento académico y cuáles simplemente generan respuestas convincentes. Para bibliotecarios, investigadores y responsables institucionales, esta cuestión resulta especialmente relevante en un momento en que las plataformas de búsqueda basadas en IA comienzan a integrarse en bases de datos científicas, catálogos bibliotecarios y servicios de apoyo a la investigación.

Inteligencia artificial y búsqueda de información: comparación entre chatbots de IA, buscadores web y recursos bibliotecarios entre estudiantes universitarios

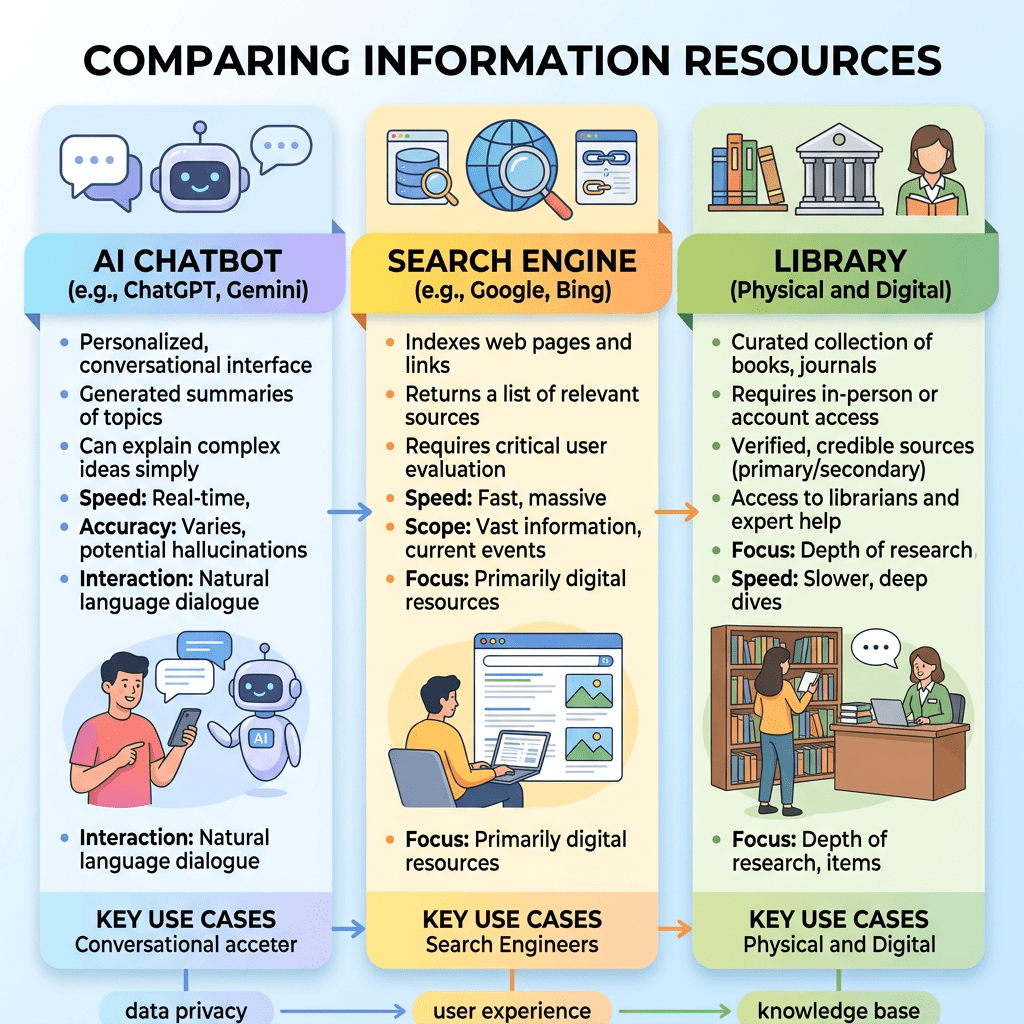
Comparison chart of AI chatbot, search engine, and library information resources
An infographic comparing AI chatbots, search engines, and libraries as information resources.

Lund, Brady D., Zoe Abbie Teel, Ting Wang, et al. “Artificial Intelligence (AI) and Information Seeking: A Comparative Exploration of AI Chatbots, Search Engines, and Library Resources as Information Sources among University Students.” Journal of Librarianship and Information Science (OnlineFirst, 2026). https://doi.org/10.1177/09610006261438484

Datos en Zenodo: https://doi.org/10.5281/zenodo.19094911.

El artículo retrata un momento de transición en el ecosistema informativo universitario. La IA no ha desplazado a Google ni a las bibliotecas, pero ya se ha incorporado de forma visible a las rutinas académicas. Su papel es complementario, aunque en expansión, especialmente entre estudiantes jóvenes e internacionales. Para las bibliotecas y universidades, el reto no consiste en resistirse al cambio, sino en liderarlo: integrar la IA de forma ética, crítica y conectada con recursos académicos de calidad.

Este estudio analiza cómo los estudiantes universitarios de Estados Unidos están integrando la inteligencia artificial generativa en sus prácticas de búsqueda académica. A partir de una encuesta electrónica respondida por 236 estudiantes de perfiles diversos, los autores comparan el uso, preferencia y satisfacción con tres grandes fuentes de información: motores de búsqueda tradicionales (como Google), recursos bibliotecarios universitarios y herramientas de IA conversacional como ChatGPT. El trabajo parte de la idea de que la irrupción de la IA está modificando profundamente la ecología informacional en la educación superior, alterando la manera en que los estudiantes localizan, evalúan y utilizan información.

Los resultados muestran que los motores de búsqueda siguen siendo la herramienta dominante para tareas académicas, tanto por frecuencia de uso como por preferencia inicial al comenzar una investigación. Casi la mitad de los estudiantes indicaron que Google o buscadores similares son su primera opción, mientras que el resto se divide entre los recursos de biblioteca y la IA. Sin embargo, la IA ya ocupa un lugar significativo: solo un 15% declaró no haberla usado nunca para fines académicos, mientras que cerca del 10% la utiliza diariamente. Esto indica que la IA no ha sustituido aún a las herramientas tradicionales, pero sí se ha convertido en una pieza estable del repertorio informacional estudiantil.

Uno de los hallazgos más relevantes es la existencia de diferencias demográficas marcadas. Los estudiantes más jóvenes muestran mayor inclinación hacia la IA como punto de partida en sus búsquedas, mientras que los mayores prefieren claramente las páginas web de bibliotecas universitarias. Asimismo, los estudiantes internacionales utilizan la IA con mucha mayor frecuencia que los estudiantes nacionales estadounidenses. De hecho, recurren menos a los recursos bibliotecarios y más a herramientas de IA, lo que los autores interpretan como posible consecuencia de barreras idiomáticas, desconocimiento del entorno bibliotecario estadounidense o búsqueda de interfaces más accesibles y conversacionales.

En cuanto a la percepción de calidad, los buscadores tradicionales siguen obteniendo mejores puntuaciones globales que la IA en relevancia y satisfacción de resultados. Los estudiantes consideran especialmente eficaces a los buscadores para noticias recientes, meteorología e información laboral. En cambio, la IA obtiene valoraciones más competitivas cuando se trata de ayuda académica, preparación de exámenes, comprensión inicial de un tema o generación de instrucciones para realizar tareas. Esto sugiere que los usuarios perciben fortalezas diferenciadas: el buscador como herramienta de acceso a fuentes actualizadas y múltiples perspectivas, y la IA como asistente para sintetizar, orientar o explicar.

El estudio también demuestra una relación clara entre uso frecuente y satisfacción con la IA. Cuanto más emplea un estudiante estas herramientas, mayor es su percepción de utilidad. Los usuarios intensivos valoran especialmente la IA para tareas educativas, estudio y resolución de procedimientos. Esto puede indicar un aprendizaje progresivo del uso eficaz de la herramienta o una adaptación de expectativas a sus capacidades reales. Los autores advierten, no obstante, que esta relación también podría fomentar dependencia acrítica si los estudiantes aceptan respuestas sintéticas sin contrastarlas con fuentes primarias.

Desde la perspectiva bibliotecaria, el artículo plantea implicaciones estratégicas de gran interés. Las bibliotecas universitarias no deberían contemplar la IA únicamente como una amenaza competitiva, sino como una oportunidad para rediseñar sus servicios. Proponen desarrollar sistemas de descubrimiento apoyados en IA conectados directamente con colecciones licenciadas, bases de datos y contenidos académicos fiables. De este modo, las bibliotecas podrían ofrecer experiencias conversacionales semejantes a ChatGPT, pero sustentadas en recursos evaluados y legales. También subrayan la necesidad urgente de programas de alfabetización informacional y alfabetización en IA, enseñando a los estudiantes a verificar respuestas, identificar sesgos, contrastar perspectivas y comprender límites de los modelos generativos.

Los autores reconocen algunas limitaciones metodológicas. La muestra estaba sobrerrepresentada por estudiantes de posgrado, internacionales y vinculados a ciencias de la computación e información, lo que puede inflar los niveles generales de adopción tecnológica. Además, el estudio se basa en autoinformes y no en observación directa del comportamiento real. Por ello recomiendan investigaciones futuras con muestras más representativas, entrevistas cualitativas y estudios experimentales que analicen cómo los estudiantes combinan IA, buscadores y biblioteca ante necesidades concretas de información.

Apéndice. Encuesta sobre IA y búsqueda de información

1. ¿Cuál de las siguientes opciones describe mejor tu especialidad académica?
a. Artes – bellas artes, música, danza, fotografía
b. Humanidades – filosofía, historia, literatura, lenguas
c. Ciencias Sociales – psicología, sociología, economía, educación, biblioteconomía
d. Ciencias Naturales – biología, química, matemáticas, ecología, ingeniería
e. Ciencias de la Computación – informática, ciencia de la información, ciencia de datos, IA
f. Empresa – administración, hostelería, sistemas y ciencias de la decisión, marketing

2. ¿Cuál es tu nivel académico actual?
a. Estudiante de grado
b. Estudiante de máster
c. Estudiante de doctorado

3. ¿Cuál es tu edad?
a. 18–25
b. 26–30
c. 31–35
d. 36 o más

4. ¿Cuál es tu género?
a. Mujer
b. Hombre
c. No binario
d. Otro

5. ¿Cuál describe mejor tu situación como estudiante?
a. Estudiante nacional
b. Estudiante internacional

6. Pensando específicamente en tus actividades académicas y/o experiencias de investigación, indica con qué frecuencia utilizas cada una de las siguientes fuentes de información (nunca, menos de una vez al mes, mensualmente, semanalmente, diariamente):
a. Libros
b. Revistas científicas
c. Actas de congresos
d. Recursos web
e. Bases de datos bibliotecarias
f. Comunicaciones personales
g. Herramientas de IA generativa

7. Pensando específicamente en tus actividades académicas y/o experiencias de investigación, ¿qué grado de confianza tienes en que encuentras toda la información necesaria sobre un tema cuando utilizas los siguientes recursos? (nada confiado, poco confiado, neutral, bastante confiado, muy confiado):
a. Libros
b. Revistas científicas
c. Actas de congresos
d. Recursos web
e. Bases de datos bibliotecarias
f. Comunicaciones personales
g. Herramientas de IA generativa

8. ¿Cuál de las siguientes interfaces preferirías utilizar al comenzar tu búsqueda de información?
a. Página principal de la biblioteca
b. Google/motor de búsqueda
c. Chatbot de IA/modelo de lenguaje grande

9. ¿Cuántas veces has realizado las siguientes actividades durante el último mes?
a. Visitado la biblioteca universitaria, utilizado la web de la biblioteca o accedido a recursos bibliotecarios mediante enlaces web.
b. Utilizado Google u otro motor de búsqueda similar para actividades o tareas universitarias.
c. Utilizado una herramienta de IA para actividades o tareas universitarias.

10. Al realizar una tarea concreta de búsqueda de información relacionada con estudios o investigación, ¿con qué frecuencia recurres a los siguientes enfoques? (nunca, raramente, a veces, a menudo, siempre):
a. Utilizar solo un motor de búsqueda tradicional
b. Utilizar solo un chatbot de IA/ChatGPT
c. Primero utilizar un motor de búsqueda tradicional y después un chatbot de IA/ChatGPT
d. Primero utilizar un chatbot de IA/ChatGPT y después un motor de búsqueda tradicional

11. Pensando en la información que buscas en tu vida diaria, ¿qué probabilidad hay de que uses un motor de búsqueda tradicional para lo siguiente? (muy improbable, algo improbable, ni probable ni improbable, algo probable, muy probable):
a. Encontrar información relacionada con empleo
b. Encontrar información relacionada con estudios
c. Aprender más sobre un tema que estudias
d. Consultar el tiempo
e. Ponerte al día con noticias recientes
f. Crear chistes o historias
g. Crear un conjunto de instrucciones para completar una tarea

12. Pensando en la información que buscas en tu vida diaria, ¿qué probabilidad hay de que uses chatbots de IA/ChatGPT para lo siguiente? (muy improbable, algo improbable, ni probable ni improbable, algo probable, muy probable):
a. Encontrar información relacionada con empleo
b. Encontrar información relacionada con estudios
c. Aprender más sobre un tema que estudias
d. Consultar el tiempo
e. Ponerte al día con noticias recientes
f. Crear chistes o historias
g. Crear un conjunto de instrucciones para completar una tarea

13. Cuando buscas cada uno de los siguientes tipos de información, ¿con qué frecuencia un motor de búsqueda es capaz de generar una respuesta relevante? Nota: relevante significa únicamente que proporciona información pertinente sobre el tema, no necesariamente que sea exacta o satisfactoria para ti. (nunca, no muy a menudo, con cierta frecuencia, muy a menudo, siempre):
a. Encontrar información relacionada con empleo
b. Encontrar información relacionada con estudios
c. Aprender más sobre un tema que estudias
d. Consultar el tiempo
e. Ponerte al día con noticias recientes
f. Crear chistes o historias
g. Crear un conjunto de instrucciones para completar una tarea

14. Cuando buscas cada uno de los siguientes tipos de información, ¿con qué frecuencia un chatbot de IA/ChatGPT es capaz de generar una respuesta relevante? Nota: relevante significa únicamente que proporciona información pertinente sobre el tema, no necesariamente que sea exacta o satisfactoria para ti. (nunca, no muy a menudo, con cierta frecuencia, muy a menudo, siempre):
a. Encontrar información relacionada con empleo
b. Encontrar información relacionada con estudios
c. Aprender más sobre un tema que estudias
d. Consultar el tiempo
e. Ponerte al día con noticias recientes
f. Crear chistes o historias
g. Crear un conjunto de instrucciones para completar una tarea

15. Cuando buscas cada uno de los siguientes tipos de información, ¿con qué frecuencia un motor de búsqueda tradicional es capaz de generar una respuesta satisfactoria? Nota: una respuesta satisfactoria es aquella que cubre completamente la información que necesitas y con la que quedas satisfecho/a. (nunca, no muy a menudo, con cierta frecuencia, muy a menudo, siempre):
a. Encontrar información relacionada con empleo
b. Encontrar información relacionada con estudios
c. Aprender más sobre un tema que estudias
d. Consultar el tiempo
e. Ponerte al día con noticias recientes
f. Crear chistes o historias
g. Crear un conjunto de instrucciones para completar una tarea

16. Cuando buscas cada uno de los siguientes tipos de información, ¿con qué frecuencia un chatbot de IA/ChatGPT es capaz de generar una respuesta satisfactoria? Nota: una respuesta satisfactoria es aquella que cubre completamente la información que necesitas y con la que quedas satisfecho/a. (nunca, no muy a menudo, con cierta frecuencia, muy a menudo, siempre):
a. Encontrar información relacionada con empleo
b. Encontrar información relacionada con estudios
c. Aprender más sobre un tema que estudias
d. Consultar el tiempo
e. Ponerte al día con noticias recientes
f. Crear chistes o historias
g. Crear un conjunto de instrucciones para completar una tarea

Explorando el comportamiento informacional

Wilson, T. D. (2026). Explorando el comportamiento informacional. (Trad. Martha Sabelli y José Vicente Rodríguez Muñoz). (Ed. y Trad. Francisco Javier Martínez Méndez). Editum. Ediciones de la Universidad de Murcia. https://doi.org/10.6018/editum.3204

Texto completo

Original en inglés

El autor revisa los principales modelos teóricos del campo e incorpora enfoques de disciplinas como la psicología, la sociología y la comunicación, destacando la influencia de factores contextuales, cognitivos y emocionales. Además, amplía la visión tradicional centrada en la “búsqueda de información” hacia un concepto más amplio de “comportamiento informacional”, que incluye tanto la búsqueda intencional como el descubrimiento accidental de información.

En conjunto, el libro ofrece una introducción estructurada que combina teoría y evidencia, consolidando un enfoque centrado en el usuario clave para la investigación, la enseñanza y el diseño de sistemas de información.

El problema de la “caja vacía”: Por qué es más difícil que nunca saber qué escribir en la barra de búsqueda de IA

Tay, Aaron. The Blank Box Problem: Why It’s Harder Than Ever to Know What to Type Into an AI Search Bar. Publicado el 10 de enero de 2026 en Aaron Tay’s Musings about Librarianship (Substack). https://aarontay.substack.com/p/the-blank-box-problem-why-its-harder

Se aborda un fenómeno importante y creciente en la forma en que interactuamos con las tecnologías de búsqueda potenciada por inteligencia artificial. Aaron Tay describe el llamado “problema de la caja vacía”, que se refiere a la interfaz minimalista y aparentemente sencilla que caracteriza a las nuevas herramientas de búsqueda con IA: una simple barra de texto en blanco donde el usuario debe escribir su consulta sin ninguna guía explícita. Aunque esta simplicidad visual puede parecer atractiva, Tay argumenta que en realidad introduce una complejidad mucho mayor para el usuario, quien ahora enfrenta un desafío mucho más grande para formular preguntas efectivas. La ausencia de señales visuales, filtros o estructuras de consulta claras que existían en los motores de búsqueda tradicionales provoca que el usuario quede desorientado y no sepa qué tipo de entrada es la más adecuada para obtener resultados precisos o útiles.

En la era previa a la inteligencia artificial, muchas plataformas de búsqueda ofrecían herramientas como operadores booleanos, menús desplegables y categorías que ayudaban a los usuarios a acotar y precisar sus consultas. Estas herramientas, aunque a veces complejas, proporcionaban un marco de referencia sobre cómo interactuar con la base de datos o motor de búsqueda. Sin embargo, las interfaces modernas con IA, como los chatbots y asistentes inteligentes, presentan una única caja de texto sin indicaciones claras sobre qué esperar. Esto crea dos niveles de ambigüedad para el usuario: por un lado, no está seguro de cómo debe redactar su consulta —si debe usar términos técnicos, lenguaje natural, frases completas, comandos específicos o prompts diseñados para la IA—, y por otro lado, desconoce qué tipo de capacidades tiene el sistema, qué preguntas puede responder con precisión y cuáles no. Esta doble incertidumbre dificulta la confianza en el sistema y genera una sensación de trial and error constante, en la que los usuarios prueban diferentes formas de preguntar sin saber cuál será la mejor.

Además, Aaron Tay compara esta situación actual con la experiencia de años anteriores en entornos académicos y profesionales, donde las bases de datos especializadas exigían un aprendizaje de formatos y comandos específicos para ser usadas eficazmente. A pesar de ser más técnicas, esas plataformas ofrecían a los usuarios un marco claro y reglas definidas para construir consultas. En contraste, la actual “caja vacía” no ofrece ningún tipo de feedback inmediato ni estructura clara, por lo que los usuarios desarrollan sus propias “teorías populares” o intuiciones sobre cómo deben preguntar, a menudo basadas en ensayo y error o en compartir trucos entre comunidades en línea. Este fenómeno evidencia la falta de transparencia en cómo los modelos de IA interpretan el lenguaje y procesan las solicitudes, dejando a los usuarios sin un entendimiento real sobre la arquitectura interna que guía la generación de respuestas.

Finalmente, el artículo enfatiza que esta simplicidad superficial puede resultar contraproducente, ya que la interfaz minimalista esconde un funcionamiento interno complejo que no se comunica al usuario. Esto crea una brecha entre la experiencia del usuario y la tecnología, dificultando no solo la eficacia en la búsqueda, sino también la confianza y la adopción plena de estas nuevas herramientas. Aaron Tay sugiere que para superar este desafío, es necesario repensar el diseño de las interfaces de búsqueda con IA, de modo que se mantenga la accesibilidad y simplicidad, pero se agreguen señales claras y transparencia sobre las capacidades reales del sistema. Solo así se podrá equilibrar la promesa de la inteligencia artificial con la necesidad humana de entender y controlar las herramientas que utilizamos diariamente.

Del buscar al responder: el enfoque CARE y el nuevo papel del bibliotecario universitario ante la IA generativa

Lo, Leo S. The CARE Approach for Academic Librarians: From Search First to Answer First with Generative AI. The Journal of Academic Librarianship 52, no. 1 (enero 2026): 103186. https://doi.org/10.1016/j.acalib.2025.103186

En el entorno académico actual, estudiantes y profesores cada vez más inician sus investigaciones solicitando explicaciones a sistemas de inteligencia artificial en lugar de comenzar con la búsqueda tradicional en los recursos de la biblioteca. Las herramientas de IA y los motores de búsqueda avanzados proporcionan respuestas desarrolladas incluso antes de que el usuario vea una lista de fuentes académicas. Este fenómeno transforma el punto de partida de la indagación académica y plantea nuevos desafíos para las prácticas de la bibliotecología.

Dado este cambio hacia un enfoque de “respuesta primero”, el autor sostiene que los bibliotecarios también deben evolucionar su mentalidad y estrategias de intervención. En lugar de simplemente ofrecer acceso a recursos, los bibliotecarios necesitan reconocer las respuestas generadas por IA como textos que demandan interpretación y análisis crítico. Para ello, se propone la creación de una tipografía de respuestas que ayude a identificar la función que cumplen estas respuestas automatizadas.

Finalmente, el artículo propone el enfoque CARE —por sus siglas en inglés: Classify, Assess, Review, Enhance (Clasificar, Evaluar, Revisar, Mejorar)— como un marco metodológico para interactuar críticamente con las respuestas de IA en colaboración con los usuarios. Este enfoque sitúa a los bibliotecarios como guías que ayudan a sus comunidades académicas a leer, cuestionar y ampliar las respuestas generadas por IA manteniendo el juicio humano y la evidencia científica en el centro de la investigación.

Del SEO al GEO: cómo los contenidos de producto determinan la visibilidad en la búsqueda impulsada por IA

Lily AI. From SEO to GEO: The Role of Product Content in AI Search and Discovery. Lily AI, 2025.

Texto completo

la transformación profunda que está experimentando la búsqueda de productos en el comercio digital con la irrupción de los motores generativos de inteligencia artificial. Durante dos décadas, el SEO tradicional marcó las normas de visibilidad online, obligando tanto a usuarios como a minoristas a pensar en términos de palabras clave, enlaces y estructuras legibles para los algoritmos. Sin embargo, ese modelo se está desmoronando. Los motores de IA como Gemini, ChatGPT, Claude o Perplexity ya no se limitan a indexar páginas, sino que interpretan significados, contextos e intenciones. Este cambio está alterando de raíz el modo en que los consumidores descubren productos: más del 60% de las búsquedas terminan sin clic y se prevé un descenso del 50% del tráfico orgánico para 2028, al prevalecer las respuestas generadas directamente por IA. En este nuevo escenario, la cuestión clave no es si un producto “aparece”, sino si es correctamente comprendido por los sistemas generativos.

Se subraya además que los consumidores ya no buscan listados de enlaces, sino relevancia, precisión contextual y orientación personalizada. Las personas formulan peticiones en lenguaje natural, como “un vestido suave y fluido para unas vacaciones de verano”, y esperan que el sistema entienda matices de ocasión, clima, estilo o preferencia estética. Esto exige un nivel de comprensión semántica imposible de satisfacer con descripciones de producto pobres o centradas únicamente en palabras clave. Frente a ello surge el concepto de GEO (Generative Engine Optimization), entendido como la disciplina orientada a que los productos se representen adecuadamente en respuestas generadas por IA. Si el SEO decía a las máquinas “qué ver”, el GEO les enseña “qué significa” cada producto: qué es, para quién sirve, en qué contexto es adecuado y por qué debería recomendarse.

El documento sostiene que los catálogos ya no pueden ser inventarios estáticos, sino auténticas infraestructuras de datos. Los motores generativos funcionan relacionando atributos, imágenes, metadatos y descripciones para formar una representación coherente de cada artículo. Si faltan datos o contexto, la IA rellena los huecos de forma incorrecta, lo que compromete la relevancia. En cambio, un catálogo enriquecido —con taxonomías coherentes, atributos completos, descripciones en lenguaje natural y metadatos unificados— se convierte en un grafo de conocimiento vivo que facilita que la IA conecte productos con necesidades reales. El texto muestra cómo la falta de precisión puede provocar errores, como confundir un pintalabios rojo con tonos completamente distintos, mientras que un sistema de datos bien estructurado favorece recomendaciones fiables, personalizadas y consistentes.

Por último, el informe explica cómo los minoristas pueden prepararse para este nuevo entorno dominado por la IA. Propone acciones como enriquecer los datos de producto más allá de lo básico; optimizar descripciones para consultas naturales; unificar y automatizar los metadatos mediante esquemas y taxonomías; mantener la información constantemente actualizada; y adoptar nuevas métricas que midan la representación semántica en lugar del ranking tradicional. Según el documento, el éxito dependerá de comprender que el contenido de producto ya no es un elemento estático de merchandising, sino un lenguaje compartido entre consumidores, comerciantes, anunciantes y máquinas. Empresas como Lily AI ofrecen plataformas diseñadas para convertir catálogos en sistemas de información legibles por la IA, mejorando la precisión de las recomendaciones, la coherencia de los datos y, en última instancia, las ventas.