Archivo de la etiqueta: Tecnologías de la información

Inteligencia Artificial y Bibliotecas: oportunidades y desafios


Inteligencia Artificial y Bibliotecas: oportunidades y desafios

Santiago de Areco, Buenos Aires 28 de septiembre de 2026

Ver en Youtube

La inteligencia artificial está transformando las bibliotecas y la manera en que las personas acceden, utilizan y producen información. En este contexto, las bibliotecas pueden desempeñar un papel fundamental en la construcción de una cultura de alfabetización en IA, facilitando conocimientos accesibles para toda la ciudadanía. Esta alfabetización implica comprender cómo funcionan estas tecnologías, sus posibilidades, limitaciones, sesgos y riesgos. Los profesionales de las bibliotecas necesitan desarrollar nuevas competencias para orientar a los usuarios en un uso crítico, ético y responsable de la IA. La formación, los talleres, las guías y los espacios de experimentación pueden contribuir a reducir las brechas digitales y de conocimiento. De este modo, la biblioteca se consolida como un espacio de aprendizaje, pensamiento crítico y participación ciudadana ante la expansión de la inteligencia artificial.

Kimi el modelo de IA chino abierto y gratuito que pone a prueba el liderazgo tecnológico de Estados Unidos

James O’Donnell, “China’s AI models have Trump’s AI world at war with itself”, MIT Technology Review, 20 de julio de 2026.
Artículo original en MIT Technology Review

El lanzamiento de Kimi, un modelo de inteligencia artificial desarrollado por la empresa china Moonshot AI, está provocando un debate dentro del entorno político y tecnológico de la Administración Trump. El artículo señala que Kimi, que se ofrece de manera gratuita y con un modelo abierto, parece alcanzar capacidades comparables a las de algunos sistemas avanzados estadounidenses de empresas como OpenAI y Anthropic. La aparición de un modelo chino de estas características modifica la percepción de la ventaja tecnológica estadounidense y plantea una cuestión fundamental: cómo responder a una competencia que no solamente procede de China, sino que utiliza además una estrategia de acceso abierto y bajo coste.

El problema tiene también una dimensión económica. Si modelos chinos suficientemente capaces están disponibles gratuitamente, las empresas y usuarios tienen menos incentivos para pagar por modelos propietarios estadounidenses. Esto puede afectar especialmente a las grandes compañías de IA de Estados Unidos, cuyas elevadas valoraciones y expectativas de crecimiento dependen en buena medida de mantener una posición de liderazgo tecnológico. El artículo relaciona esta situación con la preocupación existente en Washington por el peso que las empresas de inteligencia artificial están adquiriendo en el crecimiento económico estadounidense.

La aparición de Kimi ha puesto de manifiesto, además, divisiones dentro del propio entorno de asesores de Trump. Por un lado, figuras como David Sacks han defendido una mayor apertura y han cuestionado que el Gobierno intervenga para proteger a las empresas estadounidenses frente a modelos de código abierto. Desde esta perspectiva, impedir o dificultar la aparición de competidores abiertos podría terminar perjudicando la innovación estadounidense. Sacks también ha señalado que algunos modelos chinos resultan atractivos porque imponen menos restricciones a determinados usos, aunque el artículo recuerda que los modelos chinos están sujetos a mecanismos de censura estatal.

Frente a esta posición aparece otra corriente que considera que la evolución de los modelos de IA ha alcanzado un nivel en el que la seguridad nacional justifica una mayor intervención gubernamental. En este contexto se sitúa el nuevo proceso de revisión de la Casa Blanca destinado a evaluar determinados modelos antes de su lanzamiento. Dean Ball, antiguo asesor de Trump y posteriormente vinculado a OpenAI, criticó este mecanismo porque, en su opinión, podría convertirse de facto en un sistema de autorización previa para los modelos de frontera.

El debate llegó incluso a convertirse en una confrontación pública entre miembros y antiguos miembros del entorno gubernamental. El artículo describe intercambios especialmente duros entre Dean Ball y Emil Michael, funcionario de alto nivel del Pentágono encargado de las relaciones con las empresas de IA. Más allá de las declaraciones personales, el enfrentamiento refleja una cuestión de fondo: si Estados Unidos debe responder a la competencia china mediante una mayor libertad para innovar y competir o mediante mecanismos gubernamentales más estrictos relacionados con la seguridad y el control de los modelos.

Otro elemento importante es el relativo a los chips y la capacidad de computación. Durante la Administración Biden y durante la primera etapa de la segunda Administración Trump, una de las principales estrategias estadounidenses había sido limitar el acceso de China a los procesadores avanzados necesarios para desarrollar modelos de IA de última generación. Sin embargo, el artículo señala que posteriormente se han relajado algunas de estas restricciones, incluyendo la autorización para que Nvidia venda determinados chips a China. Al mismo tiempo, el Gobierno estadounidense ha denunciado posibles operaciones de contrabando de chips.

La cuestión que permanece abierta es cómo ha conseguido Kimi alcanzar un nivel de rendimiento tan elevado pese a las limitaciones de China en materia de capacidad computacional avanzada. El artículo plantea como una de las posibilidades la denominada distillation o destilación de modelos: un procedimiento mediante el cual un sistema puede aprender a partir de las respuestas generadas por otros modelos ya existentes. OpenAI y Anthropic han acusado anteriormente a empresas chinas de utilizar técnicas de este tipo y han solicitado medidas gubernamentales para limitar esta práctica. En abril de 2026, la Administración Trump anunció iniciativas destinadas precisamente a combatirla.

Enseñar tecnología a personas adultas: estrategias para generar confianza y autonomía desde las bibliotecas

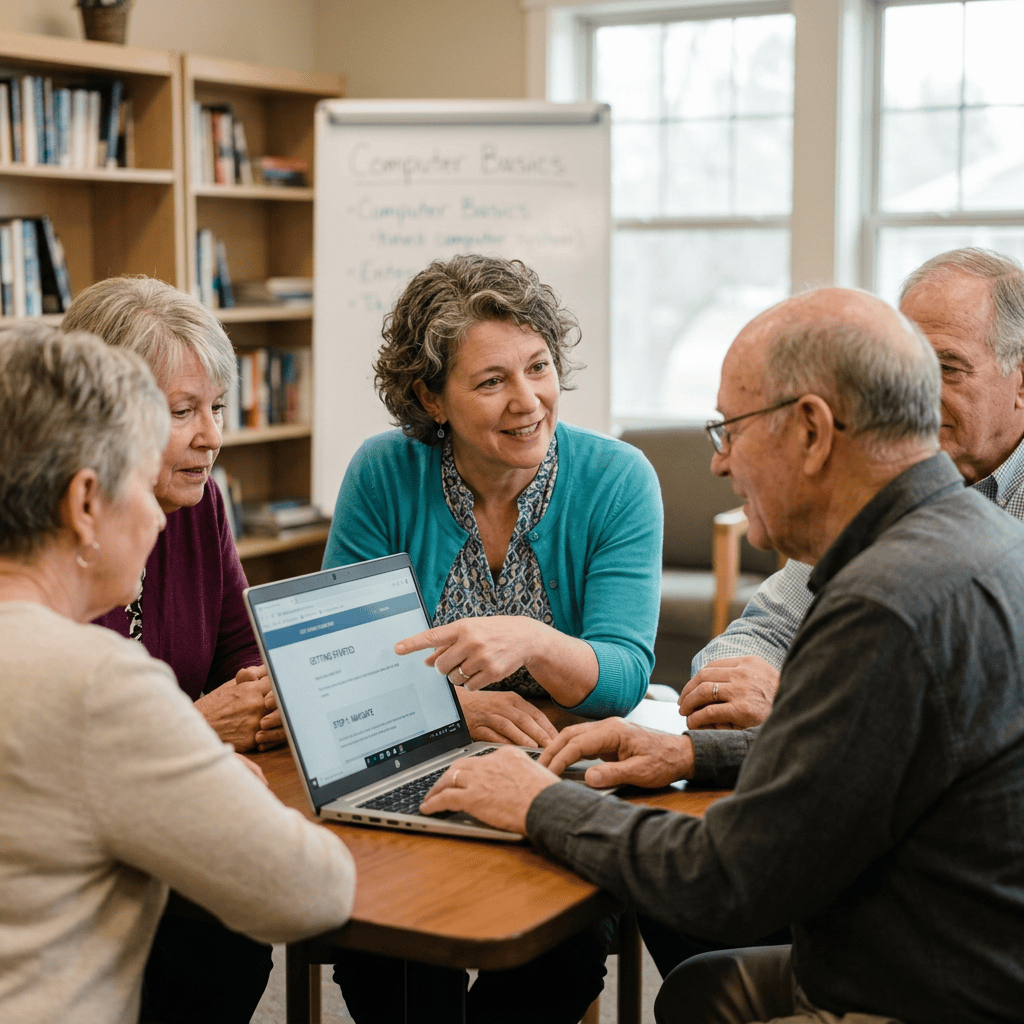
Instructor teaching older adults computer basics around a laptop
Older adults learn essential computer skills together during an encouraging group workshop.

WebJunction. (2026, 16 de julio). Teaching technology to adults: Confidence-building advice from the field. WebJunction, OCLC.
Acceder al artículo original en WebJunctio

Se aborda uno de los retos habituales de las bibliotecas públicas: ayudar a las personas adultas a desenvolverse con tecnologías que pueden resultarles complejas, intimidantes o cambiantes. La propuesta parte de una idea fundamental: muchas dificultades tecnológicas no deben interpretarse únicamente como una carencia de habilidades, sino también como un problema de confianza y seguridad personal.

La experiencia procede de Steve Alcalde, responsable de Servicios Informáticos y Tecnológicos de Rogers Memorial Library, cuyo equipo imparte aproximadamente diez clases de tecnología al mes y atiende diariamente consultas tecnológicas de usuarios y personal. El planteamiento fue presentado en una sesión de la PLA dedicada precisamente a enseñar tecnología a adultos que consideran que son «malos con la tecnología».

Uno de los principales mensajes del artículo es que la finalidad de la alfabetización tecnológica no debería limitarse a resolver el problema concreto que plantea el usuario, sino conseguir que este adquiera suficiente confianza para enfrentarse posteriormente a situaciones similares por sí mismo. Desde esta perspectiva, la intervención bibliotecaria se transforma: el profesional deja de ser simplemente quien «arregla» el problema y pasa a desempeñar una función de acompañamiento y formación. Esta diferencia es importante porque una solución rápida puede resolver la dificultad inmediata, pero no necesariamente proporciona al usuario los conocimientos o la seguridad necesarios para repetir el procedimiento de manera autónoma.

El artículo propone varias estrategias prácticas. La primera consiste en normalizar el miedo o la frustración ante la tecnología. Una persona puede temer equivocarse, romper el dispositivo, parecer poco competente o no comprender las explicaciones. Reconocer que determinadas tecnologías pueden resultar confusas ayuda a reducir esa sensación de inseguridad. También se recomienda adoptar una posición física y comunicativa más colaborativa: sentarse junto al usuario en lugar de situarse enfrente y, sobre todo, no quitarle el dispositivo de las manos. Aunque manejar directamente el teléfono o el ordenador pueda ser más rápido para el profesional, permitir que la propia persona realice las acciones favorece el aprendizaje, la familiarización con el dispositivo y la adquisición de confianza.

Otro aspecto especialmente relevante es el lenguaje empleado por el personal bibliotecario. Expresiones aparentemente inocentes como «es muy fácil» o «solo tienes que…» pueden aumentar la frustración cuando el usuario está teniendo dificultades. WebJunction propone sustituir este tipo de formulaciones por expresiones de acompañamiento, como «tú inténtalo y yo te guío», «tómate tu tiempo» o «vamos a hacerlo paso a paso». Se trata de eliminar el lenguaje excesivamente técnico y evitar que la persona sienta que su dificultad es consecuencia de una supuesta incapacidad. La comunicación se convierte así en una parte esencial de la alfabetización digital.

La fragmentación de los procesos en pequeñas acciones constituye otra de las recomendaciones centrales. Lo que para un profesional habituado a utilizar una determinada aplicación o servicio puede ser una secuencia automática de pasos, para un usuario puede representar una sucesión de decisiones desconocidas. Por ello, se aconseja explicar una sola acción cada vez, comprobar que la persona la ha realizado y continuar posteriormente con el siguiente paso. A esto se añade la recomendación de reducir deliberadamente la velocidad de explicación. El profesional puede tener interiorizado el procedimiento después de haberlo realizado cientos de veces, mientras que el usuario necesita tiempo para localizar botones, comprender términos y relacionar las instrucciones con lo que aparece en pantalla.

El artículo también plantea la conveniencia de comenzar por pequeños logros o «victorias rápidas». En lugar de abordar inmediatamente una tarea compleja, puede ser útil empezar con una acción sencilla que permita experimentar una sensación de éxito: aumentar el tamaño del texto, enviar una fotografía o realizar una operación básica. Estos pequeños avances funcionan como refuerzo positivo y pueden modificar la percepción que la persona tiene de sus propias capacidades. El objetivo no es únicamente completar una tarea, sino construir progresivamente una percepción de autonomía: «puedo hacerlo».

Un elemento particularmente interesante es la necesidad de preguntar y obtener retroalimentación durante la formación. El profesional no debería asumir automáticamente que conoce el origen del problema. Una persona que parece tener dificultades con una aplicación puede, en realidad, estar confundida por el proceso completo que hay detrás. Preguntas sencillas como «¿qué parte no coincide con lo que esperabas?» permiten descubrir las verdaderas dificultades y corregir las explicaciones. De esta manera, la interacción se convierte en un proceso bidireccional en el que también el bibliotecario aprende a identificar sus propias suposiciones y a mejorar sus métodos de enseñanza.

El artículo ofrece un ejemplo muy ilustrativo relacionado con el aprendizaje de la fotografía y el envío de imágenes desde un iPhone. El usuario seguía las instrucciones, pero dudaba antes de realizar cada paso. Cuando el instructor preguntó si estaba explicando demasiado deprisa, descubrió que la persona no conocía algunos términos utilizados y necesitaba más tiempo para localizar cada elemento en la pantalla. La solución consistió en reducir el ritmo, explicar una acción cada vez, evitar vocabulario técnico no explicado y ofrecer al usuario la posibilidad de intentar por sí mismo el siguiente paso. Al finalizar, la persona manifestó que creía que podría realizar el procedimiento en casa. Para WebJunction, este resultado es más significativo que la simple resolución de la consulta, porque demuestra que se ha conseguido transferir confianza y autonomía.

Otro ejemplo aborda un problema aparentemente técnico relacionado con la impresión desde el teléfono móvil utilizando la red Wi-Fi de la biblioteca. El usuario no entendía por qué el documento no salía inmediatamente de la impresora después de pulsar «imprimir». El problema no estaba realmente en la utilización de la página web, sino en que la persona tenía un modelo mental diferente del funcionamiento del servicio: esperaba que el documento se imprimiera automáticamente, como ocurría en su domicilio. La explicación del proceso completo —enviar el documento, acudir al mostrador, realizar el pago y liberar la impresión— permitió comprender la lógica del sistema. Además, se explicó que el mecanismo de liberación contribuía a proteger la privacidad de los usuarios. El ejemplo demuestra la importancia de explicar el funcionamiento global de un servicio y no únicamente los pasos técnicos.

En un sentido más amplio, el artículo presenta la alfabetización tecnológica como una tarea educativa y no simplemente asistencial. Las bibliotecas ofrecen cada vez más apoyo para utilizar teléfonos inteligentes, ordenadores, aplicaciones, servicios digitales, sistemas de impresión y otras herramientas tecnológicas. En este contexto, cada consulta individual puede convertirse en una oportunidad para desarrollar competencias que permitan al usuario afrontar nuevos problemas. Esta concepción conecta directamente con la función tradicional de las bibliotecas como espacios de aprendizaje permanente y con su papel en la reducción de las brechas digitales. WebJunction sitúa precisamente la formación de usuarios entre las áreas fundamentales de los servicios bibliotecarios y reúne recursos específicos sobre alfabetización digital y enseñanza a usuarios.

Después de 2.000 años, la inteligencia artificial vuelve a dar voz a los libros sepultados por el Vesubio

1000 Libraries Magazine. (30 de agosto de 2026). “After 2,000 Years, Lost Books Buried by a Volcano Are Finally Being Read”. 1000 Libraries Magazine, sección History.

Ver original

El artículo presenta uno de los proyectos más fascinantes de la arqueología digital contemporánea: la recuperación de los rollos de Herculano, una extraordinaria colección de papiros que sobrevivió a la erupción del Vesubio en el año 79 d. C.

Los manuscritos pertenecían a la llamada Villa de los Papiros, cuya biblioteca constituye una de las pocas bibliotecas de la Antigüedad clásica que han llegado hasta nosotros. El calor extremo de la erupción carbonizó los papiros, transformándolos en frágiles bloques negros que, aunque destruidos aparentemente como libros legibles, conservaron en su interior los textos. Durante siglos se intentó desenrollarlos físicamente, pero estas intervenciones provocaron daños e incluso la destrucción de algunos ejemplares.

El gran cambio ha llegado gracias a la combinación de tomografía de rayos X, aceleradores de partículas, visión por ordenador e inteligencia artificial. En lugar de abrir los rollos, los investigadores pueden realizar imágenes tridimensionales de su interior y reconstruir digitalmente las diferentes capas de papiro. Este procedimiento, conocido como “desenrollado virtual”, permite separar y aplanar digitalmente las capas superpuestas del manuscrito. Posteriormente, los algoritmos de aprendizaje automático buscan las diminutas diferencias producidas por la tinta sobre las fibras del papiro carbonizado. La dificultad es enorme porque la tinta utilizada era fundamentalmente de carbono y, por tanto, resulta muy similar al propio material carbonizado del rollo en las imágenes de rayos X.

La tecnología no funciona, sin embargo, como una máquina que simplemente «lee» los manuscritos. La IA detecta patrones que pueden corresponder a tinta, mientras que la reconstrucción del texto y su interpretación corresponden a especialistas en papirología, filología clásica e historia antigua. Esta colaboración entre disciplinas es fundamental: los algoritmos permiten localizar señales prácticamente invisibles para el ojo humano, pero son los investigadores quienes deben determinar qué letras aparecen, reconstruir las palabras y comprender su significado. El proyecto constituye así un ejemplo especialmente interesante de cómo la inteligencia artificial puede actuar como una herramienta de descubrimiento científico sin sustituir el conocimiento experto.

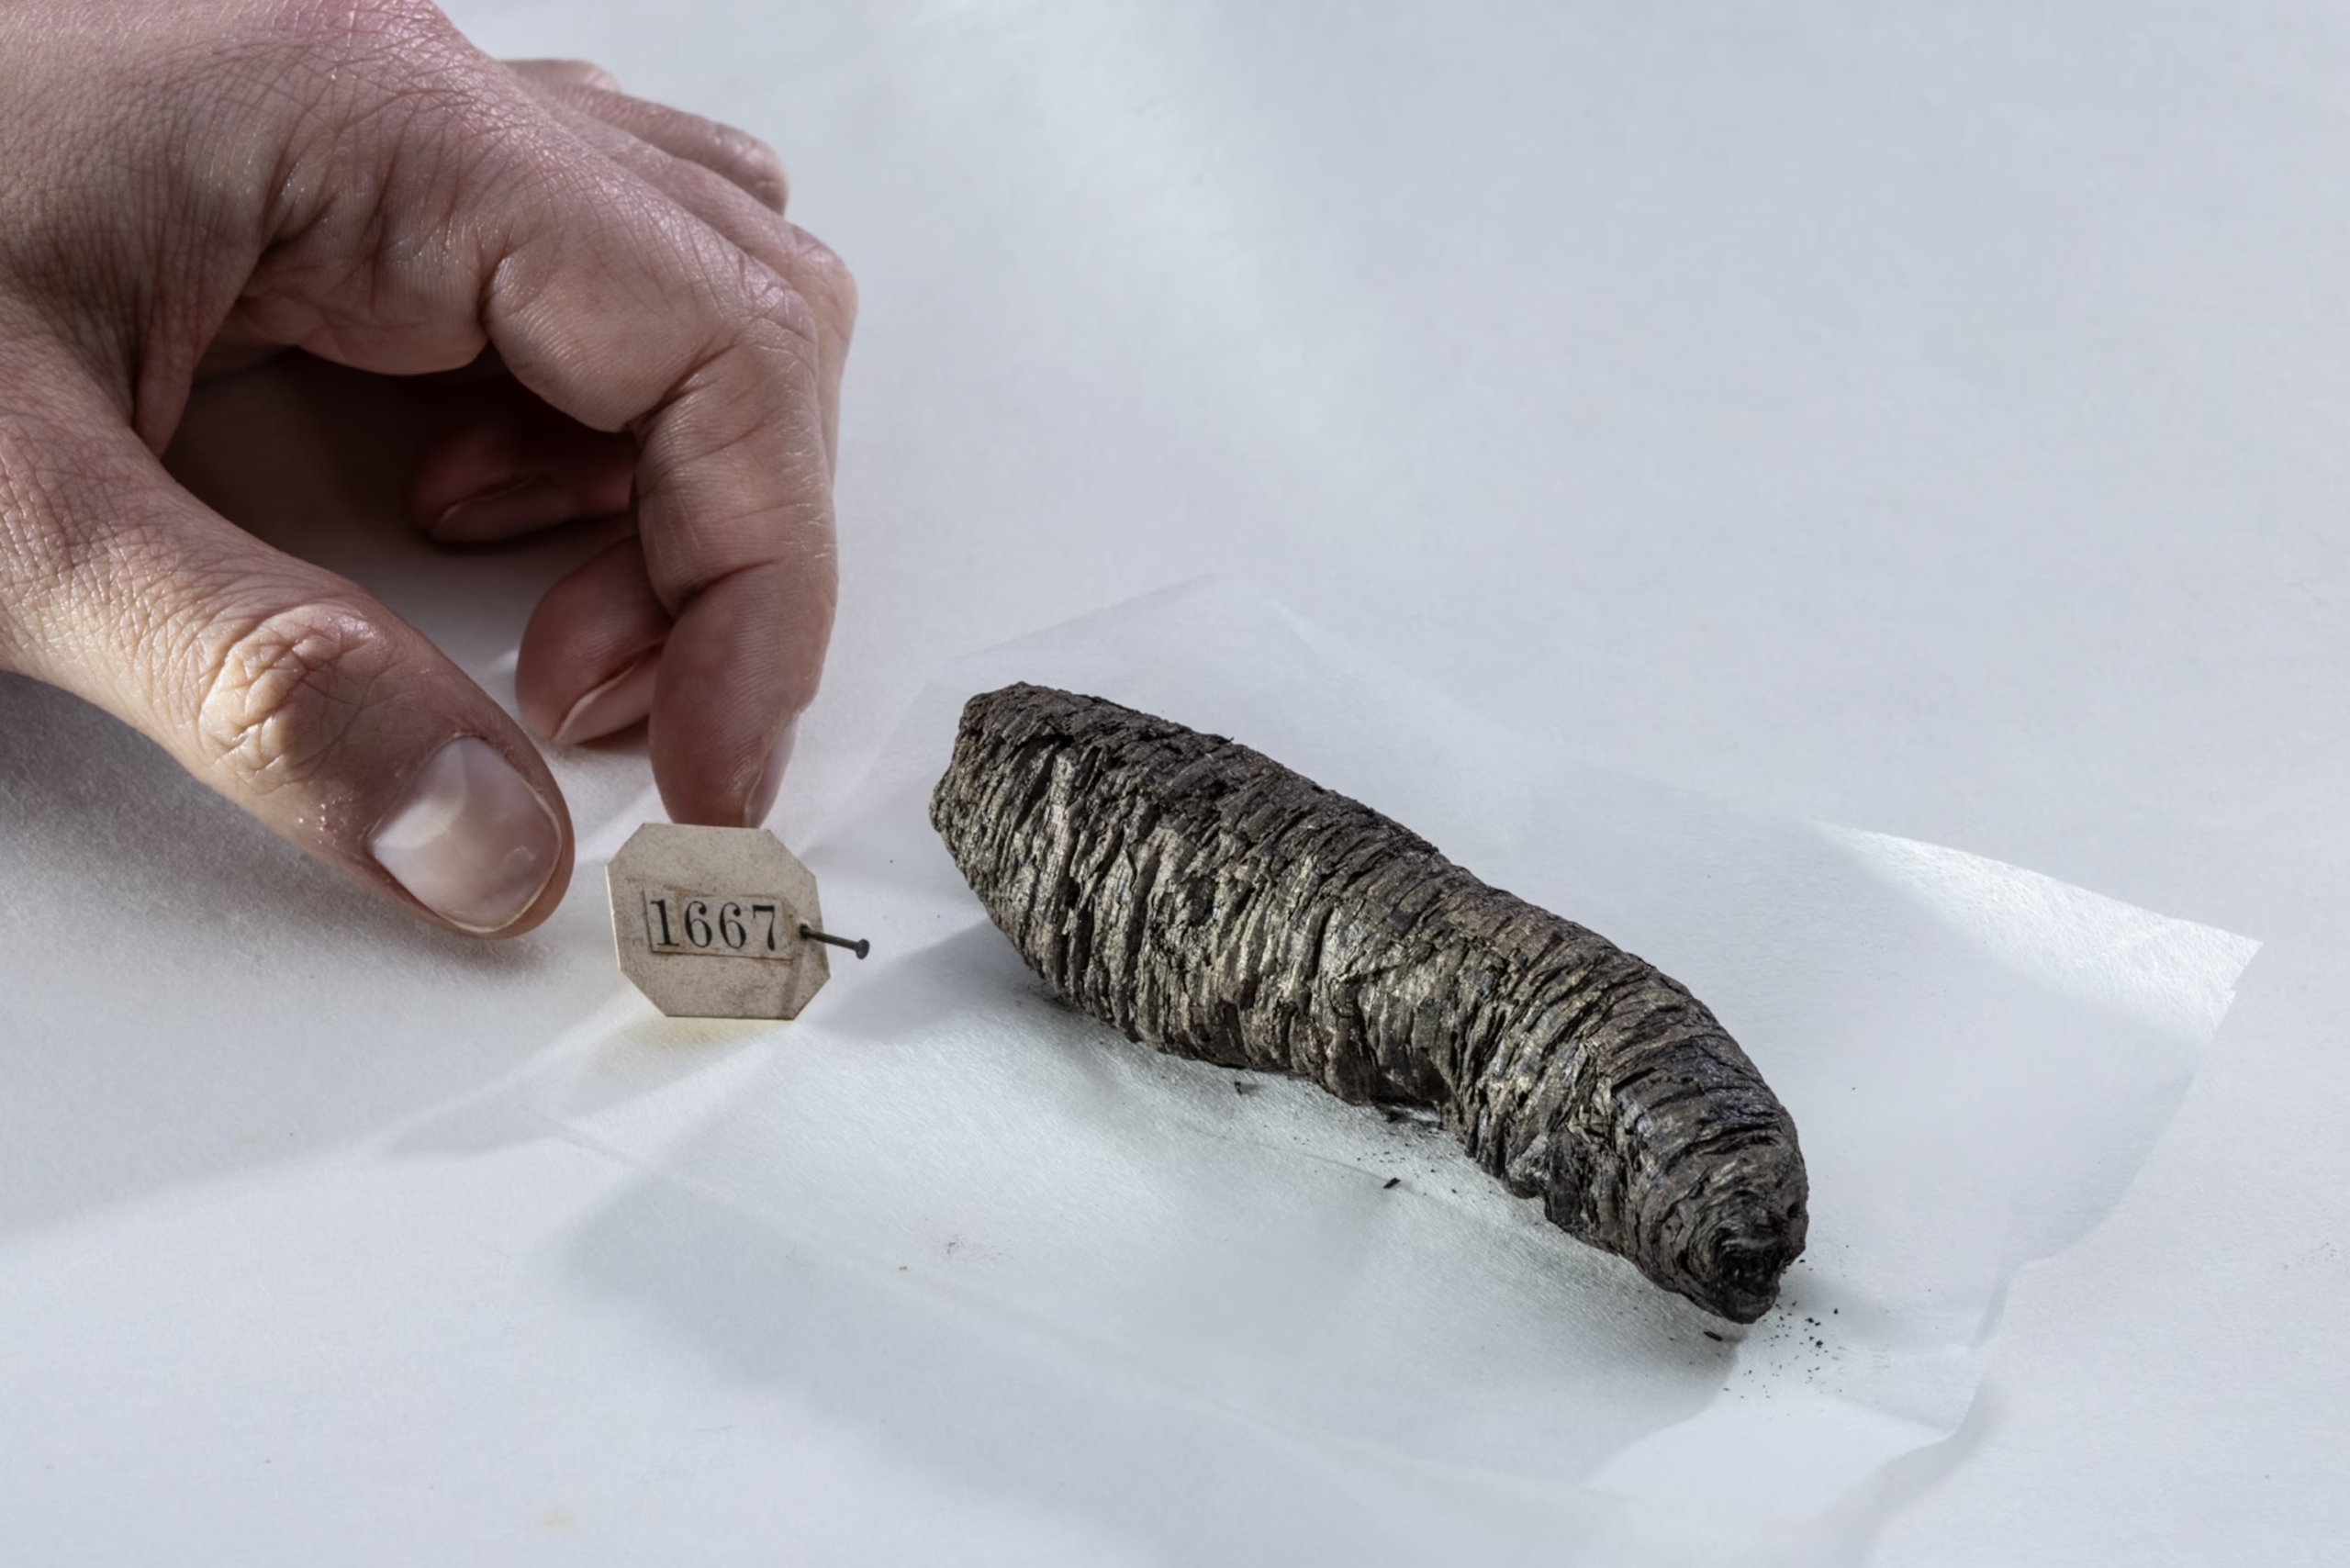
Uno de los proyectos fundamentales en este proceso es el Vesuvius Challenge, que puso a disposición de investigadores y participantes de todo el mundo imágenes y herramientas informáticas para acelerar la recuperación de los textos. La iniciativa ha convertido un problema arqueológico aparentemente imposible en un desafío interdisciplinar de aprendizaje automático, visión artificial y geometría computacional. En 2026 se alcanzó un hito extraordinario: el rollo PHerc. 1667 se convirtió en el primero de Herculano que pudo ser desenrollado virtualmente y leído de principio a fin. El proyecto continúa trabajando para recuperar muchos más textos de una colección que todavía contiene centenares de rollos sin abrir.

El descubrimiento tiene una importancia que va mucho más allá de la tecnología. Los papiros pueden contener obras filosóficas, literarias e históricas que se han perdido en la transmisión tradicional de la cultura clásica. La biblioteca de Herculano ofrece, por tanto, la posibilidad de recuperar una parte desconocida del pensamiento antiguo y ampliar nuestro conocimiento sobre la filosofía, la literatura y la cultura grecorromanas. Cada nuevo fragmento recuperado puede aportar información sobre autores y obras de los que solo conocemos referencias indirectas o que permanecían completamente desconocidos. La tecnología permite así convertir lo que durante siglos parecía un conjunto de objetos carbonizados e ilegibles en una auténtica biblioteca digital recuperable.

El caso también resulta especialmente significativo desde la perspectiva de las bibliotecas y la preservación del patrimonio documental. La recuperación de estos manuscritos demuestra que digitalizar no significa únicamente hacer una fotografía de un documento, sino desarrollar nuevas tecnologías capaces de revelar información que físicamente no puede ser consultada. Bibliotecarios, científicos, especialistas en humanidades digitales, ingenieros e investigadores trabajan conjuntamente para preservar y hacer accesibles materiales que, de otro modo, permanecerían ocultos. En este sentido, los rollos de Herculano constituyen un magnífico ejemplo de cómo la tecnología puede ampliar las posibilidades de conservación, investigación y acceso al patrimonio escrito.

El proyecto del Vesubio demuestra que la inteligencia artificial puede convertirse en una herramienta extraordinaria para recuperar conocimiento perdido: no abre físicamente los libros, sino que permite «ver» dentro de ellos, reconstruir sus páginas y ayudar a los especialistas a recuperar textos que llevan casi dos milenios esperando ser leídos. La combinación de patrimonio, bibliotecas, ciencia

Un estudio cuestiona el impacto del marcado en las citas y visibilidad de las páginas en la IA generativa

Diagram showing schema markup flow leading to AI citation and attribution with terms like JSON-LD, knowledge transfer, and algorithms.
Visual diagram illustrating schema markup and AI citation integration processes.

Schwartz, Barry. “Study: Adding Schema Did Not Improve AI Citations On Google, ChatGPT & More.” Search Engine Roundtable. Publicado el 13 de mayo de 2026. Consultado el 19 de mayo de 2026.

El artículo recoge los resultados de un estudio realizado por Ahrefs que cuestiona una de las creencias más extendidas dentro del SEO y del emergente ámbito del GEO (Generative Engine Optimization): la idea de que añadir marcado Schema o datos estructurados mejora la probabilidad de que una página web sea citada por sistemas de inteligencia artificial como Google AI Overviews, Google AI Mode o ChatGPT.

La investigación analizó 1.885 páginas web que incorporaron marcado JSON-LD Schema entre agosto de 2025 y marzo de 2026 y las comparó con un grupo de control formado por unas 4.000 páginas similares que no añadieron este tipo de marcado. El objetivo era determinar si existía una relación causal entre el uso de Schema y la frecuencia con la que las plataformas de IA citaban esos contenidos en sus respuestas generadas automáticamente. Según el estudio, los resultados no mostraron mejoras estadísticamente significativas en ninguna de las plataformas analizadas.

Los datos obtenidos fueron especialmente llamativos porque contradicen gran parte del discurso dominante en el sector SEO. En Google AI Overviews, las páginas que añadieron Schema incluso mostraron una ligera disminución del 4,6 % en las citas respecto al grupo de control. En Google AI Mode se registró un aumento del 2,4 %, mientras que en ChatGPT el incremento fue del 2,2 %, aunque ambos valores fueron considerados estadísticamente irrelevantes y posiblemente atribuibles al azar. Los investigadores concluyeron que no puede afirmarse que el Schema produzca un aumento real de visibilidad en sistemas de IA generativa.

El estudio también introduce una distinción importante entre correlación y causalidad. Ahrefs observó inicialmente que las páginas citadas por sistemas de IA tenían casi tres veces más probabilidades de incluir marcado Schema que las páginas no citadas. Sin embargo, los autores sostienen que esto probablemente se debe a que los sitios web técnicamente mejor mantenidos suelen aplicar simultáneamente buenas prácticas SEO, contenido de calidad, autoridad de dominio y estrategias de enlazado más sólidas. En otras palabras, el Schema sería un indicador indirecto de calidad técnica general, pero no el factor que impulsa directamente las citas de la IA.

Otro aspecto relevante es que algunos experimentos citados dentro del informe mostraron que varios sistemas de IA no utilizan directamente el marcado JSON-LD durante la extracción inmediata de información, sino que priorizan el contenido HTML visible de la página. Esto cuestiona la idea de que los modelos generativos “lean” o dependan necesariamente del Schema para interpretar el contenido web.

La noticia tuvo una fuerte repercusión dentro de la comunidad SEO y GEO. En diversos debates en Reddit y redes profesionales, numerosos especialistas interpretaron el estudio como un golpe a ciertas estrategias de “optimización para IA” que se habían popularizado rápidamente durante 2025 y 2026. Algunos comentarios destacan que muchas recomendaciones sobre Schema y visibilidad en IA se habían difundido más como hipótesis comerciales que como conclusiones respaldadas por evidencia empírica sólida.

No obstante, el estudio no concluye que el Schema carezca completamente de utilidad. Los autores recuerdan que los datos estructurados siguen siendo importantes para otros contextos: resultados enriquecidos en buscadores, interoperabilidad semántica, organización de contenidos, accesibilidad de datos y construcción de knowledge graphs. Además, reconocen que la investigación se centró únicamente en páginas ya visibles para los sistemas de IA y no pudo determinar si el Schema podría ayudar a páginas nuevas o menos visibles a ser descubiertas inicialmente.

En conjunto, el informe refleja una transformación profunda del SEO tradicional hacia un entorno dominado por motores generativos y asistentes conversacionales. La principal conclusión es que las estrategias centradas exclusivamente en optimizaciones técnicas aisladas parecen perder peso frente a factores más amplios como la autoridad temática, la calidad del contenido, la claridad informativa y la confianza del dominio. El debate abierto por este estudio muestra que el ecosistema GEO todavía se encuentra en una fase experimental, donde muchas prácticas consideradas “buenas estrategias” aún carecen de validación científica robusta.

Las bibliotecas reducen el tiempo de los flujos de trabajo manuales entre un 30 y un 60 % con la IA académica.

Guzman, Dani. “New Study: Libraries Cut Manual Workflow Time by 30 to 60% with Academic AI.” Clarivate. Publicado el 24 de marzo de 2026. Acceso el 19 de mayo de 2026.

Texto completo

Un reciente estudio impulsado por Clarivate analiza cómo la inteligencia artificial está transformando los flujos de trabajo en bibliotecas académicas, especialmente en tareas relacionadas con la catalogación y la elaboración de listas de lectura. La investigación se basa en entrevistas realizadas a once profesionales de bibliotecas pertenecientes a ocho instituciones de América del Norte, América Latina y Oriente Medio, y ofrece uno de los primeros conjuntos de evidencias empíricas sobre el impacto operativo real de la IA en bibliotecas universitarias.

El informe destaca que las herramientas de IA permiten reducir entre un 30 % y un 60 % el tiempo invertido en tareas manuales y repetitivas. Actividades que antes requerían entre quince y cuarenta y cinco minutos, como la creación de listas de bibliografía docente, pueden completarse ahora en apenas dos o cinco minutos gracias a asistentes inteligentes integrados en plataformas bibliotecarias. Un ejemplo citado es el de la University of Windsor, donde una lista de veinte referencias pasó de requerir veinte minutos de trabajo a solo tres.

La investigación también subraya un notable incremento de la capacidad operativa de las bibliotecas. Los equipos responsables de metadatos y catalogación consiguieron multiplicar entre dos y cuatro veces el volumen de trabajo asumible sin necesidad de aumentar el personal. En el caso de la Universidad Tecnológica de Bolívar, la IA permitió abordar enormes retrasos de catalogación que hasta entonces se consideraban prácticamente imposibles de resolver. Según la directora de biblioteca Dora Lilia Sepúlveda, la automatización eliminó el cuello de botella derivado de la transcripción manual y recuperó hasta el 80 % del tiempo operativo, facilitando la recuperación y visibilidad de miles de registros olvidados.

Otro aspecto relevante del estudio es el impacto en el acceso a los recursos por parte de los estudiantes. Entre el 50 % y el 60 % de las listas de lectura procesadas mediante IA estuvieron disponibles inmediatamente gracias a la localización automática de materiales existentes en la colección y a la generación de enlaces directos. Esto mejora considerablemente la rapidez de acceso a la bibliografía académica y contribuye a optimizar la experiencia educativa.

En relación con la calidad de los datos generados, el estudio señala que entre el 70 % y el 90 % de los metadatos creados por IA fueron aceptados con solo pequeñas correcciones por parte de los bibliotecarios. El modelo aplicado no elimina la supervisión humana: la inteligencia artificial genera un primer borrador, mientras que los profesionales siguen siendo responsables de la revisión, validación y toma de decisiones finales. Desde la University of Haifa se destaca especialmente la utilidad de la IA en la catalogación de materiales en idiomas que el catalogador no domina, así como en la asignación preliminar de materias y encabezamientos temáticos.

El estudio insiste en que la IA no sustituye el criterio profesional bibliotecario, sino que transforma la naturaleza del trabajo. Las tareas mecánicas y repetitivas disminuyen, mientras que aumenta la dedicación a actividades estratégicas, de validación, comunicación y apoyo académico. De este modo, los bibliotecarios pueden concentrarse en funciones de mayor valor añadido, como la alfabetización informacional, la mediación crítica y el acompañamiento a investigadores y estudiantes.

Estas conclusiones coinciden con debates recientes dentro de la comunidad bibliotecaria internacional. En diversos foros profesionales y discusiones en Reddit, muchos bibliotecarios describen una transición hacia un nuevo papel como “verificadores” y mediadores críticos de contenidos generados por IA. Al mismo tiempo, persisten preocupaciones sobre la fiabilidad de las respuestas automáticas, la dependencia excesiva de estas herramientas y la necesidad de establecer políticas éticas claras para su adopción en bibliotecas.

Inteligencia artificial para la generación de contenidos en Iberoamérica: experiencias editoriales en medios de comunicación

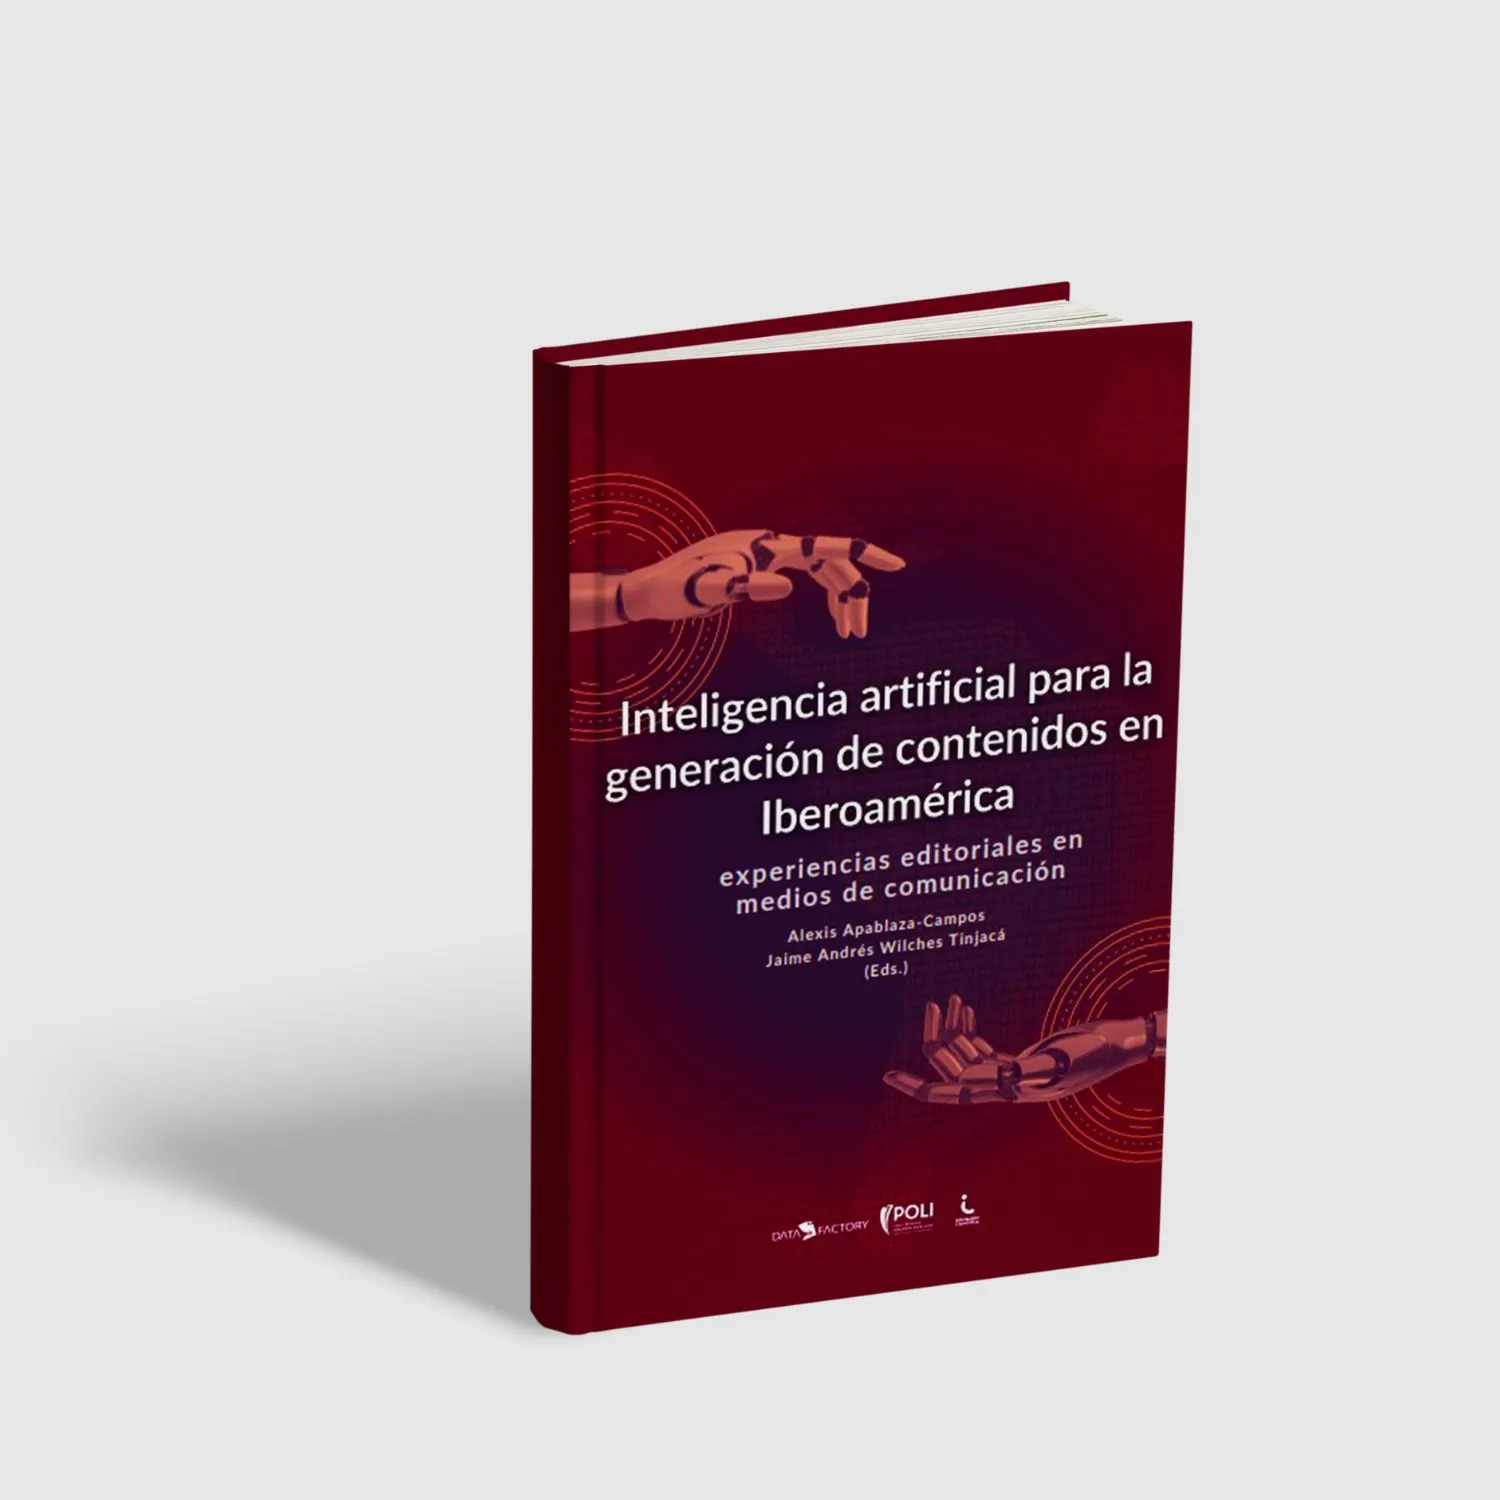
Inteligencia artificial para la generación de contenidos en Iberoamérica: experiencias editoriales en medios de comunicación / Apablaza-Campos, Alexis; Wilches Tinjacá, Jaime Andrés. 1ª edición. Bogotá D.C.: DataFactory, Institución Universitaria Politécnico Grancolombiano & Iniciación Científica; 2024.

Texto completo

Segunda edición digital y primera edición impresa de esta obra (actualizada a mayo de 2025), la cual se enmarca en un contexto donde la inteligencia artificial (IA) se está integrando de manera creciente en el periodismo y la generación de contenidos en Iberoamérica. Su justificación teórica se basa en la necesidad de comprender y evaluar el impacto de estas tecnologías emergentes en el ámbito de la comunicación, un tema de relevancia crítica tal como se ha documentado en estudios disciplinares recientes. El tipo de formato de esta obra corresponde a un estudio académico y de investigación, estructurado en varios capítulos que abordan diferentes aspectos del uso de la IA en los medios de comunicación. Estos capítulos incluyen análisis teóricos, estudios de caso, resultados de encuestas y entrevistas con expertos del sector. El objetivo de este estudio es explorar y documentar las experiencias de implementación de IA en la generación de contenidos en medios de comunicación de Iberoamérica, proporcionando una visión integral sobre cómo estas tecnologías están transformando el periodismo en la región. Se pretende no solo identificar las mejores prácticas y los desafíos enfrentados, sino también ofrecer recomendaciones para la adopción ética y eficiente de la IA en el ámbito mediático. La descripción de la actividad realizada incluye una amplia recopilación y análisis de datos provenientes de diversas fuentes. Se llevó a cabo un ciclo de webinars que contó con la participación de más de 700 asistentes y la colaboración de cuatro instituciones académicas iberoamericanas. Estos webinars sirvieron como plataforma para el intercambio de conocimientos y experiencias sobre el uso de la IA en los medios. Además, se realizó una encuesta a más de 150 participantes de estos webinars para recoger datos sobre la frecuencia de uso, el conocimiento y las expectativas respecto a las herramientas de IA. El libro se organiza en cinco capítulos principales. El primer capítulo ofrece conceptualizaciones iniciales y entrevistas a expertos sobre los desafíos éticos y técnicos del uso de la IA en los medios. El segundo capítulo resume las sesiones del ciclo de webinars y destaca los casos de éxito presentados. El tercer capítulo presenta los resultados de la encuesta realizada a los asistentes de los webinars. El cuarto capítulo es el más extenso y analiza los principales casos, desafíos y proyecciones de la generación de contenidos mediante IA en diversos países de Iberoamérica, incluyendo entrevistas y capturas de pantalla de experiencias destacadas. Finalmente, el quinto capítulo ofrece reflexiones finales y proyecciones futuras sobre el uso de la IA en el periodismo iberoamericano.

Guía de evaluación de sistemas de IA en entornos bibliotecarios

Cox, Andrew, y Maria De Brasdefer. IFLA Entry Point to Libraries and AI. International Federation of Library Associations and Institutions (IFLA), 2025. https://repository.ifla.org/items/f197f327-dc49-4743-bb57-0a373505da8b

Entry Point for Libraries and AI

Licensing an AI service from a publisher

La Inteligencia Artificial (IA) ofrece un gran potencial para apoyar los valores fundamentales de las bibliotecas, como el acceso equitativo a la información y la creación de conocimiento. Sin embargo, también es una tecnología controvertida, cuyos avances actuales suscitan inquietudes éticas y sociales. Las bibliotecas desempeñan un papel clave en la promoción de usos responsables, inclusivos y sostenibles de la IA. Sus valores —libertad de expresión, privacidad, transparencia y rendición de cuentas— proporcionan una perspectiva ética para interactuar con las herramientas y prácticas de la IA. Este documento define la IA en un sentido amplio y ofrece un conjunto práctico de preguntas para la reflexión que ayudan a los profesionales de las bibliotecas a evaluar las oportunidades y los riesgos.

El texto plantea un escenario de reflexión sobre la incorporación de herramientas de inteligencia artificial en los servicios de bibliotecas, concretamente en el caso de la posible licitación de un sistema de búsqueda potenciado por IA ofrecido por una editorial científica. Este sistema promete mejorar significativamente la recuperación de información mediante resúmenes automáticos de publicaciones, lo que obliga a los profesionales de la biblioteca a evaluar críticamente su pertinencia, utilidad y riesgos antes de su adopción.

Para ello, se propone la creación de un equipo interdisciplinar formado por especialistas en sistemas bibliotecarios, biblioteconomía, alfabetización informacional y derechos de autor. Este grupo debe elaborar una lista de preguntas clave para analizar la herramienta desde múltiples perspectivas: ética, funcionalidad, impacto institucional, fiabilidad, transparencia y adecuación a las necesidades reales de los usuarios. El objetivo no es solo valorar la innovación tecnológica, sino determinar si realmente aporta beneficios significativos frente a otras soluciones existentes y si su coste está justificado dentro de las prioridades de la biblioteca.

El documento se estructura a partir de un marco de 14 preguntas que sirven como guía de evaluación de sistemas de IA en entornos bibliotecarios. Estas cuestiones abordan aspectos como la calidad y precisión de la información generada por la IA, los posibles sesgos, la protección de la diversidad cultural y lingüística, la equidad en el acceso, la privacidad de los datos de los usuarios y la transparencia del funcionamiento del sistema. También se examina quién es responsable de los posibles errores del sistema y cómo se comunican sus limitaciones a los usuarios.

Asimismo, se subraya la importancia de garantizar que los datos utilizados por la IA no provengan de fuentes obtenidas de manera ilegítima y que se respeten los derechos de autor y la soberanía de los datos culturales. Otro eje central es la necesidad de mantener la agencia del usuario, es decir, que las personas puedan seguir controlando su interacción con la tecnología sin que esta sustituya sus habilidades críticas o de aprendizaje.

Las 14 preguntas funcionan como un marco de evaluación crítica para que las bibliotecas analicen la incorporación de sistemas de inteligencia artificial, especialmente en servicios de información y descubrimiento. No son un checklist técnico cerrado, sino una guía amplia que permite valorar tanto el impacto funcional como las implicaciones éticas, sociales y organizativas de estas herramientas.

  1. Valor y pertinencia del servicio. La pregunta inicial obliga a la biblioteca a identificar qué tipo de beneficio real aporta la IA en términos de acceso al conocimiento y creación de información. No se trata solo de si la herramienta es innovadora, sino de si mejora de forma significativa la experiencia del usuario frente a alternativas más simples o económicas. Aquí se introduce también el concepto de “coste de oportunidad”: invertir en IA implica renunciar a otros posibles servicios o mejoras.

2, Calidad de la información generada por la IA, especialmente su precisión, actualización e imparcialidad. En entornos bibliotecarios esto es crucial, ya que los sistemas de IA pueden generar resúmenes o síntesis que parecen fiables pero contienen errores, sesgos o simplificaciones. Además, se plantea la necesidad de monitorización continua, ya que estos sistemas pueden cambiar su rendimiento con el tiempo.

3. Sesgos . Se evalúa si la IA reproduce estereotipos o excluye perspectivas culturales y lingüísticas. Esto es especialmente relevante en bibliotecas, cuyo objetivo tradicional es garantizar el acceso equitativo a la información.

4. Diversidad del conocimiento. También se analiza si el sistema favorece únicamente contenido en inglés o si integra fuentes multilingües y diversas.

5. Mal uso del sistema, especialmente en relación con la desinformación o la censura. Aunque menos desarrollada en el texto, apunta a un problema creciente: la posibilidad de que herramientas avanzadas de IA sean utilizadas para manipular o distorsionar información académica o científica.

6. Equidad y accesibilidad, considerando si todos los usuarios pueden beneficiarse del sistema en igualdad de condiciones. Aquí se incluyen aspectos como la accesibilidad digital (cumplimiento de estándares como WCAG), la brecha tecnológica y la posible exclusión de determinados colectivos.

7. Transparencia, uno de los más complejos en IA. Se analiza hasta qué punto el usuario entiende qué está haciendo el sistema, cómo genera los resultados y cuáles son sus límites. También se plantea la cuestión de la responsabilidad: quién responde cuando la IA comete errores, la empresa, la biblioteca o el usuario.

8. Privacidad y gestión de datos, un tema crítico en entornos académicos. Se evalúa cómo se recogen, almacenan y utilizan los datos de los usuarios, incluyendo sus consultas, patrones de búsqueda y posibles datos personales, así como el cumplimiento de normativas como el GDPR.

9. Legalidad y ética de los datos utilizados para entrenar la IA, así como en el respeto a los derechos de autor. También introduce una preocupación emergente: la carga que la IA puede generar sobre repositorios abiertos y sistemas de acceso libre.

10. Participación social y la soberanía de los datos, es decir, si las comunidades afectadas han sido tenidas en cuenta en el desarrollo del sistema y si mantienen control sobre su información cultural.

11. Agencia del usuario y el impacto en el aprendizaje. Se analiza si la IA fortalece las competencias del usuario o si, por el contrario, fomenta la dependencia y la pérdida de habilidades críticas. También se considera la necesidad de formación para un uso responsable.

12. Empleo y la estructura laboral, tanto en bibliotecas como en el ecosistema editorial y tecnológico. Se plantea si la IA sustituye funciones humanas o si reconfigura los roles profesionales.

13. Impacto ambiental, un aspecto cada vez más relevante. El uso de modelos de IA implica consumo energético, infraestructura de servidores y uso de agua, lo que obliga a considerar la sostenibilidad del servicio en su ciclo completo.

14. Modelo de negocio y la gobernanza del proveedor, es decir, quién desarrolla la herramienta, bajo qué principios opera y si su estrategia es sostenible y alineada con valores públicos. También se abre la reflexión sobre posibles vínculos con intereses comerciales o incluso militares.

En conjunto, estas 14 preguntas no buscan una respuesta única, sino fomentar una evaluación crítica y multidimensional de la inteligencia artificial en bibliotecas, equilibrando innovación tecnológica con responsabilidad ética, social y profesional.

El texto también amplía la reflexión hacia dimensiones sociales más amplias, como el impacto laboral de estas tecnologías, su huella ambiental y el modelo de negocio de las empresas proveedoras. En conjunto, se propone una evaluación integral que no se limite a lo técnico, sino que integre criterios éticos, educativos, sociales y sostenibles, con el fin de orientar la toma de decisiones en las bibliotecas ante la creciente incorporación de la inteligencia artificial.
ChatGPT Images 2.0: la nueva generación de creación visual con texto multilingüe, infografías y capacidades avanzadas

Franzen, Carl. “OpenAI’s ChatGPT Images 2.0 Is Here and It Does Multilingual Text, Full Infographics, Slides, Maps, Even Manga — Seemingly Flawlessly.” VentureBeat, 21 de abril de 2026. https://venturebeat.com/technology/openais-chatgpt-images-2-0-is-here-and-it-does-multilingual-text-full-infographics-slides-maps-even-manga-seemingly-flawlessly

ChatGPT Images 2.0 representa un paso decisivo hacia sistemas multimodales más sofisticados, capaces de combinar lenguaje, imagen y diseño en una única interfaz, acercándose a una nueva forma de producción cultural y comunicativa mediada por inteligencia artificial.

ChatGPT Images 2.0, la nueva generación del modelo de creación de imágenes de OpenAI, destacando su salto cualitativo respecto a versiones anteriores. La principal innovación radica en su capacidad para generar no solo imágenes aisladas, sino documentos visuales complejos y estructurados, como infografías completas, diapositivas, mapas o incluso páginas de manga, con un alto grado de coherencia interna.

Uno de los avances más significativos es la mejora en la integración de texto dentro de las imágenes, especialmente en múltiples idiomas. A diferencia de modelos anteriores —que producían texto incoherente o deformado—, esta versión logra representar texto legible y contextualmente adecuado, incluso en diferentes lenguas, lo que la convierte en una herramienta útil para comunicación global, diseño gráfico y educación.

El modelo también destaca por su capacidad composicional, es decir, su habilidad para organizar distintos elementos visuales y textuales de forma lógica dentro de una misma imagen. Esto permite crear piezas complejas como presentaciones o materiales informativos que antes requerían herramientas de diseño especializadas. En este sentido, ChatGPT Images 2.0 marca un cambio conceptual: las imágenes dejan de ser meramente decorativas para convertirse en un verdadero lenguaje visual estructurado.

Otro aspecto clave es la incorporación de capacidades de razonamiento (“thinking”), que permiten al sistema interpretar mejor las instrucciones y generar resultados más precisos y alineados con la intención del usuario. Esta mejora contribuye a que los outputs sean más utilizables directamente en contextos profesionales, como marketing, educación o comunicación corporativa.

El artículo subraya también el impacto potencial de esta tecnología en industrias creativas y productivas. Al democratizar la creación de gráficos complejos y multilingües, la herramienta puede transformar la manera en que empresas, docentes o creadores generan contenido visual, reduciendo costes y tiempos de producción. Sin embargo, este avance también plantea interrogantes sobre el uso indebido, la autoría y la veracidad de los contenidos generados.

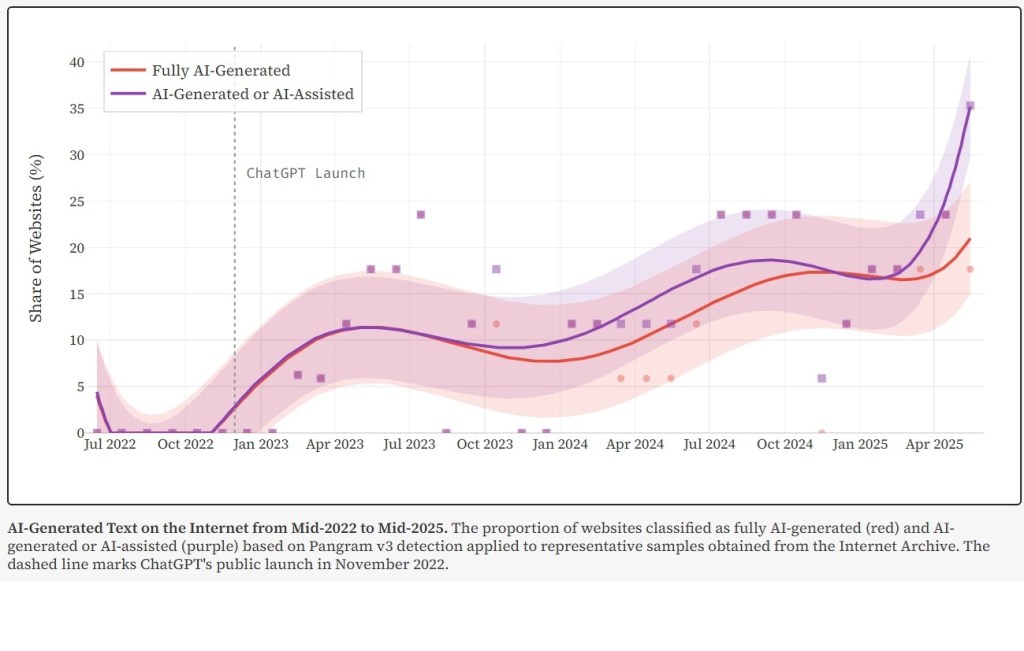
El 35 % de los nuevos sitios web contienen texto generado o asistido por IA

Jonas Dolezal, Sawood Alam, Mark Graham y Maty Bohacek. “The Impact of AI-Generated Text on the Internet.” 2025. https://ai-on-the-internet.github.io/

El estudio analiza cómo la rápida expansión del texto generado por inteligencia artificial ha transformado el ecosistema digital entre 2022 y 2025. A partir de una muestra representativa de páginas web obtenida mediante la Wayback Machine del Internet Archive, los autores estiman que hacia mediados de 2025 aproximadamente el 35 % de los nuevos sitios web contienen texto generado o asistido por IA, una cifra que contrasta con la inexistencia de este fenómeno antes del lanzamiento de ChatGPT en 2022. Este crecimiento evidencia la velocidad con la que la IA se ha integrado en la producción de contenidos en línea.

Uno de los aportes más relevantes del trabajo es su intento de medir empíricamente los efectos reales de este fenómeno frente a la percepción social. Para ello, combina análisis computacional del contenido web con una encuesta a 853 adultos en Estados Unidos. Metodológicamente, el estudio afronta dos retos clave: obtener una muestra representativa de internet —algo complejo por su naturaleza descentralizada— y distinguir entre texto humano y generado por IA, utilizando varios detectores y seleccionando el más robusto (Pangram v3).

En cuanto a los resultados, el estudio confirma dos efectos significativos. Por un lado, se observa una contracción semántica, es decir, una reducción en la diversidad de ideas y perspectivas: los textos generados por IA muestran mayor similitud entre sí. Por otro, se detecta un aumento del tono positivo, con contenidos más “amables” o emocionalmente optimistas, lo que sugiere una cierta tendencia hacia la homogeneización afectiva del discurso digital.

Sin embargo, el trabajo desmonta varias creencias extendidas. No encuentra evidencia estadísticamente significativa de que el uso de IA reduzca la precisión factual, ni de que provoque una pérdida clara de diversidad estilística, ni tampoco que genere textos más largos pero menos densos o que disminuya el uso de enlaces externos. Estos resultados contrastan fuertemente con la percepción pública: una mayoría de los encuestados cree que todos estos efectos negativos sí están ocurriendo.

En conjunto, el estudio pone de relieve una brecha importante entre evidencia empírica y opinión social. Aunque la IA sí está modificando el ecosistema textual de internet —especialmente en términos de diversidad semántica y tono—, muchos de los temores más extendidos no están respaldados por los datos. Esto sugiere la necesidad de un análisis más matizado del impacto de la inteligencia artificial, evitando tanto el alarmismo como la complacencia.