Archivo de la etiqueta: Legislación

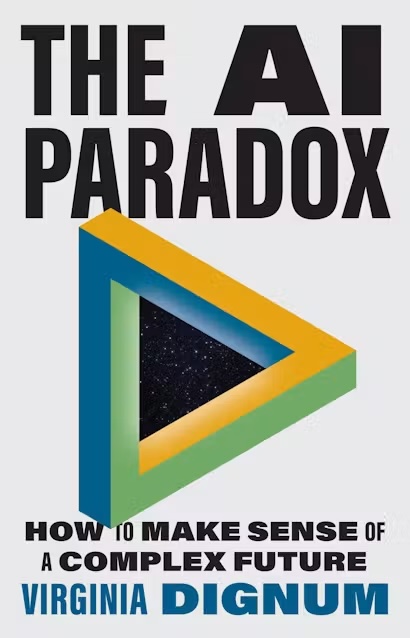
La denuncia contra una experta en IA se archiva tras las acusaciones sobre el uso de inteligencia artificial en su libro

Retraction Watch. (21 de septiembre de 2026). Misconduct case dropped against AI expert after claims of AI use in recent book. Retraction Watch. Artículo original en Retraction Watch

El caso afecta a Virginia Dignum, profesora de inteligencia artificial responsable en la Universidad de Umeå (Suecia) y especialista en las dimensiones sociales de la IA. Una persona anónima presentó una denuncia por posible mala conducta investigadora relacionada con su libro The AI Paradox, publicado por Princeton University Press en febrero de 2026. Las acusaciones se centraban principalmente en dos cuestiones: la supuesta utilización de inteligencia artificial para generar partes del texto y la existencia de referencias bibliográficas que presentaban errores o que, según la denuncia, podían haber sido inventadas.

La Universidad de Umeå recibió la denuncia el 6 de julio de 2026 y remitió el asunto al National Board for Assessment of Research Misconduct (NPOF), organismo sueco encargado de evaluar determinados casos de mala conducta científica. Sin embargo, el 4 de septiembre el organismo decidió cerrar el expediente sin iniciar una investigación, al considerar que las acusaciones quedaban fuera de su ámbito de competencia. El motivo fundamental fue la naturaleza del libro: según la información proporcionada al organismo, The AI Paradox es una obra de divulgación dirigida al público general y no una investigación científica ni un trabajo realizado en el marco de financiación para investigación.

El NPOF concluyó que el libro no constituye investigación científica a efectos de la normativa sueca sobre mala conducta investigadora. El organismo señaló que Dignum considera la obra un libro de divulgación científica, que no formula afirmaciones propias de una investigación y que fue escrita durante su tiempo libre, fuera del ámbito de proyectos financiados. La Universidad de Umeå tampoco encontró elementos que contradijeran esta descripción. Por ello, una vez archivado el expediente, la universidad indicó que no adoptaría medidas específicas contra la investigadora en relación con esta denuncia.

Un elemento particularmente interesante del caso son las referencias bibliográficas cuestionadas. Dignum negó que hubiera fuentes inventadas y explicó que las seis referencias señaladas por la denuncia correspondían a fuentes reales. Reconoció, no obstante, que algunas referencias contenían errores y que determinados problemas se produjeron al utilizar una herramienta de IA para transformar las citas a formato BibTeX. Según su explicación, se trató de errores de edición y no de fabricación deliberada de referencias. Princeton University Press publicó posteriormente una versión electrónica actualizada del libro con correcciones en varias referencias y anunció que las correcciones también se incorporarían a futuras ediciones impresas.

Dignum también reconoció haber utilizado herramientas de inteligencia artificial durante la elaboración del libro para comprobar formulaciones y proponer alternativas de redacción. Según su explicación, el contenido intelectual y el texto final son de su autoría y ella asume la responsabilidad por ellos. El caso vuelve a poner sobre la mesa una cuestión todavía poco definida en el ámbito académico: qué usos de la IA en la escritura son aceptables y cuáles deberían considerarse problemáticos desde el punto de vista de la integridad académica.

Otro aspecto relevante es la utilización de detectores de IA como elemento de prueba. Una de las acusaciones se apoyaba en herramientas que supuestamente habían identificado determinados fragmentos del libro como generados por inteligencia artificial. Dignum cuestionó este tipo de evidencia y sostuvo que no es posible demostrar de manera concluyente que un texto no haya sido generado por IA únicamente mediante herramientas de detección. El caso ilustra así una de las principales dificultades actuales de los detectores: una señal algorítmica de posible generación automática no equivale necesariamente a una prueba de autoría mediante IA.

El bioeticista David Resnik, citado por Retraction Watch, considera que todavía existe una zona de incertidumbre ética respecto al nivel de utilización de IA aceptable en la escritura académica. También advierte sobre la compleja posición de los denunciantes o whistleblowers: pueden contribuir a descubrir auténticas prácticas irregulares, pero también pueden generar investigaciones institucionales costosas cuando las irregularidades denunciadas son menores o no constituyen realmente mala conducta científica.

El caso resulta especialmente significativo para el debate sobre IA e integridad científica porque diferencia tres cuestiones que con frecuencia se mezclan: el uso legítimo o declarado de herramientas de IA durante la redacción, los errores bibliográficos producidos durante procesos asistidos por IA y la verdadera fabricación o falsificación de información. El archivo de la denuncia no significa que todos los problemas señalados en el libro fueran inexistentes: la propia autora reconoció errores bibliográficos que fueron posteriormente corregidos. Lo que determinó el cierre del procedimiento fue, fundamentalmente, que la obra no entraba dentro de la definición de investigación científica sometida a la jurisdicción del organismo sueco.

Ideas clave de la Declaración de la IFLA sobre derechos de autor e IA

Declaración completa de la IFLA en Universo Abierto

La IFLA defiende que la regulación de la IA y el copyright debe encontrar un equilibrio entre los derechos de los creadores y el interés público, garantizando que las bibliotecas puedan acceder, preservar, analizar y reutilizar legalmente los contenidos para investigación, educación, cultura e innovación.

La declaración de la IFLA, aprobada en abril de 2025, plantea una posición especialmente relevante para las bibliotecas: el derecho de autor debe favorecer el acceso al conocimiento, la investigación y la innovación con IA, y no convertirse en una barrera desproporcionada.

  1. La IA es una oportunidad para las bibliotecas. Puede utilizarse para catalogación, descubrimiento de colecciones, referencia, préstamo interbibliotecario, formación y otros servicios.
  2. El copyright no debe utilizarse como una “herramienta contundente” para resolver todos los problemas de la IA. Las cuestiones de privacidad, ética, seguridad, medioambiente o autonomía humana requieren también otros marcos regulatorios.
  3. Defensa de la minería de textos y datos (TDM). La IFLA reclama excepciones al derecho de autor que permitan realizar TDM, incluido el entrenamiento de IA, sobre contenidos adquiridos o accesibles legalmente.
  4. Más datos significa mejores IA. Las restricciones excesivas al acceso a contenidos pueden aumentar los sesgos y errores de los sistemas de IA. Por eso se defiende el acceso a conjuntos de datos lo más amplios y diversos posible.
  5. Las bibliotecas deben preparar sus colecciones para la IA. Esto implica utilizar licencias adecuadas y aplicar los principios FAIR (encontrables, accesibles, interoperables y reutilizables) y CARE (beneficio colectivo, autoridad para controlar, responsabilidad y ética).
  6. Alfabetización en IA como nueva función bibliotecaria. Las bibliotecas deben formar a profesionales, investigadores y usuarios en IA, prestando especial atención a la transparencia, integridad y evaluación crítica de las herramientas.
  7. La IA debe desarrollarse desde los valores bibliotecarios. Las herramientas utilizadas o recomendadas por las bibliotecas deberían respetar la libertad de expresión, la privacidad, la diversidad y la autonomía humana.
  8. Los contratos no deberían anular las excepciones legales. Proveedores y titulares de derechos no deberían introducir cláusulas que restrinjan injustificadamente el uso de IA por parte de los usuarios de bibliotecas ni impedir las excepciones contempladas por la legislación.
  9. Los gobiernos tienen una responsabilidad. Deben desarrollar políticas de IA compatibles con los derechos humanos y apoyar a bibliotecas y otras instituciones en la creación de prácticas éticas y capacidades de supervisión.

CNN demanda a Perplexity por reproducir artículos de forma casi literal

«CNN sues Perplexity AI over ‘verbatim‘ copies of articles». Boing Boing, 29 de mayo de 2026. Disponible en: https://boingboing.net/2026/05/29/cnn-sues-perplexity-ai-over-verbatim-copies-of-articles.html.

La cadena de noticias CNN ha presentado una demanda judicial contra la empresa de inteligencia artificial Perplexity AI, acusándola de infringir sistemáticamente los derechos de autor mediante la copia y redistribución de contenidos periodísticos. La demanda sostiene que Perplexity habría rastreado, extraído y reutilizado miles de artículos, vídeos e imágenes de CNN para alimentar sus sistemas de búsqueda y generación de respuestas basadas en inteligencia artificial.

Según la documentación judicial, CNN afirma haber identificado más de 17.000 ejemplos de contenido supuestamente utilizado sin autorización. La acusación no se limita al empleo de esos materiales para entrenar modelos de IA, sino que sostiene que las respuestas ofrecidas a los usuarios contienen fragmentos idénticos o sustancialmente similares a los artículos originales. En algunos casos, bastaría con introducir el título de una noticia para que el sistema devolviera extensos pasajes muy próximos al texto publicado por CNN, incluyendo contenidos protegidos por suscripción.

CNN argumenta que esta práctica socava el modelo económico del periodismo profesional. La cadena señala que sus noticias son fruto del trabajo de periodistas, investigadores, editores y productores que invierten recursos significativos en la creación de información original. Desde esta perspectiva, permitir que una plataforma de IA reproduzca esos contenidos sin licencia ni compensación económica equivaldría a apropiarse del valor generado por los medios de comunicación tradicionales.

Otro aspecto relevante del caso es que CNN asegura haber intentado previamente negociar con Perplexity un acuerdo de licencia para regular el uso de sus contenidos. Sin embargo, las conversaciones habrían terminado sin acuerdo a finales de 2025. Tras la ruptura de las negociaciones, CNN sostiene que la empresa continuó utilizando sus materiales y que incluso ignoró requerimientos formales para cesar dichas actividades.

Por su parte, Perplexity rechaza las acusaciones. La compañía mantiene que los hechos y la información en sí mismos no están protegidos por derechos de autor y que su tecnología se limita a recopilar, sintetizar y presentar información procedente de múltiples fuentes. Esta línea de defensa coincide con la utilizada por diversas empresas de inteligencia artificial que sostienen que existe una diferencia jurídica entre copiar una obra protegida y extraer hechos o conocimientos contenidos en ella.

La demanda de CNN se inscribe en un contexto más amplio de conflictos legales entre medios de comunicación y empresas de IA. En los últimos años, organizaciones como The New York Times, Reddit, Dow Jones, Merriam-Webster y Encyclopaedia Britannica han emprendido acciones similares, denunciando el uso no autorizado de sus contenidos para entrenar o alimentar sistemas de inteligencia artificial.

Más allá del caso concreto, el litigio plantea una cuestión fundamental para el futuro de la inteligencia artificial generativa: dónde se encuentra el límite entre el uso legítimo de información pública y la reproducción indebida de obras protegidas. El resultado de este y otros procedimientos judiciales podría definir las reglas de juego para la relación entre las empresas tecnológicas y los productores de contenido durante los próximos años, afectando tanto a la sostenibilidad económica del periodismo como al desarrollo de los sistemas avanzados de IA.

El debate sobre las prohibiciones de redes sociales en menores

Alajaji, R. (13 de mayo de 2026). The Science is Not Settled: How Weak Evidence is Fueling a National Push to Ban Social Media for Youth. Electronic Frontier Foundation. https://www.eff.org/deeplinks/2026/05/science-not-settled-how-weak-evidence-fueling-national-push-ban-social-media-youth

El artículo critica el impulso legislativo creciente en varios países para prohibir o restringir el acceso de menores a redes sociales, argumentando que estas políticas se están construyendo sobre una base científica todavía incierta. Según el texto, existe una narrativa pública que presenta el uso de redes sociales como una causa directa y comprobada del deterioro de la salud mental juvenil, pero la evidencia empírica disponible es mucho más ambigua y no permite establecer conclusiones causales firmes.

La EFF sostiene que muchos de los estudios utilizados para justificar estas prohibiciones presentan problemas metodológicos importantes, como correlaciones débiles, dificultades para aislar variables o interpretaciones simplificadas de fenómenos complejos. En lugar de demostrar un daño claro y universal, la investigación actual muestra resultados heterogéneos: algunos estudios encuentran asociaciones negativas, otros efectos neutros e incluso algunos beneficios en determinados contextos o grupos de usuarios. Por ello, el artículo insiste en que no existe aún un consenso científico sólido que permita afirmar que el uso de redes sociales sea intrínsecamente dañino para todos los menores.

El texto también advierte sobre los riesgos políticos de legislar basándose en evidencias incompletas o narrativas simplificadas. Señala que convertir hipótesis científicas en políticas de prohibición puede derivar en medidas desproporcionadas que afecten derechos fundamentales como la libertad de expresión, el acceso a la información y la autonomía digital de los jóvenes. Además, alerta de que este tipo de regulaciones podría reforzar dinámicas de control más amplias, como sistemas de verificación de edad obligatoria o mayor vigilancia en línea.

Frente a la idea de la prohibición, la EFF propone un enfoque alternativo centrado en la regulación de los mecanismos de diseño de las plataformas, en lugar de restringir el acceso en sí. Esto incluiría limitar prácticas como los algoritmos de recomendación adictivos, los patrones de diseño manipulativo o la recopilación excesiva de datos personales. Desde esta perspectiva, el problema no sería el uso de redes sociales en sí mismo, sino ciertos modelos de negocio y diseño que incentivan la atención constante y la dependencia.

En conjunto, el artículo plantea que el debate sobre redes sociales y menores está siendo acelerado por presiones políticas y sociales, pero aún no cuenta con una base científica suficientemente consolidada como para justificar prohibiciones generalizadas. En lugar de soluciones simples como el veto por edad, defiende la necesidad de políticas más matizadas, basadas en evidencia robusta y en la protección equilibrada tanto de la salud mental como de los derechos digitales de los jóvenes.

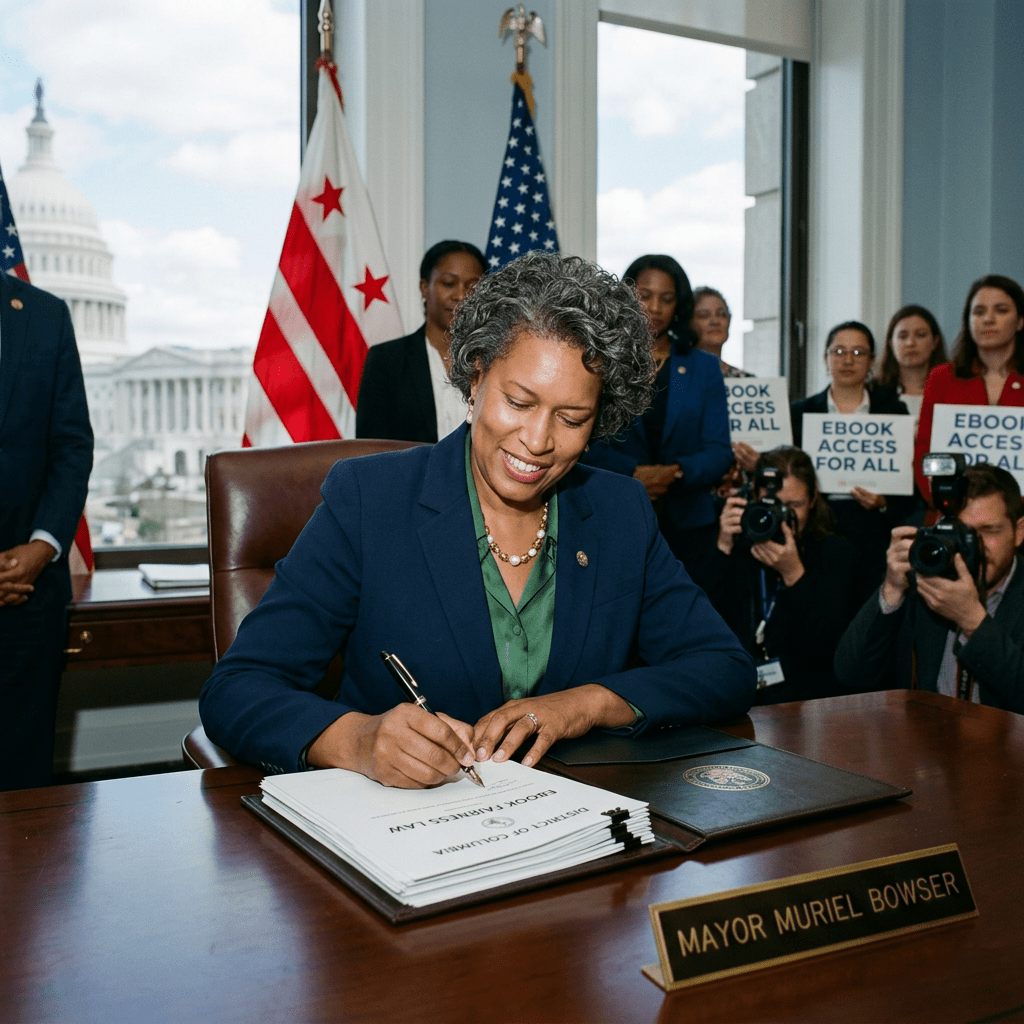
Washington D. C. aprueba una ley pionera para garantizar precios justos de libros electrónicos en las bibliotecas

Mayor Muriel Bowser signing the District of Columbia Ebook Fairness Law in an office with flags and supporters holding 'Ebook Access For All' signs
Mayor Muriel Bowser signs legislation advancing ebook access in Washington, D.C.

Price, Gary. “District of Columbia e-Book Fairness Act Signed by Mayor, Defying Corporate Pressure and Private Equity Lobbying (Statement From eBook Study Group)”. InfoDocket, 1 de junio de 2026. InfoDocket

La alcaldesa de Washington, D.C., Muriel Bowser, ha firmado la Library E-book Pricing Fairness Amendment Act of 2025, una ley considerada histórica por sus promotores porque busca corregir los desequilibrios existentes entre las bibliotecas públicas y las grandes editoriales en el mercado de los libros electrónicos.

La norma fue impulsada y redactada en gran medida por el eBook Study Group, que la presenta como una victoria para las bibliotecas, los sistemas educativos y los contribuyentes frente a los modelos de licenciamiento restrictivos utilizados por algunos grandes grupos editoriales y plataformas digitales.

El principal objetivo de la ley es impedir que las bibliotecas públicas se vean obligadas a aceptar contratos que limiten injustificadamente el acceso de los ciudadanos a los contenidos digitales. La legislación no obliga a los editores a licenciar sus obras ni modifica la legislación federal sobre derechos de autor. En cambio, se apoya en las competencias del Distrito de Columbia en materia de contratación pública y protección del consumidor para exigir que, cuando un editor decida vender o licenciar libros electrónicos a una biblioteca, las condiciones contractuales no puedan perjudicar la misión pública de esta institución.

Entre las prácticas que la ley pretende frenar se encuentran las restricciones sobre el número de préstamos que puede realizar una biblioteca, los precios superiores a los que paga el público general por una misma obra digital, las limitaciones a la preservación de contenidos electrónicos y las cláusulas que impiden compartir información sobre los contratos firmados. También protege la posibilidad de mantener copias de preservación y fomenta condiciones más transparentes y sostenibles para la gestión de colecciones digitales.

Un aspecto especialmente innovador es que la aplicación efectiva de algunas de sus disposiciones dependerá de una acción coordinada entre varios estados. La norma establece que sus restricciones entrarán plenamente en vigor cuando al menos diez estados, con una población conjunta de cincuenta millones de habitantes o más, aprueben legislaciones sustancialmente similares. Con ello se busca aumentar el poder negociador de las bibliotecas y reducir el riesgo de litigios aislados frente a grandes corporaciones del sector editorial.

El artículo también destaca el enfrentamiento político y jurídico que ha rodeado la aprobación de la ley. Los defensores de la iniciativa sostienen que algunas empresas, entre ellas la plataforma de préstamo digital OverDrive, realizaron una intensa labor de presión para intentar frenar el proyecto. Sin embargo, los legisladores del Distrito consideraron que la medida no constituye una forma de censura ni una amenaza para el mercado editorial, sino una herramienta para evitar prácticas contractuales abusivas que dificultan el acceso de la ciudadanía a la lectura digital.

La aprobación de esta ley se enmarca en un movimiento más amplio impulsado por bibliotecarios, juristas y defensores de los derechos digitales que consideran insostenible el actual mercado de los libros electrónicos para bibliotecas. El aumento de la demanda, los elevados costes de licencia, las restricciones de uso y la ausencia de acceso perpetuo a muchos títulos han generado una creciente preocupación en el sector bibliotecario. Por ello, la norma de Washington D. C. es vista como un posible modelo para futuras reformas en otros estados y jurisdicciones de Norteamérica.

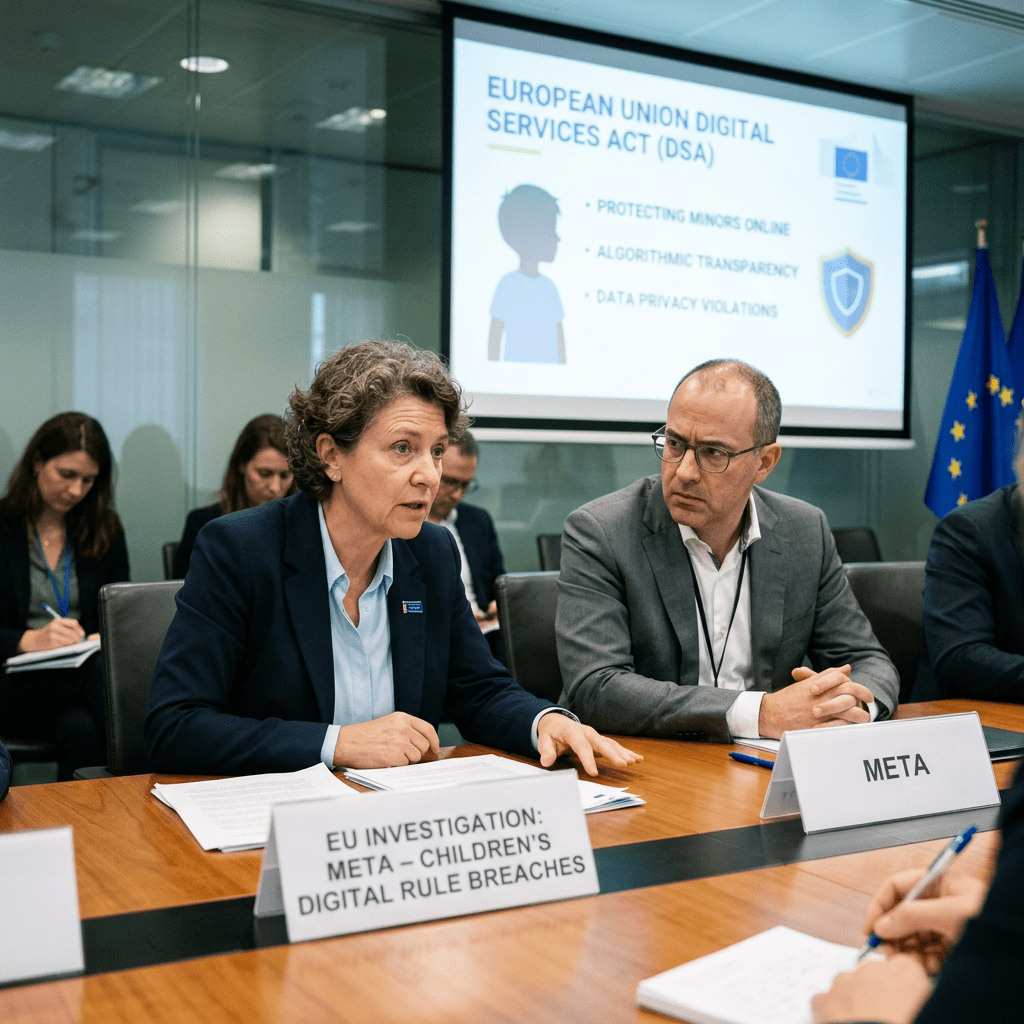
La UE acusa a Meta de incumplir la normativa digital por no proteger a menores en Instagram y Facebook

Officials at EU meeting discussing Meta and children's digital rule breaches
EU officials discussing Meta’s compliance with children’s digital rules

Euronews. “EU finds Meta in breach of digital rules over children on Instagram and Facebook.” Euronews Next, 29 de abril de 2026. https://www.euronews.com/next/2026/04/29/eu-finds-meta-in-breach-of-digital-rules-over-children-on-instagram-and-facebook

La Comisión Europea ha emitido una conclusión preliminar en la que sostiene que Meta incumple la Digital Services Act al no implementar medidas eficaces para impedir que menores de 13 años utilicen sus plataformas, especialmente Instagram y Facebook.

La investigación, que se ha prolongado durante cerca de dos años, concluye que los sistemas actuales de control de edad son insuficientes, ya que permiten a los usuarios registrarse introduciendo fechas de nacimiento falsas sin mecanismos reales de verificación. Como resultado, entre un 10% y un 12% de los menores de 13 años en la Unión Europea estarían utilizando estos servicios, contradiciendo las propias evaluaciones internas de la compañía.

El informe también critica que Meta no ha evaluado adecuadamente los riesgos que estas plataformas suponen para los menores. Según la Comisión, la empresa habría ignorado evidencia científica disponible que señala la especial vulnerabilidad de los niños frente a contenidos perjudiciales y dinámicas potencialmente adictivas en redes sociales. Esto implica un incumplimiento no solo técnico, sino también conceptual, ya que la normativa europea exige que las grandes plataformas identifiquen, analicen y mitiguen los riesgos sistémicos derivados de sus servicios, especialmente cuando afectan a colectivos vulnerables como los menores.

Otro aspecto relevante del caso es la debilidad de los mecanismos para detectar y eliminar cuentas de menores una vez creadas. La Comisión considera que las herramientas de supervisión y reporte no funcionan con la eficacia necesaria, lo que permite que muchos usuarios por debajo de la edad mínima permanezcan activos en las plataformas. Este fallo estructural evidencia una brecha entre las políticas declaradas por la empresa —que fijan los 13 años como edad mínima— y su aplicación real en el entorno digital.

Por su parte, Meta ha rechazado las conclusiones preliminares, defendiendo que ya dispone de herramientas para identificar y eliminar cuentas de menores y subrayando que la verificación de edad es un desafío que afecta a toda la industria tecnológica. La empresa ha anunciado que seguirá colaborando con las autoridades europeas y que introducirá nuevas medidas en el corto plazo para reforzar la protección de los usuarios jóvenes.

El procedimiento aún no ha concluido y Meta tiene la oportunidad de responder a las acusaciones antes de una decisión final. No obstante, si se confirma el incumplimiento, la compañía podría enfrentarse a sanciones significativas, que en el marco de la legislación europea pueden alcanzar hasta el 6% de su facturación global anual. Más allá del caso concreto, este proceso refleja una creciente preocupación en Europa por el impacto de las redes sociales en la infancia y refuerza la tendencia hacia una regulación más estricta de las grandes plataformas digitales en materia de seguridad y bienestar de los usuarios

8 de cada 10 europeos no confían en las empresas estadounidenses ni chinas para el manejo de sus datos.

Politico. “8 in 10 Europeans Don’t Trust US, Chinese Firms with Data.” Politico Europe, 2026 https://www.politico.eu/article/8-in-10-europeans-dont-trust-us-chinese-firms-with-data/

El texto pone de relieve una paradoja central del ecosistema digital europeo: una profunda desconfianza hacia actores externos que, sin embargo, siguen siendo esenciales en la infraestructura tecnológica cotidiana. Esta tensión entre dependencia y desconfianza define uno de los grandes retos de Europa en el ámbito digital: cómo garantizar la protección de los datos y la autonomía tecnológica sin quedar rezagada en la competencia global.

Se analiza los resultados de una encuesta reciente —el estudio European Pulse Forum, impulsado por Politico junto a la consultora BeBartlet— que revela un dato contundente: más de ocho de cada diez europeos desconfían de las empresas tecnológicas estadounidenses y chinas a la hora de gestionar sus datos personales. Este nivel de desconfianza no es homogéneo, sino que alcanza cifras especialmente elevadas en el caso de China (en torno al 90 % o más) y también muy altas respecto a Estados Unidos (más del 80 %), lo que pone de manifiesto una crisis de confianza generalizada hacia las grandes potencias tecnológicas globales.

El estudio, basado en miles de encuestas realizadas en países clave como Alemania, Francia, España, Italia, Polonia y Bélgica, muestra que la percepción de riesgo está profundamente vinculada a factores geopolíticos y legales. Uno de los principales motivos de esta desconfianza es la creencia de que las empresas de estos países pueden verse obligadas a entregar datos a sus respectivos gobiernos en virtud de sus leyes nacionales de seguridad. Esta posibilidad genera inquietud entre los ciudadanos europeos, que perciben una falta de control sobre el uso final de su información personal, especialmente en contextos donde la vigilancia estatal o el acceso gubernamental a datos privados es una preocupación creciente.

En contraste, las empresas tecnológicas europeas generan un nivel de confianza relativamente mayor, aunque no mayoritario: aproximadamente la mitad de los encuestados afirma confiar en ellas. También los gobiernos nacionales obtienen niveles de confianza moderados, lo que sugiere que, aunque existe una preferencia por lo “propio”, esta no implica una confianza plena. Este matiz es importante porque indica que el problema no es únicamente externo (EE. UU. o China), sino que forma parte de una preocupación más amplia sobre la privacidad, el control de los datos y la transparencia en la era digital.

El contexto normativo europeo desempeña un papel clave en esta percepción. La Unión Europea cuenta con uno de los marcos regulatorios más estrictos del mundo en materia de protección de datos, encabezado por el Reglamento General de Protección de Datos (GDPR). Este sistema no solo establece altos estándares para las empresas europeas, sino que también obliga a las compañías extranjeras a cumplirlos si operan con datos de ciudadanos europeos. Sin embargo, la coexistencia de estas normas con legislaciones nacionales de terceros países genera tensiones legales y dudas sobre su efectividad real, especialmente cuando entran en conflicto con leyes de seguridad nacional fuera de la UE.

El artículo también sugiere que esta desconfianza tiene implicaciones estratégicas profundas. En particular, refuerza el impulso europeo hacia la llamada “soberanía digital”, es decir, la necesidad de desarrollar infraestructuras tecnológicas propias en ámbitos como la computación en la nube, la inteligencia artificial o las telecomunicaciones. La dependencia actual de proveedores estadounidenses —dominantes en el mercado— contrasta con el deseo político y social de reducir esa dependencia, aunque en la práctica este cambio resulta complejo debido a factores económicos, técnicos y de mercado.

IA en salud y la ley: ¿Podría tu médico chatbot testificar en tu contra?

DiBenedetto, Chase. “Health AI and the Law: Could Your Chatbot Doc Testify Against You?” Mashable, 2026. https://mashable.com/article/health-chatbots-ai-privilege-lawsuits

Se aborda un problema emergente en la intersección entre inteligencia artificial y derecho: la falta de protección legal para las conversaciones que los usuarios mantienen con chatbots, especialmente en el ámbito de la salud.

A diferencia de las interacciones con profesionales humanos —como médicos, psicólogos o abogados—, que están protegidas por el llamado “privilegio profesional”, las conversaciones con sistemas de IA no gozan de esa confidencialidad. Esto significa que la información compartida con un chatbot podría ser utilizada como prueba en procesos judiciales, abriendo un escenario preocupante para millones de usuarios que recurren a estas herramientas en busca de orientación médica o emocional.

El texto subraya que el privilegio legal existe para fomentar la sinceridad entre paciente y profesional, ya que esa confianza es esencial para recibir un tratamiento adecuado. Sin embargo, este marco jurídico está diseñado para relaciones humanas, no digitales. En consecuencia, cuando un usuario interactúa con un chatbot —aunque perciba la experiencia como íntima o terapéutica—, en realidad está generando datos que pueden ser almacenados, analizados e incluso compartidos por las empresas tecnológicas. Esta situación genera una paradoja: cuanto más útiles y “humanos” parecen los chatbots, mayor es el riesgo de que los usuarios confíen en ellos sin ser conscientes de las implicaciones legales.

El artículo también conecta este vacío legal con un contexto creciente de litigios relacionados con la inteligencia artificial. Casos recientes han demostrado que los contenidos generados por chatbots pueden ser considerados evidencia en tribunales, ya que no están cubiertos por ninguna forma de secreto profesional. Esto se vuelve especialmente problemático en ámbitos sensibles como la salud mental, donde los usuarios pueden revelar información extremadamente personal o incluso autoincriminatoria. Así, el uso cotidiano de estas herramientas podría tener consecuencias legales inesperadas.

Por último, se plantea un debate más amplio sobre la necesidad de adaptar las leyes a la realidad tecnológica actual. Algunos expertos y desarrolladores sostienen que debería reconocerse algún tipo de privilegio para las interacciones con IA, especialmente en contextos sanitarios, mientras que otros advierten de los riesgos de equiparar máquinas con profesionales humanos. En cualquier caso, el artículo concluye que la expansión de los chatbots en el ámbito de la salud está adelantándose a la regulación, lo que probablemente dará lugar a nuevos conflictos legales y a una redefinición de los límites entre privacidad, tecnología y responsabilidad.

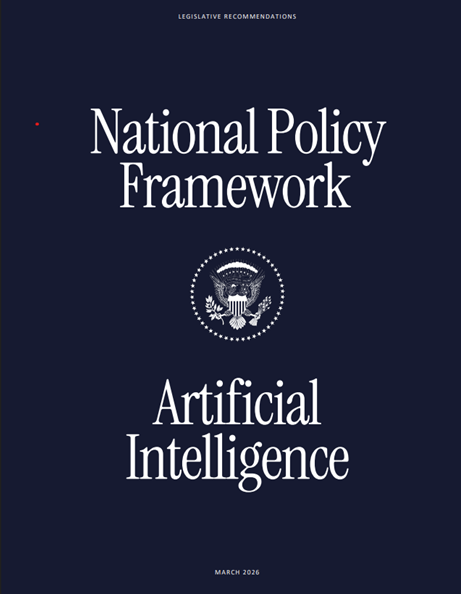
La Casa Blanca publica el Marco de Política Nacional para la IA

Campbell, Rhea Kelly. “White House Releases National Policy Framework for AI.” Campus Technology, 23 de marzo de 2026. https://campustechnology.com/articles/2026/03/23/white-house-releases-national-policy-framework-for-ai.aspx

La iniciativa surge en un contexto marcado por la proliferación de leyes estatales y la preocupación por la fragmentación normativa, que, según el gobierno federal, podría obstaculizar la innovación y debilitar la competitividad del país en el desarrollo de tecnologías emergentes.

El documento propone una serie de líneas estratégicas centradas en equilibrar el impulso tecnológico con la protección social. Entre sus ejes principales destacan la seguridad infantil en entornos digitales, la defensa de los derechos de propiedad intelectual, la protección de los consumidores frente a fraudes y riesgos derivados de la IA, así como la promoción de la libertad de expresión en sistemas automatizados. Asimismo, el marco apuesta por el desarrollo de la fuerza laboral en inteligencia artificial y por la eliminación de barreras regulatorias que puedan frenar la innovación.

Uno de los aspectos más relevantes —y también más controvertidos— es la intención de establecer la primacía de la regulación federal sobre las normativas estatales. El marco recomienda que el Congreso limite la capacidad de los estados para imponer sus propias reglas cuando estas se consideren una carga excesiva, con el objetivo de evitar un “mosaico regulatorio” y sustituirlo por un estándar nacional coherente. No obstante, se contempla que los estados mantengan competencias en ámbitos tradicionales como la protección del consumidor, la lucha contra el fraude o determinadas políticas públicas locales.

El artículo también subraya que este marco no tiene carácter vinculante, sino que constituye una propuesta política que requiere desarrollo legislativo para materializarse. En este sentido, refleja tanto la ambición del gobierno por liderar globalmente la inteligencia artificial como las dificultades políticas internas para alcanzar consensos, especialmente en cuestiones como la regulación de contenidos, los derechos de autor o el grado de intervención estatal.

En conjunto, el texto sitúa este marco como un paso clave hacia una gobernanza más estructurada de la inteligencia artificial en Estados Unidos, pero también como un punto de partida en un debate más amplio sobre cómo regular una tecnología en rápida evolución sin frenar su potencial económico y estratégico.

El plan describe seis principios rectores:

  • Los servicios y plataformas de inteligencia artificial deben adoptar medidas para proteger a los menores, al tiempo que capacitan a los padres para controlar el entorno digital y la educación de sus hijos.
  • El desarrollo de la inteligencia artificial, incluida la construcción de infraestructuras de datos, debe fortalecer a las comunidades estadounidenses y a las pequeñas empresas mediante el crecimiento económico y el liderazgo energético, garantizando al mismo tiempo que dichas comunidades estén protegidas frente a impactos perjudiciales.
  • Los creadores, editores e innovadores estadounidenses deben estar protegidos frente a contenidos generados por inteligencia artificial que infrinjan sus derechos, sin menoscabar la innovación legítima ni la libertad de expresión.
  • El gobierno federal debe defender la libertad de expresión y las protecciones de la Primera Enmienda, evitando al mismo tiempo que los sistemas de inteligencia artificial se utilicen para silenciar o censurar la expresión política o el disenso legítimos.
  • Estados Unidos debe liderar el mundo en inteligencia artificial eliminando barreras a la innovación, acelerando la adopción de aplicaciones de IA en distintos sectores y garantizando un acceso amplio a los entornos de prueba necesarios para desarrollar sistemas de IA de primer nivel.
  • Los trabajadores estadounidenses deben beneficiarse del crecimiento impulsado por la inteligencia artificial, y no solo de los resultados de su desarrollo, mediante la formación de los jóvenes, la capacitación en habilidades, la creación de nuevos empleos en una economía impulsada por la IA y la ampliación de oportunidades en distintos sectores.
  • El gobierno federal debe establecer un marco nacional de políticas de inteligencia artificial que proteja los derechos de los ciudadanos, fomente la innovación y evite una fragmentación regulatoria entre estados que perjudique la competitividad nacional, respetando al mismo tiempo el federalismo y los derechos de los estados.

¿Quién posee el conocimiento? Copyright, IA Generativa y el futuro de la publicación académica

Kochetkov, Dmitry. 2025. “Who Owns the Knowledge? Copyright, GenAI, and the Future of Academic Publishing.” arXiv, noviembre 24, 2025. https://doi.org/10.48550/arXiv.2511.21755

El documento aborda el impacto profundo y multifacético de la inteligencia artificial generativa (GenAI) y los grandes modelos de lenguaje (LLMs) en la investigación científica y el sistema de publicación académica. Las capacidades de estas tecnologías, señala el autor, representan un cambio de paradigma que ofrece oportunidades revolucionarias para acelerar descubrimiento, análisis y difusión del conocimiento, pero al mismo tiempo plantea desafíos éticos, legales y regulatorios significativos que no han sido adecuadamente resueltos por los marcos jurídicos existentes en las principales jurisdicciones del mundo.

Un foco central del análisis es el reto que GenAI plantea para las leyes de copyright tradicionales y para los principios de la ciencia abierta. Kochetkov argumenta que las normativas actuales en países como Estados Unidos, China, la Unión Europea y el Reino Unido, aunque pretenden fomentar la innovación, dejan vacíos importantes específicamente en relación con el uso de obras protegidas por derechos de autor y de resultados de ciencia abierta para entrenar modelos de IA. Es decir, las normas pensadas para regular la reutilización humana de contenidos no cubren adecuadamente la ingestión masiva de textos científicos por parte de algoritmos de aprendizaje automático.

El autor también discute las limitaciones de los mecanismos de licencia existentes, incluyendo las licencias de acceso abierto como las de Creative Commons. Aunque estas licencias han sido útiles para permitir la reutilización y difusión entre personas, no están diseñadas para regular el entrenamiento de GenAI, que implica procesamiento de datos a gran escala y sin intervención humana directa. Esto se traduce, según el artículo, en una falta de atribución y reconocimiento de la autoría real de los contenidos, lo cual socava nociones académicas fundamentales de originalidad, crédito y responsabilidad intelectual.

Frente a esto, Kochetkov propone una crítica al uso automático de figuras legales como la “excepción de uso justo” (“fair use”) en Estados Unidos para justificar el entrenamiento de modelos de IA con textos académicos. En su análisis, depender de este enfoque es problemático porque no respeta suficientemente los derechos de los creadores originales —especialmente cuando los modelos son desarrollados o explotados comercialmente o cuando producen derivados opacos sin atribución clara— y podría favorecer la consolidación de mercados oligopólicos donde prevalecen intereses comerciales sobre la integridad científica y la equidad en la producción de conocimiento.

Como alternativa, el autor aboga por que los autores mantengan derechos explícitos para rechazar el uso de sus obras en procesos de entrenamiento de IA, independientemente de la doctrina de uso justo, y que las universidades jueguen un papel más activo en la gobernanza responsable de IA. Las instituciones académicas, sostiene, están en una posición única para desarrollar políticas internas que reflejen los valores de integridad científica, transparencia y justicia epistémica, negociando derechos que incluyan cláusulas específicas sobre IA.

Finalmente, Kochetkov llama a un esfuerzo legislativo internacional armonizado que pueda integrar coherentemente derechos de autor, ciencia abierta y el uso de GenAI en la investigación académica. Una regulación coordinada a nivel global ayudaría a proteger la propiedad intelectual, garantizar transparencia en los datos de entrenamiento, y evitar que la infraestructura de conocimiento científico quede dominada por intereses comerciales en detrimento del acceso equitativo y la integridad de la producción académica.

En conjunto, el artículo plantea que la revolución de la IA en la ciencia requiere no solo innovación tecnológica, sino también reformas profundas en las políticas de derechos de autor, licencias abiertas y gobernanza institucional, para asegurar que la transformación digital refuerce —y no erosione— los principios fundamentales de la investigación científica y la difusión del saber.