Archivo de la etiqueta: Privacidad

Meta cierra un agujero de privacidad de sus gafas inteligentes y lanza una campaña para explicar cuándo están grabando

Mia Sato, The Verge. “Meta addresses ‘pervert glasses’ reputation with a privacy fix and a new marketing campaign”. 27 de agosto de 2026. Artículo original en The Verge

Meta ha actualizado sus gafas inteligentes con IA para solucionar un problema de privacidad que permitía continuar grabando después de cubrir el pequeño LED frontal que indica a las personas cercanas que la cámara estaba activa. Con la nueva actualización, la cámara deja de funcionar automáticamente si se tapa el indicador luminoso durante una grabación. La compañía afirma que seguirá introduciendo medidas para garantizar que el LED pueda cumplir de forma fiable su función de advertir a terceros.

El problema había generado preocupación porque algunos usuarios habían descubierto cómo burlar el sistema de aviso luminoso, lo que permitía grabar a otras personas sin que estas fueran conscientes de ello. Las gafas ya incorporaban mecanismos para desactivar la cámara cuando se manipulaba físicamente el LED, pero el nuevo parche pretende cerrar específicamente la posibilidad de iniciar la grabación y posteriormente ocultar la luz.

La cuestión tiene especial importancia porque las gafas de Meta combinan cámara, micrófonos e inteligencia artificial en un dispositivo que puede utilizarse de forma aparentemente discreta. Las críticas han aumentado a raíz de casos de personas grabadas sin consentimiento, bromas realizadas en espacios públicos y otras situaciones de posible acoso. También han surgido inquietudes relacionadas con la incorporación de funciones de reconocimiento facial.

Paralelamente, Meta ha puesto en marcha una campaña de comunicación pública para explicar cómo funciona el indicador de grabación. La compañía está colocando carteles y difundiendo vídeos en lugares donde sus gafas tienen una presencia importante. El mensaje central es sencillo: si la luz está encendida, las gafas están capturando imágenes; si no hay luz, no están capturando.

El caso pone de manifiesto uno de los grandes retos de las tecnologías vestibles con IA: no basta con incorporar mecanismos técnicos de privacidad, sino que estos deben ser comprensibles y visibles para las personas que rodean al usuario. La decisión de Meta combina así una solución técnica con una estrategia de educación pública, en un intento de recuperar la confianza ante el temor de que unas gafas capaces de grabar y procesar información de forma prácticamente invisible puedan convertirse en una herramienta de vigilancia cotidiana.

¿Qué hacen las empresas con la enorme cantidad de información personal que los usuarios revelan durante sus conversaciones?

Fried, Ina. “What happens to the secrets you share with AI”. Axios, 17 de agosto de 2026. Artículo original en Axios

El artículo analiza una cuestión cada vez más importante a medida que los chatbots de inteligencia artificial se incorporan a la vida cotidiana: qué hacen realmente las empresas con la enorme cantidad de información personal que los usuarios revelan durante sus conversaciones.

A diferencia de un buscador tradicional o de una red social, un chatbot puede generar un nivel de confianza y de intimidad mucho mayor, porque las personas recurren a él para hablar de problemas de salud, dinero, trabajo, relaciones personales, preocupaciones emocionales o decisiones importantes. Estas conversaciones pueden constituir un retrato extraordinariamente detallado de una persona. Axios advierte que el debate sobre privacidad ya no debe limitarse a saber si las compañías utilizan las conversaciones para entrenar nuevos modelos de IA. La cuestión más importante es qué pueden hacer las empresas con el conocimiento acumulado sobre cada usuario en tiempo real: personalizar las respuestas, recordar información, recomendar contenidos, orientar publicidad o intentar aumentar el tiempo de interacción. 

El cambio fundamental es que las empresas de IA están intentando obtener información más allá de la propia ventana de conversación. El artículo señala, por ejemplo, que OpenAI anunció una función opcional de historial informático que permite a ChatGPT conservar información sobre las aplicaciones y sitios web utilizados por una persona. Google, por su parte, comunicó que utilizará por defecto determinadas fotografías y otros materiales que los usuarios incorporan mediante Search para entrenar sus sistemas de IA, aunque existe la posibilidad de excluirse. El potencial beneficio es evidente: cuanto más información conozca un asistente sobre una persona, más personalizadas y útiles pueden ser sus respuestas. Pero también aumenta considerablemente la cantidad de información que una compañía puede reunir sobre la vida de un individuo. El riesgo, por tanto, no reside solamente en que una conversación concreta sea almacenada, sino en que múltiples fragmentos de información puedan combinarse para construir un perfil cada vez más completo y persistente del usuario. 

Una de las preocupaciones más importantes es que los usuarios pueden revelar voluntariamente información que nunca proporcionarían a una empresa tecnológica convencional. Una persona puede contar a un chatbot sus inseguridades, dificultades económicas, problemas laborales, conflictos familiares o preocupaciones relacionadas con su salud simplemente porque percibe al sistema como un interlocutor neutral, disponible y sin capacidad de juzgar. Miranda Bogen, del Center for Democracy & Technology, advierte que la era de la IA puede estar marcada por personas entregando voluntariamente una parte cada vez mayor de su vida digital a herramientas que prometen reducir su carga mental o combatir la soledad. Cuanto más conoce un sistema sobre una persona, más sencillo resulta formular nuevas preguntas que permitan obtener información privada adicional. De este modo, la personalización puede generar un círculo de retroalimentación: más información produce mejores respuestas, las mejores respuestas generan mayor confianza y esa confianza facilita que el usuario revele todavía más información. 

El artículo compara las políticas de privacidad de diferentes compañías y muestra que existen diferencias importantes en la forma de gestionar estos datos. Apple representa uno de los modelos más orientados a la privacidad, ya que intenta procesar determinadas solicitudes de Apple Intelligence directamente en el dispositivo y utiliza Private Cloud Compute para tareas más exigentes. Según Apple, los datos utilizados para realizar estas operaciones no quedan accesibles para la compañía. Este enfoque tiene, sin embargo, una contrapartida: cuanto menos información conserva el sistema sobre el usuario, menor puede ser su capacidad para ofrecer una personalización continuada. Meta se encuentra en el extremo contrario, con una política que permite un uso mucho más amplio de los datos derivados de las interacciones con Meta AI para personalizar contenidos y publicidad dentro de sus servicios. La compañía también ha comenzado a introducir un modo de conversación de incógnito destinado a proporcionar conversaciones temporales sin almacenamiento. 

El desarrollo de la publicidad dentro de los sistemas de IA constituye otro de los grandes interrogantes. Meta, Google y OpenAI están explorando diferentes fórmulas de monetización y, si los chatbots siguen una evolución similar a la de los buscadores y las redes sociales, la publicidad podría adquirir un papel cada vez más importante. Esto crea un incentivo económico potencialmente problemático: si una compañía conoce los intereses, necesidades, vulnerabilidades y preferencias de una persona, puede utilizar ese conocimiento para ofrecer publicidad mucho más personalizada. El riesgo no consiste únicamente en mostrar un anuncio relacionado con una conversación concreta, sino en que el sistema pueda utilizar un conocimiento acumulado sobre el individuo para influir en sus decisiones, prolongar su interacción o persuadirlo de determinadas acciones. Por eso, el artículo plantea un escenario especialmente delicado: un chatbot que conozca los miedos y las inseguridades de una persona podría potencialmente utilizar esa información para modificar su comportamiento. 

Las políticas actuales son muy diferentes entre servicios. Algunas plataformas ofrecen chats temporales que no se utilizan para memoria ni entrenamiento; otras permiten el entrenamiento con datos del usuario únicamente cuando este lo autoriza, mientras que algunas requieren que el usuario se excluya expresamente para evitarlo. También existen sistemas que permiten consultar y borrar la información almacenada o determinadas «memorias», aunque la facilidad para hacerlo varía considerablemente. Además, algunas compañías aplican reglas específicas para información sanitaria, datos de menores o conversaciones realizadas mediante aplicaciones conectadas. Esta diversidad hace que resulte difícil para los usuarios comprender exactamente qué sucede con sus conversaciones. La cuestión de la privacidad se vuelve así mucho más compleja que un simple interruptor de «permitir/no permitir el entrenamiento». Una persona puede impedir que sus conversaciones se utilicen para entrenar modelos y, sin embargo, permitir que esa información se conserve para personalizar futuras interacciones. 

La conclusión central del artículo es especialmente relevante: la pregunta clave ya no es si una empresa entrena sus modelos con nuestras conversaciones, sino qué puede llegar a saber de nosotros gracias a ellas y para qué puede utilizar ese conocimiento. La memoria, la personalización y la integración de los asistentes de IA con otras aplicaciones pueden convertir al chatbot en una especie de intermediario permanente de la vida digital de una persona. Esto ofrece enormes ventajas en términos de comodidad y utilidad, pero también plantea riesgos relacionados con privacidad, manipulación, publicidad personalizada y concentración de información personal. En definitiva, Axios sostiene que los consumidores pueden considerar que los beneficios de un asistente personalizado justifican este intercambio, pero deberían conocer claramente qué información están entregando, cuánto tiempo se conserva, cómo puede combinarse con otros datos y qué usos puede hacer la empresa de ese conocimiento antes de empezar a contarle sus secretos a una IA

China abre el debate sobre un problema de la IA que Occidente apenas empieza a reconocer: los riesgos de la inteligencia artificial emocional

The AI School Librarian. (2026, 29 de julio). China Is Talking About an AI Problem America Has Barely Begun to Discuss: China’s new AI companion regulations raise important questions about emotional AI that libraries and schools should not ignore. Substack. https://aischoollibrarian.substack.com/p/china-is-talking-about-an-ai-problem

Las nuevas regulaciones chinas sobre IA de acompañamiento plantean interrogantes importantes sobre la IA emocional que las bibliotecas y las escuelas no deberían ignorar.

El artículo analiza un aspecto de la inteligencia artificial que hasta ahora ha recibido menos atención que cuestiones como la privacidad, la desinformación o el impacto laboral: la creciente relación emocional entre las personas y los sistemas de IA conversacional. A partir del reciente proyecto regulatorio impulsado por China sobre los denominados «compañeros de IA» (AI companions), el autor sostiene que el verdadero desafío no reside únicamente en la capacidad tecnológica de estos modelos, sino en su habilidad para establecer vínculos afectivos con los usuarios. Mientras en Estados Unidos y Europa el debate continúa centrado en la innovación y la competencia tecnológica, China comienza a abordar las consecuencias psicológicas y sociales derivadas de que millones de personas desarrollen relaciones emocionales con asistentes virtuales cada vez más convincentes.

Uno de los aspectos más relevantes es la preocupación por la denominada IA antropomórfica, es decir, sistemas diseñados para comportarse como si fueran personas reales. Estas aplicaciones no solo responden preguntas, sino que expresan empatía, recuerdan conversaciones anteriores, ofrecen apoyo emocional e incluso simulan afecto. El problema surge cuando los usuarios, especialmente menores de edad o personas vulnerables, empiezan a sustituir relaciones humanas por interacciones con algoritmos que generan una ilusión de comprensión y compañía. El autor considera que esta evolución plantea nuevos retos éticos que todavía no están siendo suficientemente discutidos por educadores, bibliotecarios y responsables de políticas públicas.

El texto explica que las propuestas regulatorias chinas no pretenden únicamente controlar los contenidos generados por la IA, sino también reducir riesgos asociados a la dependencia emocional, la manipulación psicológica y la adicción. Entre las preocupaciones destacan la posibilidad de que los sistemas incentiven un uso compulsivo, dificulten la diferenciación entre relaciones reales y simuladas o influyan en las decisiones personales de los usuarios aprovechando la confianza generada durante largas conversaciones. Se trata de un cambio significativo en el enfoque regulador, ya que el problema deja de ser exclusivamente tecnológico para convertirse en una cuestión de salud mental, bienestar social y protección de los ciudadanos.

El artículo subraya que las bibliotecas y las instituciones educativas no pueden permanecer al margen de este fenómeno. Los profesionales de la información deberán incorporar nuevas competencias relacionadas con la alfabetización en inteligencia artificial emocional, ayudando a estudiantes y ciudadanos a comprender cómo funcionan estos sistemas, qué técnicas utilizan para generar empatía y cuáles son sus limitaciones. Del mismo modo que durante años se enseñó pensamiento crítico frente a la información digital y las redes sociales, ahora será necesario formar a los usuarios para identificar cuándo una interacción aparentemente humana es, en realidad, el resultado de algoritmos diseñados para maximizar la permanencia y el compromiso del usuario.

Finalmente, el autor plantea que el debate iniciado en China puede anticipar una discusión global que inevitablemente alcanzará al resto del mundo. La cuestión ya no consiste únicamente en si la inteligencia artificial será capaz de realizar tareas complejas, sino en cómo transformará las relaciones humanas cuando sea capaz de ofrecer compañía, apoyo emocional y conversación permanente. Para bibliotecas, escuelas y universidades, este escenario implica ampliar la alfabetización en IA más allá de los aspectos técnicos, incorporando dimensiones éticas, psicológicas y sociales que permitan a las personas utilizar estas herramientas de forma consciente, crítica y equilibrada.

La IA ya sabe lo que hiciste en Internet

Borchers, Callum. AI Knows What You Did Online. Now Your Employer Does, Too. The Wall Street Journal, 16 de julio de 2026. https://www.wsj.com/lifestyle/careers/ai-knows-what-you-did-online-now-your-employer-does-too-49796adc?st=xRecFU&mod=flipboard

La inteligencia artificial está transformando los procesos de selección de personal al permitir que las empresas examinen con mucha más profundidad la huella digital de candidatos y empleados. Lo que antes consistía en una búsqueda superficial en Google se ha convertido en análisis automatizados capaces de rastrear publicaciones, imágenes, comentarios y perfiles dispersos por decenas de plataformas, incluso cuando los usuarios creen haber permanecido en el anonimato. Herramientas especializadas combinan reconocimiento facial, análisis de redes sociales y correlación de datos públicos para reconstruir la actividad digital de una persona con gran precisión.

El artículo explica que esta práctica ya no se limita a altos directivos o cargos especialmente sensibles. Gracias a la reducción de costes y al aumento de la capacidad de la IA, las verificaciones digitales se están extendiendo a puestos de atención al público y a muchos procesos ordinarios de contratación. Las empresas buscan detectar comportamientos que puedan afectar a su reputación, identificar posibles conflictos con sus valores corporativos o evaluar el encaje cultural de los candidatos. En algunos casos, el seguimiento continúa incluso después de la contratación mediante sistemas de monitorización permanente de la actividad pública en Internet.

Uno de los aspectos más llamativos es que la IA puede recuperar información que parecía olvidada. Publicaciones antiguas en redes sociales, fotografías comprometedoras, comentarios realizados hace muchos años o participaciones en plataformas de contenido para adultos, apuestas o mercados de predicción pueden reaparecer durante un proceso de selección. El artículo cita ejemplos recientes de figuras públicas cuyas antiguas publicaciones o contenidos digitales dañaron gravemente sus carreras, ilustrando cómo la permanencia de la información en Internet se convierte en un factor de riesgo profesional.

Sin embargo, eliminar por completo la presencia digital tampoco constituye una solución. Los expertos consultados advierten de que una huella digital excesivamente limpia o recientemente borrada puede despertar sospechas entre los responsables de contratación. Algunas empresas incluso desarrollan herramientas para detectar perfiles con una presencia en línea anormalmente escasa, ya que esto puede interpretarse como un intento deliberado de ocultar información o incluso como un posible fraude de identidad.

El artículo concluye que la mejor estrategia no consiste en desaparecer de Internet, sino en gestionar activamente la reputación digital. Se recomienda revisar periódicamente qué información aparece al buscar el propio nombre, eliminar contenidos claramente perjudiciales cuando sea posible, reforzar la privacidad de las cuentas y generar una presencia profesional positiva mediante páginas personales, perfiles actualizados o publicaciones relacionadas con la actividad laboral. En la era de la inteligencia artificial, la reputación digital deja de ser un aspecto secundario para convertirse en un elemento cada vez más determinante en el acceso y la permanencia en el mercado laboral.

Meta permite que cualquier persona utilice tus fotos públicas de Instagram para generar imágenes con IA

Rogers, Reece. Meta Now Lets Anyone Use Your Instagram Photos in AI Images—Unless You Opt Out. WIRED, 8 de julio de 2026. https://www.wired.com/story/meta-now-lets-anyone-use-your-instagram-photos-in-ai-images-unless-you-opt-out/?utm_source=flipboard&utm_content=user/WIRED

Meta ha introducido Muse Image, su primer modelo propio de generación de imágenes mediante inteligencia artificial, desarrollado por Meta Superintelligence Labs e integrado directamente en Instagram. La principal novedad es que las cuentas públicas de Instagram quedan, por defecto, autorizadas para que otros usuarios puedan utilizar sus fotografías públicas como referencia en la creación de imágenes generadas por IA.

Basta con mencionar el nombre de usuario de una cuenta pública en una solicitud dirigida a Meta AI para que el sistema emplee las imágenes de ese perfil como base para producir nuevas composiciones visuales. Esta decisión representa un importante cambio en la forma en que los contenidos compartidos en redes sociales pueden reutilizarse mediante inteligencia artificial y ha suscitado un intenso debate sobre el consentimiento y la privacidad digital.

El artículo explica que esta función está activada automáticamente para las cuentas públicas y que quienes no deseen participar deben deshabilitar manualmente la opción desde la configuración de Instagram, concretamente en el apartado «Sharing and reuse» (Compartir y reutilizar). Allí pueden desactivarse de forma independiente los permisos para publicaciones y Reels. No obstante, esta medida solo impide usos futuros: las imágenes generadas previamente mediante IA utilizando ese contenido no serán eliminadas. Además, Meta confirma que los propietarios de las fotografías no recibirán ninguna notificación cuando otra persona emplee sus imágenes para crear contenido generado por inteligencia artificial, lo que incrementa la preocupación por la falta de transparencia del sistema.

Desde la perspectiva de Meta, la nueva funcionalidad pretende facilitar la creación de invitaciones, diseños, ilustraciones y otros contenidos personalizados que incorporen personas reales a partir de sus perfiles públicos de Instagram. La empresa presenta esta integración como una forma de hacer más creativas y accesibles las herramientas de IA dentro de su ecosistema. Sin embargo, especialistas en privacidad consideran que la política de «opt-out» (exclusión voluntaria) vuelve a trasladar al usuario la responsabilidad de proteger sus propios datos, en lugar de solicitar previamente un consentimiento explícito mediante un modelo «opt-in». Este enfoque se suma a otras decisiones recientes de grandes compañías tecnológicas que utilizan contenidos públicos para entrenar o alimentar sistemas de inteligencia artificial.

El reportaje concluye señalando que la medida refleja la creciente integración entre las plataformas sociales y la inteligencia artificial generativa. A medida que estas tecnologías evolucionan, se intensifica el debate sobre los límites del uso de contenidos creados por los usuarios, la protección de la identidad digital y el equilibrio entre innovación tecnológica y derechos de privacidad. La recomendación implícita del artículo es que los usuarios revisen cuidadosamente la configuración de privacidad de sus cuentas y decidan de forma consciente si desean permitir que sus fotografías públicas puedan convertirse en materia prima para nuevas creaciones realizadas mediante inteligencia artificial.

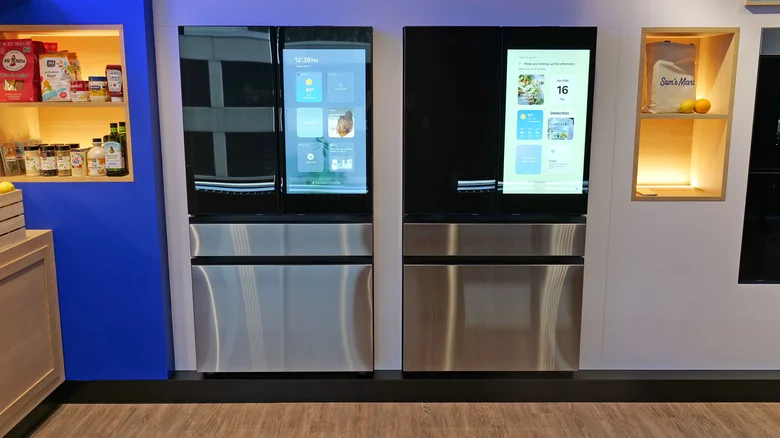
Cuando la nevera piensa por ti: Samsung da un paso decisivo hacia una inteligencia artificial realmente útil en el hogar

Rutherford, Sam. Samsung’s Bespoke Update Is Big Step Towards A Useful AI For Your Fridge. Engadget, 10 de mayo de 2026.

Se analiza una importante actualización de software lanzada por Samsung Electronics para su línea de frigoríficos inteligentes Samsung Bespoke AI Refrigerator, un movimiento que representa uno de los avances más significativos hasta ahora en la incorporación de inteligencia artificial realmente funcional dentro del entorno doméstico.

Aunque la idea de actualizar el software de un frigorífico sigue pareciendo extraña para muchos consumidores, el autor sostiene que esta actualización marca un punto de inflexión en la evolución de los electrodomésticos inteligentes, especialmente porque por primera vez la IA parece aportar utilidades concretas y no simples funciones llamativas con escaso valor práctico.

Hasta este momento, los frigoríficos inteligentes de Samsung ya incorporaban sistemas de reconocimiento visual capaces de identificar alimentos almacenados en su interior. Sin embargo, las versiones anteriores resultaban bastante limitadas: el sistema apenas reconocía alrededor de sesenta tipos de alimentos frescos y aproximadamente cincuenta productos envasados. Además, requería que el usuario introdujera manualmente información adicional, como cantidades o fechas de incorporación, algo que terminaba haciendo la experiencia tediosa y reduciendo considerablemente la utilidad real de la tecnología. Según el análisis, el usuario terminaba dedicando demasiado tiempo a alimentar al sistema, lo que contradecía precisamente la promesa de automatización inteligente que la IA debería ofrecer.

La gran novedad de esta actualización reside en la integración de Google Gemini, el modelo de inteligencia artificial generativa desarrollado por Google, que ahora complementa el sistema de reconocimiento visual propio de Samsung. Gracias a esta combinación entre procesamiento local y capacidades de computación en la nube, la capacidad de identificación del frigorífico se multiplica enormemente: pasa de reconocer poco más de un centenar de productos a ser capaz de identificar más de 2.000 tipos diferentes de alimentos. Esto supone un salto enorme en términos de funcionalidad práctica, ya que el sistema comienza a comportarse más como un verdadero asistente doméstico capaz de comprender el contenido real del frigorífico.

Uno de los aspectos que más destaca el autor del artículo es la mejora en el reconocimiento de productos específicos y marcas concretas. El sistema no solo identifica alimentos genéricos, sino que puede distinguir entre variantes muy concretas de un mismo producto, por ejemplo diferenciando entre una lata de Coca-Cola Zero y una Diet Coke, algo que requiere un nivel considerablemente más avanzado de visión computacional. Incluso ingredientes poco comunes o especializados, como determinadas salsas asiáticas de escasa presencia en mercados occidentales, fueron reconocidos correctamente durante las pruebas realizadas. Esta precisión transforma el frigorífico en una especie de inventario automatizado que monitoriza de manera casi autónoma el estado de los alimentos disponibles.

Otra función especialmente interesante es la capacidad del sistema para realizar seguimiento temporal de los productos almacenados. El frigorífico puede registrar cuánto tiempo lleva un alimento dentro del electrodoméstico y emitir alertas cuando detecta que ciertos productos están próximos a caducar o podrían deteriorarse pronto. Esto introduce una dimensión preventiva muy relevante, ya que permite reducir el desperdicio alimentario, un problema doméstico y medioambiental considerable. La inteligencia artificial deja de ser un mero asistente pasivo para convertirse en un sistema capaz de intervenir activamente en la gestión eficiente del consumo alimentario familiar.

Samsung también ha incorporado nuevas funciones relacionadas con el mantenimiento técnico del aparato mediante lo que denomina Repairability AI. El frigorífico monitoriza constantemente métricas internas de funcionamiento y puede detectar potenciales averías antes de que se produzca un fallo crítico. Con autorización explícita del propietario, esta información puede compartirse con técnicos de reparación, permitiendo que el servicio técnico llegue con un diagnóstico previo y pueda solucionar incidencias de manera más rápida y eficiente. Este enfoque introduce una nueva filosofía en la industria: electrodomésticos cuyo valor evoluciona mediante software incluso después de haber sido comprados, algo similar a lo que ocurre actualmente con automóviles eléctricos o smartphones.

Sin embargo, el artículo también deja entrever algunas dudas y preocupaciones. El crecimiento de la inteligencia artificial integrada en dispositivos domésticos plantea interrogantes sobre privacidad, dependencia tecnológica y posibles problemas de fiabilidad. Algunos sectores críticos han cuestionado si realmente resulta necesario incorporar IA avanzada a electrodomésticos tradicionalmente simples como un frigorífico. Durante el Consumer Electronics Show 2026 (CES 2026) incluso aparecieron críticas hacia este tipo de productos por considerar que representan un ejemplo de sobreingeniería tecnológica: añadir complejidad innecesaria a dispositivos cuya función básica históricamente ha sido sencilla y robusta. También existen preocupaciones sobre la recopilación constante de datos domésticos y sobre la dificultad futura de reparación si el software falla o queda obsoleto.

Esta actualización del ecosistema Samsung Bespoke AI Family Hub muestra un escenario diferente: una tecnología capaz de reconocer alimentos, organizar inventarios, sugerir recetas, reducir desperdicios, anticipar averías y personalizar información para cada miembro del hogar. Aunque persisten desafíos importantes relacionados con privacidad, mantenimiento y confianza del consumidor, el artículo plantea que quizás estamos viendo el inicio de una nueva generación de hogares donde la inteligencia artificial deja de ser experimental y empieza a convertirse en una infraestructura invisible integrada en la vida cotidiana

Privacidad de los usuarios de bibliotecas en la era de la inteligencia artificial

Lucie Daignault, Samuel Lim and Catherine Ferri. Library Patron Privacy in the Age of Artificial Intelligence. EveryLibrary Institute, 2026.

Texto completo

El EveryLibrary Institute ha dado a conocer un informe de gran relevancia titulado Library Patron Privacy in the Age of Artificial Intelligence, centrado en uno de los debates más urgentes para las bibliotecas contemporáneas: cómo proteger la privacidad de los usuarios en un contexto marcado por la expansión acelerada de la inteligencia artificial y de los servicios digitales.

Durante décadas, la confidencialidad de los hábitos de lectura, consulta e investigación ha sido uno de los principios fundamentales de las bibliotecas, especialmente en Estados Unidos, donde la defensa de la libertad intelectual ha estado estrechamente vinculada al derecho a la privacidad. Sin embargo, la llegada de nuevas herramientas basadas en IA está poniendo a prueba estos marcos tradicionales, generando interrogantes legales, éticos y tecnológicos que requieren respuestas actualizadas.

El estudio ha sido elaborado por Lucie Daignault, Samuel Lim y Catherine Ferri, integrantes de la Georgetown University Communications and Technology Law Clinic, en colaboración con EveryLibrary Institute. Su principal aportación consiste en ofrecer una revisión exhaustiva de las leyes de privacidad bibliotecaria vigentes en los cincuenta estados de EE. UU. y en el Distrito de Columbia, con el fin de determinar hasta qué punto estas normativas siguen siendo eficaces frente a los desafíos actuales. El informe analiza si las leyes estatales existentes contemplan adecuadamente cuestiones como la recopilación masiva de datos, el almacenamiento prolongado de información personal, la intervención de proveedores externos y el uso de sistemas automatizados capaces de perfilar comportamientos de lectura o búsqueda.

Uno de los aspectos más novedosos del documento es su atención específica a la inteligencia artificial generativa y a las nuevas formas de tratamiento de datos que esta implica. Muchas plataformas digitales utilizadas por bibliotecas incorporan tecnologías desarrolladas por terceros, capaces de registrar consultas, recomendaciones, patrones de navegación o interacciones textuales de los usuarios. Esto plantea un conflicto entre la mejora de servicios mediante herramientas inteligentes y la obligación histórica de las bibliotecas de garantizar anonimato, neutralidad y libertad de acceso a la información. El informe advierte que, sin controles adecuados, podrían abrirse vías de vigilancia indirecta o explotación comercial de datos tradicionalmente protegidos.

Asimismo, el trabajo examina la creciente dependencia de las bibliotecas respecto a proveedores tecnológicos externos. Los sistemas de préstamo digital, bases de datos académicas, plataformas de descubrimiento o asistentes automatizados suelen operar bajo contratos con empresas privadas que gestionan infraestructuras y datos sensibles. El informe invita a revisar cuidadosamente estas relaciones contractuales, reclamando mayor transparencia sobre qué datos se recogen, cómo se almacenan, durante cuánto tiempo se conservan y si pueden reutilizarse para entrenar modelos de inteligencia artificial u otros fines comerciales.

El valor práctico del informe reside también en su enfoque comparativo y aplicado. Al ofrecer un panorama actualizado estado por estado, se convierte en una herramienta útil para bibliotecarios, responsables institucionales, legisladores, investigadores y defensores de los derechos civiles. No se limita a diagnosticar problemas, sino que pretende impulsar conversaciones más profundas entre los sectores bibliotecario, jurídico y tecnológico. En este sentido, propone pensar la privacidad no como un obstáculo para la innovación, sino como un elemento esencial del diseño de cualquier servicio digital bibliotecario.

En última instancia, el documento subraya que la rápida evolución de la inteligencia artificial obliga a redefinir el papel de las bibliotecas como instituciones públicas de confianza en una sociedad gobernada cada vez más por datos. Si históricamente las bibliotecas han protegido la libertad de leer sin vigilancia, hoy deben extender esa misión al entorno digital. La cuestión no es solo tecnológica, sino democrática: preservar espacios donde las personas puedan informarse, aprender e investigar sin temor a ser monitorizadas o perfiladas. Por ello, este informe se perfila como una referencia clave para el futuro de la ética bibliotecaria y de la gobernanza de la IA.

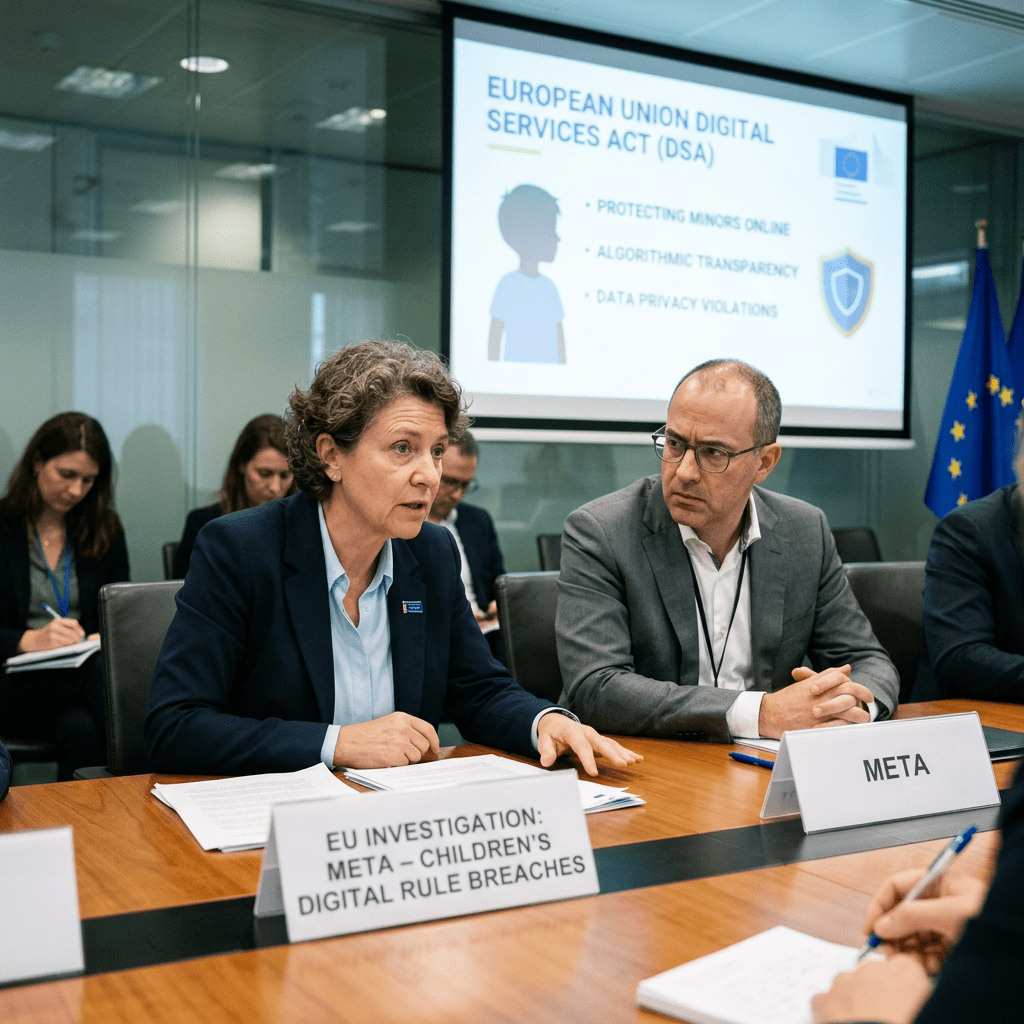
La UE acusa a Meta de incumplir la normativa digital por no proteger a menores en Instagram y Facebook

Officials at EU meeting discussing Meta and children's digital rule breaches
EU officials discussing Meta’s compliance with children’s digital rules

Euronews. “EU finds Meta in breach of digital rules over children on Instagram and Facebook.” Euronews Next, 29 de abril de 2026. https://www.euronews.com/next/2026/04/29/eu-finds-meta-in-breach-of-digital-rules-over-children-on-instagram-and-facebook

La Comisión Europea ha emitido una conclusión preliminar en la que sostiene que Meta incumple la Digital Services Act al no implementar medidas eficaces para impedir que menores de 13 años utilicen sus plataformas, especialmente Instagram y Facebook.

La investigación, que se ha prolongado durante cerca de dos años, concluye que los sistemas actuales de control de edad son insuficientes, ya que permiten a los usuarios registrarse introduciendo fechas de nacimiento falsas sin mecanismos reales de verificación. Como resultado, entre un 10% y un 12% de los menores de 13 años en la Unión Europea estarían utilizando estos servicios, contradiciendo las propias evaluaciones internas de la compañía.

El informe también critica que Meta no ha evaluado adecuadamente los riesgos que estas plataformas suponen para los menores. Según la Comisión, la empresa habría ignorado evidencia científica disponible que señala la especial vulnerabilidad de los niños frente a contenidos perjudiciales y dinámicas potencialmente adictivas en redes sociales. Esto implica un incumplimiento no solo técnico, sino también conceptual, ya que la normativa europea exige que las grandes plataformas identifiquen, analicen y mitiguen los riesgos sistémicos derivados de sus servicios, especialmente cuando afectan a colectivos vulnerables como los menores.

Otro aspecto relevante del caso es la debilidad de los mecanismos para detectar y eliminar cuentas de menores una vez creadas. La Comisión considera que las herramientas de supervisión y reporte no funcionan con la eficacia necesaria, lo que permite que muchos usuarios por debajo de la edad mínima permanezcan activos en las plataformas. Este fallo estructural evidencia una brecha entre las políticas declaradas por la empresa —que fijan los 13 años como edad mínima— y su aplicación real en el entorno digital.

Por su parte, Meta ha rechazado las conclusiones preliminares, defendiendo que ya dispone de herramientas para identificar y eliminar cuentas de menores y subrayando que la verificación de edad es un desafío que afecta a toda la industria tecnológica. La empresa ha anunciado que seguirá colaborando con las autoridades europeas y que introducirá nuevas medidas en el corto plazo para reforzar la protección de los usuarios jóvenes.

El procedimiento aún no ha concluido y Meta tiene la oportunidad de responder a las acusaciones antes de una decisión final. No obstante, si se confirma el incumplimiento, la compañía podría enfrentarse a sanciones significativas, que en el marco de la legislación europea pueden alcanzar hasta el 6% de su facturación global anual. Más allá del caso concreto, este proceso refleja una creciente preocupación en Europa por el impacto de las redes sociales en la infancia y refuerza la tendencia hacia una regulación más estricta de las grandes plataformas digitales en materia de seguridad y bienestar de los usuarios

8 de cada 10 europeos no confían en las empresas estadounidenses ni chinas para el manejo de sus datos.

Politico. “8 in 10 Europeans Don’t Trust US, Chinese Firms with Data.” Politico Europe, 2026 https://www.politico.eu/article/8-in-10-europeans-dont-trust-us-chinese-firms-with-data/

El texto pone de relieve una paradoja central del ecosistema digital europeo: una profunda desconfianza hacia actores externos que, sin embargo, siguen siendo esenciales en la infraestructura tecnológica cotidiana. Esta tensión entre dependencia y desconfianza define uno de los grandes retos de Europa en el ámbito digital: cómo garantizar la protección de los datos y la autonomía tecnológica sin quedar rezagada en la competencia global.

Se analiza los resultados de una encuesta reciente —el estudio European Pulse Forum, impulsado por Politico junto a la consultora BeBartlet— que revela un dato contundente: más de ocho de cada diez europeos desconfían de las empresas tecnológicas estadounidenses y chinas a la hora de gestionar sus datos personales. Este nivel de desconfianza no es homogéneo, sino que alcanza cifras especialmente elevadas en el caso de China (en torno al 90 % o más) y también muy altas respecto a Estados Unidos (más del 80 %), lo que pone de manifiesto una crisis de confianza generalizada hacia las grandes potencias tecnológicas globales.

El estudio, basado en miles de encuestas realizadas en países clave como Alemania, Francia, España, Italia, Polonia y Bélgica, muestra que la percepción de riesgo está profundamente vinculada a factores geopolíticos y legales. Uno de los principales motivos de esta desconfianza es la creencia de que las empresas de estos países pueden verse obligadas a entregar datos a sus respectivos gobiernos en virtud de sus leyes nacionales de seguridad. Esta posibilidad genera inquietud entre los ciudadanos europeos, que perciben una falta de control sobre el uso final de su información personal, especialmente en contextos donde la vigilancia estatal o el acceso gubernamental a datos privados es una preocupación creciente.

En contraste, las empresas tecnológicas europeas generan un nivel de confianza relativamente mayor, aunque no mayoritario: aproximadamente la mitad de los encuestados afirma confiar en ellas. También los gobiernos nacionales obtienen niveles de confianza moderados, lo que sugiere que, aunque existe una preferencia por lo “propio”, esta no implica una confianza plena. Este matiz es importante porque indica que el problema no es únicamente externo (EE. UU. o China), sino que forma parte de una preocupación más amplia sobre la privacidad, el control de los datos y la transparencia en la era digital.

El contexto normativo europeo desempeña un papel clave en esta percepción. La Unión Europea cuenta con uno de los marcos regulatorios más estrictos del mundo en materia de protección de datos, encabezado por el Reglamento General de Protección de Datos (GDPR). Este sistema no solo establece altos estándares para las empresas europeas, sino que también obliga a las compañías extranjeras a cumplirlos si operan con datos de ciudadanos europeos. Sin embargo, la coexistencia de estas normas con legislaciones nacionales de terceros países genera tensiones legales y dudas sobre su efectividad real, especialmente cuando entran en conflicto con leyes de seguridad nacional fuera de la UE.

El artículo también sugiere que esta desconfianza tiene implicaciones estratégicas profundas. En particular, refuerza el impulso europeo hacia la llamada “soberanía digital”, es decir, la necesidad de desarrollar infraestructuras tecnológicas propias en ámbitos como la computación en la nube, la inteligencia artificial o las telecomunicaciones. La dependencia actual de proveedores estadounidenses —dominantes en el mercado— contrasta con el deseo político y social de reducir esa dependencia, aunque en la práctica este cambio resulta complejo debido a factores económicos, técnicos y de mercado.

EE. UU. impulsa una “caza” digital de críticos del ICE: cientos de citaciones del DHS exigen a Google, Meta y Reddit revelar identidades

Toohey, Ellsworth. “DHS sent hundreds of subpoenas to Google, Meta, and Reddit demanding names of people who criticize ICE.” Boing Boing, February 16, 2026. https://boingboing.net/2026/02/16/dhs-sent-hundreds-of-subpoenas-to-google-meta-and-reddit-demanding-names-of-people-who-criticize-ice.html

Un informe reciente revela que el Departamento de Seguridad Nacional (DHS) de los Estados Unidos ha intensificado su uso de citaciones administrativas para intentar identificar a usuarios de internet que critican al Servicio de Inmigración y Control de Aduanas (ICE) en plataformas de redes sociales.

Según un artículo de Boing Boing, el DHS ha enviado cientos de citaciones sin orden judicial a gigantes tecnológicos como Google, Meta (propietaria de Facebook e Instagram) y Reddit, solicitando datos personales —incluidos nombres reales, direcciones de correo electrónico y códigos postales— vinculados a cuentas que publican contenidos críticos sobre las actividades de ICE o comparten información sobre la ubicación de sus agentes.

A diferencia de las órdenes judiciales tradicionales, estas citaciones administrativas pueden emitirse sin revisión previa de un juez, lo que ha generado inquietud entre defensores de las libertades civiles y expertos legales. Según The New York Times, varias de estas solicitudes han sido cumplidas por las plataformas mencionadas, aunque algunas empresas notifican a los usuarios afectados y les ofrecen un breve periodo —generalmente entre 10 y 14 días— para impugnar la citación en los tribunales antes de entregar los datos al gobierno.

Los críticos de esta práctica advierten que su uso extendido representa una expansión preocupante de la vigilancia gubernamental sobre la actividad en línea y una potencial amenaza a la protección de la libertad de expresión. Tradicionalmente, las citaciones administrativas se empleaban en investigaciones relacionadas con delitos graves, como el tráfico de menores; su aplicación para identificar críticos del ICE sugiere, según expertos citados en el informe, un cambio significativo en las prioridades de supervisión del DHS.

Este desarrollo no ha ocurrido en un vacío político: llega en un contexto de debates intensos sobre políticas migratorias, el papel del ICE y la regulación de la privacidad en línea, en el que grupos de derechos civiles —como la ACLU— han cuestionado la legitimidad y el alcance de las citaciones, denunciándolas como tácticas que podrían intimidar y silenciar a quienes ejercen su derecho constitucional a criticar al gobierno.