Archivo de la categoría: Investigación

Repensar la evaluación científica: adecuar el rigor al propósito de la investigación

Ghildiyal, Ashutosh, Mathïs Fédérico y Maria Machado. (2026, 17 de septiembre). “Rethinking Scholarly Evaluation: Matching Rigor to Purpose”. The Scholarly Kitchen. Society for Scholarly Publishing. Enlace al artículo: https://scholarlykitchen.sspnet.org/2026/09/17/rethinking-scholarly-evaluation-matching-rigor-to-purpose/

Se plantea la necesidad de adaptar los criterios de evaluación científica a la naturaleza y los objetivos de cada investigación. Los autores distinguen entre trabajos orientados a validar resultados mediante evidencias empíricas y aquellos que buscan explorar nuevas ideas, formular hipótesis o desarrollar marcos conceptuales. Aunque ambos requieren rigor, no deben evaluarse necesariamente con los mismos criterios.

El texto advierte que una aplicación demasiado uniforme de la revisión por pares puede dificultar el reconocimiento de propuestas innovadoras que cuestionan conocimientos establecidos. Por ello, propone que las revistas científicas definan criterios específicos según el tipo de contribución, sin renunciar a la transparencia, la coherencia argumentativa y la calidad metodológica.

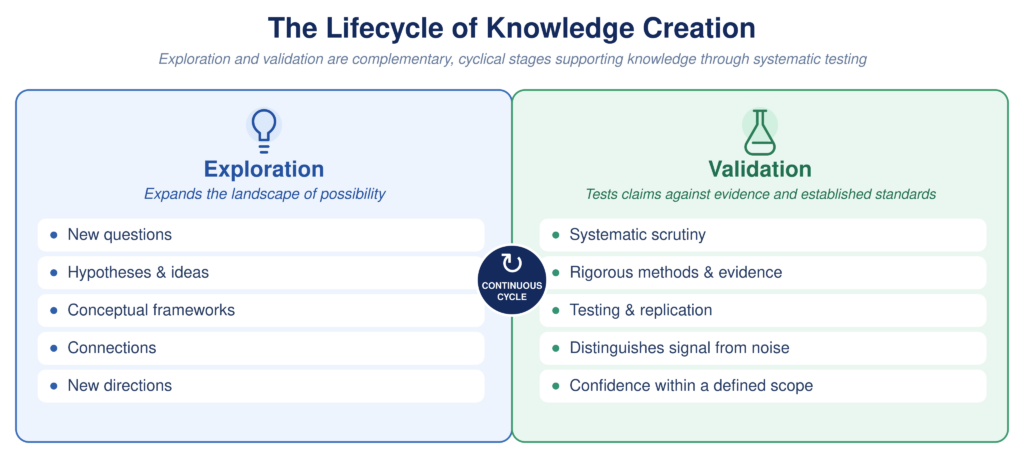
Para comprender esta limitación, el texto distingue dos actividades complementarias: la exploración y la validación. La exploración permite formular nuevas preguntas, desarrollar hipótesis, construir marcos conceptuales y establecer relaciones novedosas entre ideas. La validación, por su parte, somete las afirmaciones a una comprobación sistemática mediante evidencias, métodos adecuados y, cuando corresponde, procedimientos de reproducción de resultados. Ambas actividades son imprescindibles para el progreso científico, pero no persiguen exactamente los mismos objetivos. Por ello, los autores defienden que la evaluación académica debe adaptarse a la naturaleza de cada contribución, sin renunciar a la exigencia de rigor que caracteriza a la investigación científica.

Asimismo, destaca que la inteligencia artificial generativa obliga a prestar mayor atención al valor intelectual de los trabajos, ya que una redacción correcta no garantiza originalidad ni solidez científica. En conclusión, los autores defienden una evaluación más flexible y adaptada a cada investigación, capaz de mantener el rigor académico y, al mismo tiempo, favorecer la innovación y el avance del conocimiento.

TRACE: una iniciativa para mejorar la interoperabilidad y la confianza en la inteligencia artificial aplicada a la comunicación científica

Carpenter, Todd A. (2026, 7 de octubre). “TRACE Project Launches to Advance AI Interoperability”. The Scholarly Kitchen. Society for Scholarly Publishing. Enlace al artículo original: https://scholarlykitchen.sspnet.org/2026/10/07/trace-project-launches-to-advance-ai-interoperability/

TRACE representa un paso hacia una infraestructura científica preparada para la inteligencia artificial. Su éxito dependerá de que los estándares desarrollados sean interoperables, suficientemente flexibles para funcionar con diferentes arquitecturas tecnológicas y adoptados por los principales actores del ecosistema. Aunque la iniciativa no pretende resolver por sí sola todos los problemas relacionados con los derechos de autor, el control de acceso o la atribución dentro de los modelos de IA, sí busca establecer una base común para que la recuperación y reutilización de información científica sean más transparentes, medibles y fiables.

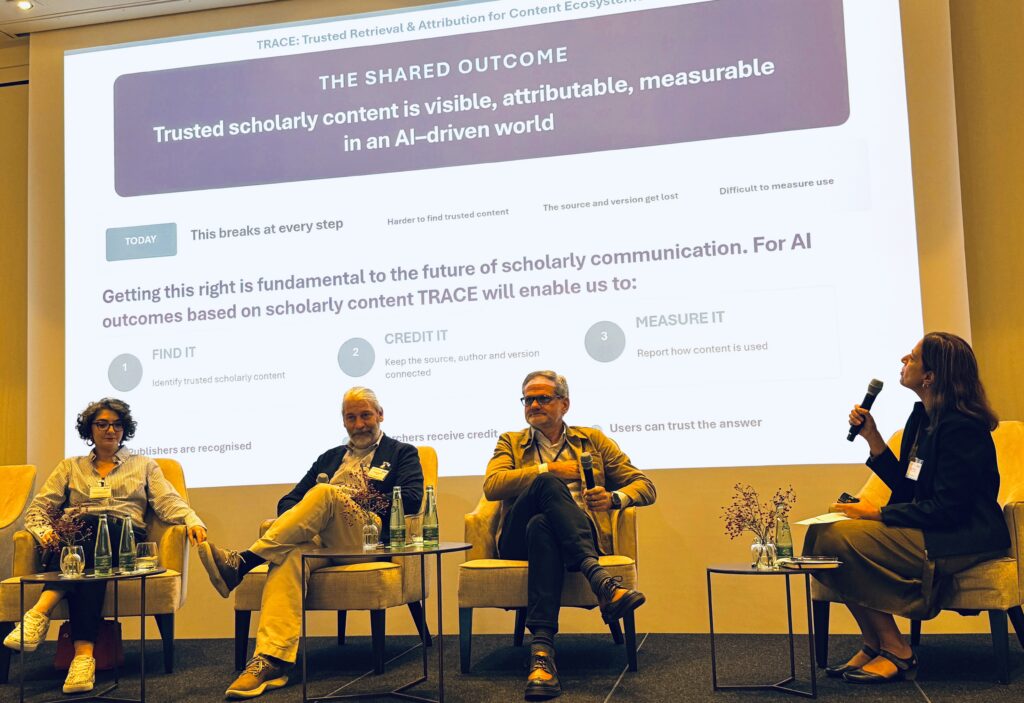
TRACE (Trusted Retrieval & Attribution for Content Ecosystems), una iniciativa internacional impulsada por diferentes organizaciones del ámbito de la comunicación científica para mejorar la interoperabilidad, la transparencia y la fiabilidad de los sistemas de inteligencia artificial que utilizan publicaciones académicas. Su objetivo es desarrollar una infraestructura técnica compartida que permita identificar las fuentes utilizadas por la IA, preservar la atribución de los contenidos y medir de forma coherente cómo los sistemas automatizados acceden a la información científica y la reutilizan. La iniciativa responde a una transformación profunda de la comunicación académica: los investigadores recurren cada vez más a asistentes inteligentes capaces de recuperar, resumir, comparar y sintetizar documentos, sin necesidad de consultar directamente las publicaciones originales.

TRACE comienza con tres líneas de trabajo complementarias. La primera, vinculada a COUNTER, busca mejorar las métricas de uso de los contenidos científicos en entornos de inteligencia artificial, incluyendo las consultas y recuperaciones realizadas por agentes automatizados. La segunda, coordinada por NISO (National Information Standards Organization), se centra en desarrollar un modelo mínimo de metadatos que permita conservar la procedencia de los documentos y fragmentos utilizados por los sistemas de IA. La tercera, impulsada por STM e Ithaka S+R, estudia cómo los agentes de inteligencia artificial descubren las publicaciones científicas, acceden a ellas mediante los permisos correspondientes y registran su utilización de manera verificable.

Uno de los principales problemas que aborda la iniciativa es la dificultad de comprobar el origen de las afirmaciones generadas por la IA. Los modelos pueden producir referencias inexistentes, atribuir información a fuentes equivocadas o elaborar respuestas sin establecer una conexión verificable entre sus afirmaciones y los documentos originales. Para afrontar esta situación, TRACE pretende favorecer el desarrollo de estándares que mantengan vinculados los contenidos recuperados con sus fuentes, sus metadatos y las condiciones de utilización. No se trata únicamente de reducir errores, sino también de reforzar la integridad científica, facilitar la verificación de los resultados y garantizar el reconocimiento del trabajo de autores y editores.

El proyecto también plantea la necesidad de adaptar los sistemas tradicionales de evaluación y gestión de recursos electrónicos a un escenario en el que parte del consumo de información se produce a través de agentes automatizados. Las bibliotecas universitarias y los editores necesitan conocer cómo se utilizan sus colecciones, qué contenidos recuperan los asistentes inteligentes y qué repercusiones tiene este uso en los modelos de suscripción, acceso abierto y financiación de la comunicación científica. Para ello, TRACE promueve una mayor coordinación entre editoriales, repositorios, proveedores tecnológicos, desarrolladores de IA y organizaciones responsables de los estándares de información.

OpenAlex incorpora listas de revistas científicas de confianza para mejorar la evaluación y la búsqueda de publicaciones académicas

Jason. (2026, 15 de octubre). Trusted journal lists come to OpenAlex. OpenAlex Blog. https://blog.openalex.org/trusted-journal-lists-come-to-openalex/

El proyecto OpenAlex anuncia la incorporación de listas de revistas científicas reconocidas por distintas instituciones y organismos especializados, con el propósito de facilitar la identificación y selección de publicaciones académicas fiables. La iniciativa responde a un contexto en el que la integridad de la comunicación científica se enfrenta a problemas crecientes, como las fábricas de artículos (paper mills), las revistas secuestradas, los anillos de citas y la proliferación de manuscritos generados mediante inteligencia artificial. En este escenario, investigadores, bibliotecarios, evaluadores y universidades necesitan herramientas que les permitan identificar las revistas incluidas en repertorios de confianza y aplicar criterios de selección más transparentes a sus búsquedas bibliográficas.

La propuesta de OpenAlex se distancia de las tradicionales listas negras de revistas depredadoras, como la conocida lista de Beall, y apuesta por un modelo basado en listas positivas o listas de inclusión (whitelists o allow lists). En lugar de excluir publicaciones consideradas problemáticas mediante un listado único, permite seleccionar aquellas que figuran en repertorios mantenidos por instituciones especializadas. Este enfoque pretende evitar algunos de los inconvenientes de las listas negras, como la falta de transparencia, su rápida obsolescencia y el riesgo de perjudicar injustamente a revistas pequeñas, emergentes, publicadas en idiomas distintos del inglés o procedentes de países del Sur Global. La idea central es que cada comunidad académica pueda elegir los criterios y las fuentes más adecuados para sus necesidades, sin delegar toda la decisión en un único índice comercial o sistema de clasificación.

Uno de los principales avances de esta iniciativa es su amplitud y diversidad. Según la publicación, OpenAlex ha pasado de las 22 listas iniciales a 61 repertorios de revistas. Entre ellos se encuentran DOAJ, para revistas de acceso abierto; MEDLINE, en ciencias de la salud; ERIH PLUS, en humanidades y ciencias sociales; y los repertorios nacionales de evaluación de Noruega y Finlandia. También se incluyen Latindex, SciELO, Publindex de Colombia, el Núcleo Básico de Argentina y el sello de calidad de la FECYT en España. La presencia de estos recursos permite adaptar las búsquedas a las características de cada disciplina, país o sistema de evaluación.

Desde el punto de vista técnico, OpenAlex incorpora el campo listed_in, que identifica las listas externas en las que figura cada revista. Este dato puede utilizarse tanto desde la interfaz web como mediante la API para filtrar publicaciones, recuperar trabajos publicados en revistas incluidas en determinados repertorios o analizar la distribución de documentos según las listas de referencia. Por ejemplo, un investigador puede limitar una búsqueda a revistas incluidas en DOAJ, mientras que una revisión sistemática en ciencias de la salud puede utilizar MEDLINE. La plataforma también contempla clasificaciones por niveles, como las de Noruega, Finlandia o el sistema JPPS, lo que permite realizar análisis más matizados que una simple distinción entre revistas aceptadas y excluidas.

La iniciativa tiene especial relevancia para las revistas del Sur Global, muchas de las cuales han quedado históricamente al margen de los grandes índices internacionales. La integración de repertorios como Latindex, SciELO y los criterios de evaluación de revistas africanas y de otras regiones contribuye a que estas publicaciones sean más visibles y puedan analizarse en condiciones más equitativas. Además, OpenAlex aclara que incorporar una revista a una lista no equivale a certificar directamente su calidad: la plataforma registra la pertenencia al repertorio y remite a la entidad responsable, que conserva la autoridad sobre sus criterios y evaluaciones.

Esta propuesta constituye un recurso de interés para bibliotecarios, investigadores y responsables de evaluación científica, ya que facilita la selección de fuentes y aporta nuevas posibilidades para estudiar la calidad y la diversidad de la comunicación académica. Para las bibliotecas universitarias, puede resultar especialmente útil en la formación de investigadores, el asesoramiento sobre dónde publicar y el diseño de estrategias de búsqueda bibliográfica. No obstante, figurar en una lista de confianza no debe interpretarse como una garantía absoluta de calidad ni como un sustituto de la evaluación crítica de cada revista y artículo. La principal aportación de OpenAlex es hacer más accesibles y combinables los criterios de distintos repertorios, favoreciendo decisiones documentadas y adaptadas a cada contexto.

Las universidades británicas abandonan Turnitin ante las dudas sobre la privacidad de los datos y la eficacia de sus detectores de IA

Luckhurst, G. (2026, 9 de octubre). More universities end Turnitin contracts as concerns mount. Times Higher Education. https://www.timeshighereducation.com/news/more-universities-end-turnitin-contracts-concerns-mount

Se analiza el creciente distanciamiento de varias universidades británicas respecto a Turnitin, una de las plataformas más extendidas para la detección de similitudes textuales y el apoyo a la integridad académica. Las universidades de Newcastle y Westminster han anunciado que no renovarán sus contratos cuando finalicen sus acuerdos actuales, sumándose a la Universidad de Southampton, que ya había comunicado una decisión similar. Estas medidas reflejan un cambio de actitud hacia herramientas que durante años han ocupado un lugar central en los procedimientos universitarios para detectar el plagio, pero cuya utilidad, coste y condiciones de tratamiento de los datos están siendo objeto de un examen más crítico.

Una de las principales razones de esta controversia son los cambios propuestos por Turnitin en su acuerdo de licencia de usuario final. Las modificaciones suscitaron preocupación porque podían abrir la posibilidad de utilizar trabajos y datos de estudiantes y personal universitario con fines relacionados con la inteligencia artificial. La Universidad de Newcastle ha señalado expresamente sus dudas sobre el posible uso de estos datos, mientras que Southampton decidió iniciar la retirada progresiva del servicio. Tras las críticas de distintas instituciones y organizaciones del sector, Turnitin aplazó la aplicación de los cambios hasta septiembre de 2027 y aceptó dialogar con representantes universitarios para abordar las inquietudes planteadas. La empresa sostiene que actualmente no utiliza los trabajos de los estudiantes para entrenar modelos de inteligencia artificial generativa o grandes modelos de lenguaje (LLM), aunque distingue este supuesto del entrenamiento de clasificadores destinados a identificar textos que probablemente hayan sido generados por IA.

El caso de la Universidad de Westminster introduce una segunda cuestión fundamental: la eficacia real de estas tecnologías frente a las nuevas formas de producción textual. La institución considera que el detector de similitudes tradicional resulta poco eficaz ante uno de los principales desafíos actuales para la integridad académica: los trabajos elaborados mediante inteligencia artificial generativa. Asimismo, cuestiona la fiabilidad de los detectores de IA, puesto que sus resultados son probabilísticos y pueden producir falsos positivos. Esto significa que un texto redactado por una persona podría ser señalado erróneamente como generado por IA. La controversia pone de manifiesto una limitación esencial de estos sistemas: la detección automática no constituye una prueba concluyente de fraude académico y sus resultados deben interpretarse con prudencia, atendiendo al contexto y a otras evidencias disponibles.

El factor económico también desempeña un papel importante en las decisiones de las universidades. Según los datos recogidos por el artículo, la Universidad de Southampton pagó 87.621 libras esterlinas por los servicios de Turnitin entre septiembre de 2024 y septiembre de 2025, mientras que la Universidad de East Anglia desembolsó 50.892 libras durante el periodo comprendido entre abril de 2024 y marzo de 2025. Aunque estos importes corresponden a instituciones de distinto tamaño y no permiten establecer una comparación directa de costes por estudiante, ilustran la dimensión presupuestaria de estos contratos. Algunos especialistas consideran que la preocupación por la privacidad y la inteligencia artificial es legítima, pero que también puede estar favoreciendo una revisión más amplia del gasto en plataformas educativas. Las universidades se preguntan si necesitan contratar un paquete completo de servicios cuando sus entornos virtuales de aprendizaje ya permiten gestionar entregas, calificaciones y comentarios, y pueden complementarse con herramientas alternativas de comprobación de originalidad.

La situación, sin embargo, no representa todavía un abandono generalizado de Turnitin. Algunas instituciones continúan utilizando la plataforma mientras revisan sus condiciones contractuales y estudian otras soluciones. La Universidad de Cambridge, por ejemplo, ha manifestado que no aceptará cambios en el acuerdo que afecten a la privacidad de los datos o a la propiedad intelectual, aunque mantiene el servicio por el momento. Aberdeen está revisando su utilización, mientras que otras universidades exploran alternativas para gestionar la entrega y evaluación de trabajos académicos. El debate se extiende así más allá de la elección de un programa concreto y alcanza cuestiones estratégicas relacionadas con la contratación tecnológica, la protección de la información y la autonomía institucional.

La expansión de la inteligencia artificial generativa está obligando a las universidades a reconsiderar sus mecanismos tradicionales de control de la integridad académica. La decisión de abandonar Turnitin no responde exclusivamente a las dudas sobre el uso de los datos estudiantiles: también intervienen el precio de las licencias, las limitaciones de los detectores y la necesidad de revisar los métodos de evaluación. Algunos especialistas proponen replantear el diseño de las actividades académicas, en lugar de confiar principalmente en herramientas automáticas para identificar posibles irregularidades. Desde esta perspectiva, resulta más adecuado combinar normas transparentes sobre el uso de la IA, evaluación crítica de los trabajos, seguimiento del proceso de aprendizaje y conversaciones pedagógicas con el alumnado. La cuestión central ya no es solamente cómo detectar textos generados por inteligencia artificial, sino cómo garantizar una evaluación justa, proteger los derechos de los estudiantes y promover una cultura de integridad académica adaptada a las nuevas tecnologías.

Inteligencia humana en tiempos de inteligencia artificial: Reflexiones pedagógicas

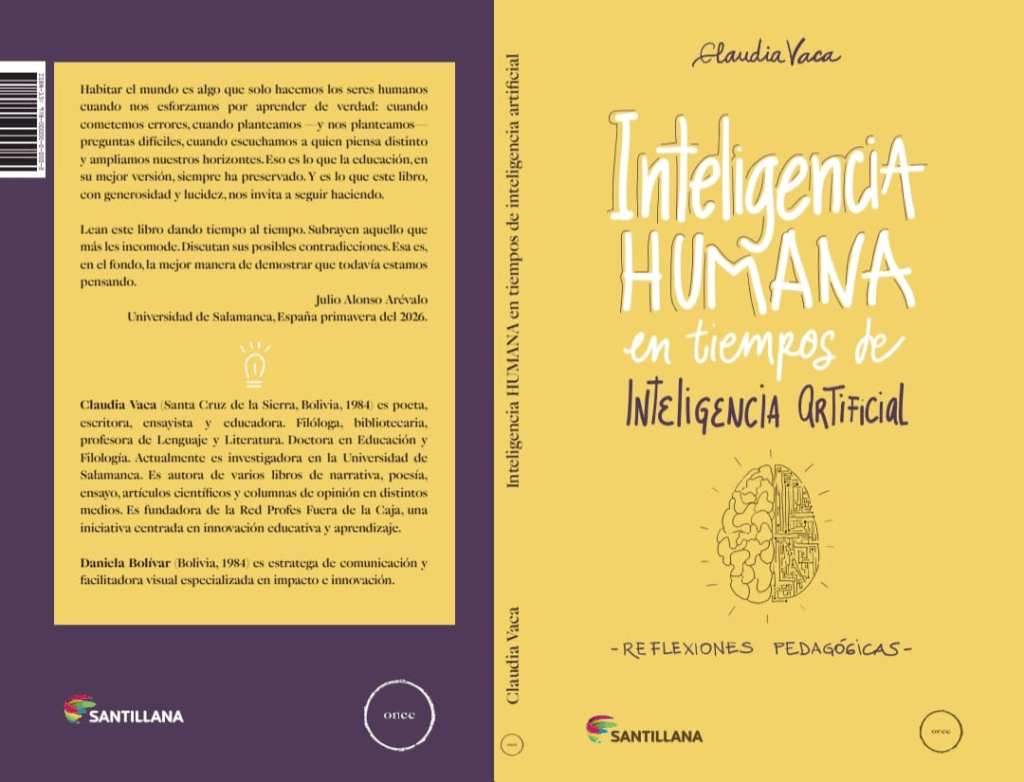
Vaca, Claudia. Inteligencia humana en tiempos de inteligencia artificial: Reflexiones pedagógicas. Madrid: Santillana, 2026.

Adquirir en Amazon

PRÓLOGO Pensar todavía por Julio Alonso Arévalo

Este libro surgió de una incomodidad. No de la incomodidad fácil, la que se puede resolver con una búsqueda en Internet que da con un texto generado en décimas de segundo, sino de la otra incomodidad, la que se instala cuando uno tiene la percepción de que algo importante está cambiando y no sabe del todo bien cómo poder nombrarlo. Claudia Vaca lo nombra. Y al nombrarlo, nos devuelve algo que es probable que habíamos comenzado a perder, sin percibirlo: la posibilidad de pararse a pensar lo que nos está sucediendo.

Vivimos en momentos de respuestas instantáneas; se enuncian preguntas y casi con inmediatez asoman respuestas -porque la apariencia es prácticamente eso-, respuestas fluidas, que pueden dar la impresión de ser respuestas eficaces, coherentes y bien escritas. Y sin embargo, es en eso mismo en donde algo está el problema. Pero contra esa misma respuesta existe un recorrido de la que no puede decirse que hubo un recorrido en este caso, no hay respuesta a esta pregunta e incluso puede llegarse a la conclusión de que se puede hacer algo que no se ha hecho, es como leer el final de un relato sin haberse dejado llevar por la magia de la construcción de la propia historia. La forma está, pero la experiencia -lo que llena, lo que deja huella- ha desaparecido.

La cuestión que plantea este libro no es si la inteligencia artificial es buena o mala. Esa pregunta, aunque legítima, nos desvía de una más urgente: ¿Qué le pasa al pensamiento humano cuando se encuentra en un entorno donde pensar no es necesario? No, no es una cuestión técnica. Es una pregunta profundamente humana, ya que tiene que ver con la educación, con el lenguaje, con la manera que tenemos de relacionarnos con el conocimiento y con los demás.

En cierta ocasión, en algún momento de esta lectura, uno tiene la impresión de que Claudia habla de los estudiantes, de las aulas, pero también, y sobre todo, de todos nosotros. De la manera que consultamos antes de preguntar, de cómo evitamos el esfuerzo de buscar algo porque ya hay algo que ha buscado por nosotros, de cómo leer un texto largo se ha convertido, para muchos, en un acto casi heroico en el contexto de una cultura que «premia» la brevedad y la velocidad. El sedentarismo cognitivo no es un tema exclusivamente de los más jóvenes: es el aire que casi todos respiramos.

* * *

Uno de los valores más apreciados y sinceros de este libro es que no propone una solución simple. No dice “Deja ya de utilizar la IA; para que las cosas empiecen a funcionar”; tampoco dice lo contrario “Usa la tecnología conscientemente”, como si eso fuera la solución única. Lo que propone es más sencillo, aunque también más real: replantéate el significado de aprender, en que consiste entender y qué es lo que desaprovechamos y perdemos cuando delegamos en una herramienta la creación de un texto.

Esta es precisamente una de las claves que encontramos a lo largo del libro —la distinción entre un texto escrito en función del entrenamiento de una herramienta con millones de textos basado en probabilidades estadísticas y crear un contenido a través del lenguaje y el pensamiento-. Esta distinción es bien tenida en cuenta por los que se dedican a la docencia: ellos saben que algunos alumnos presentan trabajos impecables sin haber comprendido nada, y otros alumnos que presentan trabajos que aunque contengan errores provienen de personas que han realizado un proceso de aprendizaje, reflexión. La diferencia entre uno y otro no está en el resultado final del texto, si no en el propio proceso. Y el problema que estamos enfrentado con la IA, es en gran medida este mismo: que el proceso creativo con la llegada de esta tecnología se ha vuelto se ha vuelto invisible.

Claudia escribe desde América Latina, y ello importa. No porque los problemas que expone sean exclusivos de esta parte del mundo, sino porque aquí adquieren texturas específicas. La brecha digital no es solo una brecha de acceso: es una brecha de relación con el conocimiento. Y la pregunta en torno a la autonomía intelectual no se puede separar la pregunta sobre la definición de qué es lo que cuenta como “inteligencia”: qué lenguas son importantes, qué saberes tienen cabida en el currículo. En ese horizonte de confluencia entre lo epistémico y lo político, este libro encuentra su propia voz.

En el texto encontramos una determinación razonada que la autora asume como una verdadera convicción: a diferencia de la inteligencia artificial la inteligencia humana no se define por la cantidad de información que utiliza, sino por la capacidad de establecer un sentido. Este proceso no se basa en lo que determina un algoritmo, si no en que el razonamiento proviene de la experiencia adquirida por la propia memoria humana, de la memoria biográfica y bibliográfica, de la posibilidad de cometer y asumir un posible error, y de la responsabilidad ante los demás. Y lamentablemente ninguna de esas cosas puede externalizarse sin que algo se pierda en el camino.

* * *

En el texto un concepto que aparece con importante frecuencia en varios capítulos es “criterio”, término que podríamos calificar como uno de los conceptos claves del libro, y es que, tener criterio es otra cosa muy diferente que tener conocimiento, hay personas que pueden saber muchas cosas, pueden saberlo todo, pero que no tienen criterio, podemos tener todo el conocimiento que existe en el mundo y no saber qué hacer con él, lo que es característico de tener un verdadero criterio es tener capacidad de discernir respecto a lo que se va haciendo; esto es lo que nos convierte en su más profundo sentido en sujetos y no en meros receptores de información.

El libro deja claro que el criterio, no se consuma simplemente proporcionando respuestas. Se enseña formulando las preguntas adecuadas, permitiendo que el posible error se convierta en una parte esencial del aprendizaje y no en una amenaza. Y esto forma parte del proceso de enseñanza y se aprende con estudio, con lectura, con esfuerzo y también con entusiasmo, y lo más importante no es llegar a la meta antes, si no llegar, y en ese proceso aprender y sobre todo llegar comprendiendo. Pero en la llamada actual sociedad del conocimiento y de la satisfacción inmediata la economía de atención parece cada vez más irrelevante.

Claudia cita una frase de Neil Postman que es especialmente pertinente: «La cuestión no es si las máquinas pueden pensar; la cuestión es si las personas aún lo hacemos». No forma parte de una simple cuestión retórica. Es una pregunta pertinente, que no tiene únicamente la intención de alarmar, si no de concienciar sobre algo que es ineludible: saber que pensar es un acto que necesita esfuerzo, y de que renunciar a ese esfuerzo, aunque sea a cambio de la comodidad tiene consecuencias negativas.

Lo que ella denomina llama “sedentarismo cognitivo” es, una de las definiciones más precisas de algo que muchos intuimos y que no habíamos alcanzado a nombrar con precisión. Así como cuidar nuestro cuerpo implica la necesidad de ejercitarse para mantenerse vivo y ágil, nuestra mente necesita esa gimnasia mental, es decir esforzarnos, aunque ello no suponga que vayamos a obtener una respuesta inmediata como sucede con la inteligencia artificial. Y será este proceso el que nos ayudará a crecer. Esto no supone renunciar a la tecnología, que puede ser una herramienta útil de ayuda, sino para utilizarla sin renunciar al sentido común y a la creatividad, que sólo es patrimonio de las personas.

El libro va dirigido a docentes, estudiantes, y a todas aquellas personas que reflexionan sobre el valor de la educación. Pero también está escrito para cualquiera que percibe, que algo de su relación con el conocimiento está cambiado en los últimos tiempos y no es capaz de determinar bien si este cambio supone una ganancia o una pérdida. Como apuntamos al inicio de este prólogo, la respuesta que Claudia propone no es simple, ni sencilla: es ambas cosas, y eso depende en buena medida de las decisiones que tomemos, individual y colectivamente.

En esencia el libro aboga por un hecho que parece lógico que la conciencia humana no es sustituible. No porque sea perfecta, que claramente no lo es, o precisamente por eso  mismo, sino porque es el único espacio en el que podemos asumir nuestras responsabilidades de lo que expresamos a través del pensamiento y de la creación. Es innegable que la inteligencia artificial tiene una enorme capacidad para escribir textos, reorganizar información y casi siempre lo hace de manera impecable, no obstante se ha entrenado con casi toda la información que ha producido la humanidad a lo largo de los siglos, pero no puede asumir ninguna  responsabilidad por sí misma. Tampoco puede hacerse cargo de los daños que pueda causar y no puede, en el sentido más profundo, habitar el mundo.

Ya que habitar el mundo únicamente lo hacemos los seres humanos cuando nos esforzamos por aprender de verdad: cuando cometemos errores, cuando plateamos y nos plateamos una pregunta difícil, cuando escuchamos a alguien que piensa diferente y eso nos abre nuevos horizontes. Precisamente esto es lo que la educación, en su mejor versión, ha preservado siempre. Y es lo que este libro, con generosidad y lucidez, nos invita a seguir haciendo.

Lean este libro dando tiempo al tiempo. Subrayen aquello que más les incomode. Discutan sobre sus posibles contradicciones. Esa es, en el fondo, la mejor manera de demostrar que todavía estamos pensando.

 Julio Alonso Arévalo

 Salamanca, primavera de 2026
Una empresa llamada Springer, que no es la editorial, está ofreciendo la autoría a la venta.

Chawla, Dalmeet Singh. (2026, 12 de octubre). A company named Springer that isn’t the publisher is offering authorship for sale. Retraction Watch. Enlace al artículo original: https://retractionwatch.com/2026/10/12/springer-journals-online-authorship-for-sale/

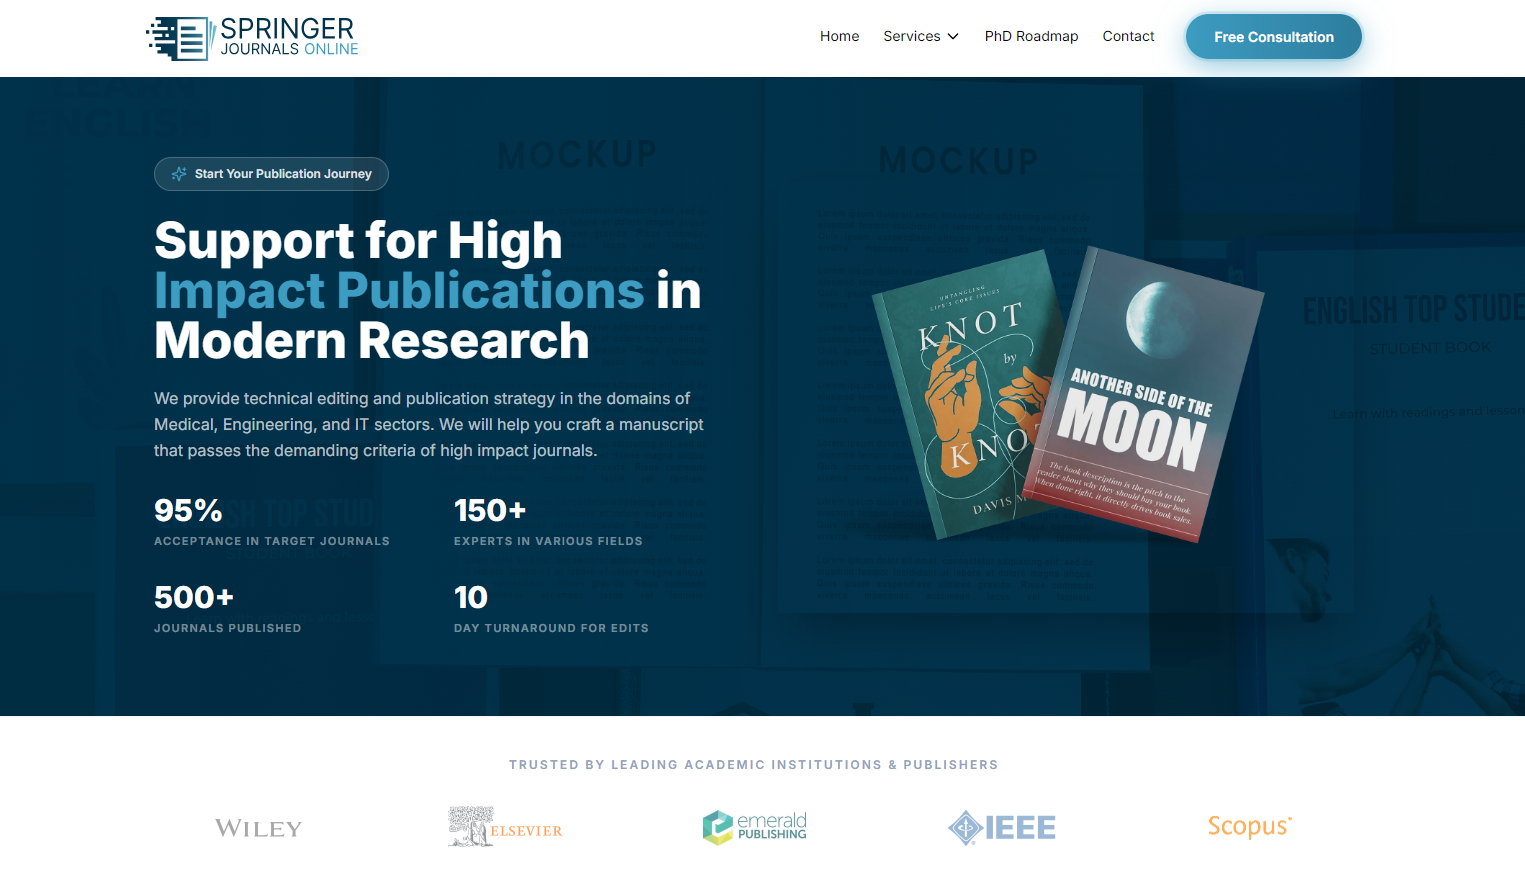
Una empresa llamada Springer Journals Online que ofrece puestos de coautoría en artículos científicos a cambio de dinero, utilizando una denominación que puede confundirse con la editorial Springer Nature. El caso evidencia el crecimiento de las fábricas de artículos científicos (paper mills), una amenaza para la integridad académica que distorsiona la evaluación investigadora y pone en riesgo la fiabilidad de las publicaciones científicas.

La comercialización de autoría en artículos destinados a revistas académicas de prestigio. El caso gira en torno a una empresa denominada Springer Journals Online, que ofrece a investigadores la posibilidad de incorporarse como coautores a manuscritos supuestamente próximos a su publicación en revistas internacionales. La organización solicita una contribución económica para cubrir parte de los costes de publicación y presenta oportunidades vinculadas a editoriales reconocidas, como Elsevier, Springer Nature, Taylor & Francis, Wiley y SAGE. La oferta resulta especialmente preocupante porque utiliza una denominación muy similar a la de Springer Nature, una editorial científica consolidada, lo que puede inducir a confusión y transmitir una apariencia de legitimidad. Sin embargo, según la investigación periodística, esta empresa no tiene relación con Springer Nature ni con la actividad editorial legítima que desarrolla esta compañía.

La investigación comienza cuando Richard Fateman, profesor emérito de informática de la Universidad de California en Berkeley, recibe un correo electrónico inesperado en el que se le propone participar como coautor en publicaciones científicas a cambio de asumir una parte de los costes. Fateman considera que la propuesta puede constituir una estafa y, además, plantea un problema ético fundamental: aceptar la inclusión de su nombre en un trabajo en cuya elaboración no ha participado. El mensaje comercial ofrece diferentes manuscritos, plazos estimados de publicación, revistas de destino y posiciones disponibles en la lista de autores. Aunque la empresa responde posteriormente que los participantes deberían intervenir en la investigación, revisar el manuscrito y aportar comentarios sustanciales desde su especialidad, la forma inicial de presentar la oferta suscita serias dudas sobre la naturaleza real de estas colaboraciones y sobre la posibilidad de comprar reconocimiento académico.

Uno de los aspectos más llamativos es la utilización de elementos que parecen diseñados para generar confianza. La página web de Springer Journals Online anuncia una tasa de aceptación del 95 % en las revistas objetivo y afirma haber publicado más de 500 revistas. Sin embargo, la investigación identifica varias señales de alerta: la dirección que figura en la web corresponde a una calle que no existe, el teléfono publicado utiliza un prefijo del Reino Unido y el perfil de Instagram de la organización está vinculado a Pakistán. Además, uno de los testimonios comerciales aparece atribuido a «Dr. Aris Thorne», un nombre ficticio conocido por su frecuente aparición en contenidos generados mediante modelos de lenguaje. Retraction Watch intentó obtener explicaciones de la empresa por correo electrónico y teléfono, sin conseguir una respuesta satisfactoria. Por su parte, un portavoz de Springer Nature confirmó que su centro de operaciones contra la piratería y los problemas de seguridad ya conocía la existencia de esta organización y estaba trabajando con las autoridades competentes.
El caso se inscribe en un fenómeno más amplio conocido como paper mills, o fábricas de artículos científicos: redes comerciales que producen, distribuyen o manipulan manuscritos académicos y ofrecen servicios que pueden incluir la venta de puestos de autoría. Estas prácticas convierten la publicación científica en una mercancía y permiten que algunas personas obtengan méritos curriculares sin haber contribuido de manera real a la investigación. El artículo recuerda que un estudio de 2024 estimó que estas fábricas podrían representar alrededor del 2 % de los envíos de manuscritos a revistas científicas en distintas disciplinas. También establece paralelismos con otros casos en los que organizaciones han creado páginas que imitan revistas legítimas o han comercializado posiciones de autoría vinculadas a publicaciones de editoriales reconocidas.

Las consecuencias van mucho más allá del incumplimiento de las normas de publicación. La autoría científica implica responsabilidad sobre la metodología, los datos, los resultados y las conclusiones de un trabajo. Cuando se incorporan autores que no han contribuido de forma significativa, se dificulta la identificación de quienes deben responder por los posibles errores o irregularidades. Además, estas prácticas distorsionan la evaluación de la actividad investigadora, perjudican a quienes desarrollan su trabajo de manera rigurosa y pueden facilitar que resultados poco fiables entren en la literatura científica y sean utilizados posteriormente por otros investigadores. La advertencia de Fateman es especialmente relevante: cuando una publicación acumula autores sin una contribución claramente identificable, la responsabilidad individual puede diluirse y aumentar el riesgo de que los errores pasen inadvertidos.

Inteligencia artificial generativa para la investigación y la elaboración de tesis: guía práctica para estudiantes, supervisores e instituciones educativas.

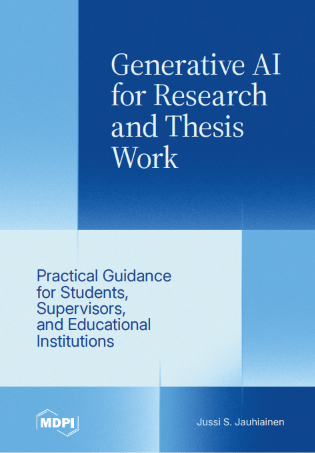
Jauhiainen, J. S. (2026). Generative AI for research and thesis work: Practical guidance for students, supervisors, and educational institutions. MDPI.

Descargar PDF

Generative AI for Research and Thesis Work publicado en septiembre de 2026 por MDPI en acceso abierto, ofrece una guía práctica para incorporar la inteligencia artificial generativa a la investigación académica y a la elaboración de trabajos de fin de grado, máster y tesis. A lo largo de sus 272 páginas, aborda las distintas etapas del proceso investigador, desde la formulación de la pregunta de investigación y la revisión bibliográfica hasta el análisis de los datos, la redacción, la revisión final y la defensa del trabajo.

La obra explica cómo utilizar herramientas como ChatGPT y Claude para generar ideas, organizar la literatura científica, analizar materiales, mejorar la escritura y preparar evaluaciones. También incluye ejemplos de instrucciones (prompts), plantillas, listas de comprobación y flujos de trabajo que permiten integrar estas tecnologías de manera sistemática en las tareas académicas. Asimismo, presta atención al papel de los tutores, docentes y responsables institucionales en la orientación del alumnado y en el desarrollo de políticas de uso de la inteligencia artificial.

Uno de los aspectos más relevantes del libro es su insistencia en la necesidad de utilizar la IA de forma crítica y responsable. Advierte sobre riesgos como las referencias bibliográficas inventadas, los sesgos, los razonamientos deficientes, los problemas de privacidad y la dependencia excesiva de estas herramientas. Su planteamiento es claro: la inteligencia artificial debe servir de apoyo al trabajo académico, pero nunca sustituir la capacidad de análisis, la originalidad ni la responsabilidad intelectual del investigador.

En definitiva, se trata de una publicación de interés para estudiantes, investigadores, tutores y profesionales de la información que quieran comprender cómo aprovechar la IA generativa durante el proceso de investigación sin comprometer la integridad académica. También constituye un recurso útil para las bibliotecas universitarias que desarrollan programas de alfabetización en inteligencia artificial, formación investigadora y acompañamiento a la comunidad académica

Integridad académica e Inteligencia artificial

Integridad académica e Inteligencia artificial

VER VIDEO

https://youtube.com/live/q-KNtysDsik?si=7ki1bjlnBuAunhwH

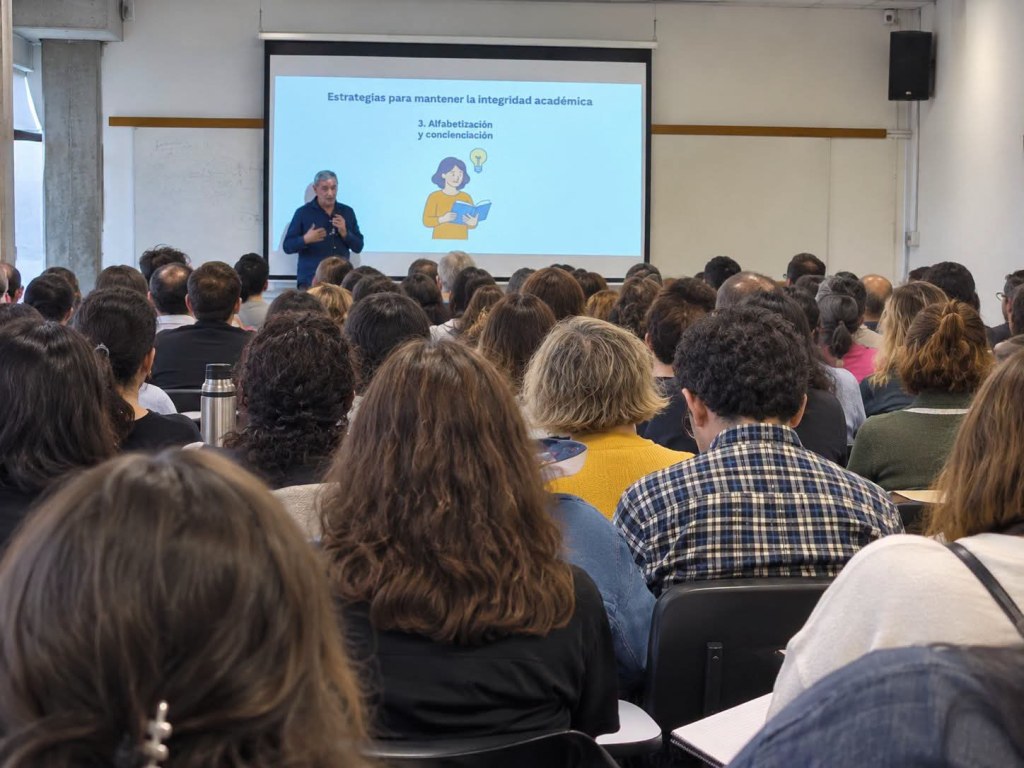
Transmisión en vivo de la conferencia «Integridad académica e inteligencia artificial» por Julio Alonso Arévalo (Universidad de Salamanca), realizada el miércoles 7 de octubre en la FIC: facultad de información y comunicación de la Universidad Nacional de la República de Uruguay. Montevideo (Uruguay)

El problema de la «validez sintética» en la investigación de IA.

Retraction Watch Staff, “AI research’s ‘synthetic validity’ problem”, Retraction Watch, 19 de septiembre de 2026. Artículo original en Retraction Watch

El problema ya no consiste únicamente en detectar artículos falsos o textos generados por IA. El reto es garantizar que los datos, métodos, referencias y evidencias que sustentan la investigación sean verificables y tengan validez respecto al fenómeno real que pretenden estudiar. La expansión de la IA hace que esta tarea sea todavía más importante.

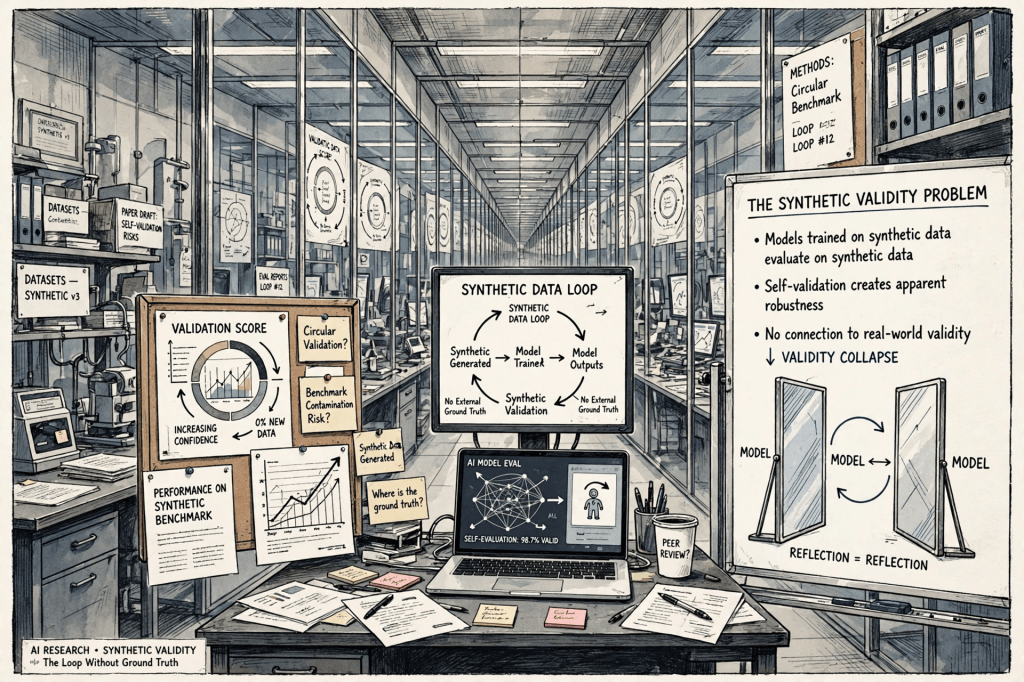
Especialmente relevante para el ámbito de la IA y la comunicación científica es la referencia al problema de la “synthetic validity”. El concepto alude a una dificultad creciente: los investigadores pueden utilizar modelos generativos para producir datos, participantes simulados, respuestas, textos u otros materiales que presentan una apariencia estadísticamente plausible, pero cuya correspondencia con el mundo real puede ser limitada. El problema no es solamente si los datos sintéticos son técnicamente coherentes, sino hasta qué punto permiten extraer conclusiones válidas sobre personas, comportamientos o fenómenos reales.

Esta cuestión adquiere especial importancia a medida que la IA generativa se incorpora a experimentos, encuestas, simulaciones y procesos de investigación. Una investigación puede obtener resultados internamente consistentes utilizando datos artificiales y, sin embargo, presentar una validez externa limitada. La posibilidad de generar grandes cantidades de respuestas sintéticas también puede facilitar estudios rápidos y baratos, pero introduce la necesidad de demostrar que los resultados no son simplemente un reflejo de los patrones incorporados en los propios modelos de IA.

La integridad científica depende de toda una cadena de controles, desde el diseño de la investigación y la recogida de datos hasta la revisión por pares, la publicación, las citaciones y la posterior corrección del registro científico. La aparición de la IA añade nuevas dificultades, pero no sustituye problemas tradicionales como las autorías fraudulentas, los datos inconsistentes, las referencias incorrectas o la ausencia de aprobación ética.

La IA introduce un nuevo problema: datos plausibles pero artificiales. La cuestión de la synthetic validity resulta particularmente importante para la alfabetización en IA. Un modelo generativo puede producir miles de respuestas aparentemente humanas y coherentes; sin embargo, que una respuesta sea verosímil no significa que represente a una población real. Esto obliga a los investigadores a diferenciar entre precisión estadística, coherencia interna y validez empírica.

Existe además el riesgo de crear un círculo de retroalimentación: los modelos se entrenan con datos producidos por seres humanos; posteriormente generan nuevos datos sintéticos; esos datos pueden utilizarse para entrenar, evaluar o alimentar otros modelos; y finalmente los resultados artificiales pueden volver a incorporarse al ecosistema científico. Si este proceso no se controla, la investigación podría terminar utilizando datos derivados de otros datos sintéticos sin una conexión suficientemente sólida con la realidad empírica original.

En investigación social, educativa o bibliométrica, por ejemplo, utilizar participantes sintéticos podría generar resultados que parecen convincentes pero que no necesariamente reproducen las características, sesgos y comportamientos de personas reales. El riesgo aumenta si los resultados generados artificialmente se utilizan posteriormente como evidencia para nuevas investigaciones. De este modo puede aparecer un círculo de retroalimentación en el que los modelos entrenados con información humana generan nuevos datos que posteriormente se utilizan para entrenar o evaluar otros modelos.

El artículo resulta especialmente útil porque conecta tres problemas que normalmente se analizan por separado: la integridad de las publicaciones, la creciente utilización de IA y la necesidad de preservar la confianza en el registro científico. Retraction Watch recuerda además que su base de datos ya supera las 67.000 retractaciones, una cifra que refleja la dimensión acumulativa de los mecanismos de corrección de la literatura científica.

El uso de la IA en la comunicación científica: transparencia, detectores y nuevos sesgos

David Crotty, “AI Use in The Scholarly Kitchen”, The Scholarly Kitchen, 27 de agosto de 2026. Publicado por la Society for Scholarly Publishing (SSP). Artículo original en The Scholarly Kitchen

El artículo parte de una experiencia concreta de The Scholarly Kitchen para analizar uno de los debates más controvertidos de la comunicación científica actual: cómo utilizar la inteligencia artificial en la escritura y edición sin convertir su uso en un problema de confianza, autoría o integridad editorial. El autor explica que el blog ha recibido un número creciente de mensajes de lectores que sospechan que determinados textos han sido escritos por IA, muchas veces basándose exclusivamente en la apariencia del estilo o en el resultado de herramientas automáticas de detección.

Una de las cuestiones centrales del artículo es la limitación de los detectores de IA. Crotty señala que herramientas como Pangram o GPTZero han mejorado su precisión, pero todavía presentan importantes limitaciones. Sobre todo, no distinguen adecuadamente entre un texto completamente generado por IA y un texto escrito por una persona que posteriormente ha sido traducido, corregido, revisado o mejorado mediante IA. Desde el punto de vista editorial, son situaciones muy diferentes, pero un detector puede clasificarlas de manera similar. Por ello, la detección de participación de IA no permite determinar automáticamente cómo se utilizó la herramienta ni si ese uso fue éticamente aceptable.

El problema se agrava con los falsos positivos. El autor relata que algunos textos de The Scholarly Kitchen acusados de haber sido generados íntegramente por IA habían sido realmente escritos, editados y ampliados por miembros del equipo editorial. Incluso menciona el caso de un informe humano que, al pasar por Pangram, fue clasificado como un 9 % generado por IA, pero el sistema identificó incorrectamente qué fragmentos procedían de la IA y cuáles habían sido escritos por una persona. Esto muestra que un porcentaje obtenido mediante un detector no debería interpretarse como una prueba concluyente de autoría artificial.

La política de The Scholarly Kitchen

La IA no puede aparecer como autora de un artículo, y las imágenes generadas por IA no se admiten salvo que exista una razón específica relacionada con el contenido del artículo. Sin embargo, sí se permite utilizar herramientas de IA para redacción y edición, tanto por parte de los autores como de editores y revisores, siempre que exista transparencia y se documente su utilización. Crotty señala que inicialmente la publicación confiaba en la responsabilidad individual de los autores, pero recientemente ha decidido adoptar una posición más activa para exigir la declaración del uso de IA.

Esta postura plantea una cuestión interesante para las publicaciones académicas: prohibir completamente la IA puede ser menos eficaz que establecer reglas claras de utilización y declaración. Crotty considera que, en un espacio editorial de opinión y análisis como The Scholarly Kitchen, existe margen para experimentar y aprender. Su planteamiento es que la transparencia puede resultar más útil que una prohibición absoluta, especialmente mientras las comunidades académicas y editoriales siguen intentando determinar qué usos son aceptables en diferentes contextos.

El riesgo de crear un nuevo sesgo

Uno de los argumentos más interesantes del artículo es que la reacción contra la IA puede generar un nuevo tipo de sesgo editorial y académico. Crotty observa que algunos lectores utilizan la sospecha de utilización de IA como una forma de descalificar contenidos con los que no están de acuerdo. En lugar de analizar los argumentos, las evidencias o la calidad de la investigación, basta con afirmar que el texto «parece escrito por IA» para cuestionarlo.

Esto tiene especial importancia en la comunicación científica. Tradicionalmente, los textos de investigadores que escriben en una lengua que no es la suya pueden recibir una valoración negativa debido a errores gramaticales o estilísticos, incluso cuando la investigación que contienen es sólida. Una de las posibles aportaciones de la IA es precisamente ayudar a superar esta barrera lingüística. Sin embargo, si la comunidad empieza a penalizar automáticamente cualquier texto que parezca haber sido mejorado mediante IA, podría sustituirse un sesgo lingüístico por un nuevo sesgo tecnológico.

“Escribir es pensar”

La parte más personal del artículo aparece cuando Crotty explica su propia relación con estas herramientas. Afirma que para él escribir constituye una forma de pensar: redactar le obliga a organizar las ideas, construir argumentos y comprender mejor aquello sobre lo que quiere escribir. Desde esta perspectiva, delegar la elaboración del texto en una IA supone también, en cierta medida, delegar una parte del proceso intelectual.

Crotty expresa además preocupación por la posibilidad de que los modelos de lenguaje conduzcan hacia una homogeneización de la escritura. Los modelos tienden a producir respuestas estadísticamente plausibles y, según su argumento, esto puede llevar a que los textos se parezcan cada vez más entre sí. La IA puede ayudar a una persona con dificultades de escritura a mejorar su expresión, pero también podría hacer que un escritor experimentado pierda parte de su estilo, originalidad o capacidad para producir ideas alejadas de los patrones habituales.

Una cuestión especialmente relevante para la ciencia

El artículo resulta particularmente interesante porque desplaza el debate desde la pregunta “¿ha utilizado IA este texto?” hacia otra mucho más útil: “¿para qué se utilizó la IA y qué responsabilidad conserva el autor?”. Esta distinción es fundamental en el ámbito académico. Utilizar IA para corregir gramática, traducir un párrafo, generar alternativas de redacción, resumir información o desarrollar una primera estructura no equivale necesariamente a delegar en ella la producción intelectual de una investigación.

Por ello, el texto apunta hacia un modelo basado en transparencia, responsabilidad humana y evaluación del contenido, en lugar de confiar exclusivamente en detectores automáticos. Un detector puede constituir una señal para investigar, pero no debería convertirse por sí mismo en una prueba de mala conducta académica. El propio artículo insiste en que incluso los mejores sistemas de detección no pueden determinar por sí solos qué uso de IA se produjo ni si ese uso resulta éticamente aceptable.

Relevancia para bibliotecas y alfabetización en IA

Para las bibliotecas universitarias y los servicios de apoyo a la investigación, el artículo ofrece una idea especialmente importante: la alfabetización en IA no debería reducirse a enseñar a detectar textos generados artificialmente. También debe enseñar a comprender los diferentes usos de estas herramientas, evaluar críticamente sus resultados, documentar cuándo y cómo se han utilizado y mantener la responsabilidad intelectual sobre el producto final.

En este sentido, el artículo puede relacionarse directamente con la integridad científica, la alfabetización informacional y la formación de investigadores. El objetivo no debería ser identificar mecánicamente si «hay IA» en un documento, sino ayudar a estudiantes, investigadores, autores, revisores y editores a establecer criterios razonables sobre autoría, contribución intelectual, transparencia, verificación de información y responsabilidad.