Archivo de la categoría: Investigación

La denuncia contra una experta en IA se archiva tras las acusaciones sobre el uso de inteligencia artificial en su libro

Retraction Watch. (21 de septiembre de 2026). Misconduct case dropped against AI expert after claims of AI use in recent book. Retraction Watch. Artículo original en Retraction Watch

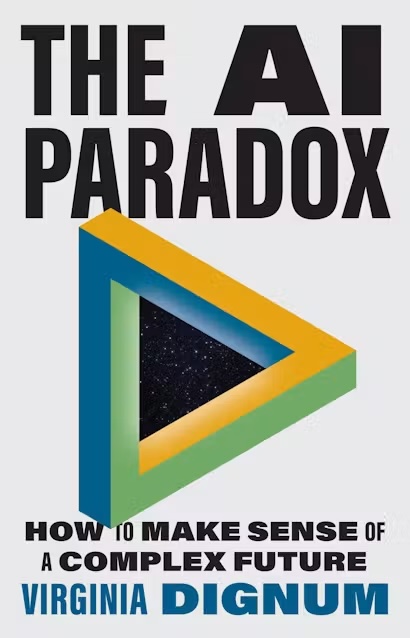
El caso afecta a Virginia Dignum, profesora de inteligencia artificial responsable en la Universidad de Umeå (Suecia) y especialista en las dimensiones sociales de la IA. Una persona anónima presentó una denuncia por posible mala conducta investigadora relacionada con su libro The AI Paradox, publicado por Princeton University Press en febrero de 2026. Las acusaciones se centraban principalmente en dos cuestiones: la supuesta utilización de inteligencia artificial para generar partes del texto y la existencia de referencias bibliográficas que presentaban errores o que, según la denuncia, podían haber sido inventadas.

La Universidad de Umeå recibió la denuncia el 6 de julio de 2026 y remitió el asunto al National Board for Assessment of Research Misconduct (NPOF), organismo sueco encargado de evaluar determinados casos de mala conducta científica. Sin embargo, el 4 de septiembre el organismo decidió cerrar el expediente sin iniciar una investigación, al considerar que las acusaciones quedaban fuera de su ámbito de competencia. El motivo fundamental fue la naturaleza del libro: según la información proporcionada al organismo, The AI Paradox es una obra de divulgación dirigida al público general y no una investigación científica ni un trabajo realizado en el marco de financiación para investigación.

El NPOF concluyó que el libro no constituye investigación científica a efectos de la normativa sueca sobre mala conducta investigadora. El organismo señaló que Dignum considera la obra un libro de divulgación científica, que no formula afirmaciones propias de una investigación y que fue escrita durante su tiempo libre, fuera del ámbito de proyectos financiados. La Universidad de Umeå tampoco encontró elementos que contradijeran esta descripción. Por ello, una vez archivado el expediente, la universidad indicó que no adoptaría medidas específicas contra la investigadora en relación con esta denuncia.

Un elemento particularmente interesante del caso son las referencias bibliográficas cuestionadas. Dignum negó que hubiera fuentes inventadas y explicó que las seis referencias señaladas por la denuncia correspondían a fuentes reales. Reconoció, no obstante, que algunas referencias contenían errores y que determinados problemas se produjeron al utilizar una herramienta de IA para transformar las citas a formato BibTeX. Según su explicación, se trató de errores de edición y no de fabricación deliberada de referencias. Princeton University Press publicó posteriormente una versión electrónica actualizada del libro con correcciones en varias referencias y anunció que las correcciones también se incorporarían a futuras ediciones impresas.

Dignum también reconoció haber utilizado herramientas de inteligencia artificial durante la elaboración del libro para comprobar formulaciones y proponer alternativas de redacción. Según su explicación, el contenido intelectual y el texto final son de su autoría y ella asume la responsabilidad por ellos. El caso vuelve a poner sobre la mesa una cuestión todavía poco definida en el ámbito académico: qué usos de la IA en la escritura son aceptables y cuáles deberían considerarse problemáticos desde el punto de vista de la integridad académica.

Otro aspecto relevante es la utilización de detectores de IA como elemento de prueba. Una de las acusaciones se apoyaba en herramientas que supuestamente habían identificado determinados fragmentos del libro como generados por inteligencia artificial. Dignum cuestionó este tipo de evidencia y sostuvo que no es posible demostrar de manera concluyente que un texto no haya sido generado por IA únicamente mediante herramientas de detección. El caso ilustra así una de las principales dificultades actuales de los detectores: una señal algorítmica de posible generación automática no equivale necesariamente a una prueba de autoría mediante IA.

El bioeticista David Resnik, citado por Retraction Watch, considera que todavía existe una zona de incertidumbre ética respecto al nivel de utilización de IA aceptable en la escritura académica. También advierte sobre la compleja posición de los denunciantes o whistleblowers: pueden contribuir a descubrir auténticas prácticas irregulares, pero también pueden generar investigaciones institucionales costosas cuando las irregularidades denunciadas son menores o no constituyen realmente mala conducta científica.

El caso resulta especialmente significativo para el debate sobre IA e integridad científica porque diferencia tres cuestiones que con frecuencia se mezclan: el uso legítimo o declarado de herramientas de IA durante la redacción, los errores bibliográficos producidos durante procesos asistidos por IA y la verdadera fabricación o falsificación de información. El archivo de la denuncia no significa que todos los problemas señalados en el libro fueran inexistentes: la propia autora reconoció errores bibliográficos que fueron posteriormente corregidos. Lo que determinó el cierre del procedimiento fue, fundamentalmente, que la obra no entraba dentro de la definición de investigación científica sometida a la jurisdicción del organismo sueco.
La investigación fraudulenta no desaparece cuando se publica, sigue siendo citada

Retraction Watch, “Paper mill studies get cited by clinical guidelines, policy docs and more, analysis finds”, 17 de septiembre de 2026. El artículo analiza un estudio de Federica Silvi y Leslie D. McIntosh, de Digital Science, publicado como preprint en arXiv el 31 de agosto de 2026 https://retractionwatch.com/2026/09/17/paper-mill-studies-get-cited-by-clinical-guidelines-policy-docs-and-more-analysis-finds/

Según un nuevo análisis, los estudios producidos por una presunta «fábrica de artículos» (paper mill) aparecen citados con frecuencia en patentes, guías clínicas y documentos de políticas públicas.

El estudio analiza qué ocurre con artículos científicos vinculados a una “paper mill”, es decir, una empresa o red que comercializa manuscritos científicos, autorías o servicios destinados a introducir trabajos de dudosa procedencia en el sistema de publicación académica. El caso estudiado procede de la Pharmakon Neuroscience Network (PNN), una supuesta red científica que, según investigaciones anteriores, funcionaba como un sistema de venta de autorías. Los primeros artículos que incluían PNN entre sus afiliaciones comenzaron a aparecer en 2019 y presentaban algunas características habituales de las publicaciones sospechosas: grupos de autores de diferentes países sin antecedentes claros de colaboración, investigadores de campos muy distintos y combinaciones de autorías difíciles de explicar por una trayectoria científica convencional. 

Silvi y McIntosh estudiaron 1.975 artículos asociados a autores que habían utilizado PNN como afiliación y utilizaron la base de datos Dimensions para seguir las citas que recibieron posteriormente. El objetivo no era simplemente contar cuántos de esos artículos habían sido retractados, sino determinar hasta dónde había llegado su influencia dentro del ecosistema científico y académico. El resultado resulta especialmente relevante: 480 artículos fueron citados en patentes, 57 aparecieron citados en documentos de política pública y 12 fueron citados en guías clínicas.

El principal hallazgo del estudio es que una investigación cuestionable puede seguir circulando y adquiriendo influencia mucho después de haber sido producida. Una vez que un artículo entra en una base de datos bibliográfica, recibe citas y forma parte del corpus de literatura científica disponible, puede ser utilizado por investigadores que desconocen completamente su procedencia.

Esto crea un problema especialmente importante porque las citas pueden actuar como una especie de mecanismo de legitimación acumulativa. Un artículo puede ser citado porque parece relevante, después aparecer en una revisión de literatura, posteriormente ser utilizado por otro investigador y finalmente llegar a un documento normativo o una guía. En cada paso puede perderse información sobre la calidad o procedencia original de la investigación.

El estudio demuestra precisamente que la contaminación del registro científico no se limita a llenar las revistas de artículos problemáticos. Puede alcanzar productos derivados de la ciencia: patentes, documentos de política científica y sanitaria, guías clínicas y eventualmente decisiones relacionadas con financiación.

El problema adquiere una dimensión adicional con la expansión de la IA generativa. Las paper mills ya pueden utilizar herramientas automatizadas para producir textos, modificar manuscritos, generar imágenes o acelerar procesos de publicación. Investigaciones recientes sobre el mercado de venta de autorías muestran precisamente que el modelo de negocio está evolucionando y que la IA puede facilitar algunas de estas operaciones.

Esto puede crear un escenario especialmente complejo: más producción científica aparente, más velocidad de publicación y más dificultad para distinguir entre investigación auténtica y contenido fabricado.

Por ello, la integridad científica futura probablemente dependerá cada vez más de una combinación de revisión humana, análisis bibliométrico, detección de patrones de autoría, verificación de datos, transparencia sobre contribuciones y sistemas capaces de rastrear cambios en el estado de una publicación.

La inteligencia artificial ya interviene en un tercio del descubrimiento de información científica

Students studying in a library beside graphic reading “STUDY FINDS: AI NOW MEDIATES A THIRD OF SCHOLARLY INFORMATION DISCOVERY,” “33% AI-ASSISTED,” and labels for academic databases, articles, researchers, journals, and an AI neural network hub.

“AI now mediates a third of scholarly information discovery, study finds”. Research Information (16 de julio de 2026), https://www.researchinformation.info/news/ai-now-mediates-a-third-of-scholarly-information-discovery-study-finds/

El artículo recoge los resultados de la primera fase del estudio Taming the Crocodile, impulsado por Kudos, que analiza cómo está cambiando la forma en que investigadores, estudiantes y bibliotecarios descubren información científica en un entorno cada vez más mediado por herramientas de inteligencia artificial.

El estudio revela un cambio profundo en las prácticas de búsqueda de información académica: aproximadamente un tercio del descubrimiento de información científica ya está mediado por la inteligencia artificial. La investigación combina encuestas realizadas a 11.500 investigadores y 200 bibliotecarios, además de un análisis de más de 300 fuentes. Uno de los datos más significativos es que uno de cada diez investigadores comienza directamente sus búsquedas en herramientas de IA, mientras que otro 25 % utiliza buscadores generales en los que las respuestas generadas por inteligencia artificial están cada vez más integradas. El fenómeno es todavía más intenso entre los investigadores que se encuentran en las primeras etapas de su carrera y entre quienes trabajan en organizaciones empresariales, donde el porcentaje que inicia sus búsquedas directamente mediante IA llega a duplicarse.

El problema no es únicamente que cambien los instrumentos de búsqueda, sino que muchos investigadores no son plenamente conscientes del papel que desempeña la IA en los resultados que reciben. El estudio señala que un 40 % de los investigadores cree que los resúmenes generados por IA que aparecen en los buscadores han sido elaborados o seleccionados por personas; entre los estudiantes esta percepción asciende al 46 %. Esta falta de comprensión tiene consecuencias prácticas: los bibliotecarios están observando que algunos usuarios solicitan artículos que en realidad no existen porque han recibido referencias bibliográficas alucinadas por sistemas de inteligencia artificial. Por tanto, la alfabetización en IA se convierte también en una cuestión de alfabetización informacional y científica: no basta con saber formular preguntas a un chatbot, sino que es necesario comprender cómo se generan las respuestas, de dónde proceden las fuentes y cómo comprobar su existencia y fiabilidad.

Otro aspecto especialmente relevante para las bibliotecas es que esta transformación puede estar modificando las propias formas de acceso y utilización de la literatura científica. Los bibliotecarios participantes en el estudio señalan una posible disminución del uso de las fuentes primarias, ya que los investigadores pueden quedarse con la síntesis o respuesta proporcionada por un sistema de IA sin llegar necesariamente al artículo original. Esto introduce una tensión importante porque las estadísticas tradicionales de uso continúan teniendo un peso considerable en decisiones como la renovación de suscripciones. Si los investigadores encuentran información a través de interfaces de IA y dejan de acceder directamente a los documentos originales, las métricas tradicionales podrían dejar de reflejar adecuadamente el verdadero impacto o valor de una colección científica.

El estudio también plantea una nueva responsabilidad para editores y proveedores de información científica. Los bibliotecarios reclaman mayor transparencia sobre la forma en que los contenidos editoriales son incorporados y representados por los sistemas de IA, así como criterios claros para la utilización de contenidos en el entrenamiento de modelos y en las nuevas formas de consulta mediante agentes de inteligencia artificial. En este escenario, ya no es suficiente con que un artículo esté correctamente indexado en una base de datos o sea recuperable mediante un buscador tradicional: las editoriales tendrán que conseguir que sus contenidos sean legibles, interpretables, atribuibles y correctamente representados por los sistemas de IA.

Una de las principales recomendaciones del informe es precisamente desarrollar contenidos “answer-ready”, es decir, preparados para ser comprendidos y utilizados por sistemas de inteligencia artificial. Esto implica utilizar estructuras claras, lenguaje comprensible, metadatos adecuados y mecanismos que permitan identificar inequívocamente autores, artículos, instituciones, resultados y fuentes. La segunda fase del proyecto se centrará precisamente en establecer buenas prácticas relacionadas con esquemas, metadatos y marcado estructurado, con el objetivo de mejorar la visibilidad de la investigación en los entornos de IA y, sobre todo, garantizar una correcta atribución.

Para las bibliotecas, el informe tiene una implicación especialmente importante: la alfabetización informacional debe evolucionar hacia una alfabetización crítica en inteligencia artificial. Los profesionales no solo tendrán que enseñar a localizar información en bases de datos, catálogos y buscadores, sino también a comprender cómo los sistemas de IA seleccionan, resumen y presentan el conocimiento. Esto incluye aprender a verificar referencias, rastrear una afirmación hasta su fuente original, distinguir entre una respuesta generada y una evidencia científica, reconocer posibles sesgos y comprender que una respuesta aparentemente convincente puede contener información falsa. El propio estudio recomienda desarrollar materiales educativos específicos para bibliotecarios e investigadores y establecer métodos para evaluar la visibilidad de los contenidos científicos en los sistemas de IA.

En definitiva, la IA está pasando de ser una herramienta complementaria para buscar información a convertirse en una nueva capa de intermediación del conocimiento científico. El cambio afecta simultáneamente a investigadores, bibliotecas, editoriales, autores y proveedores de información. La cuestión ya no es únicamente cómo conseguir que un artículo aparezca en Google Scholar, Scopus o Web of Science, sino también cómo conseguir que sea encontrado, interpretado y citado correctamente por los sistemas de inteligencia artificial. El estudio Taming the Crocodile apunta así hacia un nuevo escenario de comunicación científica en el que los metadatos, la trazabilidad, la atribución, la transparencia y la calidad de las fuentes adquieren una importancia todavía mayor.

Los artículos Gold OA reciben, en promedio, un 50 % más de citas que los publicados mediante Green OA o sin OA

Springer Nature. From access to impact: How open access shapes research reach, citations, and global visibility. Springer Nature, 2026 https://stories.springernature.com/from-access-to-impact-open-access-research/index.html

El nuevo informe de Springer Nature analiza si las ventajas asociadas al acceso abierto (open access, OA) se mantienen a medida que este modelo se ha generalizado y diversificado. Ocho años después de que Springer Nature estudiara por primera vez las ventajas del Gold OA, el nuevo análisis concluye que estas siguen siendo significativas frente a los artículos publicados mediante acceso cerrado y otras modalidades de acceso abierto. La investigación pretende determinar hasta qué punto la apertura del contenido científico continúa traduciéndose en mayor alcance, visibilidad e impacto académico.

Este informe técnico analiza el efecto de las distintas vías de acceso abierto (OA) en el alcance y el impacto de los artículos publicados en revistas híbridas. Los datos revelan que, ocho años después de nuestro primer estudio importante sobre el tema, los artículos en acceso abierto «oro» (gold OA) siguen presentando una ventaja considerable —medida en términos de descargas, citas y la puntuación de atención Altmetric— frente a los artículos que no son de acceso abierto y a los de acceso abierto «verde» (green OA).

El análisis de 204.781 artículos publicados en 1.812 revistas híbridas de Springer Nature durante 2023 también demuestra cómo el acceso abierto «oro» puede acelerar el ritmo de descargas a lo largo del tiempo y diversificar la procedencia geográfica de los lectores, lo que se traduce en un impacto más rápido y una mayor equidad en el acceso.

Uno de los resultados más destacados es que los artículos publicados en Gold OA alcanzan una difusión considerablemente superior. Según el informe, reciben casi siete veces más descargas por artículo que los trabajos que no están disponibles en acceso abierto. Esta diferencia resulta especialmente relevante porque las descargas constituyen un indicador del alcance potencial de la investigación: cuanto más fácilmente puede accederse a un artículo, mayores son las posibilidades de que sea leído, utilizado, citado y reutilizado por investigadores y otros profesionales.

El estudio también encuentra una ventaja en términos de impacto científico. Los artículos Gold OA reciben, en promedio, un 50 % más de citas que los publicados mediante Green OA y que los artículos sin acceso abierto. El dato refuerza la hipótesis de que eliminar las barreras de acceso no solo aumenta la visibilidad de las publicaciones, sino que puede favorecer su incorporación a nuevas investigaciones y ampliar su influencia dentro de la comunidad científica.

Otro aspecto particularmente interesante es la dimensión de equidad global. Los artículos Gold OA registran más de ocho veces más descargas en países de bajos ingresos y más de siete veces más en países de ingresos medianos-bajos que los artículos no disponibles en abierto. Esto muestra que el acceso abierto puede contribuir a reducir las desigualdades existentes en el acceso al conocimiento científico, especialmente para investigadores e instituciones que cuentan con recursos económicos limitados para suscribirse a grandes paquetes de revistas científicas.

El informe sostiene que el Gold OA mantiene una ventaja clara incluso en un escenario en el que el acceso abierto se ha convertido en una parte habitual del sistema de comunicación científica. Sus conclusiones coinciden además con análisis recientes de STM, que señalan al Gold OA como uno de los principales motores del crecimiento del acceso inmediato y gratuito a la investigación. Para universidades, bibliotecas e investigadores, el estudio refuerza la importancia estratégica de las políticas de ciencia abierta y de facilitar que los resultados de investigación sean accesibles al mayor número posible de lectores.

La publicación científica entra en una nueva etapa: cuatro tendencias que marcarán el futuro

Laura Harvey y Chris Reid, The Scholarly Kitchen, 3 de septiembre de 2026, “A Year of Trends Beyond Scholarly Comms: What You Need to Know” https://scholarlykitchen.sspnet.org/2026/09/03/guest-post-a-year-of-trends-beyond-scholarly-comms-what-you-need-to-know/

La IA está transformando la comunicación científica, desde el modelo de negocio editorial hasta la forma de descubrir y consumir información académica. Los investigadores recurren cada vez más a herramientas de IA, lo que aumenta la importancia de metadatos, interoperabilidad, curación y descubribilidad. En un entorno de contenidos generados masivamente, la confianza, la calidad y la autoridad del conocimiento serán los principales valores diferenciales.

El artículo propone mirar la comunicación científica más allá de sus propias fronteras para entender hacia dónde se dirige. Su tesis es que los cambios que están experimentando los medios de comunicación, las empresas de datos, las plataformas digitales y la inteligencia artificial ofrecen pistas muy valiosas para los editores académicos. Los autores identifican cuatro grandes tendencias que deberían ocupar un lugar central en la estrategia de la publicación científica.

  1. El modelo de negocio está cambiando

La primera transformación afecta al propio concepto de negocio editorial. Los contenidos dejan de ser únicamente productos que se venden para convertirse también en datos y conocimiento que pueden integrarse en sistemas de IA.

Los autores señalan el ejemplo de compañías como Bloomberg, que ha evolucionado desde un modelo centrado fundamentalmente en publicaciones y suscripciones hacia el suministro de datos empresariales que pueden incorporarse directamente a los flujos de trabajo de sus clientes. También destacan los acuerdos entre medios de comunicación y empresas de IA para licenciar contenidos.

Para las editoriales científicas esto plantea una oportunidad: no limitarse a vender artículos, sino convertir el conocimiento editorializado y fiable en servicios que puedan utilizarse directamente dentro de los procesos de investigación.

La clave está en pasar del contenido como producto al conocimiento como infraestructura.

  1. La IA está cambiando el descubrimiento de información

La segunda gran tendencia es quizá la más importante para bibliotecas y servicios de información: el usuario está dejando de comenzar su búsqueda en las plataformas tradicionales.

Los investigadores utilizan cada vez más herramientas de IA como punto de partida para descubrir información científica. El artículo cita datos según los cuales el 84 % de los investigadores utiliza IA en su trabajo y un 62 % la emplea en actividades relacionadas con investigación o publicación. Además, un tercio de los investigadores estaría comenzando sus búsquedas de información directamente mediante IA.

Esto significa que el descubrimiento bibliográfico puede desplazarse desde Google Scholar, bases de datos, catálogos o las propias plataformas de los editores hacia interfaces conversacionales y agentes de IA.

El artículo resume el problema de una manera muy gráfica: los lectores se están convirtiendo también en máquinas, mientras que los editores ya no controlan necesariamente la «puerta de entrada» a sus contenidos.

Para las bibliotecas, esto refuerza enormemente la importancia de los metadatos, los identificadores persistentes, la interoperabilidad, la calidad de los datos y la procedencia de la información.

  1. En un mundo saturado de contenidos, la diferenciación y la comunidad serán fundamentales

Si producir contenido resulta cada vez más barato gracias a la IA, tener contenido ya no constituye por sí mismo una ventaja competitiva suficiente.

Los autores observan que medios como The Economist están apostando por tres elementos: diferenciación, relaciones directas con los usuarios y descubribilidad. Otros medios están construyendo su identidad alrededor de periodistas, expertos, newsletters, eventos, comunidades y redes sociales.

La extrapolación al ámbito académico es muy interesante: los investigadores, editores, consejos editoriales, sociedades científicas y comunidades académicas pueden convertirse en parte esencial del producto.

La publicación científica podría evolucionar así desde el modelo:

artículo → revista → plataforma

hacia:

conocimiento → experto → comunidad → experiencia de investigación.

  1. La confianza se convierte en el principal valor

La cuarta tendencia atraviesa todas las anteriores: la confianza.

En un entorno en el que la IA puede producir cantidades enormes de textos, imágenes, datos y contenidos aparentemente plausibles, el valor diferencial será saber qué merece confianza, quién lo ha producido, cómo se ha elaborado y qué controles ha superado.

Los autores relacionan esta cuestión con los recientes problemas de autoría y contenidos generados mediante IA. Las polémicas no afectan únicamente a la calidad del contenido: revelan problemas relacionados con integridad, transparencia, controles editoriales y responsabilidad.

Por eso, la curación adquiere un nuevo valor. En palabras de los autores, en un mundo con una cantidad creciente de contenidos, la curación se convierte en fundamental y la confianza pasa a ser un activo central.

¿Qué cambiará durante el próximo año?

Harvey y Reid anticipan que la tecnología continuará avanzando más rápido que la cultura, las leyes y las infraestructuras. También prevén que la competencia entre editoriales aumentará, que las comunidades tendrán un papel más importante y que los editores desarrollarán productos que conviertan sus contenidos en servicios de asesoramiento experto.

Además, la IA no solo generará manuscritos: se incorporará a diferentes fases del proceso de investigación y publicación, lo que obligará a revisar prácticas, políticas y criterios de evaluación.

Y hay una observación particularmente interesante: la gente seguirá leyendo, pero cambiarán el qué, el porqué y el cómo de la lectura académica. Los datos tradicionales de lectura tendrán que adaptarse a un escenario en el que parte del consumo de información se produce indirectamente a través de sistemas de IA.

La idea más importante para bibliotecas

El artículo permite extraer una conclusión especialmente relevante: la batalla por el conocimiento ya no se libra únicamente por tener acceso al contenido, sino por conseguir que ese contenido sea encontrado, interpretado, contextualizado y considerado fiable por humanos y máquinas.

Esto coloca en primer plano cuestiones tradicionalmente bibliotecarias —metadatos, autoridad, preservación, identificación, interoperabilidad, curación y alfabetización informacional— que adquieren ahora una importancia estratégica frente a la IA.

En definitiva, la IA no elimina el valor de la intermediación bibliotecaria y editorial; puede hacerlo más importante. La diferencia es que esa intermediación tendrá que funcionar tanto para el lector humano como para el nuevo consumidor de información: la máquina.

El potencial de los datos de investigación abiertos para impulsar la ciencia abierta

Bongiovani, Paola Carolina (2026). El potencial de los datos de investigación abiertos: repositorios y ciencia abierta para la investigación. Universidad de Murcia, EDITUM, colección Cátedra UNESCO en Gestión de Información en las Organizaciones, 2. DOI: 10.6018/editum.3245. Licencia CC BY. Ficha y acceso a la publicación en EDITUM

La obra presenta los datos abiertos como una pieza fundamental de la transformación del sistema científico. Su aportación resulta especialmente relevante para bibliotecas universitarias, repositorios institucionales, gestores de información, investigadores y responsables de políticas científicas, porque muestra que la gestión de datos de investigación constituye un nuevo ámbito estratégico de apoyo a la investigación. La conclusión de fondo es clara: la apertura efectiva de la ciencia depende tanto de compartir los resultados como de garantizar que los datos que sustentan esos resultados puedan encontrarse, entenderse, verificarse, preservarse y reutilizarse de forma responsable.

El libro de Paola Carolina Bongiovani, publicado por la Universidad de Murcia en 2026, analiza el papel de los datos de investigación abiertos como uno de los componentes fundamentales de la ciencia abierta. La autora plantea que compartir los datos sobre los que se construye una investigación permite avanzar hacia una ciencia más transparente, reproducible y colaborativa, al facilitar que otros investigadores puedan comprobar los resultados, reutilizar los datos y generar nuevo conocimiento. La obra presta una atención especial a la realidad de América Latina y, particularmente, Argentina.

El primer bloque del libro aborda el concepto de ciencia abierta desde diferentes perspectivas. Se relaciona la apertura de la investigación con el acceso abierto, la responsabilidad en la investigación y la innovación y los cambios necesarios en los sistemas tradicionales de evaluación científica. También se plantea una cuestión especialmente relevante: la ciencia abierta no debe entenderse únicamente como una cuestión tecnológica, sino también como un proceso relacionado con la equidad, la inclusión y la transformación de las estructuras de producción y evaluación del conocimiento.

Un segundo eje fundamental es el intercambio de datos de investigación. La autora examina las políticas internacionales y argentinas, las exigencias de las revistas científicas y de los organismos financiadores, así como los incentivos y las barreras que encuentran los investigadores para compartir sus datos. Entre estas barreras aparecen los sistemas de evaluación académica, los problemas de reconocimiento del trabajo asociado a los datos y las cuestiones éticas, legales, de privacidad y confidencialidad. También se analiza el creciente papel de las data journals, revistas especializadas en la publicación y descripción de conjuntos de datos.

Una parte central está dedicada a los repositorios de datos de investigación, concebidos como infraestructuras esenciales para almacenar, preservar, describir, localizar y reutilizar los datos científicos. El libro explica sus diferentes tipologías y aborda el concepto de repositorio digital confiable, así como los problemas relacionados con la sostenibilidad y la calidad de estas infraestructuras. En este contexto, los repositorios dejan de ser simples lugares donde depositar archivos para convertirse en auténticas infraestructuras de conocimiento científico.

Especial importancia tienen los principios FAIR —que buscan que los datos sean localizables, accesibles, interoperables y reutilizables— y los principios TRUST, relacionados con la confiabilidad de los repositorios. La autora vincula estos principios con la necesidad de garantizar la calidad de los datos, su documentación, los metadatos, la preservación a largo plazo y las condiciones que permiten que otros investigadores puedan comprender y reutilizar adecuadamente los conjuntos de datos.

El libro concede además un protagonismo destacado a la curación de datos y a los profesionales que la realizan. Surge así la figura del data steward o curador de datos, cuya función va mucho más allá de la gestión técnica de archivos: implica ayudar a los investigadores a organizar, documentar, describir, preservar y compartir sus datos de acuerdo con buenas prácticas. En este ámbito, las bibliotecas y los repositorios universitarios adquieren un papel estratégico, ya que pueden proporcionar tanto infraestructura como asesoramiento y formación a los investigadores.

Uno de los mensajes más importantes de la obra es que abrir los datos no significa simplemente hacerlos públicos. Para que la apertura tenga verdadero valor científico, los datos deben estar correctamente documentados, disponer de metadatos adecuados, ser comprensibles, conservarse de manera sostenible y poder reutilizarse respetando las restricciones legales y éticas. Por ello, la ciencia abierta requiere una combinación de infraestructuras, políticas, competencias profesionales, incentivos y cultura científica.

La IA pone a prueba la reproducibilidad científica: miles de artículos de 2026 fueron sometidos a verificación automatizada

Science (25 de agosto de 2026). “Researchers presented 6000 papers at a major meeting. Could AI reproduce their findings?”. https://www.science.org/content/article/researchers-presented-6000-papers-major-meeting-could-ai-reproduce-their-findings

El artículo analiza un experimento de gran escala en el que agentes de inteligencia artificial intentaron reproducir los resultados de investigaciones presentadas en la conferencia ICML 2026. el experimento de ICML 2026 no demuestra que la IA pueda reemplazar a los científicos, sino algo quizá más importante: que los agentes de IA podrían hacer posible una escala de verificación científica hasta ahora inalcanzable para los revisores humanos. En un entorno donde se publican miles de investigaciones cada año, esta capacidad podría convertirse en una nueva infraestructura de control de calidad para la ciencia.

La conferencia International Conference on Machine Learning (ICML) 2026) aceptó alrededor de 6.000 trabajos científicos, casi el doble que el año anterior. Este crecimiento refleja la enorme expansión de la producción científica en inteligencia artificial y aprendizaje automático, pero también pone de manifiesto una dificultad cada vez mayor: el sistema tradicional de revisión por pares no dispone de suficientes investigadores para comprobar con profundidad todos los trabajos. En este contexto, investigadores de Hugging Face y alphaXiv organizaron una competición para explorar hasta qué punto los agentes de IA podían ayudar a verificar los resultados publicados. La pregunta era especialmente relevante: si se proporciona a una IA el artículo, los datos, el código y los métodos utilizados, ¿puede reproducir de manera independiente los experimentos y llegar a conclusiones similares?

El experimento alcanzó una dimensión considerable. Los participantes utilizaron agentes de IA para intentar reproducir resultados de más de 2.000 artículos de ICML 2026. La iniciativa no se limitó a investigadores especializados en inteligencia artificial: uno de los casos más llamativos fue el de Jansen Tang, analista de riesgos de ciberseguridad de un banco, que consiguió utilizar agentes de IA para reproducir más de 300 trabajos. El proceso permitió detectar numerosos problemas que habían pasado inadvertidos durante la revisión humana. Según los resultados comunicados, cientos de afirmaciones no pudieron reproducirse o quedaron cuestionadas, y los organizadores confirmaron que al menos una docena de artículos presentaban errores reales que habían escapado a los revisores humanos.

Los resultados son particularmente interesantes porque muestran que la IA puede funcionar como una segunda capa de control de calidad científico. En torno a la mitad de los artículos examinados contenían al menos una afirmación que los agentes pudieron verificar de manera independiente, mientras que aproximadamente un 23 % de los trabajos analizados presentaron alguna afirmación falsificada o controvertida. En otros casos, la reproducción no fue posible porque faltaban datos, código u otros elementos necesarios para repetir adecuadamente los experimentos. Esto revela que el problema de la reproducibilidad no depende exclusivamente de que los resultados sean correctos: también depende de que los investigadores proporcionen suficientes materiales y explicaciones para que otros puedan comprobarlos.

El artículo de Science plantea, por tanto, una cuestión de fondo sobre el futuro de la evaluación científica y la revisión por pares. Los agentes de IA podrían automatizar una parte de las tareas más laboriosas —ejecutar código, repetir experimentos, comprobar cálculos, contrastar resultados o buscar inconsistencias— y hacerlo a una escala que sería imposible para equipos humanos. Sin embargo, esto no significa que puedan sustituir completamente a los revisores. Determinar si un trabajo es realmente novedoso, importante, metodológicamente sólido o científicamente significativo requiere todavía conocimientos especializados y juicio humano. La conclusión que emerge del experimento es más matizada: la IA podría convertirse en una herramienta complementaria capaz de ampliar enormemente la capacidad de la comunidad científica para comprobar investigaciones.

El caso también tiene una implicación importante para la integridad científica. Si miles de artículos pueden ser sometidos automáticamente a pruebas de reproducibilidad, la IA podría transformar la cultura científica desde un modelo basado fundamentalmente en confiar en la revisión previa a la publicación hacia otro en el que los resultados puedan ser comprobados continuamente después de su publicación. Pero el experimento también demuestra que la IA necesita acceso a datos, código y materiales suficientemente documentados. La reproducibilidad se convierte así en una condición esencial para que los agentes de IA puedan auditar la ciencia, lo que puede impulsar nuevas exigencias de transparencia, disponibilidad de datos y código, documentación metodológica y ciencia abierta.

El laboratorio invisible de la publicación científica en América Latina: experiencias, desafíos y prácticas editoriales

Roman-Acosta, D., Artigas Morales, W., Linares Morales, J. A., Romero Pérez, N., Pérez de Hernández, A., Kligmann, D. M., Spengler, G., Salas Zendejo, D., Hernández Gutiérrez, K. A., Sánchez-Urdaneta, A. B., Giniebra Urra, R., & Paz Enrique, L. E. (2026). The Invisible Laboratory: Publishing Experiences in the Latin American Context. Editorial PLAGCIS. DOI: 10.69821/978-628-97750-0-

Texto completo

Se adentra en la parte menos visible de la comunicación científica: todo el trabajo, las decisiones, los problemas y los aprendizajes que existen detrás de cada artículo publicado. El libro reúne las experiencias de editores, investigadores y gestores editoriales de diferentes países latinoamericanos para mostrar cómo se construye y mantiene una publicación científica, especialmente en el contexto de las revistas de acceso abierto. Su planteamiento parte de una idea fundamental: publicar ciencia no consiste únicamente en recibir y difundir artículos, sino que implica un complejo entramado de evaluación, edición, gestión, tecnología, ética, coordinación de personas y garantía de la calidad científica.

La obra está estructurada en siete capítulos que recorren buena parte del ecosistema editorial contemporáneo. Aborda desde los primeros pasos de quien comienza a ejercer como editor científico hasta cuestiones relacionadas con la revisión por pares, la gestión de conflictos y crisis editoriales, la ética y la curaduría de contenidos, la renovación de los equipos de las revistas y la administración técnica de plataformas como Open Journal Systems (OJS). También dedica especial atención al futuro del acceso abierto, examinando cuestiones como la sostenibilidad, la equidad y la transformación del ecosistema científico.

Uno de los aspectos más interesantes del libro es que no pretende ser simplemente un manual técnico. Sus autores utilizan sus propias experiencias para convertir la práctica editorial en conocimiento compartido. El editor aparece así como una figura que debe combinar competencias científicas, técnicas, organizativas y éticas, mientras que la gestión de una revista se presenta como un proceso colectivo que requiere coordinación entre autores, revisores, editores, gestores y personal técnico. Esta perspectiva resulta especialmente relevante en América Latina, donde el acceso abierto constituye una pieza importante de las políticas de comunicación científica y donde muchas revistas desarrollan su actividad dentro de modelos institucionales y no comerciales.

El libro presta asimismo atención a los cambios provocados por la transformación digital y la inteligencia artificial. La digitalización ha modificado profundamente la producción, gestión y difusión de las revistas científicas, mientras que herramientas como OJS han convertido la gestión editorial en un proceso cada vez más dependiente de infraestructuras tecnológicas. A ello se suman nuevos retos relacionados con la inteligencia artificial, la integridad científica, la evaluación y la sostenibilidad de las publicaciones. En este contexto, conocer la «trastienda» de las revistas resulta esencial para comprender cómo garantizar la calidad, la transparencia y la integridad de la comunicación científica.

En conjunto, la obra ofrece una visión muy útil y práctica de la edición científica desde la perspectiva de quienes trabajan dentro de ella, poniendo en valor un trabajo que habitualmente permanece oculto para los lectores. Su principal aportación consiste en hacer visible ese «laboratorio invisible» en el que se toman decisiones editoriales, se gestionan revisiones, se resuelven conflictos, se mantienen plataformas tecnológicas y se construyen políticas de acceso abierto. Por ello, puede resultar especialmente interesante para quienes trabajan en bibliotecas universitarias, servicios de apoyo a la investigación, revistas científicas, edición académica y ciencia abierta, así como para investigadores que quieran comprender mejor qué ocurre con sus trabajos desde que los envían hasta que finalmente llegan a los lectores.

Guía de escritura académica científica

Contreras Briceño, Felipe. (2026). Guía de escritura académica científica. Universidad de O’Higgins, Repositorio Académico UOH https://repositorio.uoh.cl/handle/611/1129?locale-attribute=es

La Guía de escritura académica científica es un recurso didáctico elaborado por Felipe Contreras Briceño y publicado por la Universidad de O’Higgins en 2026. Su propósito es ofrecer una herramienta práctica para mejorar las competencias de escritura académica y científica, especialmente en el contexto de la educación superior. La guía aborda la escritura como un proceso que no se limita a la redacción final del documento, sino que comprende distintas fases de planificación, textualización y revisión, proporcionando orientaciones para organizar las ideas y construir textos académicos coherentes y comprensibles.

Uno de los ejes fundamentales del documento es la cohesión textual, elemento esencial para conseguir que las diferentes partes de un escrito mantengan una relación lógica y fluida. La guía dedica apartados específicos a los mecanismos de conexión, recurrencia y progresión, que permiten articular las ideas, mantener los referentes a lo largo del texto y desarrollar de manera ordenada la información. De este modo, la escritura académica se presenta como una actividad estructurada en la que la claridad de los argumentos depende tanto de la calidad de las ideas como de la forma en que estas se relacionan entre sí.

El recurso también presta especial atención a aspectos formales de la escritura, incorporando contenidos sobre puntuación, ortografía acentual y ortografía literal. Estos elementos son tratados como componentes necesarios de una comunicación científica eficaz, ya que una correcta presentación lingüística contribuye a evitar ambigüedades y facilita la comprensión de contenidos especializados. La guía combina explicaciones con ejemplos, de manera que puede utilizarse tanto como material de aprendizaje como herramienta de consulta durante la elaboración de trabajos académicos.

Otro aspecto interesante es la incorporación de recursos audiovisuales complementarios, que amplían los contenidos de la guía y favorecen el aprendizaje autónomo. En conjunto, el documento funciona como una introducción sistemática a las principales dimensiones de la escritura académica: desde la planificación inicial de un texto hasta su revisión, pasando por la construcción de la cohesión y el dominio de las convenciones lingüísticas. Por ello, resulta especialmente útil para estudiantes universitarios, investigadores en formación y cualquier persona que necesite producir textos académicos y científicos con mayor claridad, coherencia y rigor.

El 90 % de los artículos biomédicos ya muestra indicios de uso de inteligencia artificial

Kaia Glickman, “Staggering 90% of biomedical papers now show signs of AI help”, Nature, 20 de agosto de 2026. Artículo original en Nature

Una investigación reciente sugiere que el uso de herramientas de inteligencia artificial para ayudar a redactar artículos científicos está mucho más extendido de lo que indicaban estimaciones anteriores. El estudio analizó trabajos biomédicos publicados en diciembre de 2025 e incluidos en PubMed, y estima que casi nueve de cada diez artículos presentaban señales compatibles con algún grado de asistencia de IA en su redacción. La cifra resulta especialmente llamativa porque las estimaciones anteriores sobre utilización de modelos de lenguaje en publicaciones científicas habían sido considerablemente inferiores.

El trabajo al que hace referencia Nature no afirma que el 90 % de los investigadores haya dejado que una IA escriba sus artículos de principio a fin. Lo que identifica son señales lingüísticas compatibles con asistencia de modelos de lenguaje. Esto es importante porque la IA puede intervenir de formas muy diferentes: desde corregir gramática y mejorar el estilo hasta reformular párrafos, traducir textos, resumir información o generar partes sustanciales de un manuscrito. Por tanto, la cifra debe interpretarse como una estimación de la presencia de asistencia de IA en la escritura científica, no como una medida directa de cuántos artículos fueron escritos por una inteligencia artificial.

El fenómeno refleja una transformación profunda de la comunicación científica. Las herramientas generativas se están incorporando rápidamente al trabajo cotidiano de los investigadores porque permiten mejorar la redacción en inglés, acelerar determinadas tareas editoriales y facilitar la preparación de manuscritos. Esto puede resultar especialmente relevante para investigadores que trabajan en una lengua diferente del inglés, ya que los modelos de lenguaje pueden actuar como herramientas de traducción y edición. Sin embargo, la creciente presencia de IA también plantea preguntas sobre transparencia, autoría, responsabilidad y declaración de su utilización en los trabajos científicos.

La metodología del estudio merece especial atención porque permite detectar patrones de uso de IA que pueden pasar inadvertidos mediante los procedimientos tradicionales de control editorial. Los investigadores analizaron el lenguaje de los artículos y buscaron características asociadas a la intervención de modelos de lenguaje. La estimación, por tanto, no equivale a una declaración voluntaria de los autores ni a una comprobación individual de cada manuscrito. Esto introduce incertidumbre y obliga a interpretar el porcentaje como una estimación estadística, no como una identificación definitiva de textos generados o editados por IA.

El dato tiene importantes implicaciones para las revistas científicas y para la integridad de la investigación. Si la asistencia de IA se convierte en una práctica habitual, las políticas editoriales tendrán que distinguir mejor entre usos legítimos —como corrección lingüística, traducción o apoyo editorial— y usos que puedan comprometer la responsabilidad intelectual del investigador. También será necesario determinar qué utilización debe declararse, cómo debe hacerse esa declaración y qué responsabilidad conserva el autor sobre las afirmaciones, referencias, datos y conclusiones de un artículo elaborado con ayuda de herramientas generativas.

La investigación también cuestiona la utilidad de intentar establecer una frontera rígida entre textos “humanos” y textos “generados por IA”. En la práctica, la producción científica puede convertirse en un proceso híbrido en el que el investigador redacta algunas partes, una herramienta de IA corrige otras, otro sistema traduce o reformula determinados fragmentos y el autor revisa posteriormente el resultado. En este escenario, el debate sobre la IA en la ciencia debería desplazarse desde la pregunta “¿se utilizó IA?” hacia cuestiones más relevantes: ¿para qué se utilizó?, ¿qué aportó?, ¿quién verificó el resultado? y ¿quién asume la responsabilidad final?

El hallazgo resulta especialmente significativo porque procede de un campo como la biomedicina, donde la precisión del lenguaje científico y la fiabilidad de la información tienen consecuencias potencialmente importantes. Una utilización responsable de la IA puede mejorar la comunicación científica, pero no elimina la necesidad de que los investigadores comprueben las referencias, los datos, las interpretaciones y las afirmaciones producidas o modificadas por estos sistemas. La IA puede convertirse así en una herramienta habitual del proceso editorial sin que ello implique transferir a la máquina la responsabilidad científica.

En definitiva, el estudio apunta a que la IA ya forma parte de la infraestructura cotidiana de la comunicación científica, aunque las políticas editoriales y las prácticas de transparencia todavía están adaptándose a esta realidad. El dato del 90 % no significa que nueve de cada diez artículos sean “escritos por IA”, pero sí constituye una señal poderosa de que la asistencia de los modelos de lenguaje está penetrando rápidamente en la publicación biomédica. La cuestión para las revistas ya no parece ser si los investigadores utilizarán IA, sino cómo establecer unas normas que permitan aprovecharla sin comprometer la autoría, la transparencia y la integridad científica.