Archivo de la etiqueta: Propiedad intelectual

La inteligencia artificial sume a la industria editorial en una crisis de autoría y confianza

Silman, Anna. “AI Has Plunged the Book Publishing Industry Into Utter Chaos”. The Wall Street Journal, 17 de agosto de 2026. Artículo original en The Wall Street Journal

La irrupción de la inteligencia artificial generativa está provocando una crisis de confianza en la industria editorial, especialmente alrededor de una pregunta aparentemente sencilla pero cada vez más difícil de responder: ¿quién ha escrito realmente un libro?

El Wall Street Journal analiza una sucesión de casos recientes en los que contratos editoriales importantes han sido cancelados o cuestionados después de que surgieran sospechas sobre el uso de IA. Uno de los ejemplos más llamativos es el de Jerry Falade, cuyo debut literario, Call Me, I’ll Hide the Body, había conseguido un contrato de varios millones de dólares antes de que sus agentes decidieran retirarlo porque no podían verificar que el manuscrito hubiera sido escrito íntegramente por él. Falade niega haber utilizado IA para escribir la novela y considera que las acusaciones tienen un componente racial. El caso ilustra hasta qué punto la mera sospecha puede tener ya consecuencias profesionales y económicas importantes.

El problema se extiende a otros títulos. En marzo, Hachette canceló la publicación estadounidense de Shy Girl, de Mia Ballard, después de acusaciones de utilización de IA. La autora negó haber empleado directamente estas herramientas para escribir la novela y explicó que una persona conocida había utilizado IA durante el proceso de edición. También ha surgido controversia alrededor de Daggermouth, una novela autopublicada que alcanzó posiciones destacadas en las listas de ventas y cuyos derechos fueron adquiridos por Simon & Schuster. Un estudio todavía no revisado por pares señaló indicios de utilización sustancial de IA, aunque la autora lo niega y la editorial ha defendido públicamente su trabajo, señalando además que los detectores de IA pueden producir falsos positivos. El artículo muestra así una paradoja: la industria necesita mecanismos para detectar contenidos generados artificialmente, pero las herramientas disponibles tampoco son suficientemente fiables como para convertirse en una prueba definitiva de autoría.

La situación está obligando a replantear la relación entre autores, agentes y editoriales. Tradicionalmente, el sistema editorial se ha basado en un principio de confianza: el autor declara que la obra es original y el editor confía en esa declaración, del mismo modo que confía en la exactitud de la información proporcionada en una obra de no ficción. La IA introduce una incertidumbre nueva porque resulta mucho más difícil determinar, únicamente a partir del texto final, cómo ha sido producido. Un escritor puede utilizar un modelo para generar un párrafo completo, para corregir el estilo, para traducir, para investigar, para desarrollar una estructura o simplemente para buscar ideas. Entre estos usos existen diferencias sustanciales, pero la industria carece todavía de estándares consensuados que permitan establecer dónde termina la asistencia tecnológica y comienza la autoría de la máquina.

Esta incertidumbre también afecta a los contratos editoriales. Algunas editoriales están considerando incorporar cláusulas específicas sobre inteligencia artificial, mientras que otras prefieren no establecer todavía reglas demasiado rígidas porque la tecnología evoluciona rápidamente y los usos aceptables pueden cambiar en poco tiempo. Las grandes editoriales —Simon & Schuster, Penguin Random House, HarperCollins, Hachette y Macmillan— se encuentran además en una posición contradictoria: por un lado, defienden la creatividad humana y se enfrentan a controversias relacionadas con el entrenamiento de modelos de IA mediante obras protegidas por derechos de autor; por otro, reconocen que la inteligencia artificial puede tener aplicaciones económicas y prácticas en diferentes fases del proceso editorial. Penguin Random House, por ejemplo, sostiene que la IA puede apoyar determinados procesos, pero no sustituir a los autores ni el criterio humano que interviene en la creación de los libros.

El fenómeno también está relacionado con la explosión de la autopublicación y la denominada “AI slop”, es decir, una producción masiva de contenidos de baja calidad generados o asistidos por inteligencia artificial. El atractivo económico es evidente: producir un libro resulta mucho más rápido y barato cuando una máquina puede generar grandes cantidades de texto. El problema es que el mercado editorial puede verse inundado de títulos que compiten por la atención de los lectores y dificultan la visibilidad de las obras creadas mediante procesos humanos. El artículo cita estimaciones según las cuales una proporción significativa de los libros electrónicos publicados en Amazon podría contener algún grado de asistencia de IA. Al mismo tiempo, las editoriales y plataformas tienen dificultades para distinguir entre una utilización legítima de estas herramientas y la producción industrial de libros prácticamente automatizados.

Otro problema importante es el uso de detectores de inteligencia artificial. Estas herramientas pretenden identificar patrones lingüísticos característicos de los textos generados por modelos de lenguaje, pero su fiabilidad está siendo cuestionada. Un resultado positivo no demuestra necesariamente que un libro haya sido escrito por una IA y puede perjudicar injustamente a un autor humano. El caso de Daggermouth demuestra esta dificultad: la investigación que detectó indicios de IA todavía no había sido revisada por pares y la editorial rechazó la idea de utilizar un detector como prueba definitiva. La industria se encuentra, por tanto, ante un dilema complicado: necesita mecanismos para protegerse frente al fraude y la producción masiva automatizada, pero no puede sustituir el juicio editorial por una puntuación algorítmica que también puede equivocarse.

La controversia alcanza asimismo a la propiedad intelectual. El texto recuerda que el contenido generado exclusivamente por IA no disfruta en Estados Unidos de la misma protección de copyright que una obra creada por una persona. Esto proporciona a las editoriales un criterio relativamente claro en uno de los extremos del problema: copiar directamente grandes cantidades de texto generado por un chatbot no constituye una vía segura para reclamar autoría humana. Sin embargo, existe una enorme zona gris entre la generación automática y la creación humana asistida por herramientas de IA. ¿Es diferente utilizar IA para desarrollar un esquema que para reescribir capítulos? ¿Y para traducir, investigar o corregir? ¿Cuánta intervención humana es necesaria para que una obra pueda considerarse propiamente del autor? El sector todavía no dispone de respuestas uniformes.

El artículo destaca finalmente que los agentes literarios están convirtiéndose involuntariamente en policías de la IA. Algunos reciben un número creciente de manuscritos que parecen haber sido generados mediante modelos de lenguaje y otros han empezado a establecer políticas internas mucho más estrictas. Hay agentes que rechazan a autores que utilizan IA incluso para tareas de investigación o inspiración, mientras que otros intentan establecer diferencias entre usos auxiliares y generación directa de contenido. Esta situación genera una considerable inseguridad entre los escritores: pueden dedicar años a una obra y después temer que el uso ocasional de una herramienta tecnológica sea interpretado como una violación de las reglas editoriales. La ausencia de normas comunes hace que las decisiones dependan en gran medida de cada agente, editor o editorial.

En definitiva, la inteligencia artificial está obligando al sector editorial a redefinir qué significa ser autor y cómo se acredita la autoría. La cuestión ya no se limita a impedir que las máquinas escriban libros, sino a establecer reglas claras sobre qué usos de la IA son compatibles con la creación literaria, cómo deben declararse y cómo pueden verificarse. La industria del libro se ha construido históricamente sobre la confianza entre escritores, agentes, editores y lectores; la IA pone a prueba ese modelo porque dificulta comprobar el proceso que existe detrás del texto final. El desafío será encontrar un equilibrio que proteja la creatividad humana sin prohibir usos legítimos de la tecnología y, al mismo tiempo, evite que los detectores imperfectos o las sospechas sin pruebas destruyan la reputación de autores. La verdadera crisis no es solamente que la IA pueda escribir libros, sino que cada vez resulte más difícil saber quién los ha escrito y cuánto podemos confiar en lo que compramos y leemos.
Las bibliotecas reivindican el equilibrio entre inteligencia artificial y derechos de autor

Klosek, Katherine, y Marjory Blumenthal. Revisiting the Library Copyright Alliance Statement on AI and Copyright. Association of Research Libraries (ARL), 10 de diciembre de 2025. https://www.arl.org/blog/revisiting-the-library-copyright-alliance-statement-on-ai-and-copyright/

Library Copyright Alliance (LCA), integrada por la Association of Research Libraries (ARL) y la American Library Association (ALA), ha revisado y actualizado su posición sobre la relación entre la inteligencia artificial y los derechos de autor a la luz de la evolución jurídica y tecnológica de los dos últimos años.

La organización reafirma que la legislación estadounidense sobre copyright continúa siendo suficientemente sólida y flexible para abordar los desafíos planteados por la IA generativa, sin necesidad de introducir modificaciones legislativas específicas. Esta postura se apoya tanto en la doctrina del fair use (uso legítimo) como en las primeras resoluciones judiciales relacionadas con el entrenamiento de modelos de inteligencia artificial.

Uno de los argumentos centrales del documento es que el entrenamiento de modelos de IA mediante el análisis de grandes cantidades de obras protegidas constituye, en la mayoría de los casos, un uso altamente transformador. La LCA sostiene que estos sistemas no reproducen las obras para sustituirlas en el mercado, sino que las utilizan para extraer patrones estadísticos y generar nuevas capacidades computacionales, una finalidad comparable a la reconocida como transformadora en precedentes como el caso Google Books. Desde esta perspectiva, exigir licencias obligatorias para entrenar modelos de IA supondría un obstáculo innecesario para la innovación científica y tecnológica, además de limitar la investigación y el desarrollo de nuevos servicios basados en inteligencia artificial.

La actualización de la declaración también tiene en cuenta las primeras decisiones judiciales en litigios de gran relevancia, como Bartz v. Anthropic y Kadrey v. Meta, en los que los tribunales comenzaron a analizar el uso de obras protegidas durante el entrenamiento de modelos generativos. Aunque estas resoluciones no cierran definitivamente el debate, la LCA considera que refuerzan su interpretación de que el entrenamiento de IA puede encajar dentro del uso legítimo cuando el proceso es transformador y no sustituye económicamente a las obras originales. No obstante, la organización recuerda que la cuestión sigue evolucionando y que futuros pronunciamientos judiciales podrían matizar algunos aspectos de esta interpretación.

El documento también aborda una cuestión especialmente relevante para bibliotecas y universidades: las consecuencias sociales y laborales derivadas de la expansión de la inteligencia artificial generativa. La LCA reconoce que estas tecnologías pueden provocar importantes transformaciones en numerosos sectores profesionales, pero advierte que el derecho de autor no debe utilizarse como herramienta para resolver problemas económicos o laborales que exceden su finalidad. En cambio, propone que las bibliotecas desempeñen un papel activo impulsando programas de alfabetización en inteligencia artificial, formación continua y reciclaje profesional, ayudando a ciudadanos e investigadores a comprender las capacidades, limitaciones y riesgos de estas tecnologías.

La alianza reafirma su compromiso con un sistema de propiedad intelectual equilibrado, que proteja los intereses de los creadores sin obstaculizar el acceso al conocimiento ni el progreso científico. La organización continuará supervisando la evolución de la jurisprudencia y de las políticas públicas para adaptar su posición cuando sea necesario, manteniendo como principio fundamental que el derecho de autor debe seguir promoviendo la creatividad, la investigación y el interés público en un contexto marcado por el desarrollo acelerado de la inteligencia artificial.

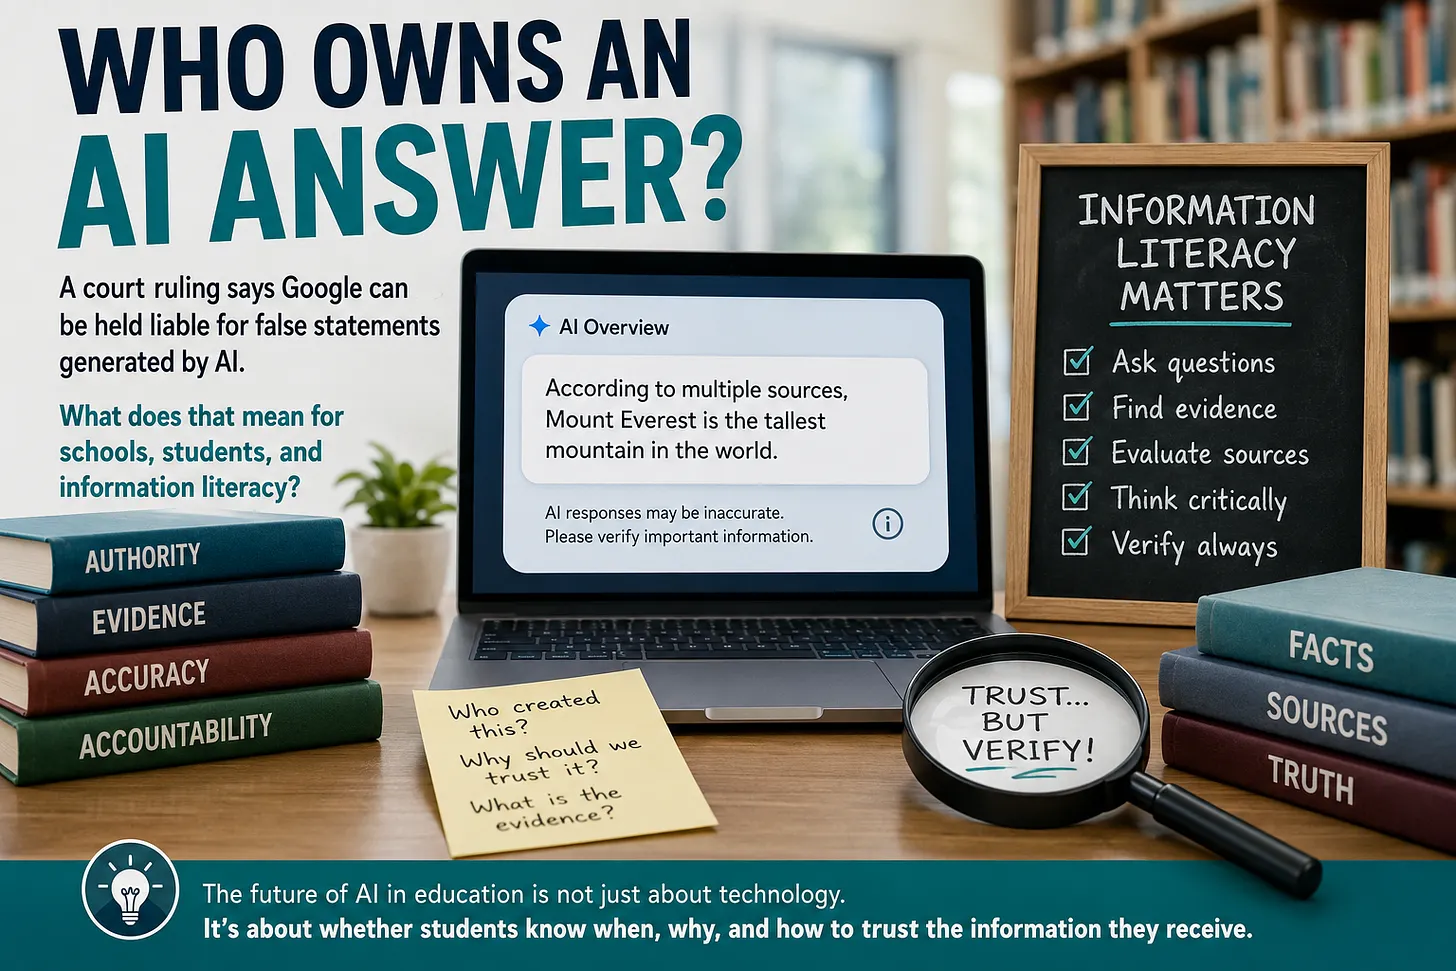
¿Quién es el propietario de una respuesta generada por IA? Un fallo judicial alemán redefine la autoría, la responsabilidad y la confianza en la inteligencia artificial

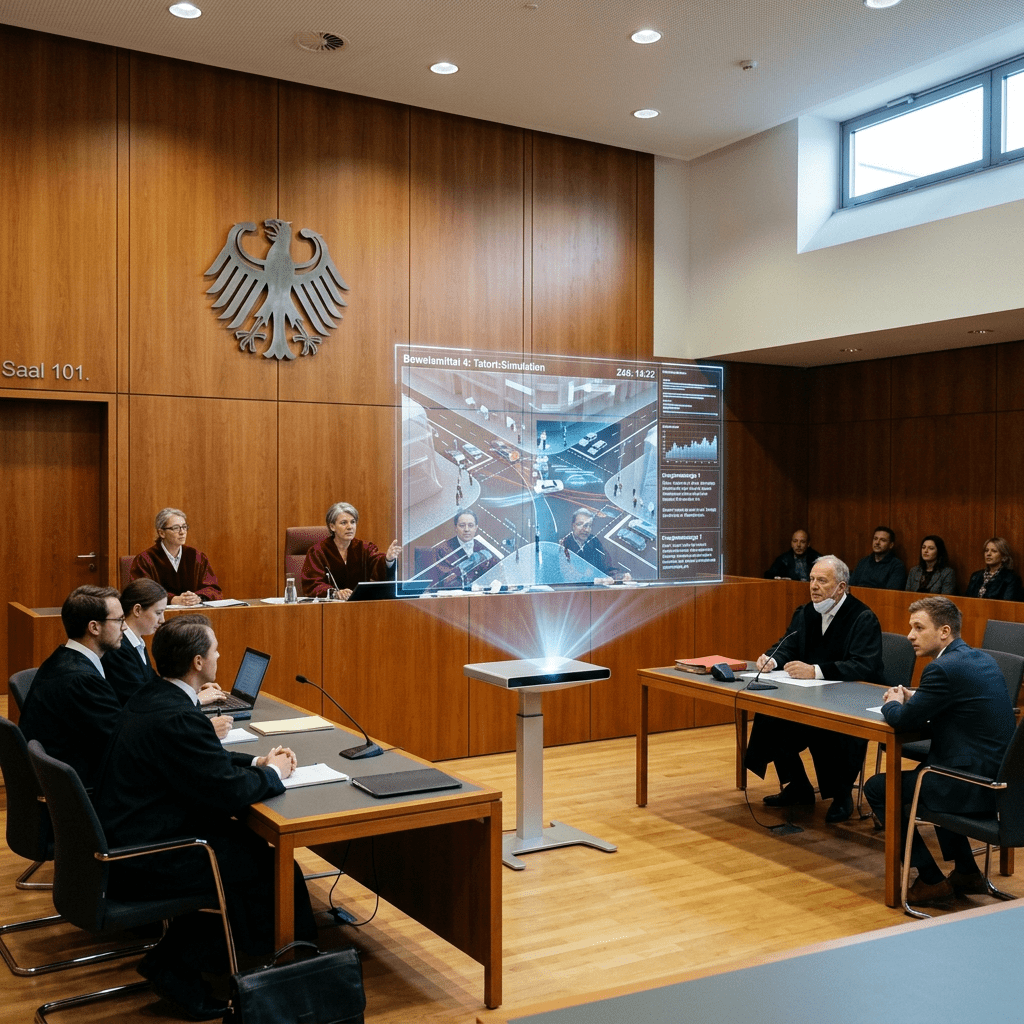
Courtroom with judges and lawyers examining a digital display of a traffic accident reconstruction
Judges and lawyers review a digital reconstruction of a traffic accident in a modern courtroom.

Malespina, E. (2026, 18 de junio). Who Owns an AI Answer? The AI School Librarian (Substack) https://aischoollibrarian.substack.com/p/who-owns-an-ai-answer

El artículo analiza las implicaciones de una reciente sentencia dictada por un tribunal alemán que aborda una cuestión cada vez más relevante: ¿quién es responsable cuando una inteligencia artificial genera una respuesta incorrecta o perjudicial? A partir de este caso, la autora examina cómo las respuestas producidas por sistemas de IA no pueden considerarse simples fragmentos de información sin autor ni responsabilidad. Aunque los modelos generativos producen textos originales en apariencia, su funcionamiento depende de datos de entrenamiento, algoritmos y decisiones de diseño tomadas por empresas y desarrolladores. La resolución judicial pone de manifiesto que, a medida que estas herramientas se integran en la vida cotidiana, resulta imprescindible definir responsabilidades legales y éticas sobre el contenido que generan.

Uno de los argumentos centrales del artículo es que las respuestas de la IA no pertenecen realmente a la máquina. Detrás de cada resultado intervienen múltiples actores: quienes desarrollan el modelo, quienes proporcionan los datos con los que se entrena, las organizaciones que lo implementan y los usuarios que formulan las preguntas. Esta compleja cadena de participación dificulta aplicar los conceptos tradicionales de autoría y propiedad intelectual. Más que preguntarse quién «posee» una respuesta de IA, la autora propone reflexionar sobre quién debe asumir la responsabilidad por su precisión, sus sesgos y sus posibles consecuencias.

El texto destaca que esta cuestión tiene una especial importancia en el ámbito educativo y bibliotecario. Profesores, bibliotecarios y estudiantes recurren cada vez con más frecuencia a herramientas de IA para obtener información, redactar textos o resolver dudas. Sin embargo, cuando una respuesta contiene errores, omite contexto o reproduce información falsa, surge el problema de determinar quién responde por esos fallos. La autora sostiene que la confianza en la IA no puede basarse únicamente en la sofisticación tecnológica, sino que debe apoyarse en mecanismos de transparencia, trazabilidad y verificación de las fuentes.

Asimismo, el artículo subraya que las bibliotecas y los profesionales de la información tienen un papel esencial en este nuevo escenario. Más allá de enseñar a utilizar herramientas de IA, deben fomentar competencias de alfabetización informacional e inteligencia artificial, ayudando a los usuarios a comprender que las respuestas generadas por estos sistemas no constituyen verdades definitivas, sino resultados probabilísticos que requieren contraste con fuentes fiables. La capacidad de evaluar críticamente la información adquiere así una importancia aún mayor que en la era de los motores de búsqueda tradicionales.

Como conclusión, la autora sostiene que el verdadero debate no gira únicamente en torno a la propiedad de las respuestas generadas por IA, sino sobre la responsabilidad y la confianza. La sentencia alemana representa un paso significativo hacia la construcción de un marco jurídico y ético que reconozca que las respuestas de la inteligencia artificial tienen consecuencias reales para las personas. En este contexto, la educación, las bibliotecas y las instituciones públicas desempeñan un papel decisivo para promover un uso informado, crítico y responsable de estas tecnologías.

Propiedad intelectual y tecnologías de la información con Carlos Guervós. Planeta Biblioteca 2027/07/17.

Propiedad intelectual y tecnologías de la información con Carlos Guervós

Planeta Biblioteca 2027/07/17.

ESCUCHAR

Descargar

Carlos Guervós Maíllo es un jurista y alto funcionario del Estado español, perteneciente al Cuerpo Superior de Administradores Civiles del Estado, cuya trayectoria profesional ha estado especialmente vinculada a la propiedad intelectual, las políticas culturales y la Administración pública. A lo largo de su carrera ha ocupado diversos cargos de responsabilidad en la Administración General del Estado, tanto en el ámbito del Ministerio de Cultura como en otros departamentos ministeriales.

En esta entrevista de Radio USAL, Carlos analiza la evolución de la propiedad intelectual desde su experiencia como responsable institucional en la Administración pública y como divulgador especializado. Explica cómo el derecho de autor ha pasado de centrarse en la protección de las obras en soportes tradicionales a enfrentarse a desafíos completamente nuevos derivados de la digitalización, las plataformas globales y, especialmente, la irrupción de la inteligencia artificial generativa. A su juicio, el marco jurídico debe seguir evolucionando para ofrecer seguridad jurídica tanto a los creadores como a quienes desarrollan nuevas tecnologías.

Durante la conversación, Guervós defiende que la propiedad intelectual constituye mucho más que un instrumento jurídico, ya que representa un elemento estratégico para el desarrollo económico, la innovación y la diversidad cultural. Insiste en la necesidad de encontrar un equilibrio entre la protección de los derechos de autores, artistas y editores y el acceso al conocimiento, una cuestión especialmente relevante para bibliotecas, universidades y centros de investigación, que desempeñan un papel esencial en la difusión responsable de la cultura y el conocimiento.

Otro de los ejes de la entrevista es el impacto de la inteligencia artificial sobre los derechos de autor. Guervós reflexiona sobre el uso masivo de obras protegidas para entrenar modelos de IA y subraya la importancia de establecer mecanismos de transparencia sobre los datos utilizados, así como sistemas de compensación y reconocimiento adecuados para los titulares de derechos. Considera que la legislación europea avanza en esa dirección, aunque todavía quedan importantes retos regulatorios por resolver.

La conversación también aborda la transformación de la lucha contra la piratería digital y la necesidad de adaptar las estrategias de protección a un entorno tecnológico en constante cambio. Guervós sostiene que la respuesta no debe limitarse a medidas sancionadoras, sino que debe combinar educación, concienciación, innovación y marcos legales eficaces que favorezcan tanto la creación como el acceso legítimo a los contenidos.

Finalmente, dirige un mensaje a los jóvenes creadores e investigadores, animándolos a innovar, compartir conocimiento y aprovechar las oportunidades que ofrecen las nuevas tecnologías, pero sin perder de vista la importancia de proteger el trabajo creativo y respetar los derechos de propiedad intelectual como base para un ecosistema cultural sostenible.

¿De quién es realmente una respuesta generada por inteligencia artificial? Propiedad intelectual, autoría y dilemas emergentes en la era de la IA

The AI School Librarian. “Who Owns an AI Answer?”. Publicado en Substack, 2026. Disponible en: The AI School Librarian (Substack)

Se aborda una de las cuestiones más complejas surgidas con la expansión de la inteligencia artificial generativa: la propiedad intelectual de los contenidos creados con ayuda de sistemas como ChatGPT, Gemini o Claude. A medida que estas herramientas producen textos, imágenes, código o ideas cada vez más sofisticadas, surge una pregunta central tanto en el ámbito educativo como en el legal: ¿quién puede reclamar la autoría o propiedad de una respuesta producida por una máquina entrenada con datos ajenos?

Durante años, una de las explicaciones más repetidas por las grandes empresas de inteligencia artificial ha sido relativamente sencilla: los sistemas de IA pueden cometer errores. Desde el comienzo, compañías tecnológicas han advertido a sus usuarios que deben contrastar la información generada, verificar las fuentes y mantener una actitud crítica frente a cualquier respuesta producida por estos sistemas. Estas advertencias aparecen de forma habitual en manuales, políticas de uso y declaraciones públicas de prácticamente todas las empresas que desarrollan herramientas de inteligencia artificial.

Sin embargo, una reciente decisión judicial en Alemania parece indicar que esa explicación podría dejar de ser suficiente.

Un tribunal alemán ha dictaminado que Google puede ser considerado legalmente responsable por información falsa generada por su sistema AI Overviews, la función que ofrece resúmenes automáticos en los resultados de búsqueda. El caso se originó cuando el sistema vinculó erróneamente a dos editores con actividades fraudulentas y estafas. La defensa de Google siguió el argumento habitual: la inteligencia artificial puede equivocarse y los usuarios no deberían asumir que todas las respuestas generadas son completamente precisas. El tribunal, sin embargo, rechazó esta justificación.

La relevancia de esta resolución judicial radica en que desplaza el foco del debate. Hasta ahora, gran parte de la discusión sobre inteligencia artificial se había centrado en cómo se entrenan los modelos, qué datos utilizan o si vulneran derechos de autor durante ese proceso. La sentencia introduce otra perspectiva: no importa únicamente cómo funciona la IA internamente, sino también qué tipo de información entrega directamente al usuario y quién asume la responsabilidad cuando esa información resulta falsa o perjudicial.

La cuestión trasciende ampliamente a Google. Durante los últimos años, buena parte del debate sobre inteligencia artificial en educación se ha centrado casi exclusivamente en el comportamiento de los estudiantes: el posible plagio, la integridad académica, el uso adecuado de herramientas generativas o el papel que debe ocupar la IA dentro del aprendizaje. Mucho menos se ha discutido sobre las obligaciones de las empresas tecnológicas cuando sus sistemas generan información errónea y esa información termina afectando a personas reales o condicionando decisiones importantes.

El texto analiza cómo los sistemas de IA generativa funcionan a partir de modelos entrenados sobre enormes cantidades de información extraída de internet, libros, artículos académicos, obras creativas y otros materiales protegidos por derechos de autor. Cuando un usuario introduce una instrucción o prompt, la IA no “crea” en un sentido humano tradicional, sino que genera una respuesta basada en patrones estadísticos aprendidos durante el entrenamiento. Esto complica enormemente la atribución de propiedad, porque la respuesta final puede contener ecos, estructuras o influencias derivadas de miles de obras previas, cuyos autores originales raramente han dado consentimiento explícito para ese uso.

Desde el punto de vista jurídico, el artículo subraya que en muchas legislaciones actuales —especialmente en Estados Unidos y Europa— la protección del copyright exige un grado de creatividad humana identificable. Esto significa que un contenido generado enteramente por inteligencia artificial podría no ser susceptible de protección legal como obra original, o al menos no bajo los marcos tradicionales del derecho de autor. La intervención humana, por tanto, se vuelve decisiva: cuanto mayor sea el nivel de edición, selección, reformulación o dirección creativa del usuario, más sólida resulta su posible reclamación de autoría sobre el resultado final.

El artículo dedica especial atención al ámbito educativo, donde docentes, investigadores y bibliotecarios deben enfrentarse a nuevos escenarios éticos relacionados con el uso de herramientas generativas. Si un estudiante presenta como propio un trabajo elaborado en gran parte por inteligencia artificial, surge un debate no solo sobre plagio, sino sobre autenticidad intelectual y aprendizaje real. Del mismo modo, en la producción académica y editorial aparece la necesidad de establecer criterios transparentes para declarar cuándo un texto ha sido asistido por IA y en qué medida esa asistencia altera la noción tradicional de autor.

La reflexión final plantea que la inteligencia artificial está obligando a redefinir conceptos fundamentales como creación, originalidad, propiedad intelectual y responsabilidad autoral. Más que una simple cuestión tecnológica, el problema revela una transformación profunda en la relación entre conocimiento, producción cultural y derechos de propiedad. En este nuevo escenario, bibliotecas, universidades, editoriales y legisladores deberán desempeñar un papel central en la construcción de marcos éticos y jurídicos capaces de responder a una pregunta cada vez más urgente: cuando una máquina produce conocimiento, ¿a quién pertenece realmente esa creación?

Tensiones y soluciones en la relación propiedad intelectual-investigación abierta

Román Pérez, Raquel de. Tensiones y soluciones en la relación
propiedad intelectual-investigación abierta
. Madrid: Federación Española de Sociedades de Archivística, Biblioteconomía, Documentación y Museística, 2026.

Texto completo

El informe de FESABID defiende que el acceso abierto en España debe consolidarse mediante una combinación de reforma normativa, alfabetización jurídica, apoyo institucional y cambio cultural en la evaluación científica. Su mensaje central es claro: el conocimiento financiado públicamente debe ser accesible públicamente, respetando siempre la autoría y construyendo un sistema más justo, eficiente y democrático de comunicación científica

Este informe de FESABID constituye un análisis jurídico y estratégico sobre la situación del acceso abierto en España, centrado especialmente en la relación entre propiedad intelectual, políticas científicas y difusión del conocimiento. El documento examina cómo el sistema normativo español ha ido incorporando progresivamente los principios de la ciencia abierta, al tiempo que identifica vacíos legales, contradicciones y oportunidades de mejora. Su enfoque resulta especialmente relevante para bibliotecas, universidades, centros de investigación y responsables de políticas públicas.

Uno de los ejes principales del estudio es la evolución legislativa del acceso abierto en España. El informe recuerda que un primer hito fue la Ley de la Ciencia, la Tecnología y la Innovación de 2011, que introdujo la obligación de depositar en repositorios abiertos los resultados de investigaciones financiadas mayoritariamente con fondos públicos. Sin embargo, esa obligación aparecía limitada por las cesiones previas de derechos a editoriales y por un marco poco preciso respecto a mecanismos de cumplimiento. En la práctica, ello significó que muchos investigadores seguían dependiendo de contratos editoriales restrictivos, lo que dificultaba el acceso universal a publicaciones sufragadas con dinero público.

El texto analiza después la reforma posterior de la Ley de la Ciencia, que fortaleció el mandato de acceso abierto y lo alineó con las estrategias europeas de Open Science. El informe subraya que la nueva orientación no se limita ya a artículos científicos, sino que apunta también hacia datos de investigación, metodologías, software y otros productos derivados de la actividad científica. Esto supone un cambio de paradigma: de entender la publicación científica como producto cerrado a concebirla como ecosistema compartido de conocimiento reutilizable.

En materia de propiedad intelectual, FESABID insiste en que el acceso abierto no implica renuncia a los derechos de autor. Al contrario, propone modelos de gestión más flexibles mediante licencias abiertas, especialmente Creative Commons, que permiten preservar la autoría al tiempo que facilitan copia, distribución y reutilización bajo ciertas condiciones. El informe combate así una confusión frecuente: abierto no significa ausencia de derechos, sino ejercicio estratégico de los mismos para favorecer circulación del conocimiento.

Otro aspecto relevante es el análisis del papel de las editoriales científicas comerciales. El documento advierte que, durante años, la cesión exclusiva de derechos por parte de los autores permitió modelos de negocio basados en suscripciones costosas, incluso sobre investigaciones financiadas con fondos públicos. Frente a ello, el acceso abierto busca restituir equilibrio entre inversión pública, derechos de los investigadores e interés general. Se plantea la necesidad de revisar contratos editoriales, promover derechos de retención para autores y fortalecer infraestructuras públicas de publicación académica.

El informe dedica también atención a los repositorios institucionales y temáticos como piezas clave del sistema. Estos espacios no solo almacenan artículos, sino que garantizan preservación digital, visibilidad internacional, interoperabilidad y métricas de impacto alternativas. Las bibliotecas universitarias aparecen aquí como agentes esenciales, ya que gestionan repositorios, asesoran en propiedad intelectual y acompañan a investigadores en procesos de depósito y publicación abierta.

Asimismo, se aborda la dimensión europea e internacional. España no actúa aislada, sino dentro de marcos como Horizon Europe, Plan S y las recomendaciones de UNESCO sobre ciencia abierta. El informe considera imprescindible armonizar la normativa española con estas tendencias para evitar rezagos competitivos y facilitar colaboración científica transnacional. La apertura del conocimiento se presenta no solo como principio ético, sino como condición de innovación y liderazgo científico.

Entre los desafíos pendientes, el texto señala la falta de cultura jurídica entre muchos investigadores, la persistencia de incentivos académicos centrados en revistas de alto impacto cerradas, la heterogeneidad institucional entre universidades y la insuficiente financiación de infraestructuras abiertas. También alerta del riesgo de sustituir el modelo de suscripción por otro basado exclusivamente en APCs (pagos por publicar), que puede generar nuevas desigualdades.

Tensiones entre propiedad intelectual e investigación abierta

Federación Española de Sociedades de Archivística, Biblioteconomía, Documentación y Museística (FESABID). Informe sobre propiedad intelectual y acceso abierto en España. Madrid: FESABID, s. f. https://www.fesabid.org/informe-propiedad-intelectual-acceso-abierto-espana/

El informe pone de relieve los retos actuales y futuros, como la sostenibilidad económica del acceso abierto, el papel de los editores científicos, la necesidad de reformas legislativas y el impacto de tecnologías emergentes como la inteligencia artificial. En conjunto, se plantea la necesidad de avanzar hacia un modelo más abierto, justo y equilibrado, que garantice tanto la protección de los creadores como el acceso universal al conocimiento.

El informe de FESABID aborda la relación compleja entre la propiedad intelectual y el acceso abierto en el contexto español, especialmente en el ámbito de bibliotecas, archivos, museos y centros de investigación. Su punto de partida es la necesidad de encontrar un equilibrio entre la protección de los derechos de autor y el derecho de la ciudadanía a acceder a la cultura, la educación y el conocimiento científico. Este equilibrio se vuelve especialmente relevante en un entorno digital donde la reproducción y difusión de contenidos es más fácil, pero también más conflictiva desde el punto de vista legal.

El acceso abierto se define como un modelo que promueve la disponibilidad libre y gratuita de la producción científica en internet, sin barreras económicas, técnicas o legales. Este modelo, impulsado por iniciativas internacionales como la Declaración de Budapest, busca maximizar el impacto del conocimiento, especialmente cuando ha sido financiado con fondos públicos. En este sentido, el informe subraya que el acceso abierto no implica la ausencia de derechos de autor, sino una gestión más flexible de estos, a menudo mediante licencias abiertas como las Creative Commons, que permiten distintos niveles de reutilización respetando la autoría.

El documento también analiza el marco legal español y europeo, señalando que la legislación de propiedad intelectual sigue siendo un elemento clave que condiciona el desarrollo del acceso abierto. La transposición de la Directiva europea sobre derechos de autor en el mercado único digital introduce nuevos escenarios, como la regulación de la minería de textos y datos, que resulta fundamental para la investigación científica. Estas normativas intentan adaptarse a los cambios tecnológicos, pero al mismo tiempo generan tensiones entre los distintos actores implicados: autores, editores, instituciones y usuarios.

Otro aspecto central es el papel de las instituciones documentales (bibliotecas, archivos y museos), que actúan como mediadoras entre los derechos de propiedad intelectual y el acceso al conocimiento. El informe destaca su función en la creación y gestión de repositorios digitales, la formación de usuarios en derechos de autor y la promoción de políticas de acceso abierto. Estas instituciones no solo facilitan el acceso a la información, sino que también contribuyen a la preservación y difusión del patrimonio cultural y científico.

Los desafíos de la IA en la educación superior y las respuestas institucionales: ¿hay espacio para marcos de competencias?

Valentini, Arianna & Blancas, Alep (2025). The challenges of AI in higher education and institutional responses: is there room for competency frameworks? París: UNESCO / Instituto Internacional de la UNESCO para la Educación Superior en América Latina y el Caribe (IESALC). 35 p

Texto completo

El documento analiza críticamente cómo la inteligencia artificial (IA) está transformando el ámbito de la educación superior y se centra en la pregunta clave de si las instituciones educativas cuentan con marcos de competencias adecuados para enfrentar estos cambios, o si es necesario desarrollar estructuras más sólidas y coherentes para ello. Partiendo de una revisión de literatura internacional y un inventario global de iniciativas institucionales, el informe evalúa la preparación de estudiantes, docentes y personal administrativo frente a un entorno educativo cada vez más dominado por la IA.

Un aspecto central del análisis es la insuficiencia de enfoques fragmentados que privilegian el uso de herramientas tecnológicas aisladas (como generadores de texto o sistemas de apoyo automático). En cambio, los autores sostienen que las instituciones deben adoptar estrategias educativas integrales y políticas robustas que vinculen la IA con objetivos pedagógicos, inclusión, equidad, interdisciplinariedad y la investigación científica. Esta perspectiva busca superar la visión limitada de la IA como simple herramienta operativa y promover su incorporación como elemento estratégico del currículum y de la gestión institucional.

El documento pone de manifiesto que, aunque existe un creciente interés por incorporar IA en la educación superior, hay una notable falta de marcos de competencias formalizados que guíen la formación tanto de estudiantes como de docentes y gestores académicos. Se identifica que muchos programas educativos no preparan adecuadamente a los futuros graduados para un mercado laboral y social en el que la IA es ubicua, y tampoco se ofrecen directrices claras para que el personal docente integre la IA de manera ética y pedagógicamente fundamentada. Para abordar estas carencias, el informe propone el desarrollo de marcos de competencias que articulen conocimientos, habilidades y valores relacionados con la IA, así como recomendaciones para su implementación sistemática en las estructuras de la educación superior.

¿Quién es el propietario de qué en lo que respecta a la IA y la propiedad intelectual?

Sharma, Seemantani. 2025. “Who owns what when it comes to AI and intellectual property?World Economic Forum, octubre 2025. https://www.weforum.org/stories/2025/10/intellectual-property-ai-human-creativity-ownership/

La cuestión de si las creaciones generadas por inteligencia artificial (IA) pueden considerarse objeto de propiedad intelectual, cuestionando si una IA puede ser reconocida como “autora” o “inventora”. Señala que los sistemas actuales de IA, por más sofisticados que sean, no tienen conciencia, experiencia subjetiva ni intencionalidad, lo que —según las teorías tradicionales de derechos de autor y patentes— impide que sean titulares de derechos.

La IA ya genera arte, diseña medicamentos e imita la imaginación humana. Esto plantea una pregunta fundamental. ¿Quién, si es que hay alguien, es el verdadero propietario de estas creaciones? ¿Se puede considerar a la IA como autora o inventora? ¿O los derechos pertenecen exclusivamente a los seres humanos?

Históricamente, los regímenes de propiedad intelectual (derechos de autor, patentes, marcas) se han fundamentado en la idea de creatividad humana: un autor humano ejerce un trabajo intelectual que refleja su personalidad, identidad o esfuerzo mental. Como una máquina no realiza ese tipo de “labor” en sentido humano —no tiene un “yo”, emociones o conciencia—, la ley hasta ahora considera que los resultados generados por IA pertenecen, en última instancia, a personas humanas, si es que hay un autor humano que haya intervenido.

El artículo destaca que muchas de las creaciones producidas por IA —arte, diseños, descubrimientos— pueden ser sorprendentes y funcionales, pero carecen del contexto emocional, intencional y experiencial que caracteriza la creatividad humana. Por tanto, aunque la IA pueda “producir” cosas, no puede reemplazar la acción creativa humana. En consecuencia, seguir otorgando la autoría a seres humanos protege la responsabilidad, la dignidad, la identidad y la justicia en el reconocimiento del trabajo intelectual.

Sin embargo, los autores del artículo advierten de que la creciente sofisticación de la IA y su uso masivo para generar contenido plantea un desafío real al marco legal tradicional. Podría ser necesario repensar la noción de propiedad intelectual: considerar modelos de propiedad compartida, nuevas categorías legales o marcos normativos que reconozcan la colaboración entre humanos y máquinas, sin perder de vista la protección de los derechos humanos y creativos. La decisión que tomemos hoy definirá el futuro de la autoría, la innovación y el valor de la creatividad en la era de la IA.

Hasta el 70 % de las escuchas de música en Deezer son realizadas por bots de IA para cobrar regalías

Deezer. “Up to 70% of Streams of AI-Generated Music on Deezer Are Fraudulent, Says Report.The Guardian, 18 junio 2025

Siete de cada diez reproducciones de música generada por inteligencia artificial en la plataforma Deezer son fraudulentas, según la plataforma francesa de streaming.

Un informe reciente de Deezer advierte que hasta el 70 % de las reproducciones de canciones generadas íntegramente por inteligencia artificial (IA) en la plataforma son fraudulentas. Estas escuchas corresponden a bots u otras formas de manipulación destinadas a inflar las cifras y obtener regalías de manera indebida. Aunque las pistas creadas con IA suponen apenas el 0,5 % del total de reproducciones, su presencia es mucho más significativa en el volumen de cargas diarias: alrededor de 20.000 temas al día, lo que representa el 18 % de todas las canciones subidas.

Para hacer frente a esta situación, Deezer asegura disponer de herramientas capaces de identificar con total precisión los contenidos producidos por modelos como Suno y Udio. Los temas detectados como totalmente artificiales se etiquetan de forma explícita, quedan fuera de las recomendaciones algorítmicas y de las listas editoriales, y además, las reproducciones fraudulentas que generan no se contabilizan para el pago de regalías.

Deezer afirmó que la música generada por IA que los estafadores transmitían iba desde pop y rap falsos hasta pistas musicales artificiales que estimulaban el estado de ánimo. La plataforma ha decidido bloquear el pago de regalías por las reproducciones que ha identificado como fraudulentas.

En su último informe global sobre música, la IFPI afirmó que el streaming fraudulento roba dinero que «debería destinarse a artistas legítimos». Añadió que la IA generativa había «exacerbado significativamente» el problema.

El año pasado, el músico estadounidense Michael Smith fue acusado en relación con un plan para crear cientos de miles de canciones generadas por IA y reproducirlas miles de millones de veces, obteniendo 10 millones de dólares en regalías.

Según Thibault Roucou, director de regalías de la compañía, muchas de estas canciones creadas de manera automática carecen de una verdadera motivación artística y responden únicamente al ánimo de lucro mediante la manipulación del sistema.