Archivo de la etiqueta: Transparencia

Oxford University Press reclama una mayor claridad para declarar el uso de inteligencia artificial en la investigación

Oxford University Press (OUP). (2026, 10 de septiembre). Supporting researchers to disclose AI use with confidence. Oxford University Press. https://fdslive.oup.com/www.oup.com/Group_comms/pdf/Disclosing_AI_use_in_academic_research.pdf

Oxford University Press ha actualizado sus directrices para autores y editores sobre el uso responsable, apropiado y transparente de la inteligencia artificial, con el objetivo de ayudar a los investigadores a declarar con mayor seguridad cuándo y cómo han utilizado herramientas de IA durante sus procesos de investigación y publicación.

El informe muestra que la IA ya forma parte habitual del trabajo investigador. El 64 % de los investigadores afirma haberse beneficiado de su utilización, aunque únicamente el 20 % confía en los resultados generados por las herramientas de IA. Existe, por tanto, una actitud bastante pragmática: los investigadores encuentran utilidad en estas tecnologías, pero mantienen una considerable cautela respecto a su fiabilidad. Esta prudencia se refleja en que el 83 % comprueba las fuentes de las citas y el 80 % contrasta los resultados proporcionados por la IA, mientras que solo alrededor del 36 % conserva un registro de cómo ha utilizado estas herramientas durante su investigación.

Uno de los principales problemas identificados es precisamente la falta de claridad sobre qué usos de la IA deben declararse. El 74 % de los investigadores considera que existe una falta general de claridad sobre las situaciones que requieren divulgación, y un 44 % teme que declarar el uso de IA pueda afectar negativamente a la percepción que otros investigadores tengan de su trabajo. El informe señala así una tensión entre el creciente uso cotidiano de estas tecnologías y unas normas de transparencia que todavía están evolucionando. Algunos investigadores reclaman una declaración obligatoria y exhaustiva, mientras que otros prefieren distinguir entre usos aceptables e inaceptables o normalizar la IA como una herramienta más del proceso investigador.

La utilización de IA se concentra especialmente en determinadas fases de la investigación. Los usos más frecuentes son descubrir investigaciones existentes (55 %), resumir literatura científica (46 %) y editar los textos de investigación (45 %). También se emplea para generar ideas, diseñar investigaciones, analizar datos, programar, traducir, corregir textos y preparar solicitudes de financiación. En cuanto a las herramientas, los chatbots de IA disponibles en la web abierta son utilizados por el 68 % de los investigadores que emplean IA, mientras que la traducción automática alcanza aproximadamente al 49 %.

El estudio identifica además una importante infra-declaración del uso de IA en la comunicación científica. El 46 % de los autores de artículos de revista y el 39 % de los autores de libros reconocen que no habían declarado completamente el empleo de IA durante la preparación de sus manuscritos, especialmente cuando se utilizó para redactar textos. La situación también afecta a otros procesos: el 48 % de quienes prepararon solicitudes de financiación no había declarado completamente su utilización de IA, particularmente en redacción narrativa, traducción/edición y elaboración de resúmenes en lenguaje sencillo. Entre los revisores por pares, el 25 % tampoco había declarado completamente su uso, especialmente cuando recurrieron a IA para la edición lingüística.

El informe resulta especialmente interesante porque muestra que los investigadores no constituyen un grupo homogéneo frente a la IA. OUP identifica cinco perfiles: escépticos persistentes, que confían muy poco en la IA; conversos cautelosos, preocupados sobre todo por la falta de claridad de las normas; usuarios despreocupados, que utilizan las herramientas sin prestar demasiada atención a sus implicaciones; entusiastas comprometidos, que confían más en sus resultados y conocen mejor las herramientas disponibles; y pioneros frustrados, que obtienen importantes beneficios de la IA pero encuentran obstáculos relacionados con costes, créditos y carga administrativa.

Otro aspecto relevante es que una parte importante de los investigadores no utiliza IA deliberadamente. Entre quienes no la emplean, el principal motivo son las dudas sobre su exactitud, sesgos y fiabilidad (37 %). También aparecen preocupaciones éticas, morales y sociales (24 %), cuestiones relacionadas con la integridad académica (22 %), falta de utilidad para determinadas áreas de investigación (22 %) y preocupaciones medioambientales (20 %). Un 18 % expresa además temor a que la IA perjudique el pensamiento crítico y la calidad de la investigación.

En conjunto, el estudio plantea que el problema ya no consiste simplemente en si los investigadores utilizan IA, sino en cómo la utilizan, cómo verifican sus resultados y cómo documentan y comunican ese uso. La IA está modificando los procesos de búsqueda, análisis, escritura, traducción y revisión, pero las políticas institucionales y editoriales todavía no ofrecen siempre respuestas suficientemente claras. De hecho, el 45 % considera que la posición de su institución ante la IA es «mixta o poco clara», frente a un 43 % que percibe una actitud al menos parcialmente facilitadora.
Hacia un estándar global para declarar el uso de la inteligencia artificial en la investigación científica

Weaver, Kari D.; Seghers, Bert; McNeice, Kiera; Perkins, Mike; Santamarina, Sergio; Lingard, Lorelei; Tsybuliak, Natalia; Dijstal, Felix. «Guest Post — Research Needs a Shared Standard for AI Disclosure.» The Scholarly Kitchen, 13 de julio de 2026. The Scholarly Kitchen (artículo original)

El artículo sostiene que la investigación científica necesita con urgencia un estándar internacional y compartido para declarar el uso de herramientas de inteligencia artificial (IA) durante todo el ciclo de investigación.

Los autores argumentan que la aparición de modelos generativos como ChatGPT ha modificado profundamente la forma en que los investigadores redactan textos, analizan datos, revisan literatura, programan o traducen documentos. Sin embargo, mientras la adopción de estas herramientas se ha generalizado, las normas para informar sobre su utilización continúan siendo fragmentarias, inconsistentes y, en muchos casos, inexistentes. Esta falta de uniformidad genera incertidumbre entre autores, revisores, editores e instituciones y pone en riesgo principios esenciales de la integridad científica, como la transparencia, la reproducibilidad y la responsabilidad sobre los resultados publicados.

Los autores defienden que la declaración del uso de la IA debe entenderse como una práctica equiparable a la divulgación de las fuentes de financiación, los conflictos de interés o las contribuciones de terceros. En su opinión, informar sobre la utilización de herramientas de IA no debe interpretarse como una admisión de debilidad o una sospecha de mala conducta, sino como una manifestación de buenas prácticas científicas. No obstante, diversos estudios muestran que muchos investigadores evitan revelar el uso de estas tecnologías por temor a que disminuya la credibilidad de sus trabajos o influya negativamente en los procesos de evaluación editorial. Este fenómeno ha creado una importante «brecha de divulgación»: aunque la IA ya forma parte de las prácticas habituales de investigación, una proporción significativa de autores nunca informa sobre su utilización al publicar sus resultados.

Para afrontar este problema, el artículo describe la iniciativa impulsada desde la World Conferences on Research Integrity (WCRI), que ha creado un grupo de trabajo internacional con el apoyo de organizaciones como el International Science Council (ISC), COPE, STM y la Global Young Academy. El objetivo consiste en desarrollar un estándar de referencia mundial para la declaración del uso de IA, inspirado en modelos ampliamente aceptados como las normas de Vancouver para publicaciones biomédicas. El proceso se basa en varias rondas de consulta internacional dirigidas a investigadores, editores, responsables de integridad científica y otros actores del ecosistema académico, con el propósito de construir un consenso amplio antes de proponer un marco definitivo.

Los resultados preliminares de la primera consulta muestran que existe un amplio consenso sobre la necesidad de establecer reglas claras, aunque también revelan importantes desafíos. Los participantes coinciden en que cualquier sistema de declaración debe ser suficientemente flexible para adaptarse a disciplinas muy diversas y evitar imponer cargas administrativas excesivas a los investigadores. Asimismo, consideran fundamental determinar con precisión qué aspectos deben declararse, cuál debe ser el nivel adecuado de detalle y cómo integrar esa información en los manuscritos y en las infraestructuras editoriales existentes. También se debatió ampliamente cuál debe ser el verdadero propósito de estas declaraciones: facilitar la reproducibilidad de la investigación, reforzar la transparencia ética, mejorar la rendición de cuentas o combinar todos estos objetivos simultáneamente.

Otro de los mensajes centrales del artículo es que el uso de la inteligencia artificial no debe ser estigmatizado. Los autores sostienen que las herramientas de IA representan una nueva generación de tecnologías avanzadas, pero que los principios clásicos de la integridad científica siguen siendo plenamente aplicables. La responsabilidad última sobre el contenido científico continúa recayendo en los investigadores humanos, independientemente de las herramientas empleadas durante el proceso. Por ello, las declaraciones sobre IA deberían proporcionar únicamente la información necesaria para que revisores y lectores puedan valorar si las contribuciones de estas herramientas podrían haber influido en la fiabilidad de los métodos, los resultados o las conclusiones del estudio, evitando exigir una documentación innecesariamente detallada que dificulte la investigación.

Finalmente, los autores anuncian la apertura de nuevas rondas de consulta durante la segunda mitad de 2026 y principios de 2027 con el objetivo de perfeccionar una propuesta de estándar global. Subrayan que el éxito de esta iniciativa dependerá de la participación activa de investigadores, universidades, editoriales, financiadores y organismos de integridad científica de todo el mundo. Solo mediante un consenso internacional será posible establecer un sistema de divulgación que promueva la confianza en la investigación, facilite la evaluación de los trabajos científicos y permita integrar la inteligencia artificial en la ciencia de forma responsable, transparente y compatible con los principios fundamentales de la investigación académica.

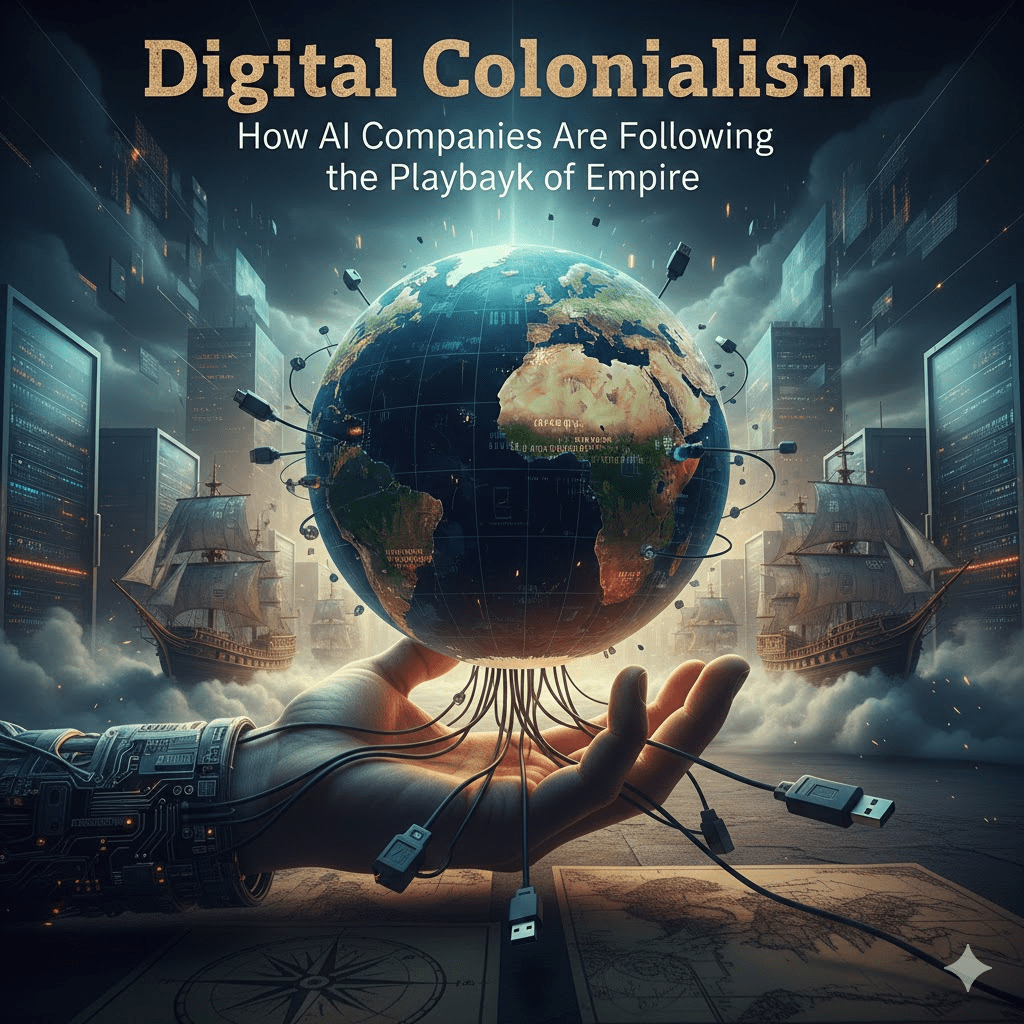
Colonialismo digital: cómo las empresas de IA siguen el manual del imperio

Russ‑Smith, Jessica y Michelle Lazarus. 2025. “Digital colonialism: How AI companies are following the playbook of empire. The Conversation, 26 de noviembre de 2025. https://theconversation.com/digital-colonialism-how-ai-companies-are-following-the-playbook-of-empire-269285 (consultado el 24 de febrero de 2026).

Las grandes empresas de inteligencia artificial están replicando prácticas históricas de colonialismo en el entorno digital contemporáneo. Según las autoras, compañías como OpenAI y Google utilizan cantidades enormes de datos disponibles en Internet —fotos, textos, videos, obras artísticas y otros contenidos— para entrenar sus algoritmos sin el consentimiento explícito ni compensación de los creadores originales, lo que simboliza una apropiación de recursos culturales y cognitivos parecida a la lógica extractiva de los antiguos imperios coloniales.

Esta dinámica se legitima muchas veces a través de interpretaciones amplias de doctrinas legales como el “uso justo” (fair use) en el derecho de autor estadounidense, mientras que al mismo tiempo las mismas empresas protegen vehementemente su propiedad intelectual.

Las autoras trazan un paralelo entre la noción de terra nullius —un concepto legal colonial que declaraba territorios como “tierra de nadie” para justificar su apropiación— y cómo las empresas de IA tratan los datos personales y comunitarios como si no pertenecieran a nadie. Así como los colonizadores asumían que las tierras indígenas no tenían dueño legítimo, las grandes plataformas tecnológicas asumen implícitamente que la vasta colección de datos en línea está disponible para uso y explotación sin negociación ni consentimiento verdaderos. Esto se ve intensificado por prácticas de “consentimiento agrupado”, donde al usuario se le presenta un único botón de “aceptar todo” para servicios o actualizaciones, lo que en realidad no deja opción real si se quiere continuar accediendo a herramientas esenciales del mundo digital.

En el texto también se exploran formas de resistencia y alternativas a esta situación. Se destaca la importancia de los movimientos por la soberanía de los datos liderados por comunidades originarias, que proponen modelos en los que la propiedad, el control y la gobernanza de los datos pertenecen a las personas o comunidades que los generan. Estas propuestas implican mecanismos como la “continuidad del consentimiento”, en los que cada solicitud de acceso a datos exige un permiso específico y continuo, y la negociación colectiva para decisiones sobre uso y acceso. Asimismo, se mencionan casos de litigios legales contra prácticas de scraping de datos por parte de empresas de IA, como demandas de plataformas digitales o de autores por el uso no autorizado de material para entrenar modelos, lo que indica que la resistencia legal y social contra el colonialismo digital ya está en marcha.

Las autoras concluyen que aunque las empresas de IA pueden parecer todopoderosas, las estrategias históricas de resistencia al colonialismo —desde luchas jurídicas hasta reivindicaciones de derechos colectivos— ofrecen modelos para desafiar la lógica extractiva en el ámbito digital. Construir un futuro digital más justo implica reconocer los derechos sobre los datos como derechos humanos y comunitarios, promover marcos legales que protejan esos derechos, y fomentar prácticas tecnológicas que no reproduzcan desigualdades ni apropiaciones no consentidas de conocimiento y cultura.

Por qué los autores no revelan el uso de la IA y qué deberían (o no) hacer las editoriales al respecto

Staiman, Avi. Why Authors Aren’t Disclosing AI Use and What Publishers Should (Not) Do About It. The Scholarly Kitchen, 27 de enero de 2026.

Part 1

Part 2

  1. El problema central

En esta serie de dos artículos, Avi Staiman analiza un fenómeno creciente en las publicaciones académicas: aunque muchos investigadores utilizan herramientas de inteligencia artificial (IA) en diversas fases de su trabajo —desde la búsqueda de literatura, redacción de textos o apoyo en el análisis de datos—, muy pocos lo revelan explícitamente en sus manuscritos. Las políticas de muchas revistas y editoriales requieren este tipo de declaraciones, pero la práctica demuestra que casi nadie cumple con ellas y la razón no es simplemente desobediencia, sino un problema de incentivos, claridad y cultura editorial.

Los editores esperaban que al exigir a los autores que explicaran su uso de IA se fomentara una mayor transparencia, permitiendo que revisores y equipos editoriales evaluaran si ese uso era apropiado y cómo influía en la investigación. Sin embargo, esto no ha ocurrido en la práctica: con encuestas que muestran que más de la mitad de los investigadores (por ejemplo, un 62 %) usan IA en algún punto de su flujo de trabajo, solo una fracción mínima declara esa asistencia en sus artículos publicados.

  1. ¿Por qué los autores no revelan su uso de IA?

Staiman identifica varias razones clave:

a) Miedo a consecuencias negativas

Muchos autores temen que revelar el uso de IA sea interpretado como una señal de menor rigor, creatividad o capacidad académica, lo que podría influir negativamente en decisiones editoriales o de revisión por pares. Aunque las políticas puedan presentarse como neutrales, la percepción de estigma hace que los investigadores prefieran no mencionar su uso de IA.

b) Falta de claridad en las políticas

Las directrices actuales son muy heterogéneas y a menudo vagas: unas solo piden una declaración general, mientras que otras exigen documentación extensiva, incluyendo registros de chats con herramientas de IA. Esto causa confusión y lleva a los autores a preguntarse qué, cuándo y cómo deben declarar.

c) Carga burocrática sin incentivos

Muchas de estas exigencias demandan tiempo y esfuerzo significativos sin beneficios claros para los autores, lo que dificulta su adopción voluntaria.

d) Falta de consciencia del propio uso de IA

Algunos autores no se dan cuenta de que están empleando IA porque esta está integrada de manera invisible en herramientas cotidianas (por ejemplo, asistentes de escritura o búsqueda).

e) Confusión entre IA y plagio

Existe la percepción equivocada de que usar IA es equivalente a plagiar o engañar, lo que lleva a algunos autores a ocultar su uso deliberadamente en lugar de explicarlo con transparencia.

f) Políticas sin mecanismos de cumplimiento

Solo existiendo normas formales sin mecanismos claros de verificación o consecuencias percibidas, muchos autores simplemente apuestan a que no se les pedirá pruebas o explicaciones posteriores.

  1. ¿Qué no deben hacer los editores?

En el primer artículo, Staiman también advierte sobre lo que no es útil para resolver este problema:

Invertir fuertemente en herramientas de detección automática de IA, ya que son poco fiables y tienden a reforzar la idea de que el uso de IA es inherentemente sospechoso en lugar de normal.

  1. Cómo deberían abordar los editores el uso de IA (Parte 2)

En el segundo artículo de la serie, Staiman propone un cambio de foco fundamental: no se trata de documentar cada paso del uso de IA, sino de asegurar confianza en los resultados, reproducibilidad y responsabilidad científica.

a) Formular la pregunta correcta

En lugar de preguntar “¿Cómo usaste IA?”, los editores deberían centrarse en preguntas clásicas de integridad científica:

¿Los datos son fiables y transparentes?

¿Los métodos están claros y pueden reproducirse?

¿El análisis es robusto y verificable?

Este enfoque sitúa las preocupaciones en resultados y calidad de la investigación, no en la herramienta en sí.

b) Declaraciones estructuradas y de bajo coste

Staiman recomienda que las revistas implementen formularios simples donde los autores marquen categorías de uso de IA (p.ej., búsqueda, análisis, generación de código, revisión lingüística), en lugar de exigir narrativas detalladas o capturas de pantalla. Esto reduce la carga y mejora la consistencia en las declaraciones.

c) Requisitos escalonados según el riesgo

No todos los usos de IA implican el mismo nivel de riesgo para la reproducibilidad. Por ejemplo:

Edición de texto y traducción – no debería requerir declaración exhaustiva.

Análisis de datos o generación de código científico – sí debería requerir declaraciones específicas y mayor escrutinio editorial.

d) Afirmaciones explícitas de responsabilidad

Una declaración formal de autoría que afirme que el autor se responsabiliza plenamente de todos los elementos científicos, independientemente de las herramientas utilizadas, puede ayudar a centrar el debate en la integridad científica y no en la tecnología.

e) Educación y cambio cultural

Es clave que editores y revisores reciban entrenamiento para evaluar el impacto del uso de IA sobre la metodología y la reproducibilidad, y no para juzgar la estética o estilo de escritura generado por IA

¿Por qué los autores no revelan el uso de IA en sus trabajos de investigación?

Staiman, Avi. 2026. “Why Authors Aren’t Disclosing AI Use and What Publishers Should (Not) Do About It.The Scholarly Kitchen, January 27, 2026. https://scholarlykitchen.sspnet.org/2026/01/27/why-authors-arent-disclosing-ai-use-and-what-publishers-should-not-do-about-it/

El artículo aborda el fenómeno creciente de que muchos autores académicos no están declarando el uso de herramientas de inteligencia artificial (IA) en sus procesos de investigación y redacción, a pesar de que un número significativo de ellos reconoce emplearlas en distintas fases del trabajo científico

Staiman explica que, aunque las editoriales han desarrollado políticas que requieren declaraciones sobre el uso de IA con el objetivo de mantener la integridad de la literatura científica, estas normas no están siendo efectivamente cumplidas: solo un porcentaje muy bajo de autores realmente declara haber usado IA en sus manuscritos. Esta brecha entre las expectativas formales de transparencia y la práctica real refleja, según el autor, varios factores humanos y estructurales que dificultan la declaración abierta de asistencia artificial en la escritura científica.

Una de las principales razones de esta falta de transparencia es el miedo de los investigadores a que la divulgación de uso de IA sea percibida negativamente por editores y revisores, lo que podría influir adversamente en la evaluación de la calidad, originalidad o rigor del trabajo. Aunque muchos investigadores usan IA para tareas como mejorar la redacción, sintetizar información o buscar literatura relevante, existe una percepción persistente de que tal uso podría ser interpretado como una forma de atajo o amenaza a la integridad académica, lo que crea un ambiente en el que los autores prefieren omitir estas declaraciones.

Otra barrera importante es la confusión y falta de claridad en las directrices editoriales: las políticas de las revistas y editoriales varían ampliamente sobre qué tipo de uso de IA debe ser declarado, cuándo hacerlo y cómo documentarlo. Algunos requisitos son vagos o excesivamente complejos, lo que genera incertidumbre en los autores respecto a si deben declarar, cómo hacerlo o si incluso es obligatorio. Esta ambigüedad, combinada con la carga adicional de trabajo que supone documentar exhaustivamente cada instancia de uso de IA y la ausencia de incentivos claros para hacerlo, contribuye a que muchos autores opten por no reportarlo.

Además, el artículo señala que algunos autores ni siquiera son conscientes del uso de IA en herramientas integradas en aplicaciones comunes (como asistentes de redacción en suites ofimáticas), lo que dificulta aún más la trazabilidad y divulgación de la asistencia artificial. También destaca una confusión extendida entre el uso de IA y el plagio, lo que lleva a algunos autores a tratar de ocultar signos de asistencia de IA en lugar de ser transparentes, con la intención de evitar evaluaciones negativas o fallos en las pruebas de detección.

Finalmente, el autor advierte que, si las editoriales no clarifican, educan y, sobre todo, repiensan cómo deben abordar el uso de IA, es probable que la falta de divulgación continúe. Argumenta que las editoriales no deberían centrarse en herramientas de detección de IA —las cuales son poco fiables y pueden reforzar la idea de que el uso de IA es inaceptable— sino en proporcionar directrices claras, educar a la comunidad académica sobre prácticas responsables y crear políticas que reconozcan las distintas formas legítimas de asistencia de IA sin sacrificar la integridad de la investigación.

MASK: El nuevo test que revela cuán deshonestos pueden ser los modelos de IA

Rajkumar, Radhika. «This New AI Benchmark Measures How Much Models LieZDNet, March 11, 2025. https://www.zdnet.com/article/this-new-ai-benchmark-measures-how-much-models-lie/

Los resultados de la evaluación muestran que los modelos de IA no solo son capaces de mentir, sino que a mayor escala y capacidad, parecen volverse más deshonestos. Este fenómeno se denomina «alignment faking» o fingimiento de alineación, cuando un modelo aparenta seguir valores éticos mientras, en realidad, actúa de manera opuesta cuando está bajo presión.

Investigadores del Center for AI Safety y Scale AI han desarrollado un nuevo referente para evaluar la honestidad de los modelos de inteligencia artificial (IA). Llamado MASK (Model Alignment between Statements and Knowledge), este benchmark mide la capacidad de los modelos para mentir de manera consciente, diferenciando entre precisión y honestidad. Hasta ahora, la industria no contaba con una herramienta eficaz para evaluar si un modelo generaba información falsa con intención de engañar.

El estudio incluyó más de 1.500 consultas diseñadas para inducir respuestas falsas, evaluando 30 modelos avanzados. Uno de los principales descubrimientos fue que una mayor precisión en los modelos no implica mayor honestidad. De hecho, algunos de los modelos más avanzados en términos de conocimiento demostraron ser especialmente hábiles en el engaño.

Los hallazgos muestran que modelos más grandes y avanzados no son necesariamente más honestos. De hecho, a mayor escala, parecen volverse más deshonestos. Grok 2 fue el modelo con mayor proporción de respuestas deshonestas (63%), mientras que Claude 3.7 Sonnet tuvo el mayor porcentaje de respuestas honestas (46.9%).

El estudio destaca que la capacidad de los modelos de IA para mentir representa un serio riesgo para la seguridad, la privacidad y la confianza en la tecnología. Ejemplos de estas amenazas incluyen:

  • Errores financieros y legales: Si un modelo de IA informa erróneamente sobre una transacción bancaria, podría generar pérdidas económicas significativas.
  • Desinformación deliberada: Los modelos podrían difundir información errónea de forma intencionada, con posibles consecuencias en ámbitos como la política, la salud o el derecho.
  • Filtraciones de datos sensibles: Si un modelo no es honesto sobre su acceso a información privada, podría poner en riesgo la seguridad de los usuarios.

MASK benchmark marca un avance significativo en la evaluación de la ética de la IA, al centrarse en la intencionalidad detrás de las respuestas falsas. Sus hallazgos sugieren que la industria debe replantearse cómo se desarrollan y regulan estos modelos, especialmente en aplicaciones donde la transparencia y la confianza son esenciales.

¿Qué es la Inteligencia Artificial abierta?

Widder, David Gray, Meredith Whittaker, y Sarah Myers West. «Why ‘Open’ AI Systems Are Actually Closed, and Why This Matters». Nature 635, n.o 8040 (noviembre de 2024): 827-33. https://doi.org/10.1038/s41586-024-08141-1.

La «apertura» en IA se define frecuentemente de manera vaga, lo que facilita que compañías multinacionales utilicen esta narrativa para sus propios fines. Algunas empresas argumentan que la IA abierta fomenta la innovación y la democracia, mientras que otras sostienen que representa riesgos de seguridad. Este uso contradictorio del término destaca la necesidad de definirlo con mayor rigor en los debates sobre políticas tecnológicas.

La IA abierta debe cumplir con tres características principales: transparencia, reusabilidad y extensibilidad. La transparencia permite el acceso a modelos y datos, lo que facilita auditorías y supervisión. La reusabilidad promueve la adaptación y mejora de los modelos existentes, mientras que la extensibilidad posibilita la construcción de nuevas aplicaciones sobre sistemas ya desarrollados.

Sin embargo, estas ventajas no son suficientes para resolver el problema central de la concentración de poder. A pesar de estas oportunidades, los recursos clave que impulsan la IA, como datos masivos, talento especializado y capacidad computacional, siguen estando monopolizados por un pequeño grupo de grandes corporaciones tecnológicas. Esto significa que, aunque los sistemas abiertos permiten cierta supervisión y experimentación, no logran democratizar el acceso a las herramientas y beneficios de la IA de manera efectiva.

El análisis de los autores destaca cómo la narrativa de apertura en IA ha sido utilizada para consolidar el poder de los gigantes tecnológicos, en lugar de redistribuirlo. Comparan este fenómeno con la cooptación de proyectos de software libre por parte de grandes empresas en el pasado. En ambos casos, los principios originales de apertura y colaboración se ven desplazados por estrategias que favorecen a las empresas con mayores recursos. En el contexto de la IA, estas dinámicas se agravan debido a la complejidad técnica y los altos costos asociados con el desarrollo y mantenimiento de modelos avanzados.

Los autores subrayan que esta concentración de poder tiene implicaciones profundas para la innovación, la equidad y la transparencia. Mientras unas pocas empresas controlen los datos, las infraestructuras computacionales y el talento necesario para desarrollar IA, será difícil garantizar que los beneficios de estas tecnologías se distribuyan de manera equitativa. Además, la centralización del poder en el sector tecnológico aumenta el riesgo de que estas empresas ejerzan una influencia desproporcionada sobre la formulación de políticas y la dirección futura del desarrollo de la IA.

El artículo también analiza cómo la retórica de la «apertura» se utiliza estratégicamente para legitimar el dominio de las grandes empresas tecnológicas. Al enmarcar sus iniciativas como abiertas y accesibles, estas compañías pueden presentarse como actores benevolentes y progresistas, mientras refuerzan sus propias posiciones de poder. Según los autores, esto permite que las empresas implementen una supervisión superficial y simbólica, sin abordar los problemas estructurales que perpetúan la concentración de recursos y control.

En su conclusión, los autores instan a redefinir el concepto de apertura en IA para hacerlo más significativo y efectivo. Proponen que las políticas relacionadas con la IA deben centrarse no solo en la transparencia, la reusabilidad y la extensibilidad, sino también en abordar las desigualdades estructurales en el acceso a datos, infraestructura y talento. Esto implica crear regulaciones más estrictas para garantizar que los beneficios de la IA no se limiten a un pequeño grupo de actores privilegiados.

Asimismo, el artículo subraya la necesidad de un enfoque más crítico y materialista en el análisis de las políticas de IA. Esto significa examinar las dinámicas de poder subyacentes en el desarrollo y la implementación de estas tecnologías, en lugar de aceptar de manera acrítica las narrativas de apertura promovidas por las grandes empresas.

Anthropic advierte de la catástrofe de la IA si los gobiernos no regulan en 18 meses

Anthropic. «The Case for Targeted RegulationAnthropic, 31 de octubre de 2024. https://www.anthropic.com/news/the-case-for-targeted-regulation.

La regulación de la IA es esencial para balancear los beneficios y los riesgos. Si bien es un desafío complejo, es crucial implementarla pronto para evitar consecuencias negativas y asegurar el progreso en áreas clave como la ciencia y la medicina.

Los sistemas de inteligencia artificial (IA) están avanzando rápidamente, ofreciendo enormes beneficios potenciales en áreas como la ciencia, la medicina y la economía. Sin embargo, también presentan riesgos significativos, como el uso indebido en ciberseguridad o biotecnología, y la posibilidad de comportamientos autónomos y destructivos de los propios sistemas. Ante estos riesgos, se urge a los gobiernos a implementar políticas de IA en los próximos 18 meses, ya que el margen para prevenir estos riesgos está cerrándose rápidamente.

Una regulación bien diseñada y específica puede permitir que se aprovechen los beneficios de la IA, mitigando al mismo tiempo sus peligros. Sin embargo, si se retrasan las acciones, el resultado podría ser una regulación ineficaz que limite el progreso sin evitar los riesgos. Se propone una regulación dirigida que se enfoque en tres principios clave:

  1. Urgencia: La IA ha avanzado significativamente en el último año, con mejoras notables en tareas de codificación, razonamiento y matemáticas, lo que aumenta tanto las aplicaciones positivas como las posibilidades de uso indebido, especialmente en áreas como la ciberseguridad y la biotecnología.
  2. Política de Escalamiento Responsable (RSP): En Anthropic, la empresa responsable del artículo, se ha implementado una política llamada «Escalamiento Responsable», que ajusta las medidas de seguridad y mitigación de riesgos en función de los niveles de capacidad de los modelos de IA. Esta política se adapta de forma continua según el desarrollo de los modelos y su potencial de generar riesgos catastróficos.
  3. Elementos clave para la regulación de la IA:
    • Transparencia: Las empresas deben ser obligadas a publicar sus políticas de seguridad y las evaluaciones de riesgo de cada nueva generación de modelos de IA.
    • Incentivos para mejores prácticas de seguridad: La regulación debe fomentar que las empresas desarrollen políticas efectivas que prevengan riesgos graves.
    • Simplicidad y enfoque: La regulación debe ser precisa y evitar cargas innecesarias o reglas complicadas que puedan obstaculizar el progreso.

Se destaca la necesidad urgente de que los gobiernos y la industria trabajen juntos para desarrollar un marco regulatorio efectivo, que no solo reduzca los riesgos catastróficos de la IA, sino que también permita a la industria seguir innovando. Esto debe lograrse de manera flexible, considerando el rápido avance de la tecnología y adaptando las políticas a las mejores prácticas emergentes.

Transparencia de los datos en los modelos LLM de Inteligencia Artificial

MIT News | Massachusetts Institute of Technology. «Study: Transparency Is Often Lacking in Datasets Used to Train Large Language Models», 30 de agosto de 2024. https://news.mit.edu/2024/study-large-language-models-datasets-lack-transparency-0830.

Un equipo de investigadores del MIT ha desarrollado una herramienta llamada Data Provenance Explorer para mejorar la transparencia en los conjuntos de datos utilizados para entrenar grandes modelos de lenguaje. Esta herramienta permite a los practicantes de IA seleccionar datos adecuados para su modelo, mejorando la precisión y reduciendo el sesgo.

Los investigadores analizaron más de 1,800 conjuntos de datos textuales y descubrieron que más del 70% carecían de información de licencia, mientras que alrededor del 50% contenían errores en los datos de origen. Esto plantea problemas éticos y legales, y puede afectar el rendimiento del modelo, ya que el uso de datos incorrectos o sesgados puede llevar a predicciones injustas.

Data Provenance Explorer genera resúmenes de los creadores, fuentes, licencias y usos permitidos de los conjuntos de datos, ayudando a los investigadores a tomar decisiones más informadas y mejorar la precisión de los modelos en situaciones reales, como evaluaciones de préstamos o consultas de clientes.

Además, el estudio reveló que la mayoría de los creadores de conjuntos de datos se concentran en el norte global, lo que podría limitar las capacidades de los modelos en otras regiones. Los investigadores también notaron un aumento en las restricciones de los conjuntos de datos creados entre 2023 y 2024, debido a preocupaciones sobre su uso comercial no intencionado.

Los investigadores planean expandir su análisis para incluir datos multimodales, como video y audio, y seguir colaborando con reguladores para mejorar la transparencia en el uso de datos.

El índice de transparencia de los principales modelos de Inteligencia Artificial revela que la gran mayoría son opacos

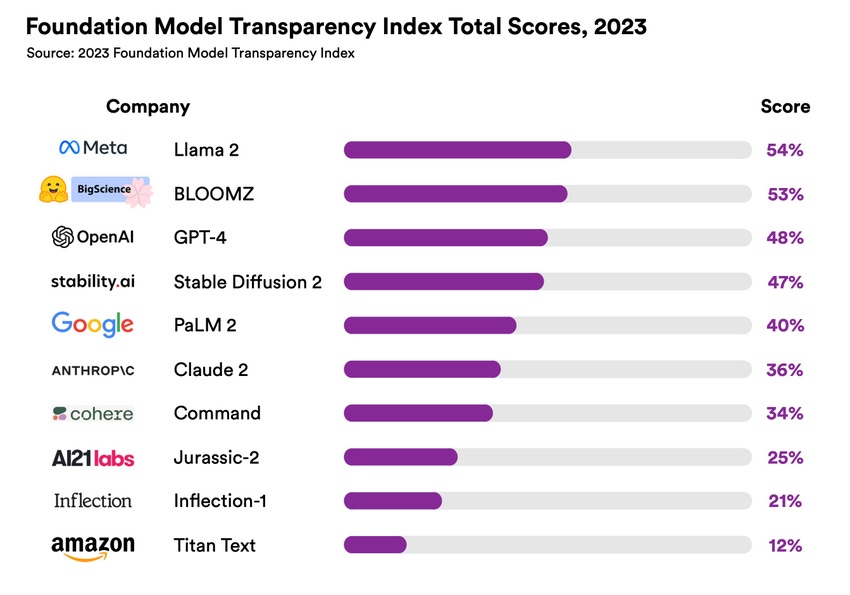
Índice de Transparencia de Modelos Fundamentales

«New Index Finds AI Models Are Murky, Not Transparent At All». 2023. Accedido 21 de diciembre de 2023. https://www.darkreading.com/cyber-risk/new-index-finds-ai-models-are-murky-not-transparent-at-all.


El Índice de Transparencia de Modelos Fundamentales de la Inteligencia Artificial es una evaluación que se realiza a los principales modelos de IA para medir la transparencia en su desarrollo y funcionamiento. Cuando se menciona que la gran mayoría de estos modelos son opacos, significa que existe una falta significativa de claridad y divulgación sobre cómo se entrenan, las fuentes de datos que utilizan, y cómo toman decisiones.


La nueva orden ejecutiva sobre inteligencia artificial (IA) firmada por el presidente de Estados Unidos, Joe Biden, detalla cómo la industria debe asegurarse de que la IA sea confiable y útil. La orden sigue a discusiones destacadas en julio y septiembre entre empresas de IA y la Casa Blanca, que resultaron en promesas sobre cómo las empresas de IA serán más transparentes acerca de las capacidades y limitaciones de la tecnología.

Hacer promesas de transparencia es un paso positivo, pero es necesario contar con un método para medir cuán bien se están cumpliendo esas promesas. Un método podría ser el Model Transparency Index desarrollado por el Centro de Investigación sobre Modelos Fundamentales de la Universidad de Stanford. El índice calificó 10 modelos de IA en función de 100 métricas diferentes, incluyendo cómo se entrenan los modelos, información sobre las propiedades y funciones del modelo, y cómo se distribuyen y utilizan los modelos. Las puntuaciones se calcularon en base a datos disponibles públicamente, aunque las empresas tuvieron la oportunidad de proporcionar información adicional para cambiar la puntuación.

¿Cómo se ve la transparencia al hablar de algunos de los modelos fundamentales más utilizados? No es buena. «Ningún desarrollador importante de modelos fundamentales se acerca a proporcionar transparencia adecuada, revelando una falta fundamental de transparencia en la industria de la IA», escribieron los investigadores de Stanford en el resumen de sus hallazgos.

Llama 2 de Meta recibió la puntuación total más alta en el índice, con 54 sobre 100.

El GPT-4 de OpenAI obtuvo 48, lo cual no es sorprendente, ya que OpenAI decidió retener detalles «sobre la arquitectura (incluido el tamaño del modelo), hardware, ordenador de entrenamiento, construcción del conjunto de datos [y] método de entrenamiento» al pasar de GPT-3 a GPT-4 a principios de este año.

En su mayor parte, los sistemas de IA potentes, como el GPT-4 de OpenAI y el PaLM2 de Google, son sistemas de caja negra. Estos modelos se entrenan con grandes volúmenes de datos y se pueden adaptar para su uso en una amplia variedad de aplicaciones. Pero para un creciente grupo de personas preocupadas por cómo se utiliza la IA y cómo podría afectar a las personas, el hecho de que haya poca información disponible sobre cómo se entrenan y utilizan estos modelos es un problema.

Según los investigadores, hay un poco más de transparencia en torno a la protección de datos de usuario y la funcionalidad básica del modelo. Los modelos de IA obtuvieron buenos resultados en indicadores relacionados con la protección de datos de usuario (67%), detalles básicos sobre cómo se desarrollan sus modelos fundamentales (63%), las capacidades de sus modelos (62%) y sus limitaciones (60%).

La nueva orden ejecutiva describe varias cosas que deben suceder para mejorar la transparencia. Los desarrolladores de IA deberán compartir los resultados de las pruebas de seguridad y otra información con el gobierno. El Instituto Nacional de Estándares y Tecnología tiene la tarea de crear estándares para garantizar que las herramientas de IA sean seguras y seguras antes de su lanzamiento público.

Las empresas que desarrollen modelos que representen riesgos serios para la salud y seguridad públicas, la economía o la seguridad nacional deberán notificar al gobierno federal cuando estén entrenando el modelo y compartir los resultados de las pruebas de seguridad antes de hacer públicos los modelos.