Archivo de la etiqueta: Transparencia

El índice de transparencia de los principales modelos de Inteligencia Artificial revela que la gran mayoría son opacos

Índice de Transparencia de Modelos Fundamentales

«New Index Finds AI Models Are Murky, Not Transparent At All». 2023. Accedido 21 de diciembre de 2023. https://www.darkreading.com/cyber-risk/new-index-finds-ai-models-are-murky-not-transparent-at-all.


El Índice de Transparencia de Modelos Fundamentales de la Inteligencia Artificial es una evaluación que se realiza a los principales modelos de IA para medir la transparencia en su desarrollo y funcionamiento. Cuando se menciona que la gran mayoría de estos modelos son opacos, significa que existe una falta significativa de claridad y divulgación sobre cómo se entrenan, las fuentes de datos que utilizan, y cómo toman decisiones.


La nueva orden ejecutiva sobre inteligencia artificial (IA) firmada por el presidente de Estados Unidos, Joe Biden, detalla cómo la industria debe asegurarse de que la IA sea confiable y útil. La orden sigue a discusiones destacadas en julio y septiembre entre empresas de IA y la Casa Blanca, que resultaron en promesas sobre cómo las empresas de IA serán más transparentes acerca de las capacidades y limitaciones de la tecnología.

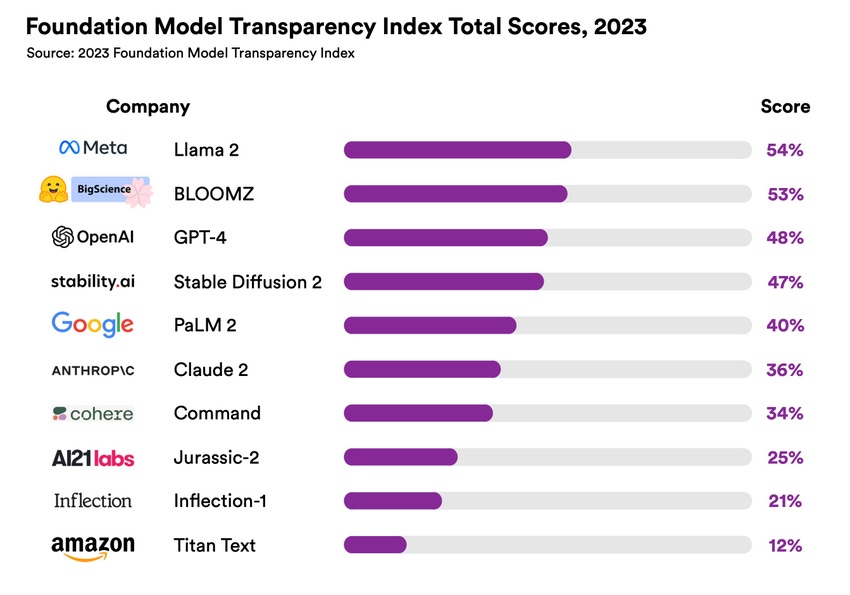
Hacer promesas de transparencia es un paso positivo, pero es necesario contar con un método para medir cuán bien se están cumpliendo esas promesas. Un método podría ser el Model Transparency Index desarrollado por el Centro de Investigación sobre Modelos Fundamentales de la Universidad de Stanford. El índice calificó 10 modelos de IA en función de 100 métricas diferentes, incluyendo cómo se entrenan los modelos, información sobre las propiedades y funciones del modelo, y cómo se distribuyen y utilizan los modelos. Las puntuaciones se calcularon en base a datos disponibles públicamente, aunque las empresas tuvieron la oportunidad de proporcionar información adicional para cambiar la puntuación.

¿Cómo se ve la transparencia al hablar de algunos de los modelos fundamentales más utilizados? No es buena. «Ningún desarrollador importante de modelos fundamentales se acerca a proporcionar transparencia adecuada, revelando una falta fundamental de transparencia en la industria de la IA», escribieron los investigadores de Stanford en el resumen de sus hallazgos.

Llama 2 de Meta recibió la puntuación total más alta en el índice, con 54 sobre 100.

El GPT-4 de OpenAI obtuvo 48, lo cual no es sorprendente, ya que OpenAI decidió retener detalles «sobre la arquitectura (incluido el tamaño del modelo), hardware, ordenador de entrenamiento, construcción del conjunto de datos [y] método de entrenamiento» al pasar de GPT-3 a GPT-4 a principios de este año.

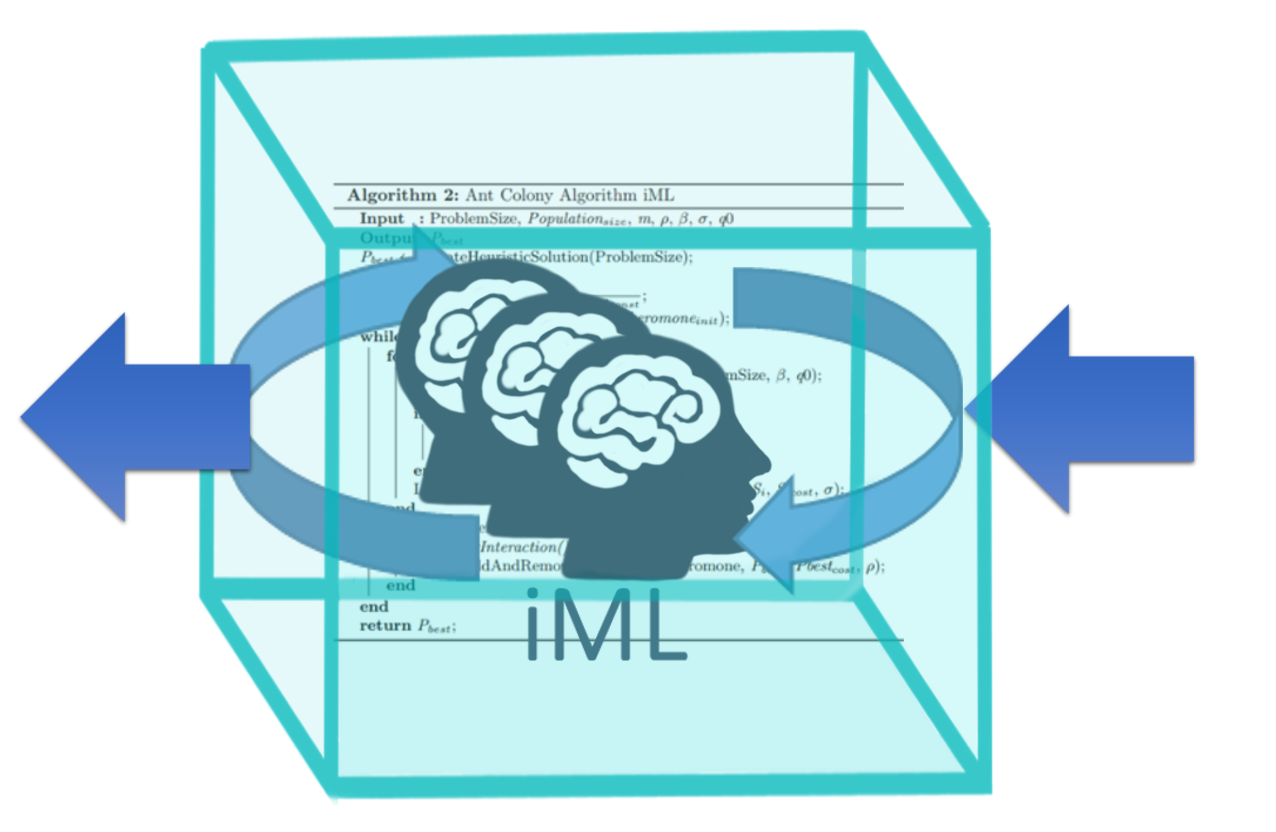
En su mayor parte, los sistemas de IA potentes, como el GPT-4 de OpenAI y el PaLM2 de Google, son sistemas de caja negra. Estos modelos se entrenan con grandes volúmenes de datos y se pueden adaptar para su uso en una amplia variedad de aplicaciones. Pero para un creciente grupo de personas preocupadas por cómo se utiliza la IA y cómo podría afectar a las personas, el hecho de que haya poca información disponible sobre cómo se entrenan y utilizan estos modelos es un problema.

Según los investigadores, hay un poco más de transparencia en torno a la protección de datos de usuario y la funcionalidad básica del modelo. Los modelos de IA obtuvieron buenos resultados en indicadores relacionados con la protección de datos de usuario (67%), detalles básicos sobre cómo se desarrollan sus modelos fundamentales (63%), las capacidades de sus modelos (62%) y sus limitaciones (60%).

La nueva orden ejecutiva describe varias cosas que deben suceder para mejorar la transparencia. Los desarrolladores de IA deberán compartir los resultados de las pruebas de seguridad y otra información con el gobierno. El Instituto Nacional de Estándares y Tecnología tiene la tarea de crear estándares para garantizar que las herramientas de IA sean seguras y seguras antes de su lanzamiento público.

Las empresas que desarrollen modelos que representen riesgos serios para la salud y seguridad públicas, la economía o la seguridad nacional deberán notificar al gobierno federal cuando estén entrenando el modelo y compartir los resultados de las pruebas de seguridad antes de hacer públicos los modelos.
Urge solucionar la falta de transparencia en torno a los datos utilizados para entrenar modelos de Inteligencia Artificial

Hardinges, Jack, Elena Simperl, y Nigel Shadbolt. 2023. «We Must Fix the Lack of Transparency Around the Data Used to Train Foundation Models». Harvard Data Science Review, diciembre. https://doi.org/10.1162/99608f92.a50ec6e6.

En el ámbito de la IA, los modelos, ya sean de aprendizaje supervisado, no supervisado o de otro tipo, necesitan ser alimentados con grandes cantidades de datos para aprender patrones y realizar tareas específicas. Abordar esta falta de transparencia es crucial para garantizar que la IA se desarrolle y utilice de manera ética y responsable. La transparencia en este proceso implica proporcionar información clara y completa sobre la naturaleza y la fuente de los datos utilizados en el entrenamiento de estos modelos. Sin embargo, en la mayoría de los casos, las empresas o desarrolladores no muestran de dónde compilan esta información, lo que puede tener consecuencias significativas en términos de ética, sesgo y confianza pública.


El estudio aborda la importancia del acceso a información sobre los datos utilizados en la formación de modelos de inteligencia artificial (IA). Aunque algunos sectores de la comunidad de IA han progresado, persiste una falta general de transparencia sobre el contenido y las fuentes de los conjuntos de datos de entrenamiento, ya sea por iniciativa voluntaria de las empresas o por intervención regulatoria, y esto debe cambiar.

Los modelos fundamentales se entrenan con grandes colecciones de datos, muchos de los cuales se recopilan de toda la web. La investigación del Instituto Allen de IA y The Washington Post sobre el popular conjunto de datos de entrenamiento C4 reveló que su contenido provenía de 15 millones de dominios web diferentes.

Conocer el contenido de los conjuntos de datos utilizados para entrenar modelos y cómo se han compilado es de vital importancia. Sin esta información, el trabajo de desarrolladores, investigadores y éticos para abordar sesgos o eliminar contenido perjudicial de los datos se ve obstaculizado. La información sobre los datos de entrenamiento también es crucial para que los legisladores evalúen si los modelos fundamentales han absorbido datos personales o material con derechos de autor. Además, los operadores previstos de los sistemas de IA y aquellos afectados por su uso son mucho más propensos a confiar en ellos si comprenden cómo se han desarrollado.

Sin embargo, algunas empresas no documentan el contenido de sus datos de entrenamiento, incluso internamente, por temor a encontrar información personal sobre individuos identificables, material con derechos de autor y otros datos obtenidos sin consentimiento.

En público, las empresas han utilizado diferentes argumentos para justificar la falta de transparencia en torno a sus datos de entrenamiento. OpenAI, en el lanzamiento de su modelo GPT-4, declaró que no compartiría información detallada sobre la «construcción del conjunto de datos» y otros aspectos del desarrollo del modelo debido al «panorama competitivo y las implicaciones de seguridad de los modelos a gran escala». Aunque algunas empresas han publicado los datos de ajuste fino, tienden a omitir los conjuntos de datos de entrenamiento más grandes y complejos que son más propensos a contener contenido perjudicial o material con derechos de autor.

Partes de la comunidad de IA han avanzado en la transparencia de los datos de entrenamiento. La plataforma Hugging Face, inspirada en los pioneros de la seguridad de la IA Emily Bender, Batya Friedman y Timnit Gebru, promueve el uso de Model Cards y Dataset Cards entre su comunidad de desarrolladores. Las Dataset Cards documentan cómo se creó un conjunto de datos, su contenido y posibles problemas legales o éticos asociados.

En julio de 2023, la Casa Blanca anunció que siete grandes empresas de IA se comprometieron a «desarrollar medidas técnicas sólidas para garantizar que los usuarios sepan cuándo el contenido es generado por IA, como el marcado de agua». Dado que los modelos fundamentales de IA han comenzado a entrenarse con datos generados por IA, estas herramientas desempeñarán un papel importante en documentar la procedencia de los datos de entrenamiento y la integridad de las salidas resultantes de la IA.

Las decisiones sobre qué documentar sobre los datos de entrenamiento podrían eventualmente salir de las manos de los desarrolladores. La Comisión Federal de Comercio de EE. UU. ha ordenado recientemente a OpenAI que documente todas las fuentes de datos utilizadas para entrenar sus grandes modelos de lenguaje. Un grupo de grandes medios de comunicación ha publicado una carta abierta instando a los legisladores de todo el mundo a introducir nuevas regulaciones que exijan transparencia en los conjuntos de datos de entrenamiento.

Se prevé que la demanda de información sobre los datos de entrenamiento sea la última ola en un esfuerzo continuo por la transparencia empresarial. En el Reino Unido, las leyes sobre el registro obligatorio y la publicación de información por parte de las empresas se remontan al siglo XIX, y a lo largo del tiempo, los reguladores han desarrollado enfoques estandarizados para evitar que cada empresa elija su propia forma de informar sobre sus finanzas y otras actividades. Quizás necesitemos lo mismo para las divulgaciones sobre los datos en los que se han entrenado los modelos fundamentales de IA.

Ya sea que las empresas den un paso adelante o que intervengan los gobiernos, deben asegurarnos de que los datos utilizados para entrenar sistemas de IA no estén envueltos en secreto. La confianza pública, nuestra capacidad para mitigar sus posibles daños y la eficacia de nuestro régimen regulatorio dependen de ello.

Estudio sobre los informes de transparencia (2019-2020) de las entidades de gestión de derechos de propiedad intelectual (2022)

Luis Fernando Ramos Simón e Ignacio Miró-Charbonnier. Estudio sobre los informes de transparencia (2019-2020) de las entidades de gestión de derechos de propiedad intelectual Madrid. FESABID, 2022

Texto completo

El presente estudio trata de analizar los Informes Anuales de Transparencia (en adelante: IAT), que son publicados por todas las entidades españolas de gestión de derechos de autor desde el ejercicio 2019. El objetivo principal de nuestro estudio consiste en conocer en qué medida la nueva regulación de las entidades de gestión de los derechos de autor –verificable a través de los IAT—modifica la operatividad de esas instituciones, que desempeñan un papel clave en la gestión de los derechos de propiedad intelectual.

Ellas pueden actuar como engranaje esencial de la actividad cultural del Estado, en la medida en que promuevan la competencia y el desarrollo tecnológico; por ello, forman parte importante de la industria cultural española. Conocerlas, comprender su papel, corregir sus defectos e impulsar sus iniciativas puede servir para revitalizar al sector cultural y en particular a todas aquellas instituciones públicas y privadas que tengan la información, el conocimiento y el patrimonio cultural como ejes de su misión.

Entrando en una nueva era de gobierno digital

eGovernment Benchmark 2021. Entering a New Digital Government Era. Comisión Europea, Capgemini, Sogeti, IDC y Politecnico di Milano, 2021

Texto completo

eGovernment Benchmark compara la forma en que los gobiernos prestan servicios públicos digitales en toda Europa. Consulta el informe de este año para obtener más información sobre la transición de los principales servicios públicos de la UE de offline a online.

La pandemia de COVID-19 no sólo ha traído turbulencias, sino que también ha estimulado la resistencia y la innovación, impulsando así la digitalización de la economía y la sociedad de la UE, lo que incluye la forma en que los gobiernos prestan sus servicios.

El eGovernment Benchmark compara la forma en que los gobiernos prestan servicios públicos digitales en toda Europa. Se ha convertido en un estudio reconocido internacionalmente que arroja luz sobre la administración electrónica en 36 países europeos mediante la evaluación de los llamados eventos vitales basados en indicadores específicos. Los eventos vitales incluyen paquetes de servicios gubernamentales que apoyan a los ciudadanos o a los empresarios en momentos clave de sus vidas, como el nacimiento de un hijo o la creación de un negocio

Estos indicadores se agrupan en 4 puntos de referencia principales de alto nivel:

  • Centrado en el usuario: indica el grado en que un servicio se presta en línea, su facilidad de uso en el móvil y la facilidad de uso en términos de apoyo en línea y mecanismos de retroalimentación disponibles.
  • Transparencia: indica hasta qué punto los gobiernos son transparentes en cuanto a:
    – El proceso de prestación
    – las responsabilidades y la actuación de los organismos públicos
    – Los datos personales tratados en los servicios públicos.
  • Movilidad transfronteriza – indica en qué medida los usuarios de los servicios públicos de otro país europeo pueden utilizar los servicios en línea.
  • Facilitadores clave: indica en qué medida se dan las condiciones técnicas y organizativas previas para la prestación de servicios de administración electrónica, como la identificación electrónica y las fuentes auténticas.

Acceso y gestión a la información gubernamental

Amanda, W. and L. Sam-chin (2019). [e-Book] Government Information in Canada: Access and Stewardshipnull, University of Alberta Press, 2019.

Texto completo

El acceso público a la información gubernamental constituye la base de una democracia liberal saludable. Como esta información puede ser precaria, necesita ser administrada. Government Information in Canada ofrece un análisis sobre el estado de la publicación de información gubernamental canadiense. Expertos de todo el país se basan en décadas de experiencia para ofrecer un estudio amplio y bien fundamentado de la historia, los procedimientos y las cuestiones emergentes, en particular los retos a los que se enfrentan los profesionales durante la transición de la información gubernamental del acceso impreso al digital. Se trata de un libro indispensable para bibliotecarios, archiveros, investigadores, periodistas y todo aquel que utilice información gubernamental y quiera saber más sobre su publicación, circulación y conservación. Colaboradores: Graeme Campbell, Talia Chung, Sandra Craig, Peter Ellinger, Darlene Fichter, Michelle Lake, Sam-chin Li, Steve Marks, Maureen Martyn, Catherine McGoveran, Martha Murphy, Dani J. Pahulje, Susan Paterson , Carol Perry, Caron Rollins, Gregory Salmers, Tom J. Smyth, Brian Tobin, Amanda Wakaruk, Nicholas Worby

Recomendaciones para la comunicación transparente de precios y servicios de acceso abierto


samuel-zeller-_es6l-apda0-unsplash-150x150-1

Final report price transparency project. Information Power, 2020

Ver

Un informe independiente publicado por Information Power tiene como objetivo mejorar la transparencia de los precios y servicios de acceso abierto (OA).


El informe es el resultado de un proyecto financiado por Wellcome y UK Research and Innovation (UKRI) en nombre de la COOlición S para informar el desarrollo del Plan S. Durante el proyecto, los financiadores, bibliotecas, editoriales y universidades trabajaron juntos para informar sobre el desarrollo de un marco destinado a proporcionar información sobre los servicios y precios de OA de forma transparente, práctica y perspicaz.

El marco brinda oportunidades a los editores para crear una mejor conciencia y apreciación por parte de los clientes del valor de sus servicios, y para demostrar el compromiso del editor con los modelos comerciales abiertos y las culturas comerciales.

La implementación de este marco requerirá cambios en las prácticas, una mayor alineación entre las partes interesadas, el esfuerzo y la infraestructura. Estos metadatos serían puestos a disposición de manera más conveniente por plataformas y editores a través del servicio CrossRef, a través de una licencia abierta para ingerir y usar en una amplia gama de servicios. Muchos servicios relevantes ya están operativos actualmente, y también hay potencial para nuevos servicios.

Este marco se pondrá a prueba en el primer trimestre de 2020.


Nature Human Behavior se pasa a la revision abierta y transparente

peer-review

Transparency in peer review Nat Hum Behav 3, 1237 (2019) doi:10.1038/s41562-019-0799-8


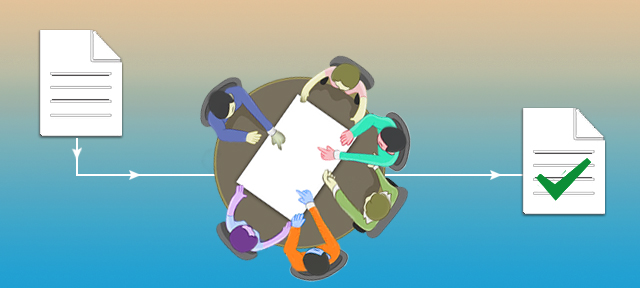
A partir de diciembre de 2019, los autores de artículos de investigación enviados a Nature Human Behavior tendrán la opción de publicar los registros completos de revisión por pares de sus manuscritos, incluidos los comentarios de los revisores, las cartas de decisión editorial y sus propias respuestas a los comentarios de los revisores y editoriales.

Antes de ser publicados, los manuscritos de investigación generalmente se someten a dos o tres rondas de revisión por pares. Este proceso supone una cantidad considerable de tiempo y esfuerzo por parte de los pares o expertos, que desempeñan un papel fundamental tanto en la evaluación de la solidez del trabajo como en el fortalecimiento de su publicación.

Los editores brindan orientación sobre qué comentarios de los revisores son cruciales a abordar, cuáles son los mejores a tener en cuenta para futuras investigaciones o cuáles son poco probables que produzcan resultados significativos, y cómo se pueden mantener los mismos estándares de análisis estadístico, generando informes e interpretación de todos los manuscritos.

A continuación los autores proporcionan respuestas detalladas y reflexivas a los comentarios revisores y editores que acompañan a sus manuscritos revisados. El proceso de revisión por pares es transformador para la mayoría de manuscritos; sin embargo, esta información se ha mantenido oculta hasta la fecha. Esta práctica ahora está cambiando. Los autores que envíen sus manuscritos de investigación a Nature Human Behavior a partir de diciembre de 2019 tendrán la oportunidad de publicar el registro completo de la revisión por pares asociado con su manuscrito, incluidas las cartas de decisión editorial, los comentarios de los revisores por pares y las respuestas de los autores a los revisores y editores. Los autores podrán optar por una revisión por pares transparente cuando se tome una decisión de aceptación en principio sobre su manuscrito. El registro de revisión por pares no incluirá comentarios confidenciales a los editores y se editará para eliminar cualquier información confidencial o de terceros. El material restante se publicará tal cual, sin más edición.

Entre las revistas de Nature Research, la revisión por pares transparente se lanzó por primera vez en la revista Nature Communications en 2016; Desde entonces, más del 60% de los autores han optado por una revisión por pares transparente en la revista. Nature Human Behavior, junto con otros seis títulos de Nature Research, ahora se une a Nature Communications para ofrecer una revisión por pares transparente.


La función de archivo y la transparencia en España


ecaae2077ade57d6b314a0d616a80b4e

Rosana de Andrés Díaz y Javier Sierra Rodríguez. La función de archivo y la transparencia en España. Madrid: Universidad Complutense de Madrid. Centro Superior de Estudios de Gestión, 2018

Texto completo

El libro recoge las aportaciones de expertos y profesionales de archivo y documentación sobre el tema de la transparencia. La función archivo es esencial en la transparencia y el acceso a la información pública.


Papel de las bibliotecas en la elaboración del censo para un gobierno transparente

census_guide_cvr_1080px

«Libraries’ Guide to the 2020 Census«. Washington: ALA, 2019

La guía describe las maneras en que las bibliotecas pueden apoyar la recopilación de datos precisos y completos del censo y cómo, como centros comunitarios, se encuentran en una posición única para ayudar a sus electores a trabajar a través del proceso del censo. Los pasos básicos descritos en la sección inicial representan y explican puntos de referencia críticos en el proceso del censo y proporcionan los plazos para cada entrega. Los pasos incluyen actualizar la lista de direcciones, solicitar respuestas y realizar un seguimiento.

El papel de las bibliotecas en el censo

Hoy en día, la recopilación de un censo preciso es incluso más importante pata Estados Unidos que en los primeros años de la nación. Los números se utilizan no solo para determinar la representación en el Congreso y los distritos de las oficinas federales, estatales y locales, sino también para determinar el Colegio Electoral. Más aún, el censo sigue siendo crítico para la asignación de miles de millones de dólares de fondos federales tanto a los estados como a las localidades, incluidas las subvenciones importantes a los estados en virtud de la Ley de Tecnología y Servicios de Bibliotecas (LSTA) .

Por primera vez en la historia del censo, a partir de marzo de 2020, la Oficina del Censo instará a los usuarios a enviar sus respuestas en línea. Cada hogar recibirá un código único para acceder al censo en línea y al formulario impreso. Si un hogar no tiene acceso a Internet, hay dos enfoques alternativos: el formulario impreso y la biblioteca local, donde las terminales públicas están disponibles para el acceso a Internet. En el pasado, las bibliotecas han servido como puntos de contacto clave para las personas que buscan ayuda para completar el formulario impreso. Ahora es posible que también necesiten proporcionar terminales donde los usuarios puedan acceder al cuestionario en línea.

ALA ya se está preparando para las preguntas y el potencial para un uso intensivo de los terminales públicos de las bibliotecas locales. Como señaló Larra Clark, subdirectora de políticas de la Oficina de Política de Tecnología de la Información (OITP) de ALA y la Asociación de Bibliotecas Públicas (PLA), “los miembros y el personal de ALA están desarrollando recursos y educación para apoyar el campo de la biblioteca, coordinando directamente con el «La Oficina del Censo y otras partes interesadas para crear conciencia sobre los roles y necesidades de la biblioteca, y avanzar en la formulación de políticas que apoyarán a las bibliotecas a las que servimos para lograr un conteo justo, preciso e inclusivo en 2020». Sigue leyendo →

Ley de Transparencia y grandes empresas en España

urhfiu

Cruz, César N. Ley de Transparencia y grandes empresas en España.Análisis de la implementación de la Ley 19/2013 de transparencia, acceso a la información pública y buen gobierno en 43 grandes empresas españolas (2017-2018) Madrid:  Transparencia Internacional España , 2018

Texto completo

Este informe repite el ejercicio de valoración realizado el año pasado 2017, y forma parte de la investigación iniciada en 2015 en el marco del Proyecto Integridad, de Transparencia Internacional España, cuyo objetivo fue identificar y precisar cuáles eran las obligaciones derivadas de la Ley 19/2013, de 9 de diciembre, de transparencia, acceso a la información pública y buen gobierno (en adelante Ley 19/2013, o LTAIBG) para las entidades privadas, en particular las derivadas del artículo 3 b) y 4 de dicha norma.

Como en 2017, el informe aquí presentado analiza el nivel de cumplimiento de la LTAIBG por parte de 43 grandes empresas españolas durante 2018. Así pues, este informe arroja luz sobre el comportamiento de las empresas españolas cotizadas en relación con la ley de transparencia de ámbito estatal: ¿Cumplen o no con la Ley 19/2013 y en qué medida? ¿Qué información publican de aquella relevante para la Ley de Transparencia? Hay que precisar que el estudio se centra en la publicidad activa y no analiza las obligaciones asociadas al suministro de información por parte de las empresas a las administraciones públicas, en el caso de que éstas la soliciten (la que también llamamos “publicidad pasiva indirecta”).

A diferencia del informe previo de 2017, este informe sí identifica a las empresas no cumplidoras, describiendo en cada caso qué información hacen pública en sus respectivas páginas web. Este informe ofrece herramientas para facilitar esta labor de publicidad activa, y se ofrecen recomendaciones para una adecuada implementación de la Ley de Transparencia 19/2013, así como también sobre los cambios que parecen necesarios en la normativa vigente, asociado a su segunda propuesta de desarrollo reglamentario de dicha norma básica, aún pendiente de iniciar trámite parlamentario.

Los principales hallazgos son que para 2018 del conjunto de 132 empresas españolas cotizadas seleccionadas (aquellas dentro del llamado mercado continuo), se identificaron como sujetos obligados al 32,6 % del total (porcentaje muy semejante al de años anteriores), y que dichas empresas reiteran su incumplimiento asociado a esta norma, pues aun siendo identificadas como sujetos obligados, no han tomado medidas claras para atender estas obligaciones de publicidad activa.