Archivo de la etiqueta: Identificadores persistentes

Cuando la IA cita ciencia: ¿qué versión del artículo ha utilizado?

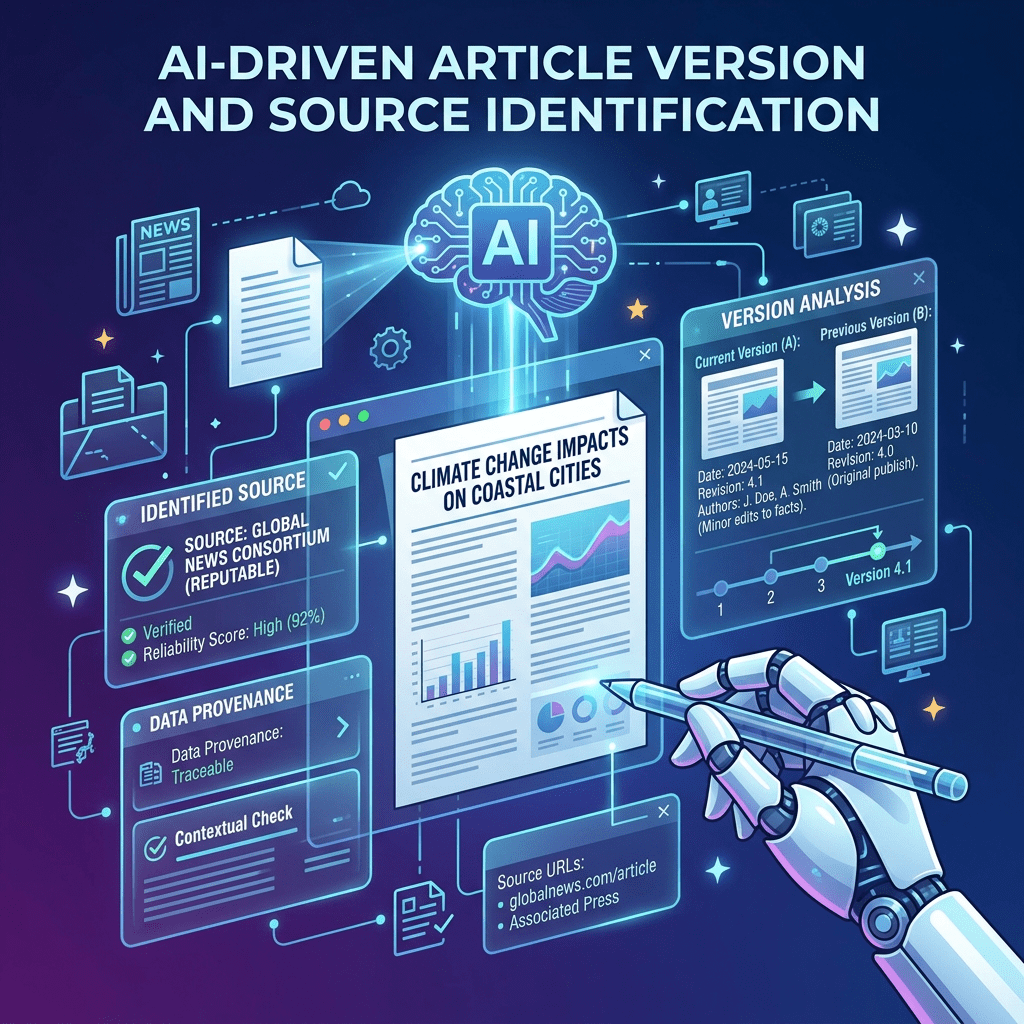
AI-driven article version and source identification with verified sources and revision analysis
A futuristic interface illustrates AI-powered article tracking, source verification, and data provenance.

Hargitt, Patrick; Smith, Steve. “AI Can Find the Article. Can It Tell Which Version It Used?”. The Scholarly Kitchen, 19 de agosto de 2026. Artículo original en The Scholarly Kitchen

La expansión de la inteligencia artificial en la búsqueda y recuperación de información científica está generando un problema que va mucho más allá de localizar correctamente un artículo: determinar exactamente qué versión del trabajo ha utilizado la IA.

Patrick Hargitt y Steve Smith parten de una cuestión fundamental para la comunicación científica: un mismo trabajo puede existir simultáneamente como preprint, manuscrito revisado, manuscrito aceptado, versión publicada por el editor, copia depositada en un repositorio institucional y versiones posteriores corregidas o retractadas. Los sistemas de IA pueden recuperar cualquiera de estas manifestaciones, fragmentar su contenido en pequeños bloques y utilizar determinados pasajes para elaborar una respuesta sin mostrar necesariamente al usuario el contexto o la versión concreta de la que procede la información. Por ello, la ambigüedad de las versiones deja de ser únicamente un problema bibliográfico o de descubrimiento y se convierte en un problema de procedencia, especialmente importante cuando una IA genera revisiones de literatura, informes, resúmenes o respuestas basadas en investigación científica.

Los autores destacan que los identificadores persistentes (PID), especialmente los DOI, siguen siendo esenciales, pero por sí solos no resuelven el problema. Un DOI puede identificar de manera estable un trabajo y conducir al registro mantenido por el editor, pero eso no significa necesariamente que sea la versión que un sistema de IA utilizó. Una IA podría haber recuperado, por ejemplo, una copia anterior depositada en un repositorio, mientras que la referencia final apunta al DOI de la versión publicada. Del mismo modo, un artículo puede haber sido corregido o retractado después de que una plataforma de IA incorporara una copia anterior. Por tanto, no basta con saber qué trabajo se ha utilizado: es necesario conocer qué estado o versión concreta del trabajo se empleó y si en ese momento existían correcciones, actualizaciones, retractaciones o versiones posteriores relevantes. El valor de un PID depende así del ecosistema de metadatos y relaciones que lo acompaña, capaz de explicar qué objeto representa, cómo se relaciona con otras versiones y cuál es su situación actual dentro del registro académico.

En este contexto cobra especial importancia la próxima revisión de la recomendación NISO Journal Article Versions (JAV). Según los autores, esta revisión se encuentra en fase editorial final y pretende proporcionar una descripción más precisa de las diferentes etapas por las que puede pasar un artículo científico. La propuesta combina etapas y estados del artículo con versionado semántico, permitiendo distinguir no solo entre un preprint, un manuscrito aceptado o una versión del registro (Version of Record), sino también entre diferentes modificaciones producidas dentro de una misma etapa. Esta distinción resulta especialmente relevante porque un artículo puede experimentar varias modificaciones sin cambiar necesariamente de categoría: una corrección menor de metadatos no tiene la misma importancia que un cambio sustancial que pueda afectar a la interpretación de los resultados. El versionado estructurado permitiría que tanto los investigadores como los sistemas automatizados comprendieran mejor qué versión están manejando y cuál es su relación con las demás.

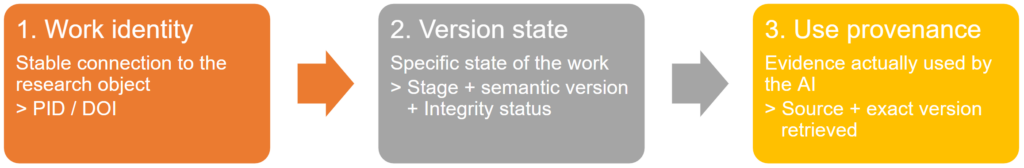
El artículo propone, en esencia, distinguir tres capas de identidad. La primera responde a la pregunta «¿qué trabajo u objeto científico es este?» y se resuelve mediante un PID, como un DOI, acompañado de metadatos y relaciones. La segunda responde a «¿en qué estado o versión se encuentra el trabajo?» y requiere información sobre la etapa editorial, el estado y el número o versión semántica. La tercera, mucho más novedosa en el contexto de la inteligencia artificial, responde a «¿qué utilizó realmente el sistema de IA?». Esta última dimensión exige información de procedencia, es decir, conocer la fuente concreta y la versión exacta que fueron recuperadas para fundamentar una determinada respuesta. Para los autores, esta tercera capa será cada vez más importante porque una referencia bibliográfica aparentemente correcta puede ocultar el recorrido real que siguió la IA para obtener la información. En consecuencia, la especificidad de la versión debería empezar a considerarse parte de la precisión de una cita, y no simplemente un detalle adicional de presentación.
Otro aspecto fundamental es que los metadatos de versión deben pasar de ser una información meramente descriptiva a convertirse en información operativa dentro de los sistemas de IA. Un sistema de recuperación debería poder identificar si está accediendo a un preprint, un manuscrito en revisión, un manuscrito aceptado o una versión del registro; debería comprobar si esa versión ha sido posteriormente corregida, retractada o sustituida; y, cuando sea posible, debería conocer si existe una versión posterior antes de generar una respuesta. Si la IA utiliza una versión antigua o no definitiva, esa circunstancia debería poder aparecer en la referencia o en la evidencia que acompaña a la respuesta. El problema adquiere todavía mayor importancia cuando el contenido se incorpora a sistemas de IA mediante procesos de ingestión estática: los artículos pueden transformarse, dividirse en fragmentos, convertirse en embeddings e incorporarse a índices vectoriales, mientras que la información sobre su versión, estado editorial o historial de correcciones puede quedar separada del texto. De ahí la necesidad de que los metadatos permanezcan vinculados al contenido durante todo el proceso de ingestión, recuperación y generación.

Los autores subrayan también el riesgo de que las correcciones y retractaciones no lleguen a las plataformas de IA. Un artículo puede haber sido incorporado a una colección licenciada o a un índice en una determinada fecha y, posteriormente, ser corregido o retractado por el editor. Si el sistema conserva una copia estática y no dispone de mecanismos para recibir las actualizaciones, puede seguir utilizando información que el propio editor ya no considera válida en su forma anterior. El problema no afecta solamente a las editoriales: también involucra a repositorios, índices bibliográficos, agregadores, proveedores de contenidos y empresas de inteligencia artificial. Los autores plantean que las correcciones, retractaciones y nuevas versiones deberían propagarse por todo el ecosistema académico mediante mecanismos fiables de actualización. En este sentido, mencionan iniciativas como CUSAP, orientada a la comunicación de actualizaciones de contenidos, y servicios destinados a transmitir información sobre retractaciones y erratas.

Desde la perspectiva de las bibliotecas y las instituciones académicas, el problema tiene consecuencias directas sobre la contratación y evaluación de servicios de IA. Ya no debería bastar con preguntar si una herramienta tiene acceso a millones de artículos científicos. También habría que saber si conserva los metadatos de versión, si actualiza los contenidos cuando se producen correcciones o retractaciones, si identifica la procedencia de los fragmentos utilizados y si puede informar de qué versión concreta respaldó una respuesta. Esto introduce una nueva dimensión en la evaluación de proveedores de IA y en las licencias de contenidos científicos. Las instituciones podrían exigir que los sistemas demuestren durante las pruebas piloto que son capaces de mantener la relación entre contenido, versión, estado, procedencia y actualización. De este modo, la calidad de un sistema de IA para investigación no dependería únicamente de su capacidad para recuperar documentos relevantes, sino también de su capacidad para recuperar y utilizar la versión correcta y vigente de esos documentos.
La tasa de adopción del identificador ORCID entre investigadores es del 72%

Porter, Stephen R. 2025. «Understanding ORCID Adoption Among Academic ResearchersScientometrics. https://doi.org/10.1007/s11192-025-05300-7

El identificador ORCID facilita la identificación única de investigadores y su producción científica. Un estudio en 31 universidades de EE. UU. encontró una adopción general del 72 %, con grandes diferencias entre disciplinas. La principal razón para adoptar ORCID es su exigencia editorial, mientras que quienes no lo tienen suelen no percibir beneficios claros. Aún existen retos para lograr una adopción universal.

El identificador ORCID (Open Researcher and Contributor Identifier) fue creado hace algo más de diez años con el propósito de asignar un identificador digital único y persistente a cada investigador, facilitando así la correcta atribución de publicaciones, proyectos y contribuciones científicas. Este sistema se ha vuelto clave tanto para los análisis bibliométricos como para que universidades, centros de investigación y agencias de financiación puedan evaluar la productividad y el impacto de sus investigadores.

A pesar de su utilidad reconocida, la adopción masiva del ORCID entre los investigadores no ha sido automática. Estudios anteriores señalaron tasas de adopción muy variables, que oscilaban entre el 3 % y el 42 %, dependiendo del área y el contexto institucional.

El estudio realizado por Stephen R. Porter se basa en una encuesta nacional a investigadores de 31 universidades de investigación de EE. UU. y proporciona una visión actualizada y más precisa de la situación. Entre sus principales hallazgos destacan:

  • Tasa general de adopción: el 72 % de los investigadores encuestados ya tienen un identificador ORCID.
  • Variabilidad por disciplinas:
    • En ciencias biológicas y biomédicas, la adopción es altísima: llega al 93 %.
    • En artes visuales y escénicas, apenas alcanza el 17 %.
    • Otras disciplinas se sitúan entre ambos extremos, evidenciando que el contexto disciplinar influye fuertemente en la adopción.

Respecto a las razones para adoptar ORCID, el principal motivo es su obligatoriedad en el proceso de envío de manuscritos a muchas revistas científicas. En otras palabras, muchos investigadores crean su ORCID porque es un requisito editorial, más que por motivación personal o institucional.

Entre los motivos para no tener un ORCID, los tres más destacados son:

  1. No percibir beneficios claros de contar con uno.
  2. Sentirse suficientemente establecidos en su carrera (especialmente en investigadores sénior), considerando innecesaria su adopción.
  3. Falta de información o de necesidad inmediata en su campo o actividad profesional.

El artículo sugiere que, aunque la adopción está creciendo, persiste una brecha entre disciplinas y generaciones, y que seguir aumentando la concienciación sobre las ventajas de ORCID será clave para alcanzar una adopción verdaderamente universal.

Características deseables de los identificadores persistentes (PIDs)

Chodacki, John, y Todd Carpenter. «Desirable Characteristics of Persistent Identifiers». Upstream, 19 de marzo de 2024. https://doi.org/10.54900/c3hdq-0ev76.

Los identificadores persistentes (PIDs) en las comunicaciones académicas y la infraestructura de investigación han atraído una creciente atención en los últimos años, especialmente de los gobiernos que reconocen su papel vital en la creación de un ecosistema de investigación más eficiente y confiable. Este resumen destaca las características clave deseables de las infraestructuras PID basadas en principios orientadores e iniciativas globales.

Antecedentes

Varios países, incluidos Australia, Canadá, Finlandia, Corea y el Reino Unido, están desarrollando estrategias nacionales de PID para apoyar la beca abierta y la innovación. En los EE. UU., se crearon recomendaciones para una Estrategia Nacional de PID por la Research Data Alliance (RDA) en colaboración con la Higher Education Leadership Initiative for Open Scholarship (HELIOS) y el Open Research Funders Group (ORFG). Estas recomendaciones guían a los interesados nacionales en la investigación sobre el uso y adopción de PIDs.

Principios generales y orientadores

La adopción y el éxito de cualquier PID dependen de la confianza en la infraestructura subyacente, los datos y los servicios asociados. Esta confianza se desarrolla mejor alineándose con marcos existentes para infraestructura abierta y principios orientadores correspondientes, como FAIR y POSI.

Principios FAIR

Los principios FAIR (Findable, Accessible, Interoperable y Reusable) proporcionan un marco fundamental para comprender la función de los PIDs como habilitadores de la investigación abierta.

  • Findability: Los PIDs hacen que los objetos digitales sean localizables a través de referencias únicas y persistentes, junto con metadatos ricos, mejorando la capacidad de descubrimiento.
  • Accessibility: Los PIDs aseguran que los objetos digitales sean identificables, con metadatos accesibles incluso si el objeto en sí está restringido.
  • Interoperability: Los PIDs utilizan sistemas y esquemas estandarizados, facilitando la integración e interacción sin problemas entre diferentes sistemas de datos.
  • Reusability: Los PIDs proporcionan enlaces persistentes al contexto y la procedencia, respaldados por metadatos claros que detallan las condiciones de reutilización.

Principios POSI

Los Principios de Infraestructura Académica Abierta (POSI) ofrecen directrices para una infraestructura abierta, sostenible y impulsada por la comunidad.

  • Cobertura: Los PIDs deben ser inclusivos en todas las disciplinas, geografías e instituciones.
  • Gobernanza de los Interesados: Los PIDs deben ser gobernados por consenso comunitario para asegurar una toma de decisiones equilibrada.
  • Transparencia: La gobernanza abierta construye y mantiene la confianza de la comunidad.
  • Cumplimiento de la Misión: Las revisiones regulares aseguran que los PIDs cumplan con las necesidades de la comunidad.

Otras consideraciones de POSI incluyen la infraestructura de código abierto y datos accesibles, asegurando un uso equitativo en varios sectores.

Orientación de UNESCO y HELIOS

El Toolkit de Ciencia Abierta de la UNESCO y el Grupo de Trabajo de Infraestructura Compartida de HELIOS enfatizan la transparencia, colaboración y capacidades técnicas. Estos incluyen:

  • Transparencia: Estructuras claras de costos y beneficios.
  • Interoperabilidad: Estándares para mejorar la reutilización de datos.
  • Cocreación: Desarrollo cooperativo con la participación de la comunidad.
  • Cumplimiento del Acceso Público: Asegurar que la infraestructura cumpla con los requisitos de las agencias financiadoras.

Memorándum Presidencial de Seguridad Nacional 33 (NSPM-33)

Las directrices federales de EE. UU. sobre PIDs indican que deben ser proporcionados por plataformas abiertas, no propietarias y dirigidas por investigadores, interoperables con estándares internacionales.

Características deseables de la infraestructura PID

Combinando los principios de FAIR, POSI, UNESCO y HELIOS, se recomiendan las siguientes características para las infraestructuras PID:

  • Disponibilidad de Metadatos Abiertos: Los metadatos básicos deben estar disponibles gratuitamente y con licencia abierta para la integración y reutilización.
  • Servicios de Resolución Estandarizados: Servicios confiables como doi.org aseguran conexiones estables con los objetos referenciados.
  • Políticas de Identificación Documentadas: Políticas claras sobre la gestión de identificadores, versionado y persistencia mejoran la transparencia.
  • Monitoreo y Reporte: El monitoreo activo asegura PIDs funcionales, con mecanismos para abordar URIs no funcionales.
  • Asignación y Curación Amigable para el Usuario: Procesos simplificados para la asignación de PIDs y la gestión de metadatos facilitan la adopción.
  • Estandarización y Participación Comunitaria: Estructuras consistentes y procesos impulsados por la comunidad aseguran robustez e inclusividad.
  • Extensibilidad: Los sistemas PID deben adaptarse a nuevos casos de uso y demandas.
  • Gobernanza Comunitaria: La infraestructura debe ser responsable ante la comunidad de usuarios, con una amplia participación en la gobernanza.

Conclusión

Los PIDs son cruciales para avanzar en la beca abierta, asegurando que los resultados de la investigación sean descubribles, atribuibles e impactantes. Alineándose con marcos como FAIR y POSI, e incorporando conocimientos globales, podemos crear infraestructuras PID inclusivas y equitativas. La colaboración entre académicos, financiadores y responsables de políticas es esencial para promover la adopción generalizada de PIDs, mejorando la transparencia y coherencia del ecosistema de investigación.

Desarrollo de una estrategia nacional sobre Identificadores Persistentes (PIDs) en EE.UU.

Simons, N., Brown, C., Bangert, D., & Sadler, S. (2023). National PID Strategies Guide and Checklist (Version 1.0). Research Data Alliance. https://zenodo.org/records/10811008

El Grupo de Trabajo sobre Estrategias Nacionales de PID fue aprobado para explorar cómo los Identificadores Persistentes (PIDs) forman parte de las políticas nacionales y los marcos de implementación de infraestructuras de investigación. El grupo reconoce que hay beneficios sistémicos y de red derivados de la adopción generalizada y coherente de los PIDs, incluidos beneficios financieros y de ahorro de tiempo. Los interesados del sector de la investigación, incluidos financiadores, agencias gubernamentales y comunidades de investigación nacionales, han creado consorcios o políticas de PID (incluidos mandatos) en busca de estos beneficios. Al establecerse el grupo de trabajo, las estrategias nacionales de PID comenzaban a surgir en el Reino Unido, Australia, Países Bajos y Canadá como una vía para lograr estos beneficios y se sintió la necesidad de una conversación internacional. La RDA proporcionó un marco para la discusión y alineación entre las estrategias, el refinamiento de la propuesta de valor y la compartición de caminos prácticos para el desarrollo de una estrategia nacional de PID.

Hallazgos de los 18 meses del Grupo de Trabajo:

  • Las estrategias nacionales de PID están en aumento, evidenciado en los estudios de caso recopilados y el creciente impulso de las discusiones en los Plenarios de la RDA y otros foros internacionales.
  • El desarrollo de estrategias nacionales de PID es un fenómeno relativamente nuevo y muchos países están en etapas muy tempranas. De hecho, muchos tienen más bien un enfoque nacional que buscan transformar en una estrategia.
  • Todas las estrategias nacionales de PID están actualmente en desarrollo y, por lo tanto, sujetas a un alto grado de cambio. Durante el curso del Grupo de Trabajo, se recopilaron nueve estudios de caso y varios de estos necesitaron ser actualizados antes de la salida final del Grupo debido a cambios que ocurrieron en esos países.
  • No existe un enfoque único para desarrollar una estrategia nacional de PID. Los componentes críticos incluyen:
    • Una propuesta de valor clara con casos de uso
    • Un grupo u organización responsable de impulsar el desarrollo de la estrategia
    • Un proceso abierto, inclusivo e iterativo que involucre a todas las partes interesadas
    • Una hoja de ruta acompañante que describa pasos prácticos para la implementación
  • Proveedores internacionales de PID como ORCID y DataCite han comenzado a involucrarse activamente con las estrategias nacionales de PID y el Grupo de Trabajo de Estrategias Nacionales de PID de la RDA proporciona un punto focal para fomentar este compromiso.
  • Un objetivo ambicioso del Grupo de Trabajo era mapear actividades comunes y producir una guía para ayudar a otros – independientemente de la región geográfica – a seguir un ‘plan’ para definir su estrategia nacional de PID. Sin embargo, dado los hallazgos mencionados, una ‘Guía de Plan’ para estrategias nacionales de PID no es posible en esta etapa. En su lugar, proporcionamos una Guía que compara y contrasta estrategias nacionales de PID basadas en los nueve estudios de caso recopilados. También se incluye una Lista de Verificación que resume y destaca consideraciones clave.

Futuro de los Identificadores Persistentes (PIDs) en la publicación académica

Packer, Tara. «CHORUS Forum: Navigating the Future of Persistent Identifiers (PIDs) in Scholarly Publishing – Summary». CHORUS (blog), 17 de junio de 2024. https://www.chorusaccess.org/chorus-forum-navigating-the-future-of-persistent-identifiers-pids-in-scholarly-publishing-summary/.

En el Foro CHORUS sobre Navegación hacia el Futuro de los Identificadores Persistentes (PIDs) en la Publicación Académica, se discutió ampliamente sobre los beneficios y desafíos asociados con los PIDs. Destacaron los siguientes puntos:

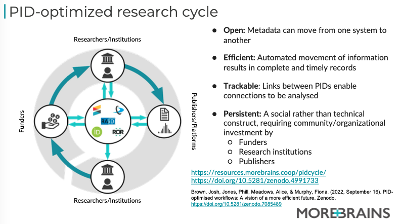
Se mencionaron las cargas administrativas para los investigadores y las dificultades en el análisis de datos como principales preocupaciones. Entre los beneficios se destacó la capacidad para rastrear métricas y establecer conexiones confiables. Se subrayó la importancia de asignar PIDs para optimizar el ciclo de los mismos, facilitando un flujo de trabajo abierto, eficiente, rastreable y persistente.

Alice Meadows, moderadora del evento, mencionó los resultados de una encuesta preliminar entre los participantes, resaltando la investigación y el seguimiento como beneficios, y la falta de interoperabilidad social como un desafío.

John Chodacki, del Centro de Curación de la Universidad de California, compartió iniciativas junto a NISO, Research Data Alliance (RDA) y Open Research Funders Group (ORFG) para definir características deseables de sistemas de PIDs, desarrollar recomendaciones para una Estrategia Nacional de PIDs en EE.UU., y asegurar la interoperabilidad a largo plazo de sistemas de identificadores.

Carly Robinson, del Departamento de Energía de EE.UU., mencionó cómo las agencias federales están implementando PIDs de manera significativa conforme a las directrices de la NSPM-33 y otras políticas, para mejorar la gestión de datos de investigación.

Scott Dineen, de Optica Publishing Group, discutió el papel crítico de los PIDs desde la perspectiva editorial, enfatizando la necesidad de convenciones más rigurosas y transparentes.

Amanda French, de Research Organization Registry (ROR), detalló los esfuerzos para la transición de la identificación de financiadores desde el Crossref Open Funder Registry a ROR, destacando colaboraciones con diversas organizaciones para asegurar la correcta implementación.

El evento concluyó con una sesión de preguntas y respuestas que exploró temas como la infraestructura ideal para PIDs, la inclusión de metadatos mejorados y la ampliación de la participación en la contribución de PIDs en las publicaciones académicas.

Características deseables de los identificadores persistentes

Chodacki, John, y Todd Carpenter. «Desirable Characteristics of Persistent Identifiers». Upstream, 19 de marzo de 2024. https://upstream.force11.org/desirable-characteristics-for-persistent-identifiers/.

En un panorama digital en rápida evolución, los identificadores persistentes (PID) se erigen en componentes cruciales para el avance y la difusión de la investigación, apuntalando la eficiencia, la transparencia y la interconectividad de la comunicación académica. Su aplicación estratégica, guiada por principios y prácticas reconocidos internacionalmente, es esencial para fomentar un entorno de investigación abierto y colaborativo.

Los identificadores persistentes (PIDs) en la investigación académica han recibido una creciente atención, particularmente en el contexto de la ciencia abierta. Varios principios, como los Principios FAIR (Encontrable, Accesible, Interoperable y Reutilizable) y los Principios de Infraestructura Académica Abierta (POSI), destacan la importancia de los PIDs para mejorar la eficiencia y transparencia de la comunicación académica.

Open Science Toolkit, publicado en 2022 por la UNESCO como parte de la fase de aplicación de su Recommendation on Open Science, incluye una guía sobre Bolstering Open Science Infrastructure for All, que detalla lo que la UNESCO considera «factores [que] deben tener en cuenta quienes desarrollan, financian y/o utilizan infraestructuras de ciencia abierta». Entre ellos figuran:

● Transparencia de costes y beneficios;
● Interoperabilidad para potenciar la reutilización;
● Cocreación cooperativa;
● Atención y beneficios compartidos; y
● Armonización con la política de ciencia abierta y supervisión.

Es importante señalar que en el apartado «Infraestructura básica», la UNESCO escribe: «Debe prestarse la debida atención a los identificadores únicos persistentes de los objetos digitales», dejando claro que consideran los PID una parte crucial de la infraestructura más amplia de la ciencia abierta a la que se aplican las consideraciones anteriores.

Los Principios de la Infraestructura Académica Abierta (POSI), desarrollado originalmente en 2015 y actualizado más recientemente en 2023, «ofrece un conjunto de directrices por las que las organizaciones e iniciativas de infraestructura académica abierta que apoyan a la comunidad investigadora pueden ser dirigidas y sostenidas». Algunas de las consideraciones que POSI enumera en el apartado de gobernanza, en particular que la infraestructura abierta debe tener, son las más relevantes para nuestra orientación sobre los PID:

● Cobertura en toda la empresa académica, siendo inclusiva para una amplia gama de disciplinas académicas, geografías, instituciones y actores;
● Gobernada por las partes interesadas, ya que esto «genera confianza en que la organización tomará decisiones impulsadas por el consenso de la comunidad y un equilibrio de intereses»;
● Gobernanza transparente, ya que esto ayuda a construir y mantener la confianza en la comunidad; e
● Incentivos para cumplir la misión, en particular que «las organizaciones y los servicios revisen periódicamente el apoyo de la comunidad y la necesidad de sus actividades».

Scholarly Communication Infrastructure Guide,, publicada por el Grupo de Trabajo de Infraestructura Compartida de HELIOS en 2023, se basa en la visión de la UNESCO de una infraestructura científica abierta. Esta guía hace hincapié en la transparencia, la colaboración, las capacidades técnicas, la gobernanza, el cumplimiento de las normas de acceso público y la puntualidad. Aunque no presiona a favor de proveedores o soluciones concretos, guía a los responsables institucionales a través de las preguntas importantes que deben plantearse a la hora de decidir comprar, construir o asociarse en infraestructuras académicas. Estas mismas preguntas podrían adaptarse y plantearse a la hora de decidir si adoptar determinados PID o servicios relacionados. Por ejemplo:

● ¿Son transparentes y asequibles los precios a corto plazo y los costes a largo plazo?
● ¿Existen oportunidades de asociación con proveedores de código abierto o sin ánimo de lucro?
● ¿Se basa la infraestructura en formatos y protocolos estándar e interoperables?
● ¿Cuál es el plan de sostenibilidad de la organización u organizaciones rectoras que apoyan la infraestructura?
● ¿Pueden los usuarios proporcionar orientación sobre su dirección, usabilidad y desarrollo?
● ¿La infraestructura es propiedad y/o está gobernada por miembros de la comunidad académica?
● ¿Permitirá la infraestructura cumplir los requisitos políticos de los organismos de financiación?

Otra fuente de orientación sobre las características y principios deseables para los PID es el artículo fundacional de 2017 “Identifiers for the 21st Century,», que hace hincapié en varios criterios clave para la infraestructura de EPI:

● Construida para la conexión y la expansión
● Promover la interoperabilidad
● Llenar las lagunas específicas de la comunicación de la investigación
● Garantizar la disponibilidad abierta de los metadatos
● Establecer la fiabilidad de los identificadores persistentes
● Hacer hincapié en la propiedad y la gobernanza de la comunidad
● Fomentar la sostenibilidad de la organización

La implementación estratégica de PIDs, alineada con estos principios y prácticas, es esencial para fomentar un entorno de investigación abierto y colaborativo. Algunas características deseables de la infraestructura de PIDs incluyen la disponibilidad abierta de metadatos básicos, el uso de servicios de resolución establecidos, la documentación de políticas de identificación, servicios de monitoreo y reporte, facilidad de asignación y curación de metadatos, estructuras estandarizadas y extensibilidad, y gobernanza comunitaria. Estas características, combinadas con la adopción de principios globales de ciencia abierta y una colaboración entre la comunidad académica, financiadores y responsables de políticas, pueden garantizar que los PIDs contribuyan a un paisaje académico más inclusivo y transparente.

¿Cuán confiables son los DOI? Un 3% de los enlaces DOI fallan

Crossref, «What, though, do we actually know about the state of persistence of these links?,» Crossref Blog, acceso el 3 de marzo de 2024, https://www.crossref.org/blog/what-do-we-know-about-dois/.

Crossref guarda metadatos de aproximadamente 150 millones de artefactos académicos. Estos van desde artículos de revistas revisados por pares hasta libros académicos y entradas de blog científico. De hecho, en medio de tal heterogeneidad, el único factor singular que une a estos elementos es que se les ha asignado un identificador de objeto de documento (DOI, por sus siglas en inglés); una cadena de identificación única que se puede utilizar para resolver a un recurso relacionado con dichos metadatos (a menudo, aunque no siempre, una copia del trabajo identificado por los metadatos).

Pero, ¿qué sabemos realmente sobre el estado de persistencia de estos enlaces? ¿Cuántos DOIs se resuelven correctamente? ¿Cuántas páginas de destino, al otro extremo de la resolución del DOI, contienen la información que se supone que debe estar allí, incluido el título y el propio DOI? ¿Cómo podemos averiguarlo?

Hablemos de las estadísticas de resolución. Otros estudios, que examinan los enlaces generales en la web, han encontrado una tasa de descomposición de enlaces de aproximadamente del 60% al 70% en un período de diez años (Lessig, Zittrain y Albert 2014; Stox 2022). La tasa de resolución de DOIs que tenemos, con el 97% de los enlaces resueltos (o una tasa de descomposición de enlaces del 3%), es mucho mejor y más sólida que un enlace web en general.

¿Es un 3% un número bueno o malo? Es más sólido que la web en general, pero aún significa que, de cada 100 DOIs, casi 3 no se resolverán. Además, no podemos determinar si estos DOIs se están resolviendo al objetivo correcto, excepto mediante el uso de métricas de detección de metadatos (¿están el título y el DOI en la página de destino, lo cual solo podríamos detectar a una tasa mucho más baja?). Es completamente posible que un sitio web se resuelva con una respuesta HTTP 200 (OK), pero que la página en cuestión sea algo muy diferente a lo que el usuario esperaba, un fenómeno llamado deriva de contenido. Un buen ejemplo es el secuestro de dominios, donde un nombre de dominio expira y empresas de spam los compran. Estos todavía se resuelven a una página web, pero en lugar de un artículo sobre ARN, por ejemplo, el usuario recibe anuncios de mangueras de soldadura de caucho. Dicho esto, otros estudios también son propensos a esto y no hay garantía de que la deriva de contenido no afecte a una gran proporción de enlaces supuestamente buenos en los otros estudios también.

Construir el avión mientras volamos: la promesa de los identificadores persistentes

Ulrich Herb, Pablo de Castro, Laura Rothfritz, & Joachim Schöpfel. (2023). Building the plane as we fly it: the promise of Persistent Identifiers. Zenodo. https://doi.org/10.5281/zenodo.7258286

Este informe es el principal resultado de un estudio encargado por Knowledge Exchange (KE). El objetivo del estudio era investigar los «Riesgos y confianza en la búsqueda de una infraestructura de identificadores persistentes para la investigación que funcione correctamente». La investigación se propuso analizar el estado actual del panorama de los identificadores persistentes (PID) en los seis países socios de Knowledge Exchange y fuera de ellos, teniendo especialmente en cuenta los PID emergentes y examinando las funciones de las partes interesadas pertinentes como proveedores de servicios de PID, instituciones de enseñanza superior, investigadores, editores y bibliotecas nacionales.

El informe examina el panorama de los PID y ofrece una visión detallada de lo que puede fallar en un servicio de PIDI poco fiable. Además, se presentan una serie de recomendaciones dirigidas a cada grupo de interesados.

El informe va acompañado de siete estudios de casos complementarios, que ayudan a profundizar en áreas específicas de actividad, flujos de trabajo y partes interesadas dentro de este panorama más amplio de los PID. Se puede acceder a cada uno de ellos a través del informe.

Sustentabilidad de contenidos e infraestructura abiertos

Sustaining Open Content and Infrastructure. Research Library Issues, no. 302 (2021)

Texto completo

En mayo de 2021, Microsoft anunció que cerraría sus Servicios Académicos de Microsoft (MAS) a finales de año. La noticia de esta decisión resonó en la comunidad académica abierta, suscitando preguntas y preocupaciones entre los numerosos interesados que confiaban en el servicio gratuito para el seguimiento de las actividades de investigación en diversos contextos.

En un momento en que el descubrimiento de la investigación es más necesario que nunca, también se está volviendo más complicado. La labor de seguimiento e identificación de las publicaciones y otros resultados de la investigación se desarrolla en un contexto de mayor complejidad tecnológica, motivaciones y prioridades contrapuestas y recursos limitados. Como ejemplifica el caso de Microsoft, uno de los retos y riesgos fundamentales en el panorama de las infraestructuras académicas es la disponibilidad imprevisible de las plataformas y servicios de los que dependemos para realizar este trabajo.

Cuando estas plataformas y servicios desaparecen, ¿qué nos queda? Estos retos y riesgos podrían superarse o al menos mitigarse si la infraestructura académica se construye con componentes abiertos que puedan persistir más allá de su embalaje. “The Principles of Open Scholarly Infrastructure” (POSI), que se esbozaron inicialmente en 2015 y que están experimentando un renacimiento en 2021, proporcionan un conjunto de directrices para la infraestructura abierta para la investigación y las comunicaciones académicas. Dentro de este marco, la infraestructura abierta es una estrategia para la sostenibilidad. Utilizando los principios POSI como telón de fondo, se examina un ingrediente esencial de la infraestructura abierta: los identificadores persistentes, o PID y las inversiones en los servicios que los soportan, pueden permitir el descubrimiento de los resultados de la investigación y promover la sostenibilidad de los datos y la información.

Las bibliotecas de investigación tienen la oportunidad de adoptar un enfoque «centrado en los PID» para rastrear, compartir y publicar la investigación. Los PID tienen el potencial de abordar los puntos débiles, aumentar la eficiencia y ahorrar tiempo. Promover la implementación de los PID abiertos y los metadatos asociados a ellos sirve al objetivo más amplio de mejorar la conectividad de la información. Aunque este artículo no pretende ofrecer una discusión exhaustiva de las muchas complejidades de la financiación, el mantenimiento y la conexión de la multiplicidad de sistemas académicos, ni promete un estudio exhaustivo de todos los identificadores persistentes, queremos compartir nuestra perspectiva de primera mano sobre la dinámica de la construcción y la planificación de la infraestructura académica abierta y sostenible y queremos esbozar ideas y estrategias para abogar específicamente por la prioridad de los PID abiertos y los metadatos abiertos para garantizar la sostenibilidad de la investigación.

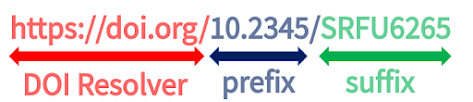
¿Qué es un DOI y para que sirve?

.

Los DOIs o Identificadores de Objetos Digitales se han convertido en algo omnipresente en nuestro ecosistema académico hasta el punto de que la mayoría de los investigadores de hoy en día están al menos vagamente familiarizados con la idea.

.

Cualquier contenido académico puede perder su URL, y aparecer la frase «Error 404» es decir, que el link es inaccesible porque el documento fue borrado o cambiado en cualquier momento. Para solucionar este problema nació el DOI de Crossref: un identificador persistente

Los DOIs son un identificador único y persistente para los artículos, pero tener un DOI no tiene relación con la calidad del artículo. Pero, utilizar el DOI para buscar la URL es más fiable que enlazar con la URL directamente. La idea es que cada vez que la ubicación del contenido académico en la web cambia, el propietario del contenido está obligado a actualizar el enlace al que resuelve el DOI. Por lo tanto, siempre que apuntemos al DOI, se nos enviará a la URL correcta actualizada, lo que reduce la perdida de enlaces.

La actualización de la resolución del DOI puede deberse a un cambio en la estructura interna del sitio web del editor, pero también puede deberse a que el propietario del contenido venda la revista a otro editor.

A menudo se asume que cada contenido único se registra con uno y sólo un DOI y, aunque esto suele ser cierto, hay excepciones. El propio análisis de Crossref en 2020 detectó un 0,8% de duplicados. Hay varias razones para ello. Por ejemplo, si un editor adquiere el control de una revista existente, debería comprobar que el control de los dois correspondientes se transfiere a ellos también y actualizar los enlaces de acuerdo, sin embargo, algunos editores pueden simplemente acuñar sus propios DOIs que lleva a esa duplicación.

Los DOI en general se utilizan hoy en día para algo más que para resolver contenidos. Por un lado, para cumplir la simple función de ser un ID persistente, es necesario mantener metadatos para cada DOI. Como mínimo se necesitaría el DOI y la URL a la que resolver. Obviamente, el DOI también estaría asociado a los metadatos habituales que describen el objeto digital, por ejemplo, el título, el autor, etc.

Pero, además, los metadatos asociados a cada DOI se han ampliado para abarcar múltiples aspectos del objeto, lo que ha dado lugar a interesantes e importantes servicios creados en torno a ellos, como el apoyo a las actualizaciones/comprobaciones de retracción, las comprobaciones de plagio y la búsqueda de citas.

El aspecto clave es que los DOIs pueden expresar relaciones entre DOIs y dado que los DOIs pueden ser usados para una variedad de objetos más allá de los artículos publicados en revistas, como por ejemplo para conjuntos de datos, preprints, revisiones por pares, subvenciones y más, se obtienen muchas posibilidades interesantes.

Por ejemplo, puede vincular un conjunto de datos con un DOI de Datacite a un artículo publicado de la revista Version of Record con un DOI de Crossref. O podría vincular un preprint con un DOI de Crossref con otro DOI de Crossref para la versión publicada del registro.

Una vez que se dispone de una red de objetos de investigación conectados entre sí, podemos crear redes de objetos académicos, lo que Crossref denomina un «nexo de investigación de artículos» que puede utilizarse para realizar consultas para responder a preguntas relevantes. Y, por supuesto, los DOI son sólo un tipo de de identificadores persistentes (PID) . Los DOI pueden incluir otros PID en sus campos, como ORCID para los autores y ROR para las afiliaciones, y al recopilar las relaciones entre dichos PID, se obtiene el gráfico de PID.

En resumen:

  1. Los DOIs no son emitidos sólo por Crossref, existen otras agencias de registro de DOIs*
  2. Los DOIs no se refieren sólo a los enlaces, sino también a los metadatos
  3. Los DOIs de Crossref tienen muchos servicios más allá del registro de contenidos para enlazar, por ejemplo, la comprobación de similitud, Crossmark
  4. Los DOIs permiten el registro de contenidos no sólo de artículos de revistas sino también de contenidos publicados (preprints, blogs) y más.
  5. Los DOIs de Crossref permiten crear relaciones entre los DOIs, por ejemplo, de preprints a VoR (Version of Record), de conjuntos de datos a artículos de revistas, de informes de revisión por pares a artículos, etc.

En realidad, hay 12 agencias de registro de DOI (RA) que pueden registrar o «acuñar» DOIs. La más famosa y popular utilizada por los editores de revistas es Crossref, por supuesto, pero también puede encontrar DOIs registrados de Datacite y raramente otros DOIs de otros como CNKI y Airiti (contenido de China), KISTI (coreano), JaLC (Japón).

Basado en: «5 Things You May Not Know about DOIs or Why There Is More to DOIs than Meets the Eye». Accedido 30 de agosto de 2022. http://musingsaboutlibrarianship.blogspot.com/2022/04/5-things-you-may-not-know-about-dois-or.html.