Archivo de la etiqueta: Identificadores persistentes

Los identificadores descentralizados (DID) v1.0 se convierten en una recomendación del W3C

Decentralized Identifiers (DIDs) v1.0 becomes a W3C Recommendation. W3C, 2022

Texto completo

El Consorcio de la World Wide Web (W3C) ha anunciado que los Decentralized Identifiers (DID) v1.0 son ya una norma oficial de la Web. Este nuevo tipo de identificador verificable, que no requiere un registro centralizado, permitirá tanto a los individuos como a las organizaciones tener un mayor control de su información y relaciones en línea, a la vez que proporciona mayor seguridad y privacidad.

Hay un análogo histórico a este anuncio en la evolución de los números de teléfono móvil. Al principio eran propiedad del operador de telefonía móvil y se «alquilaban» al individuo. Esto obligaba a los individuos a cambiar de número si cambiaban de compañía. Con la adopción de la portabilidad del número de teléfono móvil, los individuos pueden ahora «llevar sus números con ellos» cuando cambian de compañía.

Lo mismo ocurre con la mayoría de las direcciones de correo electrónico y de las redes sociales hoy en día: no son «propiedad» de los individuos y deben ser cambiadas si el individuo cambia de proveedor. En cambio, los identificadores descentralizados del W3C pueden ser controlados por las personas u organizaciones que los crean, son portátiles entre proveedores de servicios y pueden durar todo el tiempo que su controlador quiera seguir utilizándolos.

Además, los DID tienen la propiedad única de permitir al controlador verificar la propiedad del DID mediante criptografía. Esto puede permitir a cualquier controlador de un DID -un individuo, una organización, una comunidad en línea, un gobierno, un dispositivo IoT- realizar transacciones en línea más fiables. Para los individuos en particular, los DID pueden devolverles el control de sus datos personales y su consentimiento, y también permitir relaciones de confianza bidireccionales más respetuosas en las que se evite la falsificación, se respete la privacidad y se mejore la usabilidad.

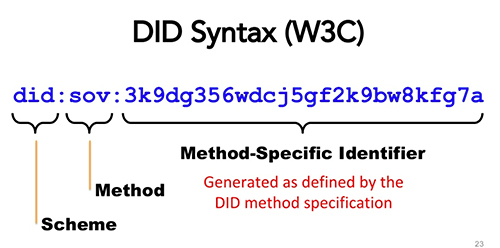
Fundamentalmente, los identificadores descentralizados son un nuevo tipo de identificador globalmente inequívoco que puede utilizarse para identificar a cualquier sujeto (por ejemplo, una persona, una organización, un dispositivo, un producto, una ubicación, incluso una entidad abstracta o un concepto). Cada DID se resuelve en un documento DID que contiene el material criptográfico y otros metadatos para controlar el DID. Los pilares fundamentales de la especificación DID son 1) Los DID no requieren una agencia central de emisión (descentralizados), 2) Los DID no requieren el funcionamiento continuo de una organización subyacente (persistentes), 3) El control de los DID, y la información a la que están asociados, puede ser demostrado criptográficamente (verificable), y 4) Los metadatos de los DID pueden ser descubiertos (resolubles).

Hacia la participación de los investigadores en los sistemas de información para la investigación

Lee, Dong Joon, et al. Towards Researcher Participation in Research Information Systems. mayo de 2016. oaktrust.library.tamu.edu,

Texto completo

Este póster presenta un estudio de colaboración en curso apoyado por la beca de investigación LIS de OCLC/ALISE. Incluye principalmente la descripción y el diseño de la investigación de este estudio.

El proyecto explora la participación de los investigadores en los sistemas de gestión de identidades de investigación (por ejemplo, Google Scholar, ResearchGate, ORCID). Sobre la base de conocimientos de cómo diseñar soluciones fiables, eficientes y escalables para los sistemas, motivar a los investigadores a participar en los sistemas, y contribuir al desarrollo del sistema en entornos de bibliotecas digitales. La identificación y determinación precisa de la identidad de investigación son esenciales para la agrupación, vinculación, agregación y recuperación eficaces de la erudición digital; la evaluación de la productividad de la investigación y el impacto de los individuos, grupos e instituciones; y la identificación de la experiencia y las habilidades.

Existen muchos sistemas de gestión de la identidad de los investigadores procedentes de editoriales, bibliotecas, universidades, motores de búsqueda y agregadores de contenidos, con diferentes modelos de datos, cobertura y calidad. Aunque la curación del conocimiento por parte de profesionales suele producir resultados de la máxima calidad, puede no ser escalable debido a su elevado coste. La literatura sobre comunidades en línea muestra que las comunidades de curación por pares que tienen éxito y son capaces de atraer y retener a suficientes participantes pueden proporcionar soluciones de curación de conocimientos escalables de una calidad comparable a la de los contenidos curados por profesionales.

Por lo tanto, el éxito de los sistemas de gestión de identidades de investigación en línea puede depender del número de colaboradores y usuarios que sean capaces de reclutar, motivar y comprometerse con la curación de datos de identidades de investigación.

Los resultados de esta investigación exploratoria incluirán, entre otros, una teoría cualitativa de las prácticas de información y datos de identidad de los investigadores, un modelo o modelos cuantitativos de las prioridades de los investigadores para los diferentes datos y servicios de identidad de investigación en línea, los factores que pueden afectar a su participación y compromiso con los sistemas de gestión de identidad de investigación en línea, y sus motivaciones para participar en la curación de datos de identidad de investigación. Los resultados del estudio pueden mejorar en gran medida nuestros conocimientos sobre el diseño de los modelos de datos/metadatos de identidad de investigación, los servicios, las actividades de garantía de calidad y los mecanismos de contratación y retención de investigadores para el suministro y mantenimiento de datos de identidad.

Cómo crear un perfil en ORCID

Cómo crear un perfil en ORCID

Los identificadores persistentes surgen para solucionar el problema de los cambios de ubicación y/o nombre de los archivos en Internet. Su objetivo es redireccionar a los documentos, aunque estos hayan cambiado de ubicación en la red (cambio de URL). ORCID es un proyecto abierto, sin ánimo de lucro, comunitario, que ofrece un sistema para la identificación inequívoca de investigadores y un método claro para vincular las actividades de investigación y los productos de estos identificadores.  

  • ORCID es aceptado por organizaciones y editores científicos tan importantes como Nature, Elsevier, Thomson-Reuters, CrossRef, Springer, Wiley, etc.
  • El identificador único ORCID es independiente y normalizado de acuerdo con la norma ISO 27729:2012. Consta de 16 dígitos que forman un código único, persistente asociado a cada autor registrado en ORCID.
  • Se trata de un código único personal sincronizado con los diferentes identificadores de cada investigador en los principales portales académicos
  • El identificador único ORCID permitirá a cada investigador conectar directamente con sus IDs en Scopus, WOK (Web of Knowledge), CrossRef y transferir los datos de sus publicaciones de manera automática desde estos portales hacia ORCID,

Qué implica la ruptura de hiprenlaces en la web: estudio de la deriva de enlaces y contenidos en The New York Times.

Zittrain, Jonathan, John Bowers, and Clare Stanton. «The Paper of Record Meets an Ephemeral Web: An Examination of Linkrot and Content Drift within The New York Times.» Library Innovation Lab, Harvard Law School, 2021

Ver completo

Los hipervínculos son una herramienta poderosa para los periodistas y sus lectores. Para profundizar en el contexto de un artículo, basta con un clic. Pero los hipervínculos son un arma de doble filo: a pesar de lo ilimitado de Internet, lo que se encuentra en la Red también puede modificarse, desplazarse o desaparecer por completo.

La fragilidad de la Red supone un problema para cualquier área de trabajo o interés que dependa de los registros escritos. La pérdida de material de referencia, los impactos negativos en el SEO y el secuestro malicioso de valiosos outlinks son algunos de los efectos adversos de una URL rota. Y lo que es más importante, deja los artículos de décadas pasadas como cáscaras vacías de lo que fueron, desvinculados de su fuente y contexto originales. En un estudio de 2014, por ejemplo, unos investigadores descubrieron que casi la mitad de los hipervínculos de las opiniones del Tribunal Supremo conducían a contenidos que habían cambiado desde su publicación original o habían desaparecido de Internet.

Esta decadencia, a menudo irreversible, de los contenidos web se conoce comúnmente como linkrot. Es similar al problema relacionado con la deriva del contenido, o los cambios típicamente no anunciados -retiros, adiciones, sustituciones- en el contenido de una determinada URL.

Este estudio examinó los hipervínculos en los artículos del New York Times, desde el lanzamiento del sitio web del Times en 1996 hasta mediados de 2019, desarrollados sobre la base de un conjunto de datos que nos proporcionó el Times. La sustancial deriva de enlaces y contenidos que se econtró refleja las dificultades inherentes a la vinculación a largo plazo de enlaces de una web volátil. The Times, en particular, es un abanderado del periodismo digital con buenos recursos y una sólida estructura de archivo institucional. Su interés por afrontar el reto del linkrot indica que aún no se ha entendido ni abordado de forma exhaustiva en todo el ámbito.

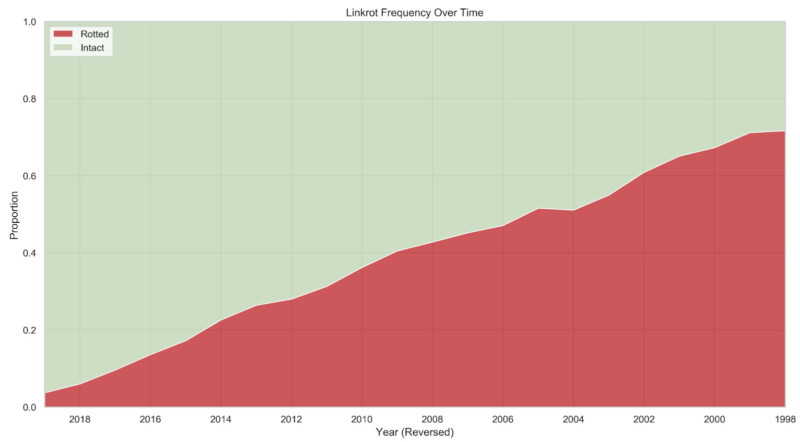
Se descubrió que de los 553.693 artículos incluidos en el estudio -es decir, que incluían URLs en nytimes.com- había un total de 2.283.445 hipervínculos que apuntaban a contenidos fuera de nytimes.com. El 72% de ellos eran «enlaces profundos» con una ruta a una página específica, como example.com/article, que es donde se centró el análisis (en lugar de simplemente example.com, que componía el resto del conjunto de datos). De estos enlaces profundos, el 25% de los enlaces eran completamente inaccesibles. La putrefacción de los enlaces se hizo más común con el tiempo: el 6 por ciento de los enlaces de 2018 se habían corrompido, en comparación con el 43 por ciento de los enlaces de 2008 y el 72 por ciento de los enlaces de 1998. El 53% de todos los artículos que contenían enlaces profundos tenían al menos un enlace fallido.

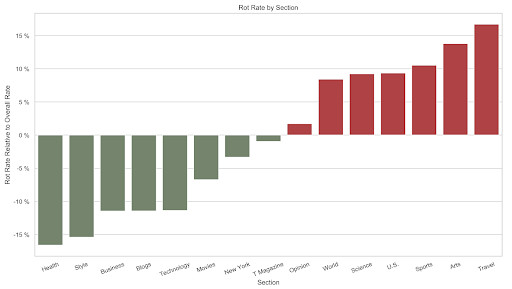
Ciertas secciones del Times mostraron tasas mucho más altas de URLs podridas. Los enlaces de la sección de deportes, por ejemplo, muestran una tasa de putrefacción relativa de alrededor del 36%, frente al 13% de The Upshot. Esta diferencia tiene que ver, en gran parte, con el tiempo. La edad media de un enlace en The Upshot es de 1.450 días, frente a los 3.196 días de la sección de deportes.

Enlaces rotos por secciones

ORCID llega a los 10 millones de perfiles

Después de 8 años de trayectoria ORCID llega a los 10000000 de perfiles. A fines de 2012, solo tres meses después de que lanzamos el registro ORCID, disponía de casi 50.000 investigadores ya se habían registrado para obtener un iD . Diez meses después de eso, el récord de ORCID creciera a casi 250,000 (¡con 80 miembros!) En dos años se llegó a 1,000,000 de iD , y nueve meses después de eso, en 2015,  1.5 millones de iD . 

Desde 2015 la plataforma ha estado creciendo constantemente superando incluso las más altas expectativas:

  • En 2015, el récord creció en 788.650 registros,
  • En 2016, por 1.068.295
  • En 2017, 1.388.796
  • En 2018, creció en 1.585.851
  • En 2019, por 2.006.672, y
  • En 2020 (hasta ahora), 2,293,631! 

Y la semana pasada, ORCID alcanzó otro hito importante: ¡10 millones de ORCID iD registrados! 

¿Qué es y cómo funciona ORCID?. Planeta Biblioteca 2020/10/21.

La imagen tiene un atributo ALT vacío; su nombre de archivo es paloma_marinarraiza-copia.jpg

Qué es y cómo funciona ORCID. Planeta Biblioteca 2020/10/21.

con Paloma Marín Arraiza

ESCUCHAR EL PROGRAMA

Ir a descargar

Paloma Marín Arraiza es licenciada en física por la Universidad de Granada (España) y máster en Información y Comunicación Científica por la misma universidad. Realizó su doctorado en Ciencia de la Información en la Universidad Estatal Paulista – UNESP (Brasil). Ha trabajado en la Biblioteca Nacional Alemana de Ciencia y Tecnología en Hannover (Alemania), en su portal de videos cientíticos, TIB-AV/Portal y en el biblioteca de la Universidad Técnica de Viena (Austria), tratando temas de identificadores persistentes (PIDs). Actualmente es Engagement Lead para Europa en ORCID y trabaja directamente con instituciones que implementen ORCID en sus sistemas. Asimismo, colabora con el programa de posgrado en Ciencia de la Información de la UNESP con una asignatura sobre Ciencia Abierta y Gestión de Datos de Investigación. Hemos hablado con Paloma sobre todas cuestiones relacionadas con el identificador de investigadores persistente ORCID

Informe anual ORCID de 2019 (2020)


screen20shot202020-03-1820at202_55_1220pm


ORCID Releases 2019 Annual Report, ORCID, 2020

Texto completo

Tutorial para crear un perfil en ORCID

Durante 2019s e registraron 1.957.249 nuevos usuarios para una identificación ORCID, lo que supone un total de 7.763.812 usuarios al final del año. Alrededor de 5.400 investigadores crean una identificación cada día, lo que supone un aumento del 8% con respecto a 2018 Más del 40% de los registros – 3.219.135 – tienen una conexión con al menos otro identificador.

¿Qué es el ORCID?

ORCID (en inglés «Open Researcher and Contributor ID», en español Identificador Abierto de Investigador y Colaborador) es un código alfanumérico, no comercial, que identifica de manera única a científicos y otros autores académicos

Proporciona tres servicios esenciales:

  • Un identificador único de investigadores
  • Un conjunto de API para permitir a los investigadores conectar su iD con sus afiliaciones y contribuciones, y
  • Una base de datos para almacenar estas conexiones.


Documentos relacionados


Perma.cc: ayuda a los investigadores y revistas a crear registros permanentes de las fuentes de Internet que citan.

40341841553_a16d10d073_b_d

https://perma.cc

Para suscribirse como biblioteca

Más información sobre


La rotura de enlaces se produce cuando se cita una fuente en línea que posteriormente desaparece o cambia de servidor o de ubicación. Es un gran problema, especialmente para los académicos, que dependen en gran medida de las citas de fuentes estables a las que los lectores pueden acceder. Perma.cc archiva el contenido referenciado y genera un enlace a un registro archivado en una página. Independientemente de lo que pueda suceder con la fuente original, el registro archivado siempre estará disponible.  


Cuando generamos una página web, al principio todos los vínculos funcionan correctamente. Después de un año, más del 20% de los enlaces citados pueden estar muertos o ser inaccesibles. Después de cinco años, la situación es mucho peor: más del 50% de los enlaces citados pueden verse afectados. A medida que pasa el tiempo. La rotura del enlace es inevitable y raramente reversible. Cuanto más extenso sea el tiempo, más probable es que un enlace haya caído. Tomando como ejemplo una muestra de varias revistas jurídicas, aproximadamente el 70% de todos los enlaces en las citas publicadas entre 1999 y 2011 habían perdido el enlace a su contenido original.

Los enlaces rotos en los artículos de las revistas socavan el sistema de erudición legal basado en citas al ocultar la evidencia que subyace a las ideas de los autores. El uso de Perma.cc asegura que el material citado por los autores esté siempre accesible a los lectores, preservando la base de la erudición y la referencia en línea. Un enlace persistente es un enlace fiable e irrompible a un registro inalterable de cualquier página que se haya citado.

¿Como funciona?

Los usuarios van al sitio web Perma.cc e introducen una URL. Perma.cc descarga el material en esa URL y devuelve una nueva URL (un «enlace Perma.cc») que puede sinsertarse en un documento, artículo, blog o lo que el autor necesite.

Los lectores que encuentren enlaces a Perma.cc pueden hacer clic en ellos como si fueran URLs ordinarias. Esto los lleva al sitio Perma.cc donde se les presenta una página que tiene enlaces tanto a la fuente original de la web (junto con alguna información, incluyendo la fecha de creación del enlace Perma.cc) como a la versión archivada almacenada por Perma.cc.

Perma.cc depende de un conjunto distribuido de revistas y bibliotecas para su administración. Las revistas trabajan con los autores para crear archivos y las bibliotecas proporcionan orientación y supervisión a las revistas.

El sistemas ha sido desarrollado por la Biblioteca de la Facultad de Derecho de Harvard junto con bibliotecas jurídicas universitarias de Estados Unidos. Las instituciones académicas y los tribunales pueden convertirse en registradores de Perma.cc de forma gratuita, y también pueden proporcionar cuentas a sus usuarios de forma gratuita. También las organizaciones pueden administrar cuentas Perma ilimitadas para sus usuarios por una tarifa plana mensual de grupo. Estas cuentas de registrador también incluyen herramientas de colaboración y controles administrativos.

Las personas pueden acceder a Perma a través de suscripciones por niveles que se adaptan a sus necesidades particulares. El estado de la suscripción no afecta a la conservación, acceso o visibilidad de los enlaces ya creados, sólo a la cantidad de enlaces Perma que un usuario puede crear en un mes determinado.


Estudios de caso sobre identificadores persistentes en la gestión de la información de la investigación europea


liber-cover-500

Bryant, Rebecca, Annette Dortmund, and Constance Malpas. Convenience and Compliance: Case Studies on Persistent Identifiers in European Research Information. Dublin, Ohio: OCLC Research, 2017.
doi:10.25333/C32K7M

Texto completo

Este informe proporciona a los líderes de universidades y bibliotecas de investigación información útil sobre prácticas e infraestructuras emergentes en la gestión de la información de investigación europea (RIM), sobre el papel actual y futuro de los identificadores de personas y organizaciones persistentes y, más específicamente, sobre los incentivos y barreras a la adopción en tres entornos nacionales diferentes -Finlandia, Alemania y Países Bajos- con el fin de comprender mejor la dinámica de la toma de decisiones en este espacio.

A través de investigaciones y entrevistas semiestructuradas con profesionales y partes interesadas de universidades, bibliotecas nacionales y organizaciones de colaboración en materia de tecnología de la información y las comunicaciones (TIC) de Finlandia, Alemania y Países Bajos, los autores exploran las prácticas institucionales locales de la gestión de la información de investigación y examinan el papel -quizás incluso la necesidad- de identificadores persistentes para facilitar las actividades de gestión de la información de investigación a escala de grupo y la agregación de datos. Este trabajo formó parte de una colaboración de investigación conjunta con LIBER (Ligue des Bibliothèques Européennes de Recherche – Asociación de Bibliotecas de Investigación Europeas).

Este informe documenta un panorama de la gestión de la información de investigación que cambia rápidamente, a medida que los sistemas CRIS agregan más tipos de datos, recogen publicaciones de un número creciente de fuentes externas y sirven como un nodo importante que interactúa dentro de un panorama de comunicaciones académicas amplio y complejo.