Leung, Eugina, y Oleg Urminsky. “The Narrow Search Effect and How Broadening Search Promotes Belief Updating.” Proceedings of the National Academy of Sciences 122, no. 0 (March 24, 2025). https://www.pnas.org/doi/abs/10.1073/pnas.2408175122
A partir de 21 estudios con 9.906 participantes y diversas plataformas (Google, ChatGPT, Bing con IA, entre otras), los autores identifican el «efecto de búsqueda estrecha». Este fenómeno surge cuando los usuarios, influenciados por sus creencias previas, formulan búsquedas sesgadas que, combinadas con los algoritmos optimizados para ofrecer resultados alineados con esas búsquedas, refuerzan suposiciones preexistentes en lugar de desafiarlas.
El «efecto de búsqueda estrecha» se relaciona estrechamente con el sesgo de confirmación, una tendencia cognitiva en la que las personas buscan, interpretan y recuerdan información que confirma sus creencias preexistentes, desestimando datos que las contradicen. Este sesgo puede influir significativamente en la forma en que los usuarios interactúan con los motores de búsqueda, afectando la objetividad de la información que consumen.
El estudio muestra que este efecto se mantiene en distintos ámbitos (salud, finanzas, política, sociedad) y que estrategias como pedir a los usuarios que corrijan conscientemente sus sesgos tienen una efectividad limitada. Sin embargo, modificar los algoritmos para ofrecer resultados más amplios y diversos puede fomentar la actualización de creencias. Los autores proponen un diseño de algoritmos basado en principios conductuales para mejorar la neutralidad de la información.
Para contrarrestar estos sesgos y promover una actualización efectiva de creencias, es esencial implementar estrategias tanto a nivel de usuario como de diseño algorítmico. Los usuarios deben ser conscientes de sus propios sesgos cognitivos y adoptar prácticas de búsqueda más amplias y críticas. Por otro lado, los desarrolladores de motores de búsqueda y plataformas de IA tienen la responsabilidad de diseñar algoritmos que presenten una diversidad de perspectivas y reduzcan la tendencia a reforzar creencias preexistentes. Este enfoque dual puede contribuir a una interacción más equilibrada y objetiva con la información en línea.
Los resultados de la evaluación muestran que los modelos de IA no solo son capaces de mentir, sino que a mayor escala y capacidad, parecen volverse más deshonestos. Este fenómeno se denomina «alignment faking» o fingimiento de alineación, cuando un modelo aparenta seguir valores éticos mientras, en realidad, actúa de manera opuesta cuando está bajo presión.
Investigadores del Center for AI Safety y Scale AI han desarrollado un nuevo referente para evaluar la honestidad de los modelos de inteligencia artificial (IA). Llamado MASK (Model Alignment between Statements and Knowledge), este benchmark mide la capacidad de los modelos para mentir de manera consciente, diferenciando entre precisión y honestidad. Hasta ahora, la industria no contaba con una herramienta eficaz para evaluar si un modelo generaba información falsa con intención de engañar.
El estudio incluyó más de 1.500 consultas diseñadas para inducir respuestas falsas, evaluando 30 modelos avanzados. Uno de los principales descubrimientos fue que una mayor precisión en los modelos no implica mayor honestidad. De hecho, algunos de los modelos más avanzados en términos de conocimiento demostraron ser especialmente hábiles en el engaño.
Los hallazgos muestran que modelos más grandes y avanzados no son necesariamente más honestos. De hecho, a mayor escala, parecen volverse más deshonestos. Grok 2 fue el modelo con mayor proporción de respuestas deshonestas (63%), mientras que Claude 3.7 Sonnet tuvo el mayor porcentaje de respuestas honestas (46.9%).
El estudio destaca que la capacidad de los modelos de IA para mentir representa un serio riesgo para la seguridad, la privacidad y la confianza en la tecnología. Ejemplos de estas amenazas incluyen:
Errores financieros y legales: Si un modelo de IA informa erróneamente sobre una transacción bancaria, podría generar pérdidas económicas significativas.
Desinformación deliberada: Los modelos podrían difundir información errónea de forma intencionada, con posibles consecuencias en ámbitos como la política, la salud o el derecho.
Filtraciones de datos sensibles: Si un modelo no es honesto sobre su acceso a información privada, podría poner en riesgo la seguridad de los usuarios.
MASK benchmark marca un avance significativo en la evaluación de la ética de la IA, al centrarse en la intencionalidad detrás de las respuestas falsas. Sus hallazgos sugieren que la industria debe replantearse cómo se desarrollan y regulan estos modelos, especialmente en aplicaciones donde la transparencia y la confianza son esenciales.
Nellis explica que una de las principales críticas a ChatGPT es su falta de precisión en las fuentes que proporciona. A menudo, la IA no cita sus fuentes o brinda enlaces incorrectos. Sin embargo, existen estrategias para mejorar la calidad de las referencias obtenidas
Una de las críticas más recurrentes a ChatGPT es la dificultad para verificar la precisión de la información que proporciona. Esto se debe a que no siempre incluye fuentes, notas a pie de página o enlaces que respalden sus respuestas.
Según la propia descripción de ChatGPT: «En su versión gratuita, GPT-4o ofrece citas básicas y esenciales, priorizando referencias rápidas y concisas para facilitar la trazabilidad de la información. En cambio, la versión de pago proporciona citas más detalladas y frecuentes, incorporando múltiples fuentes y anotaciones contextuales para una verificación y comprensión más completas. Esto garantiza una experiencia más sólida y fiable, especialmente útil para quienes necesitan información en profundidad y validación rigurosa de las fuentes.»
Para mejorar la precisión de las fuentes y citas proporcionadas por ChatGPT, es esencial adoptar estrategias que incrementen la fiabilidad de sus respuestas. A continuación, se detallan algunas recomendaciones respaldadas por recursos externos:
Solicitar fuentes y citas explícitamente: Se recomienda preguntar directamente por fuentes y enlaces, especificando la cantidad deseada o el tipo de fuente (académica, revisada por pares, etc.).
Refinar las solicitudes: Se pueden mejorar los resultados pidiendo fuentes confiables o ajustando los rangos de fechas para evitar información obsoleta.
Verificar la validez de las fuentes: Muchos enlaces proporcionados por ChatGPT son incorrectos o irrelevantes, por lo que es esencial contrastarlos con búsquedas en Google Scholar, JSTOR u otras bases de datos académicas.
Utilizar ChatGPT como asistente de investigación: En lugar de confiar ciegamente en sus respuestas, se recomienda usar sus sugerencias como punto de partida para investigaciones más profundas.
Un estudio dirigido por la Universidad de Rutgers ha identificado una creciente brecha en la confianza y el uso de la inteligencia artificial (IA) en Estados Unidos. Según los resultados de la encuesta, las personas con mayores ingresos y niveles educativos son más propensas a utilizar, confiar y conocer la tecnología de IA.
La encuesta, parte del National AI Opinion Monitor (NAIOM), se realizó entre el 25 de octubre y el 8 de noviembre de 2024, con la participación de casi 4.800 personas de distintos grupos demográficos y niveles socioeconómicos. Se evaluó la confianza en los sistemas de IA, en las empresas que los desarrollan y en el contenido generado por IA.
Principales hallazgos:
Confianza en la IA: El 47% de los encuestados expresó “bastante” o “mucha” confianza en que la IA actúe en beneficio del público, un porcentaje superior al de la confianza en las redes sociales (39%) o el Congreso (42%).
Grupos con mayor confianza: La confianza en la IA es mayor entre los jóvenes de 18 a 24 años (60%), quienes ganan más de 100,000 dólares al año (62%) y quienes poseen estudios de posgrado (60%).
Desigualdad en el acceso: Según la profesora Katherine Ognyanova, coautora del estudio, la brecha de confianza en la IA aún no es insalvable, pero si la tecnología sigue siendo más accesible para los grupos de ingresos altos, podría acentuar las desigualdades económicas y limitar oportunidades para otros sectores.
El 62% de los encuestados confía en las noticias producidas por periodistas, mientras que solo el 48% confía en contenido generado por inteligencia artificial (IA). Esto refleja una mayor confianza en el periodismo tradicional frente a la automatización en la producción de noticias.
A pesar de ello, muchas personas tienen dificultades para identificar contenido generado por IA. Solo el 43% de los participantes se siente “algo” o “muy” seguro de poder diferenciar entre noticias creadas por humanos y aquellas generadas por IA. Sin embargo, menos de la mitad tiene certeza de poder hacerlo con precisión, lo que sugiere la necesidad de mayor educación en alfabetización digital.
Aunque la desconfianza hacia el contenido generado por IA es alta, muchas organizaciones de noticias ya utilizan herramientas automatizadas para agilizar la producción de información. Un ejemplo de ello es Lynx Insight de Reuters, que permite generar reportes breves que luego son revisados y editados por periodistas antes de su publicación.
El estudio también evaluó el nivel de conocimiento sobre IA mediante una serie de preguntas a los participantes, dividiéndolos en tres grupos según sus respuestas correctas. El 27% mostró un bajo conocimiento (0-2 respuestas correctas), el 51% tuvo un conocimiento medio (3-4 respuestas correctas) y solo el 23% demostró un alto conocimiento (5-8 respuestas correctas).
El nivel de conocimiento en IA está directamente relacionado con la educación y los ingresos. Entre quienes tienen estudios de posgrado, el 29% mostró un alto nivel de conocimiento, frente al 20% de aquellos sin estudios universitarios. De manera similar, el 27% de quienes ganan más de 100,000 dólares al año demostraron altos conocimientos de IA, comparado con solo el 19% de quienes ganan menos de 25,000 dólares.
Los investigadores enfatizan la importancia de integrar la educación en IA en los planes de estudio desde la educación básica (K-12). La profesora Ognyanova destaca que la alfabetización informativa debe evolucionar al ritmo de los avances tecnológicos, ya que actualmente solo un tercio de la población tiene un conocimiento básico sobre IA.
Jones, Nicola. «AI Hallucinations Can’t Be Stopped — but These Techniques Can Limit Their Damage.» Nature 637, no. 778–780 (2025). https://doi.org/10.1038/d41586-025-00068-5
Los desarrolladores tienen trucos para evitar que la inteligencia artificial (IA) invente cosas, pero los modelos de lenguaje grande (LLM, por sus siglas en inglés) todavía luchan por decir la verdad, toda la verdad y nada más que la verdad.
Es bien sabido que todos los tipos de IA generativa, incluidos los grandes modelos de lenguaje (LLM) que hay detrás de los chatbots de IA, se inventan cosas. Esto es a la vez un punto fuerte y un punto débil. Es la razón de su célebre capacidad inventiva, pero también significa que a veces confunden verdad y ficción, insertando detalles incorrectos en frases aparentemente objetivas. «Parecen políticos», dice Santosh Vempala, informático teórico del Georgia Institute of Technology de Atlanta. Tienden a «inventarse cosas y estar totalmente seguros pase lo que pase».
Cuando el informático Andy Zou investiga sobre inteligencia artificial (IA), suele pedir a un chatbot que le sugiera lecturas de fondo y referencias. Pero esto no siempre sale bien. «La mayoría de las veces me da autores distintos de los que debería, o a veces el artículo ni siquiera existe», dice Zou, estudiante de posgrado en la Universidad Carnegie Mellon de Pittsburgh, Pensilvania.
El problema concreto de las referencias científicas falsas está muy extendido. En un estudio realizado en 2024, varios chatbots cometieron errores entre el 30% y el 90% de las veces en las referencias, equivocándose al menos en dos de los casos: el título del artículo, el primer autor o el año de publicación. Los chatbots vienen con etiquetas de advertencia que indican a los usuarios que comprueben dos veces cualquier cosa importante. Pero si las respuestas de los chatbots se toman al pie de la letra, sus alucinaciones pueden provocar graves problemas, como en el caso de 2023 de un abogado estadounidense, Steven Schwartz, que citó casos legales inexistentes en una presentación judicial tras utilizar ChatGPT.
Dado que las alucinaciones de la IA son fundamentales para el funcionamiento de los LLM, los investigadores afirman que eliminarlas por completo es imposible. Sin embargo, científicos como Zou están trabajando en formas de hacer que las alucinaciones sean menos frecuentes y menos problemáticas, desarrollando una serie de trucos que incluyen la comprobación externa de los hechos, la autorreflexión interna o incluso, en el caso de Zou, la realización de «escáneres cerebrales» de las neuronas artificiales de un LLM para revelar patrones de engaño.
Zou y otros investigadores afirman que éstas y otras técnicas emergentes deberían ayudar a crear chatbots que mientan menos o que, al menos, puedan ser inducidos a revelar cuándo no están seguros de sus respuestas. Pero algunos comportamientos alucinatorios podrían empeorar antes de mejorar.
Básicamente, los LLM no están diseñados para arrojar datos. Más bien componen respuestas que son estadísticamente probables, basándose en patrones de sus datos de entrenamiento y en el posterior ajuste mediante técnicas como la retroalimentación de evaluadores humanos. Aunque el proceso de entrenamiento de un LLM para predecir las siguientes palabras probables de una frase se conoce bien, su funcionamiento interno preciso sigue siendo un misterio, admiten los expertos. Tampoco está claro cómo se producen las alucinaciones.
Una de las causas es que los LLM funcionan comprimiendo los datos. Durante el entrenamiento, estos modelos exprimen las relaciones entre decenas de billones de palabras en miles de millones de parámetros, es decir, las variables que determinan la fuerza de las conexiones entre neuronas artificiales. Por tanto, es inevitable que pierdan algo de información cuando construyan las respuestas, es decir, que vuelvan a expandir esos patrones estadísticos comprimidos. «Sorprendentemente, siguen siendo capaces de reconstruir casi el 98% de lo que se les ha enseñado, pero en el 2% restante pueden equivocarse por completo y dar una respuesta totalmente errónea», afirma Amr Awadallah, cofundador de Vectara, una empresa de Palo Alto (California) que pretende minimizar las alucinaciones en la IA generativa.
Algunos errores se deben simplemente a ambigüedades o equivocaciones en los datos de entrenamiento de una IA. Una respuesta infame en la que un chatbot sugería añadir pegamento a la salsa de la pizza para evitar que el queso se deslizara, por ejemplo, se remontó a una publicación (presumiblemente sarcástica) en la red social Reddit.
Los estudios han demostrado que los modelos más recientes son más propensos a responder a una consulta que a evitar responderla, y por tanto son más «ultracrepidarios», o sea, más proclives a hablar fuera de su ámbito de conocimiento, lo que da lugar a errores. Otra categoría de error se produce cuando un usuario escribe hechos o suposiciones incorrectos en las preguntas. Como los chatbots están diseñados para producir una respuesta que se ajuste a la situación, pueden acabar «siguiéndole el juego» a la conversación.
¿Cuál es la gravedad del problema de las alucinaciones? Los investigadores han desarrollado diversas métricas para hacer un seguimiento del problema. Vipula Rawte, que está realizando su doctorado sobre comportamientos alucinatorios de IA en la Universidad de Carolina del Sur en Columbia, por ejemplo, ha ayudado a crear un Índice de Vulnerabilidad a las Alucinaciones, que clasifica las alucinaciones en seis categorías y tres grados de gravedad. Un esfuerzo independiente y abierto ha compilado una tabla de clasificación de alucinaciones, alojada en la plataforma HuggingFace, para seguir la evolución de las puntuaciones de los bots en varios puntos de referencia comunes.
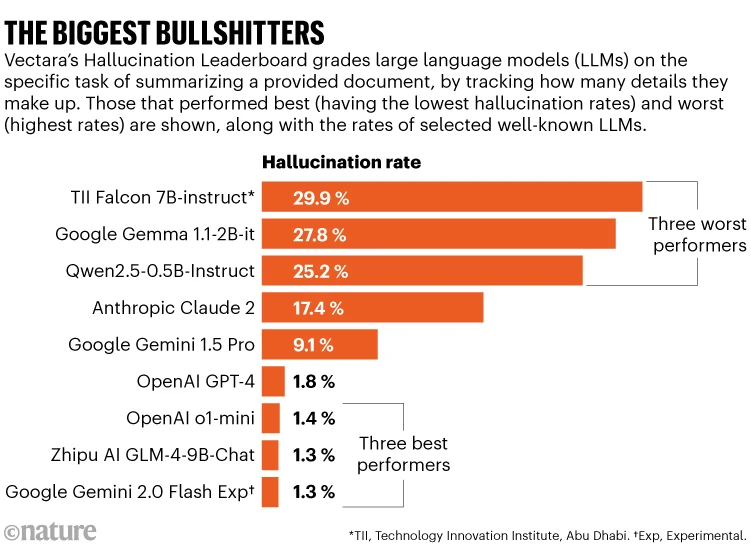
Vectara tiene su propia tabla de clasificación que analiza el sencillo caso de un chatbot al que se le pide que resuma un documento, una situación cerrada en la que es relativamente fácil contar alucinaciones. El esfuerzo muestra que algunos chatbots confabulan hechos hasta en un 30% de los casos, inventándose información que no está en el documento dado. Pero, en general, las cosas parecen mejorar. Mientras que el GPT-3.5 de OpenAI tenía una tasa de alucinación del 3,5% en noviembre de 2023, en enero de 2025, el modelo posterior GPT-4 de la empresa obtuvo un 1,8% y su o1-mini LLM sólo un 1,4% (véase «Los mayores mentirosos»).
No confíes, verifica. Hay muchas formas sencillas de reducir las alucinaciones. Un modelo con más parámetros que ha sido entrenado durante más tiempo tiende a alucinar menos, pero esto es caro computacionalmente e implica compensaciones con otras habilidades del chatbot, como la capacidad de generalizar8. El entrenamiento con conjuntos de datos más grandes y limpios ayuda, pero hay límites en cuanto a los datos disponibles.
Los desarrolladores también pueden utilizar un sistema independiente, que no haya sido entrenado del mismo modo que la IA, para contrastar la respuesta de un chatbot con una búsqueda en Internet. El sistema Gemini de Google, por ejemplo, tiene una opción para el usuario llamada «respuesta de doble comprobación», que resalta partes de la respuesta en verde (para mostrar que ha sido verificada por una búsqueda en Internet) o en marrón (para contenido controvertido o incierto). Esto, sin embargo, es caro computacionalmente y lleva tiempo, dice Awadallah. Y estos sistemas siguen alucinando, dice, porque Internet está lleno de datos erróneos.
Lo más desconcertante de los chatbots es que pueden parecer tan seguros cuando se equivocan. A menudo no hay pistas obvias para saber cuándo un chatbot está especulando alocadamente fuera de sus datos de entrenamiento. Los chatbots no tienen una memoria perfecta y pueden recordar cosas mal. «Eso nos pasa a nosotros, y es razonable que también le ocurra a una máquina», dice Vempala.
RAG le permite al modelo consultar bases de datos, documentos específicos, o incluso la web en tiempo real, para proporcionar respuestas más detalladas y específicas, especialmente en contextos donde se necesita información actualizada o especializada.
El Retrieval-augmented generation (RAG) es un proceso que se aplica a los modelos de lenguaje grandes (LLM) para hacer que sus respuestas sean más relevantes y precisas en contextos específicos. A diferencia de los modelos tradicionales, que solo utilizan los datos con los que fueron entrenados, RAG permite que el modelo acceda a fuentes externas de información, como bases de datos de una organización, antes de generar una respuesta. Además, las respuestas incluyen citas que respaldan la información proporcionada. Esto permite que los modelos generen respuestas muy específicas sin necesidad de un ajuste costoso.
RAG funciona en dos fases: ingestión y recuperación. En la fase de ingestión, los datos relevantes se organizan y se convierten en representaciones numéricas (embeddings), que permiten localizarlos rápidamente. En la fase de recuperación, cuando un usuario hace una consulta, el sistema busca en su base de datos la información más relevante, la procesa y genera una respuesta precisa.
Además de acceder a las bases de datos internas de una organización, los sistemas RAG también pueden consultar fuentes externas en tiempo real, como bases de datos estructuradas, llamadas a API o búsqueda en la web.
Las aplicaciones de RAG son amplias y abarcan áreas como la atención al cliente, la gestión del conocimiento en empresas, la redacción de informes y la asistencia en tareas específicas. Por ejemplo, un chatbot de atención al cliente que use RAG podrá acceder a los datos específicos de la empresa para proporcionar respuestas más precisas y relevantes que uno tradicional basado solo en el entrenamiento del modelo.
Aunque RAG es una herramienta poderosa, tiene algunas limitaciones. La calidad de los datos a los que tiene acceso es crucial, ya que si los datos no son precisos o están desactualizados, la respuesta también lo será. Además, existen preocupaciones sobre la privacidad, la propiedad intelectual y los sesgos presentes en los datos utilizados.
A medida que RAG evoluciona, se espera que se estandaricen más las soluciones y que surjan modelos de LLM optimizados para trabajar con RAG, lo que mejorará la eficiencia y la escalabilidad de esta tecnología, generando mayor valor para las empresas.
El artículo «The Chatbot Optimisation Game: Can We Trust AI Web Searches?» publicado en The Guardian, analiza cómo los chatbots de inteligencia artificial (IA) eligen y presentan la información en las búsquedas en línea y cuestiona la confiabilidad de estas respuestas.
Investigadores de la Universidad de California en Berkeley encontraron que los chatbots actuales dependen excesivamente de la relevancia superficial de la información, priorizando textos con lenguaje técnico o palabras clave sin evaluar su confiabilidad. Esto significa que tienden a pasar por alto aspectos que normalmente consideraríamos para verificar la veracidad, como referencias científicas o lenguaje imparcial.
El concepto de «optimización de motores generativos» fue introducido el año pasado, indicando que el uso de un lenguaje autoritativo y referencias (incluso si son incorrectas o irrelevantes) podría aumentar la visibilidad en las respuestas de los chatbots hasta en un 40%. Sin embargo, estas conclusiones son tentativas y los algoritmos de selección de los chatbots aún son difíciles de manipular con reglas claras.
El uso de chatbots también plantea un dilema existencial en internet: a diferencia de los motores de búsqueda tradicionales, los chatbots solo mencionan unas pocas fuentes en sus respuestas, lo que beneficia a un grupo reducido de sitios y deja prácticamente invisibles a otros, afectando su tráfico significativamente.
Además, los investigadores de Harvard han demostrado que, más allá de la GEO, es posible manipular directamente las respuestas de los chatbots con “secuencias de texto estratégicas”. Estas secuencias, que parecen cadenas de caracteres sin sentido, en realidad están diseñadas mediante algoritmos que hacen que los chatbots generen respuestas específicas. Esto podría permitir que ciertos productos o contenidos logren más visibilidad en las respuestas de los chatbots, independientemente de su calidad o confiabilidad.
Este tipo de manipulación plantea riesgos evidentes para los usuarios, quienes podrían ver productos o información en el chatbot sin saber que fueron posicionados mediante técnicas de manipulación. Aunque en el futuro los LLMs (modelos de lenguaje de IA) podrían fortalecerse contra estos ataques, los investigadores señalan que los métodos de manipulación también están en constante evolución, por lo que los desafíos de control seguirán presentes.
Otro problema que el artículo resalta es el llamado “dilema de la respuesta directa”, un concepto desarrollado por el investigador Martin Potthast y su equipo. Este dilema surge cuando los chatbots presentan una única respuesta a una pregunta, lo cual puede llevar a que los usuarios acepten esa respuesta sin buscar otros puntos de vista o fuentes. Esto plantea el riesgo de que los usuarios perciban la respuesta del chatbot como la verdad única, sin considerar otras perspectivas o matices que podrían ser importantes en temas complejos.
Con la introducción de resúmenes de IA en los motores de búsqueda, Google lanzó la campaña «Let Google do the searching for you» («Deja que Google haga la búsqueda por ti»), lo cual sugiere que estos resúmenes optimizan el proceso de búsqueda. Sin embargo, este tipo de automatización podría perjudicar a aquellos usuarios que buscan información imparcial y precisa, ya que los chatbots, al ser susceptibles a manipulaciones, no siempre pueden garantizar que la información proporcionada sea confiable.
En resumen, el artículo advierte sobre los desafíos éticos y prácticos que implica la creciente dependencia de chatbots generativos para obtener información en línea. Si bien pueden hacer las búsquedas más rápidas y cómodas, los riesgos de manipulación y la falta de una supervisión clara en la selección de información hacen que esta tecnología aún esté lejos de ser una fuente autoritativa y confiable para temas complejos.
Un estudio reciente de Adobe, titulado Authenticity in the Age of AI, revela que el 44% de los encuestados ha sido engañado por desinformación relacionada con las elecciones en los últimos tres meses, y el 94% está preocupado por la difusión de información falsa de cara a las elecciones presidenciales de EE. UU. de 2024. La proliferación de contenido generado por IA está dificultando que los usuarios distingan entre información real y falsa, con un 87% de los encuestados afirmando que la tecnología ha complicado esta tarea.
La creciente desconfianza ha llevado al 48% de los usuarios a reducir o abandonar el uso de redes sociales debido a la gran cantidad de desinformación, mientras que el 89% cree que estas plataformas deberían implementar medidas más estrictas para controlar el contenido engañoso. Para ayudar a verificar la autenticidad del contenido digital, Adobe propone soluciones como las Content Credentials, etiquetas que permiten a los usuarios ver detalles sobre la creación de imágenes, incluyendo si fueron generadas por IA.
Estas herramientas permiten a los usuarios cargar imágenes en un sitio donde se puede verificar si han sido creadas mediante inteligencia artificial, utilizando metadatos o comparaciones con otras imágenes en línea. Este tipo de tecnología busca mitigar el impacto de la desinformación en un entorno digital cada vez más difícil de controlar.
La IA está transformando la forma en que accedemos, procesamos y compartimos información, lo que plantea desafíos y oportunidades en términos de confiabilidad. Uno de los principales desafíos es la propagación de la desinformación y las noticias falsas. Con el avance de la IA, es posible generar contenido falso de manera cada vez más sofisticada, lo que dificulta discernir entre lo verdadero y lo falso. Esto puede tener consecuencias graves, desde influir en procesos electorales hasta propagar teorías de conspiración perjudiciales.
En última instancia, la confiabilidad de la información en un mundo impulsado por la IA depende de la capacidad de la sociedad para adaptarse a estos avances tecnológicos y mitigar los riesgos asociados, al tiempo que se aprovechan los beneficios que la IA puede ofrecer en términos de acceso a la información y su veracidad.
Parent Perceptions of Book Bans, Materials Selection, and Reading in School Libraries and Public Libraries 2024. EveryLibrary Institute and Book Riot, 2024
La serie de encuestas sobre la percepción de los padres, desarrollada en colaboración con Book Riot, el sitio editorial de libros más grande e independiente de América del Norte, es el informe final de una serie de tres partes que detalla los hallazgos de encuestas nacionales a padres sobre sus percepciones de las bibliotecas y bibliotecarios durante la actual crisis de prohibición de libros. Este informe recopiló aportes de 3,206 padres y tutores con hijos menores de 18 años en tres encuestas realizadas entre septiembre y noviembre de 2023. Las encuestas preguntaron a los padres y tutores sobre su percepción de la confiabilidad de los bibliotecarios como profesionales y curadores de una colección de biblioteca, así como sus actitudes hacia los libros y las prohibiciones de libros.
Aún más notable es que el 96% de los padres y tutores creían que sus hijos estaban seguros en la biblioteca. Este es un porcentaje aún mayor que en la primera encuesta de la serie, donde el 92% de los padres sentían que sus hijos estaban seguros en la biblioteca.
La encuesta mostró que el 90% de los padres se sentían cómodos dejando que sus hijos seleccionaran sus propios materiales. Esto se alinea con una serie similar de preguntas formuladas en la encuesta inicial, donde los padres informaron que la mayoría de las veces, no se sentían incómodos con los materiales prestados por sus hijos y que su hijo no se sentía incómodo con algo que habían tomado prestado.
Los hallazgos principales del Informe de Percepción de los Padres son los siguientes:
El 85% de los encuestados dice confiar en los bibliotecarios.
El 58% de los padres piensa que los bibliotecarios públicos deberían ser principalmente responsables de la selección de libros para la biblioteca pública, en lugar de funcionarios electos, juntas de bibliotecas o grupos de padres.
El 92% de los encuestados dice que las bibliotecas son lugares seguros para sus hijos.
El 75% de los encuestados no cree que sus bibliotecas estén experimentando prohibiciones de libros.
El 67% de los encuestados siente que las prohibiciones de libros infringen en sus derechos para tomar decisiones sobre sus hijos.
El 75% de los encuestados informa que ni ellos ni sus hijos han sacado un libro de la biblioteca que consideraron inapropiado.
El 63% de los encuestados está de acuerdo o más o menos de acuerdo en que «prohibir libros es una pérdida de tiempo» en la biblioteca pública.
El 57% de los encuestados dice que prohibir libros en la biblioteca escolar es una forma apropiada de evitar que los niños aprendan sobre ciertos temas.
El 80% de los encuestados está de acuerdo en que las bibliotecas escolares deberían tener sistemas de clasificación de contenido.
El 95% de los encuestados desea ver una biblioteca escolar en la escuela de sus hijos.