Archivo de la etiqueta: Inteligencia artificial

El NIST identifica tipos de ciberataques que manipulan el comportamiento de los sistemas de inteligencia artificial (IA)

«NIST Identifies Types of Cyberattacks That Manipulate Behavior of AI Systems». 2024. NIST, enero. https://www.nist.gov/news-events/news/2024/01/nist-identifies-types-cyberattacks-manipulate-behavior-ai-systems.

La publicación, una colaboración entre el gobierno, la academia y la industria, tiene la intención de ayudar a los desarrolladores y usuarios de IA a comprender los tipos de ataques que podrían esperar, junto con enfoques para mitigarlos, con la comprensión de que no hay una solución única.

Los sistemas de IA han permeado la sociedad moderna, trabajando en capacidades que van desde conducir vehículos hasta ayudar a los médicos a diagnosticar enfermedades o interactuar con clientes como chatbots en línea. Para aprender a realizar estas tareas, se entrenan con vastas cantidades de datos: un vehículo autónomo podría mostrar imágenes de carreteras con señales de tráfico, por ejemplo, mientras que un chatbot basado en un modelo de lenguaje grande (LLM) podría exponerse a registros de conversaciones en línea. Estos datos ayudan a la IA a predecir cómo responder en una situación dada.

Un problema importante es que los datos en sí mismos pueden no ser confiables. Sus fuentes pueden ser sitios web e interacciones con el público. Hay muchas oportunidades para que actores malintencionados corrompan estos datos, tanto durante el período de entrenamiento de un sistema de IA como después, mientras la IA continúa refinando sus comportamientos al interactuar con el mundo físico. Esto puede hacer que la IA se comporte de manera indeseable. Por ejemplo, los chatbots pueden aprender a responder con lenguaje abusivo o racista cuando se sortean cuidadosamente las protecciones mediante indicaciones maliciosas.

«En su mayor parte, los desarrolladores de software necesitan que más personas usen su producto para que pueda mejorar con la exposición», dijo Vassilev. «Pero no hay garantía de que la exposición sea buena. Un chatbot puede generar información negativa o tóxica cuando se le indica con un lenguaje cuidadosamente diseñado».

En parte porque los conjuntos de datos utilizados para entrenar una IA son demasiado grandes para que las personas los supervisen y filtren con éxito, todavía no hay una forma infalible de proteger la IA contra el desvío. Para ayudar a la comunidad de desarrolladores, el nuevo informe ofrece una visión de los tipos de ataques que podrían sufrir sus productos de IA y enfoques correspondientes para reducir el daño.

El informe considera los cuatro principales tipos de ataques: evasión, envenenamiento, privacidad y ataques de abuso. También los clasifica según múltiples criterios, como los objetivos y metas del atacante, las capacidades y el conocimiento.

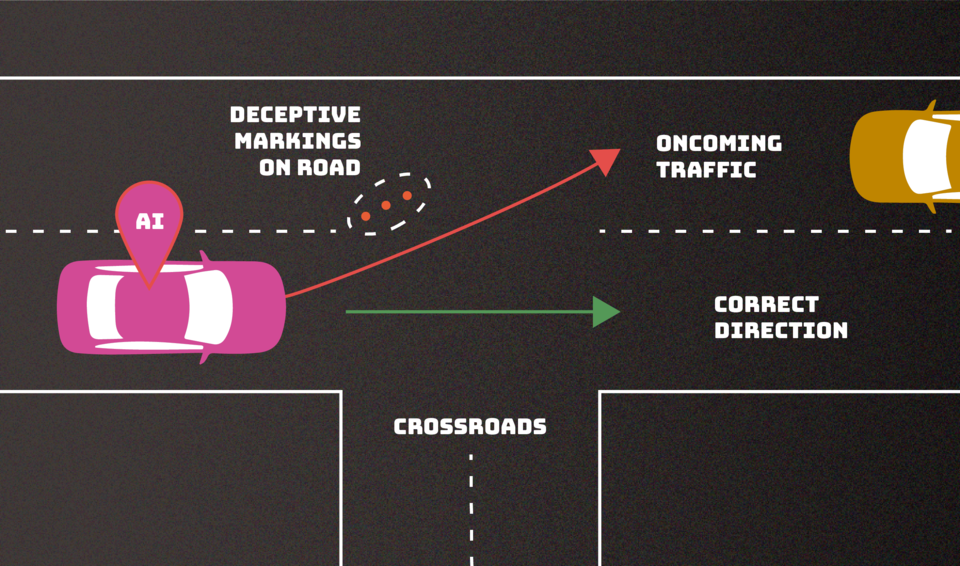
  • Los ataques de evasión, que ocurren después de que se implementa un sistema de IA, intentan alterar una entrada para cambiar cómo el sistema responde a ella. Ejemplos incluirían agregar marcas a señales de alto para hacer que un vehículo autónomo las interprete como señales de límite de velocidad o crear marcas de carril confusas para hacer que el vehículo se desvíe de la carretera.
  • Los ataques de envenenamiento ocurren en la fase de entrenamiento al introducir datos corruptos. Un ejemplo sería deslizar numerosas instancias de lenguaje inapropiado en registros de conversaciones, para que un chatbot interprete estas instancias como parloteo lo suficientemente común como para usarlo en sus propias interacciones con clientes.

Los ataques de privacidad, que ocurren durante la implementación, son intentos de aprender información sensible sobre la IA o los datos en los que se entrenó para mal usarla. Un adversario puede hacerle numerosas preguntas legítimas a un chatbot y luego utilizar las respuestas para ingeniería inversa del modelo para encontrar sus puntos débiles o adivinar sus fuentes. Agregar ejemplos indeseados a esas fuentes en línea podría hacer que la IA se comporte de manera inapropiada, y hacer que la IA olvide esos ejemplos específicos no deseados después del hecho puede ser difícil.

Los ataques de abuso implican la inserción de información incorrecta en una fuente, como una página web o un documento en línea, que una IA luego absorbe. A diferencia de los ataques de envenenamiento mencionados anteriormente, los ataques de abuso intentan darle a la IA piezas incorrectas de información de una fuente legítima pero comprometida para cambiar el uso previsto del sistema de IA.

«La mayoría de estos ataques son bastante fáciles de llevar a cabo y requieren un conocimiento mínimo del sistema de IA y capacidades adversarias limitadas», dijo la coautora Alina Oprea, profesora en la Universidad Northeastern. «Los ataques de envenenamiento, por ejemplo, pueden llevarse a cabo controlando unas pocas docenas de muestras de entrenamiento, lo que sería un porcentaje muy pequeño de todo el conjunto de entrenamiento».

Los autores, que también incluyeron a los investigadores de Robust Intelligence Inc., Alie Fordyce e Hyrum Anderson, desglosan cada una de estas clases de ataques en subcategorías y agregan enfoques para mitigarlos, aunque la publicación reconoce que las defensas que los expertos en IA han ideado contra ataques adversarios hasta ahora son incompletas.
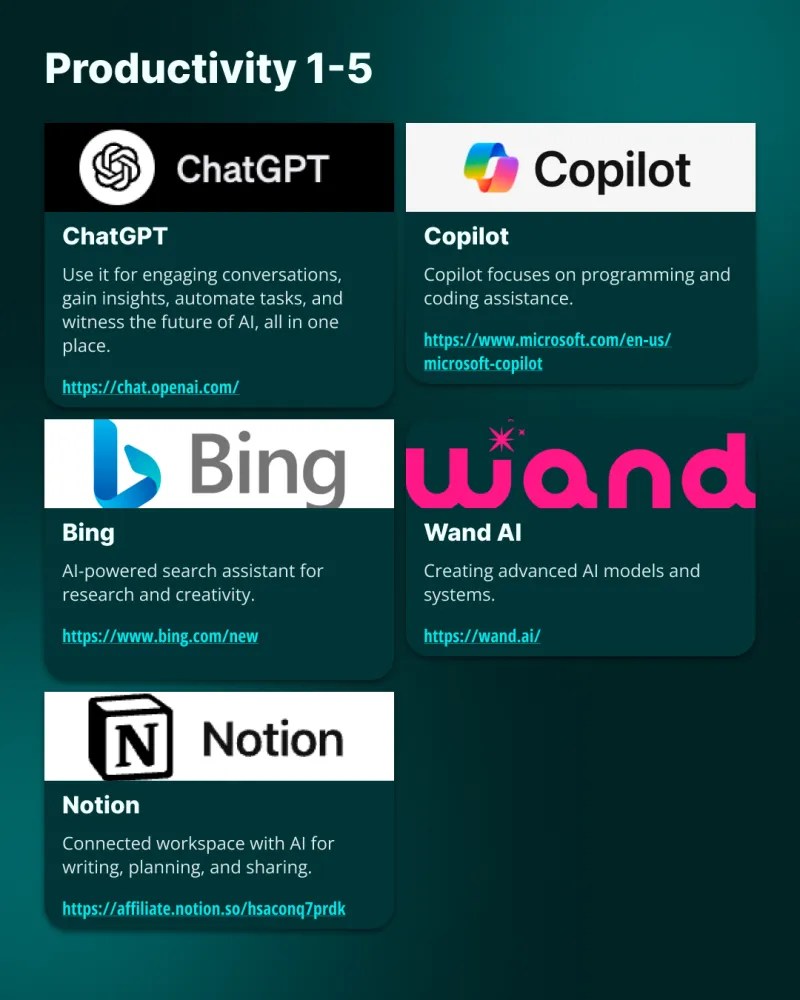
Las mejores herramientas de Inteligencia Artificial Generativa

TOP AI tools! Index by Generative AI 2024

Ver listado completo

ChatGPT – Use it for engaging conversations, gain insights, automate tasks, and witness the future of AI, all in one place. https://chat.openai.com/

Copilot – Copilot focuses on programming and coding assistance. https://www.microsoft.com/en-us/microsoft-copilot

Bing AI Search – AI-powered search assistant for research and creativity. https://www.bing.com/new

Wand AI – Creating advanced AI models and systems. https://wand.ai

Notion – Connected workspace with AI for writing, planning, and sharing. https://affiliate.notion.so/hsaconq7prdk

Character.ai – Allows non-technical users to create their own chatbots and converse with chatbots created by other users. https://beta.character.ai/

Mintlify – Meet the modern standard for public facing documentation. Beautiful out of the box, easy to maintain, and optimized for user engagement. https://mintlify.com/

Scribe – Turn any process into a step-by-step guide, instantly. https://scribehow.com/

Snyk – It is trained on security-specific data, and is all curated by top security researchers to give you all the power of AI without any of the drawbacks. https://snyk.io/

Tabnine – AI assistant that speeds up delivery and keeps your code safe https://www.tabnine.com/

WebCopilot – Write your Notion pages with AI. Speed up your writing process and focus on what matters.https://www.webcopilot.ai/

Replit Ghostwriter – An AI pair programmer that helps you write better code, faster. https://replit.com/site/ghostwriter

Anyword – Get more conversions and sales with Anyword. Anyword’s powerful predictive analytics tell you what works before you go live. https://anyword.com/

Rytr – A better, faster way to write profile bios, Facebook ads and landing page copies. https://rytr.me/

Bearly AI – Drop in research papers, pdfs, articles, word docs and more to get a thorough summary of the content.https://bearly.ai/

Inflection –  A personal AI for everyone. https://inflection.ai/

Glean – The AI-powered work assistant. https://www.glean.com/

New Relic – Data for engineers to monitor, debug, and improve their entire stack. https://newrelic.com/

Afforai – Afforai is an AI chatbot that searches, summarizes, and translates info from multiple sources to produce trustworthy research. https://afforai.com/

Quickchat AI – No-code platform that leverages Large Language Models such as OpenAI’s GPT to craft customizable AI Assistants tailored to your business. https://www.quickchat.ai/

Patched – Automated security patches for your code repositories. – https://www.patched.codes/

Agent4.ai – Lets you create custom voice experiences for callers to your business or mobile phone. https://agent4.ai/

Log Analyzer Pro GPT – Log Analyzer Pro GPT, specializes in analyzing systems, applications, web servers, and database logs, particularly for finance and healthcare industries. https://loganalyzergpt.com/

Apex – Use APEX A.L.I.C.E to unlock value from data in real-time. https://www.apexe3.com/

Stelo AI – Your AI-based Intelligent Document Processing Partner https://stelo.ai/

Ivy AI – Ivy is an all-in-one AI chatbot built to power recruitment, retention, and customer service across your organization. https://ivy.ai/

Inteligencia artificial generativa: una introducción a la tecnología de inteligencia artificial generativa y sus implicaciones en la educación.

Generative AI : An introduction to generative artificial intelligence technology and its implications on education. JISC, 2023

Texto completo

Las herramientas de IA generativa, como ChatGPT, ya están teniendo un impacto significativo en la educación. Estas herramientas están planteando retos considerables en torno a la evaluación y la integridad académica, pero también presentan oportunidades, como el ahorro de tiempo del personal al ayudar en la creación de materiales de aprendizaje o la presentación a los estudiantes de nuevas herramientas para mejorar su forma de trabajar.

El impacto de la IA generativa se está dejando sentir mucho más allá de la educación y ya está empezando a cambiar nuestra forma de trabajar. Esto plantea más retos y oportunidades a la hora de garantizar que la educación prepara a los estudiantes para un lugar de trabajo mejorado por la IA y que las evaluaciones son auténticas pero sólidas.

Puntos clave

  • La preocupación inicial se centra en la evaluación y la integridad académica.
  • La acción inmediata es que todo el personal se comprometa con la IA generativa y la pruebe por sí mismo, aprendiendo cómo se verán afectadas sus evaluaciones.
  • La IA generativa puede utilizarse de muchas otras formas, además de para producir trabajos para la evaluación.
  • La IA generativa se utilizará cada vez más en el lugar de trabajo
  • Es probable que la IA generativa sea omnipresente, por lo que prohibirla no es una opción.

Inteligencia artificial (IA) «palabra del año» para Oxford, Cambridge y Merriam-Webster.

«AI invades ‘word of the year’ lists at Oxford, Cambridge and Merriam-Webster | TechCrunch». 2023. Accedido 31 de diciembre de 2023. 

Ver completo

La inteligencia artificial (IA) ha dominado el ámbito tecnológico en 2023, y esto se refleja en las listas de «palabra del año» de Oxford, Cambridge y Merriam-Webster. Las palabras relacionadas con la IA resaltadas por estas instituciones ya existen, pero han sido apropiadas con nuevos significados.

En el caso de Cambridge, la palabra es «alucinar», que se refiere a la tendencia de los modelos generativos de IA, como ChatGPT, a inventar información en lugar de admitir que no saben algo. El problema es que estos sistemas no tienen conciencia de lo que no saben, ya que en realidad no saben nada.

Merriam-Webster eligió «auténtico» como su palabra del año, destacando la creciente confusión entre lo «real» y lo «falso» en un mundo afectado por la IA, deepfakes y otros temas relacionados.

Oxford, por otro lado, seleccionó «prompt» como su palabra del año. Se destaca que el término ha ganado una nueva connotación relacionada con el lado humano de la generación de IA. «Prompt» ahora se utiliza como verbo cuando se le indica a un sistema de IA que genere algo basado en una entrada específica.

El artículo reflexiona sobre la aceptación de palabras relacionadas con la IA en el léxico general y destaca la rapidez con la que la tecnología avanza. Aunque términos más avanzados como «espacio latente» aún no han entrado en uso común, se espera que el léxico continúe evolucionando a medida que la tecnología avanza.

El New York Times demanda a OpenAI y Microsoft por infracción de derechos de autor

Grynbaum, M. M., & Mac, R. (2023, diciembre 27). The Times Sues OpenAI and Microsoft Over A.I. Use of Copyrighted Work. The New York Times. https://www.nytimes.com/2023/12/27/business/media/new-york-times-open-ai-microsoft-lawsuit.html

La demanda es la última de una serie de demandas que buscan limitar el uso del presunto «scraping» de amplios fragmentos de contenido de internet, sin compensación, para entrenar a los llamados modelos grandes de inteligencia artificial de lenguaje. Actores, escritores, periodistas y otros creadores que publican sus trabajos en internet temen que la IA aprenda de su material y proporcione chatbots competitivos y otras fuentes de información sin una compensación adecuada.


El periódico The New York Times ha presentado una demanda contra OpenAI y Microsoft, acusándolos de infringir derechos de autor. La queja sostiene que las compañías utilizaron millones de artículos del Times sin permiso para entrenar modelos de inteligencia artificial de lenguaje, como ChatGPT, creando así una competencia directa para el Times. Esta demanda se suma a una serie de acciones legales que buscan limitar el uso del supuesto «scraping» de contenido de internet sin compensación para entrenar modelos de inteligencia artificial de lenguaje. Aunque las negociaciones para una compensación justa estuvieron en marcha desde abril, el Times afirma que no se ha llegado a una resolución con las compañías. La demanda busca daños por miles de millones de dólares y una orden permanente contra la presunta infracción, lo que podría sentar un precedente para la industria. Otras empresas de medios, como Disney, CNN y el propio Times, han bloqueado el acceso a ChatGPT. Este conflicto destaca los desafíos continuos en torno al uso de material con derechos de autor para entrenar modelos de inteligencia artificial.

Sin embargo, la demanda del Times es la primera entre los principales editores de noticias que se enfrenta a OpenAI y Microsoft, las marcas de IA más reconocidas. Microsoft (MSFT) tiene un asiento en la junta directiva de OpenAI y una inversión multimillonaria en la compañía.

En una queja presentada el miércoles, el Times dijo que tiene el deber de informar a sus suscriptores, pero el «uso ilegal del trabajo del Times por parte de Microsoft y OpenAI para crear productos de inteligencia artificial que compiten con él amenaza la capacidad del Times para proporcionar ese servicio». El periódico señaló que OpenAI y Microsoft utilizaron otras fuentes en su «copia a gran escala», pero «dieron énfasis particular al contenido del Times» buscando «montarse en la inversión masiva del Times en su periodismo al utilizarlo para construir productos sustitutivos sin permiso ni pago».

En su queja, el Times dijo que objetó cuando descubrió meses atrás que su trabajo se había utilizado para entrenar los modelos de lenguaje grandes de las compañías. A partir de abril, el Times dijo que comenzó a negociar con OpenAI y Microsoft para recibir una compensación justa y establecer los términos de un acuerdo.

Los investigadores tienen una herramienta mágica para entender la IA: Harry Potter

Borgman, C. L., & Brand, A. (2023). The Future of Data in Research Publishing: From Nice to Have to Need to Have? Harvard Data Science Review. https://doi.org/10.1162/99608f92.b73aae77


Más de dos décadas después de que J.K. Rowling introdujera al mundo a un universo de criaturas mágicas, bosques prohibidos y un mago adolescente, Harry Potter está encontrando una renovada relevancia en un ámbito muy diferente de la literatura: la investigación en inteligencia artificial (IA). Un número creciente de investigadores está utilizando los libros de Harry Potter, superventas, para experimentar con la tecnología generativa de inteligencia artificial, citando la influencia perdurable de la serie en la cultura popular y la amplia gama de datos lingüísticos y juegos de palabras complejos en sus páginas. Revisar una lista de estudios y papers académicos que hacen referencia a Harry Potter ofrece una instantánea de la investigación en inteligencia artificial de vanguardia y algunas de las preguntas más difíciles que enfrenta la tecnología.

En quizás el ejemplo más destacado recientemente, Harry, Hermione y Ron son los protagonistas de un artículo titulado «¿Quién es Harry Potter?» que arroja luz sobre una nueva técnica que ayuda a los modelos de lenguaje grandes a olvidar selectivamente información. Es una tarea de alto riesgo para la industria: los modelos de lenguaje grandes, que alimentan a los chatbots de IA, se construyen con vastas cantidades de datos en línea, incluido material con derechos de autor y otro contenido problemático. Esto ha llevado a demandas y escrutinio público para algunas empresas de IA. Los autores del artículo, los investigadores de Microsoft Mark Russinovich y Ronen Eldan, afirmaron haber demostrado que los modelos de IA pueden ser modificados o editados para eliminar cualquier conocimiento de la existencia de los libros de Harry Potter, incluyendo personajes e historias, sin sacrificar las capacidades de toma de decisiones y análisis del sistema de IA en general. El dúo eligió los libros debido a su familiaridad universal. «Creíamos que sería más fácil para las personas en la comunidad de investigación evaluar el modelo resultante de nuestra técnica y confirmar por sí mismos que el contenido realmente se ha ‘desaprendido'», dijo Russinovich, director de tecnología de Microsoft Azure. «Casi cualquier persona puede idear preguntas para el modelo que indaguen si ‘sabe’ de los libros. Incluso personas que no los hayan leído serían conscientes de elementos de la trama y personajes».

En otro estudio, investigadores de la Universidad de Washington en Seattle, la Universidad de California en Berkeley y el Instituto Allen de IA desarrollaron un nuevo modelo de lenguaje llamado Silo que puede eliminar datos para reducir riesgos legales. Sin embargo, el rendimiento del modelo disminuyó significativamente si solo se entrenaba con texto de bajo riesgo, como libros sin derechos de autor o documentos gubernamentales, según un artículo publicado a principios de este año.

Para profundizar, los investigadores utilizaron libros de Harry Potter para ver si fragmentos individuales de texto influyen en el rendimiento de un sistema de IA. Crearon dos almacenes de datos, o colecciones de sitios web y documentos. El primero incluía todos los libros publicados excepto el primer libro de Harry Potter; otro incluía todos los libros de la serie menos el segundo, y así sucesivamente. «Cuando se eliminan los libros de Harry Potter del almacén de datos, la perplejidad empeora», dijeron los investigadores, refiriéndose a la medida de precisión de los modelos de IA.

Los estudios de IA han citado a Harry Potter durante al menos una década, pero se ha vuelto más común a medida que académicos y tecnólogos se han centrado en herramientas de IA que pueden procesar y responder al lenguaje natural con respuestas relevantes. Con Harry Potter, «la abundancia de escenas, diálogos y momentos emocionales lo hace muy relevante para el área específica del procesamiento del lenguaje natural», dijo Leila Wehbe, una investigadora de Carnegie Mellon que realizó un conjunto de experimentos en 2014 recopilando datos de resonancia magnética cerebral de personas que leían historias de Harry Potter para comprender mejor los mecanismos del lenguaje. En arXiv, un repositorio de investigación científica de acceso abierto, los papers recientes incluyen «Aprendizaje automático para el desarrollo de pociones en Hogwarts«, «Grandes modelos de lenguaje se encuentran con Harry Potter» y «Detección de hechizos en literatura fantástica con una inteligencia artificial basada en transformadores«.

Incluso cuando no es central para la investigación, Harry Potter también es una referencia literaria favorita para los investigadores. Un estudio, por ejemplo, utilizó las obras de Rowling para poner a prueba la inteligencia de sistemas de IA como los que dieron origen al chatbot ChatGPT, un tema que ha generado mucha controversia en debates recientes. Terrence Sejnowski, director del laboratorio de neurobiología computacional en el Instituto de Estudios Biológicos Salk, argumentó en el artículo que los chatbots simplemente reflejan la inteligencia y los sesgos de sus usuarios, como el Espejo de Oesed en el primer libro de Harry Potter, que refleja los deseos de una persona. «Harry Potter es popular entre los investigadores más jóvenes», dijo Wehbe. «Lo habrían leído cuando eran niños o adolescentes, pensando en ellos al elegir un corpus de texto escrito o hablado».

La curación de los datos es un paso crítico en la creación de una Inteligencia Artificial Súper Inteligente (ASI) segura.

AI is Deterministic Based Upon the Starting Data – AI Alignment Could Be Relatively Easy. Next Big Future November 27, 2023 by Brian Wang

Texto completo

Un empleado de OpenAI ha observado que los Modelos de Lenguaje Grandes (LLM) que comienzan con el mismo conjunto de datos convergen hacia el mismo punto. Esto sugiere que la curación de los datos es un paso crítico en la creación de una Inteligencia Artificial Súper Inteligente (ASI) segura. Si podemos cargar la IA con ejemplos éticos deseados y a favor de la humanidad desde el principio, el sistema resultante debería tener un núcleo de seguridad alineado con los valores humanos.

La superinteligencia artificial (ASI) es un sistema basado en software con capacidades intelectuales más allá de las de los humanos en una amplia gama de categorías y campos de acción. La ASI aún no existe y es un estado hipotético de la inteligencia artificial (IA). La ASI difiere de la inteligencia artificial regular (IA), que implica la simulación basada en software de las capacidades intelectuales humanas, como el aprendizaje a través de la adquisición de información, el razonamiento y la autocorrección

Se plantea la posibilidad de que sea muy fácil entrenar al LLM en datos acumulados de todos los estudios relacionados con el conocimiento de la alineación de la IA. En teoría, la IA debería aprender y absorber las lecciones de manera efectiva.

El autor, Brian Wang, destaca la importancia de la curación de datos para la seguridad de la IA y sugiere que alinear la IA con valores éticos humanos podría ser relativamente fácil si se aborda desde el inicio con la información correcta.

Cabe señalar que algunos comentarios en la publicación plantean dudas sobre la premisa, argumentando que simplemente escalar un LLM puede no ser suficiente para lograr una ASI y que se pueden necesitar avances fundamentales en la comprensión y modelos internos de la IA.

VideoPoet: El último gran modelo lingüístico de Google genera vídeos por Inteligencia Artificial

VideoPoet

Google ha presentado VideoPoet, un nuevo sistema generativo de inteligencia artificial que puede crear y editar videos a partir de texto y otros inputs.


Google presenta VideoPoet, un sistema de inteligencia artificial que puede generar y editar video a partir de texto y otros inputs, incluyendo texto a video, imagen a video y estilización de video. 

VideoPoet puede generar videos de longitud variable y con una variedad de movimientos y estilos, según el contenido de texto. También puede tomar una imagen de entrada y animarla con una indicación, predecir flujo óptico e información de profundidad para estilización de video, y generar audio. Por defecto, el modelo genera videos en orientación vertical para adaptar su salida a contenido de formato corto.

VideoPoet utiliza múltiples tokenizadores (MAGVIT V2 para video e imagen y SoundStream para audio) para entrenar un modelo de lenguaje autoregresivo en modalidades de video, imagen, audio y texto. También se puede controlar el movimiento de la cámara en los videos mediante indicaciones de texto que describen el movimiento de la cámara.

En el futuro, el marco podría admitir generación de cualquier tipo a cualquier tipo y ampliarse a texto a audio, audio a video y subtitulado de video para habilitar aplicaciones aún más versátiles.

Aunque la compañía no ha revelado si tiene planes de poner el modelo a disposición, la integración en un eventual Bard Advanced parece posible. También, Google ha producido un cortometraje utilizando VideoPoet, utilizando Bard como guionista.

OpenAI lanza un documento para guiar el desarrollo seguro de la inteligencia artificial

Preparedness 
Framework
(Beta)

PDF

OpenAI, empresa creadora de ChatGPT, ha lanzado un «marco preparatorio» para guiar el desarrollo seguro de sistemas de inteligencia artificial cada vez más poderosos. El marco, considerado un «documento vivo», tiene como objetivo ayudar a la empresa a «rastrear, evaluar, prever y protegerse contra riesgos catastróficos» que podrían surgir con los avances en la inteligencia artificial.

Esta iniciativa es parte del compromiso voluntario de OpenAI con la Casa Blanca y otros interesados para el desarrollo seguro y transparente de la inteligencia artificial. Según Anton Dahbura, experto en inteligencia artificial y co-director del Instituto de Autonomía Asegurada de la Universidad Johns Hopkins, este marco es un buen «primer paso en un viaje muy largo».

El marco detalla cómo la empresa evaluará sus sistemas emergentes y determinará si es seguro proceder. Incluye la creación de un Grupo Asesor de Seguridad para supervisar la evaluación de riesgos y asesorar a la dirección en decisiones de seguridad. Además, establece niveles de riesgo, como «bajo», «medio», «alto» y «crítico», con varios criterios para evaluar áreas como ciberseguridad, amenazas CBRN (químicas, biológicas, radiológicas, nucleares) y persuasión.

Solo los modelos de inteligencia artificial con una puntuación de mitigación de «medio» o menos pueden ser implementados, y solo aquellos con una puntuación de mitigación de «alto» o menos pueden seguir desarrollándose. OpenAI también se compromete a buscar constantemente «desconocidos-ignorados», explorando categorías actualmente desconocidas de riesgos catastróficos.

El CEO de OpenAI, Sam Altman, ha afirmado que los beneficios superan los riesgos para los sistemas que la empresa ha lanzado al público, pero destaca la necesidad de intervenciones regulatorias gubernamentales para mitigar los riesgos de modelos cada vez más poderosos.

Aunque la administración Biden ha propuesto una «Hoja de Ruta para una Declaración de Derechos de la IA», OpenAI, por ahora, se centra en desarrollar pautas internas, como su nuevo marco. Dahbura elogia la proactividad de OpenAI y destaca que el marco es más detallado y menos genérico que otros documentos aspiracionales de alto nivel en la industria de la inteligencia artificial.

Escritores demandan a OpenAI y Microsoft por supuesto uso no autorizado de libros en inteligencia artificial

Brittain, Blake, y Blake Brittain. 2023. «Pulitzer-Winning Authors Join OpenAI, Microsoft Copyright Lawsuit». Reuters, 21 de diciembre de 2023, sec. Legal. https://www.reuters.com/legal/pulitzer-winning-authors-join-openai-microsoft-copyright-lawsuit-2023-12-20/.

Un grupo de 11 autores de no ficción se ha unido a una demanda en la corte federal de Manhattan que acusa a OpenAI y Microsoft de utilizar indebidamente libros escritos por los autores para entrenar los modelos detrás del popular chatbot ChatGPT de OpenAI y otros programas basados en inteligencia artificial.

Los escritores, incluyendo a los ganadores del Premio Pulitzer Taylor Branch, Stacy Schiff y Kai Bird, argumentan que las compañías infringieron sus derechos de autor al usar sus obras para entrenar los modelos de lenguaje GPT de OpenAI.

Representantes de OpenAI y Microsoft no respondieron de inmediato a las solicitudes de comentarios el miércoles.

El abogado de los escritores, Rohit Nath, afirmó que «los acusados están obteniendo miles de millones de dólares de su uso no autorizado de libros de no ficción, y los autores de estos libros merecen una compensación justa y un trato adecuado por ello».

La demanda, presentada por el escritor y editor de Hollywood Reporter, Julian Sancton, alega que OpenAI «raspó» los trabajos de los autores junto con gran cantidad de otro material con derechos de autor de Internet sin permiso para enseñar a sus modelos GPT a responder a instrucciones de texto humano.

La demanda también afirma que Microsoft ha estado «profundamente involucrado» en el entrenamiento y desarrollo de los modelos y es responsable de la infracción de derechos de autor. Los autores piden daños monetarios no especificados y una orden para que las compañías dejen de infringir sus derechos de autor.