Archivo de la categoría: Procesos técnicos

BIBFRAME: una guía práctica para transformar la catalogación en datos enlazados

Library of Congress. BIBFRAME Primer: Reference Guide for Those Who Would Like to Implement the BIBFRAME Model and Vocabulary. Bibliographic Framework Initiative, 3 de septiembre de 2026. BIBFRAME Primer

La Library of Congress acaba de publicar el BIBFRAME Primer, una guía concebida como punto de partida para las bibliotecas y organizaciones que quieran comprender e implementar el modelo BIBFRAME y su vocabulario.

El documento pretende cubrir una necesidad que existía desde hace años: disponer de una explicación práctica que conecte los principios teóricos de BIBFRAME con situaciones reales de implementación. No pretende ser un manual cerrado ni exhaustivo, sino un documento vivo, que será ampliado y modificado conforme evolucione BIBFRAME y aparezcan nuevas experiencias de aplicación. 

Del registro bibliográfico al ecosistema de datos

La idea fundamental de BIBFRAME es superar el modelo tradicional de descripción bibliográfica basado en registros aislados y avanzar hacia un modelo de datos enlazados (Linked Data). En lugar de considerar un registro MARC como una unidad cerrada, BIBFRAME representa las entidades bibliográficas como recursos identificables en la Web y establece relaciones entre ellas mediante propiedades. De esta manera, autores, obras, ediciones, temas, organizaciones, lugares y otros elementos pueden convertirse en nodos conectados dentro de una red de información. 

Esto constituye uno de los cambios conceptuales más importantes para la catalogación: la información bibliográfica deja de estar pensada exclusivamente para ser interpretada por un sistema de gestión bibliotecaria y pasa a formar parte de la Web de datos.

Work, Instance e Item

Uno de los pilares del modelo BIBFRAME es la diferenciación entre diferentes niveles de una entidad bibliográfica. El modelo tradicional de BIBFRAME 2.0 distingue fundamentalmente entre Work, Instance e Item. Una Work representa el contenido o concepto intelectual de una creación; una Instance representa una determinada materialización o publicación de esa obra; y un Item identifica un ejemplar concreto. 

Por ejemplo, si pensamos en Don Quijote de la Mancha, la obra sería la creación literaria de Cervantes; una edición publicada por una determinada editorial en 2024 sería una Instance; y el ejemplar concreto que posee una biblioteca, con su código de barras y características particulares, sería un Item.

Esta separación permite representar con mucha mayor precisión las relaciones existentes entre diferentes ediciones, traducciones, formatos y ejemplares.

¿Por qué es importante frente a MARC?

BIBFRAME no debe entenderse simplemente como “un nuevo formato MARC”. Su propósito es modificar la manera en que se conciben y relacionan los datos bibliográficos. La Library of Congress plantea BIBFRAME como una base para el futuro de la descripción bibliográfica en la Web y como una vía de transición respecto de MARC 21. 

MARC está fundamentalmente orientado al intercambio de registros bibliográficos, mientras que BIBFRAME utiliza tecnologías de Linked Data para representar entidades y relaciones. Esto permite que los datos bibliográficos puedan integrarse más fácilmente con otros conjuntos de datos de la Web.

RDF, URI y Linked Data

El Primer también introduce los aspectos técnicos necesarios para comprender BIBFRAME, especialmente RDF, URI, datatypes y blank nodes. Estos elementos permiten construir las relaciones entre recursos y expresar los datos de una manera que pueda ser procesada por máquinas. El documento avanza desde los conceptos generales hacia cuestiones progresivamente más técnicas. 

La utilización de URI persistentes es particularmente importante porque permite identificar inequívocamente entidades. Así, una persona, una obra o un concepto no tiene que estar representado simplemente por una cadena de texto: puede estar identificado mediante un recurso Web que otros sistemas pueden reutilizar.

El papel de los vocabularios controlados

BIBFRAME también favorece la utilización de vocabularios y fuentes de autoridad externas. La Library of Congress dispone, por ejemplo, de id.loc.gov, que proporciona identificadores y vocabularios vinculados para autores, materias y otros elementos. La combinación de BIBFRAME con estos recursos permite construir descripciones mucho más ricas y conectadas. 

Esto tiene una consecuencia práctica muy importante: en lugar de escribir simplemente “Cervantes Saavedra, Miguel de”, el catálogo puede vincular esa persona con una identidad identificada de forma inequívoca. El mismo autor puede entonces conectarse con todas sus obras y con otras fuentes externas.

Un documento pensado para la implementación

Una de las características más interesantes del nuevo Primer es que no se limita a explicar la ontología. Incluye ejemplos reales y consideraciones de implementación, y aborda progresivamente las clases y propiedades más comunes de BIBFRAME antes de entrar en cuestiones específicas de determinados formatos. Finalmente, dedica una sección a aspectos relacionados con RDF y un apéndice al concepto de Hub. 

Esto lo convierte en un recurso especialmente útil para quienes trabajan en proyectos de transformación de catálogos, diseño de perfiles de aplicación, conversión MARC-BIBFRAME o creación de infraestructuras de datos bibliográficos enlazados.

BIBFRAME y la transición desde MARC

La publicación del Primer adquiere especial relevancia porque la Library of Congress continúa trabajando activamente en la transición hacia BIBFRAME. En 2026 ha seguido actualizando sus herramientas de conversión MARC 21 → BIBFRAME y BIBFRAME → MARC 21, mientras desarrolla herramientas de edición como Marva Quartz. 

Esto indica que BIBFRAME no es únicamente un proyecto experimental. La Library of Congress está desarrollando progresivamente un entorno de producción en el que los catalogadores pueden crear, editar y mantener datos BIBFRAME, manteniendo al mismo tiempo mecanismos para generar registros MARC cuando sea necesario para el intercambio con sistemas tradicionales. 

¿Qué significa para las bibliotecas?

El cambio tiene importantes implicaciones profesionales. El catalogador del futuro necesitará conocer no solo MARC, RDA o las reglas de descripción, sino también conceptos como Linked Data, RDF, URI, ontologías, identificadores persistentes, vocabularios controlados y modelado de datos.

La catalogación pasa así de una lógica centrada en “rellenar campos” a otra basada en identificar entidades, describirlas y establecer relaciones entre ellas.

Por ejemplo:

Modelo tradicional:

Cervantes, Miguel de. Don Quijote de la Mancha. Madrid: Editorial X, 2024.

Modelo BIBFRAME conceptual:

ObraDon Quijote de la Mancha

Autor → Miguel de Cervantes

Instancia → edición de Editorial X, 2024

Ejemplar → copia concreta de la biblioteca

Relaciones → autor, traducciones, materias, ediciones, formatos, identificadores externos…

El segundo modelo permite que cada elemento pueda conectarse con otros recursos y sistemas.

Una nueva etapa para los catálogos bibliotecarios

La publicación del BIBFRAME Primer representa, por tanto, un paso importante en la maduración del ecosistema BIBFRAME. La propia Library of Congress define BIBFRAME como una base para el futuro de la descripción bibliográfica en la Web y como una vía para preservar las ventajas del intercambio bibliográfico que históricamente ha proporcionado MARC. 

La idea esencial: BIBFRAME no consiste simplemente en sustituir MARC por otro formato. Supone cambiar la concepción del catálogo: de una colección de registros bibliográficos a una red de entidades, identificadores y relaciones que puede integrarse con la Web de datos. El nuevo Primer ofrece precisamente una hoja de ruta para comprender y llevar a la práctica ese cambio.

Referencias complementarias

Catalogación con IA: Clarivate impulsa una nueva generación de metadatos bibliotecarios con SkyRiver

Library staff member cataloging a book on a computer
A library staff member catalogs a book using metadata software alongside print references.

Clarivate. “Clarivate Enhances SkyRiver to Help Libraries Share, Reuse and Create Trusted Metadata”. Clarivate News, 12 de agosto de 2026. Artículo original en Clarivate

SkyRiver representa un paso hacia una catalogación más colaborativa, interoperable y asistida por IA, pero con una premisa importante: automatizar la creación de metadatos no significa renunciar a la calidad, la procedencia, la atribución ni a la gobernanza bibliotecaria. La cuestión estratégica será conseguir que la IA acelere el trabajo de catalogación sin diluir el conocimiento profesional que da valor a los metadatos bibliotecarios.

Clarivate ha anunciado una versión mejorada de SkyRiver, su plataforma orientada a la gestión e intercambio de metadatos bibliográficos, con el objetivo de facilitar a las bibliotecas el acceso, reutilización y creación de registros de calidad. La nueva plataforma apuesta por utilizar metadatos abiertos por defecto, al tiempo que mantiene las condiciones establecidas por los contribuyentes, las obligaciones de licencia y las políticas de gobernanza de cada institución. La propuesta busca mejorar la interoperabilidad entre bibliotecas, consorcios y sistemas de gestión bibliotecaria, permitiendo que los registros puedan compartirse y reutilizarse con mayor facilidad.

Una de las principales novedades es la incorporación de capacidades de inteligencia artificial para la creación de registros bibliográficos. La IA pretende agilizar los flujos de trabajo de catalogación y ayudar a producir registros de alta calidad de una manera más eficiente. Clarivate sitúa esta funcionalidad dentro de una transformación más amplia de los servicios de descubrimiento, en la que disponer de metadatos fiables, transparentes e interoperables resulta fundamental. La compañía subraya, sin embargo, que la automatización no elimina la importancia de las decisiones y controles bibliotecarios: las instituciones mantienen capacidad de elección sobre su participación y sobre la contribución de sus propios datos.

SkyRiver pretende funcionar como una infraestructura de colaboración basada en la comunidad bibliotecaria. Las bibliotecas podrán acceder a metadatos fiables para catalogación, descubrimiento y préstamo o intercambio de recursos, además de conectar y reutilizar registros entre diferentes sistemas de gestión. La plataforma incorpora asimismo información sobre derechos, procedencia, atribución y condiciones de acceso, elementos especialmente importantes en un contexto en el que los metadatos circulan entre múltiples instituciones y pueden ser reutilizados posteriormente por otros servicios y aplicaciones.

La propuesta tiene especial interés porque aborda uno de los problemas históricos de las bibliotecas: evitar que cada institución tenga que crear desde cero registros que otras bibliotecas ya han producido. Compartir y reutilizar metadatos puede reducir la duplicación de esfuerzos y permitir que los profesionales dediquen más tiempo a aquellos recursos que requieren descripción original, enriquecimiento local o tratamiento especializado. Al mismo tiempo, la plataforma pretende preservar las mejoras realizadas localmente por cada biblioteca, reconociendo que los metadatos producidos por una institución pueden aportar información de valor para toda la comunidad.

La dimensión de gobernanza constituye otro elemento destacado. Clarivate anuncia la creación de un Metadata Governance Advisory Group, destinado a proporcionar orientación sobre el desarrollo futuro de SkyRiver y participar en cuestiones relacionadas con políticas de metadatos, estándares de calidad y principios de gobernanza. Esto resulta particularmente relevante en un entorno en el que la apertura y reutilización de datos debe equilibrarse con derechos, licencias, atribución y autonomía institucional. La gobernanza se convierte así en una pieza tan importante como la tecnología para determinar cómo se producen, comparten y reutilizan los registros bibliográficos.

Las declaraciones de representantes de la University of Delaware y la University of Regina ponen el acento precisamente en la relación entre metadatos y descubrimiento. Para estas instituciones, unos metadatos de calidad permiten incrementar la visibilidad de las colecciones y favorecer la colaboración entre bibliotecas. También se destaca la necesidad de que las nuevas herramientas sean capaces de integrar las mejoras locales dentro de los flujos de trabajo existentes, de manera que la automatización no suponga perder el valor añadido generado por los profesionales de la información.

En un sentido más amplio, el anuncio refleja una evolución importante en la función de los metadatos bibliográficos en la era de la IA. Los metadatos ya no sirven únicamente para que una persona encuentre un libro o un artículo en un catálogo: constituyen una infraestructura que permite que diferentes sistemas informáticos comprendan, relacionen, intercambien y reutilicen información bibliográfica. La incorporación de IA a SkyRiver refuerza esta tendencia y plantea un modelo en el que metadatos abiertos + interoperabilidad + automatización + supervisión profesional pueden convertirse en componentes fundamentales de los futuros ecosistemas de descubrimiento.

Rediseñando la catalogación bibliotecaria en la era de la inteligencia artificial

Two people interacting with an AI cataloging touchscreen in a modern library
Two people using an AI cataloging interface in a bright, spacious library

Program for Cooperative Cataloging (PCC), Library of Congress. PCC Task Group on AI and Machine Learning for Cataloging and Metadata: Final Report. Washington, D.C.: Library of Congress, 2024. PDF. https://www.loc.gov/aba/pcc/taskgroup/TG-Strategic-Planning-AI-final-report.pdf

Este informe final es el resultado del trabajo del Task Group del Program for Cooperative Cataloging (PCC) creado en diciembre de 2023 con el objetivo de analizar el impacto actual y potencial de la inteligencia artificial (IA) y el aprendizaje automático en los procesos de catalogación y gestión de metadatos en bibliotecas. El grupo llevó a cabo un estudio exploratorio basado en una encuesta distribuida en marzo de 2024, que obtuvo 193 respuestas de profesionales del ámbito bibliotecario y de la información.

El documento parte de el informe Environmental scan sobre el uso emergente de la IA en bibliotecas, especialmente en tareas relacionadas con catalogación, descripción bibliográfica, normalización de metadatos y apoyo a la toma de decisiones en sistemas de información. A partir de los resultados de la encuesta, el informe identifica patrones comunes de adopción, preocupaciones profesionales y oportunidades de desarrollo en el uso de estas tecnologías.

Uno de los aportes centrales del informe es la identificación de seis grandes temas transversales que reflejan cómo la comunidad bibliotecaria está interpretando la incorporación de la IA. Estos temas incluyen cuestiones relacionadas con la calidad de los datos, la confianza en los sistemas automatizados, la necesidad de supervisión humana, la formación profesional, la interoperabilidad de sistemas y el impacto organizativo de estas tecnologías en los flujos de trabajo bibliotecarios.

A partir de este análisis, el Task Group formula un conjunto de recomendaciones estratégicas dirigidas al PCC, orientadas a guiar la integración responsable de la IA en la catalogación. Entre estas recomendaciones se incluyen la necesidad de promover la alfabetización en IA entre los profesionales, fomentar marcos de gobernanza y ética, y apoyar el desarrollo de estándares que aseguren la calidad y consistencia de los metadatos generados o asistidos por IA.

El informe también propone líneas de acción institucional, entre las que destacan tres grandes direcciones:

(1) fortalecer la colaboración con comunidades más amplias de gestión de datos y metadatos,

(2) fomentar una cultura de pluralismo tecnológico que no dependa de una única solución o proveedor, y

(3) mejorar la forma en que el PCC documenta, almacena y comparte el conocimiento generado en torno a estas tecnologías.

Finalmente, el documento incluye un compendio de recursos sobre IA y catalogación, destinado a ser difundido a través del PCC Wiki, con el objetivo de servir como base de referencia para bibliotecarios, catalogadores e investigadores interesados en la aplicación de IA en el ámbito de los metadatos.

En conjunto, este informe representa un paso significativo en la reflexión institucional del mundo bibliotecario sobre la inteligencia artificial, al situar el foco no solo en la adopción tecnológica, sino también en sus implicaciones éticas, organizativas y profesionales dentro de los sistemas de catalogación modernos.

Zotero 9.0. Tutorial. Gestor de referencias bibliográficas

Zotero 9.0. Tutorial. Gestor de referencias bibliográficas

por Julio Alonso Arévalo

Ver en Youtube

Zotero 9 es la versión más reciente del popular gestor bibliográfico y supone un cambio importante respecto a las versiones 7 y 8, especialmente en lectura asistida, rendimiento y experiencia de investigación. Por Julio Alonso Arévalo

Que características tiene esta versión:

Lectura en voz alta (Read Aloud). La función más destacada es el nuevo sistema de lectura automática de documentos:

Lee PDFs, EPUB y capturas web.
Usa voces naturales de alta calidad.
Permite avanzar por frases o párrafos.
Puede comenzar desde cualquier punto del texto.
Integra anotaciones rápidas mientras escuchas.

Esto convierte a Zotero en una herramienta híbrida entre gestor bibliográfico y asistente de lectura académica.

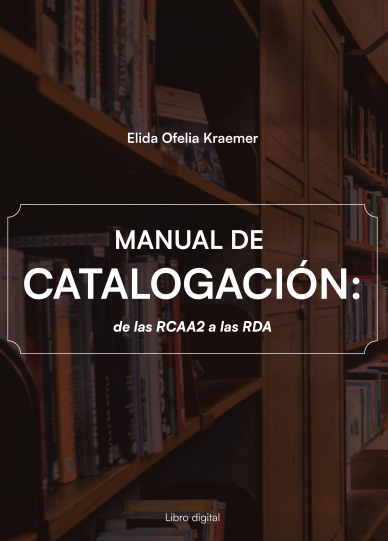
Manual de catalogación : de las RCAA2 a las RDA

Kraemer, Elida Ofelia . Manual de catalogación : de las RCAA2 a las RDA., 2026 Lanús : Elida Ofelia Kramer, 2026. [Book]

Descargar

El libro consta de dos partes: la primera sobre aspectos técnicos y la segunda sobre su aplicación. La primera parte aborda: la organización de la información, control bibliográfico, catálogos, normas para la descripción y acceso. Se hace mención a los esquemas de codificación para la manipulación de datos, MARC y al sistema integrado de gestión de bibliotecas KOHA. Se presenta una revisión de los distintos elementos que conforman las áreas de RCAA2 y su comparación con las RDA. Finalmente se aborda el tema relacionado a los puntos de acceso. Para la segunda parte del libro se han elaborado guías para la catalogación de materiales cartográficos, música notada, grabaciones sonoras, videograbaciones, recursos integrables, publicaciones seriadas y catalogación analítica. Las guías consisten en grillas que están formadas por los elementos principales del registro, una breve síntesis de la regla RDA, el campo MARC correspondiente, un ejemplo y observaciones. Sigue a cada guía, registros MARC completos que responden a las RDA. El libro tiene además una tabla de siglas y abreviaturas, un glosario y bibliografía.

Herramientas de Inteligencia Artificial aplicadas a la catalogación de bibliotecas para el año 2025

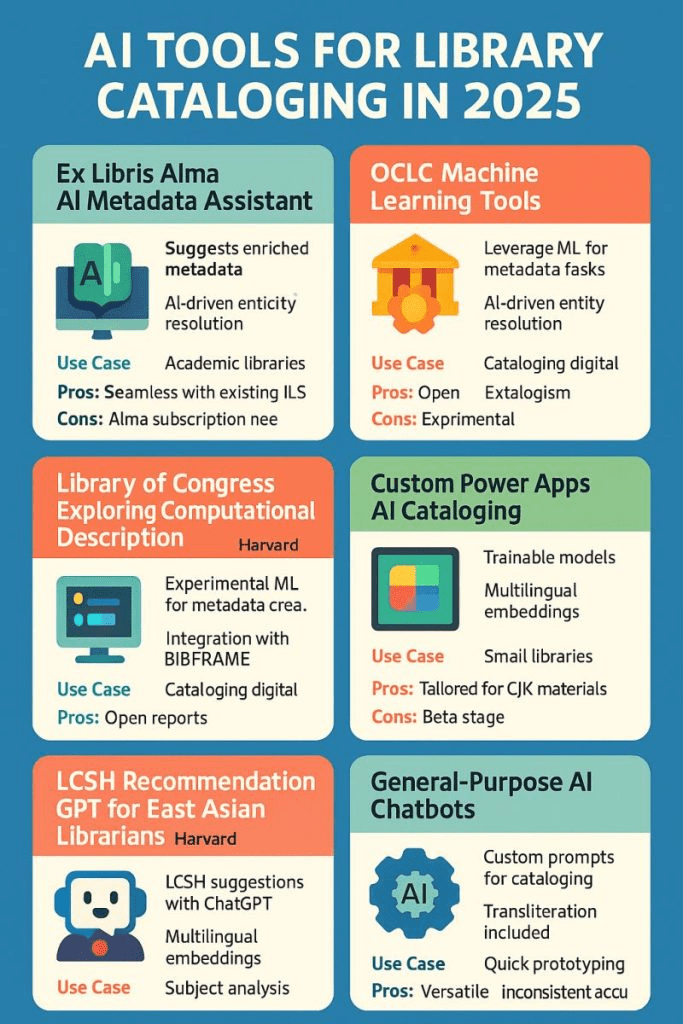
El contenido se divide en seis categorías principales que abarcan desde sistemas integrados comerciales hasta soluciones personalizadas y experimentales, destacando sus características, casos de uso, ventajas y limitaciones.

En el ámbito de las grandes plataformas, se mencionan el Ex Libris Alma AI Metadata Assistant y las herramientas de Machine Learning de OCLC. La primera está enfocada en bibliotecas universitarias para sugerir metadatos enriquecidos, destacando por su integración fluida con sistemas actuales, aunque requiere una suscripción. La segunda utiliza aprendizaje automático para la resolución de entidades en catalogación digital, caracterizándose por ser de código abierto pero aún en etapa experimental.

Por otro lado, instituciones académicas y gubernamentales lideran proyectos como el de la Biblioteca del Congreso y Harvard, que explora la descripción computacional y su integración con BIBFRAME para informes abiertos. Paralelamente, Harvard ha desarrollado una herramienta basada en GPT para bibliotecarios de Asia Oriental, la cual facilita sugerencias de encabezamientos de materia (LCSH) y análisis de temas mediante embeddings multilingües.

Finalmente, la infografía destaca soluciones más flexibles como las Custom Power Apps y los Chatbots de IA de uso general. Las Power Apps están diseñadas para bibliotecas pequeñas y materiales en idiomas asiáticos (CJK), ofreciendo modelos entrenables a pesar de estar en fase beta. Por su parte, los chatbots genéricos se utilizan para el prototipado rápido y la transliteración; aunque son muy versátiles, se advierte que su precisión puede ser inconsistente.

A continuación, se detallan los pros y contras de cada una de las 6 herramientas mencionadas en la infografía, para que puedas comparar sus ventajas y limitaciones:


1. Ex Libris Alma AI Metadata Assistant

  • Pros: Su principal ventaja es la integración fluida (seamless) con el sistema ILS (Sistema Integrado de Gestión Bibliotecaria) que ya utilizan muchas bibliotecas académicas.
  • Contras: Requiere obligatoriamente tener una suscripción activa a Alma, lo que representa un costo institucional elevado.

2. OCLC Machine Learning Tools

  • Pros: Se destaca por ser un ecosistema de catalogación abierta, lo que fomenta la colaboración entre instituciones.
  • Contras: Todavía se encuentra en una fase experimental, por lo que sus procesos podrían no ser totalmente estables o definitivos.

3. Library of Congress: Computational Description

  • Pros: Ofrece informes abiertos (open reports), lo que permite transparencia en cómo se generan los metadatos bajo el estándar BIBFRAME.
  • Contras: Al ser un proyecto de exploración institucional, su implementación práctica fuera de la Biblioteca del Congreso puede ser compleja o limitada.

4. Custom Power Apps AI Cataloging

  • Pros: Es una solución altamente personalizada para materiales CJK (chino, japonés y coreano), permitiendo entrenar modelos específicos.
  • Contras: Se encuentra en fase beta, lo que implica que aún está en desarrollo y puede presentar errores de funcionamiento.

5. LCSH Recommendation GPT (Harvard)

  • Pros: Muy eficiente para el análisis de materias multilingües, ayudando a traductores y catalogadores con términos complejos de encabezamiento de materia (LCSH).
  • Contras: (Aunque no se detalla explícitamente en el cuadro rojo, se infiere que depende de la precisión del modelo GPT de turno y del contexto específico de Harvard).

6. General-Purpose AI Chatbots (ChatGPT, etc.)

  • Pros: Son herramientas extremadamente versátiles que sirven para prototipado rápido, traducción y transliteración de diversos idiomas.
  • Contras: Tienen una precisión inconsistente. Al ser modelos generales, pueden cometer errores factuales («alucinaciones») en la creación de registros bibliográficos.

Catalogar con inteligencia artificial: retos y límites de la IA en los metadatos

Bryant, Rebecca y Annette Dortmund. “Striking the Right Balance: Opportunities and Challenges of AI in Metadata Workflows.Hanging Together, OCLC Research Library Partnership, 2025. https://hangingtogether.org/striking-the-right-balance-opportunities-and-challenges-of-ai-in-metadata-workflows/

La inteligencia artificial (IA) tiene un gran potencial para mejorar los flujos de trabajo de metadatos, ya que ofrece herramientas para aumentar la eficiencia, mejorar la búsqueda y abordar retos que llevan mucho tiempo presentes en las bibliotecas. Sin embargo, como ocurre con cualquier tecnología transformadora, la adopción de la IA requiere una reflexión profunda sobre sus limitaciones, sus implicaciones éticas y su impacto en la práctica profesional. La clave está en encontrar el equilibrio adecuado, uno que aproveche las capacidades de la IA y, al mismo tiempo, mantenga la calidad y los estándares profesionales de los que dependen las bibliotecas.

Entre abril y junio de 2024, la OCLC Research Library Partnership (RLP) convocó al Grupo de Trabajo sobre la Gestión de la IA en los Flujos de Trabajo de Metadatos. Este grupo de trabajo reunió a gestores de metadatos para explorar cómo se podría integrar la IA en los flujos de trabajo de catalogación, colecciones especiales y repositorios institucionales. A lo largo de estos debates, los bibliotecarios y archiveros expresaron tanto entusiasmo como cautela sobre la adopción de la IA, y surgieron una serie de temas transversales, ideas que van más allá de los flujos de trabajo específicos y destacan las oportunidades y los retos de la adopción responsable de la IA en las bibliotecas.

Un tema fundamental en todos los debates fue la importancia crítica de la calidad de los metadatos. Los participantes en los grupos de trabajo afirmaron de manera sistemática que crear registros utilizando IA es contraproducente si los recursos no se describen con precisión o si se induce a error a los usuarios. Este énfasis en la calidad no es un obstáculo para la adopción de la IA, sino un marco para su implementación responsable.

A partir de las conclusiones del grupo de trabajo “Managing AI in Metadata Workflows” de la OCLC, se destacan varias tensiones: por un lado, la IA ofrece eficiencia, puede automatizar tareas repetitivas y liberar tiempo para que los catalogadores se centren en trabajos de mayor valor; por otro, se plantea la necesidad de preservar la calidad de los metadatos, evitar “alucinaciones” (errores de la IA), y mantener el control humano mediante revisiones.

Se plantearon repetidamente varias consideraciones relacionadas con la calidad:

  • Alucinaciones que introducen información falsa en los registros del catálogo.
  • Resultados inconsistentes a partir de entradas idénticas, lo que socava la fiabilidad.
  • Puntuaciones de confianza poco fiables que no siempre reflejan con precisión la calidad del contenido generado por la IA.
  • Fallos en el reconocimiento de entidades, en los que los resultados generados por la IA pueden parecer sintácticamente correctos, pero no identifican a la persona, el lugar o la organización correctos.

Sin embargo, estos retos están impulsando innovaciones productivas en lugar de suponer barreras insuperables. El enfoque de OCLC para la deduplicación basada en IA en WorldCat demuestra cómo se pueden abordar las preocupaciones sobre la calidad mediante enfoques híbridos que combinan la eficiencia de la IA con la experiencia humana. OCLC ha colaborado estrechamente con la comunidad de catalogación para ayudar a validar la comprensión de su modelo de aprendizaje automático de los registros duplicados en WorldCat. Hasta la fecha, OCLC ha eliminado más de 9 millones de registros duplicados de WorldCat gracias a este modelo de IA, que seguimos probando y perfeccionando. El proceso incluye protocolos de toma de decisiones conservadores y supervisión humana para casos complejos, lo que demuestra cómo la IA puede ampliar el trabajo de calidad en lugar de comprometerlo.

Una cuestión recurrente es la dificultad de los modelos actuales para entender contexto cultural o terminología especializada, lo que puede llevar a imprecisiones semánticas. Además, se discute cómo los roles profesionales están cambiando: la IA puede encargarse del volumen bajo, pero los especialistas siguen siendo indispensables para revisar, validar y ajustar los resultados. Esto implica diseñar nuevos perfiles profesionales con habilidades para evaluar salidas de IA y para intervenir cuando la máquina se equivoca.

El texto también profundiza en los aspectos éticos: subraya la importancia de la transparencia (se debe dejar constancia de cuándo un metadato ha sido generado por IA), la trazabilidad y los estándares para gestionar la autoría de la IA. Además, apunta a las preocupaciones medioambientales relacionadas con el consumo energético de los modelos de IA y reclama una implementación sostenible. El análisis termina señalando que no se trata de sustituir al profesional, sino de colaborar con la IA de manera que se potencien sus fortalezas sin sacrificar rigor, equidad ni responsabilidad.

Cuando la inteligencia artificial reemplaza la experiencia: bibliotecas y catalogación en riesgo

Olson, Mike. «Beyond Classification: The Human Cost of Library and Information Labor Under Digital CapitalismThe Scholarly Kitchen, 26 de agosto de 2025. https://scholarlykitchen.sspnet.org/2025/08/26/guest-post-beyond-classification-the-human-cost-of-library-and-information-labor-under-digital-capitalism/

Las bibliotecas y su personal se ven afectados por la automatización, la externalización y la mercantilización del trabajo informativo en la era del capitalismo digital.

Se destaca cómo la consolidación de proveedores y la automatización mediante inteligencia artificial están eliminando el trabajo invisible que sostiene los sistemas bibliotecarios. Por ejemplo, la reciente reducción de personal en OCLC, la organización sin fines de lucro que gestiona el Sistema Dewey y WorldCat, refleja una contradicción fundamental en la valoración de la experiencia en catalogación: mientras que la organización cita la inteligencia artificial como justificación para los recortes laborales, también está desarrollando herramientas de inteligencia artificial para el procesamiento de metadatos. Esta contradicción pone de manifiesto cómo los avances tecnológicos celebrados por su eficiencia están borrando la experiencia humana que crea los metadatos de alta calidad de los que dependen estos sistemas para funcionar.

Además, el artículo señala que la mano de obra bibliotecaria ejemplifica lo que Maurizio Lazzarato identifica como «trabajo inmaterial»: trabajo que produce tanto contenido informativo como estandarización cultural, convirtiéndose en directamente productivo para el capitalismo digital a través de sistemas controlados por proveedores que agregan y monetizan metadatos estandarizados. La devaluación de la experiencia en catalogación se hace visible cuando las instituciones eliminan estos puestos durante los recortes presupuestarios. Por ejemplo, el despido de Violet Fox, una de las voces líderes en catalogación crítica y creadora del Cataloging Lab, ejemplifica el tipo de conocimiento especializado en catalogación que las instituciones están eliminando precisamente cuando más se necesita. Los catalogadores como Fox realizan el trabajo invisible de desafiar los sistemas de clasificación coloniales, asegurando que los encabezamientos de materia reflejen las necesidades de la comunidad en lugar de los términos genéricos proporcionados por los proveedores, haciendo que las colecciones sean descubribles y accesibles, y manteniendo la calidad de los metadatos que permite la investigación académica.

El artículo también destaca cómo los catálogos en línea actuales funcionan cada vez más como interfaces de sistemas de descubrimiento controlados por proveedores que agregan metadatos de múltiples fuentes con una supervisión local mínima. Esto representa una pérdida de autonomía institucional, ya que las decisiones sobre encabezamientos de materia, clasificación y referencias cruzadas se toman cada vez más en función de las necesidades de los proveedores en lugar de las necesidades de las colecciones y comunidades locales.

Inteligencia artificial y catalogación en bibliotecas

Getaneh Alemu, Anna Maria Tammaro; Navigating the artificial intelligence frontier on cataloguing and metadata work in libraries: an interview with Getaneh AlemuDigital Library Perspectives 20 August 2025; 41 (3): 587–592. https://doi.org/10.1108/DLP-08-2025-208

Se reflexiona sobre cómo la inteligencia artificial (IA) está transformando la catalogación. Plantea que la relación ideal entre la IA y los representantes humanos debe basarse en la complementariedad, más que en la sustitución. Según el autor, las máquinas pueden hacerse cargo de tareas repetitivas y estructuradas —como la clasificación inicial o el etiquetado automático—, mientras que los bibliotecarios y catalogadores deben conservar el papel de brindar juicio experto, interpretación contextual y garantía de calidad, elementos que aún son difícilmente automatizables

Además, Alemu insiste en que la implementación responsable de la IA en entornos bibliotecarios debe partir de los principios éticos de transparencia y precisión. Es fundamental que los sistemas automatizados actúen con transparencia, de modo que los usuarios puedan entender cómo se generan los metadatos y qué criterios siguen los algoritmos

La entrevista también destaca una visión esperanzadora para el futuro: la IA no debería percibirse como una amenaza, sino como una herramienta para potenciar la eficiencia, liberando a los profesionales de la biblioteconomía de labores mecánicas para enfocarse en aspectos más complejos y creativos de su labor. Alemu vislumbra un ecosistema en que la tecnología permita una mejor organización del conocimiento, sin sacrificar la supervisión humana ni el cuidado por la calidad bibliográfica.

La postura de Alemu subraya la necesidad de un enfoque equilibrado: integrar la IA como aliada, no como reemplazo, reforzando el rol humano a través de la ética, la transparencia y la experiencia profesional en catalogación y metadatos.

Chewy Decimal System: una crítica satírica a la clasificación decimal en bibliotecas

Video humorístico compartido en el blog Kottke.org, en el que se presenta la propuesta del divulgador científico Hank Green, quien argumenta que la forma en la que están organizados las bibliotecas es ineficiente y frustrante para los usuarios. Como solución, sugiere reorganizarlos siguiendo una lógica inspirada en el sistema de clasificación bibliotecario, al que llama irónicamente el “Chewy Decimal System” (Sistema Decimal Masticable), parodiando el Dewey Decimal System usado en bibliotecas.

El artículo también sirve como una crítica indirecta a dicho sistema bibliotecario. Se menciona que muchos bibliotecarios no lo aprecian, ya que fue diseñado en el siglo XIX con una visión eurocentrista y colonial, reflejando prejuicios como:

  • Priorizar el cristianismo en la clasificación religiosa.
  • Colocar a los pueblos indígenas en la sección de historia como si fueran del pasado.
  • Separar arbitrariamente animales salvajes y domésticos.

Además, se cuestiona su utilidad para niños, ya que exige comprensión de decimales antes de que se enseñen en la escuela, y se señala que existen sistemas alternativos más intuitivos, aunque su implementación es costosa.

La propuesta de Hank Green es, en esencia, un comentario satírico sobre la rigidez de los sistemas organizativos tradicionales, tanto en bibliotecas como en supermercados, y una invitación a repensar cómo organizamos la información (o los productos) en función de la experiencia del usuario.