Archivo de la etiqueta: Investigación

Citas científicas falsas generadas por IA: un problema creciente que amenaza la integridad de la literatura académica

Mondal, S. (2026, 18 de mayo). AI-generated fake citations are flooding scientific literature across publications, scientists warn. Phys.org. https://phys.org/news/2026-05-ai-generated-fake-citations-scientific.html

Se informa de una creciente preocupación en la comunidad científica ante la proliferación de citas bibliográficas falsas generadas por sistemas de inteligencia artificial en artículos académicos. Según un estudio reciente citado por Phys.org, el uso cada vez más extendido de modelos de lenguaje en la redacción científica está provocando que aparezcan referencias que no corresponden a publicaciones reales, lo que compromete la trazabilidad del conocimiento científico y la fiabilidad de la literatura académica.

Las citas al final de un artículo de investigación deberían representar una base sólida del conocimiento existente sobre un campo concreto, un conjunto de fuentes revisadas por pares construido a lo largo de años de investigación y estudio. Sin embargo, con el uso creciente de la IA y de los modelos de lenguaje de gran tamaño en la redacción de trabajos científicos, existe una posibilidad cada vez mayor de que la cita en la que alguien hace clic ni siquiera exista, y de que el estudio, la fuente o incluso los propios investigadores sean completamente falsos.

Uno de los hallazgos más relevantes del estudio es la magnitud del fenómeno: los investigadores detectaron aproximadamente 146.900 citas inexistentes en artículos científicos publicados en 2025, distribuidos en repositorios de gran relevancia como arXiv, bioRxiv, SSRN y PubMed Central. Este dato sugiere que el problema no es marginal ni anecdótico, sino estructural y extendido a múltiples disciplinas y plataformas de publicación.

El artículo explica que estas “alucinaciones bibliográficas” no suelen aparecer como errores masivos en un solo documento, sino como pequeñas cantidades de referencias falsas dispersas en numerosos artículos. Esto dificulta su detección mediante los sistemas tradicionales de revisión por pares, que no siempre verifican de forma exhaustiva la existencia real de cada fuente citada. El resultado es que estas referencias pueden incorporarse al registro científico y ser reutilizadas en trabajos posteriores, amplificando el problema.

Asimismo, el estudio sugiere que el fenómeno está relacionado con la adopción creciente de herramientas de inteligencia artificial en el proceso de escritura académica. Los modelos generativos pueden producir citas plausibles en apariencia, pero carentes de correspondencia real con publicaciones existentes, lo que introduce un riesgo sistémico en la producción de conocimiento científico. Esto afecta especialmente a la confianza en los mecanismos de validación académica y plantea la necesidad de reforzar los controles editoriales y las herramientas automáticas de verificación de referencias.

En este estudio, el equipo realizó una auditoría a gran escala de 111 millones de referencias extraídas de 2,5 millones de artículos científicos. Mediante una combinación de comprobaciones automáticas y manuales, buscaron títulos de citas que no pudieran vincularse a ninguna publicación real.

Más del 95% de las referencias fueron verificadas con éxito. En las restantes, corrigieron errores tipográficos con ayuda de IA hasta encontrar una coincidencia, y para los pocos títulos aún no identificados recurrieron a Google Scholar para asegurarse de que no se pasaba por alto ninguna publicación poco conocida.

Para aislar el papel de la IA, el equipo también analizó las tasas de citas no coincidentes antes de 2023, es decir, antes de la aparición generalizada de ChatGPT, Gemini y otros modelos de lenguaje, lo que sirvió como línea base para medir cuánto del problema podía atribuirse a la IA frente al error humano.

Los datos también revelaron lagunas en los sistemas de control, como la moderación de preprints, los editores de revistas y la revisión por pares, que solo detectaban una pequeña parte de estos errores. Por ejemplo, aunque la moderación de arXiv detectó algunos casos, se estima que el 78,8% de las citas inexistentes pasaron el filtro y fueron publicadas en la plataforma.

El estudio encontró que los científicos en etapas iniciales de su carrera y los equipos pequeños eran los más dados a incluir estas citas falsas, y en algunos casos estos mismos investigadores habían visto aumentar su productividad aproximadamente tres veces desde la llegada de la IA.

En conjunto, el artículo subraya que la expansión de la inteligencia artificial en la investigación científica está generando beneficios en términos de productividad, pero también nuevos riesgos para la integridad del sistema científico. La aparición de citas falsas no solo afecta a la calidad de los artículos individuales, sino que puede erosionar la base de conocimiento sobre la que se construye la ciencia contemporánea, lo que obliga a replantear los procesos de revisión, edición y validación de la literatura académica.
La IA alucina… y sus errores ya están entrando en la ciencia: riesgos para la investigación, la medicina y el conocimiento

Bove, Tristan. “AI Hallucinations in Research, Legal Filings, and Books Are Growing and Getting Harder to Fix.” Fortune, 24 de mayo de 2026. Fortune

El artículo analiza un problema cada vez más preocupante en la era de la inteligencia artificial: la incorporación de información falsa generada por sistemas de IA en documentos científicos, jurídicos, periodísticos y editoriales. Estas falsas afirmaciones, conocidas como “alucinaciones” de la IA, no son simples errores aislados, sino contenidos inventados que se presentan con apariencia de veracidad y que pueden terminar integrándose en el conocimiento académico y profesional.

El texto se centra especialmente en el caso de Maxim Topaz, investigador especializado en aplicaciones de IA para la salud. Durante la revisión de un artículo científico suyo, descubrió que una herramienta de inteligencia artificial había introducido una referencia bibliográfica inexistente sin advertirlo. Este incidente le llevó a investigar la magnitud del problema junto con otros colegas. Los resultados fueron alarmantes: tras analizar cerca de 2,5 millones de artículos biomédicos y alrededor de 97 millones de citas bibliográficas, identificaron más de 4.000 referencias falsas distribuidas en casi 3.000 trabajos científicos. Además, la frecuencia de estas referencias ficticias se ha multiplicado rápidamente desde la popularización de las herramientas de IA generativa.

El estudio revela que la presencia de referencias inexistentes en la literatura biomédica ha crecido de forma exponencial. Mientras que en 2023 aproximadamente uno de cada 2.828 artículos contenía alguna cita falsa, en 2025 la proporción había aumentado hasta uno de cada 458 trabajos. Los datos preliminares de 2026 muestran una tendencia todavía más preocupante, con una incidencia cercana a un artículo problemático por cada 277 publicados. Los investigadores consideran que estas cifras probablemente representan solo una parte del problema real, ya que muchas referencias falsas aún no han sido detectadas.

La preocupación principal radica en que la ciencia funciona como una cadena acumulativa de evidencias. Un artículo cita investigaciones previas, las revisiones sistemáticas sintetizan múltiples estudios y, posteriormente, las guías clínicas y protocolos médicos se basan en esas revisiones para orientar decisiones terapéuticas. Cuando una referencia inexistente se introduce en ese proceso, existe el riesgo de contaminar toda la cadena de conocimiento. En ámbitos como la medicina, esto podría afectar indirectamente a decisiones sobre diagnósticos, tratamientos o políticas sanitarias.

El artículo también destaca que el problema no se limita al ámbito científico. Casos recientes muestran cómo libros, informes periodísticos y documentos legales han incorporado citas o afirmaciones inventadas por sistemas de IA. En el sector jurídico, por ejemplo, se han documentado cientos de resoluciones y escritos legales que incluyen referencias erróneas generadas por modelos de lenguaje. Del mismo modo, algunos autores y periodistas han publicado obras que contenían citas inexistentes o atribuciones incorrectas producidas durante procesos de investigación asistidos por inteligencia artificial.

Otro aspecto especialmente inquietante es que la mayoría de estos errores no parecen ser fraudes deliberados. En muchos casos, los investigadores utilizan herramientas de IA para tareas aparentemente inocuas, como mejorar la redacción, corregir el estilo o formatear referencias. Sin embargo, los sistemas pueden introducir información falsa de manera silenciosa, lo que hace que incluso expertos familiarizados con las limitaciones de la IA puedan pasar por alto los errores. La confianza excesiva en estas herramientas aumenta el riesgo de que información incorrecta llegue a publicarse.

El artículo concluye señalando que la solución no consiste en abandonar la inteligencia artificial, sino en establecer procedimientos rigurosos de verificación. Los autores defienden que cualquier contenido generado o asistido por IA debe ser revisado cuidadosamente antes de incorporarse a publicaciones científicas, decisiones legales o productos informativos. La verdadera amenaza no es la existencia de errores ocasionales, sino que estos errores pasen desapercibidos y se integren en el registro permanente del conocimiento humano, dificultando posteriormente su corrección.

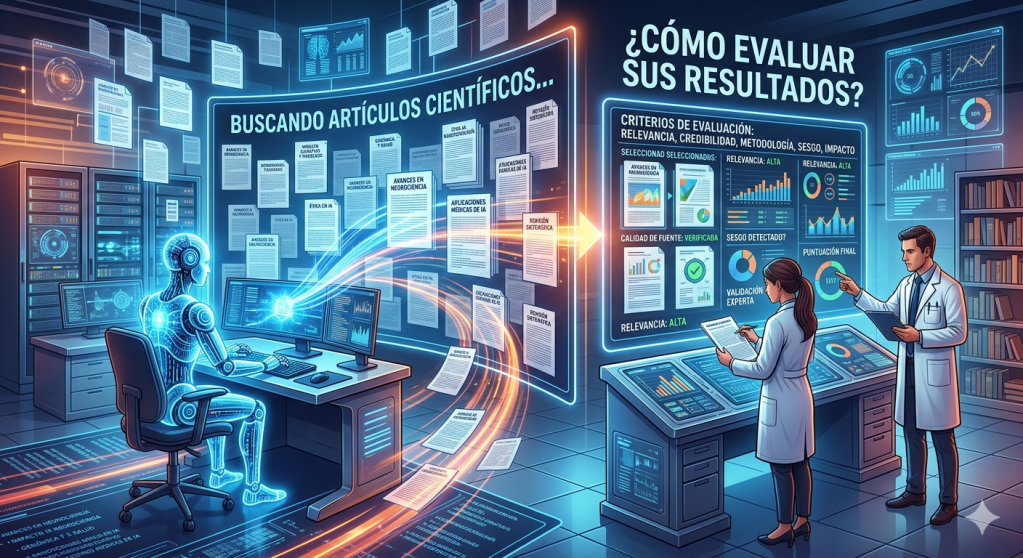
La inteligencia artificial busca artículos científicos, pero ¿Cómo evaluar sus resultados?

Aaron Tay. “AI Academic Search and the Missing Benchmark Problem”. Aaron Tay’s Musings about Librarianship, 2026.

Uno de los problemas más importantes en la evaluación de los sistemas de búsqueda académica basados en inteligencia artificial: la ausencia de estándares de referencia sólidos y compartidos. Mientras proliferan herramientas como Elicit, Consensus, Scite, Scopus AI o los sistemas de “Deep Research”, existe una gran dificultad para determinar objetivamente cuál de ellas ofrece mejores resultados, ya que no disponemos de benchmarks ampliamente aceptados que permitan comparar su rendimiento de forma rigurosa.

Tay señala que la situación recuerda a los primeros años de otros campos de la inteligencia artificial, donde los avances tecnológicos fueron más rápidos que los mecanismos de evaluación. Muchas plataformas promocionan capacidades como la búsqueda semántica, la recuperación aumentada por generación (RAG), la identificación automática de literatura relevante o la elaboración de revisiones bibliográficas asistidas por IA. Sin embargo, los usuarios suelen disponer únicamente de demostraciones comerciales o ejemplos seleccionados por los propios desarrolladores, lo que dificulta conocer el rendimiento real de estas herramientas en contextos de investigación auténticos.

Uno de los argumentos centrales del autor es que la búsqueda académica constituye un problema mucho más complejo que responder preguntas generales. No basta con recuperar documentos relacionados; también es necesario encontrar trabajos relevantes aunque utilicen terminología diferente, identificar literatura seminal, reconocer relaciones de citación y ofrecer resultados adecuados para distintas etapas del proceso investigador. Debido a ello, evaluar únicamente la precisión de una respuesta generada por IA resulta insuficiente.

El artículo destaca además que muchas pruebas actuales se centran en tareas demasiado simples. Un sistema puede responder correctamente a preguntas factuales concretas y aun así fracasar cuando se enfrenta a necesidades reales de investigación, como localizar artículos fundamentales omitidos en una revisión bibliográfica, detectar debates emergentes o construir estrategias de búsqueda exhaustivas. Tay sostiene que los escenarios de evaluación deberían reflejar mejor las tareas cotidianas de investigadores, estudiantes y bibliotecarios.

Otro problema importante es la falta de transparencia. Muchas herramientas académicas basadas en IA funcionan mediante modelos propietarios cuyos índices documentales, algoritmos de recuperación y mecanismos de clasificación no son públicos. Como consecuencia, resulta difícil reproducir experimentos o comprender por qué dos sistemas ofrecen resultados distintos ante la misma consulta. Esta opacidad limita la posibilidad de desarrollar evaluaciones comparables y acumulativas.

Tay también subraya que la calidad de un sistema RAG depende de dos componentes distintos: la recuperación de información y la generación de respuestas. Un modelo puede producir un texto aparentemente convincente pero basado en documentos poco relevantes, o bien recuperar excelentes artículos y resumirlos de forma deficiente. Por ello, propone evaluar por separado la capacidad de recuperación y la fidelidad de la síntesis generada.

En sus análisis previos sobre herramientas de búsqueda académica, el autor ha mostrado que algunos sistemas especializados fracasan en tareas relativamente sencillas para un investigador humano, mientras que modelos generales pueden resolverlas con más eficacia. Estos resultados sugieren que muchas plataformas funcionan mediante flujos de trabajo predefinidos que son muy eficaces en determinados escenarios, pero menos flexibles cuando la consulta se aparta de los casos previstos por sus diseñadores.

El texto conecta además con una cuestión más amplia dentro de la inteligencia artificial: la importancia de los benchmarks. Históricamente, disciplinas como el procesamiento del lenguaje natural o la visión artificial han avanzado gracias a conjuntos de pruebas estandarizados que permiten comparar sistemas bajo condiciones comunes. Sin estándares equivalentes para la búsqueda académica asistida por IA, resulta difícil distinguir entre mejoras reales y simples estrategias de marketing.

Aaron Tay defiende la necesidad de construir marcos de evaluación abiertos, transparentes y orientados a tareas reales de investigación. Solo mediante benchmarks compartidos será posible determinar qué herramientas mejoran verdaderamente el descubrimiento académico y cuáles simplemente generan respuestas convincentes. Para bibliotecarios, investigadores y responsables institucionales, esta cuestión resulta especialmente relevante en un momento en que las plataformas de búsqueda basadas en IA comienzan a integrarse en bases de datos científicas, catálogos bibliotecarios y servicios de apoyo a la investigación.

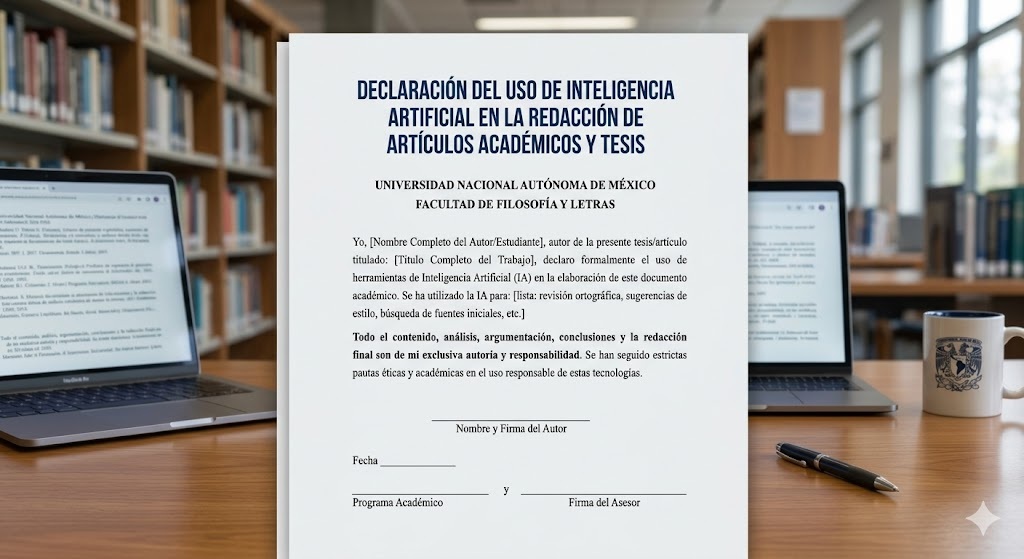
Declaración del uso de inteligencia artificial en la redacción de artículos académicos y tesis

Cabrera Huaycochea, Daril. 2025. Declaración del uso de inteligencia artificial en la redacción de artículos académicos y tesis: Hacia un estándar ético y transparente para la producción científica en la era de los modelos de lenguaje de gran escala. ResearchGate. Consultado el 30 de mayo de 2026.

Texto completo

La expansión de los modelos de lenguaje de gran escala, como GPT, Claude o Gemini, ha transformado profundamente la producción académica, facilitando tareas como la redacción, la síntesis bibliográfica y la revisión textual. Sin embargo, este avance tecnológico no ha ido acompañado de normas homogéneas para declarar su utilización, generando importantes desafíos éticos relacionados con la transparencia, la autoría y la evaluación del mérito académico. El artículo de analiza esta problemática y propone un marco estandarizado para la declaración del uso de inteligencia artificial en artículos científicos y tesis.

El autor examina las políticas adoptadas por algunas de las principales instituciones y editoriales científicas internacionales, entre ellas arXiv, Elsevier, Nature y el Comité de Ética en Publicaciones (COPE). Aunque existen diferencias en los procedimientos, todas coinciden en dos principios fundamentales: las herramientas de inteligencia artificial no pueden ser consideradas autoras de trabajos académicos y cualquier utilización relevante debe ser declarada de manera explícita. Estas organizaciones subrayan que la responsabilidad sobre la exactitud, integridad y ética de los contenidos recae siempre en los autores humanos.

Uno de los principales aportes del trabajo es la formulación de una taxonomía de cuatro niveles de declaración. El Nivel 1 corresponde a trabajos elaborados sin IA generativa; el Nivel 2 contempla el uso de herramientas para corrección gramatical y estilística; el Nivel 3 incluye la generación de borradores, síntesis o análisis supervisados por los autores; y el Nivel 4 se refiere a aquellos casos en los que la IA participa de forma sustancial en la estructura argumentativa o conceptual del trabajo. El objetivo de esta clasificación no es juzgar moralmente los distintos usos de la tecnología, sino ofrecer un marco de transparencia que permita comprender el grado de intervención tecnológica en cada investigación.

El artículo también proporciona modelos prácticos de declaración para revistas científicas y tesis universitarias. Estas plantillas buscan facilitar la adopción de estándares comunes que permitan describir qué herramientas se utilizaron, en qué fases del proceso participaron y qué mecanismos de revisión humana se aplicaron posteriormente. Según el autor, la normalización de estas declaraciones contribuiría a reducir la ambigüedad normativa y fomentaría una cultura de integridad académica basada en la transparencia y la responsabilidad.

Se presta especial atención al contexto latinoamericano, donde identifica importantes desafíos relacionados con la desigualdad en el acceso a tecnologías avanzadas, la obsolescencia de los reglamentos universitarios y los sesgos lingüísticos de los modelos entrenados principalmente en inglés. Ante esta situación, propone que las universidades actualicen sus normativas y distingan claramente entre el uso declarado de la inteligencia artificial y el fraude académico por ocultamiento u omisión. La conclusión central del trabajo es que el verdadero debate no debe centrarse en prohibir o permitir la IA, sino en garantizar que su utilización sea transparente, verificable y compatible con los principios fundamentales de la integridad científica.

La búsqueda en IA para la ciencia aún depende de los metadatos

Man searching academic articles with AI software on computer in library
A man uses AI-powered research software in a library setting.

Hansen, Stephanie Lovegrove. 2026. “Scholarly AI Search Shortcomings and the Need for Better Metadata.” The Scholarly Kitchen, 29 de mayo de 2026. https://scholarlykitchen.sspnet.org/2026/05/29/guest-post-scholarly-ai-search-shortcomings-and-the-need-for-better-metadata

El artículo defiende que el futuro de la búsqueda académica no será una sustitución de los sistemas actuales, sino un modelo híbrido en el que coexistan la búsqueda por palabras clave, la IA generativa y los sistemas de metadatos enriquecidos. En este escenario, la calidad, estandarización y estructura de los metadatos se convierten en un elemento clave: sin ellos, incluso los sistemas de IA más avanzados no pueden ofrecer resultados fiables ni plenamente utilizables en entornos científicos.

Se analiza las limitaciones actuales de los sistemas de búsqueda académica basados en inteligencia artificial y sostiene que su rendimiento depende de forma crítica de la calidad de los metadatos subyacentes. A partir de la evaluación de herramientas de descubrimiento científico impulsadas por IA, la autora argumenta que estos sistemas aún no logran sustituir de manera fiable a la búsqueda tradicional basada en palabras clave, especialmente cuando se trata de consultas precisas, técnicas o altamente estructuradas.

Uno de los problemas centrales es la dificultad de las herramientas de IA para manejar con precisión información exacta como fórmulas, datos químicos, identificadores o referencias bibliográficas específicas. Aunque la IA destaca en tareas de síntesis y en la exploración de preguntas abiertas en lenguaje natural, tiende a fallar en escenarios donde la exactitud, la reproducibilidad y la trazabilidad son esenciales. Esto genera una tensión entre dos modelos de descubrimiento: el tradicional, basado en control y precisión, y el emergente, centrado en interpretación y síntesis automática.

El texto subraya además la opacidad de muchos sistemas de IA, que dificulta comprender por qué un resultado es recuperado o no. Esta falta de transparencia afecta directamente a la confianza de los usuarios y complica su uso en contextos académicos formales, como revisiones sistemáticas o investigación regulatoria.

Análisis de las citas de los motores de búsqueda generativos para detectar la presencia de referencias generadas por IA

Allaham, Mowafak, and Nicholas Diakopoulos. 2026. Synthetic Sources?: Auditing Generative Search Engine Citations for Evidence of AI-Generated Sources. arXiv:2605.23684, May 2026. https://arxiv.org/abs/2605.23684

El artículo analiza un problema emergente en la ecosfera informativa contemporánea: la aparición de “fuentes sintéticas” en los sistemas de búsqueda generativa, es decir, referencias o citas que no provienen de documentos humanos tradicionales verificables, sino que podrían haber sido generadas parcial o totalmente por modelos de inteligencia artificial. Los autores se centran en cómo los motores de búsqueda basados en IA —que combinan recuperación de información con generación de texto— pueden introducir nuevos tipos de distorsión en la cadena de citación científica y periodística.


El trabajo parte de una preocupación central: los sistemas de búsqueda generativa no solo responden preguntas, sino que también construyen aparentes evidencias mediante citas, enlaces o referencias que parecen legítimas. Sin embargo, estas referencias pueden no corresponder a documentos reales, o pueden ser reconstrucciones plausibles generadas por el modelo. Esto plantea un riesgo crítico para la integridad del ecosistema informativo, ya que el usuario puede asumir que una cita es verificable cuando en realidad es una “alucinación documentada” o una fuente fabricada.

Metodológicamente, el estudio propone un enfoque de auditoría para examinar las respuestas de diferentes sistemas de búsqueda generativa. Los autores diseñan un conjunto de procedimientos para analizar la trazabilidad de las citas: verifican si los enlaces conducen a documentos reales, si las fuentes son consistentes con el contenido citado y si existen patrones recurrentes de generación de referencias inexistentes. Este enfoque permite clasificar las citas en diferentes categorías, incluyendo fuentes auténticas, fuentes parcialmente verificables y fuentes completamente sintéticas.

Los resultados muestran que una proporción significativa de las citas generadas por sistemas de IA no puede ser rastreada directamente a publicaciones reales o presenta inconsistencias importantes entre el contenido citado y la fuente original. Esto sugiere que los sistemas de búsqueda generativa pueden producir un tipo de “autoridad simulada”, donde la apariencia de rigor académico o periodístico no está respaldada por una verificación documental sólida.

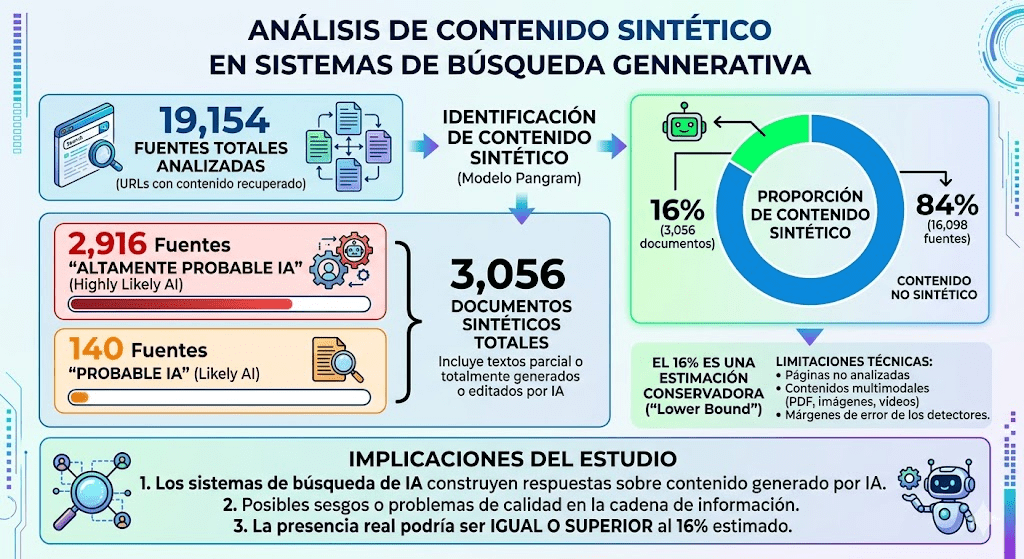
El estudio analiza en total 19.154 fuentes (URLs con contenido recuperado) que han sido citadas por distintos sistemas de búsqueda generativa. Estas fuentes representan el conjunto de documentos que los modelos consultan y utilizan como apoyo para construir sus respuestas a los usuarios. En este corpus amplio, los investigadores intentan determinar no solo qué dominios se citan, sino también la naturaleza del contenido que contienen.

Dentro de este conjunto, el sistema de detección de contenido generado por inteligencia artificial —en este caso, el modelo Pangram— identifica dos categorías principales de contenido sintético. Por un lado, 2.916 fuentes son clasificadas como “Highly Likely AI”, es decir, textos con una alta probabilidad de haber sido generados por modelos de lenguaje o sistemas automáticos. Por otro lado, 140 fuentes adicionales se clasifican como “Likely AI”, lo que indica una probabilidad significativa, aunque algo menos concluyente, de haber sido producidas o fuertemente asistidas por IA.

Al sumar ambas categorías, el estudio concluye que existen 3.056 documentos sintéticos en total dentro de las fuentes analizadas. Esta cifra no implica únicamente textos completamente generados por IA, sino también aquellos que pueden haber sido parcialmente producidos o editados mediante herramientas de inteligencia artificial, lo que amplía el concepto de “contenido sintético” utilizado en el análisis.

En términos proporcionales, estos 3.056 documentos representan aproximadamente un 16% del total de fuentes examinadas. Este dato es especialmente relevante porque indica que una parte no menor de las fuentes utilizadas por los sistemas de búsqueda generativa podría estar influida por procesos automatizados de generación de texto, lo que introduce posibles sesgos o problemas de calidad en la cadena de información.

El estudio subraya además que esta cifra debe interpretarse como una estimación conservadora o “lower bound”, es decir, un límite inferior. Esto significa que el 16% probablemente no refleja la totalidad real del fenómeno, ya que existen limitaciones técnicas importantes: no todas las páginas pudieron ser analizadas, algunos contenidos multimodales (como PDFs, imágenes o vídeos) quedaron fuera, y además los detectores de IA tienen márgenes de error inherentes.

En consecuencia, los autores advierten que la presencia real de contenido sintético en las citas podría ser igual o incluso superior al 16% estimado. Este resultado sugiere que los sistemas de búsqueda basados en IA están construyendo sus respuestas sobre un ecosistema informativo donde el contenido generado por IA ya es una fracción significativa y potencialmente creciente del total de fuentes disponibles en la web.

El artículo también discute las implicaciones teóricas y prácticas de este fenómeno. En primer lugar, plantea un desafío epistemológico: la noción tradicional de citación como mecanismo de validación del conocimiento se ve erosionada cuando las citas pueden ser generadas artificialmente. En segundo lugar, advierte sobre el impacto en la confianza pública en sistemas de información, especialmente en contextos de alta sensibilidad como salud, política o investigación académica.
Finalmente, los autores proponen la necesidad de nuevos marcos de transparencia y auditoría para sistemas de búsqueda generativa. Esto incluye mecanismos automáticos de verificación de fuentes, estándares de trazabilidad de citas y políticas de diseño que eviten la generación de referencias no comprobables. El objetivo general es preservar la integridad del ecosistema informativo en un entorno donde la frontera entre contenido generado y contenido documentado se vuelve cada vez más difusa.

Papel de la automatización y la inteligencia artificial en el ciclo completo de la investigación científica

Frechette, John, and Heather Pierce-Lopez. 2026. “A Friendly Debate: Where Automation Will (And Should) Land in the Research Lifecycle.” The Scholarly Kitchen, 22 de mayo de 2026. https://scholarlykitchen.sspnet.org/2026/05/22/guest-post-a-friendly-debate-where-automation-will-and-should-land-in-the-research-lifecycle/

El artículo de The Scholarly Kitchen plantea un debate estructurado sobre el papel de la automatización y la inteligencia artificial en el ciclo completo de la investigación científica. Más que discutir si la IA “debe” o “no debe” utilizarse, el texto propone una reflexión más matizada: en qué fases del proceso investigador la automatización puede mejorar la eficiencia y en cuáles es imprescindible preservar el juicio humano.

El punto de partida es la constatación de que la IA ya está integrada de forma implícita en numerosas herramientas académicas, desde motores de búsqueda hasta sistemas de descubrimiento y gestión bibliográfica, aunque muchas veces no se perciba como tal.

El artículo identifica varias fases del ciclo de investigación donde la automatización ya está avanzando o podría hacerlo con mayor intensidad. Entre ellas se encuentran la búsqueda y descubrimiento de literatura, la organización de información, el apoyo a la redacción científica, la revisión preliminar de manuscritos y ciertas tareas administrativas dentro de las instituciones académicas. En estos ámbitos, la IA se presenta como un mecanismo de ampliación de capacidades, especialmente relevante para equipos con recursos limitados, como bibliotecas universitarias pequeñas o centros de investigación con alta carga operativa. La automatización permite reducir tareas repetitivas y liberar tiempo para actividades de mayor valor intelectual o pedagógico.

Sin embargo, el texto subraya que existen dimensiones del proceso de investigación que no pueden ni deberían ser completamente automatizadas. Entre ellas destacan la curación crítica del conocimiento, la interpretación contextual de los resultados, la toma de decisiones éticas y la integración del conocimiento en marcos institucionales específicos. Estas funciones requieren experiencia acumulada, sensibilidad disciplinar y comprensión del entorno académico que la IA no puede replicar plenamente. También se enfatiza la importancia del juicio humano en cuestiones relacionadas con la integridad científica, el riesgo institucional y la responsabilidad legal.

Un eje central del debate es la tensión entre eficiencia y confianza. Aunque la automatización puede acelerar significativamente el ciclo de producción del conocimiento, también introduce problemas de opacidad, reproducibilidad y gobernanza. El artículo señala que muchas de las herramientas actuales operan como “cajas negras”, lo que genera preocupación entre bibliotecarios, editores y gestores de investigación. La cuestión no es solo técnica, sino estructural: cómo garantizar que los sistemas automatizados sean transparentes, auditables y alineados con los valores de la ciencia abierta.

Finalmente, el texto propone una visión intermedia en la que la IA no sustituye el proceso de investigación, sino que se inserta en él como infraestructura. Esto implica rediseñar flujos de trabajo completos, definir claramente los puntos de intervención humana y establecer mecanismos de control y supervisión. En este modelo, la automatización no elimina la necesidad del investigador, sino que redefine su papel, desplazándolo hacia funciones de mayor nivel cognitivo, como la interpretación, la supervisión crítica y la toma de decisiones estratégicas dentro del ecosistema de producción científica.

Zotero 9.0. Tutorial. Gestor de referencias bibliográficas

Zotero 9.0. Tutorial. Gestor de referencias bibliográficas

por Julio Alonso Arévalo

Ver en Youtube

Zotero 9 es la versión más reciente del popular gestor bibliográfico y supone un cambio importante respecto a las versiones 7 y 8, especialmente en lectura asistida, rendimiento y experiencia de investigación. Por Julio Alonso Arévalo

Que características tiene esta versión:

Lectura en voz alta (Read Aloud). La función más destacada es el nuevo sistema de lectura automática de documentos:

Lee PDFs, EPUB y capturas web.
Usa voces naturales de alta calidad.
Permite avanzar por frases o párrafos.
Puede comenzar desde cualquier punto del texto.
Integra anotaciones rápidas mientras escuchas.

Esto convierte a Zotero en una herramienta híbrida entre gestor bibliográfico y asistente de lectura académica.

La ciencia ante la avalancha de “AI slop”

Peters, Jay. 2026. “AI Research Papers Are Getting Better, and It’s a Big Problem for Scientists.” The Verge, mayo de 2026. https://www.theverge.com/ai-artificial-intelligence/930522/ai-research-papers-slop-peer-review-problem

Se analiza una creciente preocupación dentro de la comunidad científica internacional: la expansión de artículos académicos generados parcial o totalmente mediante inteligencia artificial y el impacto que este fenómeno está teniendo sobre el sistema de revisión por pares. Lo que hace apenas dos años se identificaba fácilmente como “AI slop” —textos plagados de errores, referencias inventadas y frases incoherentes— ha evolucionado rápidamente hacia trabajos aparentemente sofisticados, bien redactados y difíciles de detectar incluso para expertos. Investigadores y editores científicos advierten que la automatización masiva de la escritura académica amenaza con saturar los mecanismos tradicionales de validación científica.

El reportaje explica que los modelos de lenguaje actuales son capaces de producir artículos completos en cuestión de minutos utilizando bases de datos públicas, gráficos automatizados y síntesis bibliográficas generadas algorítmicamente. Herramientas agentivas de IA permiten ya redactar hipótesis, construir marcos teóricos, producir análisis estadísticos e incluso responder automáticamente a comentarios de revisores. El problema no reside únicamente en la existencia de errores, sino en la enorme escala de producción. Según varios investigadores citados, la IA puede generar trabajos mucho más rápido de lo que los científicos humanos pueden leerlos o evaluarlos.

Uno de los aspectos más preocupantes es el deterioro progresivo del sistema de revisión por pares, históricamente considerado uno de los pilares de la credibilidad científica. Revisores y editores describen un entorno cada vez más difícil de gestionar debido al incremento de manuscritos redundantes, superficiales o engañosos. El artículo señala que muchos de estos textos utilizan lenguaje técnico convincente y estructuras académicas correctas, pero aportan escaso valor científico real. Esto obliga a los revisores a invertir más tiempo verificando datos, referencias y metodologías. La carga de trabajo se multiplica mientras la calidad media de las contribuciones disminuye.

La situación ha llevado a plataformas científicas a adoptar medidas drásticas. El repositorio científico arXiv anunció recientemente que prohibirá durante un año a los autores que publiquen trabajos con evidencia clara de contenido generado por IA no verificado, incluyendo referencias inventadas o comentarios residuales dejados por modelos lingüísticos. Además, quienes sean sancionados deberán demostrar posteriormente que sus investigaciones han sido aceptadas en publicaciones revisadas por pares antes de poder volver a subir artículos a la plataforma. Esta decisión refleja la preocupación institucional por preservar la confianza y la integridad académica en un contexto de creciente automatización textual.

El artículo también subraya que la crisis no puede entenderse únicamente como un problema tecnológico, sino como una consecuencia de las propias dinámicas estructurales del sistema académico contemporáneo. La presión por publicar, conseguir financiación y mantener productividad científica favorece comportamientos donde la cantidad de publicaciones se valora más que la calidad o la originalidad. La IA amplifica estas dinámicas al reducir drásticamente el coste y el tiempo necesarios para producir artículos. Algunos expertos comparan la situación con una “tragedia de los comunes”: cada investigador obtiene beneficios individuales al aumentar su productividad mediante IA, pero colectivamente el ecosistema científico se degrada debido a la saturación y pérdida de confianza.

Otro problema destacado es la aparición de errores sofisticados difíciles de detectar. Investigaciones recientes muestran que incluso conferencias científicas de alto prestigio han aceptado trabajos con referencias completamente inventadas generadas por IA. Estos fallos no siempre resultan evidentes porque los modelos producen citas plausibles, nombres verosímiles y estructuras metodológicas aparentemente coherentes. El riesgo no es solo la publicación de investigaciones deficientes, sino la contaminación progresiva del propio ecosistema científico con datos falsos, referencias inexistentes y conocimiento difícilmente verificable.

Paradójicamente, mientras algunos sectores intentan frenar el “AI slop”, otros comienzan a utilizar inteligencia artificial para aliviar precisamente la crisis de revisión. Algunos proyectos experimentales, como los desarrollados en conferencias de inteligencia artificial, ya emplean sistemas automatizados capaces de revisar miles de artículos en menos de un día. Sus defensores argumentan que la IA puede detectar errores técnicos y debilidades metodológicas con gran rapidez, aunque críticos advierten de que esto puede generar revisiones homogéneas, sesgadas y fácilmente manipulables mediante ajustes estilísticos. El debate gira así en torno a una paradoja creciente: utilizar IA para controlar los problemas creados por la propia IA.

Las reacciones en comunidades académicas y tecnológicas reflejan una mezcla de alarma, resignación y escepticismo. En foros como Reddit, numerosos investigadores consideran que el problema no se limita a los modelos lingüísticos, sino a un sistema científico que ya estaba sobrecargado antes de la llegada de la IA generativa. Algunos usuarios sostienen que el verdadero riesgo es que el volumen de textos automatizados haga imposible distinguir entre investigación genuina y producción mecánica. Otros creen que la crisis obligará a replantear prácticas fundamentales de evaluación científica, desde la verificación de referencias hasta la exigencia de compartir datos experimentales completos.

La inteligencia artificial no solo está transformando la manera de escribir artículos científicos, sino que está alterando profundamente los mecanismos de validación del conocimiento académico. La revisión por pares, concebida históricamente como filtro de calidad y garantía de rigor, enfrenta ahora un escenario donde la producción automatizada amenaza con superar la capacidad humana de evaluación. El desafío ya no consiste únicamente en detectar textos generados por IA, sino en redefinir qué significa producir conocimiento fiable en una época dominada por la automatización intelectual.