Archivo de la etiqueta: Investigación

La compraventa de autorías científicas: un análisis de Nature destapa el mercado global del fraude académico

Research Information. 2026. “Paper Mills Expose Global Market for Authorship Fraud, Nature Analysis Finds.” Research Information, 27 de abril de 2026. https://www.researchinformation.info/news/paper-mills-expose-global-market-for-authorship-fraud-nature-analysis-finds

Un análisis publicado por Nature revela la existencia de un mercado internacional altamente organizado dedicado a la venta de autorías científicas, una de las manifestaciones más preocupantes del fraude en la comunicación académica. La investigación recopiló una base de datos con más de 18.700 anuncios publicados entre marzo de 2020 y abril de 2026 por siete grandes paper mills —empresas que producen artículos científicos fraudulentos o de escasa calidad y comercializan puestos de autoría—, poniendo de manifiesto que estas prácticas se han convertido en una industria transnacional con un elevado volumen económico.

El estudio muestra que el precio por ocupar la posición de primer autor oscila desde 57 dólares hasta más de 5.600 dólares, con una mediana cercana a los 800 dólares. Las ofertas se difundían principalmente mediante canales de Telegram y páginas web especializadas, dirigidas especialmente a investigadores sometidos a fuertes presiones para publicar, procedentes de regiones como Oriente Medio, Asia Central, Europa del Este e India. Además de artículos científicos, algunas organizaciones ofrecían también autorías en libros, patentes, premios académicos e incluso otros servicios destinados a mejorar artificialmente el prestigio profesional de los clientes.

Los investigadores sostienen que estos negocios van mucho más allá de la producción de manuscritos falsificados. En realidad, operan como empresas especializadas en la manipulación de la reputación científica, aprovechando un sistema académico donde las publicaciones siguen siendo el principal indicador para acceder a promociones, financiación y reconocimiento profesional. Esta dinámica alimenta un mercado que responde directamente a la presión del modelo de «publicar o perecer».

La investigación también demuestra que una parte de estos trabajos fraudulentos consigue superar los procesos editoriales y llegar a revistas científicas de prestigio. Al comparar cientos de anuncios con publicaciones reales, los autores identificaron 53 artículos publicados cuyos títulos coincidían con las ofertas de venta de autoría; únicamente cinco habían sido retractados. Entre las revistas afectadas aparecen publicaciones de grandes editoriales internacionales como Springer Nature, Wiley, Elsevier, Frontiers y Taylor & Francis, además de actas de congresos del IEEE, lo que evidencia que incluso los sistemas editoriales más consolidados siguen siendo vulnerables a estas prácticas.

El estudio concluyó que ocupar la posición de primer autor tiene un coste medio cercano a los 800 dólares, con precios que oscilan entre 57 y más de 5.600 dólares. Los resultados se describen en un preprint enviado al repositorio arXiv. La base de datos también pone de manifiesto el alcance internacional de las paper mills. Los investigadores localizaron anuncios en Telegram relacionados con operaciones en India, Irak y Uzbekistán, además de miles de anuncios procedentes de sitios web vinculados a empresas establecidas en Rusia, Letonia, Kazajistán y Ucrania. Las siete paper mills analizadas anunciaban la venta de puestos de autoría en artículos científicos, mientras que algunas también ofrecían la posibilidad de figurar como autores de libros de texto, patentes y otros productos académicos, además de servicio relacionados con la obtención de premios y reconocimientos académicos.

El análisis también sugiere que algunos manuscritos producidos por estas organizaciones llegan a publicarse. Los periodistas de Nature revisaron más de 600 anuncios vinculados a unos 400 artículos e identificaron 53 trabajos publicados cuyos títulos coincidían con los de los anuncios. Solo cinco de ellos habían sido retractados.

Los autores consideran que la base de datos recopilada puede convertirse en una herramienta valiosa para editores y editoriales científicas. El análisis de los anuncios permitirá desarrollar mecanismos automáticos para detectar manuscritos sospechosos, identificar revistas especialmente expuestas y comprender mejor las estrategias comerciales empleadas por estas organizaciones. En un contexto donde el fraude científico evoluciona rápidamente y se beneficia de nuevas tecnologías y plataformas digitales, disponer de este tipo de información resulta esencial para reforzar la integridad de la investigación y proteger la credibilidad de la literatura científica.
Por qué las emociones también importan en la comunicación académica

Irfanullah, H. (2026). The Emotional Rollercoaster of Scholarly Publishing. The Scholarly Kitchen, 6 de julio de 2026. The Scholarly Kitchen

La publicación científica suele analizarse desde una perspectiva centrada en los procesos editoriales, la revisión por pares, los indicadores bibliométricos o la integridad de la investigación. Sin embargo, Haseeb Irfanullah propone un enfoque diferente: situar las emociones de quienes participan en este ecosistema en el centro del debate.

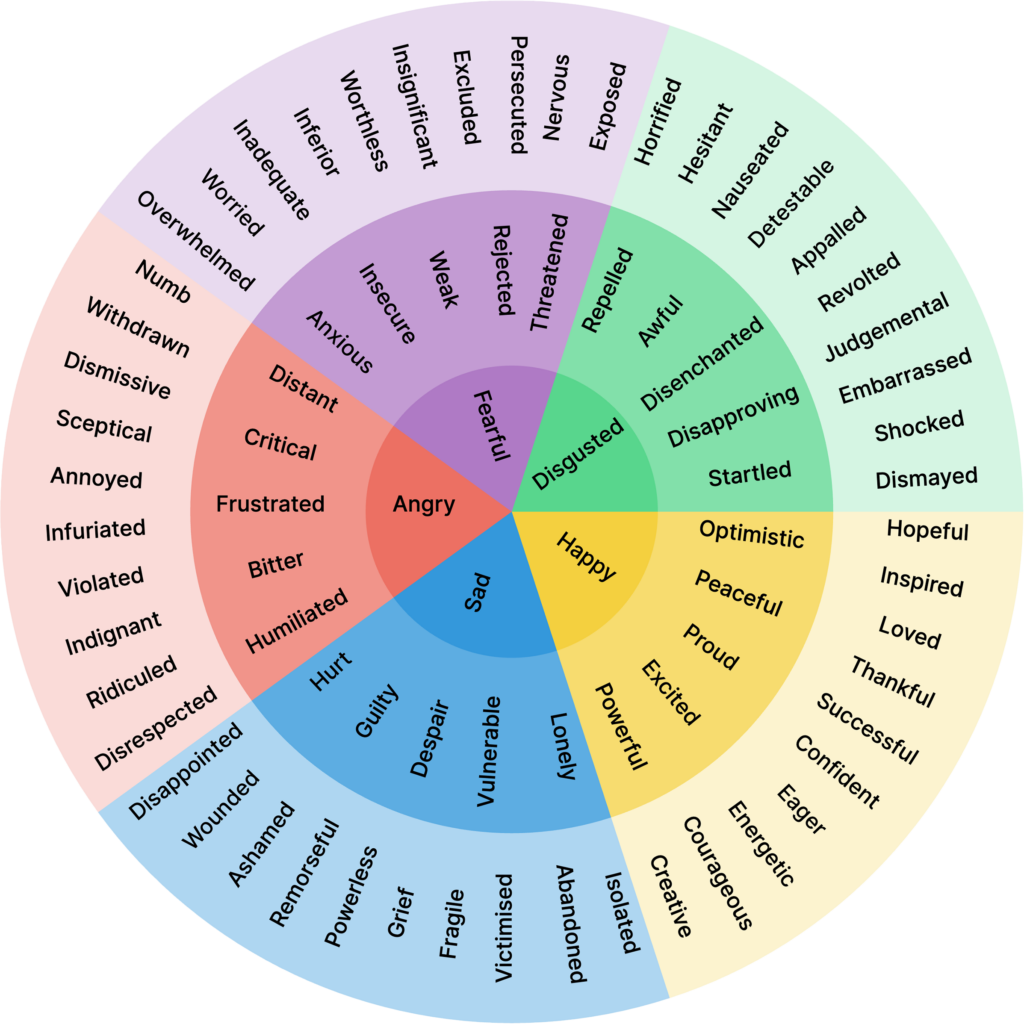
El autor sostiene que autores, revisores y editores experimentan una auténtica «montaña rusa emocional» a lo largo del ciclo de publicación, marcada por la incertidumbre, la frustración, la esperanza, la satisfacción o el agotamiento. A pesar de que estas emociones influyen directamente en la calidad del trabajo científico y en el bienestar de sus protagonistas, rara vez son consideradas en el diseño de las políticas editoriales o en la gestión de las revistas.

El artículo parte de una experiencia personal del propio autor para mostrar cómo la relación entre investigadores y revistas puede evolucionar de maneras muy distintas según las respuestas emocionales que generan los procesos editoriales. La larga espera para recibir una decisión, las revisiones contradictorias, el rechazo de un manuscrito o la falta de comunicación por parte de las revistas provocan sentimientos de ansiedad, desmotivación e incluso pérdida de confianza. Estas experiencias no afectan únicamente a quienes publican; también repercuten en su disposición futura para aceptar invitaciones como revisores o colaborar con determinadas publicaciones. Irfanullah recuerda que detrás de cada manuscrito hay personas cuya trayectoria profesional y estado emocional pueden verse profundamente condicionados por la forma en que se gestionan estos procesos.

El autor amplía posteriormente la reflexión al conjunto del sistema de comunicación científica. Se pregunta cómo se sienten los propios editores cuando son conscientes de que determinadas políticas editoriales o retrasos perjudican a los autores, y si las estructuras actuales favorecen realmente relaciones más humanas entre todos los actores implicados. Esta mirada invita a reconsiderar los desequilibrios de poder existentes en la publicación académica, donde los autores suelen ocupar la posición más vulnerable mientras dependen de decisiones tomadas por editores, revisores y editoriales. Incorporar la dimensión emocional permitiría construir procesos editoriales más empáticos, transparentes y respetuosos, sin renunciar al rigor científico.

Otro de los aspectos destacados del artículo es la relación entre las emociones y las profundas transformaciones que atraviesa la comunicación científica. Irfanullah aborda cuestiones como el crecimiento descontrolado del número de publicaciones, la presión constante por publicar, la dependencia de indicadores bibliométricos y los problemas de integridad científica derivados de este modelo. También analiza el papel emergente de los servidores de preprints y de la inteligencia artificial aplicada a la revisión científica, preguntándose si estos cambios acabarán modificando o incluso sustituyendo el modelo tradicional de revista académica, vigente desde 1665. Frente a estas incertidumbres, el autor invita a reflexionar no solo sobre las implicaciones técnicas o económicas de estas innovaciones, sino también sobre las emociones que generan entre quienes participan en el sistema científico.

En la parte final, el artículo plantea una llamada a humanizar la publicación académica. Para Irfanullah, las decisiones que toman investigadores, revisores, editores y editoriales no responden únicamente a criterios racionales, sino que están profundamente influidas por emociones como la confianza, el miedo, la ilusión o el cansancio. Reconocer explícitamente esta dimensión permitiría diseñar políticas editoriales más sensibles al bienestar de la comunidad investigadora y favorecer una cultura científica menos dominada por la presión de publicar y más orientada a la colaboración, la calidad y el impacto social del conocimiento. La comunicación científica, concluye el autor, no puede entenderse únicamente como un proceso técnico; es, ante todo, una actividad profundamente humana.

La inteligencia artificial ya forma parte de la revisión por pares: es hora de que las políticas editoriales lo reconozcan

Vicario, E. (2026). Guest Post — Now is the Time for AI in Peer Review, and Publishing Policies Need to Recognize This. The Scholarly Kitchen, 30 de junio de 2026.

Se plantea que el debate sobre la utilización de la inteligencia artificial en la revisión por pares (peer review) ha dejado de ser una cuestión de futuro para convertirse en una realidad que las políticas editoriales deben afrontar de manera explícita. La autora sostiene que la IA ya está profundamente integrada en numerosos procesos de la comunicación científica —desde la detección de plagio y la identificación de manipulaciones de imágenes hasta el descubrimiento de patrones asociados a las «paper mills» o fábricas de artículos fraudulentos—, por lo que resulta incoherente prohibir o restringir su utilización precisamente en una de las fases más importantes del proceso editorial: la evaluación por pares.

Vicario parte de un diagnóstico ampliamente compartido en la comunidad científica: la inteligencia artificial ha acelerado tanto las posibilidades legítimas de producción científica como las formas industrializadas de fraude académico. Las investigaciones recientes sobre redes organizadas de generación masiva de artículos falsos muestran que las herramientas basadas en IA están siendo utilizadas para fabricar investigaciones fraudulentas a gran escala. Sin embargo, la autora defiende que la respuesta no puede consistir en excluir la IA del ecosistema editorial, sino en emplearla también para combatir esas mismas amenazas. En su opinión, si la inteligencia artificial forma parte del problema, necesariamente debe formar parte de la solución.

El texto subraya que los grandes editores científicos ya utilizan sistemas inteligentes para examinar los manuscritos antes de que lleguen a los revisores humanos. Estas herramientas permiten detectar manipulaciones de imágenes, similitudes textuales, anomalías en las citas, patrones característicos de artículos producidos por «paper mills» y otros indicios de fraude científico. Plataformas como el STM Integrity Hub representan, según la autora, un ejemplo de cómo la IA se ha convertido en una infraestructura habitual para preservar la integridad de la literatura científica. Desde esta perspectiva, la pregunta ya no es si la inteligencia artificial tiene cabida en la publicación científica, sino cómo debe gobernarse su utilización de forma ética y transparente.
El núcleo del artículo se centra en la revisión por pares, un ámbito donde persisten fuertes restricciones debido a preocupaciones relacionadas con la confidencialidad de los manuscritos inéditos, la privacidad de los datos y el riesgo de delegar en algoritmos decisiones que requieren juicio científico. Vicario reconoce que estas preocupaciones son legítimas, pero considera que las políticas actuales han quedado desfasadas respecto a la práctica real. En su experiencia, numerosos revisores ya emplean discretamente herramientas de IA para resumir manuscritos, comprobar análisis estadísticos, revisar código, mejorar la redacción o identificar posibles inconsistencias. La ausencia de normas claras no elimina este uso; simplemente lo convierte en una práctica invisible y no regulada.

La autora también sitúa este debate en el contexto de la creciente crisis del sistema de revisión por pares. El número de manuscritos sometidos a evaluación continúa aumentando mientras disminuye la disponibilidad de revisores expertos, que soportan una carga de trabajo cada vez mayor. Diversos estudios citados muestran un incremento de la fatiga de los revisores y una distribución desigual del esfuerzo de evaluación. En este escenario, la IA podría actuar como una herramienta de apoyo que permitiera automatizar tareas rutinarias y liberar tiempo para aquellas actividades donde el criterio humano resulta insustituible: valorar la originalidad de una investigación, la solidez metodológica, la relevancia de los resultados o la contribución al conocimiento científico.

Uno de los aspectos más relevantes del artículo es su propuesta de sustituir el actual debate dicotómico —permitir o prohibir la IA— por un marco de gobernanza basado en principios comunes para toda la comunidad científica. Vicario propone cinco pilares fundamentales. El primero es la transparencia, de modo que los revisores declaren cuándo y cómo han utilizado herramientas de inteligencia artificial sin temor a ser penalizados. El segundo es la responsabilidad, dejando claro que el juicio científico corresponde siempre al revisor humano, independientemente del apoyo tecnológico recibido. El tercero consiste en establecer límites claros sobre las tareas que la IA puede desempeñar —como resumir textos, mejorar el lenguaje o analizar estructuras— y aquellas que deben permanecer exclusivamente bajo criterio humano, como evaluar la novedad científica o la calidad metodológica. A ello añade la necesidad de garantizar la confidencialidad mediante herramientas que respeten estándares adecuados de protección de datos y, finalmente, implantar mecanismos de supervisión editorial que hagan visible, auditable y controlable el uso de la IA durante todo el proceso de evaluación.

El artículo concede un papel especialmente relevante al Committee on Publication Ethics (COPE), organización que durante años ha establecido las principales referencias éticas para la publicación científica. Aunque COPE ya ha comenzado a elaborar documentos de discusión y posicionamientos sobre inteligencia artificial, Vicario considera que todavía falta una guía práctica específica dirigida a revisores y editores que unifique criterios y reduzca la actual fragmentación de políticas entre editoriales, universidades y organismos financiadores. La autora también menciona las discusiones mantenidas durante la edición de 2026 de la World Conference on Research Integrity como una oportunidad para construir un consenso internacional sobre estos principios.

En conjunto, el texto constituye una defensa de un uso responsable, regulado y transparente de la inteligencia artificial en la revisión por pares. No propone sustituir el juicio de los expertos por algoritmos, sino integrar estas herramientas como apoyo dentro de un sistema donde la responsabilidad última siga correspondiendo a los revisores humanos. Para la autora, ignorar que la IA ya está presente en la práctica cotidiana solo incrementará la distancia entre las normas oficiales y el funcionamiento real de la comunicación científica. El verdadero desafío no consiste en decidir si la inteligencia artificial debe participar en la revisión por pares, sino en establecer un marco común que garantice confianza, transparencia e integridad en su utilización.

Descubren una red de 80.000 citas fraudulentas ocultas en los metadatos de publicaciones científicas

Besançon, Lonni; Cabanac, Guillaume; Labbé, Cyril; Magazinov, Alexander; di Scala, Jules; Tkaczyk, Dominika; Weber-Boer, Kathryn (2025). Detection of metadata manipulations: Finding sneaked references in the scholarly literature. Preprint enviado a Journal of the Association for Information Science and Technology (JASIST). arXiv:2501.03771. Disponible en: arXiv – Detection of metadata manipulations

La investigación demuestra que la infraestructura global de comunicación científica presenta una vulnerabilidad crítica: es posible manipular artificialmente el impacto académico insertando citas inexistentes en los metadatos de un artículo sin alterar el documento publicado, comprometiendo así la fiabilidad de los sistemas internacionales de evaluación basados en citación. Los resultados son extraordinariamente reveladores. El análisis de 4.077 documentos identificó más de 80.000 referencias fraudulentas insertadas artificialmente, distribuidas en 2.787 artículos manipulados.

Este trabajo constituye una de las investigaciones más inquietantes y relevantes de los últimos años en el ámbito de la integridad científica, al revelar una nueva forma de manipulación bibliométrica basada en la inserción de lo que los autores denominan “sneaked references” o referencias infiltradas. Se trata de citas que no aparecen en el texto visible ni en la bibliografía real de un artículo científico, pero que sí son introducidas artificialmente en los metadatos depositados en infraestructuras académicas como Crossref, permitiendo que sistemas bibliométricos las contabilicen como citas legítimas. El hallazgo cuestiona directamente la fiabilidad de numerosos indicadores de impacto científico utilizados globalmente, desde el índice h hasta métricas institucionales empleadas en rankings universitarios, financiación de proyectos o evaluación académica.

El estudio se centra inicialmente en el caso del International Journal of Innovative Science and Research Technology (IJISRT), una revista en la que los investigadores detectaron un patrón sistemático de inserción fraudulenta de referencias adicionales durante el registro de metadatos. Estas referencias eran invisibles para cualquier lector que consultara el PDF del artículo, pero aparecían en los registros enviados a Crossref, generando citas falsas que beneficiaban principalmente a artículos publicados en la misma revista. Este mecanismo constituye una variante sofisticada del conocido fenómeno del citation gaming, es decir, estrategias destinadas a inflar artificialmente el número de citas recibidas por revistas o artículos con el fin de mejorar indicadores de impacto y reputación científica.

Para detectar esta anomalía, los autores diseñan dos metodologías automatizadas innovadoras. La primera consiste en comparar la lista de referencias depositadas en los metadatos de Crossref con las referencias extraídas automáticamente del PDF mediante herramientas como GROBID, especializada en extracción estructurada de documentos académicos. La segunda técnica compara directamente el texto completo extraído del PDF con las cadenas textuales almacenadas en los registros de referencias de Crossref, utilizando algoritmos de similitud textual como la distancia de Levenshtein implementada en bibliotecas como RapidFuzz. Ambas metodologías buscan determinar si una referencia registrada en el sistema realmente aparece en el documento original o si ha sido añadida clandestinamente en la fase de indexación.

Los resultados son extraordinariamente reveladores. El análisis de 4.077 documentos identificó más de 80.000 referencias fraudulentas insertadas artificialmente, distribuidas en 2.787 artículos manipulados. Algunos artículos beneficiados llegaron a recibir cientos de citas indebidas, alcanzando cifras completamente anómalas en plataformas como Digital Science Dimensions o OpenAlex OpenAlex. El caso más extremo documentado en el artículo corresponde a un DOI que aparecía acreditado con aproximadamente 1.700 citas en Dimensions y 1.800 en OpenAlex, aunque una parte sustancial de esas citas provenían exclusivamente de referencias falsas introducidas en metadatos y nunca presentes en publicaciones reales. Esto demuestra que la manipulación logró atravesar múltiples sistemas de agregación científica y afectar directamente bases de datos utilizadas mundialmente para evaluar investigación.

Uno de los aspectos más preocupantes del estudio es que esta manipulación ocurre en una capa invisible para la mayoría de investigadores, bibliotecarios y evaluadores científicos. Tradicionalmente, las malas prácticas en citación implicaban añadir citas irrelevantes dentro del propio artículo, mediante coerción editorial o acuerdos entre autores. Sin embargo, el mecanismo identificado aquí opera después de la publicación, en el nivel de los metadatos depositados en infraestructuras centrales del ecosistema científico. Esto significa que incluso artículos perfectamente legítimos pueden convertirse, sin conocimiento de sus autores, en vehículos para generar citas artificiales que alteren métricas globales. El problema deja de ser un asunto editorial aislado para convertirse en una vulnerabilidad sistémica de la infraestructura internacional de comunicación científica.

Los investigadores intentaron además escalar el análisis a gran escala examinando más de 47 millones de documentos científicos procesados por Dimensions desde el año 2000, con el objetivo de detectar patrones similares en toda la literatura académica mundial. Aunque el procesamiento masivo presenta limitaciones técnicas, especialmente en la extracción automática de referencias desde archivos PDF, el estudio demuestra que existen mecanismos potenciales para auditar grandes volúmenes de literatura científica y detectar patrones anómalos de citación. Los autores también exploraron heurísticas basadas en referencias duplicadas dentro de registros Crossref como posible señal temprana de manipulación sistemática.

El artículo plantea profundas implicaciones para todo el ecosistema de comunicación científica. Si plataformas como Crossref, OpenAlex, Scopus o sistemas derivados utilizan metadatos potencialmente manipulados, entonces gran parte de los indicadores bibliométricos contemporáneos podrían estar sujetos a distorsiones invisibles. Los autores reclaman mecanismos de auditoría más rigurosos por parte de infraestructuras académicas, validaciones automáticas entre texto completo y metadatos depositados, así como mayor vigilancia sobre prácticas editoriales sospechosas. Más allá del caso específico investigado, el estudio abre una discusión fundamental sobre la fragilidad de los sistemas de evaluación científica contemporáneos y sobre cómo la obsesión por las métricas cuantitativas puede incentivar nuevas formas de fraude cada vez más sofisticadas y difíciles de detectar.

OpenEval: la inteligencia artificial entra en la revisión científica y redefine el futuro del peer review

OpenEval Project. “OpenEval Project: Transparent LLM-Enabled Peer Review Assessment”. Plataforma de investigación abierta sobre evaluación científica asistida por inteligencia artificial, 2026. Disponible en: OpenEval Project

OpenEval propone una revolución en la evaluación científica al sustituir la revisión global del artículo por un análisis automatizado de cada afirmación individual contenida en el paper, demostrando que la inteligencia artificial puede participar activamente en la validación del conocimiento científico y cuestionando el modelo tradicional de peer review que ha dominado la ciencia durante siglos

El proyecto OpenEval representa una de las iniciativas más ambiciosas actualmente en desarrollo para replantear uno de los pilares centrales de la ciencia moderna: el sistema de peer review o revisión por pares. Durante más de tres siglos, la validación de artículos científicos ha dependido casi exclusivamente del juicio humano de especialistas encargados de evaluar la calidad metodológica, la consistencia argumentativa y la solidez empírica de un trabajo antes de su publicación. Sin embargo, el crecimiento exponencial de la producción científica mundial —acentuado todavía más por el uso creciente de herramientas de inteligencia artificial generativa— está comenzando a desbordar la capacidad del sistema tradicional. OpenEval surge precisamente como respuesta a este problema estructural: desarrollar un sistema transparente, sistemático y automatizado capaz de analizar artículos científicos mediante modelos de lenguaje avanzados y comparar sus evaluaciones con revisiones realizadas por expertos humanos.

La innovación central del proyecto consiste en cambiar radicalmente la unidad básica de evaluación científica. Tradicionalmente, un artículo se revisa como un documento global donde los revisores formulan observaciones generales sobre hipótesis, metodología, resultados o conclusiones. OpenEval propone descomponer cada paper en unidades mínimas verificables: afirmaciones concretas o claims individuales. Cada afirmación es extraída automáticamente del texto mediante procesamiento lingüístico avanzado y posteriormente clasificada según el tipo de evidencia que la respalda. El sistema distingue, por ejemplo, afirmaciones sustentadas en datos experimentales directos, referencias bibliográficas previas, inferencias estadísticas o interpretaciones especulativas. Esta descomposición granular permite que la inteligencia artificial no evalúe un artículo como un bloque narrativo indivisible, sino como una red estructurada de afirmaciones susceptibles de verificación independiente. La idea responde a una intuición fundamental: la ciencia debería ser legible no solo para seres humanos, sino también para máquinas capaces de interpretar formalmente la arquitectura lógica del conocimiento científico.

Para poner a prueba esta metodología, los desarrolladores construyeron uno de los mayores corpus experimentales de revisión científica automatizada disponibles actualmente. El sistema procesó 16.089 artículos científicos procedentes de la revista de acceso abierto eLife, identificando 1.964.856 afirmaciones individuales distribuidas en casi 300.000 unidades evaluables. Paralelamente se recopilaron más de 29.000 revisiones generadas por OpenEval y cerca de 29.205 revisiones realizadas previamente por revisores humanos, permitiendo comparar ambos sistemas de evaluación. Uno de los hallazgos más significativos fue comprobar que la inteligencia artificial identificaba un mayor número de afirmaciones relevantes dentro de cada artículo que los revisores humanos. Mientras los expertos humanos tendían a concentrarse en un conjunto relativamente limitado de resultados principales, OpenEval lograba cubrir un espectro mucho más amplio del contenido científico, detectando matices argumentativos que frecuentemente pasan desapercibidos durante el proceso convencional de peer review.

El proyecto revela además una cuestión especialmente relevante: los sistemas automatizados no solo son capaces de reproducir evaluaciones humanas, sino que en ciertos aspectos pueden mostrar comportamientos analíticos diferentes e incluso más rigurosos. Los datos comparativos muestran que OpenEval tiende a ser más conservador frente a afirmaciones basadas en especulación o inferencias indirectas, mientras que otorga mayor confianza a resultados respaldados por datos experimentales o citas verificables. En varios casos, la inteligencia artificial clasificó determinadas afirmaciones como inciertas o insuficientemente sustentadas allí donde revisores humanos habían emitido valoraciones más favorables. Esto sugiere que la automatización no necesariamente implica replicar sesgos humanos existentes, sino introducir nuevas formas de escrutinio científico potencialmente más sistemáticas y consistentes. La revisión científica comienza así a transformarse desde una práctica artesanal basada en juicio experto hacia un proceso parcialmente algorítmico basado en análisis estructurado del conocimiento.

Otro elemento decisivo del proyecto es su apuesta por la transparencia. A diferencia del sistema tradicional de revisión académica, donde los informes de los evaluadores suelen permanecer ocultos o limitados al editor y a los autores, OpenEval permite explorar públicamente los resultados a través de una interfaz interactiva. Los usuarios pueden examinar manuscritos concretos, visualizar cada afirmación extraída automáticamente y comparar directamente las evaluaciones emitidas por inteligencia artificial frente a revisores humanos. Esta apertura convierte el proceso de evaluación científica en un objeto de investigación en sí mismo, permitiendo estudiar empíricamente cómo se toman decisiones editoriales, qué tipo de afirmaciones generan mayor controversia y en qué áreas coinciden o divergen humanos y algoritmos. La revisión por pares deja de ser una práctica opaca para convertirse en un sistema observable y cuantificable.

Desde una perspectiva más amplia, OpenEval se inscribe en un cambio profundo dentro del ecosistema de comunicación científica contemporánea. Durante siglos, el artículo académico fue simultáneamente unidad de conocimiento, unidad narrativa y unidad de evaluación. Proyectos como OpenEval cuestionan esa estructura histórica al sugerir que el verdadero objeto de validación científica no debería ser el artículo como documento cerrado, sino cada afirmación verificable que lo compone. Esta lógica conecta directamente con propuestas emergentes que defienden una ciencia machine-readable, es decir, una producción científica estructurada de tal forma que sistemas artificiales puedan navegar, contrastar y evaluar automáticamente el conocimiento publicado. Si esta visión prospera, el peer review del futuro podría dejar de consistir en enviar manuscritos completos a dos o tres especialistas y pasar a funcionar como un sistema híbrido donde algoritmos analizan miles de afirmaciones individuales antes de que expertos humanos intervengan en la interpretación final.

La consecuencia filosófica de este proyecto resulta especialmente profunda. Durante siglos se asumió que evaluar ciencia era una capacidad exclusivamente humana basada en experiencia disciplinar, intuición metodológica y juicio crítico experto. OpenEval pone en cuestión esa convicción al demostrar que sistemas algorítmicos pueden participar activamente en la validación del conocimiento científico a gran escala. Esto obliga a replantear no solo la infraestructura editorial académica, sino conceptos mucho más amplios como autoridad científica, legitimidad epistemológica y confianza en los mecanismos que históricamente han definido qué conocimiento merece incorporarse al patrimonio intelectual colectivo. La inteligencia artificial deja así de ser simplemente una herramienta auxiliar para convertirse en un nuevo actor dentro del propio proceso de construcción y validación de la ciencia contemporánea.

¿Es el artículo científico la próxima víctima de la inteligencia artificial? La transformación radical de la comunicación científica

Requarth, Tim. “The next unit of science: Is the scientific paper due to be replaced?” En The Transmitter, sección From Bench to Bot, 11 de mayo de 2026. Publicado en el medio especializado The Transmitter: Neuroscience News and Perspectives

El artículo de plantea una cuestión profundamente disruptiva para el ecosistema académico contemporáneo: si el tradicional artículo científico —la unidad fundamental de comunicación del conocimiento desde hace más de tres siglos— está entrando en una fase terminal debido al avance de la inteligencia artificial.

La reflexión parte de una perspectiva histórica, recordando que antes de la aparición de las revistas científicas en el siglo XVII, los investigadores publicaban extensos tratados, como hizo Johannes Kepler en Astronomia Nova o Isaac Newton en su célebre Principia. La aparición de publicaciones periódicas, como Philosophical Transactions de la Royal Society, permitió acelerar el intercambio de resultados científicos, fragmentando el conocimiento en unidades más pequeñas y dinámicas: el paper. Durante siglos, este modelo fue extraordinariamente exitoso y permitió avances acumulativos que definieron la ciencia moderna.

Sin embargo, según el autor, ese modelo ha comenzado a mostrar signos evidentes de agotamiento, y la irrupción de la inteligencia artificial no hace sino acelerar una crisis que ya existía. Herramientas basadas en modelos de lenguaje permiten hoy producir artículos académicos a una velocidad sin precedentes, hasta el punto de saturar completamente el sistema de revisión por pares. Se menciona el caso de investigadores que generan versiones casi idénticas de estudios reutilizando bases de datos públicas con ligeras modificaciones textuales para evitar sistemas antiplagio, así como el desarrollo de sistemas automatizados como Paper Orchestra, presentado por Google, capaz de transformar notas de laboratorio en un manuscrito científico completo, con figuras y referencias verificadas, en apenas cuarenta minutos. Esta automatización masiva amenaza directamente uno de los pilares del sistema científico: la evaluación rigurosa realizada por expertos humanos, cuyos tiempos y capacidades están siendo desbordados.

Frente a esta situación, diversos científicos comienzan a proponer un replanteamiento radical de la propia estructura de la publicación académica. El artículo analiza especialmente el proyecto OpenEval, desarrollado por investigadores como Lior Pachter y colaboradores, que propone descomponer cada paper en unidades verificables: afirmaciones concretas, evidencias que las sustentan y evaluaciones automatizadas de la consistencia de dichas evidencias. Aplicado a cerca de 16.000 artículos de la revista eLife, el sistema logró identificar casi dos millones de afirmaciones individuales y mostró una capacidad de evaluación comparable a revisores humanos, aunque con una cobertura significativamente superior. La idea central consiste en separar dos funciones que actualmente están fusionadas en el paper: por un lado, la comunicación estructurada de resultados; por otro, la narrativa interpretativa que contextualiza esos hallazgos.

El texto presta especial atención a cómo esta transformación podría beneficiar disciplinas particularmente fragmentadas como la neurociencia. En campos donde conviven investigaciones sobre genética molecular, sinapsis neuronales, comportamiento, neuroimagen o psicología experimental, gran parte del conocimiento permanece aislado en compartimentos estancos porque ningún investigador puede procesar el volumen total de publicaciones existentes. Sistemas de conocimiento estructurado y legible por máquinas permitirían conectar automáticamente descubrimientos relacionados que actualmente permanecen invisibles entre sí. El autor cita ejemplos concretos en los que investigaciones independientes sobre mecanismos sinápticos similares no llegaron a citarse mutuamente pese a sus implicaciones complementarias, un problema que podría resolverse mediante bases de conocimiento interconectadas alimentadas por inteligencia artificial.

Más radical todavía es la propuesta formulada por la física italiana Francesca Colaiori, quien imagina una futura red adaptativa del conocimiento donde el paper desaparece por completo como unidad principal y es sustituido por “objetos de conocimiento”: hipótesis, conjuntos de datos, métodos, preguntas abiertas o resultados experimentales individuales que se conectan dinámicamente entre sí, de manera similar a una gigantesca enciclopedia científica colaborativa. En este escenario, publicar dejaría de consistir en redactar un artículo cerrado y pasaría a parecerse más a editar una red viva de conocimiento colectivo. Paralelamente, revistas como NEJM AI ya experimentan con sistemas híbridos en los que revisores humanos trabajan junto a modelos de lenguaje que generan informes automatizados, reduciendo el tiempo entre envío y aceptación a apenas siete días.

No obstante, Requarth introduce una advertencia crucial frente a este entusiasmo tecnológico. El acto mismo de escribir un artículo científico no es únicamente un mecanismo administrativo de comunicación, sino una parte fundamental del proceso intelectual del investigador. La dificultad de redactar obliga a clarificar ideas, detectar incoherencias metodológicas, reorganizar argumentos y descubrir debilidades conceptuales que a menudo no se perciben durante la experimentación. Automatizar completamente la escritura científica podría eliminar precisamente ese proceso cognitivo donde muchas veces surge una comprensión más profunda del propio descubrimiento. En otras palabras, aunque el artículo científico sea un formato imperfecto como contenedor de datos, podría seguir desempeñando una función intelectual esencial que no resulta fácilmente reemplazable por sistemas automatizados.

El ensayo sitúa a la ciencia en un momento histórico comparable a la transición que siglos atrás llevó del tratado erudito al artículo breve de revista. Así como aquel cambio revolucionó la velocidad y naturaleza del progreso científico, la inteligencia artificial podría estar impulsando una nueva mutación estructural en la forma en que la humanidad organiza, valida y comparte el conocimiento. El paper tradicional, argumenta el autor, ya está siendo superado de facto por un ecosistema caótico formado por archivos suplementarios interminables, repositorios de datos, código sin documentar y bases distribuidas en múltiples plataformas. La pregunta ya no sería si el artículo científico desaparecerá, sino qué nueva arquitectura sustituirá ese modelo y cómo preservar, en medio de esa transición tecnológica, la dimensión profundamente humana del pensamiento científico. El futuro de la investigación, concluye Requarth, dependerá de encontrar un equilibrio entre la eficiencia algorítmica y la reflexión intelectual que durante siglos ha definido el acto mismo de hacer ciencia.

Por qué el impacto científico es más que una simple cuestión de números

Banino, Yehonatan. “Guest Post — Beyond the Prestige: Why Scientific Impact is More Than a Numbers Game”. En The Scholarly Kitchen, 1 de julio de 2026. Publicado por la Society for Scholarly Publishing.

El autor plantea una crítica profunda al modo en que tradicionalmente se evalúa el impacto de la investigación científica. Durante décadas, la academia ha utilizado métricas cuantitativas simples, especialmente el número bruto de citas recibidas por un artículo o el prestigio de la revista donde se publica, como indicadores casi absolutos del valor de una investigación. Sin embargo, Banino argumenta que esta visión resulta limitada e incluso engañosa, ya que reduce la complejidad del conocimiento científico a cifras descontextualizadas que no reflejan adecuadamente la verdadera influencia de un trabajo académico.

Uno de los argumentos centrales del texto es que las citas, por sí solas, carecen de significado cuando no se interpretan dentro de un contexto comparativo adecuado. Un artículo que ha recibido veinticinco citas puede parecer exitoso, pero ese número solo adquiere sentido cuando se analiza en relación con otros trabajos publicados en la misma disciplina, en el mismo periodo temporal y dentro de comunidades científicas similares. El autor utiliza una analogía pedagógica: dos estudiantes pueden obtener exactamente la misma nota en un examen, pero el valor real de esa calificación cambia radicalmente dependiendo del promedio general del grupo. De igual manera, una cifra aislada en ciencia no representa necesariamente impacto o calidad.

Banino propone superar esta visión tradicional mediante herramientas de evaluación más sofisticadas, centradas en métricas relativas en lugar de métricas absolutas. En este contexto presenta el llamado YCR-index, un sistema que busca medir la influencia científica tomando en cuenta factores comparativos como el área temática, el año de publicación y el comportamiento general de trabajos equivalentes. Según esta perspectiva, el verdadero valor científico no debe medirse simplemente contando citas, sino analizando cómo una investigación destaca dentro de su ecosistema académico específico. La propuesta intenta corregir lo que denomina la “trampa de la citación bruta”, es decir, la falsa idea de que más citas equivalen automáticamente a mayor relevancia científica.

El artículo también se inserta dentro de un debate cada vez más amplio en la comunicación académica contemporánea sobre las limitaciones de indicadores tradicionales como el Impact Factor, el h-index y otros sistemas bibliométricos. Diversos sectores de la comunidad científica han advertido que estas métricas han terminado incentivando prácticas problemáticas: presión excesiva por publicar en revistas prestigiosas, priorización del volumen sobre la calidad, estrategias editoriales diseñadas para aumentar artificialmente las citas y desigualdades estructurales que perjudican especialmente a investigadores jóvenes o pertenecientes a regiones periféricas del sistema científico global.

En el fondo, la reflexión de Banino invita a reconsiderar qué significa realmente “impacto científico”. La ciencia, sostiene implícitamente el autor, no puede evaluarse únicamente mediante indicadores cuantitativos porque su verdadero valor reside también en factores más difíciles de medir: la originalidad de una idea, su capacidad de transformar paradigmas, su utilidad social, su influencia a largo plazo y su contribución al avance colectivo del conocimiento. En una época marcada por debates sobre ciencia abierta, inteligencia artificial, transparencia editorial y nuevas formas de evaluación académica, este texto representa una defensa de modelos más justos, contextualizados y humanizados para valorar la producción científica.

El artículo constituye una llamada a abandonar la dependencia excesiva de los indicadores numéricos y avanzar hacia una cultura científica donde el valor de la investigación no quede determinado exclusivamente por el prestigio editorial o por estadísticas de citación, sino por la auténtica contribución intelectual y social que cada trabajo aporta al ecosistema global del conocimiento.

Carta Europea del Investigador

European Commission: Directorate-General for Research and Innovation, Charte européenne du chercheur – Renforcer l’attrait des carrières dans les secteurs public et privé, Publications Office of the European Union, 2025, https://data.europa.eu/doi/10.2777/6000481

Texto completo en español

La Carta Europea del Investigador es una directriz de la Unión Europea que establece 40 principios generales sobre los derechos, responsabilidades y obligaciones de los investigadores, instituciones y financiadores. Su objetivo principal es crear un mercado laboral abierto, transparente y justo para el personal científico en toda Europa

La Carta Europea del Investigador fue adoptada por el Consejo el 18 de diciembre de 2023, como anexo 2 de la Recomendación C/2023/1640 del Consejo, que define un marco europeo para atraer y retener a investigadores, así como a innovadores y emprendedores con talento en Europa. Esta nueva carta sustituye a la antigua Carta y Código europeos (de 2005) y responde a una evolución significativa de la política de investigación e innovación.

La carta establece un conjunto de principios que deben permitir el desarrollo de carreras atractivas en la investigación, con el fin de apoyar la excelencia en la investigación y la innovación en Europa. La Comisión Europea la considera un motor para reforzar el Espacio Europeo de Investigación.

La presente publicación constituye una referencia esencial para el proceso de concesión del premio “Human Resources Excellence in Research”. Sus objetivos son sensibilizar, facilitar la difusión y ofrecer apoyo a investigadores, empleadores, organismos financiadores y responsables políticos en todas las disciplinas y

Clarivate publica el Journal Citation Reports 2026

Research Information. “Clarivate Releases Journal Citation Reports 2026”. Junio de 2026. Basado en el anuncio oficial de Clarivate Analytics

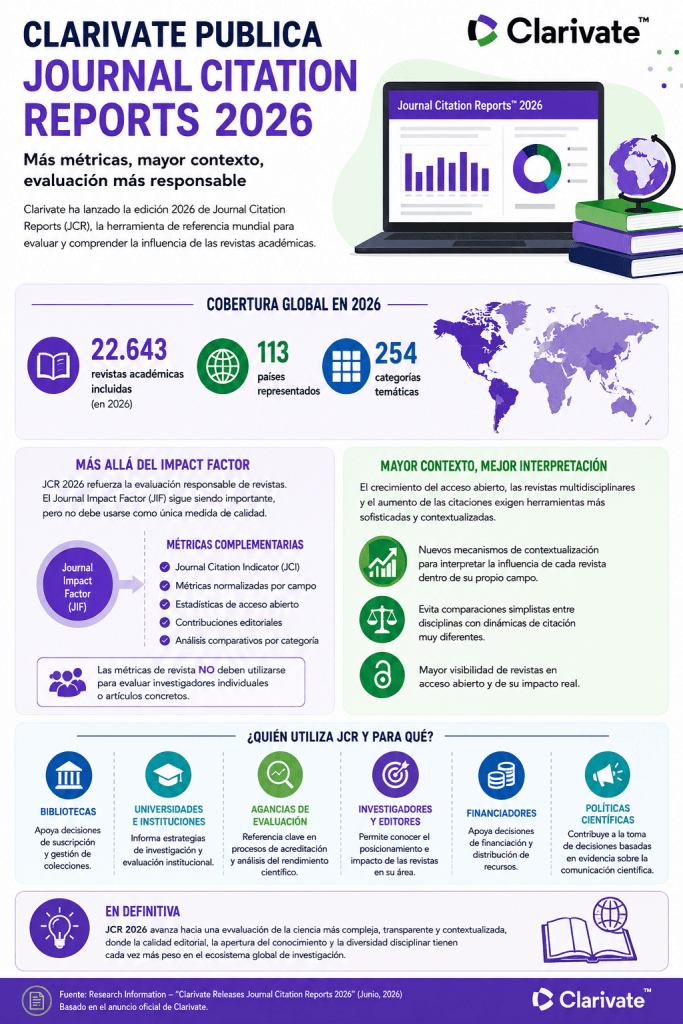
Clarivate ha presentado la edición 2026 de su influyente informe Journal Citation Reports (JCR), una de las herramientas bibliométricas más utilizadas en el mundo académico para evaluar el impacto y la influencia de las revistas científicas. Esta nueva edición refuerza la apuesta por una evaluación más responsable, contextualizada y multidimensional de las publicaciones científicas, en un momento en que la comunidad investigadora cuestiona cada vez más la dependencia exclusiva del tradicional Impact Factor.

El informe, integrado en la plataforma Journal Citation Reports de Clarivate, amplía significativamente su cobertura global. La edición 2026 incorpora 22.643 revistas académicas procedentes de 113 países y distribuidas en 254 categorías temáticas, consolidando a JCR como uno de los repertorios de referencia para universidades, bibliotecas, agencias de evaluación e instituciones científicas. La metodología mantiene un enfoque estable que permite comparaciones longitudinales entre disciplinas y seguimiento de tendencias de publicación a escala internacional.

Una de las principales líneas de evolución del JCR 2026 es el énfasis en la evaluación responsable de revistas, reduciendo la centralidad histórica del Journal Impact Factor (JIF) como único indicador de calidad. Clarivate insiste en que las métricas de revista no deben utilizarse para evaluar directamente investigadores individuales o artículos concretos. En este sentido, la plataforma complementa el JIF con indicadores adicionales como el Journal Citation Indicator (JCI), métricas normalizadas por campo disciplinar, estadísticas de acceso abierto, datos sobre contribuciones editoriales y análisis comparativos por categoría científica.

El lanzamiento refleja también cambios más amplios en el ecosistema de la comunicación científica. Según Clarivate, el crecimiento de modelos de publicación en acceso abierto, la expansión de revistas multidisciplinares y el aumento global del volumen de citación exigen herramientas analíticas más sofisticadas. Por ello, JCR 2026 incorpora nuevos mecanismos de contextualización que permiten interpretar mejor la influencia de una revista dentro de su propio campo, evitando comparaciones simplistas entre disciplinas con dinámicas de citación muy diferentes.

Para bibliotecarios, gestores de colecciones y responsables universitarios, esta actualización resulta especialmente relevante porque influye directamente en políticas de suscripción, estrategias de adquisición, decisiones de financiación y evaluación institucional de la investigación. El sistema sigue funcionando como referencia central en numerosos procesos de acreditación académica y análisis del rendimiento científico internacional, aunque en paralelo continúa creciendo el debate sobre alternativas más abiertas y menos dependientes de métricas cuantitativas tradicionales.

El inquietante aumento de artículos científicos en la era de la inteligencia artificial

Dahl, Josh. “Guest Post — Is Growth Always Good News? 2026 Article Submission Surges”. The Scholarly Kitchen, 13 de mayo de 2026. Disponible en: The Scholarly Kitchen

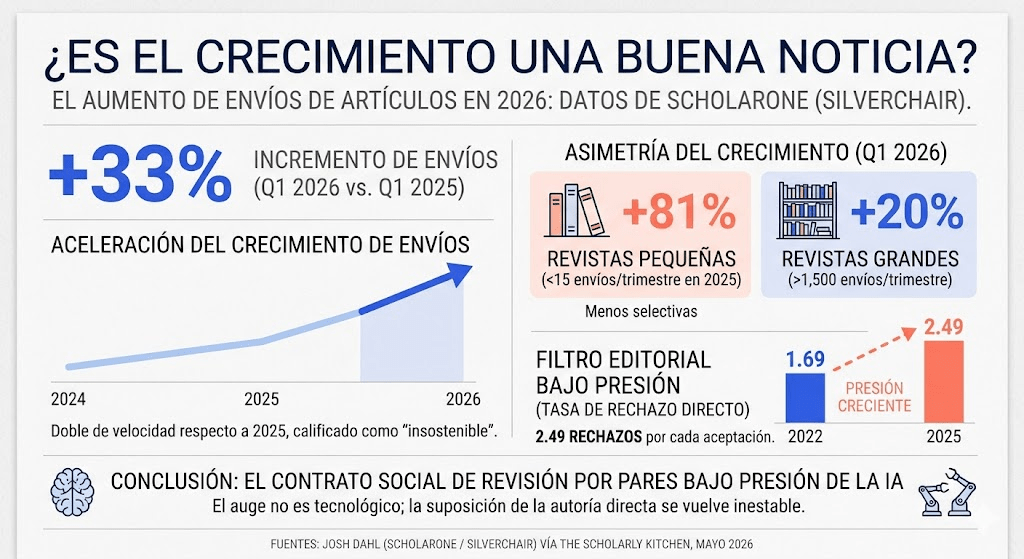
Una cuestión que está generando creciente preocupación en la comunicación científica: el espectacular aumento de manuscritos enviados a las revistas cientificas durante 2026 y el papel que la inteligencia artificial podría estar desempeñando en este fenómeno. Basándose en datos de la plataforma ScholarOne Manuscripts, una de las mayores infraestructuras mundiales de gestión editorial, Dahl revela que durante el primer trimestre de 2026 las revistas recibieron un 33 % más de artículos que en el mismo período del año anterior. Lo más llamativo no es únicamente la magnitud del crecimiento, sino su aceleración: mientras que en 2025 el incremento había sido del 17 %, en 2026 prácticamente se duplicó. Para muchos editores y responsables de revistas, esta tendencia empieza a parecer insostenible.

El autor evita interpretar automáticamente estos datos como una señal positiva. A primera vista, podría pensarse que estamos asistiendo a una expansión saludable de la actividad investigadora mundial. Más investigadores, más proyectos y más artículos podrían indicar un fortalecimiento del sistema científico. Sin embargo, Dahl advierte que los datos permiten otra lectura menos optimista. La proliferación de herramientas de inteligencia artificial generativa ha reducido drásticamente el esfuerzo necesario para producir textos académicos, lo que podría estar favoreciendo una avalancha de manuscritos elaborados con ayuda de sistemas automatizados. El problema no sería únicamente la cantidad de artículos, sino la posible disminución de la calidad media y el aumento de trabajos producidos con escasa supervisión intelectual.

Uno de los hallazgos más reveladores del análisis es que el crecimiento no se distribuye de forma homogénea entre las revistas. Las publicaciones más pequeñas y menos selectivas son las que están experimentando los mayores aumentos. Las revistas que recibían menos de quince artículos por trimestre registraron incrementos cercanos al 81 %, mientras que las grandes publicaciones, con más de 1.500 envíos trimestrales, crecieron aproximadamente un 20 %. Este patrón no demuestra por sí mismo que exista una invasión de manuscritos generados por IA, pero sí resulta compatible con esa hipótesis. Los autores que buscan publicar rápidamente podrían estar orientando sus envíos hacia revistas con menos recursos editoriales y menores barreras de entrada, precisamente aquellas que tienen más dificultades para detectar problemas metodológicos, éticos o de autoría.

El artículo destaca asimismo que los mecanismos de filtrado editorial ya están reaccionando a esta presión. Entre 2022 y 2025, los rechazos iniciales sin revisión por pares (desk rejections) aumentaron un 72 %, mientras que el número total de decisiones editoriales creció un 43 %. En otras palabras, los editores están rechazando proporcionalmente más trabajos antes de enviarlos a revisión externa. Esta tendencia sugiere que las revistas están absorbiendo una creciente cantidad de manuscritos considerados inadecuados, irrelevantes o insuficientemente elaborados. El sistema editorial continúa funcionando como filtro, pero lo hace a costa de una carga de trabajo cada vez mayor.

Para Dahl, el verdadero problema no es tecnológico, sino social. El sistema de revisión por pares se construyó sobre una premisa fundamental: que el investigador es el autor intelectual del texto que presenta, comprende plenamente su contenido y puede defender cada afirmación, referencia y conclusión. La inteligencia artificial ha introducido una zona de ambigüedad que desafía ese supuesto. Entre una simple corrección gramatical y la generación completa de borradores existe un amplio espectro de usos de la IA para el que todavía no existen normas claras ni consensos sólidos. La frontera entre asistencia legítima y delegación excesiva de la escritura se vuelve cada vez más difusa.

El autor pone como ejemplo el problema de las referencias bibliográficas inventadas por los modelos de lenguaje. Un investigador puede utilizar una herramienta de IA para redactar parte de un artículo y recibir citas aparentemente válidas que en realidad no existen. Aunque no haya intención deliberada de fraude, el manuscrito acaba incorporando información falsa. Este tipo de situaciones revela una brecha entre los actuales sistemas de responsabilidad científica y las nuevas prácticas de escritura asistida por inteligencia artificial. Los mecanismos tradicionales de autoría y rendición de cuentas fueron diseñados para un entorno en el que la producción textual era completamente humana.

Otro aspecto destacado es la dimensión psicológica del fenómeno. Dahl sostiene que el uso de IA para redactar textos académicos no genera la misma percepción moral que prácticas claramente fraudulentas como la contratación de empresas que venden artículos científicos. Muchos investigadores consideran que utilizar IA para escribir partes de un manuscrito es simplemente una herramienta de productividad. El razonamiento suele ser que las ideas, los datos y la investigación siguen siendo propios, aunque la redacción haya sido parcialmente automatizada. Esta normalización puede resultar más problemática que el fraude deliberado porque es mucho más fácil de escalar y puede afectar a miles de investigadores que no se consideran deshonestos.

Las consecuencias se extienden también al sistema de revisión por pares. Cada nuevo artículo enviado requiere revisores y tiempo editorial. Sin embargo, la disponibilidad de revisores lleva años disminuyendo. La fatiga asociada a la evaluación científica ya era un problema antes de la explosión de la IA, pero el incremento del 33 % en los envíos amenaza con agravar una situación que muchos consideran crítica. De hecho, datos complementarios citados en la discusión del artículo indican que las tasas de respuesta de revisores han descendido significativamente durante los últimos años. Esto significa que el sistema recibe más manuscritos precisamente cuando dispone de menos capacidad para evaluarlos rigurosamente.

Particularmente vulnerables aparecen las revistas pequeñas, gestionadas frecuentemente por editores a tiempo parcial, comités voluntarios o sociedades científicas con recursos limitados. Son estas publicaciones las que están absorbiendo la mayor parte del crecimiento de envíos y las que disponen de menos infraestructura para afrontar el problema. Dahl considera que esta situación pone de manifiesto una debilidad estructural del ecosistema editorial académico: la insuficiente inversión histórica en capacidades editoriales y mecanismos de control en los márgenes del sistema científico.

La conclusión del artículo es que el aumento de envíos no debe interpretarse únicamente como un desafío tecnológico ni resolverse exclusivamente mediante detectores de IA o herramientas automáticas de control. Lo que está en juego es la propia arquitectura de confianza sobre la que se construye la comunicación científica. La explosión de manuscritos en 2026 funciona como una prueba de estrés que obliga a replantear cuestiones fundamentales: cómo redefinir la responsabilidad de los autores en la era de la IA, cómo sostener la participación de los revisores y cómo proteger a las revistas más vulnerables frente a una presión creciente. Más que una crisis de software, Dahl ve en estos datos una señal de que el contrato social que sustenta la revisión por pares necesita ser revisado y adaptado a un entorno donde la producción científica ya no es exclusivamente humana.