Archivo de la etiqueta: Piratería

Estadísticas de uso de Sci-Hub: países con mayor número de descargas y limitaciones metodológicas de los datos

Sci-Hub. Sci-Hub Statistics. Disponible en: https://sci-hub.ee/stats

La sección de estadísticas de Sci-Hub ofrece una visión general del uso de la plataforma a partir de los datos recopilados exclusivamente de sus dominios oficiales. El objetivo de esta página es mostrar tendencias de utilización, especialmente en lo relativo a los países desde los que se realizan más descargas de artículos científicos. No obstante, el propio sitio advierte que estos datos representan únicamente una parte de la actividad total de Sci-Hub, ya que no incluyen las descargas realizadas a través de los numerosos dominios espejo (mirrors) que reproducen el servicio. En aquellos países donde los dominios principales han sido bloqueados por decisiones judiciales o administrativas, el tráfico hacia estos sitios alternativos puede ser considerablemente superior al registrado por los servidores originales.

El responsable del sitio también anuncia su intención de publicar en el futuro el registro completo de descargas (full Sci-Hub download log), lo que permitiría disponer de un conjunto de datos mucho más detallado para analizar patrones de acceso, distribución geográfica, frecuencia de uso y comportamiento de los usuarios. Un registro de esta naturaleza tendría un notable interés para investigadores especializados en comunicación científica, bibliometría y acceso abierto, ya que posibilitaría estudiar con mayor precisión cómo se distribuye el acceso informal a la literatura académica a escala mundial.

Entre los datos que actualmente se ofrecen destaca una clasificación de los países con mayor número de descargas durante el último mes. La tabla ordena las naciones según el volumen de artículos descargados, proporcionando una instantánea de los lugares donde Sci-Hub presenta una mayor utilización reciente. Este tipo de información permite identificar tendencias geográficas, observar variaciones temporales en el uso de la plataforma y detectar regiones donde la demanda de literatura científica mediante canales alternativos resulta especialmente intensa.

El dato más llamativo es el claro liderazgo de China, con 62.841.491 descargas, una cifra extraordinariamente superior a la del resto de los países. De hecho, el volumen chino supera ampliamente la suma de las descargas de todos los demás países del Top 20. Este predominio puede explicarse por una combinación de factores: el enorme tamaño de su comunidad científica, el elevado número de estudiantes e investigadores, la intensa actividad investigadora del país y las barreras de acceso a determinadas publicaciones internacionales.

En segundo lugar aparece Estados Unidos, con 14.565.580 descargas. Aunque la cifra es muy elevada, representa menos de una cuarta parte de las descargas registradas para China. Resulta especialmente significativo porque Estados Unidos alberga algunas de las universidades y centros de investigación con mayores presupuestos para suscripciones científicas. Ello confirma que el uso de Sci-Hub no responde únicamente a la falta de acceso institucional, sino también a razones de conveniencia, rapidez o facilidad de acceso a los artículos.

Existe un gran salto entre los dos primeros países y el resto del ranking. India, en tercera posición, registra 2.992.560 descargas, seguida por Rusia (1.936.812), Brasil (1.853.519) e Indonesia (1.444.790). Estos países representan grandes sistemas nacionales de educación superior y cuentan con millones de estudiantes e investigadores, pero también con importantes desigualdades en el acceso a la literatura científica comercial, lo que puede favorecer el recurso a plataformas alternativas como Sci-Hub.

En el grupo intermedio destacan Alemania, Singapur, Irán, Japón, Turquía, Francia y Corea del Sur, todos ellos con cifras comprendidas entre aproximadamente 700.000 y 1,3 millones de descargas. La presencia simultánea de países con infraestructuras científicas muy desarrolladas (Alemania, Francia, Japón o Corea del Sur) junto a otros con mayores limitaciones económicas demuestra que el uso de Sci-Hub constituye un fenómeno global y no exclusivo de los países con menos recursos.

Los últimos puestos del Top 20 corresponden a Países Bajos, Filipinas, México, Malasia, Reino Unido, Vietnam y Canadá, con cifras que oscilan entre unas 460.000 y 600.000 descargas. Aunque el volumen es inferior al de los primeros países del ranking, sigue representando un uso considerable de la plataforma. La presencia de países como Reino Unido o Canadá, cuyos sistemas universitarios disponen de amplias colecciones de revistas científicas, sugiere nuevamente que muchos usuarios recurren a Sci-Hub por la rapidez de acceso o para evitar barreras de autenticación.

Desde una perspectiva geográfica, Asia domina claramente la clasificación, con diez de los veinte países representados (China, India, Indonesia, Singapur, Irán, Japón, Turquía, Corea del Sur, Malasia y Vietnam). América aporta cuatro países (Estados Unidos, Brasil, México y Canadá), Europa cinco (Rusia, Alemania, Francia, Países Bajos y Reino Unido) y África no aparece representada entre los veinte primeros. Esta distribución refleja, en gran medida, dónde se concentra actualmente la producción científica mundial y el crecimiento de los sistemas de investigación.

La tabla también ilustra una desigualdad muy marcada en el uso de la plataforma. China registra aproximadamente 4,3 veces más descargas que Estados Unidos y más de veinte veces las de India, que ocupa el tercer lugar. Esto indica que el uso de Sci-Hub no está distribuido de forma uniforme, sino que se concentra en unos pocos países con grandes comunidades investigadoras.

Sin embargo, el propio sitio reconoce importantes limitaciones metodológicas que deben tenerse en cuenta al interpretar estas estadísticas. En particular, los datos no se depuran para eliminar el efecto del uso de redes privadas virtuales (VPN), servidores proxy ni accesos automatizados mediante robots. Como consecuencia, la localización geográfica que reflejan las direcciones IP puede no corresponder con la ubicación real del usuario. Un ejemplo señalado expresamente es el del Reino Unido, donde el acceso a Sci-Hub ha sido restringido en diversas ocasiones; muchos usuarios recurren a servidores VPN situados en Estados Unidos para acceder al servicio, de modo que sus descargas aparecen registradas como procedentes de ese país. Este fenómeno puede distorsionar significativamente la distribución geográfica observada y sobreestimar el uso en determinadas regiones mientras subestima el de otras.

Estas advertencias ponen de manifiesto que las estadísticas deben interpretarse como una aproximación al comportamiento de los usuarios y no como una representación exacta del consumo mundial de artículos científicos a través de Sci-Hub. A ello se suma el hecho de que la exclusión de los dominios espejo implica que una parte sustancial del tráfico internacional queda fuera del análisis. En consecuencia, los datos disponibles son útiles para identificar tendencias generales y realizar comparaciones aproximadas, pero no constituyen una medición exhaustiva del uso global de la plataforma.

En conjunto, esta sección refleja el interés de Sci-Hub por aportar cierta transparencia sobre la utilización del servicio y por facilitar datos que puedan ser analizados por la comunidad investigadora. Al mismo tiempo, el propio sitio reconoce las limitaciones técnicas y metodológicas inherentes a la recopilación de estos datos, recordando que factores como la censura de dominios, el empleo de VPN, los accesos automatizados y la existencia de múltiples réplicas del servicio condicionan la fiabilidad de las estadísticas y hacen necesario interpretarlas con cautela.

¿Qué puede hacer un autor? Las bibliotecas piratas en la era de la inteligencia artificial

Person standing near digital AI output connecting to pirate library bookshelves
A person contemplates AI generation fueled by unlicensed pirate libraries.

Swartz, M. (2026). What’s an Author to Do? Shadow Libraries in the Age of AI. Slaw, 8 de mayo de 2026. https://www.slaw.ca/2026/05/08/whats-an-author-to-do-shadow-libraries-in-the-age-of-ai/

La irrupción de la inteligencia artificial generativa ha transformado profundamente el debate sobre las denominadas shadow libraries o bibliotecas piratas. En este artículo, Mark Swartz analiza cómo plataformas como Anna’s Archive, heredera de LibGen y Sci-Hub, han dejado de ser únicamente repositorios de obras distribuidas sin autorización para convertirse en una fuente estratégica de datos destinada al entrenamiento de grandes modelos de lenguaje (LLM).

El detonante de esta nueva etapa ha sido la demanda presentada por las cinco mayores editoriales comerciales del mundo contra “Anna’s Archive”, en la que ya no solo se denuncia la vulneración de los derechos de autor, sino también el suministro masivo de libros y artículos a empresas desarrolladoras de inteligencia artificial.

El autor sostiene que el desarrollo acelerado de la IA ha generado un vacío ético y normativo en el que los intereses tecnológicos avanzan mucho más deprisa que la legislación. En ese contexto, millones de libros, artículos científicos y otros contenidos protegidos han sido incorporados a los conjuntos de entrenamiento de los modelos de IA sin el consentimiento de sus autores ni una compensación económica. Swartz recuerda que las bibliotecas piratas han adquirido un papel central porque proporcionan enormes colecciones de textos ya digitalizados, accesibles y estructurados, lo que las convierte en una fuente extremadamente atractiva para las empresas tecnológicas que compiten por desarrollar modelos cada vez más potentes.

El artículo repasa algunos de los litigios más relevantes que ilustran esta nueva realidad. Entre ellos destaca el caso contra Meta por el uso del conjunto de datos Books3, formado por cerca de 200.000 libros obtenidos de forma ilícita, así como el procedimiento contra Anthropic, cuya estrategia de digitalización masiva de millones de libros desembocó en uno de los mayores acuerdos económicos relacionados con derechos de autor en el ámbito de la inteligencia artificial. Estos casos muestran que el conflicto jurídico ya no gira únicamente en torno a la copia ilegal de obras, sino sobre el uso sistemático de esos contenidos para entrenar sistemas capaces de generar nuevos textos, imágenes o respuestas basadas en ese conocimiento acumulado.

Swartz también llama la atención sobre el papel de las propias editoriales académicas y comerciales. Mientras denuncian el uso ilícito de sus publicaciones por parte de las bibliotecas piratas, muchas de ellas han comenzado simultáneamente a negociar acuerdos de licencia con compañías de inteligencia artificial para permitir el entrenamiento de modelos utilizando sus catálogos. En algunos casos, los propios autores han conocido estos acuerdos únicamente a través de comunicados de prensa. Frente a este panorama, el autor destaca iniciativas más transparentes, como la de Cambridge University Press, que permite a los autores excluir sus obras del entrenamiento de IA y contempla mecanismos de compensación económica. Esta evolución refleja, según Swartz, una transformación del sector editorial, que pasa de comercializar información a gestionar grandes volúmenes de datos con valor para la industria de la inteligencia artificial.

En la parte final del artículo, el autor se pregunta qué opciones reales conservan escritores e investigadores para proteger sus obras. La respuesta es poco optimista: probablemente la mayor parte de los contenidos publicados en inglés ya han sido utilizados para entrenar uno o varios modelos de lenguaje. Aunque empiezan a surgir iniciativas como Creative Commons (CC) Signals, destinadas a permitir que los titulares de derechos indiquen cómo desean que sus obras sean utilizadas por sistemas de IA, su eficacia dependerá de que las empresas desarrolladoras respeten voluntariamente esas señales. A la vista de los antecedentes de utilización de contenidos procedentes de bibliotecas piratas, Swartz considera que esa confianza resulta difícil de sostener.

En conjunto, el artículo plantea una reflexión de gran actualidad sobre el delicado equilibrio entre innovación tecnológica, acceso al conocimiento y protección de la propiedad intelectual. Más allá del problema jurídico, pone de relieve cómo la inteligencia artificial está alterando las relaciones tradicionales entre autores, editoriales, bibliotecas y empresas tecnológicas, obligando a replantear los modelos de acceso, compensación y gestión de los contenidos en la economía digital.

Bibliotecas piratas y plataformas de acceso ilegal a contenidos en la era de la Inteligencia Artificial

Swartz, Mark. 2026. “What’s an Author to Do? Shadow Libraries in the Age of AI.” Slaw (blog), May 8, 2026. https://www.slaw.ca/2026/05/08/whats-an-author-to-do-shadow-libraries-in-the-age-of-ai/

La emergencia de la inteligencia artificial generativa está reconfigurando de forma profunda el ecosistema del acceso al conocimiento, especialmente en relación con las llamadas shadow libraries (bibliotecas sombra) como Anna’s Archive, LibGen o Sci-Hub. El autor parte del contexto de una nueva oleada de litigios impulsados por grandes editoriales internacionales contra estas plataformas, que históricamente han sido vistas como espacios de acceso no autorizado a libros y artículos académicos. Sin embargo, el debate actual no se limita a la infracción de derechos de autor, sino que incorpora un elemento decisivo: su uso como fuentes de entrenamiento para modelos de lenguaje de gran escala (LLM).

El 6 de marzo, un importante grupo de editoriales, incluidas las cinco más grandes del mundo (Hachette, Penguin Random House, HarperCollins, Macmillan y Simon & Schuster), presentó una demanda ante un tribunal federal de Nueva York para intentar cerrar la biblioteca clandestina «Anna’s Archive». Décadas atrás, John Willinsky describió la publicación académica como su «momento Napster» con la aparición de sitios piratas como LibGen y Sci-Hub. La carrera por entrenar grandes modelos de lenguaje utilizando sitios como Anna’s Archive (sucesor de LibGen/Sci-Hub) se asemeja a una segunda etapa, donde estos sitios no solo sirven como canales para libros y artículos pirateados, sino también como fuentes de datos de entrenamiento para grandes modelos de lenguaje (LLM). Esto también se limita a las editoriales comerciales; HathiTrust informó recientemente que una gran parte de su colección fue obtenida y redistribuida en Anna’s Archive.

Las demandas contra bibliotecas clandestinas no son nuevas: editores y creadores llevan intentando eliminar obras creativas pirateadas de internet desde sus inicios, como lo demuestra la interminable lista de demandas publicadas en el blog Torrentfreak. En los últimos años, estas demandas han puesto de relieve el papel que desempeñan sitios como Anna’s Archive en el entrenamiento de grandes modelos de lenguaje (LLM), ya que «la actuación de los editores es ahora especialmente crucial a la luz de los informes que indican que Anna’s Archive anuncia activamente que proporcionará acceso de alta velocidad —y de hecho ya ha proporcionado— obras de autores robadas a desarrolladores de grandes sistemas de IA de modelos de lenguaje (LLM) y a intermediarios de datos»

El rápido ritmo del progreso tecnológico, sumado a la feroz competencia entre las empresas que desarrollan modelos de IA, ha generado un vacío ético, y países de todo el mundo se apresuran a desarrollar políticas para ponerse al día. Una de las muchas víctimas de este vacío son los autores y creadores, cuyas obras publicadas se han convertido en el principal material de entrenamiento para modelos de IA, frecuentemente sin recibir compensación alguna. Y dado que las grandes empresas tecnológicas detrás del desarrollo de la IA han adoptado un enfoque de entrenamiento similar al de Trump, han recurrido al pirateo de sitios web y bibliotecas clandestinas como Anna’s Archive para obtener datos de entrenamiento.

Esto, naturalmente, ha dado lugar a un sinfín de demandas y acusaciones. Por ejemplo, en el caso Kadrey contra Meta, se alegó que Meta entrenó su modelo de aprendizaje automático (LLM) con Books3, un conjunto de datos que incluía el texto completo de casi 200.000 libros pirateados. En esta decisión, Meta obtuvo una ajustada victoria, al determinarse que el uso de este conjunto de datos constituía un uso legítimo. Por otro lado, el caso Bartz et al. contra Anthropic PBC culminó en el mayor acuerdo de demanda colectiva por derechos de autor en la historia de Estados Unidos (1.500 millones de dólares). Los documentos judiciales de este caso ofrecen el ejemplo más claro del insaciable apetito de la IA por los datos de entrenamiento: además de contenido de bibliotecas clandestinas, Anthropic contrató a Tom Turvey, exdirector de alianzas del proyecto de digitalización de libros de Google, y le encargó obtener «todos los libros del mundo». Anthropic compró, digitalizó y destruyó millones de los libros impresos más utilizados y creó un gigantesco corpus electrónico que se planeaba que continuara indefinidamente. La liquidación de Anthropic se debió en gran medida al uso de una «biblioteca central» de obras pirateadas, a pesar de la sentencia del juez Alsup que dictaminó que el entrenamiento con libros adquiridos legalmente constituía un uso legítimo. Además, muchas otras empresas tecnológicas líderes, como Nvidia, Salesforce y Apple, han estado utilizando una estrategia similar para la formación de másteres en derecho (LLM).

Por supuesto, no son solo las grandes tecnológicas las que se benefician de esta situación. Grandes editoriales, incluidas algunas de las editoriales académicas más destacadas como Taylor & Francis y Wiley, han firmado importantes acuerdos de licencia para que grandes empresas tecnológicas utilicen sus publicaciones en el entrenamiento de IA. Los autores solo se enteran de estos acuerdos a través de artículos o comunicados de prensa. Cambridge University Press adoptó un modelo más progresista que permite a los autores optar por no permitir que su trabajo se utilice para entrenamiento, pagando además regalías. Estos son solo algunos ejemplos; para una lista más extensa, consulte el rastreador de acuerdos de licencia de IA generativa de Ithaka S+R. Esto refleja un cambio de perspectiva: las grandes editoriales se están convirtiendo menos en proveedoras de información y más en intermediarias de datos, al tiempo que investigan el desarrollo de sus propias herramientas y plataformas de IA que utilizan el contenido que poseen y licencian.

¿Qué implica esto para los autores y creadores? En este punto, es probable que muchas publicaciones en inglés, entradas de blog o publicaciones en internet se hayan utilizado como datos de entrenamiento para múltiples másteres en Derecho (LLM). Los autores que no desean que su contenido se utilice para entrenamiento tienen pocas opciones. Pueden publicar en plataformas que permiten a los autores optar por no participar, aunque esta opción no tiene mucho sentido si los datos de entrenamiento se obtienen de bibliotecas no oficiales. También pueden analizar los modelos de licenciamiento emergentes.

En este escenario, el artículo subraya que las bibliotecas piratas han pasado de ser únicamente mecanismos de distribución paralela de contenidos a convertirse en infraestructuras invisibles dentro de la economía de datos de la IA. Esta transformación intensifica el conflicto entre acceso abierto y propiedad intelectual, ya que las obras de autores y académicos no solo se consumen por lectores humanos, sino que también son absorbidas masivamente por sistemas automatizados sin compensación ni control efectivo. El texto destaca cómo esta dinámica ha generado una “zona gris ética y legal”, donde las fronteras entre uso legítimo, reutilización y explotación se vuelven cada vez más difusas.

Finalmente, el artículo plantea un problema de fondo para los autores contemporáneos: la pérdida de capacidad de control sobre sus obras en un entorno donde prácticamente todo contenido publicado puede haber sido ya incorporado a múltiples sistemas de IA. Frente a ello, se mencionan respuestas emergentes como nuevos modelos de licencia, mecanismos de “opt-out” y proyectos como Creative Commons Signals, aunque el autor se muestra escéptico respecto a su efectividad real frente a la escala y opacidad del entrenamiento de modelos de IA por parte de grandes empresas tecnológicas.

La mayor demanda colectiva por derechos de autor contra la industria de la IA: el caso Anthropic

Novet, Jordan. “AI Industry Horrified to Face Largest Copyright Class Action Ever Certified.” Ars Technica, August 21, 2025. https://arstechnica.com/tech-policy/2025/08/ai-industry-horrified-to-face-largest-copyright-class-action-ever-certified/.

Investigadores se han convertido en protagonistas de un caso sin precedentes: un tribunal federal en California ha aprobado una demanda colectiva (class action) contra Anthropic, una startup especializada en inteligencia artificial. Tres autores (Andrea Bartz, Charles Graeber y Kirk Wallace Johnson) actúan como representantes de todos los escritores cuyos libros registrados hayan sido descargados y utilizados por Anthropic para entrenar su modelo de IA. La demanda alega que la empresa obtuvo millones de títulos de sitios pirata como LibGen y PiLiMi sin consentimiento, lo que podría derivar en daños millonarios para la compañía si se prueba la infracción.

Desde la perspectiva legal, aunque el juez William Alsup reconoció que el entrenamiento del modelo podría constituir un uso legítimo (fair use), también resolvió que la mera conservación de libros piratas en una biblioteca central viola los derechos de autor, lo que justifica llevar el caso a juicio. En paralelo, organizaciones del sector tecnológico, como la Consumer Technology Association y la Computer and Communications Industry Association, han expresado su alarma ante un veredicto adverso: advierten que esta certificación de clase podría representar una amenaza existencial para Anthropic y el ecosistema emergente de IA en EE. UU., al desalentar futuros inversores y minar la competitividad tecnológica del país.

La demanda se ha expandido de forma dramática: lo que comenzó con tres autores podría llegar a incluir hasta 7 millones de demandantes potenciales, cada uno con posibilidad de reclamar hasta 150.000 USD por obra infringida. Eso transforma el caso en el mayor litigio por derechos de autor jamás aprobado en EE. UU., con riesgos financieros que podrían ascender a cientos de miles de millones de dólares.

Entrenar modelos de lenguaje de Inteligencia Artificial utilizando libros adquiridos legalmente constituye un uso legítimo

Hansen, Dave. 2025. “Anthropic Wins on Fair Use for Training Its LLMs, Loses on Building a ‘Central Library’ of Pirated Books.” Authors Alliance, 24 de junio de 2025. https://www.authorsalliance.org/2025/06/24/anthropic-wins-on-fair-use-for-training-its-llms-loses-on-building-a-central-library-of-pirated-books/

El 24 de junio de 2025, el juez William Alsup del Tribunal del Distrito Norte de California emitió una resolución clave en el juicio colectivo contra Anthropic, empresa creadora de los modelos de lenguaje Claude. La demanda, presentada por los autores Andrea Bartz, Charles Graeber y Kirk Wallace Johnson en representación de millones de escritores, cuestiona el uso de libros protegidos por derechos de autor para entrenar sistemas de inteligencia artificial.

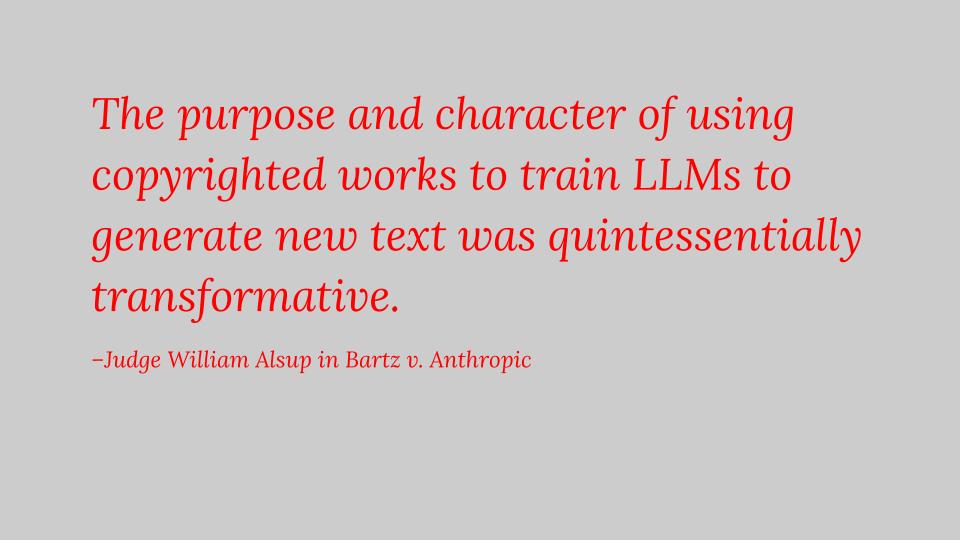
El fallo representa una victoria parcial para Anthropic. Por un lado, el tribunal determinó que entrenar modelos de lenguaje utilizando libros adquiridos legalmente constituye un uso legítimo bajo la doctrina de fair use del derecho estadounidense. Según el juez Alsup, este tipo de uso es “transformador”, ya que no busca replicar ni sustituir las obras originales, sino generar contenido nuevo, lo que encaja dentro del espíritu de la ley de derechos de autor que pretende fomentar la creatividad y el avance científico.

Sin embargo, la empresa perdió en un punto crítico: el uso sistemático de libros pirateados para construir una “biblioteca central” con fines de entrenamiento de IA. La evidencia demuestra que en 2021 y 2022, miembros de Anthropic descargaron millones de obras de sitios como Books3, Library Genesis (LibGen) y Pirate Library Mirror (PiLiMi). Estas plataformas contienen copias no autorizadas de libros protegidos, y Anthropic era plenamente consciente de ello. El propio CEO, Dario Amodei, reconoció internamente que optar por este camino era una manera de evitar el “trabajo legal, comercial y de gestión” que implicaría adquirir licencias.

En particular, el cofundador Ben Mann descargó en 2021 el conjunto de datos Books3 (compuesto por cerca de 196.000 libros pirateados), seguido de cinco millones de títulos desde LibGen y otros dos millones desde PiLiMi. Estas acciones fueron calificadas por el juez como violaciones deliberadas del derecho de autor, y aunque todavía no se ha determinado la magnitud de los daños, el tribunal ha decidido celebrar un juicio separado para abordar esta cuestión y valorar posibles indemnizaciones.

Desde Anthropic, una portavoz declaró a The Verge que celebran que el tribunal haya validado el uso transformador de las obras con fines de entrenamiento. La empresa sostiene que su objetivo no era imitar o reemplazar los libros originales, sino crear algo nuevo con base en ellos. No obstante, este argumento no exime de responsabilidad cuando se utilizan materiales obtenidos de forma ilegal, incluso si el uso posterior pudiera ser considerado transformador.

Este caso se enmarca dentro de un creciente número de demandas contra empresas de inteligencia artificial por el uso indebido de contenido protegido. La resolución de Alsup podría sentar un precedente clave: valida el entrenamiento de IA sobre obras adquiridas legalmente como fair use, pero marca una línea roja cuando se trata de contenidos pirateados. Las próximas fases del proceso judicial determinarán las consecuencias económicas y legales para Anthropic, y el caso podría influir significativamente en las prácticas de entrenamiento de modelos de IA en la industria.

Más de 850 músicos han pedido a Universal Music Group que retire su demanda contra Internet Archive

King, Ashley. «Over 600 Artists Demand UMG Drop Its $621 Million Lawsuit Against Internet Archive.» Digital Music News, December 11, 2024. https://www.digitalmusicnews.com/2024/12/11/artists-vs-umg-internet-archive-lawsuit/

Más de 850 músicos han firmado una carta abierta exigiendo que Universal Music Group (UMG) y otras discográficas retiren su demanda de 621 millones de dólares contra Internet Archive, una biblioteca digital sin fines de lucro conocida por su Wayback Machine. La carta, organizada por Fight for the Future, cuenta con la firma de artistas como Tegan & Sara, Open Mike Eagle, Amanda Palmer y Kathleen Hanna (Bikini Kill).

Los músicos argumentan que la demanda amenaza la preservación cultural y atenta contra el acceso público a la música. En la carta, destacan que la industria musical debería apoyar el legado artístico en lugar de priorizar los beneficios de los accionistas. Como alternativas, proponen tres medidas concretas para mejorar la situación de los músicos: colaborar con organizaciones como Internet Archive para conservar grabaciones originales, permitir a los artistas quedarse con el 100% de las ganancias de su merchandising y poner fin a las inversiones de las grandes discográficas en plataformas de streaming como Spotify.

Según los firmantes, mientras se espera que los ingresos de la industria musical superen los 100 mil millones de dólares en 2031, los músicos enfrentan dificultades económicas. Señalan que las giras son cada vez más costosas debido a los monopolios de Live Nation, que los ingresos por regalías son injustos debido al modelo de negocio de Spotify y que los archivos físicos han sido destruidos por intereses corporativos. También denuncian que la censura y la monetización desigual de la música afectan directamente a su bienestar, contribuyendo a la crisis de salud mental en la comunidad artística.

La demanda original de UMG, Sony Music y otras discográficas se centra en el Great 78 Project de Internet Archive, una iniciativa para digitalizar y preservar grabaciones en discos de 78 RPM, que incluyen a leyendas como Billie Holiday, Ella Fitzgerald y Frank Sinatra. Si las discográficas ganan el caso, Internet Archive podría enfrentarse a un pago millonario por haber permitido la reproducción en línea de estas grabaciones desde 2006.

Este caso se suma a la reciente derrota de Internet Archive en su apelación contra editoriales de libros, quienes han argumentado que el préstamo digital de libros escaneados por la plataforma no se ajusta a los principios de uso justo (fair use), fallo que podría sentar un precedente en la batalla legal sobre el acceso a contenidos digitales.

Meta utilizó libros pirateados de Library Genesis (LibGen) para entrenar su modelo de inteligencia artificial Llama 3 sin autorización de los autores

Reisner, Alex. “Meta Used Pirated Books to Train Its AI.” The Atlantic, March 20, 2025. https://www.theatlantic.com/technology/archive/2025/03/libgen-meta-openai/682093/?gift=iWa_iB9lkw4UuiWbIbrWGYDRoX8kfg3ZQZL6J-W0kQE.

La decisión de emplear estos materiales surge de la necesidad de contar con grandes volúmenes de texto de alta calidad para mejorar sus productos de IA y competir con modelos como ChatGPT. Sin embargo, en lugar de optar por acuerdos de licencia con editoriales y autores, lo cual implicaba costos elevados y plazos largos, la empresa decidió recurrir a LibGen, una de las mayores bibliotecas piratas de Internet, que alberga más de 7.5 millones de libros y 81 millones de artículos académicos.

Las revelaciones provienen de documentos judiciales recientemente desclasificados en el marco de una demanda por infracción de derechos de autor presentada por autores como Sarah Silverman y Junot Díaz. Entre los hallazgos más significativos se encuentra la confirmación de que Meta obtuvo permiso explícito de su CEO, Mark Zuckerberg, para descargar y utilizar la base de datos de LibGen en el entrenamiento de su modelo de IA. Este hecho subraya que la empresa no solo era consciente de la ilegalidad de sus acciones, sino que las respaldó desde los niveles más altos de la compañía.

Meta, al igual que OpenAI, ha defendido su uso de contenido protegido argumentando que los modelos de IA generan obras «transformadoras» a partir del material entrenado y, por lo tanto, están amparados bajo el principio de «fair use» (uso justo). No obstante, este argumento es altamente controvertido y todavía está lejos de una resolución definitiva en los tribunales. Más allá de la cuestión de si entrenar IA con libros pirateados constituye un uso legítimo de los materiales protegidos por derechos de autor, el artículo plantea un problema adicional: la forma en que Meta accedió a estos contenidos. Según los registros internos, la empresa utilizó BitTorrent para descargar los archivos, un método que generalmente implica no solo la descarga, sino también la distribución de los mismos, lo que agravaría aún más su situación legal.

Los documentos internos de Meta también revelan que sus empleados eran plenamente conscientes del riesgo legal que implicaba usar LibGen, calificándolo de «riesgo medio-alto». Para mitigar posibles repercusiones, sugirieron estrategias para ocultar la procedencia de los datos, como eliminar metadatos que indicaran que los textos estaban protegidos por derechos de autor y evitar cualquier mención pública del uso de LibGen. Además, se discutió la posibilidad de ajustar Llama 3 para que se negara a responder solicitudes que pudieran revelar la reproducción de contenido protegido, como pedirle que generara las primeras páginas de un libro específico.

El artículo también aborda el papel de LibGen en el acceso al conocimiento. Esta biblioteca pirata surgió en Rusia en 2008 con el propósito de ofrecer acceso gratuito a libros y artículos académicos, particularmente para estudiantes y profesionales de países con dificultades para costear estos materiales, como India, Pakistán e Irán. Sin embargo, su crecimiento exponencial ha facilitado su uso más allá de estos contextos, permitiendo que grandes corporaciones tecnológicas como Meta se beneficien del contenido sin retribuir a los autores originales.

Finalmente, Reisner plantea una reflexión sobre el impacto de esta práctica en el ecosistema del conocimiento y la creación intelectual. Si bien bibliotecas piratas como LibGen han democratizado el acceso a la información, el uso que hacen las empresas de IA de estos materiales plantea preocupaciones éticas y económicas. Al desarrollar chatbots y modelos generativos que sintetizan el conocimiento sin citar sus fuentes, estas compañías descontextualizan la información, limitan la colaboración intelectual y dificultan que escritores e investigadores reciban reconocimiento por su trabajo. La cuestión de fondo es si este tipo de apropiación tecnológica realmente beneficia a la sociedad en su conjunto o simplemente maximiza los beneficios de las grandes corporaciones, desplazando a los creadores originales en el proceso.

Las editoriales de textos y materiales educativos Cengage Learning, Bedford, Freeman & Worth, Macmillan y Elsevier demandan a Google por infracción de derechos de autor y marcas registradas

Brittain, Blake, y Blake Brittain. «Google Sued by Top Textbook Publishers over Ads for Pirated E-Books». Reuters, 5 de junio de 2024, sec. Litigation. https://www.reuters.com/legal/litigation/google-sued-by-top-textbook-publishers-over-ads-pirated-e-books-2024-06-05/.

Texto completo de la demanda

Google fue demandado el miércoles por los editores educativos Cengage, Macmillan Learning, McGraw Hill y Elsevier, acusando al gigante tecnológico de promover copias piratas de sus libros de texto.

Los editores dijeron al Tribunal de Distrito de los Estados Unidos para el Distrito Sur de Nueva York que Google ha ignorado miles de avisos de infracción de derechos de autor y continúa lucrándose con la venta de versiones digitales pirateadas de libros de texto anunciados a través de su motor de búsqueda dominante.

Los representantes de Google no respondieron de inmediato a una solicitud de comentarios sobre la demanda. El abogado de los editores, Matt Oppenheim de Oppenheim + Zebrak, dijo a Reuters que Google se había convertido en una «guarida de ladrones» para los piratas de libros de texto.

La queja dijo que las búsquedas en Google de las obras de los editores muestran versiones pirateadas de libros electrónicos con grandes descuentos en la parte superior de los resultados.

«Las obras infractoras con precios artificialmente bajos ahogan las obras legítimas con precios regulares,» dijo la demanda. «Por supuesto, los vendedores piratas pueden vender sus obras infractoras a precios tan bajos porque no hicieron nada para crearlas o licenciarlas; simplemente hicieron copias digitales ilegales.»

Según la demanda, Google ha empeorado la piratería al restringir los anuncios de libros electrónicos licenciados.

«Como resultado, el mercado de libros de texto está al revés, ya que el mayor negocio de publicidad en línea del mundo anuncia ebooks para piratas pero rechaza anuncios de ebooks para vendedores legítimos,» dijo la demanda.

La demanda afirmó que los editores han estado quejándose a Google sobre los anuncios desde 2021 sin resultado. Acusaron a Google de infracción de derechos de autor y marcas registradas y prácticas comerciales engañosas, solicitando una cantidad no especificada de daños monetarios.

De la Introducción:

Párrafo 1:

Esta demanda busca abordar la publicidad sistemática y generalizada de Google de copias no autorizadas e infractoras de los libros de texto y obras educativas de los Editores. Durante años, Google ha facilitado y obtenido ganancias de la venta de obras infractoras a través de sitios web piratas que Google promociona. Los Editores han informado repetidamente sobre infracciones a Google, solo para que esos informes sean ignorados. Google ha seguido anunciando obras infractoras mientras restringe simultáneamente los anuncios de obras educativas auténticas, apoyando la piratería en lugar de la legitimidad. La conducta de Google viola la Ley de Derechos de Autor, la Ley Lanham y la Ley de Negocios Generales de Nueva York, causando un daño incalculable a los Demandantes. Ahora, ese daño debe ser remediado.

Párrafos 3-6:

  1. Los Editores han estado enviando avisos de infracción al agente designado por Google para recibir dichos avisos. Cada aviso identifica cientos o miles de anuncios específicos de Google para obras infractoras, incluidos los URL de los anuncios, las obras con derechos de autor infringidos y los sitios web piratas a los que los anuncios contienen enlaces directos. Los Editores envían estos avisos a Google para que Google pueda tomar medidas para detener la piratería. Las respuestas de Google a estos avisos han sido un desastre de fallos. Google ha fallado en eliminar miles de anuncios de obras infractoras de manera oportuna, o en absoluto, y ha continuado haciendo negocios con piratas conocidos. Google incluso ha amenazado con dejar de revisar todos los avisos de los Editores por hasta seis meses simplemente porque los Editores volvieron a enviar apropiadamente avisos para obras infractoras que Google no actuó anteriormente.
  2. Legalmente, cuando Google recibe los avisos de los Editores y se da cuenta específicamente de que está anunciando y dirigiendo a los usuarios de Google a sitios web infractores, Google tiene la obligación de hacer algo al respecto. Continuar anunciando y obteniendo ganancias de actividades infractoras conocidas y continuar haciendo negocios con infractores reincidentes viola la ley.
  3. Públicamente, Google afirma que quiere proteger la propiedad intelectual, jactándose de ser «un líder en la erradicación y expulsión de sitios fraudulentos» de sus servicios publicitarios. Pero las acciones de Google no coinciden con sus palabras. No solo Google no ha «erradicado y expulsado» de manera independiente a los piratas reincidentes, sino que ha ignorado los avisos de infracción que identifican claramente estos «sitios fraudulentos.» Los Demandantes han intentado repetidamente discutir estos problemas con Google, pero Google se niega a tomar medidas básicas para resolverlos. Así, a pesar de los esfuerzos de los Demandantes, el sitio de Google sigue plagado de anuncios de obras infractoras.

Párrafos 7-10:

  1. Para empeorar las cosas, al usar imágenes no autorizadas de los libros de texto de los Editores, que a menudo contienen marcas registradas, Google engaña a los consumidores haciéndoles creer que están obteniendo un producto legítimo a un precio de ganga, cuando en realidad están comprando un producto ilícito. Por lo tanto, además de sus violaciones de derechos de autor, las prácticas publicitarias de Google violan la Ley Lanham.
  2. Además, Google se niega a permitir que vendedores legítimos como los Editores anuncien libros digitales independientes en la plataforma de compras de Google, pero permite tales anuncios de vendedores piratas. Como resultado, el mercado de libros de texto está al revés, ya que el mayor negocio de publicidad en línea del mundo anuncia ebooks para piratas pero rechaza anuncios de ebooks para vendedores legítimos. Las prácticas de Google dañan a los consumidores, que son dirigidos a productos ilegales e inferiores. Las prácticas de Google también dañan a los Editores, cuyas ventas disminuyen, mientras que las ventas de los piratas aumentan. Esta práctica comercial engañosa viola la ley de Nueva York.
  3. Sin la intervención del tribunal, Google continuará infringiendo deliberadamente los derechos de autor de los Editores y las marcas registradas de los Demandantes de Marcas Registradas y violando la ley de Nueva York. Para abordar y remediar la persistente y dañina conducta de Google, los Demandantes presentan esta acción.

Sci-Hub presenta una paradoja para la publicación en acceso abierto

Hall, Gary. «Sci-Hub Presents a Paradox for Open Access Publishing». Impact of Social Sciences (blog), 25 de octubre de 2023. https://blogs.lse.ac.uk/impactofsocialsciences/2023/10/25/sci-hub-presents-a-paradox-for-open-access-publishing/.

Sci-Hub se ha convertido en una puerta de acceso ampliamente utilizada pero no autorizada a la literatura científica. Abdelghani Maddi explora su relación compleja con la publicación de acceso abierto genuino. Si bien los investigadores y los financiadores de la investigación están de acuerdo en la importancia de compartir el conocimiento científico, los métodos para organizar y difundir este conocimiento siguen siendo objeto de controversia.

El sistema actual, dominado por unos pocos editores y basado en modelos de suscripción, restringe el acceso a la investigación detrás de muros de pago. Algunos proponen que las bibliotecas piratas como Sci-Hub pueden perturbar y transformar este sistema. Sin embargo, una investigación reciente revela que la amplia disponibilidad de publicaciones no de acceso abierto (no OA) en Sci-Hub puede afectar negativamente la Ventaja de Citación de Acceso Abierto, especialmente para revistas completamente de acceso abierto.

El estudio analizó el impacto de Sci-Hub en las prácticas de citación de los autores y la Ventaja de Citación de Acceso Abierto. Comparó el impacto de citación de más de 2,4 millones de publicaciones en revistas de acceso abierto con el de un grupo de control de más de 10,3 millones de publicaciones no OA. También examinó las publicaciones de acceso abierto en revistas híbridas en comparación con un grupo de control de más de 11,5 millones de publicaciones no OA, distinguiendo entre aquellas accesibles a través de Sci-Hub y las que no lo eran. Los hallazgos mostraron que Sci-Hub indexa la mayoría de las publicaciones científicas (más del 75% de las publicaciones no OA en 2020), lo que conlleva una disminución significativa en la Ventaja de Citación de Acceso Abierto, especialmente para las revistas completamente de acceso abierto. Esto sugiere que Sci-Hub influye sutilmente en las prácticas de citación de los investigadores.

El impacto de Sci-Hub se extiende a las políticas de acceso abierto y al avance de las revistas de acceso abierto. Los defensores del acceso abierto buscan valorar la producción de OA independientemente de la plataforma, con iniciativas como  COARA. Sin embargo, estas políticas pueden pasar por alto la importancia de la reputación de los investigadores, el capital simbólico y sus recursos económicos derivados de la publicación en revistas no OA de prestigio. Por ejemplo, a pesar de que Alemania cortó lazos con el principal editor Elsevier, los investigadores, especialmente los hombres, continuaron publicando en revistas de Elsevier, sin verse afectados por la cancelación de la suscripción.

Sorprendentemente, Sci-Hub, aunque aparentemente apoya el acceso abierto, en realidad perpetúa el sistema de publicación tradicional. Hace que la literatura científica sea universalmente accesible, lo que reduce la eficacia de las restricciones de acceso y la cancelación de suscripciones. Por lo tanto, incluso si las reformas de la evaluación de la investigación favorecen el acceso abierto, la existencia de Sci-Hub puede llevar a los investigadores a seguir enviando y citando artículos de revistas con un capital simbólico significativo.

Además, la proliferación de Sci-Hub complica la promoción de las revistas de acceso abierto, ya que socava uno de los principales incentivos para que los autores elijan plataformas de acceso abierto: una mayor visibilidad y potencial de citación. En esencia, la capacidad de Sci-Hub para eludir los muros de pago puede reducir la motivación de los autores para optar por el acceso abierto cuando su contenido se vuelve accesible de forma gratuita a través de otros medios.

Para resolver estos problemas, la comunidad científica, los editores y los responsables de políticas deben encontrar un terreno común, similar a la «“Battle of the sexes”» en la teoría de juegos. La coordinación entre estas partes interesadas puede generar beneficios más significativos que el desacuerdo. Iniciativas lideradas por investigadores establecidos, como la creación de revistas de acceso abierto de bajo costo y revistas de acceso abierto Diamond, marcan el camino a seguir y sugieren un futuro más equitativo y sostenible para la publicación académica.

Este análisis se basa en el artículo coescrito titulado «On the culture of open access: the Sci-hub paradox,«, publicado en Scientometrics.

Mejorar el acceso y la distribución de contenidos académicos desde las bibliotecas universitarias

Aaron Tay. «Improving Access to and Delivery of Academic Content from Libraries» Library Technology Reports vol. 58, no. 6 (agosto/septiembre de 2022)

Texto completo

Aunque las bibliotecas universitarias se han centrado tradicionalmente en el descubrimiento, ayudar a los usuarios a acceder sin problemas a los recursos disponibles tras un muro de pago se está convirtiendo en algo igualmente importante. La aparición de Sci-Hub en la escena pública no sólo ha provocado un aumento de la piratería académica, sino también el descubrimiento de que los usuarios académicos utilizaban Sci-Hub por la comodidad de no tener que autenticarse. Esta y otras razones han llevado a sospechar que es necesario mejorar y agilizar los procesos para que los usuarios se autentiquen y accedan a los recursos disponibles tras los muros de pago.

Si bien las soluciones tradicionales son la autenticación IP y el acceso federado, ahora disponemos de una serie de posibles alternativas o mejoras. Entre ellas se encuentran iniciativas como SeamlessAccess y GetFTR, así como la aparición de nuevas herramientas de terceros conocidas como extensiones de navegador access broker, como Lean Library y LibKey Nomad.

Google también ha estado trabajando en una solución denominada Campus Activated Subscriber Access (CASA), mientras que el aumento de las asociaciones de sindicación de contenidos entre editores como Springer Nature y ResearchGate ofrece la posibilidad de autenticación mediante perfiles de investigador.

Este número de Library Technology Reports, «Improving Access to and Delivery of Academic Content from Libraries», guiará al bibliotecario no técnico interesado a través de la comprensión de los fundamentos necesarios para planificar estos nuevos desarrollos.