Archivo de la etiqueta: Noticias falsas

¿Qué es la lectura lateral? verificación de la fiabilidad de la información a través de fuentes externas

Evaluar la procedencia de la información es crucial para decidir si es fiable. Observando a los verificadores de hechos, descubrimos que la mejor manera de aprender sobre un sitio web es la lectura lateral: salir de un sitio para ver qué dicen otras fuentes digitales sobre él. El proceso implica ser crítico y curioso, buscando información adicional fuera de la fuente original para obtener una visión más completa y objetiva de la información.

En la llamada Lectura Lateral (Lateral Reading) los profesores modelan la lectura lateral y guían a los alumnos a través de una serie de actividades estructuradas para desarrollar y mejorar sus habilidades de verificación de las noticias. Los alumnos contrastan la lectura lateral con la lectura vertical (permanecer en una sola página web), y aprenden cómo comprobar lo que otros sitios web dicen sobre una fuente es una mejor estrategia de evaluación que confiar en lo que la fuente dice sobre sí misma. Estas lecciones también presentan a los alumnos los recursos que pueden utilizar en la lectura lateral: Wikipedia, noticias y sitios web de organizaciones de verificación de hechos.

La lectura lateral es una técnica de evaluación de la información que consiste en abandonar la página web o la fuente que se está examinando para recabar información de otras fuentes antes de emitir un juicio sobre la credibilidad y fiabilidad de la fuente original. En lugar de basarse únicamente en el contenido presentado en una única página web, la lectura lateral anima a las personas a realizar una investigación más amplia buscando fuentes e información adicionales fuera del contexto original. De este modo, se potencia el pensamiento crítico y la comprobación de los hechos, lo que permite evaluar la información con mayor conocimiento y precisión. La lectura lateral es especialmente útil en la era digital, donde la desinformación y la desinformación pueden propagarse rápidamente, ya que ayuda a los usuarios a evitar ser víctimas de fuentes sesgadas o poco fiables.


El proceso de lateral reading implica varios pasos para evaluar la información y determinar su credibilidad. Aquí está el proceso general del lateral reading:

  1. Encuentra la fuente original: Identifica el sitio web, artículo o fuente original que estás leyendo y deseas evaluar. Toma nota del título, autor, fecha de publicación y cualquier otra información relevante.
  2. Abre una nueva pestaña del navegador: En lugar de quedarte en la página original, abre una nueva pestaña en tu navegador para buscar información adicional sobre la fuente y el tema en cuestión.
  3. Investiga la fuente: Utiliza motores de búsqueda confiables para buscar más información sobre la fuente original. Examina si hay otros artículos o fuentes que respalden o contradigan la información proporcionada. Presta atención a las fuentes reputadas, como medios de comunicación confiables, instituciones académicas o expertos reconocidos en el campo.
  4. Verifica la reputación de la fuente: Evalúa la credibilidad y la reputación de la fuente original y de las fuentes adicionales que encuentres. Investiga quién es el autor, su experiencia y sus posibles sesgos. Considera si la fuente tiene un historial confiable y si ha sido citada o reconocida en otros lugares.
  5. Analiza múltiples perspectivas: Busca diferentes perspectivas y opiniones sobre el tema en cuestión. Lee fuentes con puntos de vista divergentes para obtener una imagen más completa y equilibrada.
  6. Identifica señales de calidad: Presta atención a las señales de calidad en la fuente original y en las fuentes adicionales que encuentres. Esto puede incluir la presencia de datos respaldados por evidencia, citas y referencias a otras fuentes confiables, así como un tono objetivo y profesional.
  7. Evalúa la coherencia y consistencia: Compara la información proporcionada en la fuente original con la información encontrada en otras fuentes. Busca inconsistencias, contradicciones o falta de evidencia para respaldar las afirmaciones hechas.
  8. Reflexiona y toma una decisión informada: Después de examinar la fuente original y realizar una investigación adicional, reflexiona sobre la información y toma una decisión informada sobre su credibilidad y confiabilidad. Ten en cuenta las perspectivas múltiples y la evidencia disponible antes de llegar a una conclusión.

Guía de alfabetización informacional digital para ciudadanos en la era digital

Kari Kivinen, Minna Aslama Horowitz, Pipsa Havula, Tiina Härkönen, Carita Kiili,
Elsa Kivinen, Harto Pönkä, Joonas Pörsti, Mikko Salo, Riina Vuorikari & Jukka Vahti. «Digital Information Literacy Guide: A Digital Information Literacy Guide for Citizens in the Digital Age». Helsinki: Faktabaari, 2022

Texto completo

«Digital Information Literacy Guide: A Digital Information Literacy Guide for Citizens in the Digital Age», resume muchas de las estrategias y actividades clave que Finlandia ha incorporado recientemente a su currículo escolar formal K12, así como las competencias digitales, mediáticas y de alfabetización informacional que el gobierno finlandés pretende cultivar intencionadamente en los ciudadanos adultos de todas las edades.


La alfabetización digital es una habilidad cívica moderna que sustenta la participación en la toma de decisiones democráticas. Finlandia es conocida por su alta tasa de alfabetización, y la enseñanza de múltiples alfabetizaciones se ha integrado en los currículos actuales desde la educación infantil temprana.

Sin embargo, en plataformas digitales como TikTok, YouTube, Instagram y Facebook, los niños y los jóvenes se enfrentan a una confusa avalancha de información que puede que no puedan filtrar con las habilidades que han adquirido en la comunidad escolar y en casa: afirmaciones sobre productos por parte de influencers, resultados de búsqueda adaptados por algoritmos comerciales, propaganda ingeniosamente elaborada y autorizaciones para rastrear el comportamiento en línea o el movimiento físico en el espacio urbano ocultas detrás de innumerables botones de «sí».

La alfabetización informacional digital es la capacidad de acceder, gestionar, comprender, integrar, comunicar, evaluar, crear y difundir información de forma segura y a través de las tecnologías digitales. Incluye competencias denominadas alfabetización informacional, alfabetización mediática, alfabetización informática y alfabetización en TIC,. pero también la capacidad de comprender el funcionamiento del panorama de la información digital en general. La alfabetización informacional digital implica una dimensión de compromiso activo y cívico con el mundo digital y promueve la ciudadanía activa.

Perspectivas de los bibliotecarios sobre la desinformación: Un estudio comparativo y de seguimiento

Saunders, Laura. «Librarian Perspectives on Misinformation: A Follow-Up and Comparative Study | Saunders | College & Research Libraries», 7 de julio de 2023. https://doi.org/10.5860/crl.84.4.478.

Mientras que los bibliotecarios universitarios han respondido rápidamente a la crisis de la desinformación a través de la enseñanza de la alfabetización informacional y el desarrollo de herramientas, existe poca investigación sobre el grado en que están enseñando habilidades de alfabetización informativa en el aula. Este estudio explora las perspectivas de los bibliotecarios universitarios sobre la desinformación y si están abordando la desinformación en su enseñanza.


Los hallazgos de este estudio indican que la mayoría de los bibliotecarios universitarios están preocupados por la desinformación y los impactos que está teniendo en la sociedad, en el campo de la bibliotecología y en la capacidad de los estudiantes para identificar y utilizar información confiable. Estos bibliotecarios consideran en gran medida que la alfabetización en noticias es una herramienta importante para combatir la desinformación, y la mayoría está integrando estos conceptos en su enseñanza. Sin embargo, algunos bibliotecarios también encuentran barreras para impartir esta instrucción, como la falta de tiempo y la falta de interés real o percibida por parte de los profesores en cuyos cursos ofrecen instrucción. Dado que los profesores también expresan preocupaciones similares sobre la desinformación y apoyan la alfabetización en noticias, pero a veces se muestran reacios a colaborar con los bibliotecarios o dedicar tiempo de clase a la instrucción de biblioteca, los bibliotecarios universitarios podrían llevar a cabo actividades de divulgación para aumentar la conciencia de los profesores sobre las formas en que los bibliotecarios pueden apoyar su enseñanza en estos temas. También podrían considerar talleres para capacitar a los profesores en estas áreas, lo que les permitiría brindar su propia instrucción. Por último, es importante asegurarse de que los bibliotecarios estén bien informados sobre las complejidades y matices de los problemas relacionados con la evaluación de la desinformación, y que estén proporcionando instrucción en enfoques basados en la evidencia para su evaluación. Dada la prevalencia del problema y el papel potencial de los bibliotecarios, las asociaciones profesionales y los programas de grado en biblioteconomía podrían ofrecer cursos destinados a desarrollar aún más el conocimiento pedagógico de los bibliotecarios para prepararlos mejor para abordar estos temas en su propia instrucción.

Por último, vale la pena señalar que aunque los bibliotecarios pueden estar brindando instrucción en alfabetización en noticias, según los resultados de este estudio, en general no están evaluando los resultados de aprendizaje relacionados con esas habilidades. Solo alrededor del 10 por ciento de los bibliotecarios encuestados indicaron que evalúan la capacidad de los estudiantes para identificar o evaluar la desinformación, y aún menos colaboran con los profesores en la evaluación. En cierta medida, la falta de evaluación probablemente se debe al formato de una sola sesión, en el cual los bibliotecarios generalmente no tienen la oportunidad de asignar tareas ni ver las tareas a las que a menudo se ajustan sus sesiones. Como tal, las calificaciones de los bibliotecarios sobre las habilidades de los estudiantes deben considerarse estimaciones en la mayoría de los casos, y de hecho, en una respuesta abierta, un bibliotecario señaló que «por lo general no veo el resultado final de las tareas de pregrado, por lo que no puedo responder algunas de las preguntas anteriores». Sin embargo, los datos de evaluación podrían ayudar a establecer la eficacia (o la falta de ella) de los programas de instrucción en alfabetización en noticias, lo que a su vez podría ser una forma de involucrar a los profesores reticentes sobre el tema y ayudar a reforzar el papel de los bibliotecarios en la instrucción relacionada en el aula. Como tal, sería conveniente que los bibliotecarios de instrucción integren alguna forma de evaluación en su instrucción. Una vez más, los programas de grado en ciencias de la información y biblioteconomía desempeñarán un papel en proporcionar a los bibliotecarios emergentes los fundamentos pedagógicos para participar en dicha instrucción y evaluación.

Alfabetización informacional y pensamiento crítico en la enseñanza superior: lucha contra la desinformación

Sanches, T., Antunes, M. L., Lopes, C. Literacia da informação e pensamento crítico no Ensino Superior: Combater a desinformação: Relatório final do projeto [ebook]. BAD. 2023

Texto completo

El proyecto Alfabetización informacional y pensamiento crítico en la enseñanza superior: lucha contra la desinformación, promovido por la Asociación Portuguesa de Bibliotecarios, Archiveros, Profesionales de la Información y Documentación (BAD) y apoyado por la Embajada de los Estados Unidos de América se enmarca en el ámbito de la alfabetización informacional en la lucha contra la desinformación: se describen actividades que promueven la alfabetización informacional y el pensamiento crítico, para resistir la influencia nociva de las fake news y combatir la desinformación. Su objetivo es promover el conocimiento, proporcionar estrategias de formación y prácticas pedagógicas que promuevan habilidades y disposiciones adecuadas entre los estudiantes de educación superior. Las directrices forman parte de una metodología de intervención-acción en el desarrollo de diversas acciones dirigidas a profesionales de la información y comunidades de práctica para:

(a) conocer y aplicar puntos de referencia internacionales, como el Framework for Information Literacy for Higher Education (Association of College & Research Libraries),

(b) promover las relaciones profesionales entre bibliotecarios de EE.UU. y Portugal,

(c) difundir documentos de orientación e inspirar buenas prácticas y,

(d) capacitar a los jóvenes en el uso y elección cuidadosa de la información y en el desarrollo y mejora del pensamiento crítico.

Los resultados y el impacto social estuvieron marcados por un amplio alcance nacional, con la promoción de eventos, formación y acciones descentralizadas de sensibilización, con la difusión de conocimientos sobre el tema en las diferentes regiones de Portugal, incluidas las Azores y Madeira.

La IA generativa puede fomentar el negacionismo científico. La alfabetización digital es más importante que nunca

«Be on Alert: Generative AI Can Foster Science Denial | Psychology Today». Accedido 13 de junio de 2023. https://www.psychologytoday.com/us/blog/the-psychology-of-science-denial/202305/generative-ai-can-foster-science-denial-how-to-be-on.

ChatGPT y otros sistemas de IA generativa generan respuestas prediciendo posibles combinaciones de palabras a partir de una amalgama de información en línea. Lo que puede fomentar potencialmente el negacionismo científico porque puede ser engañoso y generar desinformación.

Hasta hace muy poco, si uno quería saber más sobre un tema científico controvertido -la investigación con células madre, la seguridad de la energía nuclear, el cambio climático-, probablemente hacías una búsqueda en Google. Cuando se le presentaban múltiples fuentes, elegía qué leer y en qué sitios o autoridades confiar.

ChatGPT no busca en Internet como Google. En su lugar, genera respuestas a las consultas prediciendo combinaciones de palabras probables a partir de una amalgama masiva de información en línea. Por lo que ahora tienes otra opción: Plantear la pregunta a ChatGPT o a otra plataforma de inteligencia artificial generativa y recibir rápidamente una respuesta sucinta en forma de párrafo.

Aunque tiene el potencial de mejorar la productividad, la IA generativa ha demostrado tener algunos fallos importantes. Puede producir información errónea. Puede crear «alucinaciones«: un término utilizado para cuando ChatGPT se inventa cosas. Y no siempre resuelve con precisión los problemas de razonamiento.

Así, la IA generativa puede difuminar los límites entre la verdad y la ficción para quienes buscan información científica fidedigna. Todos los consumidores de medios de comunicación deben estar más atentos que nunca para verificar la exactitud científica de lo que leen. De esta manera, con la abundancia de información disponible en línea, las personas se enfrentan constantemente al reto de determinar en quién y en qué confiar. El uso de la IA generativa introduce el riesgo de erosionar aún más esta confianza, ya que la manipulación y la desinformación pueden propagarse fácilmente.

Uno de los principales problemas de la IA generativa es la posibilidad de que la información sea engañosa o incorrecta. Si los datos utilizados para entrenar las plataformas de IA contienen errores o sesgos, pueden dar lugar a respuestas inexactas o sesgadas. Incluso cuando se les hace la misma pregunta varias veces, los sistemas de IA pueden generar respuestas contradictorias, reconociendo su propia falibilidad. Esto plantea un reto a la hora de identificar cuándo el contenido generado por la IA es preciso o digno de confianza.

Otro aspecto preocupante es la difusión intencionada de desinformación mediante IA. La IA generativa puede utilizarse para producir textos falsos convincentes, imágenes deepfake y vídeos que difundan información falsa. Los sistemas de IA pueden programarse para generar desinformación de forma que parezca auténtica, lo que dificulta a las personas distinguir entre realidad y ficción. Esta facilidad para crear y difundir información científica deliberadamente incorrecta amplifica el problema existente de la desinformación.

Las fuentes falsas agravan aún más el problema. Los sistemas de IA generativa suelen dar respuestas sin fuentes, o pueden generar fuentes ficticias cuando se les pregunta. Esto puede ser problemático, sobre todo cuando la autoridad de la información se atribuye a la reputación de las fuentes citadas. Los lectores que no verifiquen estas fuentes pueden ser engañados por referencias aparentemente reputadas pero fabricadas, lo que socava la confianza en el conocimiento científico.

La IA generativa también adolece de conocimientos obsoletos. Los modelos de IA se entrenan con datos hasta una determinada fecha límite, lo que significa que desconocen los acontecimientos y descubrimientos posteriores. Esta limitación puede conducir a la difusión de información errónea y obsoleta. Las personas que buscan las últimas investigaciones o información sobre temas que evolucionan rápidamente, como problemas de salud personal o enfermedades emergentes, pueden recibir información inexacta o incompleta de los sistemas de IA.

Los sistemas de IA son cada vez más potentes y capaces de aprender a un ritmo acelerado. Sin embargo, faltan salvaguardias suficientes para garantizar que la IA generativa se convierta en una fuente fiable de información científica. La posibilidad de que la IA aprenda y perpetúe la desinformación científica hace temer por su exactitud y credibilidad a largo plazo.

En conclusión, la IA generativa tiene el potencial de promover el negacionismo científico a través de varios mecanismos. La erosión de la confianza epistémica, la posibilidad de que la información sea engañosa o incorrecta, la desinformación intencionada, las fuentes inventadas, los conocimientos obsoletos y el rápido avance de la IA sin la transparencia adecuada contribuyen a los retos que plantea la IA generativa en el ámbito de la información científica. Abordar estos problemas es crucial para garantizar el uso responsable y fiable de la IA en la promoción de la comprensión científica y la lucha contra la negación de la ciencia.

¿Qué hacer?

Si utilizas ChatGPT u otras plataformas de IA, lo primero es ser consciente que muchas de las informaciones que genera podrían no ser completamente precisas. Para ello aumenta la vigilancia. Es posible que en el futuro estén disponibles aplicaciones de verificación de hechos mediante IA, pero por ahora los usuarios deben ser sus propios verificadores de hechos. Se recomienda seguir algunos pasos:

  • El primero es estar alerta. Con frecuencia, las personas comparten información encontrada en las redes sociales sin examinarla adecuadamente. Es importante saber cuándo debemos reflexionar más y cuándo vale la pena identificar y evaluar las fuentes de información. Si estás tratando de decidir cómo abordar una enfermedad grave o entender las mejores medidas para enfrentar el cambio climático, tómate el tiempo necesario para investigar las fuentes.
  • Mejora tu capacidad de verificación de hechos. Un segundo paso es realizar una «lectura lateral», un proceso utilizado por los verificadores de hechos profesionales. Si es posible, abre una nueva ventana y busca información sobre las fuentes. ¿Es creíble esa fuente? ¿El autor tiene la experiencia necesaria? ¿Cuál es el consenso de los expertos? Si no se proporcionan fuentes o si no sabes si son válidas, utiliza un motor de búsqueda convencional para encontrar y evaluar a expertos en el tema.
  • Evalúa las pruebas. A continuación, examina las pruebas y su relación con la afirmación. ¿Existen pruebas de que los alimentos modificados genéticamente son seguros? ¿Hay pruebas de lo contrario? ¿Cuál es el consenso científico al respecto? Evaluar las afirmaciones requerirá un esfuerzo más allá de una rápida consulta a ChatGPT.
  • Si recurres a la IA, no te detengas ahí. Sé cauteloso al utilizarla como única autoridad en cuestiones científicas. Puedes ver lo que dice ChatGPT sobre organismos modificados genéticamente o la seguridad de las vacunas. Sin embargo, realiza una búsqueda más exhaustiva en motores de búsqueda convencionales antes de sacar conclusiones.
  • Evalúa la verosimilitud. Juzga si la afirmación es plausible. ¿Es probable que sea cierta? Si la IA hace una afirmación inverosímil (e incorrecta), como «las vacunas causaron un millón de muertes, no el COVID-19», considera si tiene sentido siquiera. Haz un juicio provisional y mantente abierto a revisar tus ideas una vez que hayas verificado las pruebas.
  • Promueve tu alfabetización digital y la de los demás. Todos debemos mejorar en este aspecto. Mejora tu alfabetización digital y promueve la alfabetización digital de los demás si eres padre, profesor, mentor o líder comunitario. La Asociación Americana de Psicología ofrece orientación sobre la verificación de información en línea y recomienda que los adolescentes reciban formación sobre redes sociales para minimizar los riesgos para la salud y el bienestar. El Proyecto de Alfabetización en Noticias proporciona herramientas útiles para mejorar y apoyar la alfabetización digital.
  • Equípate con las habilidades necesarias para navegar por el nuevo panorama informativo de la IA. Aunque no utilices IA generativa, es probable que ya hayas leído artículos creados por ella o desarrollados a partir de ella. Encontrar y evaluar información confiable sobre ciencia en línea puede llevar tiempo y esfuerzo, pero vale la pena hacerlo.

Qué es y que significa «alucinación» cuando utilizamos ChatGPT

En el contexto de la IA generativa, «alucinar» se refiere a la capacidad del modelo para generar información que puede parecer precisa y coherente, pero que en realidad no se basa en hechos reales o conocimiento verificable. Cuando un modelo de lenguaje como ChatGPT «alucina», está generando contenido que puede parecer posible, pero que no está respaldado por evidencia o información verificada.

ChatGPT es un generador de texto. No «sabe» nada y no garantiza que lo que dice sea correcto. De hecho, muchas de las cosas que proporciona son erróneas. Es importante tener en cuenta que ChatGPT, como modelo de lenguaje, aunque ha sido entrenado con una amplia variedad de datos y puede generar respuestas coherentes y contextualmente relevantes, pero no tiene acceso directo a información verificable ni a conocimiento específico más allá de lo que ha sido previamente entrenado. Por lo tanto, la información proporcionada por ChatGPT debe ser evaluada críticamente y verificada con otras fuentes confiables. Es importante tener en cuenta que la precisión de las respuestas generadas por un modelo de lenguaje depende de la calidad y la veracidad de los datos con los que fue entrenado.

Los desarrolladores de IA adoptaron el término «alucinaciones» de la psicología humana de manera intencional. Las alucinaciones en los seres humanos son percepciones de cosas que no existen realmente en el entorno circundante. De manera similar, en el contexto de la IA, se produce una alucinación cuando el modelo generativo de IA produce resultados que difieren de lo que se consideraría normal o esperado. Se dice que alucina cuando el modelo genera información que puede parecer plausible pero que no está respaldada por hechos verificables. Esto puede deberse a la forma en que el modelo asocia conceptos y genera respuestas a partir de los datos con los que fue entrenado. Por ejemplo, cuando se le presiona sobre la búsqueda de determinada bibliografía, la herramienta puede proporcionarnos libros o artículos que nunca fueron escritos, pero que podrían haber sido escritos por un autor determinado. Esta desviación puede llevar a la generación de información incorrecta, incoherente o fantasiosa.

Los expertos insisten en que estas herramientas son tan buenas como sus datos subyacentes, que sabemos que a veces pueden ser datos erróneos, sesgados y incluso diseñados para engañar. Por consiguiente, aunque el resultado generado por un modelo sea gramaticalmente correcto y suene sensato, puede contener información falsa, o información «inventada» por el modelo. De ahí viene el concepto de “Alucinación”. Las alucinaciones se producen porque, aunque los modelos se entrenan con enormes cantidades de datos textuales, no son capaces de entender el mundo de forma humana ni de verificar la veracidad de la información como harían las personas.

Si bien se han implementado medidas para mejorar la precisión y la coherencia de las respuestas generadas por ChatGPT, todavía es posible que ocasionalmente produzca información incorrecta o inexacta. Como un proceso en desarrollo continuo, OpenAI sigue trabajando en mejorar sus modelos y mitigar estos problemas.

Pero es muy importante que los usuarios sean críticos y verifiquen la información proporcionada buscando información adicional de fuentes confiables y contrastar los datos para obtener una imagen precisa. Ya que no se puede determinar la veracidad de un hecho generado por la IA basándose únicamente en el aspecto del texto o en la apariencia de veracidad que pueda tener. Los modelos de lenguaje como ChatGPT están diseñados para generar respuestas coherentes y contextualmente relevantes, lo que puede hacer que la información parezca verosímil y correcta. Sin embargo, la generación de texto se basa en patrones y datos previos en lugar de tener acceso directo a información verificable o conocimiento actualizado.

Desinformación, información errónea y noticias falsas en las redes sociales: desafíos y oportunidades de investigación emergentes

Shu, Kai, Suhang Wang, Dongwon Lee, y Huan Liu, eds. Disinformation, Misinformation, and Fake News in Social Media: Emerging Research Challenges and Opportunities. Lecture Notes in Social Networks. Cham: Springer International Publishing, 2020. https://doi.org/10.1007/978-3-030-42699-6.

PDF

ePub

Este libro sirve como un punto de entrada conveniente para que investigadores, profesionales y estudiantes comprendan los problemas y desafíos, aprendan soluciones de vanguardia para sus necesidades específicas e identifiquen rápidamente nuevos problemas de investigación en sus dominios. Los colaboradores de este volumen describen los avances recientes en tres partes relacionadas: (1) participación de los usuarios en el desorden de la difusión de la información; (2) técnicas para detectar y mitigar la desinformación; y (3) temas de actualidad como ética, blockchain, clickbaits, etc. Este volumen editado atraerá a estudiantes, investigadores y profesionales que trabajan con desinformación, información errónea y noticias falsas en las redes sociales desde una perspectiva única.

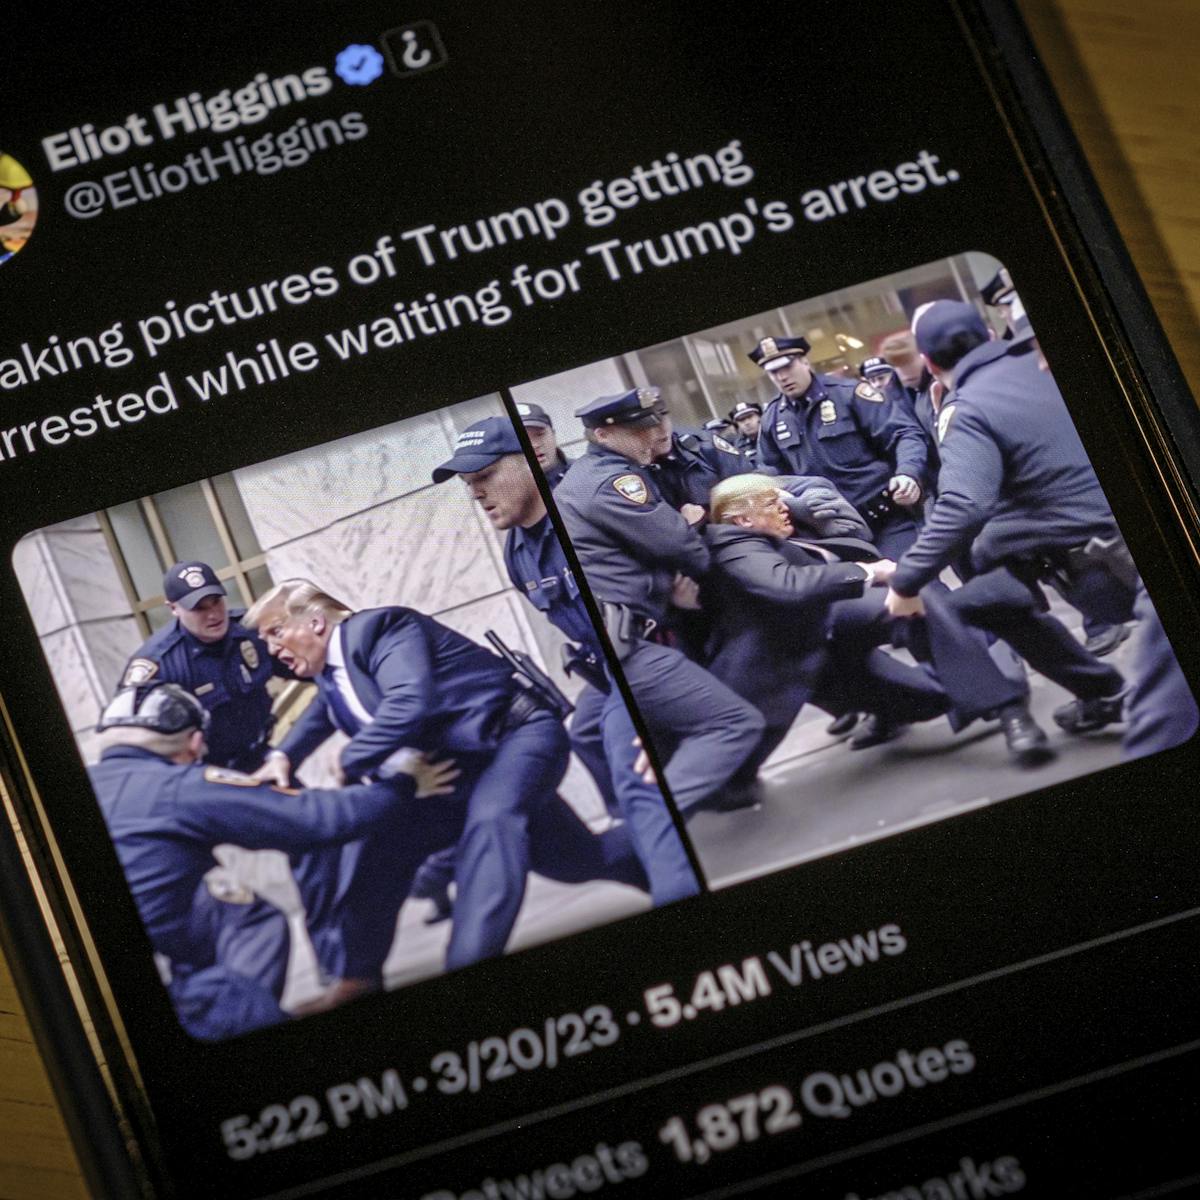
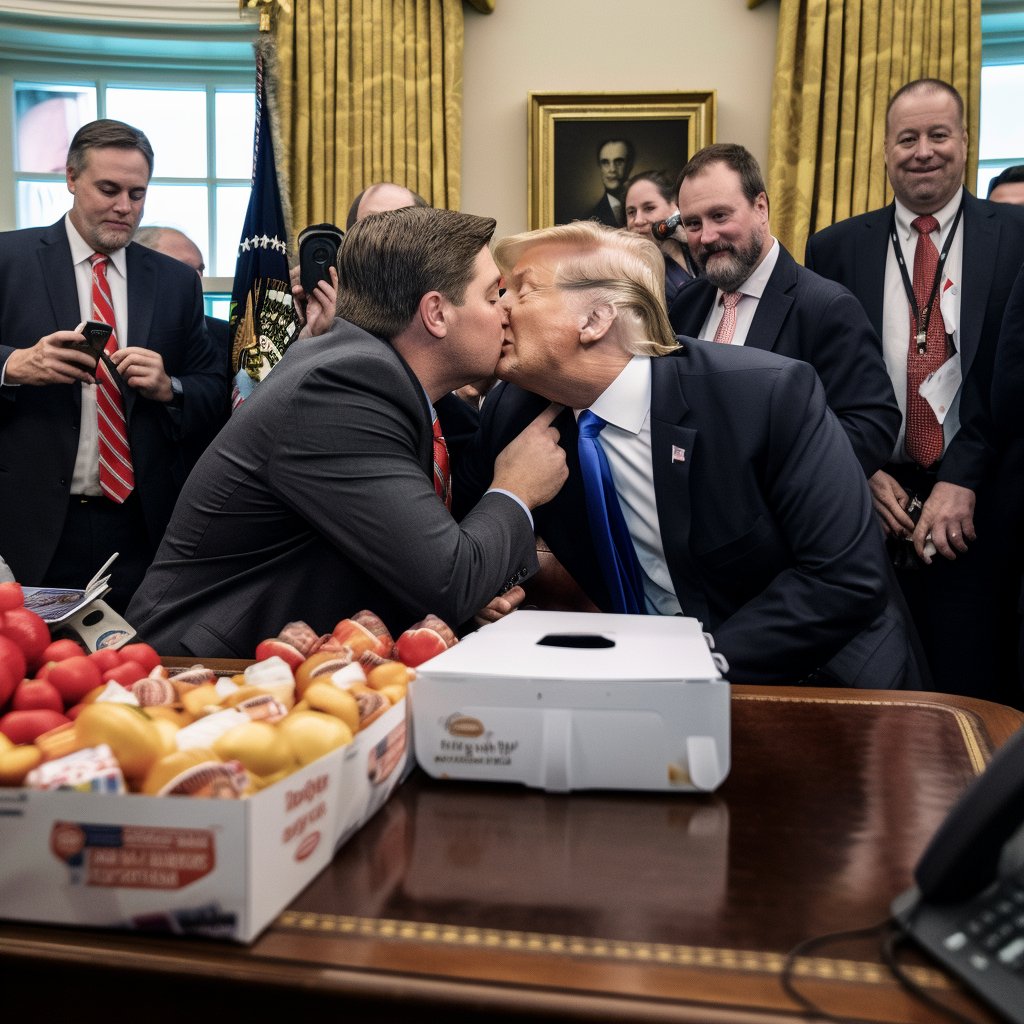
Las herramientas de IA están generando una desinformación convincente.

Foto generada con IA por Del Walker

Given, L. M. (2023, marzo 23). AI tools are generating convincing misinformation. Engaging with them means being on high alert. The Conversation.

Ver completo

Las herramientas de IA pueden ayudarnos a crear contenidos, aprender sobre el mundo y (quizá) eliminar las tareas más cotidianas y tediosas de la vida, pero no son perfectas. Se ha demostrado que pueden alterar la información, utilizan el trabajo de otras personas sin su consentimiento e incorporar convencionalismos sociales, como las disculpas, para ganarse la confianza de los usuarios.

Por ejemplo, algunos chatbots de IA, como los bots «acompañantes», se desarrollan a menudo con la intención de tener respuestas empáticas. Esto los hace especialmente creíbles. A pesar de nuestro asombro y admiración, debemos ser consumidores críticos de estas herramientas, o corremos el riesgo de ser engañados.

Sam Altman, consejero delegado de OpenAI (la empresa que creo el chatbot ChatGPT), ha declarado que le «preocupa que estos modelos puedan utilizarse para la desinformación a gran escala».

La desinformación crecerá con la IA de bolsillo

Las herramientas de aprendizaje automático utilizan algoritmos para realizar determinadas tareas. Van «aprendiendo» a medida que acceden a más datos y en consecuencia perfeccionan sus respuestas. Por ejemplo, Netflix utiliza IA para rastrear los programas que te gustan y sugerirte otros para ver en el futuro. Cuantos más programas de cocina veas, más programas de cocina te recomendará Netflix.

Aunque muchos estamos explorando y divirtiéndonos con las nuevas herramientas de IA, los expertos insisten en que estas herramientas son tan buenas como sus datos subyacentes, que sabemos que a veces pueden ser datos erróneos, sesgados y incluso diseñados para engañar. Mientras que antes los errores ortográficos nos alertaban de las estafas por correo electrónico, las mejoras del sistema hacen más difícil distinguir la realidad de la ficción.

Estas preocupaciones se ven acentuadas por la creciente integración de la IA en aplicaciones como Microsoft, Google y Adobe que han anunciado la introducción de herramientas de IA en varios de sus servicios, como Google Docs, Gmail, Word, PowerPoint, Excel, Photoshop e Illustrator.

Crear fotos y vídeos falsos ya no requiere conocimientos ni equipos especializados.

Por lo tanto, las herramientas avanzadas de IA permiten democratizar el acceso al conocimiento y su creación, pero tienen un precio. No siempre podemos consultar a expertos, así que tenemos que hacer juicios informados nosotros mismos. Aquí es donde el pensamiento crítico y las habilidades de verificación son vitales.

Estos consejos pueden ayudarle a navegar por un panorama informativo rico en IA.

  1. Haz preguntas y verifica con fuentes independientes
  2. Sé escéptico con los contenidos que encuentres
  3. Habla abiertamente de la IA en tus círculos

¿Está ChatGPT más cerca de un bibliotecario humano que de Google?


Shah, Chirag. «Is ChatGPT Closer to a Human Librarian Than It Is to Google?» Gizmodo, 19 de marzo de 2023. https://gizmodo.com/chatgpt-ai-openai-like-a-librarian-search-google-1850238908.

Más sobre

ChatGPT y Chatbot

Un investigador de motores de búsqueda explica la promesa y el peligro de dejar que ChatGPT y sus replicas busquen en Internet por ti.

El modelo predominante de acceso y recuperación de información antes de que los motores de búsqueda se convirtieran en la norma -bibliotecarios y expertos en la materia o en la búsqueda proporcionando información relevante- era interactivo, personalizado, transparente y autorizado. Hoy en día, los motores de búsqueda son la principal forma de acceder a la información, pero introducir unas cuantas palabras clave y obtener una lista de resultados ordenados por una función desconocida no es lo ideal.

Una nueva generación de sistemas de acceso a la información basados en inteligencia artificial, como Bing/ChatGPTGoogle/Bard y Meta/LLaMA está cambiando el modo tradicional de entrada y salida de los motores de búsqueda. Estos sistemas son capaces de a partir de frases completas e incluso párrafos y generar respuestas personalizadas en lenguaje natural.

A primera vista, esto podría parecer lo mejor de ambos mundos: respuestas personalizadas combinadas con la amplitud y profundidad del conocimiento en Internet. Pero como investigador que estudia los sistemas de búsqueda y recomendación, creo que el panorama es, en el mejor de los casos, contradictorio.

Los sistemas de IA como ChatGPT y Bard se basan en grandes modelos lingüísticos. Un modelo lingüístico es una técnica de aprendizaje automático que utiliza una gran cantidad de textos disponibles, como artículos de Wikipedia y PubMed, para aprender patrones. En términos sencillos, estos modelos calculan qué palabra es probable que venga a continuación, dado un conjunto de palabras o una frase. De este modo, son capaces de generar frases, párrafos e incluso páginas que corresponden a una consulta de un usuario. El 14 de marzo de 2023, OpenAI anunció la próxima generación de la tecnología, GPT-4, que funciona tanto con texto como con imágenes, y Microsoft anunció que su Bing conversacional se basa en GPT-4.

Gracias al entrenamiento sobre grandes volúmenes de texto, ajuste fino y otros métodos basados en el aprendizaje automático, este tipo de técnica de recuperación de información funciona con bastante eficacia. Los grandes sistemas basados en modelos lingüísticos generan respuestas personalizadas para satisfacer las consultas de información. Los resultados han sido tan impresionantes que ChatGPT alcanzó los 100 millones de usuarios en un tercio del tiempo que tardó TikTok en llegar a ese hito. La gente lo ha utilizado no sólo para encontrar respuestas, sino para generar diagnósticos, crear planes de dieta y hacer recomendaciones de inversión.

Sin embargo, existen muchos inconvenientes. En primer lugar, consideremos lo que constituye el núcleo de un gran modelo lingüístico: un mecanismo mediante el cual conecta las palabras y, presumiblemente, sus significados. Esto produce un resultado que a menudo parece una respuesta inteligente, pero se sabe que los grandes sistemas de modelos lingüísticos producen declaraciones casi como loros sin una comprensión real. Así que, aunque el resultado generado por estos sistemas pueda parecer inteligente, no es más que un reflejo de patrones subyacentes de palabras que la IA ha encontrado en un contexto apropiado.

Esta limitación hace que los grandes sistemas de modelos lingüísticos sean susceptibles de inventarse o «deducir» respuestas. Los sistemas tampoco son lo suficientemente inteligentes como para entender la premisa incorrecta de una pregunta y responder de todos modos a preguntas erróneas. Por ejemplo, cuando se le pregunta qué cara de presidente de EE.UU. aparece en el billete de 100 dólares, ChatGPT responde Benjamin Franklin sin darse cuenta de que Franklin nunca fue presidente y de que la premisa de que el billete de 100 dólares tiene la foto de un presidente de EE.UU. es incorrecta.

El problema es que, aunque estos sistemas se equivoquen sólo un 10% de las veces, no se sabe qué 10%. La gente tampoco puede validar rápidamente las respuestas de los sistemas. Esto se debe a que estos sistemas carecen de transparencia: no revelan con qué datos se han entrenado, qué fuentes han utilizado para dar respuestas o cómo se generan esas respuestas.

Por ejemplo, puedes pedirle a ChatGPT que escriba un informe técnico con citas. Pero a menudo se inventa estas citas, «elucubrando» tanto con los títulos de los artículos académicos como con los autores. Los sistemas tampoco validan la exactitud de sus respuestas. Esto deja la validación en manos del usuario, y los usuarios pueden no tener la motivación o las habilidades para hacerlo o incluso reconocer la necesidad de comprobar las respuestas de una IA. ChatGPT no sabe cuándo una pregunta no tiene sentido, porque no conoce ningún dato.

Aunque la falta de transparencia puede ser perjudicial para los usuarios, también es injusta para los autores, artistas y creadores de los contenidos originales de los que han aprendido los sistemas, ya que éstos no revelan sus fuentes ni proporcionan atribuciones suficientes. En la mayoría de los casos, los creadores no son compensados ni acreditados, ni se les da la oportunidad de dar su consentimiento.

Esto también tiene un aspecto económico. En un motor de búsqueda típico, los resultados se muestran con los enlaces a las fuentes. Esto no sólo permite al usuario verificar las respuestas y proporciona las atribuciones a esas fuentes, sino que también genera tráfico para esos sitios. Muchas de estas fuentes dependen de este tráfico para generar ingresos. Dado que los grandes sistemas de modelos lingüísticos producen respuestas directas pero no las fuentes de las que proceden, es probable que esos sitios vean disminuir sus flujos de ingresos.

Por último, esta nueva forma de acceder a la información también puede restar poder a las personas y les quita la oportunidad de aprender. Un proceso de búsqueda típico permite a los usuarios explorar el abanico de posibilidades para sus necesidades de información, lo que a menudo les lleva a ajustar lo que buscan. También les da la oportunidad de aprender qué hay ahí fuera y cómo se conectan las distintas piezas de información para realizar sus tareas. Y permite encuentros accidentales o serendipia.

Estos son aspectos muy importantes de la búsqueda, pero cuando un sistema produce los resultados sin mostrar sus fuentes ni guiar al usuario a través de un proceso, le priva de estas posibilidades.

Los grandes modelos lingüísticos suponen un gran avance en el acceso a la información, ya que ofrecen a las personas una forma de interactuar basada en el lenguaje natural, producir respuestas personalizadas y descubrir respuestas y patrones que a menudo resultan difíciles de encontrar para un usuario medio. Pero tienen graves limitaciones por la forma en que aprenden y construyen las respuestas. Sus respuestas pueden ser erróneas, tóxicas o sesgadas.

Aunque otros sistemas de acceso a la información también pueden adolecer de estos problemas, los sistemas de IA con grandes modelos lingüísticos también carecen de transparencia. Y lo que es peor, sus respuestas en lenguaje natural pueden contribuir a alimentar una falsa sensación de confianza y autoridad que puede resultar peligrosa para los usuarios desinformados.

La mayoría de las personas buscan noticias fiables, pero a menudo son vulnerables a la desinformación

Trust misplaced ? A report on the future of trust in media. Ipsos, 2020

Ver completo

La investigación de Ipsos para el Trust Project revela que la disposición a pagar por las noticias es limitada y que se confía más en la propia perspicacia sobre la fiabilidad de las fuentes que en la de los demás. En la mayoría de los países, la gente «se asegura de que las noticias que lee, ve o escucha proceden de fuentes fiables». Sin embargo, esto plantea algunos problemas. Por naturaleza, las personas confían en contenidos que consideran verdaderos, pero en muchos casos lo hacen porque refuerzan su visión del mundo.

El informe se basa en dos encuestas de Ipsos Global Advisor realizadas en 29 países. La mitad de los encuestados (49%) afirma que, por lo general, se asegura de que las noticias que lee, ve o escucha proceden de fuentes fiables, y un tercio (33%) afirma que lo hace ocasionalmente. Dos tercios (64%) afirman tener fácil acceso a noticias en las que pueden confiar.

Sin embargo, tras estos signos alentadores se esconde un posible terreno fértil para la continua propagación de la desinformación. A nivel mundial, el 67% de los adultos afirma que sólo lee noticias a las que puede acceder gratuitamente, mientras que sólo el 29% dice que puede y el 27% está dispuesto a pagar por noticias de fuentes en las que confía. Muchos confían en su capacidad para detectar «noticias falsas» (58 %), aunque confían menos en la capacidad de sus conciudadanos para hacerlo (30 %). Sólo la mitad de los encuestados (46%) cree que otros países se dirigen a la población de su país con desinformación, incluso en Estados Unidos (58%) y Gran Bretaña (54%), donde está ampliamente documentado.

Otras conclusiones clave

  • El porcentaje de adultos que buscan fuentes de noticias fiables al menos de vez en cuando oscila entre el 94% en Perú y el 92% en Colombia, Chile y Sudáfrica, y el 65% en Japón y el 66% en Corea del Sur. En Estados Unidos es del 88% (59% generalmente, 29% ocasionalmente).
  • En todos los países encuestados, la mayoría está de acuerdo en que tiene fácil acceso a noticias en las que confía y menos de uno de cada cinco está en desacuerdo, con la única excepción de Japón (25% de acuerdo frente a 23% en desacuerdo, mientras que el 53% ni está de acuerdo ni en desacuerdo).
  • Globalmente, la mayoría de los adultos encuestados obtienen con frecuencia noticias de diversas fuentes: Casi tres cuartas partes afirman obtener sus noticias al menos tres veces por semana de la televisión (74%) y las redes sociales (72%), seis de cada diez de sitios web de noticias (62%) y aplicaciones de noticias (61%), cuatro de cada diez de la radio (42%), y uno de cada cuatro de periódicos y revistas impresas (24%).
  • El uso de cada una de estas fuentes de noticias es algo menor en EE.UU., lo que sugiere que la dieta de medios de comunicación de los estadounidenses es menos variada que la de otras personas de todo el mundo, por término medio. Sin embargo, el orden de importancia de cada fuente de noticias es el mismo: televisión (64%), redes sociales (51%), sitios web de noticias (50%), aplicaciones de noticias (40%), radio (32%) y publicaciones impresas (19%).
  • La capacidad declarada de pagar por noticias procedentes de fuentes fiables varía mucho de un país a otro, desde el 57% en la India, el 48% en China y el 43% en los Países Bajos hasta sólo el 13% en Japón, el 15% en Rusia y el 18% en España y Francia. La disposición a hacerlo muestra un patrón muy similar.
  • La confianza en la propia capacidad para distinguir «noticias reales de noticias falsas» es mayor en América Latina, Oriente Medio y los países de habla inglesa, y menor en Japón, Corea del Sur, Europa continental y Rusia. En Estados Unidos, el 61% confía en su capacidad para discernir la fiabilidad de las noticias.
  • A nivel mundial, el porcentaje de quienes confían en su propia capacidad para contar noticias reales es 28 puntos superior al de quienes expresan confianza en que los hombres y mujeres de su país puedan hacerlo. La diferencia supera los 40 puntos en Gran Bretaña, Hungría y Estados Unidos; en cambio, es inferior a 10 puntos en Arabia Saudí, China y Japón.
  • Quienes están de acuerdo con ideas populistas o nativistas son más propensos a estar expuestos a la desinformación