Archivo de la etiqueta: Investigación

NISO Publica el borrador de la revisión de la Práctica Recomendada para Versiones de Artículos de Revista

Journal Article Version (JAV) Recommended Practice. The National Information Standards Organization (NISO)

PDF

The National Information Standards Organization (NISO) anunció hoy que su borrador de la revisión de la Journal Article Version (JAV) Recommended Practice está abierto para comentarios públicos hasta el 7 de julio de 2024 en la página web del proyecto.

Publicado por primera vez en 2008, Journal Article Version (JAV) Recommended Practice se desarrolló para describir las diferentes versiones del contenido académico en línea. Desde entonces, las prácticas editoriales han seguido evolucionando y, con cambios como el rápido crecimiento de las publicaciones preprint, el concepto de una única versión oficial se ha vuelto menos relevante. Preguntas sobre las citas de diferentes versiones y el etiquetado de versiones, por ejemplo, han destacado la necesidad de estandarizar términos y recomendar cómo gestionar, rastrear e indexar múltiples versiones. El grupo de trabajo de NISO se formó para abordar estos desafíos y desarrollar una revisión de la Práctica Recomendada JAV, incluyendo un apéndice con múltiples ejemplos que ilustran una variedad de casos de uso para aquellos que buscan orientación.

«Nos complace presentar la Práctica Recomendada revisada para comentarios públicos,» dijo Clay Burgett, Copresidente del Grupo de Trabajo (Director Asistente de Tecnología de Aplicaciones, Publicaciones ACS). «Esperamos que sea útil para una variedad de partes interesadas en las comunicaciones académicas y esperamos incorporar comentarios de la comunidad en general.» Los Copresidentes del grupo de trabajo, Patrick Hargitt (Director Senior de Gestión de Productos, Atypon) y Michael Nason (Bibliotecario de Publicaciones y Becas Abiertas, Universidad de New Brunswick), destacaron los esfuerzos determinados de los miembros del grupo de trabajo para abordar de manera colaborativa los problemas y preguntas de un panorama editorial en constante evolución y la expectativa del grupo de someter su producto a revisión pública.

«NISO aprecia el servicio del Grupo de Trabajo de Revisión de JAV,» dijo Nettie Lagace, Directora Ejecutiva Asistente de NISO. «Muchas cosas han cambiado desde 2008, y estas revisiones esenciales ayudarán a asegurar que la Práctica Recomendada JAV se mantenga actualizada y satisfaga las necesidades de los creadores y consumidores de artículos académicos. Esperamos recibir más aportaciones y opiniones de la comunidad, que fortalecerán la Práctica Recomendada final.»

Directrices para académicos buscan reducir los riesgos éticos en el uso de IA generativa

Drew, Liam. «Guidelines for Academics Aim to Lessen Ethical Pitfalls in Generative-AI Use». Nature, 22 de mayo de 2024. https://doi.org/10.1038/d41586-024-01543-1.

Investigadores del Reino Unido están desarrollando un nuevo conjunto de herramientas para ayudar a los académicos a utilizar la inteligencia artificial generativa (IA generativa) de manera más ética.

Wendy Moncur, investigadora en ciberseguridad de la Universidad de Strathclyde en Glasgow, lidera este proyecto. La falta de orientación en el uso de herramientas de IA generativa ha llevado a Moncur y su equipo a considerar la necesidad de un conjunto de directrices que aborden las fortalezas y amenazas de estas tecnologías.

El proyecto se centra en los problemas que pueden surgir cuando se utilizan herramientas de IA generativa, como ChatGPT de OpenAI y Gemini de Google, para analizar y procesar información personal de voluntarios en estudios. Moncur y su equipo están utilizando herramientas de IA generativa para crear materiales educativos basados en las historias de los participantes, pero se preocupan por el riesgo de que la información anonimizada pueda ser reidentificada y distorsionada por la IA.

Las inquietudes de Moncur la llevaron a colaborar con científicos informáticos y un académico en derecho para desarrollar soluciones. Financiado por el Centro Nacional de Investigación del Reino Unido sobre Privacidad, Reducción de Daños e Influencia Adversarial en Línea, el proyecto de diez meses busca crear directrices para investigadores y comités de ética universitarios, con fecha de finalización en agosto.

El proyecto tiene tres objetivos principales: abordar la falta de experiencia en la identificación de riesgos de privacidad, cumplir con los requisitos de gestión de datos en la investigación del Reino Unido y mitigar los riesgos legales para las instituciones que utilizan IA generativa para procesar datos de participantes.

El equipo está realizando una revisión de la literatura y planea entrevistar a académicos en comités de ética para desarrollar una herramienta que analice fortalezas, debilidades, oportunidades y amenazas, y que esté disponible en línea de forma gratuita.

Robert Davison, científico de sistemas de información en la Universidad de la Ciudad de Hong Kong, apoya estos esfuerzos y advierte contra la normalización del uso de IA generativa sin la debida atención ética. Moncur y sus colegas apuntan a los comités de ética universitarios como el primer paso para establecer normas éticas robustas en el uso de esta tecnología.

Lanzamiento de la Plataforma de IA de Clarivate

Ben-Porat, Guy. «Introducing the Clarivate Academic AI Platform». Clarivate (blog), 21 de mayo de 2024. https://clarivate.com/blog/introducing-the-clarivate-academic-ai-platform/.

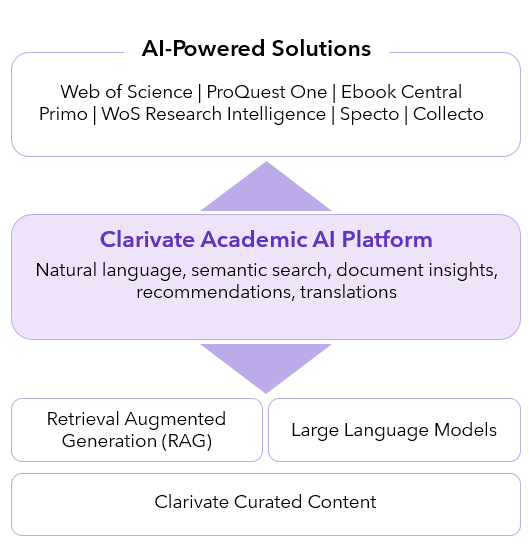
La Plataforma Académica de IA de Clarivate marca un hito significativo en su esfuerzo por empoderar a la comunidad académica con herramientas y tecnologías de IA innovadoras y servirá como una columna vertebral tecnológica, permitiendo la implementación acelerada y consistente de capacidades de IA en todo su portafolio de soluciones Académicas y Gubernamentales.

Esta iniciativa ha sido el resultado de varios proyectos de investigación en los que la empresa se ha involucrado durante el último año, trabajando estrechamente entre sus equipos de ciencia de datos, ingeniería, contenido y experiencia de usuario, y la comunidad de clientes para aprender de primera mano sobre el potencial y las limitaciones de la IA generativa (GenIA). Además, la experiencia acumulada durante años de uso de IA y aprendizaje automático en sus productos ha sido fundamental para dar forma a este avance.

Algunas de sus características son:

  • Asistente de Investigación de Web of Science: Ayudando a investigadores de todos los niveles a explorar el índice de citas más confiable del mundo, aprovechando más de un siglo de investigación, con descubrimiento en lenguaje natural, tareas guiadas y visualizaciones contextuales.
  • Asistente de Investigación de ProQuest: Permitiendo a los usuarios navegar por millones de trabajos académicos de texto completo dentro de ProQuest y obtener fácilmente nuevos conocimientos para la investigación y el aprendizaje.
  • Entrenador Académico Alethea: Fomentando las habilidades de aprendizaje y pensamiento crítico de los estudiantes al guiarlos hacia el núcleo de sus lecturas de curso, ayudándolos a destilar los puntos clave y prepararse para la discusión en clase.
  • Asistente de Investigación de Primo: Transformando el descubrimiento en bibliotecas, proporcionando a los usuarios una nueva forma de encontrar y explorar materiales a través de la búsqueda en lenguaje natural, referencias de artículos y consultas recomendadas para apoyar la investigación.

En el futuro, la plataforma ampliará sus capacidades para admitir la introducción de capacidades de IA en productos adicionales, incluidos Alma, Ebook Central, EndNote y Leganto, así como presentar eficiencias de backend como la creación y enriquecimiento de metadatos.

Las bibliotecas universitarias se preparan para un mundo de investigación y erudición influenciado por la Inteligencia Artificial

Ruttenberg, Judy. «Research Libraries Prepare for a World of AI-Influenced Research and Scholarship». Association of Research Libraries (blog), 23 de mayo de 2024. https://www.arl.org/blog/research-libraries-prepare-for-a-world-of-ai-influenced-research-and-scholarship/.

Las bibliotecas de investigación, responsables de preservar el pasado, el presente y el futuro del conocimiento, tienen una larga experiencia con tecnologías disruptivas. Ahora están utilizando el crecimiento de la inteligencia artificial (IA), especialmente la IA generativa, para mejorar sus servicios, crear oportunidades educativas y evaluar su impacto en las operaciones y colecciones. La Asociación de Bibliotecas de Investigación (ARL) se asegura de que sus miembros y las comunidades a las que sirven prosperen en medio de esta disrupción tecnológica. Esto implica equilibrar las oportunidades innovadoras de la IA generativa con las posibles amenazas al acceso equitativo, la libertad intelectual y la integridad de la información.

La ARL ha sido históricamente fuerte en la defensa de un régimen de derechos de autor equilibrado. A través de la Library Copyright Alliance (LCA), la Asociación emitió en 2023 un conjunto de principios para los derechos de autor y la inteligencia artificial. Estos principios fueron presentados a la Oficina de Derechos de Autor de EE. UU. y a la Oficina de Política de Ciencia y Tecnología de la Casa Blanca. Los principios destacan la diferencia crucial entre lo que un modelo de IA aprende y lo que produce en relación con las obras protegidas por derechos de autor. En resumen, para que la IA generativa pueda innovar, es necesario proteger el uso justo en el entrenamiento de modelos de IA, mientras que la ley actual puede abordar las posibles infracciones de derechos de autor en las producciones de IA.

Como líder en la creación de normas para bibliotecas de investigación, la ARL también ha formulado principios generales sobre la IA generativa. Estos principios buscan influir en las políticas y abogar por el desarrollo responsable de tecnologías de IA, promoviendo prácticas éticas y transparentes, y construyendo confianza entre todas las partes involucradas, tanto dentro de las bibliotecas como en el entorno de investigación en general.

Además, la ARL y la Coalición para la Información en Red (CNI) han publicado un conjunto de escenarios que anticipan el impacto del aprendizaje automático y la IA generativa en el ecosistema del conocimiento y la investigación para el año 2035. Estos escenarios no pretenden predecir el futuro, sino ayudar a imaginarlo y explorar las incertidumbres que el sector enfrentará. En una reciente reunión en Boston, la comunidad de la ARL utilizó estos escenarios para identificar y priorizar oportunidades.

Invertir en bibliotecas siempre ha beneficiado a las comunidades durante las disrupciones tecnológicas. La ARL y sus bibliotecas miembro colaboran con socios del sector de investigación y aprendizaje para preservar el patrimonio cultural, apoyar nuevas formas de investigación y publicación, y promover el éxito estudiantil. La Asociación invita a colaborar en el avance de sus principios de IA y en el uso de estos escenarios para asegurar un entorno informativo que promueva el progreso del conocimiento.

Una cuarta parte de los ensayos clínicos podrían ser problemáticos o incluso totalmente inventados

Van Noorden, Richard. «Medicine Is Plagued by Untrustworthy Clinical Trials. How Many Studies Are Faked or Flawed?» Nature 619, n.o 7970 (18 de julio de 2023): 454-58. https://doi.org/10.1038/d41586-023-02299-w.

Las investigaciones sugieren que, en algunos campos, al menos una cuarta parte de los ensayos clínicos podrían ser problemáticos o incluso totalmente inventados, advierten algunos investigadores. Instan a un mayor escrutinio.

¿Cuántos estudios de ensayos clínicos publicados en revistas médicas son falsos o contienen errores fatales? En octubre de 2020, John Carlisle publicó una sorprendente estimación. El anestesista John Carlisle, conocido por detectar datos dudosos en ensayos médicos, revisó más de 500 estudios durante tres años y encontró que el 26% tenía problemas tan graves que no se podían confiar, lo que él llamó «ensayos zombis». Estos ensayos, que se asemejan a la investigación real pero son huecos, pueden pasar desapercibidos sin acceso a los datos individuales de los participantes.

Por ello, se sugiere que los editores de revistas revisen los datos de los participantes antes de publicar ensayos controlados aleatorios. La preocupación por la integridad de la investigación también se extiende a otras áreas médicas, como la salud de la mujer, la anestesiología y la COVID-19, donde se han encontrado numerosos ensayos sospechosos.

Los problemas con los ensayos falsificados o poco confiables plantean serias amenazas, ya que pueden influir en las decisiones médicas y distorsionar el conocimiento científico. Aunque se están realizando más estudios para evaluar la magnitud del problema, la detección y corrección de ensayos problemáticos sigue siendo un desafío importante para la comunidad científica.

Wiley cerró 19 revistas científicas a raíz de problemas con las llamadas «fábricas de artículos» con inteligencia artificial

Claburn, Thomas. «Wiley Shuts 19 Scholarly Journals amid AI Paper Mill Problem». Accedido 21 de mayo de 2024. https://www.theregister.com/2024/05/16/wiley_journals_ai/.

Wiley cerró 19 revistas científicas a raíz de problemas con «fábricas de artículos» con inteligencia artificial. Estas revistas pertenecían a su subsidiaria Hindawi, centro de un escándalo de publicación académica.

En diciembre de 2023 Wiley anunció que dejaría de utilizar la marca Hindawi, adquirida en 2021, tras su decisión en mayo de 2023 de cerrar cuatro de sus revistas «para mitigar la manipulación sistemática del proceso de publicación» Se descubrió que las revistas de Hindawi estaban publicando artículos provenientes de «fábricas de artículos» (Papel Mills), organizaciones que intentan manipular el proceso de publicación académica con fines financieros. En respuesta a esto, Wiley ha retiró más de 11.300 artículos de su cartera de Hindawi. La preocupación por la integridad de la investigación académica no se limita a las publicaciones de Wiley, ya que estudios sugieren que hasta una cuarta parte de los ensayos clínicos pueden ser problemáticos o completamente fabricados.

Según un preprint publicado en febrero, el volumen de artículos enviados a ArXiv aumentó considerablemente en las tres categorías principales entre 2019 y 2023, un período que coincide aproximadamente con la puesta a disposición del público de herramientas como ChatGPT. Los artículos de ciencias de la computación aumentaron un 200 por ciento durante estos cuatro años, seguidos por los artículos de física (45 por ciento) y matemáticas (22 por ciento).

Como se describe en un libro blanco de Wiley publicado el pasado diciembre, «Tackling publication manipulation at scale: Hindawi’s journey and lessons for academic publishing», las fábricas de artículos recurren a diversas prácticas contrarias a la ética, como el uso de inteligencia artificial en la fabricación de manuscritos y la manipulación de imágenes, así como la manipulación del proceso de revisión por pares.

La creciente disponibilidad y sofisticación de la inteligencia artificial generativa está facilitando estas prácticas. Wiley ha implementado una nueva tecnología de detección para identificar artículos con posibles usos indebidos de la inteligencia artificial generativa antes de su publicación. «El sector reconoce que las editoriales utilizan la IA para generar contenidos fraudulentos», explica el portavoz de Wiley. «Recientemente hemos introducido una nueva tecnología de cribado que ayuda a identificar artículos con un potencial mal uso de la IA generativa antes del punto de publicación».

Las editoriales académicas, sin embargo, parecen apoyar los beneficios de la ayuda de la IA a la redacción sin sus inconvenientes. Springer Nature, por ejemplo, lanzó el pasado mes de octubre «Curie», un asistente de escritura basado en IA para ayudar a los científicos cuya lengua materna no es el inglés. De ahí las peticiones de mejores herramientas para detectar los resultados generativos de la IA, una petición a la que han respondido los recientes esfuerzos por mejorar la marca de agua de los contenidos de IA, que según algunos investigadores no funcionará.

Aunque Wiley caracterizó el cierre de las 19 revistas como parte de su plan anunciado previamente para integrar las carteras de Hindawi y Wiley, y distinto del problema de las fábricas de artículos, este incidente destaca los desafíos en la integridad de la investigación académica frente a la proliferación de prácticas fraudulentas facilitadas por la inteligencia artificial.

Mientras tanto, el informe de ganancias del tercer trimestre fiscal de 2024 de Wiley, el editor indicó que se anticipa que los ingresos de su división de aprendizaje se sitúen en el extremo superior de las proyecciones, debido a «acuerdos de derechos de contenido del cuarto trimestre para el entrenamiento de modelos de IA».

¿Qué tienen en cuenta los investigadores a la hora de elegir una revista a la que enviar un artículo para su publicación?

Maggio, Lauren A., Natascha Chtena, Juan Pablo Alperin, Laura L. Moorhead, y John M. Willinsky. «“The Best Home for This Paper”: A Qualitative Study of How Authors Select Where to Submit Manuscripts». bioRxiv, 17 de mayo de 2024. https://doi.org/10.1101/2024.05.14.594165.

Para los investigadores, seleccionar una revista objetivo para enviar un manuscrito es una decisión crítica con implicaciones en su carrera. En el contexto de la investigación médica, una investigación realizada en 2016 encontró que los autores eran influenciados por múltiples factores como el prestigio de una revista y su misión. Sin embargo, desde que se realizó esta investigación, el panorama editorial ha cambiado para incluir una variedad más amplia de revistas, una amenaza aumentada de revistas depredadoras y nuevos modelos de publicación. Este estudio actualiza y amplía cómo los autores de educación médica deciden a qué revista enviar con el objetivo de describir los factores motivacionales y las características de las revistas que guían la toma de decisiones de los autores.

Métodos: Los autores llevaron a cabo cinco grupos focales cualitativos en los que participaron veintidós autores y editores de educación médica. Durante los grupos focales, los participantes participaron en una discusión sobre cómo seleccionan una revista para enviar sus manuscritos. Se transcribió el audio de todos los grupos focales. Las transcripciones fueron analizadas utilizando análisis temático con un código de libro.

Resultados: Los participantes consideraron múltiples factores al seleccionar una revista objetivo. Los factores incluyeron el impacto de una revista, el alcance de una revista, la calidad de la revista y factores técnicos (por ejemplo, límites de palabras). Los participantes también describieron cómo los factores sociales influenciaron su proceso y que el acceso abierto juega un papel que podría tanto fomentar como disuadir la presentación.

Discusión: Los hallazgos describen los factores motivacionales y las señales influyentes que guían a los autores en su toma de decisiones sobre la selección de revistas. Estos hallazgos confirman, amplían y actualizan los factores de selección de revistas reportados en educación médica y otras disciplinas. Especialmente, estos hallazgos enfatizan el papel de los factores sociales, las relaciones y las experiencias personales, que estaban ausentes en trabajos previos. Además, observamos una mayor consideración del acceso abierto y un alejamiento del énfasis en el prestigio de la revista.

Conjunto de herramientas para archiveros y bibliotecarios que apoyan la investigación y la enseñanza en Humanidades Digitales

Sayers, Karen. «A Toolkit for Archivists and Librarians Supporting Research and Teaching in Digital Humanities», The Research Libraries (RLUK) and The National Archives (TNA), 24 de abril de 2024.

Texto completo

Este toolkit es un recurso para archiveros y bibliotecarios que apoyan, o desean apoyar, a investigadores y profesores de humanidades digitales y convertirse en socios o colaboradores en proyectos. Además, es valioso para investigadores, profesores académicos y gestores. El toolkit contiene enlaces a proyectos de humanidades digitales, recursos de capacitación y redes de apoyo.


«Toolkit for Archivists and Librarians Supporting Research and Teaching in Digital Humanities» es una herramienta diseñada por Karen Sayers. Está dirigida a archiveros y bibliotecarios que desean brindar apoyo a investigadores y profesores de humanidades digitales, así como convertirse en socios o colaboradores en proyectos relacionados. Además, es útil para investigadores, profesores académicos y gestores. El toolkit incluye enlaces a proyectos de humanidades digitales, recursos de capacitación y redes de apoyo.

Durante 2023-24, Karen Sayers realizó una investigación centrada en humanidades digitales utilizando datos de series de registros históricos. Para crear este toolkit, consideró esencial comprender los procesos que un investigador de humanidades digitales.

El toolkit esta dividido en secciones que describen las etapas en un proyecto de investigación. Contiene enlaces a recursos que brindan apoyo o capacitación relacionados con las habilidades necesarias para llevar a cabo investigaciones en humanidades digitales. El recurso se centra en habilidades de investigación que son especialmente relevantes para las humanidades digitales.

Dentro del toolkit, se incluyen enlaces a recursos de acceso abierto para apoyar a investigadores y profesores de humanidades digitales siempre que sea posible. Es importante recordar que constantemente están surgiendo nuevos recursos.

Guía necesaria para el uso de la inteligencia artificial en la detección de conductas impropias en las presentaciones de artículos a revistas científicas

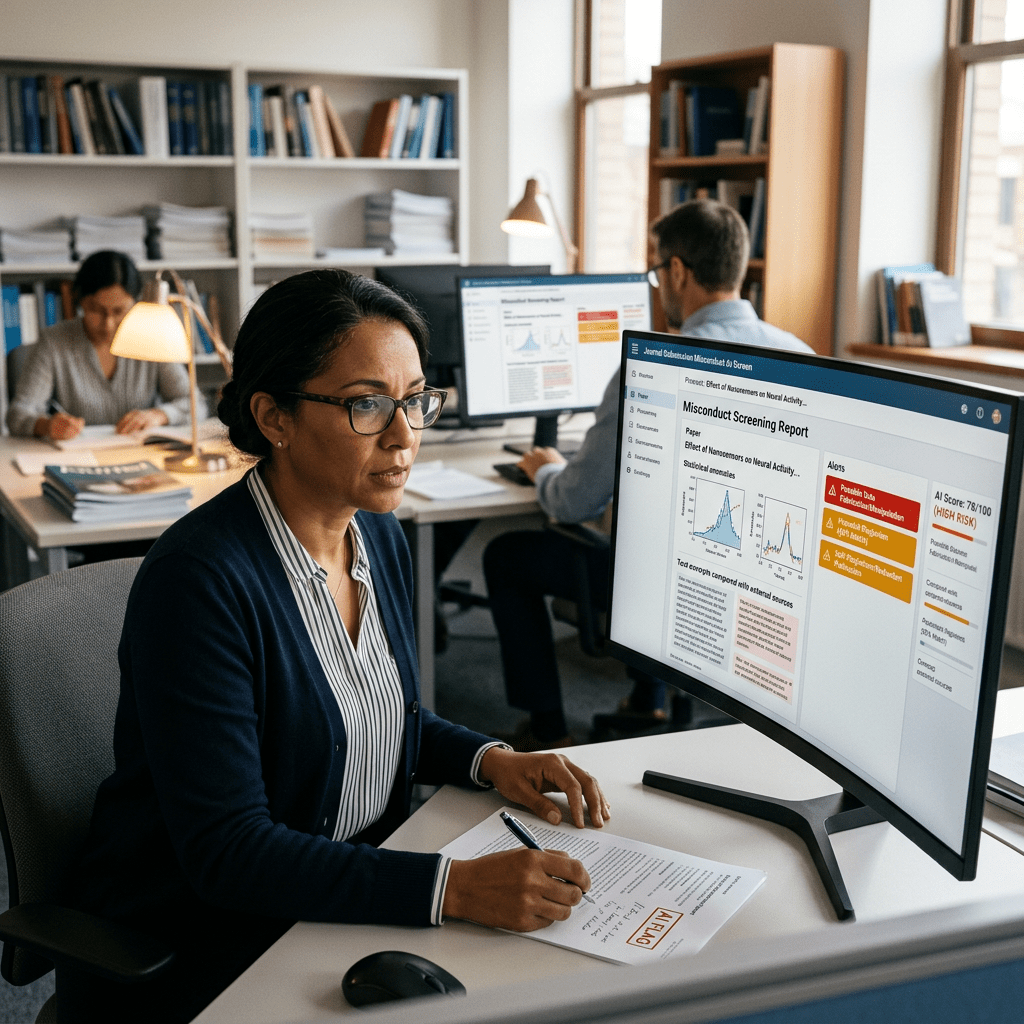
Woman analyzing misconduct screening report on computer, writing notes on paper marked 'ALTO'
A woman reviews a high-risk misconduct screening report on a large computer monitor in an office.

Hosseini, Mohammad, y David B Resnik. «Guidance Needed for Using Artificial Intelligence to Screen Journal Submissions for Misconduct». Research Ethics, 11 de mayo de 2024, 17470161241254052. https://doi.org/10.1177/17470161241254052.

Las revistas y editoriales están utilizando cada vez más la inteligencia artificial (IA) para examinar las presentaciones en busca de posibles conductas impropias, incluido el plagio y la manipulación de datos o imágenes.

Si bien el uso de la IA puede mejorar la integridad de los manuscritos publicados, también puede aumentar el riesgo de acusaciones falsas/no fundamentadas. Las ambigüedades relacionadas con las responsabilidades de las revistas y editoriales con respecto a la equidad y transparencia también plantean preocupaciones éticas.

En el presente artículo, se proporciona la siguiente guía:

  • Todos los casos de conducta impropia sospechosa identificados por herramientas de IA deben ser revisados cuidadosamente por humanos para verificar la precisión y garantizar la responsabilidad;
  • Las revistas/editoriales que utilizan herramientas de IA para detectar conductas impropias deben utilizar solo herramientas bien probadas y confiables, permanecer vigilantes con respecto a formas de conducta impropia que no pueden ser detectadas por estas herramientas y mantenerse al tanto de los avances en tecnología;
  • Las revistas/editoriales deben informar a los autores sobre irregularidades identificadas por herramientas de IA y darles la oportunidad de responder antes de enviar acusaciones a sus instituciones de acuerdo con las pautas del Comité de Ética de Publicaciones;
  • Las revistas/editoriales que utilizan herramientas de IA para detectar conductas impropias deben examinar todas las presentaciones relevantes y no solo presentaciones seleccionadas al azar/intencionalmente; y
  • Las revistas deben informar a los autores sobre su definición de conducta impropia, su uso de herramientas de IA para detectar conductas impropias y sus políticas y procedimientos para responder a casos sospechosos de conducta impropia.

Declaración de Barcelona. Los investigadores necesitan bases de datos bibliográficas «abiertas»

Barcelona Declaration on Open Research Information

Español

Los investigadores necesitan bases de datos bibliográficas «abiertas», según una nueva declaración Las principales plataformas, como Web of Science, ampliamente utilizadas para generar métricas y evaluar a los investigadores, están protegidas por derechos de propiedad intelectual.


Cuando las universidades están decidiendo a quién contratar y promocionar, o cuando las organizaciones de financiamiento están seleccionando proyectos para financiar, es muy probable que estén consultando más que solo los materiales de solicitud. Muchas organizaciones confían en bases de datos que recopilan información sobre publicaciones, incluidos autores, afiliaciones, citas y fuentes de financiamiento, para crear métricas destinadas a cuantificar la productividad de un investigador y la calidad de su trabajo.

Algunas de las bases de datos más conocidas, como Web of Science y Scopus, son propietarias y ofrecen datos y servicios de acceso pago que respaldan estas y otras métricas, incluidos los rankings universitarios y los factores de impacto de las revistas. Pero en una declaración publicada hoy, más de 30 organizaciones de investigación y financiamiento llaman a la comunidad a comprometerse con plataformas que, en cambio, sean gratuitas para todos, más transparentes sobre sus métodos y sin restricciones sobre cómo se puede utilizar los datos.

La Declaración de Barcelona sobre la Información de Investigación Abierta afirma que «en un momento en que la toma de decisiones en ciencia está cada vez más guiada por indicadores y análisis, abordar los problemas de la información de investigación cerrada debe ser una prioridad absoluta». Los firmantes hasta ahora incluyen a financiadores como la Fundación Bill y Melinda Gates y la Agencia Nacional de Investigación de Francia, así como a más de una docena de instituciones académicas.

La Universidad de la Sorbona, que canceló su suscripción a Web of Science el año pasado y cambió a una plataforma más nueva y abierta llamada OpenAlex, dijo en un comunicado que “al firmar la Declaración, queremos demostrar que no solo este movimiento hacia la información de investigación abierta debería ser un objetivo, sino que también se puede lograr”. El cambio puede ayudar a remediar el enfoque de las bases de datos existentes en las revistas en inglés, dicen los defensores. También podría ayudar a mejorar “la circulación del conocimiento científico y local producido en diferentes idiomas, formatos y en diferentes regiones geográficas”, dice otro signatario, el Consejo Latinoamericano de Ciencias Sociales a través del Foro Latinoamericano para la Evaluación Científica.

Jason Portenoy, ingeniero de datos senior en OurResearch, reconoce esta necesidad de aporte de la comunidad, diciendo que es comprensible que las instituciones puedan dudar en volver a hacer el trabajo. “Pero la diferencia es que con OpenAlex, está sucediendo de manera abierta”, dice. Cualquier brecha en la calidad de los datos se está cerrando rápidamente, agrega Jason Priem, CEO de OurResearch. “OpenAlex está evolucionando muy rápidamente, y a menudo los problemas descubiertos por nuestra comunidad se solucionan en unos pocos meses”. Cuando uno de los coordinadores de la declaración, Ludo Waltman, director científico del Centro de Estudios de Ciencia y Tecnología en la Universidad de Leiden, y colegas recientemente usaron OpenAlex para clasificar más de 1400 universidades en todo el mundo, concluyeron que, aunque necesita mejorar, el enfoque produjo “datos de calidad sorprendentemente buenos”.

Daniel Hook, CEO de Digital Science, que opera la base de datos propietaria Dimensions, acoge esta idea. (Dimensions ya ofrece una versión gratuita para uso no comercial, aunque los usuarios deben suscribirse para acceder a todas las funciones). Sin embargo, Hook dice que tal transición llevará tiempo. Las bases de datos propietarias necesitan recuperar los costos de establecer, mejorar y mantener conjuntos de datos tan grandes, un desafío que los equivalentes abiertos como OpenAlex también podrían enfrentar a largo plazo.

La declaración es un «excelente desarrollo», dice Elizabeth Gadd, experta en comunicaciones académicas y jefa de cultura e evaluación de investigación e innovación en la Universidad de Loughborough, que no estuvo involucrada en su preparación. “Muchas organizaciones han hecho compromisos públicos con prácticas de investigación abierta pero continúan utilizando fuentes de datos bibliográficos cerradas y comerciales para análisis de investigación”. El anuncio debería “estimular a una gama más amplia de organizaciones a ‘poner su dinero donde está su boca’”.

Con ese fin, los partidarios de la declaración esperan establecer una Coalición para la Información de Investigación Abierta para planificar los próximos pasos, dice la coordinadora Bianca Kramer, experta en comunicaciones académicas de la consultora Sesame Open Science. “Queremos facilitar que las organizaciones trabajen hacia esa transición, entre otras cosas, beneficiándose de la experiencia de los demás y explorando la acción colectiva”.

COMPROMISOS


1 – Haremos que la apertura sea la norma para la información de investigación que utilizamos y producimos

  • La apertura será la norma para la información sobre investigación que utilizamos, por ejemplo, para evaluar a investigadores e instituciones, apoyar la toma de decisiones estratégicas y encontrar resultados de investigación relevantes.
  • La apertura será la norma para la información de investigación que produzcamos, por ejemplo, la información sobre nuestras actividades y resultados, con excepción de la información cuya apertura sería inapropiada (‘tan abierta como sea posible y tan
    cerrada como sea necesario’


2. – Trabajaremos con servicios y sistemas que apoyen y hagan posible
la información abierta sobre investigación

  • En cuanto a los servicios y plataformas de publicación, requeriremos que la información de investigación generada en los procesos de publicación (por ejemplo, metadatos de artículos de investigación y otros resultados) esté disponible de forma abierta a través de infraestructuras académicas abiertas, utilizando protocolos e identificadores estándar cuando estén disponibles.
  • En el caso de los sistemas y plataformas para la gestión interna de la información de investigación (por ejemplo, los actuales sistemas de información de investigación), requeriremos que toda la información de investigación pertinente pueda exportarse y hacerse abierta, utilizando protocolos e identificadores estándares cuando estén disponibles.


3. Apoyaremos la sostenibilidad de las infraestructuras para la información abierta sobre investigación

  • Asumimos la responsabilidad de apoyar infraestructuras para la información abierta sobre investigación, por ejemplo participando en la creación de comunidades y en la gobernanza de las mismas y aportando contribuciones justas y equitativas a la estabilidad financiera y al desarrollo de estas infraestructuras.
  • Esperamos que las infraestructuras que apoyamos apliquen buenas prácticas
    de gobernanza comunitaria y sostenibilidad (por ejemplo, los Principios de la
    Infraestructura Académica Abierta).


4. Apoyaremos actuaciones colectivas para acelerar la transición hacia la apertura de la información sobre investigación

  • Reconocemos la importancia de compartir experiencias y coordinar acciones para promover en todo el sistema la transición de cerrada a abierta de la información de investigación.
  • Para facilitarlo, apoyamos la creación de una Coalición para la Información
    Abierta sobre Investigación y el refuerzo de la colaboración con otras iniciativas y organizaciones afines.