Archivo de la etiqueta: Gestión de datos de investigación

Gestión y reutilización de datos en bibliotecas

modesto5jp

Escuchar programa

Ir a descargar

Esta semana con Modesto Escobar, catedrático del Departamento de Sociología y Comunicación de la Facultad de Ciencias Sociales de la Universidad de Salamanca. Modesto ha desarrollado junto a otros investigadores el proyecto What’s in a library catalogue? (¿Qué hay en un catálogo de biblioteca?) analítica visual aplicada al conjunto de datos de la British National Bibliography (BNB) http://www.luismart.es/

Network Coincidence Analysis (NCA) es un marco de análisis visual que utiliza un conjunto robusto de métodos estadísticos, incluyendo el análisis de redes, para estudiar las coincidencias en los datos y poder visualizarlos.

Los retos de la gestión de los datos, información y documentos en la Transformación Digital


whitepaper-td

Palma Villalón, M. d. V. (2016). [e-Book] Libro blanco – Los retos de la gestión de los datos, información y documentos (records management) en la Transformación Digital. Madrid, Revista Transformación Digital |, 2016

Texto completo

Este libro blanco pretende resaltar la importancia de la gestión de los datos, información y documentos (records management) en las empresas e instituciones en la era de la transformación digital ya que en la literatura sobre el tema que se está publicando no se menciona ni se destaca. El desarrollo de las nuevas tecnologías y el auge de publicación de contenidos en las redes sociales facilita el procesamiento de millones de datos e información, el Big Data y el Big Content, que se almacenan mediante la nube en servidores esparcidos por todo el planeta, la consecuencia para las empresas es la dilución de los límites de sus sistemas de información corporativos. Los responsables de gestión de datos, información y evidencias (records) deben enfrentarse a este nuevo escenario que ofrece grandes oportunidades y desafíos en su recolección, organización, tratamiento y preservación. En la era de la transformación digital se han ampliado considerablemente estos tipos de records, sus estructuras, sus formatos, su tamaño y sus límites. Se difuminan las fronteras tradicionales entre datos, información y records.

DataFinder: el catálogo de datos de investigación de la Universidad de Oxford


datafinder-logo

RUMSEY, S. y JEFFERIES, N., 2013. DataFinder: A Research Data Catalogue for Oxford. Ariadne [en línea], no. 71. [Consulta: 7 noviembre 2016]. ISSN 1361-3200. Disponible en: http://www.ariadne.ac.uk/issue71/rumsey-jefferies.

En 2012, el Comité de Investigación de la Universidad de Oxford aprobó una política universitaria sobre la gestión de datos y registros de investigación. Gran parte de la infraestructura para apoyar esta política se está desarrollando bajo el Proyecto Damaro financiado por Jisc. Los nacientes servicios que sustentan la infraestructura de RDM (gestión de datos de investigación) de la Universidad se han dividido en cuatro temas:

  • Planificación de RDM;
  • Gestión de datos en vivo;
  • Descubrimiento y localización;
  • Acceso, reutilización y curación.

El catálogo de resultados de datos dará lugar a un conjunto de metadatos e interfaces que soportan el descubrimiento, la localización, la cita y los informes para los conjuntos de datos de investigación de Oxford. Este concepto de una herramienta que apoye una lista completa de resultados de datos de investigación de la Universidad, junto con la capacidad de encontrar, citar e informar sobre tales resultados, es lo que ha dado lugar a que la Universidad haya desarrollado DataFinder, que será el centro de herramientas y servicios de infraestructura de RDM para la institución. La visión general es que proporcionará el  punto de conexión entre los servicios, técnicos y no técnicos, y las políticas, a través de los cuatro temas enumerados arriba.

figure4-datafinder-prototype-interface-v2

Asi DataFinder proporcionará una lista de resultados de datos de investigación de Oxford, utilizando metadatos que apoyan el descubrimiento y la citación estándar. DataFinder pondrá las herramientas a disposición de los administradores para permitir a la Universidad informar tanto interna como externamente sobre sus resultados de datos de investigación. Para satisfacer estas necesidades de los usuarios, el catálogo ha sido diseñado de tal forma que cubra las necesidades de sus usuarios, cumpliendo con los estándares comunes. Durante el proceso de diseño e implementación, se tomaron varias decisiones sobre el diseño. Inevitablemente, se tuvieron que hacer adaptaciones  para desarrollar un servicio útil y utilizable por parte de investigadores, administradores y otros usuarios.

Recursos:

  1. Policy available at http://www.admin.ox.ac.uk/rdm/(link is external)
  2. Damaro Project http://damaro.oucs.ox.ac.uk/(link is external)
  3. Oxford DMPOnline
    http://www.jisc.ac.uk/whatwedo/programmes/di_researchmanagement/managingresearchdata/dmponline/oxforddmponline.aspx(link is external)
  4. DataStage http://www.dataflow.ox.ac.uk/index.php/about/about-datastage(link is external)
  5. ORDS (Online Research Database Service) http://ords.ox.ac.uk/(link is external)
  6. UK Data Archive (UKDA) http://data-archive.ac.uk/(link is external)
  7. Oxford DataBank [in development] https://databank.ora.ox.ac.uk/(link is external)
  8. FAST (Faceted Application of Subject Terminology) http://fast.oclc.org/searchfast/(link is external)
  9. RCUK Research Classifications http://www.rcuk.ac.uk/research/Efficiency/Pages/harmonisation.aspx(link is external)
  10. JACS Joint Academic Subject Coding
    http://www.hesa.ac.uk/index.php?option=com_content&task=view&id=158&Itemid=233(link is external)
  11. RIOXX http://rioxx.net/(link is external)
  12. CKAN http://ckan.org/(link is external)
  13. ColWiz http://www.colwiz.com/(link is external)
  14. Solr index and search http://lucene.apache.org/solr/(link is external)
  15. Piwik Web analytics http://piwik.org/(link is external)
  16. Fedora Commons http://fedora-commons.org/

What’s in a library catalogue? analítica visual aplicada al conjunto de datos de la British National Bibliography (BNB)


2eaf69_d17ec487ffac431daad4211cee0542cbmv2

http://www.luismart.es/

Network Coincidence Analysis (NCA) es un marco de análisis visual que utiliza un conjunto robusto de métodos estadísticos, incluyendo el análisis de redes, para estudiar las coincidencias en los datos y poder visualizarlos.

Puedes escuchar una entrevista de Radio USAL «Planeta Biblioteca» con el profesor Modesto Escobar, de la Universidad de Salamanca, uno de los desarrolladores de este interesante proyecto para hablarnos sobre el mismo

Este proyecto presenta un método de investigación y una herramienta, denominada Network Coincidence Analysis (NCA) (red de análisis de coincidencia) aplicada al conjunto de datos de la British National Bibliography (BNB) para proporcionar un método que permite profundizar en las relaciones inherentes a los datos, descubrir asociaciones y hacer comparaciones.

El principal resultado de este proyecto son visualizaciones que nos presentan exploraciones interactivas del corpus de la British National Bibliography (BNB) desde diferentes perspectivas y  descubrir nuevas tendencias.

Por ley la British Library mantiene una copia de todas las publicaciones del Reino Unido desde 1662. El conjunto de datos de la BNB es un registro de la actividad editorial del Reino Unido y la República de Irlanda desde la década de 1950.Los datos están disponibles en el sitio web de la Biblioteca Británica en formato RDF LOD y la instantánea del conjunto de datos BNB transformado en CSV para este proyecto está disponible en: http://dx.doi.org/10.7910/DVN/YGHGQB

tumblr_odliimhfec1tdazmho1_1280

 Infografía con un análisis descriptivo básico del conjunto de datos BNB.

NCA con sus métodos de investigación estadística y herramientas interactivas intenta inspirar y capacitar a los estudiosos de distintas disciplinas a utilizar grandes conjuntos de datos, colecciones, especialmente del mundo de las bibliotecas, y técnicas de visualización como parte de su investigación.

La herramienta permite:

  • Personalizar el tamaño, la forma y el aspecto de la red;
  • Filtrado, selección y aislamiento de los nodos y sus vecinos;
  • Exportar los gráficos a PDF y SVG y la descarga de la información sobre los nodos y enlaces.

Por ejemplo existen unos 50.000 libros que contienen temas sobre Europa. Esta red facilita el descubrimiento de la historia de la relación entre el Reino Unido y Europa, y muestra los datos sobre los vínculos históricos entre ellos, tales la importancia de la seguridad nacional durante la época de la guerra fría y el papel de EE.UU., los cambios geopolíticos en Europa del Este, así como los aspectos más actuales de la función de la Unión Europea en la política y el derecho.Ver visualización

También podemos visualizar por ejemplo la evolución de los temas BNB a través del tiempo. Ha habido un aumento en los libros publicados cada década desde los años sesenta. Sin embargo, los temas de las publicaciones han ido cambiando a través del tiempo. Esta red muestra cómo los intereses de las publicaciones han ido cambiando con un enfoque inicial en la ficción, poesía, cuentos y matemáticas en las últimas décadas, como han evolucionado hacia otras disciplinas científicas, como la Economía, la Ciencia y la Administración, así como un extraordinario crecimiento de las publicaciones relacionadas. (Ver visualización)

30577479156_deeedb3557_b_d

Minería de datos de la web social: Facebook, Twitter, LinkedIn, Google +, GitHub, Amazon.es y otros

51vin54vc5l-_sx258_bo1204203200_

Russell, M. A. (2013). [e-Book] Mining the Social Web: Data Mining Facebook, Twitter, LinkedIn, Google+, GitHub, and More: Amazon.es: , O’Reilly Media, 2013.

Texto completo

¿Cómo se puede aprovechar la gran cantidad de datos de la web social para descubrir quién está haciendo conexiones con quién, lo que están hablando, y dónde se encuentran? Con esta edición ampliada y revisada a fondo, aprenderás cómo recopilar, analizar y resumir los datos de todos los rincones de la web social, incluyendo Facebook, Twitter, LinkedIn, Google +, GitHub, correo electrónico, páginas web y blogs.

La importancia de los resultados negativos de una investigación


crushed-by-criticism-vector-image-640x385

En la actualidad, la evaluación de la investigación es una cuestión que se está replanteando en todo el mundo. En algunos casos, los trabajos de investigación están generando resultados muy buenos, en la mayoría de los casos los resultados son mediocres, y en algunos casos negativos. El nuevo entono tecnológico favorece nuevas posibilidades y oportunidades para la publicación, el impacto y la medición de la calidad. Que una obra sea citada no quiere decir que haya sido citada por su alta calidad. Existe un mito sobre las citas negativas, y se dice que cualquiera puede incluir a propósito un error importante en una investigación con el fin de conseguir más citas. Esto que en principio puede ser posible, no lo es en la práctica, ya que se hay estudios que ponen de manifiesto que los investigadores no suelen citar los trabajos con errores; en una investigación que incluía 10.400 artículos científicos, sólo se encontró que los comentarios negativos que acompañan de forma explícita a una cita solo fueron 10. Por lo general si se piensa que un documento es malo, simplemente no se cita.

Pero, con la llegada de la Gestión de Datos de Investigación (GDI), se está dando aún relevancia a los datos procedentes de procesos fallidos o erróneos de una investigación. El intercambio de datos permite a los científicos utilizar, analizar y reproducir los resultados de los demás, con importantes beneficios derivados del intercambio de datos que van más allá de la mera posibilidad de replicación, ya que permiten la comprobación de los métodos nuevos o alternativos, además de la capacidad de utilizar esos datos de una manera que los investigadores originales nunca hubieran previsto. Para cualquier investigador es de vital importancia conocer porque algo no funciono, que falló en concreto o no permitió obtener los resultados esperados de la aplicación de una metodología o un proceso determinado. De ahí que la mayoría de repositorios de datos instan a los investigadores a facilitar todos los datos de una investigación, no sólo los resultados finales como ocurría hasta ahora; por lo que es importante para un investigador conocer porque una determinada metodología no obtuvo los resultados esperados. Para la ciencia es de una valor primordial poder disponer de la información de todo el proceso de investigación, por ello son importantes y necesarios los datos de resultados positivos y/o negativos, incluidos estos últimos que tradicionalmente no han contado para la ciencia, y que ahora son tenidos en cuenta, ya que informan sobre que método no ha funcionado, y porque razón, entre otras cuestiones para no cometer el mismo error o para buscar una alternativa válida. Ya que en término estrictamente económicos, dentro de un proceso de investigación probablemente lo que consume más insumos es la compilación de datos, disponer de todos los datos de las investigaciones precedentes incluidas los datos de investigaciones fallidas es económicamente sostenible para la ciencia.

Ciencia abierta es más que sólo el acceso abierto a las publicaciones o datos; ya que además incluye otros aspectos como las etapas de los procesos de investigación. Intentos fallidos y metodologías de trabajo. Dentro de los movimientos open hay uno denominado Open Notebook Science, que se refiere a la aplicación del concepto de datos abiertos en el proceso científico, incluidos los experimentos fallidos y los datos en bruto.

F1000Research es una plataforma de publicación de la ciencia abierta original que ofrece la posibilidad de publicación inmediata en acceso abierto, transparente y un sistema de revisión por pares posterior a la publicación. Además de ofrecer la posibilidad de depositar y compartir todos los datos subyacentes utilizados en el desarrollo de la investigación. F1000Research no sólo recopila los resultados finales de la investigación, también acepta documentos relativos a casos clínicos, posters, presentaciones, protocolos, repeticiones y resultados nulos o negativos. F1000Research utiliza un proceso dirigido por el autor, facilitando la publicación de todos los documentos relacionados con la investigación científica en un plazo de pocos días, a través de un sistema de revisión post-publicación, centrado en la solidez científica en lugar de en la novedad o en el impacto.

En la actualidad Figshare es un repositorio de datos ciencia abierta con más de 1,5 millones de datos y objetos públicos, se trata de un desarrollo operado por Macmillan Publishers que puso en marcha Mark Hahnel en enero de 2011, y que desde 2013 colabora con PLOS, y también en esa fechas se integró con ImpactStory para apoyar la recolección de datos altmétricos. Figshare es un repositorio digital en línea donde los investigadores pueden preservar y compartir todos los datos y resultados que genera un proceso de investigación, incluyendo figuras, bases de datos, imágenes y vídeos; de este modo cualquier investigador pueden cargar todos estos importantes datos haciéndoles accesibles al público mediante un número DOI que asigna de manera automática a cada set que se genera con la aplicación: y una cuestión muy importante Figshare también permite a los investigadores publicar los datos negativos de una investigación.

Existe una revista Journal of Negative and No Positive Results, dedicada al tema de los resultados negativos de la ciencia. El objetivo de la misma es para dar valor a los investigadores que han contribuido al avance de la ciencia y el conocimiento de diferentes maneras, decisiones e hipótesis.

 La GDI se tienen en cuenta y se aplica a todo el ciclo vital de los datos, y cuenta con todos los datos, abarcando todo el proceso de archivo y difusión de los datos, incluso antes de que los propios datos lleguen a existir.


Geovisualización de grandes volúmenes de datos ambientales: diseño e implementación de un sistema para el acceso y la difusión de datos globales

20150720-congreso-ci-geovisualizacion-1

Álvarez Francoso, J. I., M. F. Pita López, et al. (2016). [e-Book] Geovisualización de grandes volúmenes de datos ambientales: Diseño e implementación de un sistema para el acceso y la difusión de datos globales. Sevilla, Universidad de Sevilla, 2016.

Texto completo

PDF

El dato climático es una representación abstracta que se utiliza para intentar alcanzar un mayor grado de comprensión de una realidad extraordinariamente compleja. De forma paradójica, el formidable crecimiento de la capacidad para registrar y almacenar datos los ha convertido en otra realidad tan compleja, que se revela imprescindible la utilización de sistemas que ayuden a descifrarlos. Uno de los aspectos fundamentales de la información climática es la importancia de su dimensión espacial, que se presta especialmente bien a la exploración mediante herramientas de visualización. Además, el desarrollo de las tecnologías de la información ha propiciado que hoy en día, el número de usuarios interesados que pueden acceder a la información climática haya aumentado también de manera sustancial. Pero el simple acceso no es suficiente para una transmisión efectiva de la información, sino que esta debe organizarse de manera adecuada y acompañarse de los medios y herramientas para su exploración y comunicación. En este sentido, la geovisualización web juega un papel fundamental. Esta tesis doctoral hace una aportación en el campo de la geovisualización web de datos climáticos haciendo en primer lugar una revisión de los principales aspectos de la misma: los datos, los sistemas de geovisualización y los usuarios; y proponiendo posteriormente una metodología para el diseño e implementación de dos sistemas abiertos para la geovisualización web de datos climáticos a dos escalas: global y regional. Los resultados demuestran la efectividad de la metodología propuesta, basada en un adecuado diseño, tanto del modelo de datos en el que se sustentan los sistemas, como de los flujos de los procesos implicados en el funcionamiento de los mismos.

La biblioteca de la Universidad de Michigan lanza Deep Blue Data un respositorio de servicios de datos de investigación

29312939863_9ee9e7673a_o_d

Deep Blue Data

La biblioteca de la Universidad de Michigan ha puesto en marcha un conjunto de servicios, así como un repositorio que incluye la planificación, creación, organización, intercambio y preservación de los datos de investigación para apoyar la tarea de los investigadores a lo largo de todas las fases del ciclo de vida de datos de investigación.


Los conjuntos de datos que subyacen a los resultados de la investigación son cada vez más demandados. Los organismos de financiación exigen que los datos de la investigación sean visibles, accesibles y conservado para su uso futuro. Los editores piden conjuntos de datos para ser incluidos junto de publicaciones como archivos suplementarios para apoyar los resultados de la investigación. Los investigadores buscan conjuntos de datos existentes para poner a prueba las nuevas teorías o generar nuevos descubrimientos.

Deep Blue Data es un repositorio que proporciona servicios de acceso y conservación de los datos digitales de investigación para apoyar las actividades de investigación en la U-M. El objetivo de este proyecto es fundamental maximizar los beneficios de los 1.3 mil millones de dólares que gastan anualmente los investigadores U-M, y para asegurar el cumplimiento con el creciente número de mandatos de gestión y distribución de datos recomendados por el gobierno y otros proveedores de fondos.

Para ello el personal, formado fundamentalmente por bibliotecarios de referencia, se ha formado y ha desarrollado un programa de planes de gestión de datos, esquemas de metadatos, sistemas de acceso y publicación, visualización y preservación para una variedad amplia de conjuntos de datos. Deep Blue ofrece una nueva plataforma especializada para conjuntos de datos que permite a los investigadores U-M cumplir con los mandatos de intercambio de datos y lograr sus objetivos de hacer que sus conjuntos de datos de investigación sean más fácilmente reutilizados por los propios colegas de todo el mundo y que los investigadores de la U-M sean más visibles;  ya que el sistema asigna un Identificador de Objetos Digitales (DOI) por cada depósito, por lo que es fácil que otros investigadores les citen y dispongan de una identificación persistente y adecuada de sus datos de investigación.


Informe sobre la publicación de datos de investigación en Humanidades

dariah-eu-logo-cmyk-1-1

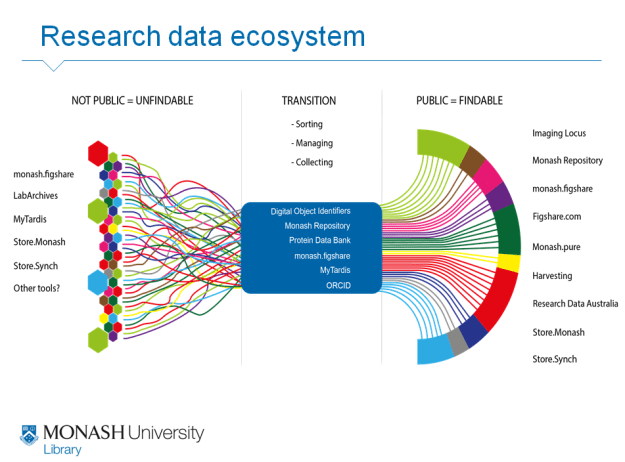
research-data-management-in-the-humanities-and-social-sciences-9-638

Buddenbohm, S., N. Cretin, et al. [e-Book] State of the art report on open access publishing of research data in the humanities, Paris: DARIAH, 2016.

Texto completo

Annex 1: A comparison of infrastructures for publishing research data

Annex 2
State-of-the-art open access research data for the Humanities in
FRANCE

La publicación de datos de la investigación abiertos aún no es una práctica común para los investigadores de artes y humanidades, que van a la zaga de otras áreas científicos como las ciencias. Incluso cuando los investigadores en humanidades publican sus datos en repositorios, estos datos a menudo son difíciles de encontrar y utilizar por parte de otros investigadores.

El objetivo del proyecto DARIAH  es desarrollar una plataforma abierta de datos de investigación en Humanidades para las Humanidades. El trabajo forma parte de un esfuerzo conjunto de instituciones en el que colaboran Data Archiving and Networked Services (DANS), Centre National de la Recherche Scientifique (CNRS) y University of Göttingen – State and University Library (UGOE-SUB).

Este informe proporciona información y orientación sobre la publicación de datos de investigación en humanidades. Siendo el resultado de un estudio teórico sobre el estado actual de la investigación sobre datos y sobre los retos específicos que presenta esta área de conocimiento. Para ello se da una visión general de los diferentes actores involucrados y se analizan las ventajas y obstáculos que conlleva compartir datos de investigación en humanidades. finalmente, se hace una descripción de los repositorios de datos europeos, así como un análisis comparado de las normas de certificación de repositorios de datos digitales de confianza. También se analizan los diversos aspectos que se han de tener en cuenta en torno a la publicación de datos de la investigación en humanidades, las definiciones de conceptos clave, y se describen las fases del ciclo de vida de los datos de investigación, destacando la importancia de la citación de datos para el adecuado intercambio de datos abiertos en función de las diferentes normas sobre el uso de metadatos en Humanidades. Finalmente, se aportan ejemplos de buenas prácticas de los sistemas de datos de investigación en la disciplina.


La gestión de datos de investigación en el horizonte de las bibliotecas universitarias y de investigación

Alonso-Arévalo, Julio. La gestión de datos de investigación en el horizonte de las bibliotecas universitarias y de investigación. Cuadernos de Documentación Multimedia, vol 30 (2019)

Texto completo


La  sociedad  TIC  necesita, hace uso y proporciona de una enorme cantidad de datos; procesarlos, entenderlos y transformarlos en decisiones de valor es el reto del análisis de los llamados «big data», un término utilizado para referirse a la explosión de una ingente  cantidad  y  diversidad  de  datos  digitales  de  alta  frecuencia,  que se  están convirtiendo   en   un   elemento   esencial   para   la   competencia,   y   en   un   futuro inmediato, y que  según la mayoría de los expertos en el tema serán  clave  para  el crecimiento  de  la  productividad, la  innovación  y  la posibilidad de generar el suficiente excedente para las sostenibilidad de la sociedad. Y la gestión de los datos de  investigación  (Big  Data)  se  plantea  como  uno  de  los grandes  retos  que  han  de asumir  durante  los  próximos  años  las  bibliotecas  científicas y de investigación. Ya la mitad de las universidades estadounidenses tienen un plan de trabajo sobre esta cuestión, todos los informes de tendencias están de acuerdo en que la Gestión de Datos de Investigación (RDM) será una de las cuestiones prioritarias y de futuro que deberán asumir las bibliotecas de investigación. En esta comunicación se hace un análisis del estado de la cuestión sobre la gestión de datos de investigación, normativa, repositorios de datos, prácticas y políticas que están desarrollando las bibliotecas en torno al tema.

30858575265_da704657c4_o_d

Palabras clave: Bibliotecas universitarias, Research data management (RDM), Big Data, Tendencias, Futuro. Gestión de datos de investigación, Acceso abierto

29243229574_ff72a6d2a5_c_d