Archivo de la etiqueta: Investigación

¿Qué es la propiedad digital?: en la era digital la propiedad debe significar algo

Carta

El 7 de mayo de 2025, la organización Public Knowledge, junto con otras 16 entidades defensoras del interés público, los derechos del consumidor y las bibliotecas, envió una carta al presidente de la Comisión Federal de Comercio (FTC), Andrew Ferguson, solicitando que se establezcan reglas claras sobre lo que significa ser propietario de bienes digitales.

Las organizaciones sostienen que “la propiedad debe significar algo en la era digital” y que si una transacción no incluye los derechos esenciales de uso, conservación y transferencia, no debería promocionarse como una venta. Denuncian que muchas plataformas digitales anuncian “ventas” cuando en realidad solo ofrecen licencias revocables, sin informar claramente al consumidor hasta después de la compra, lo que consideran una distorsión de las expectativas tradicionales sobre la propiedad.

La carta propone que la FTC defina legalmente qué constituye una “venta digital” e incluya tres derechos fundamentales:

  • Derecho de uso: acceso continuo al producto digital, incluso si la tienda cierra o el servicio finaliza.
  • Derecho de conservación: posibilidad de respaldar, reparar o archivar el producto adquirido, incluso sin soporte oficial.
  • Derecho de transferencia: libertad para regalar, prestar, revender o legar el bien digital, tal como se hace con objetos físicos.

Finalmente, las organizaciones aclaran que no buscan prohibir los modelos de licencia, pero sí exigen que no se etiquete como «venta» aquello que no garantiza estos derechos, en aras de la transparencia, honestidad y recuperación de la confianza del consumidor en los mercados digitales.

Perspectivas disciplinarias y metodológicas en el estudio de revistas científicas mexicanas del siglo XX

Garza, Dalia Valdez, Rodrigo Antonio Vega y Ortega Báez, y María Elena Ramírez de Lara, coords. Perspectivas disciplinarias y metodológicas en el estudio de revistas científicas mexicanas del siglo XX. Primera edición. Ciudad de México: Universidad Nacional Autónoma de México, Instituto de Investigaciones Bibliográficas, 2023.

Texto completo

En esta obra colectiva se brinda un panorama para el estudio de las revistas científicas mexicanas del siglo XX editadas en formato impreso, muchas de ellas elaboradas todavía en contextos ajenos a la especialización y profesionalización de las labores editoriales, a la «democratización de la edición y del diseño» y a métricas de evaluación, aspectos que, entre otros, caracterizan el actual paradigma digital de publicación periódica en la ciencia. Esto quiere decir que quizá las revistas científicas manufacturadas sin computadoras y por profesionales de las ciencias (con conocimientos editoriales) merezcan un tratamiento aparte. Los autores aportan herramientas para el diseño de proyectos de investigación en este tema, desde una «práctica integrativa» y con perspectiva histórica, producto de la consideración de una «revista» como un dispositivo cultural que sus creadores ponen en escena en la sociedad con todos sus componentes y discursos en simultaneidad. Se hace un repaso por diversas perspectivas disciplinarias para su estudio; también se ofrecen ejemplos de cómo estudiar partes específicas de su estructura, desde los paratextos hasta las encuadernaciones en que son preservadas, y se evidencia el potencial para su estudio mediante una muestra inicial por disciplinas de estas revistas. Con todo ello, se pretende dar impulso a una serie de nuevos estudios en los que las revistas científicas mexicanas del siglo XX sean las protagonistas, con renovados acercamientos marcadamente interdisciplinarios, con metodologías integradoras de prácticas del pasado y con la innovación que se genera en los estudios de las humanidades y las ciencias sociales.

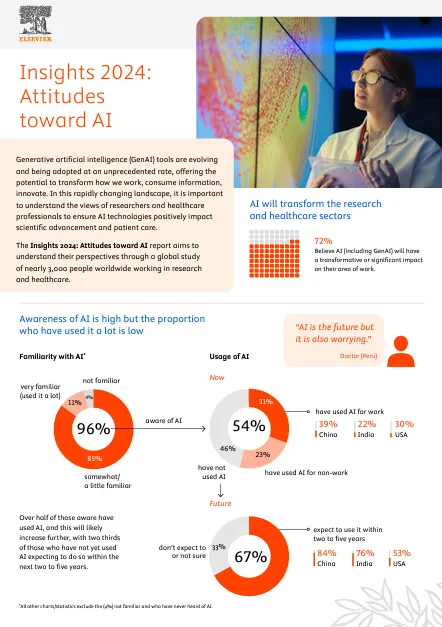
Actitudes hacia la IA 2024 revela que investigadores y clínicos creen en el potencial de la IA pero exigen transparencia para confiar en las herramientas

Elsevier. «The Insights 2024: Attitudes toward AI Report Reveals Researchers and Clinicians Believe in AI’s Potential but Demand Transparency in Order to Trust Tools.» 9 de julio de 2024.

Informe

Ver infografía

El estudio de Elsevier subraya que, aunque existe un reconocimiento generalizado del potencial de la IA para transformar la investigación y la atención médica, su adopción efectiva depende de abordar preocupaciones clave relacionadas con la transparencia, la calidad del contenido y la confianza en las herramientas. Para que la IA sea plenamente aceptada e integrada en estos campos, es esencial garantizar que las herramientas sean desarrolladas y utilizadas de manera ética y responsable

El informe «Insights 2024: Actitudes hacia la IA» de Elsevier ofrece una visión detallada sobre cómo investigadores y profesionales de la salud perciben la inteligencia artificial (IA) en sus campos. Basado en una encuesta a 3,000 participantes de 123 países, el estudio revela tanto el entusiasmo por las oportunidades que brinda la IA como las preocupaciones que genera su implementación.

Potencial percibido de la IA

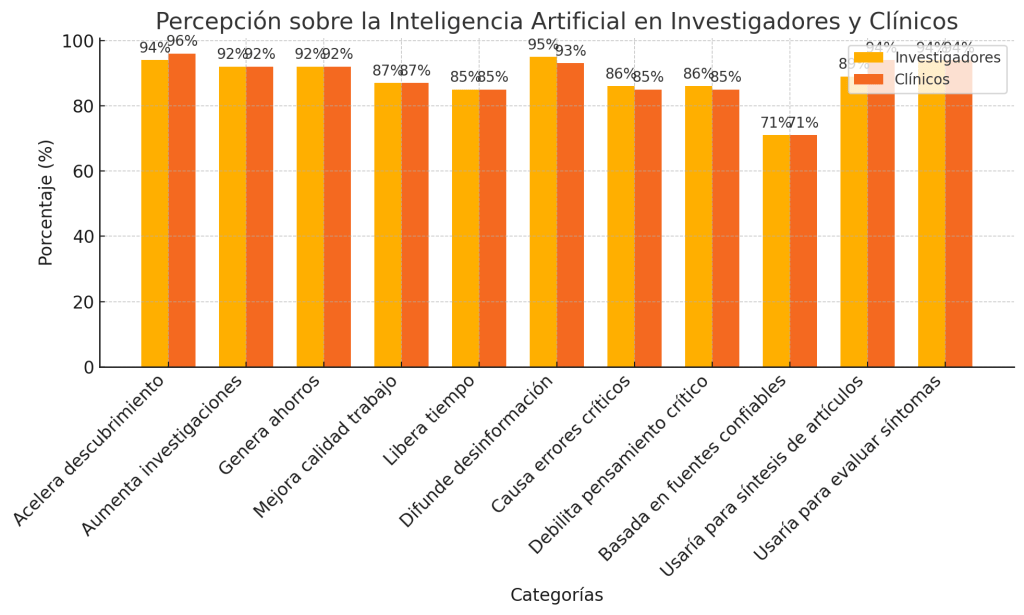
Una mayoría significativa de investigadores (94%) y clínicos (96%) cree que la IA puede acelerar el descubrimiento de conocimientos. Además, el 92% de ambos grupos anticipa que la IA aumentará rápidamente el volumen de investigaciones académicas y médicas, así como generará ahorros de costos para instituciones y empresas. El 87% considera que la IA mejorará la calidad general del trabajo, y el 85% piensa que liberará tiempo para enfocarse en proyectos de mayor valor

Preocupaciones sobre la desinformación y la confianza

A pesar del optimismo, existen inquietudes significativas. El 95% de los investigadores y el 93% de los clínicos temen que la IA se utilice para difundir desinformación. Asimismo, el 86% de los investigadores y el 85% de los clínicos creen que la IA podría causar errores críticos, y una proporción similar expresa preocupación por el debilitamiento del pensamiento crítico debido a la dependencia excesiva de estas herramientas

Necesidad de transparencia y contenido confiable

Los encuestados enfatizan la importancia de que las herramientas de IA se basen en contenido de alta calidad y confianza. El 71% espera que los resultados de herramientas dependientes de IA generativa se basen únicamente en fuentes confiables. Además, si las herramientas de IA están respaldadas por contenido confiable, controles de calidad y principios de IA responsable, el 89% de los investigadores las utilizaría para generar síntesis de artículos, y el 94% de los clínicos las emplearía para evaluar síntomas e identificar condiciones o enfermedades

Variaciones geográficas en la adopción de la IA

El informe también destaca diferencias regionales en la familiaridad y uso de la IA. Por ejemplo, en China, el 39% de los encuestados ha utilizado activamente la IA para propósitos laborales, mientras que en India esta cifra es del 22%. Solo el 11% de los participantes se considera muy familiarizado con la IA o la utiliza con frecuencia. Sin embargo, el 67% de quienes no han utilizado la IA esperan hacerlo en los próximos dos a cinco años, con China (83%) e India (79%) superando significativamente a EE. UU. (53%) en estas expectativas .

Declaración de posición de Wiley sobre el uso ilegal de contenidos con derechos de autor por parte de desarrolladores de IA

Wiley Position Statement on Illegal Scraping of Copyrighted Content by AI Developers. Última modificación en 2024. https://www.wiley.com/en-us/terms-of-use/ai-principles/wiley-statement-illegal-scraping-ai-copyright.

En Wiley, defendemos el valor de la propiedad intelectual y de quienes la crean. Como pioneros en la creación y difusión del conocimiento durante más de dos siglos, estamos comprometidos a garantizar que las obras de los autores sean respetadas y adecuadamente licenciadas en el cambiante entorno digital. La colaboración entre autores, sociedades científicas y académicas, y desarrolladores de IA garantiza un uso responsable de esta tecnología para avanzar en la investigación y el descubrimiento, al tiempo que se preserva la libertad académica, esencial para el progreso científico.

Reafirmamos esta postura. Creemos en el potencial transformador de la inteligencia artificial para impulsar la investigación y el descubrimiento. Este avance debe basarse en el respeto a los derechos de propiedad intelectual, incluida la compensación y atribución acordadas para los creadores de contenido. Nos posicionamos firmemente junto a nuestros autores y socios editoriales para exigir prácticas éticas y legales en la obtención de datos en la industria de la IA, y alentamos la adopción generalizada de prácticas de licenciamiento adecuadas, como ya hacen algunos desarrolladores de IA.

Para mayor claridad:

  • Los desarrolladores y empresas de IA deben obtener autorización antes de usar contenido de Wiley, o contenido que publicamos para nuestros socios, para el desarrollo, entrenamiento o implementación de IA.
  • Wiley ha reservado de forma constante y pública todos los derechos sobre sus materiales protegidos por derechos de autor; no existe permiso implícito sin una licencia adecuada.
  • La atribución transparente y la trazabilidad de los datos son componentes esenciales del desarrollo ético de la IA.
  • Para demostrar nuestro compromiso con la innovación responsable, hemos desarrollado marcos de licenciamiento que ofrecen condiciones flexibles y justas adaptadas a distintos usos y necesidades de desarrollo.

Se han alcanzado numerosos acuerdos reconocidos entre desarrolladores de IA y editoriales académicas y comerciales, incluidos nuestros propios acuerdos exitosos con desarrolladores de IA que comparten nuestro compromiso con el uso ético del contenido. Esto demuestra claramente que existe un mercado de licencias para IA que funciona eficazmente.

Este mercado de licencias también permite fundamentar la IA en contenido autorizado. La colaboración activa con la comunidad de IA incluye la incorporación de expectativas y estándares en los acuerdos sobre transparencia, citación, atribución y procedencia de datos, con el fin de fomentar la confianza de los usuarios en los sistemas de IA.

A través de alianzas con autores, socios editoriales, investigadores y desarrolladores de IA éticos, podemos crear un ecosistema sostenible que valore tanto el avance tecnológico como las contribuciones humanas únicas de autores e investigadores.

Motores de búsqueda académicos con IA

Lim, Aaron Tay. “Testing AI Academic Search Engines (1).” Musings about Librarianship (blog), March 2025. https://musingsaboutlibrarianship.blogspot.com/2025/03/testing-ai-academic-search-engines-1.html

Este artículo es el primero de una serie dedicada a desarrollar un marco para evaluar motores de búsqueda académicos impulsados por inteligencia artificial (IA). El autor destaca que, antes de establecer métodos de evaluación, es esencial definir claramente qué se entiende por “motor de búsqueda académico con IA”. Sin una definición precisa, las comparaciones entre herramientas pueden resultar vagas o engañosas.

Los motores de búsqueda académicos con inteligencia artificial (IA) son herramientas diseñadas específicamente para facilitar el acceso, la comprensión y la organización del conocimiento científico. A diferencia de los buscadores tradicionales que se limitan a localizar documentos mediante coincidencias literales de palabras clave, estos motores aplican tecnologías avanzadas de IA para ofrecer resultados más pertinentes y comprensivos, adaptándose mejor a las necesidades de investigadores, estudiantes y profesionales académicos.

Estos motores integran IA de diversas formas, incluyendo:

  • Búsqueda semántica (más allá de los métodos tradicionales de palabras clave).
  • Generación de respuestas directas con citas mediante técnicas como RAG (Retrieval Augmented Generation).
  • Resúmenes automáticos de documentos.
  • Síntesis de estudios en matrices o tablas.
  • Identificación de autores clave, artículos fundamentales y tendencias emergentes.

Una de sus principales características es la búsqueda semántica, que permite interpretar la intención detrás de una consulta más allá de las palabras exactas empleadas. Esto significa que pueden entender sinónimos, relaciones conceptuales y contextos temáticos, lo que mejora significativamente la relevancia de los resultados. Además, muchos de estos sistemas utilizan técnicas como RAG (Retrieval Augmented Generation) para generar respuestas directas a preguntas específicas, acompañadas de citas de fuentes relevantes, lo cual agiliza el proceso de revisión de la literatura.

Otra capacidad destacada es la de elaborar resúmenes automáticos de artículos académicos, extrayendo la información clave de textos largos y complejos para facilitar su comprensión rápida. También pueden sintetizar hallazgos de múltiples estudios en tablas comparativas o matrices, lo cual es especialmente útil para revisiones sistemáticas o estudios de meta-análisis. Por último, estos motores son capaces de identificar autores influyentes, artículos fundamentales y tendencias emergentes en distintas áreas del conocimiento, contribuyendo así a una mejor navegación por el creciente universo de la literatura científica.

El autor propone clasificar las herramientas en cuatro grandes grupos.

  1. Motores de búsqueda académicos con IA como Elicit.com, Scite assistant*, Consensus, Scopus AI, Primo Research Assistant, Perplexity.ai. Estas herramientas están diseñadas específicamente para la búsqueda académica y utilizan modelos de lenguaje de última generación para generar respuestas con citas, permitir consultas en lenguaje natural y combinar búsquedas semánticas con técnicas de recuperación de información.
  2. Modelos de lenguaje con capacidad de búsqueda, como ChatGPT, Microsoft Copilot, Geinmi, Claude, DeepSeek, Grok. Aunque estos sistemas pueden responder a preguntas sobre temas académicos, su objetivo principal no es funcionar como buscadores científicos. A menudo generan respuestas que no provienen de una búsqueda real, lo que puede derivar en errores o invenciones, conocidas como “alucinaciones”.
  3. Sistemas de mapeo bibliográfico basados en citas, como Connected Papers, ResearchRabbit, Litmaps*, Citation Gecko, Incitefu. Estas herramientas no funcionan como buscadores tradicionales, sino como sistemas de recomendación que, a partir de uno o varios documentos “semilla”, generan mapas visuales de literatura relacionada utilizando relaciones de citación entre artículos.
  4. Herramientas de asistencia a la escritura académica, como Keenius, Jenna,ai. Estas aplicaciones están orientadas a ayudar a redactar textos científicos, ofreciendo sugerencias de redacción con base en citas reales, y suelen incorporar interfaces de escritura más parecidas a un procesador de texto que a un motor de búsqueda.

Descripción de cada herramienta:

Elicit: Un asistente de investigación que ayuda a analizar y sintetizar información de artículos académicos, acelerando tareas como la extracción de datos y la creación de revisiones sistemáticas.

Scite Assistant: Una herramienta que contextualiza citas académicas, destacando si apoyan o contradicen un argumento, ideal para revisiones de literatura.

Consensus: Un asistente que utiliza IA para responder preguntas basadas en evidencia científica, extrayendo información de artículos académicos.

Scopus AI: Basado en la base de datos Scopus, esta herramienta genera resúmenes y revisiones de literatura académica.

Primo Research Assistant: Aunque no encontré información específica, parece ser un asistente enfocado en la investigación académica.

Perplexity.ai: Un motor de búsqueda que utiliza IA para responder preguntas con explicaciones claras y referencias.

ChatGPT: Un modelo de lenguaje desarrollado por OpenAI que puede generar texto, responder preguntas y realizar tareas creativas.

Microsoft Copilot: Tu compañero de IA creado por Microsoft, diseñado para ayudarte en tareas de productividad, creatividad y aprendizaje.

Geinmi: La propuesta de Meta para la IA

Claude: Un asistente de IA desarrollado por Anthropic, enfocado en conversaciones naturales y tareas complejas.

DeepSeek: La web de IA China

Grok: modelo de inteligencia artificial generativa (IA) creado por xAI, la empresa de Elon Musk, que se utiliza como un asistente de IA en X.

Connected Papers: Una herramienta para explorar conexiones entre artículos académicos y descubrir investigaciones relevantes.

ResearchRabbit: Ayuda a encontrar y organizar artículos académicos relacionados con un tema específico.

Litmaps: Una herramienta para visualizar y rastrear la evolución de la investigación académica a través de mapas de citas.

Citation Gecko: Permite explorar redes de citas para encontrar artículos relevantes.

Inciteful: Una herramienta para analizar redes de citas y descubrir investigaciones relacionadas.

Keenius: No encontré información específica sobre esta herramienta.

Jenna.ai: Jenni AI es una herramienta de inteligencia artificial que asiste en la redacción académica

Lens.org: Una plataforma para buscar y analizar patentes y literatura académica.

OpenAlex: Una base de datos abierta que proporciona información sobre artículos académicos, autores e instituciones.
Cómo el negocio editorial compromete la integridad académica

Montgomery, Lucy, Emilia C. Bell, y Karl Huang. 2025. “Academic Publishing Is a Multibillion-Dollar Industry. It’s Not Always Good for Science.” The Conversation, March 20, 2025. https://theconversation.com/academic-publishing-is-a-multibillion-dollar-industry-its-not-always-good-for-science-250056

La publicación académica se ha convertido en una industria multimillonaria que, según algunos expertos, ya no sirve prioritariamente a los intereses de la ciencia, sino a los del mercado. Se examina críticamente cómo las prácticas comerciales de las grandes editoriales afectan a la calidad de la investigación, a la accesibilidad del conocimiento y a la integridad del proceso científico.

Uno de los casos recientes más notorios que ejemplifica esta problemática es el del comité editorial de la revista Journal of Human Evolution, cuyos miembros dimitieron en masa en diciembre de 2024 tras acusar a la editorial Elsevier de prácticas inadecuadas. Denunciaron ediciones pobres, el uso indebido de inteligencia artificial en procesos editoriales y tarifas excesivas para acceder a los artículos. Este caso no es aislado: episodios similares se han producido en revistas de otros campos, lo que evidencia un conflicto creciente entre editores académicos y las editoriales comerciales.

La industria editorial académica, que surgió como un esfuerzo comunitario tras la Segunda Guerra Mundial, está ahora dominada por un pequeño grupo de grandes corporaciones como Elsevier, Springer Nature y Wiley. Estas empresas controlan aproximadamente la mitad de todas las publicaciones científicas y obtienen márgenes de beneficio cercanos al 40%, superiores incluso a los de gigantes tecnológicos como Google o Apple. Esto es posible gracias a un modelo de negocio en el que los investigadores escriben y revisan artículos sin recibir remuneración, mientras las universidades y bibliotecas deben pagar cuantiosas sumas para acceder a los contenidos que ellas mismas ayudaron a producir.

Este sistema también impacta en la calidad y el propósito de la ciencia. La presión por publicar en revistas de alto impacto ha provocado una avalancha de estudios apresurados o de escasa relevancia. Además, han proliferado las llamadas “revistas depredadoras”, que aceptan artículos sin una revisión rigurosa a cambio de dinero, lo que debilita la confianza pública en la ciencia y complica la identificación de investigaciones serias.

Ante este panorama, algunos sectores académicos están promoviendo modelos alternativos de publicación científica. Uno de ellos es el modelo «publicar-revisar-curar», que propone publicar primero los artículos como preprints, someterlos después a una revisión abierta y generar finalmente informes de evaluación que puedan ser consultados públicamente. Este sistema busca agilizar el acceso al conocimiento, mejorar la transparencia del proceso y reducir el control monopolístico de las grandes editoriales.

Por otra parte, aunque el modelo de acceso abierto pretende democratizar el conocimiento, en la práctica muchas veces supone un traslado de costes: en lugar de pagar por leer, los investigadores deben pagar por publicar. Esto impone nuevas barreras económicas, especialmente en regiones o instituciones con menos recursos, y genera una desigualdad en la participación científica global.

Repensar la forma de publicar para apoyar la ciencia abierta

Kiermer, Véronique, Alison Mudditt, and Niamh O’Connor. «Rethinking How We Publish to Support Open Science.» Leap: The Journal of Open Science 1, no. 1 (2025): 1-15. https://doi.org/10.1002/leap.2006

Se analiza cómo las publicaciones científicas pueden avanzar hacia un modelo que apoye la ciencia abierta. La clave de este cambio radica en ampliar la gama de contribuciones a la investigación que se muestran y reutilizan, lo cual permitirá una mayor diversidad de participantes y perspectivas, esenciales para una investigación confiable.

La llegada de la era digital ha transformado la manera en que creamos y consumimos información. En el ámbito de la investigación, este cambio abre nuevas oportunidades para practicar la ciencia abierta, permitiendo que una gama más amplia de contribuciones sea visibilizada y reutilizada. Aunque este avance se predijo cuando los primeros diarios aparecieron en línea, ha tardado más de lo esperado en materializarse. Los flujos de trabajo de la investigación han cambiado significativamente en las últimas décadas gracias a la capacidad de recopilar grandes cantidades de datos, analizarlos con más potencia computacional y colaborar en línea. Sin embargo, la publicación científica ha quedado rezagada. Aunque los artículos se procesan y distribuyen mayoritariamente de forma digital, los flujos de trabajo y conceptos fundamentales de la publicación siguen siendo vestigios de la era de la impresión.

Este estancamiento debe cambiar, ya que las revistas han servido históricamente como garantes de la calidad mediante la supervisión editorial y la revisión por pares. Sin embargo, las normas del siglo XX se basaban en un modelo que solo permitía la publicación de aquellos autores con credenciales conocidas. Este enfoque es obsoleto, y comunicar la investigación en la actualidad requiere una ampliación de esta visión. Es necesario repensar cómo evaluamos, compartimos y descubrimos la investigación, todo ello dentro de un ecosistema de ciencia abierta.

La importancia de la ciencia abierta

La ciencia abierta no se trata solo de hacer que un artículo sea accesible, sino de proporcionar el contexto necesario para comprenderlo, los recursos para replicar el trabajo y las herramientas para colaborar y mejorar la ciencia. Uno de los aspectos esenciales de la ciencia abierta es la ampliación de la participación en la creación, difusión y reutilización del conocimiento. Este modelo permite que más investigadores y otras partes interesadas se beneficien de la creación de conocimiento, algo que se alinea con el informe de la Academia Nacional de Ciencias de EE.UU., el cual señala que la ciencia realizada de manera abierta y transparente tiene más probabilidades de producir conocimientos confiables. La transparencia y la apertura son cruciales para garantizar que la investigación resista el escrutinio, así como para permitir que los mecanismos autocorrectivos de la ciencia funcionen eficazmente.

El informe de la UNESCO sobre Ciencia Abierta también refuerza este enfoque, al destacar la necesidad de diversidad en la participación, lo cual contribuye a una creación de conocimiento más confiable y efectiva. Para lograr una ciencia abierta efectiva, se deben abrir las puertas a una mayor variedad de perspectivas, tal como lo sugieren investigadores como Naomi Oreskes, quien defiende que la diversidad de comunidades de búsqueda de conocimiento es fundamental para alcanzar un conocimiento objetivo.

Obstáculos para la ciencia abierta

A pesar de los avances en el acceso abierto y las políticas de ciencia abierta, todavía existen importantes obstáculos. Uno de ellos radica en el hecho de que la publicación sigue centrada en los artículos, un vestigio del paradigma impreso que no valora de igual manera otros tipos de resultados de investigación, como los datos, los códigos y los protocolos. A pesar de que el porcentaje de artículos con declaraciones de disponibilidad de datos ha aumentado, la mayoría de los datos aún están disponibles solo «a solicitud» o a través de archivos de información adicional asociados a los artículos. El principal impedimento para compartir datos abiertos es la falta de reconocimiento y crédito para los investigadores que hacen estos datos accesibles. Para que la ciencia abierta se adopte de manera generalizada, es necesario que los diferentes tipos de resultados de investigación sean reconocidos, accesibles y acreditados adecuadamente.

Otro obstáculo importante es el modelo de negocio basado en las tarifas por publicación (APCs), que aunque ha facilitado el acceso abierto, excluye a muchos investigadores e instituciones que no pueden permitirse estos costos. A pesar de que se han implementado modelos no basados en APC, como el modelo de Publicación de Acción Comunitaria de PLOS, estos no son fácilmente escalables. Además, el modelo de APC sigue siendo dominante y muchas veces favorece a las grandes editoriales, perpetuando las desigualdades en el acceso al conocimiento.

El rol de los editores en la investigación

Los editores desempeñan un papel crucial en el ecosistema de la investigación, contribuyendo a la creación de conocimiento e innovación en varias etapas clave, como el financiamiento, la actividad investigadora, la difusión de los resultados y la innovación. A lo largo del ciclo de investigación, los editores facilitan la colaboración, el debate, la evaluación de calidad y la preservación de los resultados. Aunque el sistema de evaluación tradicional mediante revisión por pares sigue siendo importante, los editores deben adaptarse a nuevos modelos que respalden una ciencia abierta, permitiendo la vinculación y el descubrimiento de una variedad de contribuciones más allá de los artículos tradicionales.

Catalizando el cambio desde dentro de la publicación

El cambio hacia un modelo de ciencia abierta es un desafío complejo que requiere la colaboración de múltiples actores. PLOS, una organización pionera en este campo, ha comenzado un proyecto de Investigación y Diseño para definir los elementos clave de un nuevo modelo de publicación que se base en los principios de la ciencia abierta, con un modelo de negocio sostenible. Este proyecto incluye una consulta con diversos actores del ecosistema de investigación para garantizar que las soluciones propuestas sean inclusivas y accesibles para una amplia gama de investigadores e instituciones, especialmente en el contexto de las disparidades globales.

A través de esta iniciativa, PLOS espera catalizar un cambio sistémico en la publicación científica, promoviendo un modelo más inclusivo y accesible que permita la participación activa de más comunidades en la creación y difusión del conocimiento.

Desafíos específicos que plantea la inteligencia artificial en la ética de la investigación

Bouhouita-Guermech, Sarah, Patrick Gogognon, y Jean-Christophe Bélisle-Pipon. 2023. «Specific Challenges Posed by Artificial Intelligence in Research Ethics.» Frontiers in Artificial Intelligence 6. https://doi.org/10.3389/frai.2023.1149082.​

Se abordan los retos que plantea la inteligencia artificial (IA) en el contexto de la ética Los sistemas de inteligencia artificial, cada vez más presentes en entornos científicos, están modificando la manera en que se desarrolla y evalúa la investigación, pero los comités de ética responsables de supervisarla no siempre están preparados para comprender ni gestionar adecuadamente estos cambios. La investigación explora hasta qué punto los comités de ética en investigación están capacitados para enfrentar los desafíos específicos que introduce la IA.

Uno de los principales problemas éticos identificados es la opacidad de los modelos de IA, especialmente aquellos que emplean aprendizaje automático profundo. Muchos de estos sistemas funcionan como “cajas negras”, en las que ni los propios desarrolladores pueden explicar con claridad cómo se han generado ciertos resultados. Esta falta de transparencia es especialmente crítica en el ámbito de la investigación, donde la justificación de los métodos y la reproducibilidad son principios fundamentales. Si no se puede explicar cómo funciona un sistema de IA utilizado para analizar datos o generar conclusiones, resulta muy difícil evaluar la validez científica y ética del estudio.

Otro desafío relevante es la atribución de responsabilidad. A medida que se incorporan algoritmos de IA en decisiones que afectan a seres humanos —por ejemplo, en estudios sobre salud, comportamiento o justicia social— se diluye la línea de responsabilidad entre los investigadores, los programadores, las instituciones y los propios sistemas autónomos. ¿Quién debe rendir cuentas cuando una decisión automatizada causa un daño o una injusticia? Esta cuestión complica enormemente la evaluación ética, ya que los marcos tradicionales asumen que detrás de cada decisión humana hay un agente moral claramente identificable.

También se analizan en profundidad las implicaciones de la IA sobre la privacidad y el consentimiento informado. Los sistemas de IA a menudo requieren grandes volúmenes de datos para entrenarse y operar, lo que puede poner en riesgo la privacidad de los participantes en los estudios. Además, en muchos casos, los participantes no comprenden plenamente cómo se utilizarán sus datos ni qué tipo de inferencias pueden derivarse de ellos, lo que pone en entredicho la validez del consentimiento informado. Este problema se agudiza cuando los datos son reutilizados con fines no previstos originalmente o cuando se recopilan de manera pasiva, sin intervención directa del sujeto.

El sesgo algorítmico es otro de los puntos clave tratados en el artículo. Al estar entrenados con datos históricos que reflejan desigualdades sociales, raciales o de género, los algoritmos pueden reproducir e incluso amplificar estos sesgos en sus resultados. En el contexto de la investigación, esto puede llevar a conclusiones erróneas o a prácticas injustas que afecten negativamente a ciertos grupos sociales. Los comités de ética deben ser conscientes de este riesgo para poder exigir evaluaciones rigurosas del sesgo en los sistemas empleados.

A partir de una revisión de 657 artículos científicos, de los cuales 28 fueron seleccionados como más relevantes, la autora evalúa el grado de preparación de los REB para enfrentar estos retos. La conclusión es clara: la mayoría de los comités carecen de pautas específicas y de conocimientos técnicos suficientes para abordar los dilemas éticos asociados a la IA. La falta de formación interdisciplinaria y de protocolos adaptados a las nuevas tecnologías pone en peligro la calidad ética de las decisiones que se toman en la revisión de proyectos de investigación.

Ante este panorama, el artículo propone una serie de recomendaciones concretas. En primer lugar, se señala la necesidad de elaborar directrices éticas específicas para la evaluación de proyectos que incluyan inteligencia artificial. Estas directrices deberían abordar no solo la transparencia, la privacidad y el consentimiento, sino también los riesgos sistémicos y sociales de las tecnologías utilizadas. En segundo lugar, se propone la capacitación continua de los miembros de los comités de ética, quienes deben adquirir competencias técnicas y filosóficas para entender el funcionamiento y las implicaciones de la IA. Finalmente, se destaca la importancia de la colaboración interdisciplinaria entre expertos en informática, derecho, ética, sociología y otras áreas del conocimiento, para poder ofrecer una visión más integral de los problemas éticos que plantea la IA.

La inteligencia artificial ha introducido cambios profundos en la forma de hacer investigación, y estos cambios requieren una respuesta igualmente profunda por parte de quienes se encargan de proteger a los participantes y de velar por la integridad de la ciencia. Adaptar los marcos éticos existentes, formar a los comités y fomentar el diálogo interdisciplinar son pasos imprescindibles para enfrentar este nuevo escenario con responsabilidad y justicia.

Los «golden oldies» de la ciencia: los trabajos de investigación de hace décadas que siguen siendo muy citados hoy

Van Noorden, Richard. «Science’s Golden Oldies: The Decades-Old Research Papers Still Heavily Cited Today.» Nature, April 15, 2025. https://doi.org/10.1038/d41586-025-01126-8

Supplementary information.

Se analiza cómo ciertos trabajos clave han mantenido su relevancia a lo largo del tiempo, destacando especialmente los más citados en los artículos publicados en 2023.

El análisis revela que, aunque muchas publicaciones recientes sobre inteligencia artificial (IA), software científico y métodos para mejorar la calidad de la investigación dominan hoy las listas de referencias, algunos estudios más antiguos continúan siendo referenciados con frecuencia. Entre ellos, se incluyen trabajos de los años 90, como el que describe una arquitectura temprana de redes neuronales llamada long short-term memory (LSTM) de 1997, que sigue siendo citado con frecuencia debido a su eficiencia en el procesamiento de datos.

También se destacan investigaciones sobre materiales publicadas en 1996 que, gracias a su innovador enfoque para calcular interacciones electrónicas en materiales, siguen siendo citadas en una proporción significativa. Un cuarto de las citas de este trabajo se han dado en los últimos dos años, mostrando cómo el impacto de investigaciones antiguas puede continuar creciendo a medida que nuevas generaciones de científicos las descubren y aplican.

El estudio muestra cómo algunas publicaciones, incluso décadas después de su publicación, siguen siendo fundamentales para el avance de la ciencia, gracias a su base teórica sólida y la continua aplicabilidad de sus descubrimientos. Esto subraya la importancia de identificar y reconocer las «piedras angulares» del conocimiento científico, independientemente de su antigüedad.

RankTitleNumber of Citations (Range)
1Deep residual learning for image recognition (2016)19,826–33,339
2Global cancer statistics 2020: GLOBOCAN estimates of incidence and mortality worldwide (2021)10,952–24,830
3Attention is all you need (2017)9,395–19,348
4Generalized gradient approximation made simple (1996)14,338–17,540
5Using thematic analysis in psychology (2006)10,660–17,347
6The PRISMA 2020 statement: an updated guideline for reporting systematic reviews (2021)13,115–13,443
7Analysis of relative gene expression data using real-time quantitative PCR and the 2−ΔΔCT method (2001)11,851–13,082
8Random forests (2001)6,266–12,294
9Efficient iterative schemes for ab initio total-energy calculations using a plane-wave basis set (1996)10,063–10,789
10Long short-term memory (1997)2,394–12,355

Fuente: Nature (2025).

Los artículos científicos más citados de todos los tiempos

Van Noorden, Richard. 2025. “These Are the Most-Cited Research Papers of All Time.” Nature, April 17, 2025. https://www.nature.com/articles/d41586-025-01124-w.

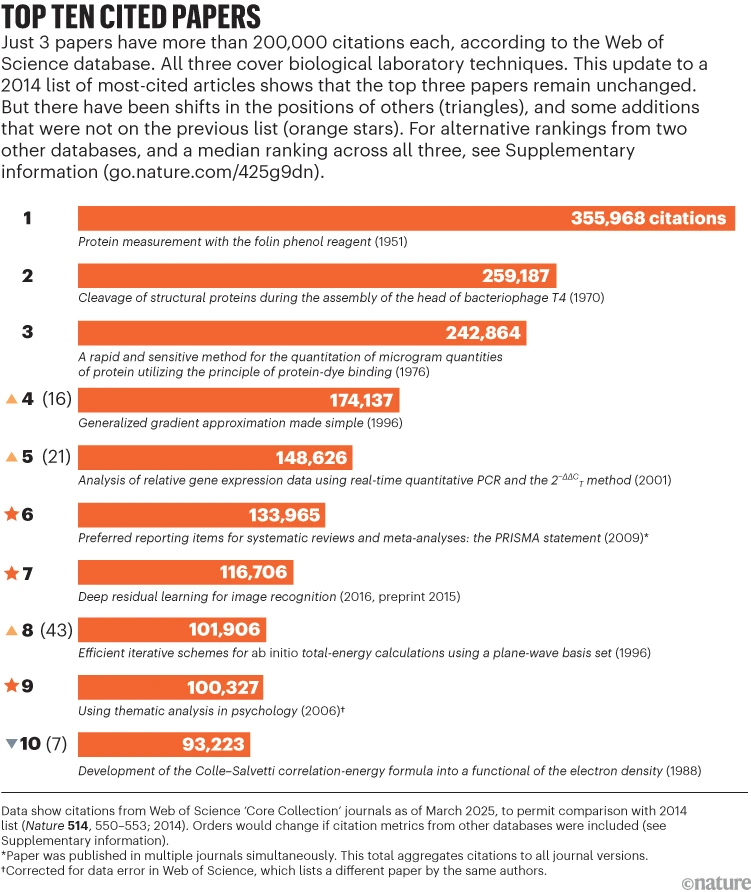
Nature ha actualizado su análisis sobre los trabajos científicos más citados de la historia, revelando que algunos han sido referenciados cientos de miles de veces. Esta revisión evidencia no solo el impacto de ciertas investigaciones, sino también cómo han evolucionado las tendencias en la producción científica y la citación a lo largo del tiempo.

Sorprendentemente, el artículo más citado no es ampliamente conocido entre la comunidad científica actual. Se trata de un trabajo de 1951 publicado en el Journal of Biological Chemistry, que describe un método para determinar la cantidad de proteínas en una solución. Este artículo ha sido citado más de 350.000 veces según el índice Web of Science (WoS), una base de datos que recopila 98 millones de publicaciones desde 1900.

Muchos de los artículos más citados están relacionados con técnicas de laboratorio en biología, lo que sugiere que los métodos ampliamente aplicables generan un impacto duradero. También figuran trabajos clave en inteligencia artificial (IA), software de investigación y métodos estadísticos.

La nueva clasificación actualiza una lista publicada por Nature en 2014, cuando los trabajos más citados eran herramientas de biología celular y molecular, principalmente de las décadas de 1950 y 1970. Desde entonces, alrededor de la mitad de los artículos en el top 100 han cambiado, debido al auge en las citas de trabajos más recientes. En 2014, eran necesarios unos 12.000 citas para entrar en el top 100. Hoy, hacen falta más de 30.000, lo que indica una inflación en el número de citas y el creciente volumen de publicaciones científicas.

Para este análisis, Nature también consultó otras dos grandes bases de datos de investigación: Dimensions y OpenAlex, cuyas versiones públicas permiten el análisis desde 1900. Aunque los rankings y recuentos de citas varían ligeramente entre bases, los artículos destacados son generalmente los mismos. La lista completa de los 100 más citados, con detalles sobre las diferencias entre bases, está disponible en el material suplementario del artículo.

Uno de los datos más llamativos es que un artículo de 2015 de investigadores de Microsoft, presentado en una conferencia sobre IA, ya ocupa el quinto lugar si se consideran los rankings medianos entre las tres bases de datos, y el séptimo solo en WoS. Esto muestra la velocidad con la que algunos artículos contemporáneos pueden acumular citas.

Actualmente, 16 artículos del siglo XXI se encuentran ya entre los 50 más citados de todos los tiempos, a pesar de su relativa juventud. Muchos de ellos están vinculados a desarrollos en software y al uso de la inteligencia artificial para acelerar el descubrimiento científico. Este fenómeno puede explicarse, según Paul Wouters (experto en cienciometría retirado de la Universidad de Leiden), por el aumento anual del número de publicaciones, lo que incrementa el volumen de referencias, así como por la mayor visibilidad de los trabajos científicos a través de Internet y las redes sociales.