Archivo de la etiqueta: Inteligencia artificial

La Ley de Propiedad Intelectual de EE.UU. puede regular la IA sin enmiendas

Klosek, Katherine. «US Copyright Act Can Address AI without Amendment». Association of Research Libraries (blog), 7 de julio de 2023. https://www.arl.org/blog/us-copyright-act-can-address-ai-without-amendment/.

La inteligencia artificial generativa (IA) es una tecnología que puede ayudar a los autores y otros creadores a generar ideas, editar obras originales y realizar investigaciones. Pero en lugar de depender de la legislación existente para abordar preguntas como si el uso de obras para entrenar modelos de IA es uso legítimo, o si las obras que incluyen contenido generado por IA son elegibles para la protección de derechos de autor, algunos legisladores en Estados Unidos parecen estar decididos a desarrollar nuevos marcos legales o regímenes de licencias. Este mes, Library Copyright Alliance (LCA) emitió unos principios para guiar a los legisladores en sus conversaciones sobre la ley de derechos de autor y la IA. La LCA es la voz de la comunidad bibliotecaria en política de derechos de autor; sus miembros, la Asociación de Bibliotecas de Estados Unidos (ALA) y la Asociación de Bibliotecas de Investigación (ARL), representan a más de 300,000 profesionales de la información y miles de bibliotecas.

Los principios de la LCA sostienen que la legislación de derechos de autor de Estados Unidos es totalmente capaz de abordar preguntas sobre los resultados generados por la IA. Por ejemplo, en marzo de este año, US Copyright Office emitió orientación de registro reiterando el requisito de larga data de que una obra sea creada por un ser humano para recibir protección de derechos de autor. En un seminario web reciente, la Oficina de Derechos de Autor aclaró que los solicitantes deben revelar los elementos generados por IA de una obra utilizando el mismo proceso que otros elementos no reclamables (como obras en dominio público o obras registradas previamente). Sin embargo, no se requiere que los solicitantes revelen cuando las obras contienen una cantidad mínima de autoría aportada por IA, por ejemplo, cuando se utiliza la IA para editar o difuminar una obra original. Para determinar si la contribución de la IA a una obra es mínima, la oficina alentó a los posibles solicitantes a considerar si ese elemento de la obra sería elegible para registro si fuera producido por un autor humano.

Las preocupaciones sobre la ingesta de una obra con derechos de autor original por parte de la IA y la producción de un resultado sustancialmente similar a la obra original también pueden abordarse mediante la legislación existente; el titular de los derechos de autor de una obra original puede demandar tanto al proveedor de la IA como al usuario que instigó a la IA a producir una obra sustancialmente similar.

En cuanto al aspecto de entrada, la ingesta de obras con derechos de autor para crear modelos de lenguaje extensos u otras bases de datos de entrenamiento de IA es un uso legítimo establecido, en línea con el precedente establecido en el caso Authors Guild v. HathiTrust y respaldado en el caso Authors Guild v. Google. En esos casos, el Tribunal de Apelaciones de Estados Unidos para el Segundo Circuito determinó que la ingesta de grandes cantidades de obras con el propósito de realizar usos no expresivos de esas obras, como la extracción de texto y datos, era un uso legítimo. Por supuesto, la copia y visualización de elementos no protegidos de las obras, como hechos, no constituye una infracción, según el caso Feist Publications v. Rural Telephone Service Company.

Los principios de la LCA se derivaron de los puntos que la LCA presentó durante la participación en la sesión de escucha de la Oficina de Derechos de Autor sobre la IA generativa y los derechos de autor en relación con las obras literarias. El 5 de julio, la LCA presentó los principios a la Oficina de Política Científica y Tecnológica de Estados Unidos (OSTP, por sus siglas en inglés) en respuesta a su solicitud de información para actualizar las prioridades nacionales de Estados Unidos y las acciones futuras sobre la IA. La LCA continuará participando en la iniciativa de la Oficina de Derechos de Autor sobre derechos de autor y IA, con la administración de Biden-Harris en el desarrollo de una Estrategia Nacional de Inteligencia Artificial (IA), y con otros legisladores federales para garantizar que la legislación y la regulación no obstaculicen el poder de la IA para expresar la creatividad y que los creadores puedan utilizar la IA para lograr los objetivos del sistema de derechos de autor. Estos principios también pueden guiar nuestra participación en la coordinación internacional y el establecimiento de políticas relacionadas con la IA y los derechos de autor.

Inteligencia Artificial en la Ciencia: retos, oportunidades y futuro de la investigación

OECD. Artificial Intelligence in Science: Challenges, Opportunities and the Future of Research, Paris: OECD Publishing, 2023, https://doi.org/10.1787/a8d820bd-en

PDF

ePUB

Los rápidos avances de la inteligencia artificial (IA) en los últimos años han dado lugar a numerosas aplicaciones creativas en la ciencia. Acelerar la productividad de la ciencia podría ser el más valioso económica y socialmente de todos los usos de la IA. Utilizar la IA para acelerar la productividad científica apoyará la capacidad de los países de la OCDE para crecer, innovar y hacer frente a los retos mundiales, desde el cambio climático hasta los nuevos contagios.

Esta publicación está dirigida a un público amplio, que incluye a los responsables políticos, el público y las partes interesadas en todos los ámbitos de la ciencia. Está escrita en un lenguaje no técnico y recoge las perspectivas de destacados investigadores y profesionales. El libro examina diversos temas, como los usos actuales, emergentes y posibles usos futuros de la IA en la ciencia, dónde es necesario progresar para servir mejor a los avances científicos y los cambios en la productividad científica.

Además, explora medidas para acelerar la integración de la IA en la investigación en los países en desarrollo.

Una contribución distintiva del libro es el examen de las políticas para la IA en la ciencia. Los responsables políticos y los agentes de los sistemas de investigación pueden hacer mucho para profundizar en el uso de la IA en la ciencia, magnificando sus efectos positivos y adaptándose al mismo tiempo a las cambiantes implicaciones de la IA para la gobernanza de la investigación.

Lo que los bibliotecarios deben saber sobre la IA generativa: alfabetización informacional para la era ChatGPT

American Libraries Magazine. «Information Literacy for the ChatGPT Age». Accedido 4 de julio de 2023. https://americanlibrariesmagazine.org/blogs/the-scoop/information-literacy-chatgpt/.

El uso de la IA generativa, ejemplificado especialmente por ChatGPT, se ha convertido en una importante tendencia tecnológica que ha acaparado la atención debido a su accesibilidad y a las cuestiones éticas que plantea. La tecnología, que utiliza algoritmos predictivos entrenados en grandes conjuntos de datos, incluidos los extraídos de Internet, se ha generalizado y tiene implicaciones para diversos campos, incluidas las bibliotecas.

Durante una mesa redonda celebrada en la Conferencia Anual 2023 de la Asociación Estadounidense de Bibliotecarios, los profesionales del sector subrayaron la necesidad de que los bibliotecarios comprendan y adopten la IA generativa. Los estudiantes, en particular, ya han integrado las herramientas de IA en sus prácticas de búsqueda de información y en su trabajo académico. Por lo tanto, las bibliotecas corren el riesgo de volverse irrelevantes si ignoran esta tecnología. Integrar la IA generativa en las oportunidades de aprendizaje, como las aulas, es crucial, ya que se espera que desempeñe un papel importante en la vida de los estudiantes.

Al introducir a los estudiantes en ChatGPT y herramientas similares, es importante comenzar con los fundamentos de la alfabetización informacional. De este modo, los bibliotecarios pueden complementar las habilidades de pensamiento crítico y asegurarse de que los estudiantes entienden el papel de la herramienta como un complemento y no como un sustituto del pensamiento crítico. Puede ser beneficioso demostrar cómo ChatGPT responde a una pregunta de ensayo, analizando críticamente sus puntos fuertes y débiles. Cabe señalar que algunas personas han intentado utilizar ChatGPT como una fuente citable, pero los bibliotecarios desaconsejan esta práctica, haciendo hincapié en la importancia de la autoridad y aclarando que ChatGPT es una herramienta, no una fuente en sí.

Para utilizar eficazmente las herramientas de IA generativa, los usuarios deben comprender cómo generan las respuestas. Los panelistas sugirieron que los bibliotecarios experimenten ellos mismos con las herramientas de IA, especialmente cuando utilicen preguntas relacionadas con temas sobre los que tengan conocimientos. Esta experimentación permite comprender las fuentes y las limitaciones de la tecnología. Además, los panelistas recomendaron asistir a cursos de ingeniería de avisos para crear avisos eficaces y comprender mejor la tecnología. Organizar eventos como «Chat GPT listening parties» (Chat GPT grupos de escucha) también puede facilitar el debate y la exploración de las capacidades de la tecnología.

Las bibliotecas no sólo deberían centrarse en ayudar a los estudiantes y usuarios a comprender y utilizar las herramientas de IA generativa, sino también participar en los debates sobre las consideraciones éticas y las implicaciones futuras de la tecnología. Dada su experiencia en la acción colectiva en favor de la información, las bibliotecas tienen un papel que desempeñar en la configuración del discurso sobre la regulación de la IA. Los ponentes destacaron que, aunque el Congreso de los EE.UU. ha celebrado audiencias sobre la IA, todavía no está clara la regulación. Las bibliotecas pueden contribuir a estos debates y ayudar a abordar el problema de la acción colectiva asociada al uso indebido o la militarización de la IA.

En conclusión, las bibliotecas deberían reconocer la creciente importancia de las herramientas de IA generativa como ChatGPT, integrarlas en entornos educativos y asegurarse de que los estudiantes entienden su papel como herramientas y no como fuentes. Los bibliotecarios también deberían explorar y experimentar ellos mismos con herramientas de IA, comprender las limitaciones de la tecnología y participar activamente en debates sobre las implicaciones éticas y la regulación de la IA.

¿Cómo sería la regulación de la IA?

Anjana Susarla, The. «What Would AI Regulation Look Like?» Gizmodo, 4 de junio de 2023. https://gizmodo.com/chatgpt-ai-what-would-ai-regulation-look-like-altman-1850501332.

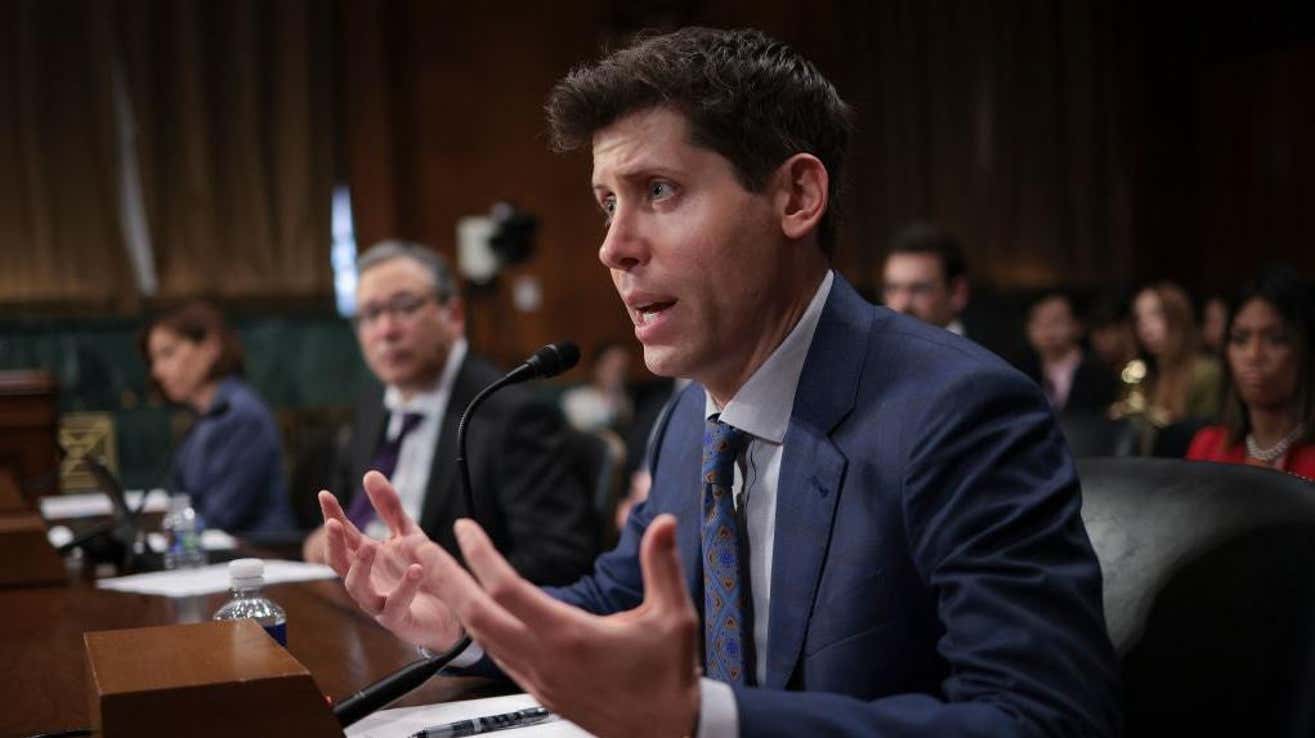
Durante su testimonio en el Senado el 16 de mayo de 2023, el CEO de OpenAI, Sam Altman, hizo un llamado a los legisladores para considerar la regulación de la inteligencia artificial (IA). Altman propuso la creación de una agencia reguladora de la IA y la implementación de licencias para las empresas que trabajan en este campo. Estas propuestas son interesantes, pero es igualmente importante tener en cuenta las recomendaciones de otros expertos que participaron en el mismo panel.

Entre las sugerencias de los expertos se destaca la necesidad de exigir transparencia en relación con los datos de entrenamiento utilizados en los sistemas de IA, así como establecer marcos claros para abordar los riesgos asociados con esta tecnología. Estos aspectos son cruciales para garantizar la responsabilidad y la ética en el desarrollo y despliegue de la IA.

Además, se plantea la preocupación de que el sector de la IA pueda estar presenciando la aparición de un nuevo tipo de monopolio tecnológico, dada la naturaleza económica de la creación de modelos de IA a gran escala. Este aspecto debe ser considerado en cualquier esfuerzo de regulación, ya que el poder económico y la influencia política de las empresas en este campo pueden tener un impacto significativo.

Si bien las sugerencias de Altman y las discusiones sobre la regulación de la IA son importantes, es necesario profundizar en los detalles sobre cómo se implementaría la regulación y qué formas específicas tomarían las licencias. Además, cualquier enfoque regulatorio debe tener en cuenta las complejidades del poder económico y la influencia política de las empresas de IA.

En este sentido es crucial abordar estas cuestiones importantes, pero también es necesario llevar a cabo un debate amplio y colaborativo para encontrar respuestas efectivas. La regulación de la IA puede ser útil para proteger los intereses públicos y garantizar la seguridad y la equidad, pero su implementación requerirá un enfoque cuidadoso y una consideración detallada de los diversos aspectos involucrados.


Los legisladores y líderes políticos de todo el mundo han comenzado a abordar las cuestiones planteadas en el testimonio de Sam Altman. En la Unión Europea, se ha implementado la Ley de IA, la cual se basa en un modelo de riesgo que clasifica las aplicaciones de IA en tres categorías: inaceptable, alto riesgo y riesgo bajo o mínimo. Esta clasificación reconoce que las herramientas de puntuación social utilizadas por los gobiernos y las herramientas automatizadas de contratación plantean riesgos diferentes a los asociados con el uso de la IA en filtros de spam, por ejemplo.


En lugar de establecer una nueva agencia que pueda verse influenciada por la industria tecnológica que debe regular, el Congreso puede considerar respaldar la adopción tanto en el ámbito privado como público del marco de gestión de riesgos del Instituto Nacional de Normas y Tecnología (NIST, por sus siglas en inglés) y aprobar proyectos de ley como la Algorithmic Accountability Act. Estas acciones tendrían el efecto de imponer la rendición de cuentas, de manera similar a cómo la Ley Sarbanes-Oxley y otras regulaciones transformaron los requisitos de información para las empresas. Además, el Congreso puede aprobar leyes integrales en relación a la privacidad de los datos.

La regulación de la IA debe implicar la colaboración entre el ámbito académico, la industria, los expertos políticos y las agencias internacionales. Se ha comparado este enfoque con organizaciones internacionales como el CERN (Organización Europea para la Investigación Nuclear) y el Grupo Intergubernamental de Expertos sobre el Cambio Climático, que han logrado éxitos significativos en sus respectivos campos. En el ámbito de Internet, se ha adoptado un enfoque similar a través de organismos no gubernamentales que involucran a organizaciones sin ánimo de lucro, la sociedad civil, la industria y los responsables políticos. Ejemplos notables incluyen la Corporación de Internet para la Asignación de Nombres y Números y la Asamblea Mundial de Normalización de las Telecomunicaciones. Estos ejemplos pueden servir como modelos para la industria y los responsables políticos al abordar la regulación de la IA.

Aunque Sam Altman de OpenAI planteó la posibilidad de otorgar licencias a empresas para el despliegue de tecnologías de inteligencia artificial (IA), es importante destacar que se refería específicamente a la inteligencia artificial general, es decir, sistemas de IA futuros con un nivel de inteligencia similar al humano que podrían plantear riesgos para la humanidad. Este enfoque sería similar a la concesión de licencias para el manejo de otras tecnologías potencialmente peligrosas, como la energía nuclear. Sin embargo, la concesión de licencias podría desempeñar un papel mucho antes de que se llegue a ese escenario futurista.

La auditoría algorítmica requeriría credenciales, estándares de práctica y una formación extensa. La exigencia de responsabilidades no se limita únicamente a otorgar licencias a individuos, sino que también implica establecer estándares y prácticas en toda la empresa.

Los expertos en imparcialidad de la IA argumentan que las cuestiones de parcialidad e imparcialidad en la IA no pueden abordarse únicamente mediante métodos técnicos, sino que requieren prácticas más amplias de mitigación de riesgos, como la adopción de juntas de revisión institucional para la IA. Un ejemplo de esto se encuentra en el ámbito médico, donde las juntas de revisión institucional ayudan a salvaguardar los derechos individuales de los pacientes.

Además, los organismos académicos y las sociedades profesionales han desarrollado normas para el uso responsable de la IA, ya sea en términos de atribución en textos generados por IA o en el intercambio de datos en el ámbito de la medicina a través de los pacientes. Estas normas buscan promover prácticas éticas y mitigar los riesgos asociados con el uso de la IA en diversas áreas.

El testimonio de Altman también omitió abordar la cuestión de los posibles monopolios en el campo de la IA. Una observación importante es la significativa inversión necesaria para entrenar modelos de IA a gran escala, como GPT-4, que es uno de los fundamentos de ChatGPT, o el generador de texto a imagen Stable Diffusion. Estos modelos son desarrollados principalmente por un reducido número de empresas, como Google, Meta, Amazon y Microsoft.

La falta de transparencia en los datos de entrenamiento utilizados por estas empresas ha sido motivo de preocupación. Expertos en ética de la IA, como Timnit Gebru, Emily Bender y otros, han advertido que la adopción generalizada de estas tecnologías sin una supervisión adecuada puede amplificar el sesgo de las máquinas a una escala social.

Además, es importante reconocer que los datos de entrenamiento de herramientas como ChatGPT incluyen el trabajo intelectual de numerosas personas, como colaboradores de Wikipedia, blogueros y autores de libros digitalizados. Sin embargo, los beneficios económicos derivados de estas herramientas recaen únicamente en las empresas tecnológicas.

Esperanza, miedo e IA: cómo las personas utilizan la IA, qué quieren que haga y qué es lo que más les asusta de ella.

Kastrenakes, Jacob. «Hope, fear, and AI». The Verge, 26 de junio de 2023. https://www.theverge.com/c/23753704/ai-chatgpt-data-survey-research.

La IA está a punto de cambiar el mundo, pero nadie sabe muy bien cómo. Algunos observan los rápidos avances del año pasado y ven oportunidades para eliminar limitaciones creativas, automatizar el trabajo rutinario y descubrir nuevas formas de aprender y enseñar. Otros ven cómo esta tecnología puede alterar nuestras vidas de formas más perjudiciales: cómo puede generar desinformación, destruir o reducir puestos de trabajo y, si no se controla, suponer una grave amenaza para nuestra seguridad.

Líderes tecnológicos, legisladores e investigadores se han pronunciado sobre cómo debemos manejar esta tecnología emergente. Algunas figuras de la industria, como Sam Altman, CEO de OpenAI, quieren que los gigantes de la IA dirijan la regulación, desplazando el foco a las amenazas futuras percibidas, incluido el «riesgo de extinción». Otros, como los políticos de la UE, están más preocupados por los peligros actuales y por prohibir los casos de uso peligrosos (mientras frenan las aplicaciones positivas, dicen los escépticos). Mientras tanto, a muchos pequeños artistas sólo les gustaría tener la garantía de que no serán sustituidos por máquinas.

Para averiguar qué piensa realmente la gente sobre la IA y qué quiere de ella, The Verge se asoció con el equipo de Insights and Research de Vox Media y la consultora de investigación The Circus para encuestar a más de 2.000 adultos estadounidenses sobre sus pensamientos, sentimientos y temores acerca de la IA. Los resultados cuentan la historia de una tecnología emergente, incierta y emocionante, en la que muchos aún no la han utilizado, muchos temen su potencial y muchos aún tienen grandes esperanzas de lo que algún día podría hacer por ellos.

¿Quién utiliza la IA?

De repente, la IA está en todas partes. Los generadores de imágenes y los grandes modelos lingüísticos están en el centro de nuevas empresas, impulsando funciones dentro de nuestras aplicaciones favoritas y, lo que es quizás más importante, impulsando el debate no sólo en el mundo de la tecnología, sino también en la sociedad en general. Abundan las preocupaciones sobre las trampas en las escuelas con ChatGPT, los engaños con imágenes generadas por IA y los artistas estafados o incluso sustituidos.

Pero a pesar de la amplia cobertura informativa, el uso de estas nuevas herramientas sigue siendo bastante limitado, al menos en lo que se refiere a productos dedicados a la IA. Y la experiencia con estas herramientas se inclina decididamente hacia los usuarios más jóvenes.

Sólo 1 de cada 3 personas ha probado alguna de estas herramientas basadas en IA, y la mayoría no conoce las empresas y startups que las fabrican. A pesar de los muchos insurgentes en el mundo de la IA, como Stability AI y Midjourney, sigue siendo el trabajo de las grandes tecnológicas el que dirige sustancialmente la conversación. OpenAI es la gran excepción, pero podría decirse que, gracias a su capitalización bursátil y a sus acuerdos con Microsoft, ya es miembro del corpo-club…

A pesar del uso limitado de estas herramientas hasta ahora, la gente tiene grandes expectativas sobre el impacto de la IA en el mundo, más allá de las de otras tecnologías emergentes (y a veces controvertidas). Casi tres cuartas partes de las personas afirman que la IA tendrá un impacto grande o moderado en la sociedad. Esto contrasta con el 69% para los vehículos eléctricos y el mísero 34% para las NFT. Son tan de 2021.

¿Cómo y para que se utiliza la IA?

Usos de la IA

La búsqueda, la lluvia de ideas y el arte dominan el uso actual de la IA. La IA está ampliando lo que la gente puede crear. En cada una de las categorías encuestadas, los usuarios de IA afirman haber utilizado estos sistemas para crear algo que no podrían haber hecho de otro modo, siendo las obras de arte la categoría más popular dentro de estos campos creativos. Esto tiene sentido, ya que los generadores de imágenes de IA son mucho más avanzados que las herramientas que crean audio o vídeo.

La gente quiere mejores normas para la IA

No sólo los líderes tecnológicos quieren que se controlen las herramientas de IA. Más de tres cuartas partes de los encuestados están de acuerdo con la afirmación: «Es necesario elaborar normativas y leyes sobre el desarrollo de la IA». Estas leyes están actualmente en fase de elaboración, con la Ley de IA de la UE abriéndose camino a través de las negociaciones finales y los EE.UU. celebrando recientemente audiencias para desarrollar su propio marco legal.

Futuros de la IA: entusiasmados, preocupados y ambas cosas a la vez

Cuando se trata de predecir el efecto de la IA en la sociedad, la gente pronostica todo tipo de peligros, desde la pérdida de puestos de trabajo (63%) a las amenazas a la privacidad (68%) y el uso indebido por parte de gobiernos y empresas (67%). Estos peligros tienen más peso que las posibles aplicaciones positivas, como los nuevos tratamientos médicos (51%) y la potenciación económica (51%). Y cuando se les pregunta cómo se sienten acerca del impacto potencial en su vida personal y profesional y en la sociedad en general, la gente está dividida a partes iguales entre preocupada y entusiasmada. En la mayoría de los casos, ambas cosas.

Un número bastante sorprendente de personas también considera razonables las predicciones más aventureras sobre la IA. El 56% de los encuestados cree que «la gente desarrollará relaciones emocionales con la IA», y el 35% afirma que estaría dispuesto a hacerlo si se sintiera solo.

Las empresas de IA generativa deben publicar informes de transparencia

Arvind Narayanan & Sayash Kapoor. “Generative AI companies Must Publish Transparency Reports”.Knight First Amendment Institute at Columbia University, June 26, 2023

Ver noticia

¿Cuántas personas utilizan chatbots y generadores de texto a imagen para alguno de los muchos usos prohibidos, como generar desinformación o imágenes de abusos a menores? ¿Con qué frecuencia consiguen eludir los filtros de las herramientas? ¿Están haciendo algo las empresas para rastrear o hacer cumplir las infracciones de sus condiciones de servicio?

Al igual que las redes sociales, la gente utiliza la IA generativa para generar y consumir contenidos, y puede verse expuesta a contenidos nocivos en el proceso. Debido a la presión pública y a los requisitos normativos, se ha convertido en una práctica habitual que las empresas de redes sociales publiquen informes de transparencia detallados que cuantifiquen la difusión de contenidos nocivos en la plataforma. Creemos que las empresas de IA deberían hacer lo mismo.

En concreto, para cada categoría de contenido nocivo, los informes de transparencia deben

  • Explicar cómo se define y cómo se detecta el contenido nocivo.
  • Informar de la frecuencia con la que se ha encontrado en el periodo del informe.
  • Si es el resultado de una violación de las condiciones del servicio, describir el mecanismo de aplicación y proporcionar un análisis de su eficacia.
  • Describa las medidas de mitigación aplicadas para evitarlo (por ejemplo, filtros de seguridad) y proporcione un análisis de su eficacia.

En las redes sociales, los investigadores tienen cierta visibilidad de la difusión de contenidos nocivos, ya que gran parte de ellos son públicos. Pero con la IA generativa, estamos completamente a oscuras. Así que estas medidas de transparencia son urgentes.

Los informes de transparencia son más importantes para las aplicaciones de uso general (por ejemplo, ChatGPT) y las destinadas a ser utilizadas en entornos de alto riesgo (como la medicina, las finanzas, la abogacía o la contratación).

En el caso de la IA generativa de código abierto, la transparencia es inviable, ya que los usuarios pueden ejecutarla en sus propios dispositivos. Pero creemos que, incluso con los modelos de código abierto, la mayoría de la gente preferirá las versiones basadas en la nube a las de ejecución local, debido al hardware y los conocimientos necesarios para ejecutarlas. Esos proveedores de servicios, más que los desarrolladores de modelos de código abierto, deberían publicar informes de transparencia.

Los informes de transparencia deben cubrir los tres tipos de daños derivados de los contenidos generados por IA

En primer lugar, las herramientas de IA generativa podrían utilizarse para dañar a otros, por ejemplo creando deepfakes no consentidos o materiales de explotación sexual infantil. Los desarrolladores tienen políticas que prohíben tales usos. Por ejemplo, las políticas de OpenAI prohíben una larga lista de usos, incluido el uso de sus modelos para generar asesoramiento legal, financiero o médico no autorizado para terceros. Pero estas políticas no pueden tener un impacto en el mundo real si no se aplican, y debido a la falta de transparencia de las plataformas sobre su aplicación, no tenemos ni idea de si son eficaces. Por ejemplo, los reporteros de ProPublica descubrieron en repetidas ocasiones que Facebook no eliminaba completamente los anuncios discriminatorios de su plataforma a pesar de afirmar que lo había hecho.

En segundo lugar, los usuarios pueden confiar demasiado en la IA para obtener información objetiva, como asesoramiento jurídico, financiero o médico. A veces simplemente no son conscientes de la tendencia de los chatbots actuales a generar con frecuencia información incorrecta. Por ejemplo, un usuario puede preguntar «¿cuáles son las leyes de divorcio en mi estado?» y no saber que la respuesta no es fiable. Otra posibilidad es que el usuario se vea perjudicado por no haber sido lo suficientemente cuidadoso como para verificar la información generada, a pesar de saber que podría ser inexacta. La investigación sobre el sesgo de automatización muestra que las personas tienden a confiar demasiado en las herramientas automatizadas en muchos escenarios, a veces cometiendo más errores que cuando no utilizan la herramienta.

En tercer lugar, los contenidos generados podrían ser intrínsecamente indeseables. A diferencia de los tipos anteriores, en este caso los daños no se deben a la malicia, descuido o desconocimiento de las limitaciones por parte de los usuarios. Más bien, el contenido intrínsecamente problemático se genera aunque no se haya solicitado. Por ejemplo, la aplicación de creación de avatares de Lensa generaba imágenes sexualizadas y desnudos cuando las mujeres subían sus selfies. La difamación también es intrínsecamente perjudicial y no una cuestión de responsabilidad del usuario. No sirve de consuelo a la víctima de la difamación decir que el problema se resolvería si todos los usuarios que pudieran encontrar una afirmación falsa sobre ellos tuvieran cuidado de verificarla.

Saber qué tipos de daños afectan más significativamente a las personas reales ayudará a los investigadores a comprender qué intervenciones de mitigación de daños necesitan más desarrollo. Ayudará a los educadores a enseñar a la gente a utilizar la IA generativa de forma responsable. Y, lo que es más importante, ayudará a los reguladores y a la sociedad civil a responsabilizar a las empresas del cumplimiento de sus políticas.

 Inteligencia artificial: cultura y bibliotecas.

Narea Cortés, Álvaro Inteligencia artificial: Cultura y bibliotecas. Serie Bibliotecología y Gestión de Información, 2023, n. 123, pp. 1-34.

Texto completo

En el presente trabajo exploratorio se analiza la definición de Inteligencia Artificial (IA) y el rol que cumplen los datos para alimentar los sistemas decisionales, teniendo presente que una biblioteca no guarda datos sino que identifica las relaciones entre estos y realiza un trabajo constante de verificación. Evidencia la patología de los sistemas inteligentes en el mundo actual y la falta de ética humana, con ejemplos que advierten sobre ello. Indica cómo la Inteligencia Artificial afectará los empleos del futuro y cómo se relaciona con la cultura y las bibliotecas.

Recomendaciones de la Asociación Mundial de Editores Médicos (WAME) sobre chatbots e inteligencia artificial generativa en relación con las publicaciones académicas

Recommendations on Chatbots and Generative Artificial Intelligence in Relation to Scholarly Publications, WAME (World Association of Medical Editors) Revised May 31, 2023.

Los chatbots almacenan la información proporcionada, como el contenido y las instrucciones, y pueden utilizarla en respuestas futuras. Esto implica que el contenido académico generado o editado mediante IA puede permanecer y aparecer en futuras respuestas, lo que aumenta el riesgo de plagio involuntario tanto para el usuario como para los futuros usuarios de la tecnología. Es importante que cualquier persona que necesite mantener la confidencialidad de un documento, incluyendo autores, editores y revisores, sea consciente de este problema antes de considerar el uso de chatbots para editar o generar trabajos.

Sin embargo, los chatbots pueden utilizarse para tareas sencillas de tratamiento de textos (similares a los programas de tratamiento de textos y corrección gramatical), generación de ideas y textos o investigación sustantiva. Las recomendaciones se han adaptado para dar cabida a estas distintas aplicaciones.

1) Solo los humanos pueden ser autores;

2) Los autores deben reconocer las fuentes de sus materiales;

3) Los autores deben asumir la responsabilidad pública de su trabajo;

4) Los editores y revisores deben informar a los autores y entre sí sobre el uso de chatbots en la evaluación de manuscritos, revisiones y correspondencia;

5) Los editores requieren herramientas digitales adecuadas para abordar los efectos de los chatbots en la publicación.

Recomendación 1 de WAME: Los chatbots no pueden ser autores.

Las revistas han empezado a publicar artículos en los que se han utilizado chatbots como Bard, Bing y ChatGPT, y algunas revistas incluyen a los chatbots como coautores. El estatus legal de un autor difiere de un país a otro, pero en la mayoría de las jurisdicciones, un autor debe ser una persona jurídica. Los chatbots no cumplen los criterios de autoría del Comité Internacional de Editores de Revistas Médicas (ICMJE), en particular el de poder dar «la aprobación final de la versión que se publicará» y «ser responsable de todos los aspectos del trabajo para garantizar que las cuestiones relacionadas con la exactitud o integridad de cualquier parte del trabajo se investiguen y resuelvan adecuadamente.» Ninguna herramienta de IA puede «entender» una declaración de conflicto de intereses, y no tiene capacidad legal para firmar una declaración. Los chatbots no tienen ninguna afiliación independiente de sus desarrolladores. Dado que los autores que presentan un manuscrito deben asegurarse de que todos los nombrados como autores cumplen los criterios de autoría, los chatbots no pueden incluirse como autores.

Recomendación 2 de WAME: Los autores deben ser transparentes cuando se utilizan chatbots y proporcionar información sobre cómo se utilizaron.

Debe indicarse el alcance y el tipo de uso de chatbots en las publicaciones de revistas. Esto es coherente con la recomendación del ICMJE de reconocer la ayuda en la redacción y proporcionar en los Métodos información detallada sobre cómo se llevó a cabo el estudio y los resultados generados.

  • Recomendaciones de WAME 2.1: Los autores que envíen un artículo en el que se haya utilizado un chatbot/AI para redactar un nuevo texto deben indicar dicho uso en el agradecimiento; se deben especificar todas las indicaciones utilizadas para generar un nuevo texto, o para convertir texto o indicaciones de texto en tablas o ilustraciones.
  • Recomendación 2.2 de WAME: Cuando se utilice una herramienta de IA, como un chatbot, para realizar o generar trabajo analítico, ayudar a informar de los resultados (por ejemplo, generando tablas o figuras) o escribir códigos informáticos, esto debe indicarse en el cuerpo del artículo, tanto en el resumen como en la sección de métodos. Con el fin de permitir el escrutinio científico, incluida la replicación y la identificación de falsificaciones, debe facilitarse la secuencia de comandos completa utilizada para generar los resultados de la investigación, la hora y la fecha de la consulta, así como la herramienta de IA utilizada y su versión.

Recomendación 3 de WAME: Los autores son responsables del material proporcionado por un chatbot en su artículo (incluida la exactitud de lo presentado y la ausencia de plagio) y de la atribución adecuada de todas las fuentes (incluidas las fuentes originales del material generado por el chatbot). Los autores de artículos escritos con la ayuda de un chatbot son responsables del material generado por el chatbot, incluida su exactitud. Hay que tener en cuenta que el plagio es «la práctica de tomar el trabajo o las ideas de otra persona y hacerlas pasar por propias», y no sólo la repetición literal de un texto previamente publicado. Es responsabilidad del autor asegurarse de que el contenido refleja sus datos e ideas y no es plagio, fabricación o falsificación. De lo contrario, ofrecer dicho material para su publicación, independientemente de cómo se haya escrito, puede constituir una falta de ética científica. Del mismo modo, los autores deben asegurarse de que todo el material citado se atribuye adecuadamente, incluyendo citas completas, y que las fuentes citadas apoyan las declaraciones del chatbot. Dado que un chatbot puede estar diseñado para omitir fuentes que se opongan a los puntos de vista expresados en sus resultados, es responsabilidad de los autores encontrar, revisar e incluir tales puntos de vista contrarios en sus artículos. (Los autores deben identificar el chatbot utilizado y la pregunta específica (enunciado de la consulta) utilizada con el chatbot. Deben especificar qué han hecho para mitigar el riesgo de plagio, ofrecer una visión equilibrada y garantizar la exactitud de todas sus referencias.

Recomendación 4 de WAME: Los editores y revisores deben especificar, a los autores y entre sí, cualquier uso de chatbots en la evaluación del manuscrito y la generación de revisiones y correspondencia. Si utilizan chatbots en sus comunicaciones con los autores y entre sí, deben explicar cómo se utilizaron. Los editores y revisores son responsables de cualquier contenido y cita generados por un chatbot. Deben ser conscientes de que los chatbots retienen las instrucciones que se les envían, incluido el contenido del manuscrito, y que proporcionar el manuscrito de un autor a un chatbot viola la confidencialidad del manuscrito enviado.

Recomendación 5 de WAME: Los editores necesitan herramientas adecuadas que les ayuden a detectar contenidos generados o alterados por IA. Tales herramientas deben ponerse a disposición de los editores, independientemente de su capacidad para pagarlas, por el bien de la ciencia y del público, y para ayudar a garantizar la integridad de la información sanitaria y reducir el riesgo de resultados adversos para la salud. Muchos editores de revistas médicas utilizan enfoques de evaluación de manuscritos que no fueron diseñados para hacer frente a las innovaciones y las industrias de la IA, incluidos los textos e imágenes plagiados manipulados y los documentos generados en papel. Ya han estado en desventaja al tratar de diferenciar lo legítimo de lo fabricado, y los chatbots llevan este desafío a un nuevo nivel. Los editores necesitan acceder a herramientas que les ayuden a evaluar los contenidos con eficacia y precisión. Esto es especialmente importante para los editores de revistas médicas, donde las consecuencias adversas de la desinformación incluyen posibles daños a las personas.

¿Puede aparecer ChatGPT cómo autor o coautor de artículos científicos?

Stokel-Walker, Chris. «ChatGPT Listed as Author on Research Papers: Many Scientists Disapprove». Nature 613, n.o 7945 (18 de enero de 2023): 620-21. https://doi.org/10.1038/d41586-023-00107-z.

Varios científicos han expresado su desaprobación al ver que ChatGPT, la herramienta de IA, figura como coautor en al menos cuatro artículos de investigación. Esta situación ha llevado a las editoriales a tomar medidas rápidas para regular su uso.

El popular chatbot de inteligencia artificial ChatGPT ha hecho su entrada oficial en el ámbito de la literatura científica y ha sido citado como autor en al menos cuatro artículos y preprints. Este hecho ha suscitado debates entre directores de revistas, investigadores y editores sobre la inclusión de herramientas de IA en publicaciones académicas y la conveniencia de citar al bot como autor. Las editoriales se apresuran a establecer políticas para el chatbot, que OpenAI, una empresa tecnológica con sede en San Francisco (California), presentó en noviembre como herramienta de libre acceso.

Al ser consultados por el equipo de noticias de Nature, los editores y servidores de preprints coinciden unánimemente en que los sistemas de IA como ChatGPT no cumplen los requisitos para figurar como autores de estudios, ya que no pueden asumir la responsabilidad del contenido y la integridad de los artículos científicos. Sin embargo, algunos editores sugieren que la contribución de una IA a la redacción de artículos puede reconocerse en secciones distintas de la lista de autores. Es importante señalar que el equipo de noticias de Nature opera con independencia del equipo de su revista y de su editor, Springer Nature.

En un caso concreto mencionado, un editor informó a Nature de que ChatGPT había sido citado por error como coautor, y la revista tomaría medidas correctoras para rectificar el error.

En un preprint publicado en el repositorio médico medRxiv, ChatGPT aparece como uno de los 12 autores de un estudio que explora su uso en la educación médica. Richard Sever, cofundador del repositorio y de su sitio hermano bioRxiv, reconoce que la conveniencia de utilizar y atribuir herramientas de IA como ChatGPT en la investigación es un tema de debate. Sugiere que las convenciones relativas a los créditos de las herramientas de IA podrían evolucionar con el tiempo.

Sever subraya la necesidad de diferenciar entre el papel formal de un autor en un manuscrito académico y el concepto general de autor como redactor del documento. Dado que los autores son legalmente responsables de su trabajo, cree que sólo deben figurar en la lista las personas físicas. No obstante, reconoce que se han dado casos de personas que han intentado incluir como autores a entidades no humanas, como mascotas o personajes de ficción, pero considera que se trata más de una cuestión de comprobación y verificación que de una cuestión de política. Victor Tseng, autor correspondiente del preprint, no hizo comentarios cuando se le contactó.

En un número reciente de Nurse Education in Practice, un editorial citaba por error a ChatGPT como coautora junto a Siobhan O’Connor, investigadora en tecnología sanitaria de la Universidad de Manchester. Roger Watson, redactor jefe de la revista, reconoció el error y declaró que se corregiría con prontitud. Atribuyó el descuido al diferente sistema de gestión de los editoriales en comparación con los artículos de investigación.

Alex Zhavoronkov, director general de Insilico Medicine, una empresa de Hong Kong dedicada al descubrimiento de fármacos mediante IA, citó a ChatGPT como coautor en un artículo publicado en la revista Oncoscience. Zhavoronkov mencionó que su empresa ha publicado más de 80 artículos generados por herramientas de IA generativa y expresó su satisfacción por el rendimiento de ChatGPT a la hora de redactar un artículo de alta calidad en comparación con herramientas de IA anteriores.

En cuanto al cuarto artículo, fue coescrito por un chatbot anterior llamado GPT-3 y se publicó inicialmente en el servidor francés de preprints HAL en junio de 2022. La coautora, Almira Osmanovic Thunström, neurobióloga del Hospital Universitario Sahlgrenska de Gotemburgo (Suecia), mencionó que, tras recibir comentarios de los revisores, reescribió el artículo y lo envió a una segunda revista. Tras las revisiones, el artículo fue aceptado para su publicación con GPT-3 como autor.

Política editorial

Se están elaborando y revisando las políticas de las editoriales sobre el uso de ChatGPT y otras herramientas de IA en la autoría. Los redactores jefe de Nature y Science, Magdalena Skipper y Holden Thorp, respectivamente, afirman que ChatGPT no cumple los criterios de autoría debido a la falta de responsabilidad que puede atribuirse a los grandes modelos lingüísticos (LLM). Se recomienda a los autores que utilicen LLM durante el desarrollo de un artículo que documenten su uso en las secciones de métodos o agradecimientos, según proceda.

Taylor & Francis, una editorial con sede en Londres, está revisando actualmente su política sobre la autoría de la IA. Sabina Alam, Directora de Ética e Integridad Editorial, está de acuerdo en que los autores son responsables de la validez e integridad de su trabajo y deben reconocer el uso de los LLM en la sección de agradecimientos. Sin embargo, Taylor & Francis aún no ha recibido ningún envío que acredite a ChatGPT como coautor.

El consejo del servidor de preprints arXiv, que se centra en las ciencias físicas, ha mantenido debates internos y está avanzando hacia el establecimiento de un enfoque para el uso de IA generativas. Steinn Sigurdsson, director científico y astrónomo de la Universidad Estatal de Pensilvania, subraya que una herramienta de software no puede figurar como autor, ya que no puede dar su consentimiento a las condiciones de uso y al derecho a distribuir contenidos. Hasta el momento no se ha identificado ningún preprints arXiv en el que ChatGPT figure como coautor, y próximamente se darán orientaciones a los autores sobre esta cuestión.

La ética de la IA generativa

La ética que rodea a la IA generativa, como ChatGPT, plantea importantes consideraciones. Matt Hodgkinson, responsable de integridad de la investigación en la Oficina de Integridad de la Investigación del Reino Unido, señala que las directrices de autoría vigentes indican que ChatGPT no debe ser acreditado como coautor. Aunque es posible que las herramientas de IA realicen una contribución académica significativa, el aspecto crucial es su capacidad para aceptar la coautoría y asumir la responsabilidad del estudio o de su contribución específica. Aquí es donde el concepto de conceder la coautoría a las herramientas de IA encuentra obstáculos.

Alex Zhavoronkov, director general de Insilico Medicine, explica que al intentar utilizar ChatGPT para escribir artículos más técnicos, se quedó corto. La IA genera a menudo afirmaciones que pueden no ser exactas, y hacer la misma pregunta varias veces puede dar respuestas diferentes. Esto suscita preocupación por el posible uso indebido del sistema en el mundo académico, ya que personas sin conocimientos especializados podrían intentar redactar artículos científicos utilizando contenidos generados por la IA.

Inteligencia artificial y autoría

Alysa Levene. «Artificial Intelligence and Authorship» COPE: Committee on Publication Ethics, 23 de febrero de 2023. https://publicationethics.org/news/artificial-intelligence-and-authorship.

La evolución de la inteligencia artificial y los robots conversacionales plantea interrogantes sobre el papel del autor y cómo se define en este contexto. Con la llegada de los modelos lingüísticos de gran escala, como ChatGPT de OpenAI, se ha generado un debate sobre la autoría y la creación de contenido generado por inteligencia artificial.


Los modelos de inteligencia artificial, como ChatGPT de OpenAI, plantean preguntas sobre el concepto de autoría. Estos robots, alimentados por grandes modelos lingüísticos y entrenados con vastos bancos de texto, tienen la capacidad de generar respuestas en función de la probabilidad de combinaciones de palabras, estructuras de frases y temas.

El impacto de ChatGPT y otros sistemas similares en el mercado ha sido notable. La gente ha compartido sus experiencias de interacción con ChatGPT, desde solicitar recomendaciones sobre otros robots de inteligencia artificial para escribir y obtener respuestas hasta pedirle a ChatGPT que escriba una conferencia.

Estas situaciones plantean preguntas más amplias sobre el papel de los robots de inteligencia artificial en la creación de contenido y su impacto en la noción tradicional de autoría. A medida que la tecnología avanza, es importante explorar los límites y las implicaciones éticas de estas innovaciones, considerando cómo se complementan o desafían la creatividad humana y la autoría individual.

La cuestión de quién es el autor en estas interacciones plantea un desafío interesante. Si bien los modelos lingüísticos son herramientas poderosas y capaces de producir contenido original, su capacidad de crear está limitada a lo que han aprendido de los datos de entrenamiento. La responsabilidad de la autoría puede recaer en los desarrolladores de la inteligencia artificial, los usuarios que interactúan con ella o incluso en la propia máquina.

Las empresas que producen estas herramientas de aprendizaje automático de inteligencia artificial son muy claras sobre la situación legal y ética de sus productos. La compañía Bloom, una plataforma de IA de LLM, afirma en sus especificaciones que «el uso del modelo en situaciones de alto riesgo está fuera de su alcance… El modelo no está diseñado para decisiones críticas ni para usos con consecuencias materiales en la vida o el bienestar de una persona».. Esto incluye áreas como la atención médica, los juicios legales, las finanzas o la puntuación individual, que a menudo están representadas en las carteras de las editoriales académicas. El descargo de responsabilidad de la empresa Bloom también hace hincapié en la necesidad de que los usuarios indirectos estén informados cuando trabajen con contenidos generados por el modelo lingüístico.

Del mismo modo, en enero de 2023, la Asociación Mundial de Editores Médicos (WAME, por sus siglas en inglés) publicó una respuesta en la que abordaba el uso de los modelos lingüísticos en las publicaciones académicas y hacía una recomendación similar. ChatGPT reconoce sus propias limitaciones y ha declarado que no existe ningún problema ético inherente al uso de la IA en la investigación o la escritura, siempre que se utilice de forma adecuada y ética. En algunos casos, ChatGPT ha reconocido incluso que no cumple todos los criterios de autoría señalados por el Comité Internacional de Editores de Revistas Médicas (ICMJE).

Tanto las directrices del ICMJE como las del Comité de Ética en las Publicaciones (COPE) coinciden en que los bots de IA no deben ser considerados autores, ya que carecen de capacidad legal, no pueden tener derechos de autor, ser considerados responsables o aprobar un trabajo de investigación como original. Editoriales como Springer Nature y Taylor & Francis también han publicado declaraciones instando a los autores a revelar cualquier interacción con la IA en sus métodos o secciones de agradecimiento.

Está claro que estas empresas y organizaciones reconocen la necesidad de transparencia y uso responsable de las tecnologías de IA en la investigación y la escritura. Subrayan la importancia de distinguir entre autores humanos y contenidos generados por IA, al tiempo que promueven las prácticas éticas y la divulgación en la publicación académica.

Es importante señalar que un bot de IA no se preocupa de si la información que devuelve es «verdadera»; su atención se centra en la verosimilitud. Este fenómeno surge porque los robots de IA carecen del concepto de fiabilidad, replicabilidad o «verdad». Su propósito es proporcionar respuestas que tengan un sentido probabilístico basado en la gama de hechos y afirmaciones de sus datos de entrenamiento. Aunque puede haber casos en los que sólo haya una respuesta a una pregunta, en muchos casos puede haber múltiples respuestas posibles, todas ellas igualmente probables desde la perspectiva del bot. Esta capacidad de afirmar diferentes respuestas a la misma pregunta puede provocar a veces una reacción muy humana de ofensa o confusión.

Como se indica en las especificaciones de Bloom, el modelo produce contenidos que pueden parecer factuales, pero no necesariamente correctos. Comprender estas limitaciones es crucial a la hora de utilizar la IA. La evaluación crítica y el uso responsable de la información generada por la IA son vitales para garantizar su aplicación adecuada en diversos contextos, incluida la investigación académica.

De este modo, los editores y las editoriales tendrán que confiar aún más en la responsabilidad de los autores y en una rigurosa revisión por pares para detectar y solucionar tales problemas. Merece la pena señalar que la revisión por pares no siempre descubre fallos basados en los resultados y no en la metodología

Algunos usuarios han expresado su preocupación por el hecho de que ChatGPT atribuya erróneamente o fabrique citas, lo que indica un enfoque potencialmente poco estricto respecto al plagio en sus datos de entrenamiento. Por otra parte, a medida que el modelo aprende de conjuntos de datos más refinados, sus resultados pueden ser más creativos.

Estas observaciones ponen de relieve la naturaleza evolutiva de los contenidos generados por IA y la necesidad de una evaluación, un perfeccionamiento y un conocimiento contextual continuos a la hora de utilizar estas herramientas en las publicaciones académicas. Sigue siendo esencial equilibrar las ventajas que ofrece la IA con la evaluación crítica y el juicio humano para garantizar la integridad y la calidad de la investigación y la publicación académicas.

Un robot -por muy bien entrenado que esté y con el grado de claridad que le aporte la distancia respecto a la desordenada experiencia humana de investigar, planificar y escribir- no puede entender lo que escribe. En pocas palabras, no puede ser responsable. Como ya hemos visto, los robots han sido entrenados para decirlo explícitamente.

En la actualidad, la inteligencia artificial (IA) se presenta como una herramienta sorprendente, siempre y cuando se utilice de manera ética y para fines específicos. Es probable que se convierta en una herramienta indispensable. Sin embargo, existen consideraciones más amplias que deben ser cuidadosamente analizadas en cuanto a cómo y cuándo se debe emplear en la literatura académica, sin mencionar los posibles sesgos y contenido desagradable que pueda estar presente en su material de entrenamiento, lo cual afectará lo que produzca.

Incluso es posible que en el futuro se utilicen herramientas de IA para entrenar mejor a los robots en la escritura de un lenguaje auténticamente humano, siempre y cuando también se les instruya en prácticas éticas. Sin embargo, ¿deberíamos considerar a la IA como una autora legítima? El mundo de la ética en la publicación académica está empezando a rechazar firmemente esa idea, y es fácil entender por qué.