Archivo de la etiqueta: Plagio

Una cuarta parte de los ensayos clínicos podrían ser problemáticos o incluso totalmente inventados

Van Noorden, Richard. «Medicine Is Plagued by Untrustworthy Clinical Trials. How Many Studies Are Faked or Flawed?» Nature 619, n.o 7970 (18 de julio de 2023): 454-58. https://doi.org/10.1038/d41586-023-02299-w.

Las investigaciones sugieren que, en algunos campos, al menos una cuarta parte de los ensayos clínicos podrían ser problemáticos o incluso totalmente inventados, advierten algunos investigadores. Instan a un mayor escrutinio.

¿Cuántos estudios de ensayos clínicos publicados en revistas médicas son falsos o contienen errores fatales? En octubre de 2020, John Carlisle publicó una sorprendente estimación. El anestesista John Carlisle, conocido por detectar datos dudosos en ensayos médicos, revisó más de 500 estudios durante tres años y encontró que el 26% tenía problemas tan graves que no se podían confiar, lo que él llamó «ensayos zombis». Estos ensayos, que se asemejan a la investigación real pero son huecos, pueden pasar desapercibidos sin acceso a los datos individuales de los participantes.

Por ello, se sugiere que los editores de revistas revisen los datos de los participantes antes de publicar ensayos controlados aleatorios. La preocupación por la integridad de la investigación también se extiende a otras áreas médicas, como la salud de la mujer, la anestesiología y la COVID-19, donde se han encontrado numerosos ensayos sospechosos.

Los problemas con los ensayos falsificados o poco confiables plantean serias amenazas, ya que pueden influir en las decisiones médicas y distorsionar el conocimiento científico. Aunque se están realizando más estudios para evaluar la magnitud del problema, la detección y corrección de ensayos problemáticos sigue siendo un desafío importante para la comunidad científica.

Wiley cerró 19 revistas científicas a raíz de problemas con las llamadas «fábricas de artículos» con inteligencia artificial

Claburn, Thomas. «Wiley Shuts 19 Scholarly Journals amid AI Paper Mill Problem». Accedido 21 de mayo de 2024. https://www.theregister.com/2024/05/16/wiley_journals_ai/.

Wiley cerró 19 revistas científicas a raíz de problemas con «fábricas de artículos» con inteligencia artificial. Estas revistas pertenecían a su subsidiaria Hindawi, centro de un escándalo de publicación académica.

En diciembre de 2023 Wiley anunció que dejaría de utilizar la marca Hindawi, adquirida en 2021, tras su decisión en mayo de 2023 de cerrar cuatro de sus revistas «para mitigar la manipulación sistemática del proceso de publicación» Se descubrió que las revistas de Hindawi estaban publicando artículos provenientes de «fábricas de artículos» (Papel Mills), organizaciones que intentan manipular el proceso de publicación académica con fines financieros. En respuesta a esto, Wiley ha retiró más de 11.300 artículos de su cartera de Hindawi. La preocupación por la integridad de la investigación académica no se limita a las publicaciones de Wiley, ya que estudios sugieren que hasta una cuarta parte de los ensayos clínicos pueden ser problemáticos o completamente fabricados.

Según un preprint publicado en febrero, el volumen de artículos enviados a ArXiv aumentó considerablemente en las tres categorías principales entre 2019 y 2023, un período que coincide aproximadamente con la puesta a disposición del público de herramientas como ChatGPT. Los artículos de ciencias de la computación aumentaron un 200 por ciento durante estos cuatro años, seguidos por los artículos de física (45 por ciento) y matemáticas (22 por ciento).

Como se describe en un libro blanco de Wiley publicado el pasado diciembre, «Tackling publication manipulation at scale: Hindawi’s journey and lessons for academic publishing», las fábricas de artículos recurren a diversas prácticas contrarias a la ética, como el uso de inteligencia artificial en la fabricación de manuscritos y la manipulación de imágenes, así como la manipulación del proceso de revisión por pares.

La creciente disponibilidad y sofisticación de la inteligencia artificial generativa está facilitando estas prácticas. Wiley ha implementado una nueva tecnología de detección para identificar artículos con posibles usos indebidos de la inteligencia artificial generativa antes de su publicación. «El sector reconoce que las editoriales utilizan la IA para generar contenidos fraudulentos», explica el portavoz de Wiley. «Recientemente hemos introducido una nueva tecnología de cribado que ayuda a identificar artículos con un potencial mal uso de la IA generativa antes del punto de publicación».

Las editoriales académicas, sin embargo, parecen apoyar los beneficios de la ayuda de la IA a la redacción sin sus inconvenientes. Springer Nature, por ejemplo, lanzó el pasado mes de octubre «Curie», un asistente de escritura basado en IA para ayudar a los científicos cuya lengua materna no es el inglés. De ahí las peticiones de mejores herramientas para detectar los resultados generativos de la IA, una petición a la que han respondido los recientes esfuerzos por mejorar la marca de agua de los contenidos de IA, que según algunos investigadores no funcionará.

Aunque Wiley caracterizó el cierre de las 19 revistas como parte de su plan anunciado previamente para integrar las carteras de Hindawi y Wiley, y distinto del problema de las fábricas de artículos, este incidente destaca los desafíos en la integridad de la investigación académica frente a la proliferación de prácticas fraudulentas facilitadas por la inteligencia artificial.

Mientras tanto, el informe de ganancias del tercer trimestre fiscal de 2024 de Wiley, el editor indicó que se anticipa que los ingresos de su división de aprendizaje se sitúen en el extremo superior de las proyecciones, debido a «acuerdos de derechos de contenido del cuarto trimestre para el entrenamiento de modelos de IA».

El gobierno chino intensifica medidas contra el fraude académico


Steele, Evie. «Chinese Government Cracks Down on Academic Fraud.» Voice of America, March 11, 2024. https://flip.it/qVLrXn.

China está intensificando su lucha contra el fraude en la investigación académica tras revelaciones en enero de que editoriales habían retractado miles de trabajos de académicos chinos en los últimos años. Sin embargo, observadores señalan que abordar este problema será difícil debido a su amplia prevalencia.

Según la revista científica Nature, en 2023 se retractaron aproximadamente 14.000 artículos de revistas en inglés, tres cuartas partes de los cuales tenían coautores chinos. El Ministerio de Educación de China ha exigido a las universidades que presenten una lista completa de artículos académicos retractados en los últimos tres años para auditar el alcance del fraude.

Aunque los resultados de la revisión del Ministerio de Educación aún no se han publicado, académicos y estudiantes chinos afirman que el problema es generalizado. Parte del problema radica en la facilidad con la que se puede pagar a escritores fantasma para que realicen investigaciones y publiquen en revistas de baja calidad. Sun Fugui, exestudiante de posgrado en la Universidad de Ludong, comentó que tanto estudiantes como profesores utilizan estos servicios.

Otro problema es que las revistas científicas chinas de bajo nivel frecuentemente publican investigaciones fraudulentas sin verificar su calidad. Yang Ningyuan, exdirector de un instituto de investigación en la Universidad de Zhengzhou, mencionó que ha recibido numerosas ofertas para publicar artículos a cambio de dinero.

Analistas creen que la naturaleza política de la investigación en China es en parte responsable de los problemas de integridad académica. Yun Sun, del think tank Stimson Center, señaló que la transparencia y libertad en los intercambios académicos están fuertemente controladas por el estado en China, lo que dificulta la verificación de datos fabricados.

Perry Link, profesor en la Universidad de California, Riverside, comentó que el volumen de investigaciones fabricadas refleja la indiferencia de los funcionarios hacia la verdad. La intervención política en la investigación también desanima a los investigadores a producir trabajos de alta calidad.

Zhang Mingxin, un estudiante universitario en Beijing, mencionó que el fraude académico y la politización de los datos hacen que la investigación sea muy difícil. La estricta censura gubernamental complica la búsqueda de datos, especialmente en temas sensibles.

Yun Sun concluyó que las universidades chinas quedarán rezagadas respecto a otras universidades globales debido a sus problemas de integridad académica no resueltos. El Ministerio de Educación aún no ha presentado un plan para abordar estas preocupaciones.

Guía necesaria para el uso de la inteligencia artificial en la detección de conductas impropias en las presentaciones de artículos a revistas científicas

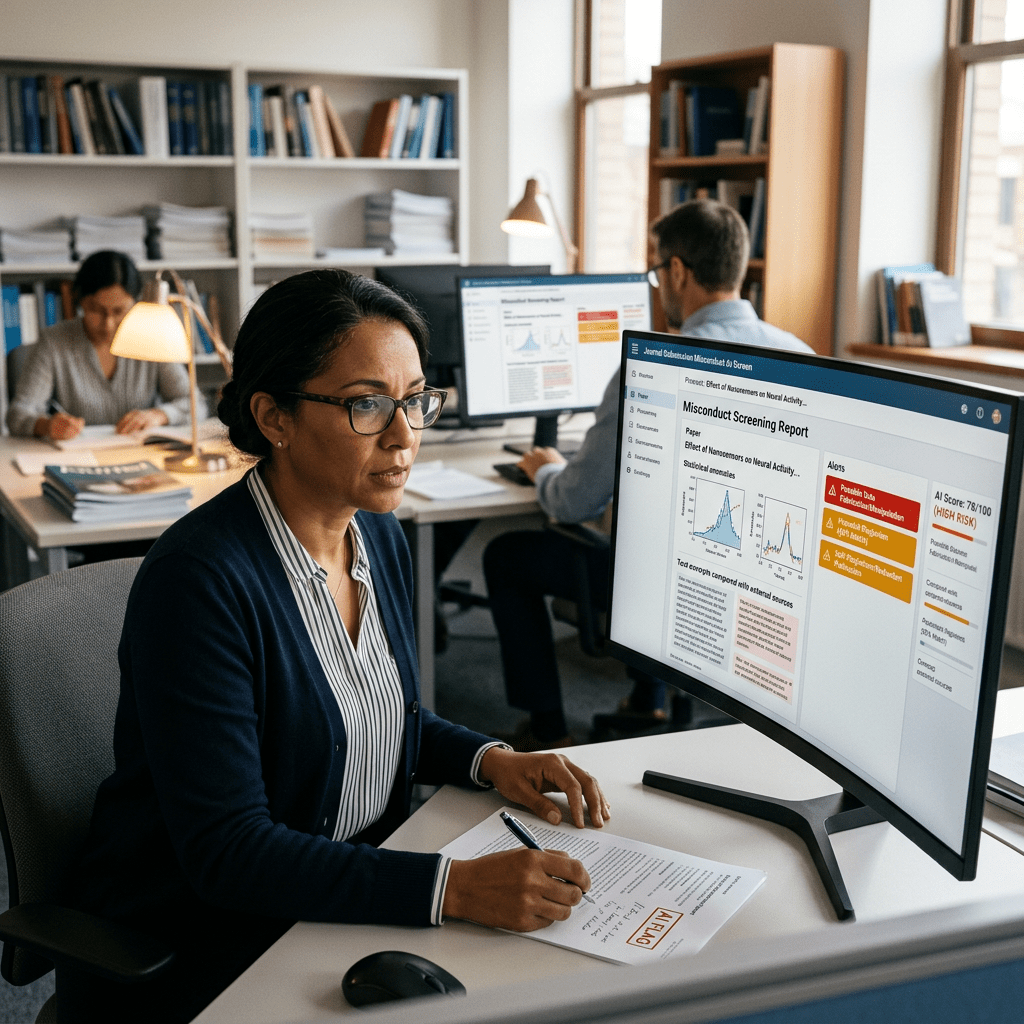
Woman analyzing misconduct screening report on computer, writing notes on paper marked 'ALTO'
A woman reviews a high-risk misconduct screening report on a large computer monitor in an office.

Hosseini, Mohammad, y David B Resnik. «Guidance Needed for Using Artificial Intelligence to Screen Journal Submissions for Misconduct». Research Ethics, 11 de mayo de 2024, 17470161241254052. https://doi.org/10.1177/17470161241254052.

Las revistas y editoriales están utilizando cada vez más la inteligencia artificial (IA) para examinar las presentaciones en busca de posibles conductas impropias, incluido el plagio y la manipulación de datos o imágenes.

Si bien el uso de la IA puede mejorar la integridad de los manuscritos publicados, también puede aumentar el riesgo de acusaciones falsas/no fundamentadas. Las ambigüedades relacionadas con las responsabilidades de las revistas y editoriales con respecto a la equidad y transparencia también plantean preocupaciones éticas.

En el presente artículo, se proporciona la siguiente guía:

  • Todos los casos de conducta impropia sospechosa identificados por herramientas de IA deben ser revisados cuidadosamente por humanos para verificar la precisión y garantizar la responsabilidad;
  • Las revistas/editoriales que utilizan herramientas de IA para detectar conductas impropias deben utilizar solo herramientas bien probadas y confiables, permanecer vigilantes con respecto a formas de conducta impropia que no pueden ser detectadas por estas herramientas y mantenerse al tanto de los avances en tecnología;
  • Las revistas/editoriales deben informar a los autores sobre irregularidades identificadas por herramientas de IA y darles la oportunidad de responder antes de enviar acusaciones a sus instituciones de acuerdo con las pautas del Comité de Ética de Publicaciones;
  • Las revistas/editoriales que utilizan herramientas de IA para detectar conductas impropias deben examinar todas las presentaciones relevantes y no solo presentaciones seleccionadas al azar/intencionalmente; y
  • Las revistas deben informar a los autores sobre su definición de conducta impropia, su uso de herramientas de IA para detectar conductas impropias y sus políticas y procedimientos para responder a casos sospechosos de conducta impropia.

TikTok comenzará a etiquetar el contenido generado por IA para combatir la desinformación


TikTok ha anunciado que comenzará a etiquetar contenido creado utilizando inteligencia artificial cuando se cargue desde fuera de su propia plataforma, como parte de su esfuerzo para combatir la desinformación.

La compañía afirma que si bien la IA ofrece oportunidades creativas increíbles, puede confundir o engañar a los espectadores si no saben que el contenido fue generado por IA. Por lo tanto, la etiqueta ayudará a proporcionar claridad sobre el origen del contenido. TikTok ya etiqueta contenido generado por IA creado con efectos de IA de TikTok, y ha requerido a los creadores que etiqueten contenido realista generado por IA durante más de un año.

Esta medida de TikTok forma parte de un esfuerzo más amplio en la industria tecnológica para proporcionar más salvaguardias para el uso de la IA. Meta anunció en febrero que estaba trabajando con socios de la industria en estándares técnicos que facilitarán la identificación de imágenes y, eventualmente, videos y audio generados por herramientas de inteligencia artificial. Los usuarios de Facebook e Instagram verían etiquetas en imágenes generadas por IA. Google también anunció el año pasado que las etiquetas de IA llegarían a YouTube y otras plataformas.

Este impulso hacia el «marcado de agua digital» y la etiquetación del contenido generado por IA también fue parte de una orden ejecutiva que el presidente de Estados Unidos, Joe Biden, firmó en octubre.

TikTok espera que esta medida ayude a fortalecer la confianza del usuario y a reducir la propagación de desinformación en su plataforma.

Los generadores de imágenes de Inteligencia Artificial Midjourney y DeviantArt afirman que nunca han utilizado imágenes de artistas para entrenar sus modelos de IA


«AI Image Generators Say They Never Used Artists’ Images to Train AI Models». Accedido 10 de mayo de 2024. https://www.courthousenews.com/ai-image-generators-say-they-never-used-artists-images-to-train-ai-models/.

Empresas que ofrecen software de inteligencia artificial generativa de imágenes argumentaron para desestimar una demanda por infracción directa de derechos de autor de artistas que afirman que las empresas utilizaron su trabajo sin permiso para entrenar un modelo de IA de texto a imagen.

Según la demanda colectiva de los artistas, la empresa de software de IA Midjourney y la plataforma de arte en línea DeviantArt utilizaron sus obras para entrenar la herramienta de IA de texto a imagen Stable Diffusion sin pagar a los artistas ni obtener su consentimiento para utilizar sus obras como imágenes de entrenamiento, y las imágenes resultantes siguen compitiendo con las obras de los artistas humanos en el mercado.

Los artistas demandaron por primera vez a DeviantArt, Midjourney y Stability AI, creador de Stable Diffusion, el año pasado, pero el juez superior de distrito de EE.UU. William Orrick desestimó la mayoría de las demandas de los artistas en octubre de 2023, permitiendo que sólo sobreviviera una demanda directa de derechos de autor contra Stability AI.

El juez William Orrick permitió que una única demanda de infracción directa de derechos de autor sobreviviera contra Stability AI, pero desestimó la mayoría de las otras reclamaciones de los artistas.

Los abogados de DeviantArt argumentaron que la plataforma de arte debería ser excluida de la acción porque solo utilizó Stable Diffusion para producir imágenes para su herramienta DreamUp AI y nunca utilizó directamente las imágenes de los artistas para entrenar un modelo de IA o crear imágenes que se parecieran a las de los artistas.

Los abogados de Midjourney ofrecieron una defensa similar. El juez Orrick tomó el asunto bajo consideración.

El crecimiento explosivo del fraude impulsado por la IA: Deepfakes

Statista Daily Data. «Infografía: El explosivo crecimiento del fraude impulsado por la IA», 15 de marzo de 2024. https://es.statista.com/grafico/31907/paises-con-mayores-aumentos-de-casos-de-fraude-de-deepfake.

La proliferación de videos, fotos y grabaciones de audio engañosas, generadas con sistemas de inteligencia artificial (IA), ha alcanzado proporciones alarmantes en diversas plataformas de internet.

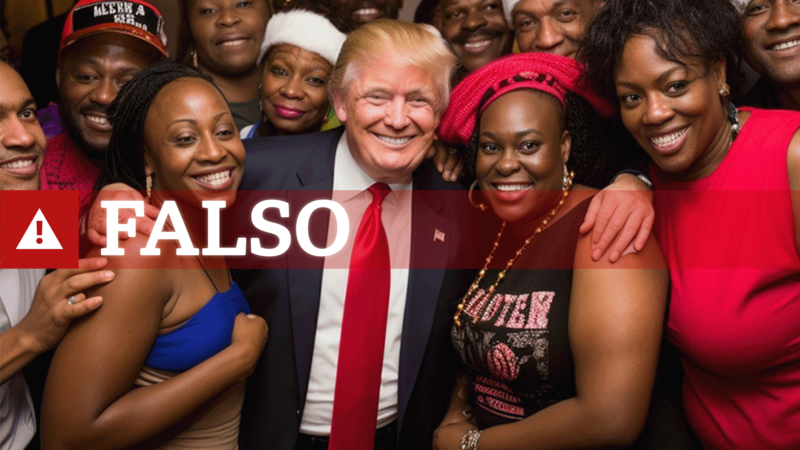
Desde imágenes de Donald Trump posando con votantes negros hasta el Papa luciendo una chaqueta estilo puffer, estos contenidos manipulados pueden hacer que parezca que figuras prominentes en la política o el entretenimiento expresen ideas o acciones que nunca han realizado.

Además de su uso para crear contenido falso, esta tecnología también facilita la comisión de fraudes de identidad, ya sea mediante la fabricación de documentos falsificados o usurpando la identidad de personas a través de llamadas telefónicas. Entre 2022 y 2023, los casos de fraude vinculados a deepfakes se han disparado en numerosos países alrededor del mundo, como lo revela nuestro análisis basado en el informe anual más reciente del proveedor de verificación de identidad Sumsub.

Entre los hallazgos clave del estudio se destacan:

  • Un aumento significativo de 10 veces en el número de deepfakes detectados globalmente en todas las industrias entre 2022 y 2023, con diferencias regionales notablemente marcadas.
  • España es el país más atacado por deepfakes, el pasaporte de los Emiratos Árabes Unidos es el documento más falsificado a nivel mundial, y América Latina es la región donde el fraude aumentó en todos los países.
  • Las tarjetas de identificación siguen siendo las más explotadas para el fraude de identidad, representando casi el 75% de todas las actividades fraudulentas relacionadas con documentos de identidad.
  • Los medios de comunicación en línea son la industria con el mayor aumento de fraude de identidad.

Por ejemplo, en Filipinas, los intentos de fraude aumentaron en un 4.500% respecto al año anterior, seguido de países como Vietnam, Estados Unidos y Bélgica. Con el potencial de la inteligencia artificial en constante crecimiento, es probable que los intentos de fraude mediante deepfakes se expandan a otras áreas. Pavel Goldman-Kalaydin, Jefe de Inteligencia Artificial y Aprendizaje Automático de Sumsub, señala que «hemos observado cómo los deepfakes se han vuelto cada vez más convincentes en los últimos años, y esto solo continuará y se ramificará hacia nuevos tipos de fraudes, como se ha visto con los deepfakes de voz».

Aunque la creación de deepfakes en sí misma no constituye un delito, muchos gobiernos están adoptando regulaciones más estrictas en el uso de la IA para prevenir daños a las partes involucradas. Además, alrededor de 400 expertos en IA y tecnología han suscrito una carta abierta el mes pasado, instando a los gobiernos de todo el mundo a tomar medidas enérgicas contra los deepfakes.

El informe concluye con predicciones para el próximo año en cuanto a verificación de identidad, así como pautas para la prevención del fraude proporcionadas por expertos. Entre las predicciones se incluyen un énfasis en la verificación no documental, un aumento de las reglas más estrictas en los medios de comunicación en línea y un cambio en la posesión de datos de identidad hacia un almacenamiento local obligatorio.

Libros electrónicos de baja calidad escritos con Inteligencia Artificial inundan el mercado de Kindle Amazon

Grady, Constance. «Amazon Is Filled with Garbage Ebooks. Here’s How They Get Made.» Vox, 16 de abril de 2024. https://www.vox.com/culture/24128560/amazon-trash-ebooks-mikkelsen-twins-ai-publishing-academy-scam.


El artículo explora cómo se generan los libros electrónicos de baja calidad que inundan el mercado de Amazon, describiendo una combinación de inteligencia artificial, esquemas para hacerse rico rápidamente y un perjuicio total para los consumidores confundidos. Lo que ilustra cómo la explotación de la inteligencia artificial y la ausencia de regulación han facilitado la propagación de libros de baja calidad, teniendo un impacto negativo tanto en los escritores como en los lectores.
Es tan difícil para la mayoría de los autores ganarse la vida con su escritura que a veces perdemos de vista cuánto dinero hay que ganar con los libros, si solo pudiéramos ahorrar costos en el proceso laborioso y que consume mucho tiempo de escribirlos.

Internet, sin embargo, siempre ha sido un puerto seguro para aquellos con planes de innovar esa molesta parte de escribir un libro fuera de la publicación de libros real. En internet, es posible copiar texto de una plataforma y pegarlo en otra sin problemas, compartir archivos de texto, construir vastas bases de datos de libros robados. Si quisieras diseñar un lugar específicamente para piratear y monetizar libros de manera rastrera, sería difícil hacerlo mejor que internet tal como ha existido durante mucho tiempo.

Ahora, la IA generativa ha hecho posible crear imágenes de portada, esquemas e incluso texto con solo hacer clic en un botón. La IA ha creado un mundo donde los utopistas tecnológicos sueñan abiertamente con eliminar la parte humana de escribir un libro — cualquier cantidad de arte o artesanía o incluso solo esfuerzo puro — y reemplazarla con corrientes de texto generadas por máquina; como si poner el trabajo de escribir fuera un juego para tontos; como si importara si lo que estás leyendo es o no un sinsentido solo para elitistas. El futuro es ahora, y está lleno de libros basura que nadie se molestó realmente en escribir y que ciertamente nadie quiere leer.

La parte más triste de todo esto, sin embargo, es que los libros basura en realidad no ganan tanto dinero. Incluso es posible perder dinero generando tu libro electrónico de baja calidad para venderlo en Kindle por 0.99$. La forma en que la gente gana dinero en estos días es enseñando a los estudiantes el proceso de hacer un libro basura. Es estafa y basura, y las personas que finalmente salen perdiendo son los lectores y escritores que aman los libros.

Hoy en día, el paisaje de la publicación de libros electrónicos basura está totalmente saturado de estafadores. Hay blogs que hablan sobre la industria, pero tienden a ser sitios sensacionalistas plagados de palabras clave de SEO y enlaces de afiliados que se citan entre ellos. Prácticamente cada parte del mundo de las estafas de autopublicación que se puede automatizar o monetizar se ha automatizado y monetizado. Según los blogs de la época, uno de los maestros más infames era un hombre que se hacía llamar Luca de Stefani, o Big Luca. La leyenda decía que tenía el récord mundial de ganar más dinero usando Kindle Publishing en un solo día. Aunque Luca no inventó esta fórmula. Lo aprendió del curso OG de estafa de autoedición K Money Mastery, ahora aparentemente extinto, donde sobresalió.

Para la estafa de la autoedición, las buenas reseñas son cruciales. Cuantas más reseñas de cinco estrellas tenga un libro, más probable es que el algoritmo de Amazon lo empuje hacia los lectores. Si principalmente estás publicando libros basura, no vas a obtener toneladas de reseñas de cinco estrellas de manera orgánica. El grupo de Facebook de Big Luca les dio a los estafadores un lugar para ofrecer intercambios de reseñas de cinco estrellas o vender reseñas de cinco estrellas por 0.99$ cada una. Según el algoritmo de Amazon, no había diferencia entre ese tipo de reseña y la que podría dejar un lector real. Los resultados fueron extremadamente lucrativos.

Cómo se hacen los libros basura

El caso de estudio de cómo se hacen los libros basura comienza con el curso ofrecido por los hermanos Mikkelsen en el dominio Publishing.com cuyo titular es «Donde la edición se encuentra con los beneficios. Ayudamos a personas sin experiencia empresarial ni tecnológica a crear y publicar libros que se venden». Su presentación de ventas dura dos horas y es un video de Christian en una habitación oscura, mostrando capturas de pantalla de cheques de regalías de sus estudiantes y repitiendo que ya es rico; no tiene que mostrar cómo ganar ese dinero. Christian ofrece enseñar a producir un libro sin necesidad de escribirlo, utilizando inteligencia artificial (IA) para generar el esquema del libro, ahorrando semanas de investigación. Aunque Amazon refuerza las regulaciones contra textos generados puramente por IA, los Mikkelsen anuncian su nuevo programa de IA, Publishing.ai, que promete escribir un manuscrito aún más rápido que un escritor fantasma. Bajo su modelo, los estudiantes tienen acceso a rastreadores de palabras clave y luego envían el esquema generado por IA a un escritor fantasma por una tarifa. Además, los Mikkelsen prometen enseñar a contratar narradores de audiolibros y a conseguir reseñas de cinco estrellas. Aunque nada de esto es ilegal, es éticamente cuestionable, según las normas de la industria editorial.

En última instancia, el timo explota cada faceta del proceso de creación y venta de libros, capitalizando los aspectos laboriosos y socavando el significado cultural de los libros como artefactos significativos y enriquecedores. El resultado es una proliferación de archivos digitales con forma de libro carentes de sustancia, perpetuando un ciclo de explotación y desilusión en el mundo literario.

Ello ilustra cómo la explotación de la inteligencia artificial y la ausencia de regulación han facilitado la propagación de libros de baja calidad, teniendo un impacto negativo tanto en los escritores como en los lectores.
La IA generativa frente a la publicación académica

«Hanging in the balance: Generative AI versus scholarly publishing». Accedido 24 de abril de 2024. https://spie.org/news/photonics-focus/janfeb-2024/hanging-in-the-balance#_=

Desde la invención de la imprenta por Gutenberg en 1454, el sector editorial ha enfrentado desafíos relacionados con la alfabetización, el plagio, la censura de la información y el acceso a la misma. El lanzamiento de ChatGPT-3 en noviembre de 2022 marcó un hito, ya que este modelo de lenguaje generativo ha revolucionado la capacidad de generación de ideas, lo que ha generado tanto entusiasmo como preocupación en la comunidad académica.

Uno de los aspectos más destacados del debate es la creatividad de los modelos de lenguaje generativo, que pueden generar textos e imágenes. Aunque su capacidad para inventar referencias puede ser un problema, estos modelos son útiles para la generación de nuevas ideas y para identificar lagunas en la investigación existente. Sin embargo, surge la pregunta sobre la atribución de autoría, ya que los modelos generativos no pueden ser considerados como autores de estudios científicos, según el Consejo de Ética en Publicación (COPE).

En cuanto a la revisión por pares, la falta de revisores cualificados y la sobrecarga de trabajo en los editores han llevado a considerar el uso de AI para agilizar el proceso. Aunque existen preocupaciones sobre la confidencialidad y el sesgo en los resultados generados por los modelos de lenguaje generativo, estos también pueden ser herramientas útiles para la revisión de literatura y la identificación de trabajos relevantes en un área de investigación.

Otro aspecto a considerar es el fraude en la publicación académica, que ha aumentado con la capacidad de los modelos de lenguaje generativo para producir textos con una calidad gramatical aparentemente perfecta. Sin embargo, la responsabilidad sigue recayendo en los autores humanos, quienes deben garantizar la integridad ética de sus investigaciones.

A pesar de estos desafíos, los modelos de lenguaje generativo también ofrecen oportunidades para hacer que la publicación académica sea más accesible para personas cuyo idioma nativo no es el inglés. Estas herramientas pueden ayudar a superar barreras lingüísticas y permitir que los investigadores se centren en la ciencia en lugar de en la perfección gramatical en sus manuscritos.

En última instancia, el debate sobre el papel de la AI generativa en la publicación académica aún está en curso. A medida que la tecnología avanza, es crucial abordar sus desafíos éticos y técnicos para garantizar que beneficie a la comunidad académica en su conjunto.

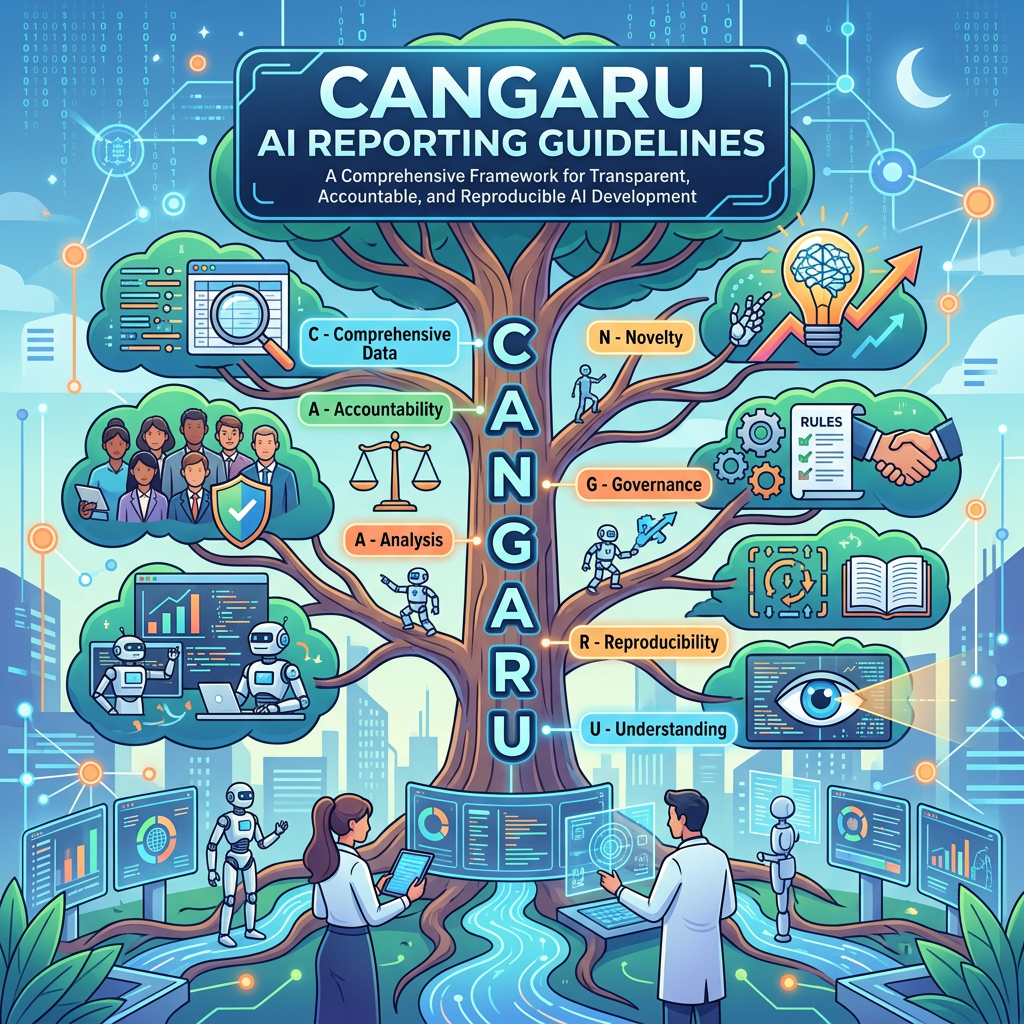
CANGURU: directrices éticas y de divulgación para el uso de inteligencia artificial generativa en la investigación académica

Tree diagram depicting CANGARU AI reporting guidelines: Comprehensive Data, Accountability, Analysis, Novelty, Governance, Reproducibility, Understanding
An illustrated tree diagram explaining the CANGARU AI reporting guidelines for transparent and accountable AI development.

Cacciamani, Giovanni, Michael Eppler, Conner Ganjavi, Asli Pekcan, Brett Biedermann, Gary Collins, y Inderbir Gill. «Development of the ChatGPT and generative artificial intelligence natural large language models for accountable reporting and use (cangaru) guidelines», 27 de junio de 2023. https://doi.org/10.17605/OSF.IO/9Y5NW.

Ver guidelines

CANGARU es una iniciativa interdisciplinaria que busca establecer estándares éticos y de divulgación para el uso de inteligencia artificial generativa y modelos de lenguaje natural en la investigación académica. Su objetivo es promover el uso responsable de estas tecnologías mediante la colaboración con instituciones y desarrollar directrices coherentes y universales. Se enfoca en crear criterios para prácticas éticas y transparentes en el ámbito académico.

La iniciativa ChatGPT, Inteligencia Artificial Generativa y Modelos de Lenguaje Natural para el Reporte y Uso Responsable (CANGARU) con el objetivo de establecer un consenso interdisciplinario sobre el uso responsable, divulgación y guía para el reporte del uso de GAI/GPTs/LLM en el ámbito académico. Trabajando colaborativamente con individuos, organizaciones regulatorias académicas y editoriales, se mitigará de manera efectiva la posible confusión o guías conflictivas que podrían surgir cuando varios grupos trabajan independientemente en la misma tarea. A su vez, esto asegurará que cualquier recomendación sea coherente, completa y universalmente aplicable, promoviendo el uso responsable de esta poderosa tecnología.

El objetivo general de las directrices CANGARU es establecer prácticas recomendadas comúnmente compartidas y transdisciplinares para el uso de GAI/GPTs/LLM en el ámbito académico de la siguiente manera:

a. La Lista de Criterios ‘NO HACER’: Será una guía integral que tiene como objetivo asegurar el uso ético y adecuado de GAI/GPTs/LLM en la investigación académica. Cubrirá cada paso del proceso académico, desde (pero no limitado a) la generación de hipótesis de investigación, la conducción del estudio y el análisis de datos (incluida la codificación), la creación de imágenes, la interpretación de hallazgos y la redacción, revisión, refinamiento y edición del manuscrito. Esta lista servirá como un recurso valioso para los investigadores, proporcionando orientación sobre qué evitar a lo largo de las diferentes etapas del proceso de investigación. Al identificar y resaltar posibles obstáculos y preocupaciones éticas, la Lista de Criterios ‘NO HACER’ ayudará a los investigadores a navegar el uso de GAI/GPTs/LLM de manera responsable y con integridad.

b. La Lista de Criterios de Divulgación: Proporcionará orientación para que los investigadores divulguen de manera transparente su uso de GAI/GPTs/LLM en la investigación académica, mejorando la transparencia, la responsabilidad y permitiendo una mejor evaluación de los hallazgos de investigación. Se enfatiza la importancia de qué y cómo divulgar, fomentando la responsabilidad y abordando los posibles riesgos y limitaciones asociados con esta tecnología.

c. La Lista de Criterios de Reporte: Proporcionará una lista de verificación de recomendaciones para garantizar el reporte completo y transparente de GAI/GPTs/LLM cuando se utilicen como intervenciones en estudios científicos. Considerará todos los aspectos importantes que deben reportarse en el manuscrito científico para mejorar la transparencia, mejorar la reproducibilidad, estandarizar las prácticas de reporte, reducir la interpretación errónea, apoyar los procesos de revisión por pares y editoriales, y facilitar la síntesis de investigación y la traducción del conocimiento.