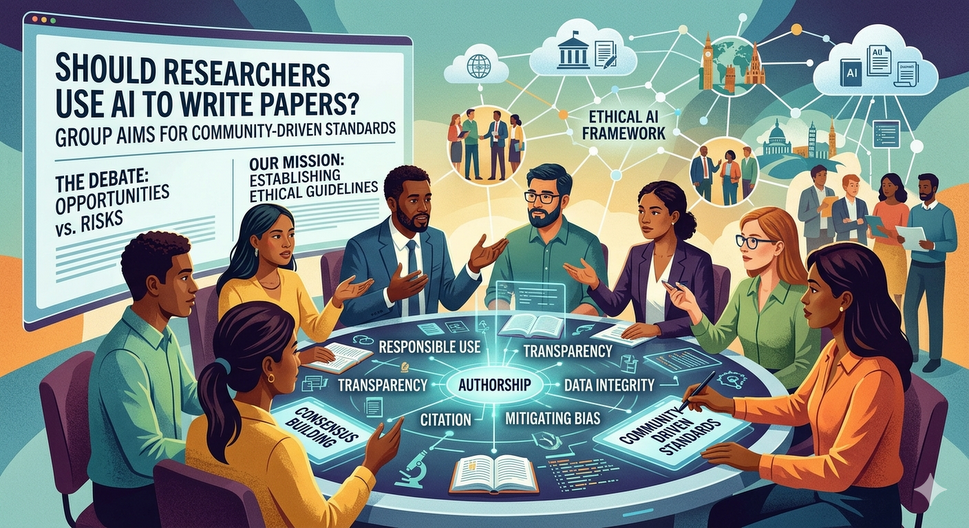
En los últimos meses ha surgido un intenso debate sobre cuándo y cómo deberían los programas de inteligencia artificial (IA) generadora de texto, como ChatGPT, ayudar a redactar artículos de investigación. Un grupo de 4000 investigadores de diversas disciplinas y países está trabajando en directrices que podrían ser adoptadas ampliamente en la publicación académica. Esta iniciativa, conocida como CANGARU, busca reemplazar el paisaje fragmentado de las directrices actuales con un conjunto único de estándares que representen el consenso de la comunidad investigadora.
CANGARU Generative Artificial Intelligence, and Natural Large Language Models for Accountable Reporting and Use Guidelines es una colaboración entre investigadores y editoriales como Elsevier, Springer Nature y Wiley, así como representantes de revistas como eLife, Cell y The BMJ, junto con el Comité de Ética de Publicación. El objetivo es lanzar un conjunto final de directrices para agosto, actualizándolas anualmente debido a la rápida evolución de esta tecnología. Estas directrices incluirán formas en las que los autores no deben utilizar los grandes modelos de lenguaje (LLMs) que alimentan a los chatbots, así como cómo deben revelar otros usos.
Si bien algunos argumentan que las herramientas de IA pueden ayudar a redactar manuscritos de manera responsable, otros temen que los defraudadores científicos las utilicen para publicar trabajos falsos convincentes rápidamente. La propensión de los LLMs a inventar cosas, combinada con su relativa fluidez en la escritura y un sistema de revisión por pares sobrecargado, representa una grave amenaza para la investigación y la publicación científica, según Tanya De Villiers-Botha, filósofa de la Universidad de Stellenbosch.
Algunas revistas y organismos ya han establecido reglas sobre cómo los científicos pueden usar herramientas de IA generativa en su trabajo, aunque el nivel de orientación varía. CANGARU está llevando a cabo una revisión sistemática de la literatura relevante para informar las directrices de IA. Sin embargo, algunos investigadores temen que la iniciativa no avance lo suficientemente rápido, dado el rápido progreso de la IA generativa.
El número de investigadores que utilizan estas herramientas en sus escritos parece estar aumentando, y se han identificado casos de uso no divulgado e ilícito de ChatGPT. Algunos investigadores han buscado pistas más sutiles en el texto generado por LLM. A medida que se establezcan las directrices de IA, el próximo paso será garantizar que los autores las cumplan, lo que requerirá la colaboración de las editoriales y un riguroso proceso de revisión por pares.
En el complejo panorama de la investigación contemporánea, el lema «publicar o perecer» ha evolucionado gradualmente hacia un mantra diferente: «Se citado o tu carrera se verá perjudicada». Las citas son la nueva moneda académica y las carreras ahora dependen firmemente de esta forma de reconocimiento académico. De hecho, la citación se ha vuelto tan importante que ha impulsado una nueva forma de engaño: redes clandestinas diseñadas para manipular citas.
Los investigadores, impulsados por el imperativo de asegurar impacto académico, recurren a la formación de anillos de citas: círculos colaborativos diseñados para aumentar artificialmente la visibilidad de su trabajo. Al hacerlo, comprometen la integridad del discurso académico y socavan los fundamentos de la búsqueda académica. La historia del moderno «cartel de citas» no es solo resultado de la presión de publicación. El surgimiento de las mega revistas también juega un papel, al igual que las revistas depredadoras y los esfuerzos institucionales por sobresalir en las clasificaciones académicas globales.
En la última década, el panorama de la investigación académica ha sido significativamente alterado por el gran número de académicos que participan en empresas científicas. El número de académicos que contribuyen a publicaciones indexadas en matemáticas se ha duplicado, por ejemplo. En respuesta a la creciente demanda de espacio en publicaciones científicas, una nueva generación de emprendedores editoriales ha aprovechado la oportunidad, y el resultado es el surgimiento de mega revistas que publican miles de artículos anualmente. Mathematics, una revista de acceso abierto producida por el Multidisciplinary Digital Publishing Institute, publicó más de 4.763 artículos en 2023, lo que representa el 9.3 por ciento de todas las publicaciones en el campo, según Web of Science. Tiene un factor de impacto de 2.4 y una medida de influencia de artículos de solo 0.37, pero, crucialmente, está indexada por Web of Science de Clarivate, Scopus de Elsevier y otros indexadores, lo que significa que sus citas cuentan hacia una variedad de métricas profesionales. (En comparación, Annals of Mathematics, publicada por la Universidad de Princeton, contenía 22 artículos el año pasado, y tiene un factor de impacto de 4.9 y una medida de influencia de artículos de 8.3.)
Las mega revistas prosperan en la era del acceso abierto, proporcionando una plataforma conveniente para investigadores ansiosos por ver su trabajo publicado y ampliamente leído. Sin barreras de pago, los artículos en esas revistas pueden compartirse (y citarse) fácilmente. La revista gana «cargos por procesamiento de artículos» (APCs) pagados por los autores de un artículo o sus instituciones, con tarifas que suelen rondar en las cuatro cifras bajas en dólares estadounidenses por artículo. Los anillos de citas, que han existido durante décadas, ahora explotan los procesos de revisión por pares rápidos y fáciles de las mega revistas para canalizar miles de referencias a sus colaboradores. El resultado es una distorsión de los índices de citas académicas y los puntajes de factor de impacto que permiten que la erudición mediocre parezca mucho más influyente de lo que es, por el precio correcto para la revista, por supuesto.
Una métrica de citas importante objetivo para los juegos de manipulación es la prestigiosa lista de «Highly Cited Researchers» de Clarivate. «De la población mundial de científicos y científicos sociales, los Investigadores Altamente Citados™ son 1 de cada 1.000», explica Clarivate. La inclusión en la lista ocurre primero a través de la actividad de citación: «Cada investigador seleccionado ha sido autor de múltiples artículos altamente citados™ que se clasifican en el 1% superior por citaciones para su(s) campo(s)». Esa lista luego se «refina utilizando análisis cualitativo y juicio experto». En general, el sello Highly Cited Researchers de Clarivate es reconocido por la comunidad investigadora como un marcador de influencia.
La lista de investigadores altamente citados también alimenta un indicador en el Ranking de Shanghái, una clasificación académica de universidades mundiales. En un intento por obtener visibilidad internacional, las instituciones no siempre se oponen a que sus miembros de la facultad encuentren atajos para el reconocimiento académico, incluso aquellos que involucran prácticas de citas dudosas. El atractivo de subir en las tablas de clasificación internacionales
Google Books está indexando libros generados por inteligencia artificial (IA) de baja calidad que aparecerán en los resultados de búsqueda, lo que podría afectar al visor de Ngram de Google, una herramienta importante utilizada por investigadores para rastrear el uso del lenguaje a lo largo de la historia.
Se encontraron libros generados por IA mediante la búsqueda de la frase «As of my last knowledge update» en Google Books. Algunos de estos libros son sobre ChatGPT, aprendizaje automático, inteligencia artificial y temas relacionados, pero la mayoría parecen ser generados por IA y no tratan sobre IA.
Estos libros generados por IA son similares a los encontrados en Amazon, y muchos de ellos están presentes en ambas plataformas. Una preocupación es la posible inclusión de estos textos generados por IA en el visor de Ngram de Google, lo que podría alterar significativamente los resultados.
Google afirmó que ninguno de los libros generados por IA identificados actualmente afecta los resultados del visor de Ngram. Sin embargo, no confirmaron si filtrarán estos libros en el futuro o si tienen una política para hacerlo.
El director de investigación del Instituto de Investigación en IA Distribuida (DAIR) señaló que esto podría crear un ciclo de retroalimentación, donde el contenido generado por IA se utiliza para entrenar nuevos modelos de IA.
La inclusión de libros generados por IA en Google Books plantea preocupaciones sobre la calidad de los resultados de búsqueda y la integridad de herramientas de investigación importantes como el visor de Ngram de Google.
Penabad-Camacho, Liana, Maria Morera, y María Amalia Penabad-Camacho. «Guía para la regulación del uso de Inteligencia Artificial en revistas científico-académicas de ciencias sociales, en procesos de arbitraje y para reportar su uso en textos científicos», 16 de marzo de 2023. https://repositorio.una.ac.cr/handle/11056/27431.
Este documento introduce el concepto de Inteligencia Artificial (IA) y su impacto en la ciencia, proponiendo una reestructuración de los métodos tradicionales de investigación y publicación. Destaca la importancia de la transparencia en el uso de la IA y su congruencia con los estándares de comunicación científica. El objetivo principal es proporcionar orientación para el reporte del uso de la IA en la publicación científica, dirigido a editores, revisores y autores.
Se incluyen definiciones clave, como la de «prompts» y «prompt net», así como diagramas para conceptualizar su uso. La guía se divide en tres partes: una dirigida a editores y equipos editoriales, otra a revisores y la tercera a autores, ofreciendo recomendaciones específicas para cada uno de estos roles en relación con el uso ético y transparente de la IA en el proceso de comunicación del conocimiento científico.
Se enfatiza que el objetivo final del uso de la IA debe ser el bien común y la mejora de la calidad de vida, destacando la importancia de mitigar sesgos y desinformación. Además, se reconoce que la IA es un fenómeno en constante evolución, por lo que se sugiere la necesidad de futuras actualizaciones de la guía y sus conceptos para adaptarse a los avances tecnológicos y científicos.
Gray, Andrew. «ChatGPT “contamination”: estimating the prevalence of LLMs in the scholarly literature». arXiv, 25 de marzo de 2024. https://doi.org/10.48550/arXiv.2403.16887.
El uso de ChatGPT y herramientas similares de Large Language Model (LLM) en la comunicación académica y la publicación académica ha sido ampliamente discutido desde que se volvieron fácilmente accesibles para una audiencia general a fines de 2022.
Las herramientas de Modelos de Lenguaje Grande (LLM) ofrecen una forma de generar grandes cantidades de texto de calidad razonablemente alta automáticamente, en respuesta a indicaciones humanas. Aunque estas herramientas han estado disponibles durante algunos años, el lanzamiento de ChatGPT 3.5 a finales de 2022, que ofrece una interfaz fácil y amplia publicidad para la herramienta, las hizo disponibles y visibles para el público en general. Desde entonces, ha habido una amplia discusión sobre su uso en las comunicaciones académicas. El entusiasmo inicial de que podrían reemplazar de manera confiable la mayoría de las formas de escritura seria, incluidos los intentos de enumerarlas como autores en documentos, ha sido reemplazado por una comprensión más matizada de sus capacidades y sus considerables limitaciones.
A fines de 2023, las encuestas encontraron que el 30% de los investigadores había utilizado herramientas para ayudar a escribir manuscritos, y muchos editores habían comenzado a ofrecer orientación sobre su uso. Por ejemplo, Wiley permite el uso de herramientas para desarrollar contenido, pero solo si los autores asumen plena responsabilidad por las declaraciones realizadas, y cuando este uso se divulga de manera transparente en el documento. Sin embargo, «las herramientas que se utilizan para mejorar la ortografía, la gramática y la edición general no están incluidas en el alcance de estas pautas».
El uso de LLMs para generar documentos fue ampliamente predicho después del lanzamiento, particularmente en «fábricas de documentos» (Paper Mills) que producen grandes cantidades de artículos de calidad deficiente. Sin embargo, es desafiante evaluar el efecto a gran escala. Algunos elementos distintivos de ChatGPT (como su conocida propensión a «alucinar» referencias) son difíciles de identificar que con el análisis caso por caso, y es probable que sean detectados por editores de todas formas.
Recientes investigaciones han identificado evidencia sólida de que ChatGPT y herramientas similares están siendo utilizados por investigadores para generar revisiones por pares para documentos de conferencias en el campo de la inteligencia artificial. Sin embargo, no se encontraron indicios de un patrón similar en las revisiones por pares para el portafolio de revistas de Nature.
Para identificar potencialmente documentos asistidos por LLM, se han identificado palabras conocidas por estar desproporcionadamente asociadas con textos generados por LLM. Estas palabras pueden ser señales de un aumento en el uso de texto generado por LLM en la literatura en su conjunto.
El estudio ha analizado la prevalencia de ciertas palabras clave y ha encontrado un aumento significativo en el uso de estas palabras en 2023, indicativo del posible uso extendido de LLM en la escritura académica. Se estima que al menos 60.000 artículos publicados en 2023 podrían haber sido asistidos por LLM, representando ligeramente más del 1% de todos los artículos académicos publicados.
Se han observado implicaciones significativas tanto para la integridad de la investigación como para el desarrollo futuro de los LLMs. Es importante abordar estas implicaciones para garantizar la calidad y la integridad de la investigación académica en el futuro.
La frase ChatGPT «A partir de mi última actualización de conocimientos» aparece en varios trabajos publicados por revistas académicas. Las revistas científicas están publicando artículos con texto generado por IA
La inclusión de lenguaje aparentemente generado por herramientas de IA como ChatGPT en artículos científicos publicados muestra cuán omnipresente se ha vuelto la tecnología, y destaca los problemas que arrastra desde tiempo atrás la publicación académica en algunas revistas académicas revisadas por pares.
Al buscar la frase «As of my last knowledge update» en Google Scholar, una herramienta de búsqueda gratuita que indexa artículos publicados en revistas académicas, se obtienen 115 resultados. La frase es utilizada frecuentemente por ChatGPT de OpenAI para indicar cuándo se está obteniendo los datos que proporciona a los usuarios, y los meses y años específicos encontrados en estos artículos académicos corresponden a actualizaciones de conocimiento previas de ChatGPT.
«Hasta la última actualización de mis conocimientos, en septiembre de 2021, no existe una correlación científica ampliamente aceptada entre el entrelazamiento cuántico y las ondas escalares longitudinales», una frase que frecuentemente utiliza ChatGPT, se lee en un artículo titulado «Quantum Entanglement: Examining its Nature and Implications» publicado en el «Journal of Material Sciences & Manfacturing [sic] Research», una publicación que afirma estar revisada por expertos.
La mayoría de los artículos científicos que se observan y que incluyen esta frase fueron publicados en revistas que son pequeñas, no muy conocidas y parecen ser «fábricas de artículos«, revistas con bajos estándares editoriales que publicarán casi cualquier cosa rápidamente. Una publicación donde se encontró la frase generada por IA, la revista Open Access Research Journal of Engineering and Technology,, solicita «cargos por publicación bajos», un «certificado electrónico» de publicación, y actualmente está anunciando una convocatoria de artículos, prometiendo la aceptación dentro de 48 horas y la publicación dentro de cuatro días.
Este tipo de revistas son un problema bien conocido en la comunidad académica, y preceden a la llegada de las herramientas de IA generativas. En febrero, The Guardian informó que el año pasado se retiraron 10.000 «artículos fraudulentos» de revistas académicas. Un estudio en Nature también destacó estafas de «pago por publicación», que son revistas que cobran tarifas exorbitantes a cambio de publicar un artículo rápidamente. Separar este tipo de artículos y revistas de la ciencia legítima a veces puede ser difícil, porque muchas revistas respetables también cobran a los científicos «tarifas de procesamiento de artículos» (APCs) para ser publicadas.
Sin embargo, también se encontró lenguaje generado por IA en revistas académicas más respetables. La semana pasada, la investigadora de Bellingcat Kolina Koltai tuiteó un artículo publicado en Superficies e Interfaces, que incluía la frase «Certainly, here is a possible introduction for your topic:» (He aquí una posible introducción para su tema) al comienzo de la introducción del artículo. El título del artículo es “The three-dimensional porous mesh structure of Cu-based metal-organic-framework – aramid cellulose separator enhances the electrochemical performance of lithium metal anode batteries.”
Michael J. Naughton, profesor de física en Boston College y uno de los editores de Superficies e Interfaces, dijo que la publicación es consciente del artículo y está «retractándolo». Naughton también señaló la política existente de la publicación sobre IA.
«Cuando los autores utilizan inteligencia artificial generativa (IA) y tecnologías asistidas por IA en el proceso de escritura, los autores solo deben usar estas tecnologías para mejorar la legibilidad y el lenguaje», establece la política. «La aplicación de la tecnología debe hacerse con supervisión y control humanos, y los autores deben revisar cuidadosamente y editar el resultado, ya que la IA puede generar una salida que suena autoritaria pero que puede ser incorrecta, incompleta o sesgada.»
La política también establece que los autores deben revelar si usan IA en el artículo.
Algunos de los artículos indexados en Google Scholar que usan respuestas estándar de ChatGPT no son necesariamente investigaciones generadas por IA. Algunos de los artículos son estudios que investigan los tipos de respuestas que da ChatGPT, y simplemente citan las respuestas que obtienen. Por ejemplo, uno de los artículos que utiliza el término está investigando los «modelos de falla» de varios sistemas de chat de IA.
Esta no es la primera vez que se observa a revistas académicas publicar contenido generado por IA. En febrero, una revista llamada Frontiers in Cell Development and Biology publicó un artículo con varias imágenes claramente generadas por IA, incluida una de una rata con un pene gigante.
Según la propia empresa BypassGPT reescribe el contenido para convertirlo en una escritura de IA indetectable, ayudando a evitar la detección de IA incluso por parte de los detectores de IA más avanzados del mercado. Además también dice que humaniza el contenido sin errores, eliminando los errores gramaticales, sintácticos, de puntuación y ortográficos que podrían socavar la profesionalidad.
Estos sistemas modifican el texto original, cambiando términos y estructuras para que no sea tan fácilmente detectable por algoritmos de detección de IA. Para usarlo, se accede ala web como bypassgpt.ai/es, se pega el texto en la ventana izquierda y se hace clic en «Humanizar». El texto mejorado aparecerá en la ventana derecha.
Ofrece diferentes modos de funcionamiento: rápido, creativo o mejor. Es importante recordar que no garantiza que el texto no sea detectado como IA, especialmente si el original fue escrito por IA. Se recomienda probar los diferentes modos y revisar el texto resultante para mejorarlo.
BypassGPT, una herramienta diseñada para hacer que el texto escrito por la inteligencia artificial parezca más humano. Reconoce que, aunque BypassGPT puede ser útil, no garantiza que el texto sea indistinguible del contenido escrito por humanos. Esto se debe a que los detectores de IA también mejoran constantemente.
Los científicos están haciendo sonar la alarma sobre la publicación masiva de miles de documentos de investigación falsos en revistas, lo que constituye un creciente escándalo internacional. Esta situación está comprometiendo la investigación médica, obstaculizando el desarrollo de medicamentos y poniendo en peligro la prometedora investigación académica. Una ola global de ciencia fraudulenta está afectando gravemente a laboratorios y universidades.
El año pasado, el número anual de documentos retractados por revistas de investigación superó los 10.000 por primera vez. La mayoría de los analistas creen que la cifra es solo la punta de un iceberg de fraude científico.
«La situación se ha vuelto alarmante», dijo la profesora Dorothy Bishop de la Universidad de Oxford. «El nivel de publicación de documentos fraudulentos está creando problemas serios para la ciencia. En muchos campos, está volviéndose difícil construir un enfoque acumulativo hacia un tema, porque nos falta una base sólida de hallazgos confiables. Y va empeorando más y más».
El sorprendente aumento en la publicación de documentos de ciencia falsa tiene sus raíces en China, donde a jóvenes médicos y científicos que buscaban ascensos se les exigía haber publicado documentos científicos. Organizaciones clandestinas, conocidas como «fábricas de documentos» (Paper mills), comenzaron a suministrar trabajos fabricados para su publicación en revistas allí.
La práctica se ha extendido desde entonces a India, Irán, Rusia, estados de la antigua Unión Soviética y Europa del Este, con «fábricas de documentos» suministrando estudios fabricados a más y más revistas a medida que aumenta el número de jóvenes científicos que intentan impulsar sus carreras al reclamar una falsa experiencia de investigación. En algunos casos, los editores de revistas han sido sobornados para aceptar artículos, mientras que las «fábricas de documentos» han logrado establecer a sus propios agentes como editores invitados que luego permiten que se publiquen montones de trabajos falsificados.
«Los editores no están cumpliendo adecuadamente con sus roles y los revisores por pares no están haciendo su trabajo. Y algunos están siendo pagados grandes sumas de dinero», dijo la profesora Alison Avenell de la Universidad de Aberdeen. «Es profundamente preocupante».
Los productos de las «fábricas de documentos» a menudo parecen artículos regulares pero se basan en plantillas en las que se insertan nombres de genes o enfermedades al azar entre tablas y figuras ficticias. Preocupantemente, estos artículos pueden ser incorporados a grandes bases de datos utilizadas por aquellos que trabajan en el descubrimiento de medicamentos.
Otros son más extraños e incluyen investigaciones no relacionadas con el campo de una revista, lo que deja en claro que no se ha llevado a cabo una revisión por pares en relación con ese artículo. Un ejemplo es un documento sobre la ideología marxista que apareció en la revista Computational and Mathematical Methods in Medicine. Otros son distintivos debido al lenguaje extraño que utilizan, incluyendo referencias a «peligro del seno» en lugar de cáncer de seno y «afección de Parkinson» en lugar de enfermedad de Parkinson.
Grupos de vigilancia, como Retraction Watch, han rastreado el problema y han notado retractaciones por parte de revistas que se vieron obligadas a actuar en ocasiones cuando se descubrieron fabricaciones. Un estudio, realizado por Nature, reveló que en 2013 hubo poco más de 1.000 retractaciones. En 2022, la cifra superó los 4.000 antes de saltar a más de 10.000 el año pasado.
De los más de 10.000 documentos retractados el año pasado, más de 8,000 habían sido publicados en revistas propiedad de Hindawi, una subsidiaria de Wiley. Estas cifras han obligado a la empresa a tomar medidas drásticas. Un portavoz de Wiley anunció: «Vamos a eliminar la marca Hindawi y hemos comenzado a integrar completamente los más de 200 diarios de Hindawi en el portafolio de Wiley». Además, la compañía ha identificado a cientos de estafadores en su cartera de revistas y ha removido a aquellos que desempeñaron roles editoriales. Aunque Wiley reconoce que no puede abordar la crisis por sí sola, otras editoriales también se ven afectadas por los «paper mills». Los académicos se muestran cautelosos, ya que en muchos países son remunerados según la cantidad de artículos publicados. El daño causado por la publicación de investigaciones deficientes o falsas se evidencia con el caso del fármaco antiparasitario ivermectina, que inicialmente se creyó que podría tratar el Covid-19 pero posteriormente se descubrió evidencia clara de fraude en los estudios. Este incidente ilustra cómo la ciencia se ve afectada por el material fabricado. Los expertos advierten sobre la creciente amenaza de los «paper mills» y la investigación fraudulenta, señalando que la integridad del conocimiento científico está en peligro y que la corrupción está infiltrándose en el sistema.
Según el Comité de Ética de las Publicaciones, una organización sin ánimo de lucro financiada por los editores, las revistas pueden decidir rechazar o retractarse de los lotes de artículos sospechosos de haber sido producidos por una Paper mills, aunque las pruebas sean circunstanciales. Sus directrices anteriores animaban a las revistas a pedir más información a los autores de cada artículo sospechoso, lo que puede desencadenar un largo tira y afloja.
Este documento proporciona orientación práctica para abordar cuatro áreas de preocupación donde los editores necesitan más orientación: cómo manejar la carga práctica y administrativa de recopilar evidencia; cómo proporcionar un debido proceso oportuno que considere la evaluación en lote, al mismo tiempo que también considere los impactos y restricciones de recursos para revistas/editoriales; el alcance y los mecanismos para compartir información entre editores; y cómo manejar las demandas conflictivas de libertad editorial, responsabilidad editorial y riesgos legales.
Puntos clave La orientación cubre los principios generales:
La necesidad de políticas de revistas que especifiquen qué acciones se tomarán si hay sospechas de manipulación del proceso de publicación (fábricas de artículos).
La necesidad de compartir información de manera confidencial entre editores (por ejemplo, a través del foro de editores de COPE o del STM Integrity Hub).
La gestión de casos de manera colectiva en lugar de caso por caso.
Transparencia en los avisos de retractación relacionados con la manipulación del proceso de publicación.
La toma de decisiones editoriales basada en todas las pruebas (incluidas las circunstanciales) relevantes para las preocupaciones a nivel de lote, y empoderar a los editores para usar el juicio sobre si se debe solicitar datos primarios u otra documentación.
El papel del editor en apoyar a los editores para tomar decisiones basadas en la confiabilidad del contenido, y asegurar que haya sistemas para respaldar a los editores en responder a amenazas legales.
Un nuevo estudio resalta que un vendedor que ofrece citas a la venta se suma a la lista de actores problemáticos en la publicación académica. Según la investigación, investigadores sin escrúpulos disponen de múltiples opciones para manipular las métricas de citas.
En 2023, apareció un nuevo perfil de Google Scholar en línea que presentaba a un investigador desconocido. En pocos meses, el científico, un experto en noticias falsas, fue catalogado por la base de datos académica como el 36º investigador más citado en su campo. Tenía un índice h de 19, lo que significa que había publicado 19 artículos académicos que habían sido citados al menos 19 veces cada uno. Fue un impresionante debut en la escena de la publicación académica.
Pero nada de eso era legítimo. El investigador y su institución eran ficticios, creados por investigadores de la Universidad de Nueva York en Abu Dhabi que investigaban prácticas editoriales cuestionables. Las publicaciones fueron escritas por ChatGPT. Y los números de citas eran falsos: algunas provenían de la excesiva auto-cita del autor, mientras que otras 50 fueron compradas por 300$ a un vendedor que ofrecía un «servicio de impulso de citas».
«La capacidad de comprar citas en gran cantidad es un desarrollo nuevo y preocupante», dice Jennifer Byrne, una investigadora de cáncer de la Universidad de Sídney que ha estudiado publicaciones problemáticas en la literatura biomédica. En la universidad, el índice h de un investigador y el número de citas que han recibido a menudo se utilizan para decisiones de contratación y ascenso. Y el perfil fabricado, que fue parte de un estudio publicado como preprint la semana pasada en arXiv, muestra tácticas «extremas» que se pueden emplear para manipularlos, agrega Byrne, quien no estuvo involucrada en el trabajo. (Los investigadores declinaron nombrar al vendedor para evitar darles más negocios).
El estudio comenzó cuando Yasir Zaki, un científico de la computación en la Universidad de Nueva York en Abu Dhabi, y sus colegas notaron patrones preocupantes entre investigadores reales. Después de examinar los perfiles de Google Scholar de más de 1.6 millones de científicos y mirar a autores con al menos 10 publicaciones y 200 citas, el equipo identificó a 1016 científicos que habían experimentado un aumento de 10 veces en las citas en un solo año. «Sabes que algo anda mal cuando un científico experimenta un aumento repentino y masivo en sus citas», dice Zaki.
El equipo señaló a 114 científicos que habían recibido más de 18 citas de un solo artículo, un signo sospechoso, según Zaki, «ya que es raro que incluso los científicos establecidos tengan más de un puñado de citas provenientes de la misma fuente». En un caso particularmente flagrante, el 90% de las referencias en un solo artículo citaban las publicaciones de un científico. «Fue… publicado en una revista de la que el científico sospechoso es editor», dice Zaki.
Muchas de las citas asociadas con los 114 científicos sospechosos provenían de publicaciones de baja calidad, dicen los investigadores, incluidos preprints, que no están sujetos a revisión por pares. Algunas de las publicaciones citantes ni siquiera mencionaban el trabajo del investigador en el texto principal del artículo; la cita simplemente se había añadido a la lista de referencias al final.
El equipo también notó que uno de los autores había recibido muchas citas de documentos alojados por una cuenta en ResearchGate, un sitio de redes sociales para científicos. «Para nuestro asombro, ¡esa cuenta estaba anunciando abiertamente un servicio de compra de citas!», dice el autor del estudio, Talal Rahwan, un científico de informática en la Universidad de Nueva York en Abu Dhabi.
Fue entonces cuando decidieron crear el perfil ficticio de Google Scholar y ver si podían comprar citas ellos mismos. Le pidieron a ChatGPT que escribiera 20 artículos de investigación sobre el tema de las noticias falsas, incluyendo muchas auto-citas, referencias a documentos escritos por el mismo autor ficticio, imitando una práctica que algunos investigadores usan para aumentar sus números de citas.
Luego, publicaron los artículos en varios servidores de preprints. Google Scholar detectó esos artículos en su exploración de la literatura académica y se recogieron en el perfil del autor ficticio, enumerando esos preprints como publicaciones y dándole al investigador crédito por 380 auto-citas contenidas en ellos.
A partir de ahí, fue relativamente fácil comprar citas adicionales. Utilizando el nombre del científico ficticio, el equipo de investigación contactó al vendedor a través de WhatsApp y compró el «paquete de 50 citas». Dentro de 40 días, se publicaron cinco artículos que incluían cada uno 10 citas al trabajo del investigador de noticias falsas ficticio. Cuatro de los cinco aparecieron en una sola revista de química. «Esto no tenía sentido, ya que los documentos de nuestro investigador ficticio no estaban ni remotamente relacionados con la química», señala Rahwan.
El estudio sugiere que algunos investigadores están utilizando tácticas similares a las empleadas por el equipo de la Universidad de Nueva York en Abu Dhabi para aumentar sus clasificaciones de citas. «La evidencia que muestran en este documento es bastante sólida», dice Naoki Masuda, un matemático de la Universidad de Buffalo que ha estudiado citas anómalas.
Los autores no pueden decir cuan extendidos son estos problemas en la literatura académica. «Solo nos enfocamos en los casos escandalosos», dice Rahwan. Pero vieron señales de que otros artículos publicados por la misma revista de química pueden haber incluido citas que fueron compradas: Once otros (reales) científicos habían recibido al menos 10 citas de un solo artículo publicado en esa revista.
Bernhard Sabel, un neuropsicólogo de la Universidad Otto von Guericke en Magdeburgo que ha estudiado fábricas de papel que venden autoría en artículos científicos, dice que la comunidad académica debería estar «muy preocupada» por este tipo de manipulaciones. «El problema es grande, y ha estado creciendo rápidamente en los últimos 10-15 años», agrega Sabel. En su opinión, Google Scholar y otras bases de datos