Se analiza el creciente distanciamiento de varias universidades británicas respecto a Turnitin, una de las plataformas más extendidas para la detección de similitudes textuales y el apoyo a la integridad académica. Las universidades de Newcastle y Westminster han anunciado que no renovarán sus contratos cuando finalicen sus acuerdos actuales, sumándose a la Universidad de Southampton, que ya había comunicado una decisión similar. Estas medidas reflejan un cambio de actitud hacia herramientas que durante años han ocupado un lugar central en los procedimientos universitarios para detectar el plagio, pero cuya utilidad, coste y condiciones de tratamiento de los datos están siendo objeto de un examen más crítico.
Una de las principales razones de esta controversia son los cambios propuestos por Turnitin en su acuerdo de licencia de usuario final. Las modificaciones suscitaron preocupación porque podían abrir la posibilidad de utilizar trabajos y datos de estudiantes y personal universitario con fines relacionados con la inteligencia artificial. La Universidad de Newcastle ha señalado expresamente sus dudas sobre el posible uso de estos datos, mientras que Southampton decidió iniciar la retirada progresiva del servicio. Tras las críticas de distintas instituciones y organizaciones del sector, Turnitin aplazó la aplicación de los cambios hasta septiembre de 2027 y aceptó dialogar con representantes universitarios para abordar las inquietudes planteadas. La empresa sostiene que actualmente no utiliza los trabajos de los estudiantes para entrenar modelos de inteligencia artificial generativa o grandes modelos de lenguaje (LLM), aunque distingue este supuesto del entrenamiento de clasificadores destinados a identificar textos que probablemente hayan sido generados por IA.
El caso de la Universidad de Westminster introduce una segunda cuestión fundamental: la eficacia real de estas tecnologías frente a las nuevas formas de producción textual. La institución considera que el detector de similitudes tradicional resulta poco eficaz ante uno de los principales desafíos actuales para la integridad académica: los trabajos elaborados mediante inteligencia artificial generativa. Asimismo, cuestiona la fiabilidad de los detectores de IA, puesto que sus resultados son probabilísticos y pueden producir falsos positivos. Esto significa que un texto redactado por una persona podría ser señalado erróneamente como generado por IA. La controversia pone de manifiesto una limitación esencial de estos sistemas: la detección automática no constituye una prueba concluyente de fraude académico y sus resultados deben interpretarse con prudencia, atendiendo al contexto y a otras evidencias disponibles.
El factor económico también desempeña un papel importante en las decisiones de las universidades. Según los datos recogidos por el artículo, la Universidad de Southampton pagó 87.621 libras esterlinas por los servicios de Turnitin entre septiembre de 2024 y septiembre de 2025, mientras que la Universidad de East Anglia desembolsó 50.892 libras durante el periodo comprendido entre abril de 2024 y marzo de 2025. Aunque estos importes corresponden a instituciones de distinto tamaño y no permiten establecer una comparación directa de costes por estudiante, ilustran la dimensión presupuestaria de estos contratos. Algunos especialistas consideran que la preocupación por la privacidad y la inteligencia artificial es legítima, pero que también puede estar favoreciendo una revisión más amplia del gasto en plataformas educativas. Las universidades se preguntan si necesitan contratar un paquete completo de servicios cuando sus entornos virtuales de aprendizaje ya permiten gestionar entregas, calificaciones y comentarios, y pueden complementarse con herramientas alternativas de comprobación de originalidad.
La situación, sin embargo, no representa todavía un abandono generalizado de Turnitin. Algunas instituciones continúan utilizando la plataforma mientras revisan sus condiciones contractuales y estudian otras soluciones. La Universidad de Cambridge, por ejemplo, ha manifestado que no aceptará cambios en el acuerdo que afecten a la privacidad de los datos o a la propiedad intelectual, aunque mantiene el servicio por el momento. Aberdeen está revisando su utilización, mientras que otras universidades exploran alternativas para gestionar la entrega y evaluación de trabajos académicos. El debate se extiende así más allá de la elección de un programa concreto y alcanza cuestiones estratégicas relacionadas con la contratación tecnológica, la protección de la información y la autonomía institucional.
La expansión de la inteligencia artificial generativa está obligando a las universidades a reconsiderar sus mecanismos tradicionales de control de la integridad académica. La decisión de abandonar Turnitin no responde exclusivamente a las dudas sobre el uso de los datos estudiantiles: también intervienen el precio de las licencias, las limitaciones de los detectores y la necesidad de revisar los métodos de evaluación. Algunos especialistas proponen replantear el diseño de las actividades académicas, en lugar de confiar principalmente en herramientas automáticas para identificar posibles irregularidades. Desde esta perspectiva, resulta más adecuado combinar normas transparentes sobre el uso de la IA, evaluación crítica de los trabajos, seguimiento del proceso de aprendizaje y conversaciones pedagógicas con el alumnado. La cuestión central ya no es solamente cómo detectar textos generados por inteligencia artificial, sino cómo garantizar una evaluación justa, proteger los derechos de los estudiantes y promover una cultura de integridad académica adaptada a las nuevas tecnologías.
Retraction Watch. (21 de septiembre de 2026).Misconduct case dropped against AI expert after claims of AI use in recent book. Retraction Watch. Artículo original en Retraction Watch
El caso afecta a Virginia Dignum, profesora de inteligencia artificial responsable en la Universidad de Umeå (Suecia) y especialista en las dimensiones sociales de la IA. Una persona anónima presentó una denuncia por posible mala conducta investigadora relacionada con su libro The AI Paradox, publicado por Princeton University Press en febrero de 2026. Las acusaciones se centraban principalmente en dos cuestiones: la supuesta utilización de inteligencia artificial para generar partes del texto y la existencia de referencias bibliográficas que presentaban errores o que, según la denuncia, podían haber sido inventadas.
La Universidad de Umeå recibió la denuncia el 6 de julio de 2026 y remitió el asunto al National Board for Assessment of Research Misconduct (NPOF), organismo sueco encargado de evaluar determinados casos de mala conducta científica. Sin embargo, el 4 de septiembre el organismo decidió cerrar el expediente sin iniciar una investigación, al considerar que las acusaciones quedaban fuera de su ámbito de competencia. El motivo fundamental fue la naturaleza del libro: según la información proporcionada al organismo, The AI Paradox es una obra de divulgación dirigida al público general y no una investigación científica ni un trabajo realizado en el marco de financiación para investigación.
El NPOF concluyó que el libro no constituye investigación científica a efectos de la normativa sueca sobre mala conducta investigadora. El organismo señaló que Dignum considera la obra un libro de divulgación científica, que no formula afirmaciones propias de una investigación y que fue escrita durante su tiempo libre, fuera del ámbito de proyectos financiados. La Universidad de Umeå tampoco encontró elementos que contradijeran esta descripción. Por ello, una vez archivado el expediente, la universidad indicó que no adoptaría medidas específicas contra la investigadora en relación con esta denuncia.
Un elemento particularmente interesante del caso son las referencias bibliográficas cuestionadas. Dignum negó que hubiera fuentes inventadas y explicó que las seis referencias señaladas por la denuncia correspondían a fuentes reales. Reconoció, no obstante, que algunas referencias contenían errores y que determinados problemas se produjeron al utilizar una herramienta de IA para transformar las citas a formato BibTeX. Según su explicación, se trató de errores de edición y no de fabricación deliberada de referencias. Princeton University Press publicó posteriormente una versión electrónica actualizada del libro con correcciones en varias referencias y anunció que las correcciones también se incorporarían a futuras ediciones impresas.
Dignum también reconoció haber utilizado herramientas de inteligencia artificial durante la elaboración del libro para comprobar formulaciones y proponer alternativas de redacción. Según su explicación, el contenido intelectual y el texto final son de su autoría y ella asume la responsabilidad por ellos. El caso vuelve a poner sobre la mesa una cuestión todavía poco definida en el ámbito académico: qué usos de la IA en la escritura son aceptables y cuáles deberían considerarse problemáticos desde el punto de vista de la integridad académica.
Otro aspecto relevante es la utilización de detectores de IA como elemento de prueba. Una de las acusaciones se apoyaba en herramientas que supuestamente habían identificado determinados fragmentos del libro como generados por inteligencia artificial. Dignum cuestionó este tipo de evidencia y sostuvo que no es posible demostrar de manera concluyente que un texto no haya sido generado por IA únicamente mediante herramientas de detección. El caso ilustra así una de las principales dificultades actuales de los detectores: una señal algorítmica de posible generación automática no equivale necesariamente a una prueba de autoría mediante IA.
El bioeticista David Resnik, citado por Retraction Watch, considera que todavía existe una zona de incertidumbre ética respecto al nivel de utilización de IA aceptable en la escritura académica. También advierte sobre la compleja posición de los denunciantes o whistleblowers: pueden contribuir a descubrir auténticas prácticas irregulares, pero también pueden generar investigaciones institucionales costosas cuando las irregularidades denunciadas son menores o no constituyen realmente mala conducta científica.
El caso resulta especialmente significativo para el debate sobre IA e integridad científica porque diferencia tres cuestiones que con frecuencia se mezclan: el uso legítimo o declarado de herramientas de IA durante la redacción, los errores bibliográficos producidos durante procesos asistidos por IA y la verdadera fabricación o falsificación de información. El archivo de la denuncia no significa que todos los problemas señalados en el libro fueran inexistentes: la propia autora reconoció errores bibliográficos que fueron posteriormente corregidos. Lo que determinó el cierre del procedimiento fue, fundamentalmente, que la obra no entraba dentro de la definición de investigación científica sometida a la jurisdicción del organismo sueco.
CNET. “AI Detectors Are Being Used to Discipline Students. I Tested Whether They Should Be.” CNET, 2026. Artículo original en CNET
Los detectores de IA pueden proporcionar indicios, pero no deberían considerarse una prueba concluyente de autoría ni constituir, por sí solos, la base para sancionar a un estudiante. La cuestión fundamental no es solamente si podemos detectar IA, sino cómo garantizar procesos de evaluación académica justos y fiables en un contexto en el que humanos e inteligencia artificial colaboran cada vez más en la producción de textos.
Se aborda un problema cada vez más controvertido en el ámbito educativo: el uso de detectores de inteligencia artificial para determinar si un estudiante ha utilizado ChatGPT u otras herramientas generativas en la elaboración de un trabajo. La cuestión adquiere especial importancia porque algunas instituciones educativas están utilizando estas herramientas como elemento de prueba para investigar o incluso sancionar a estudiantes, pese a que la detección de textos generados por IA no ofrece una certeza equivalente a la de una prueba objetiva de autoría.
La experiencia descrita en el artículo pone de manifiesto una de las principales debilidades de estos sistemas: los detectores pueden equivocarse tanto al identificar textos humanos como textos generados por IA. El problema de los falsos positivos resulta especialmente preocupante en contextos académicos, ya que un texto redactado íntegramente por un estudiante puede ser clasificado como producido por inteligencia artificial. Del mismo modo, pequeñas modificaciones o procesos de edición pueden alterar considerablemente el resultado de la detección.
El artículo también cuestiona la idea de que exista una especie de “huella digital” inequívoca de la IA en un texto. Los modelos de detección trabajan mediante estimaciones probabilísticas relacionadas con características lingüísticas y patrones estadísticos, pero no pueden demostrar por sí mismos quién ha escrito un documento. Por ello, un porcentaje elevado de probabilidad de utilización de IA no debería interpretarse como una prueba definitiva de que un estudiante ha cometido una infracción académica.
Una cuestión particularmente relevante es la asimetría entre el poder de estas herramientas y las consecuencias de sus errores. Cuando un detector se emplea simplemente como instrumento orientativo para iniciar una conversación con el estudiante, sus limitaciones pueden resultar manejables. Sin embargo, cuando el resultado se transforma directamente en una acusación o en una sanción académica, un falso positivo puede tener consecuencias importantes para la trayectoria educativa de una persona. El artículo invita, por tanto, a diferenciar claramente entre detectar una anomalía estadística y demostrar una conducta académicamente deshonesta.
El texto resulta especialmente pertinente para el debate sobre integridad académica en la era de la IA generativa. La aparición de ChatGPT y de otras herramientas similares obliga a las universidades a replantearse no solamente cómo detectar posibles usos indebidos de IA, sino también qué significa actualmente escribir, investigar, aprender y demostrar competencias. En lugar de depositar una confianza excesiva en los detectores, parece más razonable combinar diferentes evidencias: proceso de elaboración del trabajo, versiones anteriores, referencias utilizadas, capacidad del estudiante para explicar sus argumentos y diálogo con el docente.
En este sentido, el artículo plantea indirectamente un cambio de enfoque: la respuesta a la IA generativa no debería basarse exclusivamente en una tecnología destinada a “policiar” los textos, sino en estrategias educativas que permitan enseñar un uso responsable, transparente y crítico de estas herramientas. Para las bibliotecas universitarias y los programas de alfabetización informacional, esto supone una oportunidad para incorporar nuevas competencias relacionadas con la IA, la evaluación crítica de sus resultados, la transparencia en su utilización y la comprensión de sus limitaciones.
Un 35 % de las páginas analizadas publicadas después de noviembre de 2022 mostraban en julio de 2026 una alta probabilidad de haber sido escritas o editadas con IA, frente al 9,6 % cuando se considera todo el conjunto de páginas analizadas.
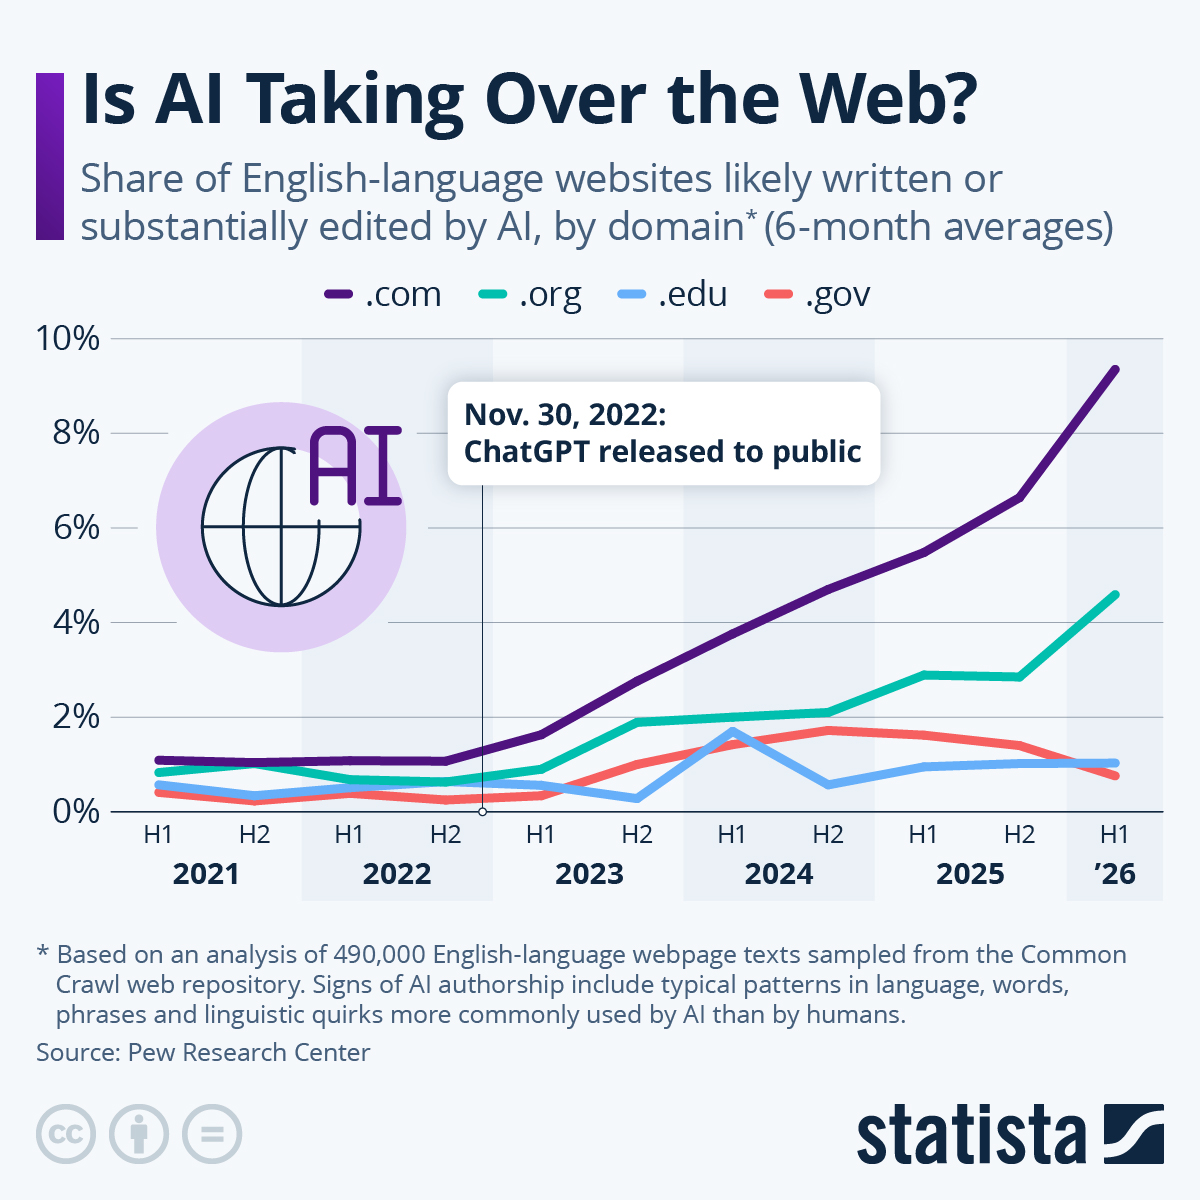
El crecimiento de las herramientas de inteligencia artificial generativa está transformando rápidamente la producción de contenidos en Internet. Un análisis realizado por el Pew Research Center sobre casi 490.000 páginas web, recopiladas a través de Common Crawl y analizadas mediante la herramienta de detección Open Pangram, muestra un incremento muy significativo de los textos que presentan características compatibles con haber sido escritos o editados mediante IA desde la aparición de ChatGPT en noviembre de 2022.
Antes de la llegada de ChatGPT, aproximadamente el 1 % de las páginas bajo dominios .com presentaba señales significativas de autoría mediante IA. En la primera mitad de 2026, esta proporción había aumentado hasta más del 9 %. Sin embargo, esta cifra debe interpretarse con cautela, ya que el conjunto analizado incluye páginas publicadas antes de la aparición de las herramientas actuales de IA generativa. Por ello, cuando se consideran exclusivamente contenidos publicados después de noviembre de 2022, la presencia de IA resulta considerablemente mayor.
De hecho, el dato más llamativo corresponde a julio de 2026: el 35 % de las páginas publicadas después del lanzamiento de ChatGPT presentaba una alta probabilidad de haber sido escrita o editada con inteligencia artificial. Cuando se analiza el conjunto de páginas web de la muestra, independientemente de su fecha de publicación, la proporción era del 9,6 %. La diferencia muestra hasta qué punto la utilización de IA se ha acelerado en apenas tres años y medio.
El fenómeno no afecta por igual a todos los tipos de sitios web. Según el análisis presentado por Statista, los dominios .gov y .edu presentan niveles de utilización de IA significativamente inferiores, lo que sugiere que las administraciones públicas y las instituciones educativas continúan dependiendo en mayor medida de la producción humana. Esto resulta especialmente relevante para el ámbito académico, donde la autoría, la trazabilidad y la integridad de los contenidos adquieren una importancia particular.
El estudio también pone de manifiesto un problema metodológico importante: detectar que un texto probablemente ha sido generado o editado por IA no equivale a demostrar que lo ha sido. Herramientas como Open Pangram trabajan mediante indicadores estadísticos y de estilo, por lo que pueden producir falsos positivos. Incluso elementos que se han convertido en supuestas «señales de IA», como el uso frecuente de la raya o em dash, no constituyen por sí mismos una prueba de autoría artificial.
En conjunto, los datos apuntan hacia una transformación profunda del ecosistema informativo de Internet: la web posterior a ChatGPT está incorporando contenidos producidos o modificados mediante IA a una velocidad considerable. El dato del 35 % entre las páginas posteriores a ChatGPT resulta especialmente significativo y plantea nuevas cuestiones sobre la calidad, originalidad, transparencia y fiabilidad de la información digital. La cuestión ya no parece ser si la IA está entrando en Internet, sino hasta qué punto llegará a determinar la producción futura de sus contenidos.
El crecimiento del uso de herramientas de inteligencia artificial como ChatGPT, Gemini o Claude ha generado una nueva preocupación en ámbitos como la educación, el periodismo, la contratación de personal y la creación de contenidos: ¿es posible distinguir con fiabilidad un texto escrito por una persona de otro generado por una IA? Para responder a esta pregunta, Popular Science realizó una prueba práctica con cinco de los detectores de IA más populares del mercado: Pangram, Grammarly, GPTZero, Scribbr y Copyleaks.
Los detectores de texto generado por inteligencia artificial se han convertido en una herramienta habitual en escuelas, universidades y empresas preocupadas por el uso de modelos como ChatGPT, Gemini o Claude. Sin embargo, una prueba realizada por Popular Science demuestra que estas aplicaciones están lejos de ser infalibles. El artículo evaluó cinco detectores ampliamente utilizados enfrentándolos tanto a textos escritos íntegramente por una persona como a otros producidos por diferentes modelos de IA.
El objetivo era comprobar si realmente pueden distinguir con precisión entre escritura humana y escritura artificial. Los resultados revelan que todos los sistemas analizados cometieron errores, aunque en distinta medida, lo que pone de manifiesto las limitaciones actuales de esta tecnología.
La principal conclusión es que ningún detector ofrece una fiabilidad del 100 %. Algunas herramientas identificaron correctamente buena parte de los textos generados por IA, pero también clasificaron como artificiales escritos completamente humanos (falsos positivos) y, a la inversa, consideraron como humanos algunos textos creados por modelos de lenguaje (falsos negativos). Esta variabilidad se debe a que los detectores no reconocen el origen real de un documento, sino que calculan la probabilidad de que un texto presente determinados patrones estadísticos característicos de la escritura generada por IA, como la baja «perplejidad» o una estructura lingüística especialmente uniforme.
Pangram: el detector más preciso
La primera herramienta evaluada fue Pangram, que se presenta como «un detector de IA que realmente funciona». En la prueba obtuvo un resultado perfecto. Reconoció correctamente ambos textos escritos por el autor como completamente humanos, asignándoles un 100 % de probabilidad de autoría humana y un alto grado de confianza. Del mismo modo, identificó correctamente los textos generados por ChatGPT y Claude como escritos íntegramente por IA. Además de emitir un porcentaje, explicó qué expresiones o estructuras habían influido en su decisión, señalando algunas frases típicas del estilo de los modelos de lenguaje.
Grammarly: muy fiable, aunque menos contundente
La segunda herramienta fue Grammarly, conocida tradicionalmente por sus funciones de corrección ortográfica y gramatical, pero que también incorpora un detector de IA. Los dos textos humanos fueron clasificados correctamente como escritos por una persona, sin detectar ningún patrón asociado a inteligencia artificial. Sin embargo, cuando analizó los textos generados por Claude y Gemini, sí detectó que probablemente habían sido creados mediante IA, aunque con un grado de confianza inferior al de Pangram: uno recibió una probabilidad del 68 % y el otro del 66 % de haber sido generado artificialmente. Es decir, Grammarly acertó en todos los casos, aunque mostró mayor cautela en sus conclusiones.
GPTZero: otra de las herramientas más fiables
El tercer detector fue GPTZero, una de las aplicaciones más conocidas en el ámbito educativo y universitario. Los dos textos escritos por el autor fueron clasificados como completamente humanos, indicando incluso que existía una elevada confianza en esa conclusión. Cuando analizó los textos producidos por Gemini y ChatGPT también los identificó correctamente como generados por inteligencia artificial. Una característica interesante de GPTZero es que no solo ofrece una valoración global, sino que señala las frases concretas que considera más características de un texto generado por IA. Sin embargo, el propio autor reconoce que, al revisar esas frases, no siempre resulta evidente qué rasgos específicos justifican dicha clasificación.
Scribbr: el gran decepcionante
La cuarta herramienta fue Scribbr, conocida principalmente por sus servicios de revisión académica. En este caso, el detector identificó correctamente los textos humanos como escritos por personas. Sin embargo, falló completamente al analizar los textos generados por IA, clasificándolos también como totalmente humanos. Lo más llamativo es que el sistema mostró una elevada confianza en sus conclusiones erróneas, lo que pone de manifiesto una calibración insuficiente para detectar contenidos generados por modelos actuales.
Copyleaks: resultados irregulares
El último detector analizado fue Copyleaks, una plataforma que también ofrece herramientas para detectar imágenes y vídeos generados mediante IA. Como ocurrió con los demás detectores, identificó correctamente los textos humanos. Sin embargo, al evaluar los textos generados por IA obtuvo resultados contradictorios: uno de ellos fue clasificado erróneamente como completamente humano, mientras que el otro fue detectado correctamente como generado por inteligencia artificial. Esta inconsistencia llevó al autor a concluir que la calibración del sistema todavía necesita mejoras.
Detector
Textos humanos
Textos IA
Resultado
Pangram
✔✔
✔✔
4/4
Grammarly
✔✔
✔✔
4/4
GPTZero
✔✔
✔✔
4/4
Scribbr
✔✔
✘✘
2/4
Copyleaks
✔✔
✔✘
3/4
El reportaje explica que basta con realizar pequeñas modificaciones en un texto generado por IA para dificultar considerablemente su detección. Una revisión manual, la incorporación de experiencias personales o incluso el uso de herramientas de reformulación pueden alterar los patrones lingüísticos que utilizan los detectores para emitir sus predicciones. Del mismo modo, textos escritos por personas con un estilo muy formal, repetitivo o académico pueden ser erróneamente etiquetados como contenidos generados por inteligencia artificial. Esta limitación resulta especialmente preocupante en el ámbito educativo, donde ya se han documentado casos de estudiantes acusados injustamente debido a la confianza excesiva depositada en estas herramientas.
Otra conclusión importante del análisis es que los detectores deben considerarse únicamente un indicio y nunca una prueba definitiva. El artículo coincide con numerosos investigadores y organismos educativos en que estas herramientas pueden servir para señalar textos que merecen una revisión más detallada, pero no deberían utilizarse como única evidencia para sancionar a un estudiante o cuestionar la autoría de un documento. La mejor práctica consiste en combinar su uso con otros métodos de evaluación, como el seguimiento del proceso de escritura, entrevistas con el autor, versiones previas del trabajo o actividades presenciales que permitan verificar el aprendizaje.
En conjunto, la prueba de Popular Science confirma que los detectores de IA siguen siendo una tecnología inmadura. Aunque han mejorado respecto a sus primeras versiones y pueden ofrecer información útil en determinados contextos, la rápida evolución de los modelos generativos hace que la carrera entre generación y detección sea cada vez más difícil. La tendencia actual apunta a que, más que confiar ciegamente en algoritmos de detección, instituciones educativas y organizaciones deberán desarrollar nuevas estrategias de evaluación y políticas de uso responsable de la inteligencia artificial.
El creciente problema de la detección de libros escritos total o parcialmente con inteligencia artificial, en un contexto en el que la producción de textos generados por modelos como ChatGPT se ha vuelto masiva y cada vez más difícil de distinguir de la escritura humana. La preocupación central es cómo bibliotecarios, editores y lectores pueden identificar este tipo de obras sin herramientas infalibles.
a irrupción de la inteligencia artificial en el ámbito editorial ha transformado profundamente la forma de producir y distribuir libros. En la actualidad, es posible generar textos extensos en muy poco tiempo mediante herramientas capaces de imitar con gran precisión el lenguaje humano. Este fenómeno ha abierto nuevas posibilidades creativas, pero también ha generado una preocupación creciente: cómo distinguir un libro escrito por una persona de uno producido total o parcialmente por inteligencia artificial.
El texto señala que no existe un método único y fiable para detectar con certeza un libro generado por IA. Las herramientas automáticas de detección presentan márgenes de error importantes, por lo que no pueden considerarse definitivas. En su lugar, se propone una combinación de indicios estilísticos y análisis crítico del texto.
Entre los rasgos que suelen asociarse a textos generados por IA se encuentra un lenguaje correcto pero poco expresivo, una tendencia a la repetición de ideas con formulaciones distintas y el uso frecuente de generalizaciones. Asimismo, estos textos tienden a mostrar una estructura excesivamente regular y predecible, con escasas variaciones estilísticas. En narrativa, pueden aparecer personajes poco complejos o poco memorables, así como una limitada exploración de la experiencia emocional.
Entre las señales más habituales se mencionan la excesiva uniformidad del estilo, la ausencia de variaciones personales en la voz narrativa, estructuras demasiado regulares y una tendencia a la generalización o al uso de explicaciones poco concretas. También se advierte que los textos generados por IA pueden mostrar coherencia superficial, pero carecer de profundidad experiencial o de una perspectiva verdaderamente autoral. Otro elemento relevante es la ausencia de vivencias personales o de una perspectiva situada. Mientras que la escritura humana suele incorporar huellas de experiencia, memoria o subjetividad, los textos generados por IA tienden a construir significados a partir de patrones estadísticos, lo que puede traducirse en una sensación de neutralidad o impersonalidad.
A pesar de estas diferencias, la distinción no siempre es evidente, ya que los modelos actuales han mejorado notablemente su capacidad de imitación estilística. Por ello, la lectura crítica se convierte en una herramienta fundamental. Más que buscar “errores”, se trata de evaluar la profundidad del texto, la coherencia de su voz y su capacidad para generar una experiencia significativa en el lector.
El artículo subraya además la importancia de no demonizar la IA como herramienta, ya que puede utilizarse en procesos de escritura asistida. La clave estaría en diferenciar entre obras generadas automáticamente y aquellas en las que la IA actúa como apoyo creativo, destacando la necesidad de criterios editoriales y lectura crítica para afrontar este nuevo escenario literario.
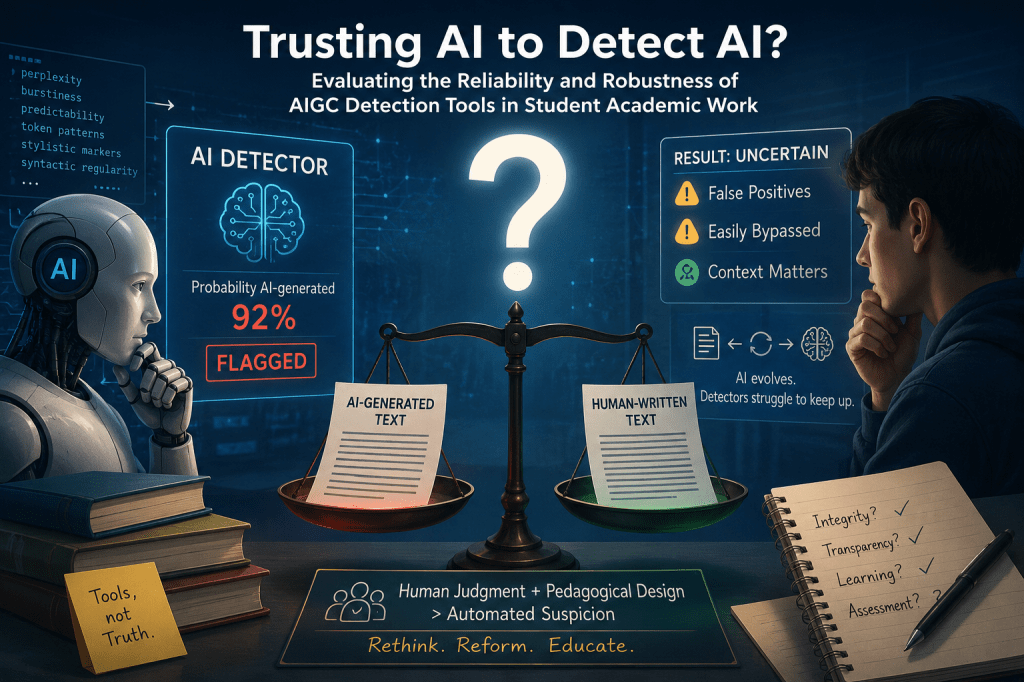
Sun, Yicheng, Yihan Liao, and Xiaoxue Ma. “Trusting AI to Detect AI? A Systematic Evaluation of the Reliability and Robustness of Current AIGC Detection Tools for Student Academic Work.” Computers & Education (2026). Elsevier. https://doi.org/10.1016/j.compedu.2026.105456
La investigación demuestra que los actuales detectores de texto generado por inteligencia artificial presentan problemas significativos de precisión, vulnerabilidad ante modificaciones simples y riesgo elevado de falsos positivos, por lo que no deben considerarse herramientas plenamente fiables para evaluar autoría académica, abriendo un debate más amplio sobre cómo la educación debe adaptarse a la presencia estructural de la inteligencia artificial en la escritura y el aprendizaje.
El estudio analiza uno de los debates más relevantes en el ámbito educativo contemporáneo: hasta qué punto pueden considerarse fiables las herramientas de inteligencia artificial diseñadas para detectar contenidos producidos por otros sistemas de IA generativa, especialmente en contextos académicos donde universidades, escuelas y docentes buscan identificar si un trabajo ha sido elaborado por estudiantes o generado parcial o totalmente mediante modelos como OpenAI ChatGPT, asistentes de escritura automatizada o generadores de texto similares. La investigación parte de una preocupación creciente: mientras las instituciones educativas adoptan detectores automáticos para preservar la integridad académica, todavía existe poca evidencia científica sólida acerca de la precisión real de estos sistemas y de sus limitaciones metodológicas.
Los autores realizaron una evaluación sistemática y comparativa de múltiples detectores de contenido generado por IA (AIGC detectors, Artificial Intelligence Generated Content detectors), sometiéndolos a pruebas extensivas con diferentes tipos de textos académicos producidos tanto por humanos como por sistemas de lenguaje avanzados. El objetivo era medir dos dimensiones fundamentales: la fiabilidad, entendida como la capacidad del sistema para clasificar correctamente un texto, y la robustez, es decir, la resistencia del detector frente a modificaciones o manipulaciones deliberadas destinadas a engañar al algoritmo. Los resultados muestran que muchas herramientas presentan inconsistencias importantes y no ofrecen un nivel de precisión suficientemente estable como para convertirse en un criterio único de evaluación académica.
Uno de los hallazgos más significativos es que numerosos detectores funcionan razonablemente bien cuando analizan textos generados directamente por modelos de lenguaje sin edición posterior, pero su rendimiento cae de manera drástica cuando el contenido es ligeramente modificado por una persona. Cambios mínimos como reformular frases, alterar el orden sintáctico, introducir expresiones más personales o corregir ciertos patrones lingüísticos pueden reducir notablemente la capacidad del sistema para identificar el origen artificial del texto. Esto revela que la mayoría de detectores dependen de patrones estadísticos superficiales relacionados con la predictibilidad léxica y la regularidad sintáctica, en lugar de comprender realmente la autoría del contenido.
La investigación también advierte sobre el problema inverso: los falsos positivos. En numerosas pruebas, textos completamente redactados por humanos fueron clasificados erróneamente como producidos por inteligencia artificial. Este aspecto resulta especialmente preocupante en contextos universitarios, ya que una detección incorrecta puede derivar en acusaciones injustas de fraude académico, cuestionamiento de la honestidad del estudiante o procedimientos disciplinarios basados en evidencia técnicamente poco fiable. El estudio subraya que confiar excesivamente en estas herramientas puede generar problemas éticos y legales, particularmente cuando las instituciones utilizan resultados automatizados como prueba concluyente en procesos de evaluación.
Otro aspecto analizado es la evolución constante de los grandes modelos lingüísticos (LLM, Large Language Models). Herramientas de detección entrenadas para reconocer patrones asociados a versiones anteriores de modelos como ChatGPT ChatGPT, Anthropic Claude o sistemas similares pueden volverse rápidamente obsoletas cuando aparecen modelos más sofisticados capaces de producir lenguaje cada vez más cercano a la escritura humana natural. Esto genera una especie de carrera tecnológica permanente: conforme mejoran los generadores de texto, los detectores deben actualizarse continuamente, aunque sin garantía de alcanzar precisión duradera.
El estudio examina además estrategias conocidas como evasión adversarial, es decir, técnicas intencionadas utilizadas para burlar detectores automáticos. Entre ellas se incluyen la paráfrasis automática, traducción múltiple entre idiomas, edición humana posterior, reformulación mediante otros modelos lingüísticos e incluso la mezcla de fragmentos humanos con contenido generado por IA. Los resultados demuestran que muchos detectores pierden efectividad frente a estas intervenciones relativamente simples, lo que pone en duda su utilidad práctica en escenarios reales donde un usuario busca deliberadamente evitar la detección.
Desde una perspectiva educativa, los investigadores plantean una reflexión importante: el problema no puede abordarse únicamente desde la lógica policial o punitiva. La expansión de herramientas generativas obliga a repensar los sistemas tradicionales de evaluación académica. Si resulta cada vez más difícil distinguir entre producción humana y producción asistida por IA, las universidades deben reconsiderar qué significa realmente aprender, escribir, investigar y demostrar competencias intelectuales en un entorno donde la inteligencia artificial forma parte habitual del proceso de trabajo. En lugar de centrarse exclusivamente en detectar fraude, el sistema educativo debería avanzar hacia modelos pedagógicos que integren críticamente la IA, enseñando al alumnado a utilizarla de manera ética, transparente y reflexiva.
Los autores concluyen que, aunque los detectores automáticos pueden servir como herramientas auxiliares dentro de procesos más amplios de evaluación, actualmente no ofrecen suficiente precisión, consistencia ni robustez como para convertirse en árbitros definitivos de la autenticidad académica. Recomiendan que cualquier institución educativa evite depender exclusivamente de sistemas automáticos y combine su uso con revisión humana, análisis contextual del trabajo, conocimiento previo del estilo del estudiante y nuevas estrategias pedagógicas orientadas a la alfabetización crítica en inteligencia artificial.
En términos más amplios, el estudio pone de relieve una paradoja tecnológica cada vez más evidente: se está utilizando inteligencia artificial para detectar inteligencia artificial, pero ambos sistemas evolucionan simultáneamente en una dinámica competitiva donde los mecanismos de control van siempre un paso detrás de las capacidades generativas. Esto plantea preguntas profundas no solo sobre integridad académica, sino sobre confianza, autoría intelectual y el futuro mismo de la producción del conocimiento en la era algorítmica
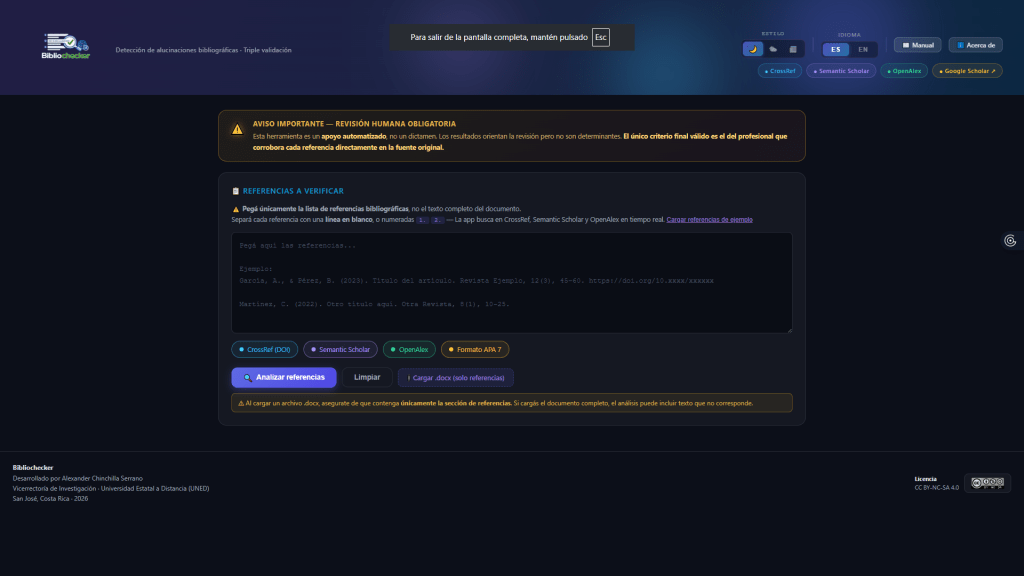
Bibliochecker ejemplifica cómo las nuevas herramientas de verificación automatizada pueden convertirse en aliadas estratégicas para preservar la integridad académica frente a los errores y alucinaciones producidas por la inteligencia artificial generativa.
En un contexto académico marcado por el uso creciente de sistemas de inteligencia artificial generativa como ChatGPT, Gemini o Claude, una de las preocupaciones más relevantes dentro de la investigación científica es la proliferación de “alucinaciones bibliográficas”, es decir, referencias inventadas o parcialmente incorrectas que los modelos generan al construir citas aparentemente plausibles pero inexistentes. Frente a este problema surge Bibliochecker, una herramienta web diseñada específicamente para verificar la autenticidad y consistencia de referencias bibliográficas generadas o asistidas por inteligencia artificial.
Bibliochecker se presenta como una aplicación accesible directamente desde el navegador, sin necesidad de instalación ni registro, lo que facilita su uso inmediato por parte de investigadores, estudiantes, bibliotecarios, editores científicos y revisores académicos. Su objetivo principal consiste en detectar posibles errores, inconsistencias o invenciones en listas bibliográficas, especialmente aquellas elaboradas mediante herramientas de IA. La plataforma automatiza la verificación cruzando la información proporcionada con bases de datos académicas consolidadas como CrossRef, Semantic Scholar y OpenAlex, lo que permite comprobar la existencia real de un documento, validar identificadores DOI y contrastar la coherencia entre título, autoría y fecha de publicación.
Una de sus fortalezas radica en la flexibilidad del ingreso de datos. El usuario puede introducir referencias de tres formas distintas: pegando directamente texto copiado desde documentos Word o PDF, cargando archivos en formato .docx que contengan exclusivamente la sección bibliográfica o utilizando ejemplos predeterminados para familiarizarse con el funcionamiento del sistema. La herramienta identifica automáticamente cada referencia incluso cuando estas aparecen en texto corrido o sin separación entre líneas, aplicando patrones inspirados en la normativa APA 7 para detectar estructuras bibliográficas.
El sistema permite activar distintos módulos de comprobación según las necesidades del usuario. El módulo de CrossRef verifica en tiempo real la validez del DOI y compara metadatos asociados; Semantic Scholar realiza búsquedas por similitud textual del título y verifica autoría y año; OpenAlex consulta su base académica abierta para confirmar coincidencias; mientras que un verificador específico examina si la referencia cumple con requisitos formales del estilo APA 7, revisando aspectos como el formato de autores, la correcta ubicación del año entre paréntesis, el uso de puntuación normativa o la presencia obligatoria del DOI en artículos científicos. Además, el sistema incorpora enlaces a Google Scholar para facilitar comprobaciones manuales complementarias.
Cada referencia analizada recibe un diagnóstico estructurado en cuatro categorías claramente diferenciadas. La categoría “Válida” indica que la obra fue localizada en las bases de datos sin inconsistencias detectadas. La categoría “Sospechosa” señala discrepancias parciales, como diferencias entre nombres de autores, títulos ligeramente distintos o inconsistencias cronológicas. La categoría “Problema” representa casos más graves, donde el DOI no existe o el documento no aparece en ninguna base académica consultada, sugiriendo una alta probabilidad de invención o error generado por IA. Finalmente, el estado “Sin DOI” identifica referencias donde no ha sido posible realizar validación automática mediante identificadores persistentes, algo frecuente en libros, tesis o documentos no indexados formalmente.
Otro elemento destacable es la posibilidad de exportar un reporte completo en formato HTML, generando una tabla estructurada con todos los resultados obtenidos. Este informe puede compartirse, archivarse o imprimirse, facilitando procesos editoriales, revisión académica o auditoría bibliográfica previa a la publicación de artículos científicos. La herramienta también incorpora distintos modos visuales —oscuro, claro y editorial sobrio— que mejoran la experiencia de uso en distintos contextos de trabajo.
Desde una perspectiva más amplia, Bibliochecker responde a una necesidad emergente dentro del ecosistema de la comunicación científica contemporánea: la verificación crítica de contenidos generados por inteligencia artificial. A medida que investigadores y estudiantes incorporan sistemas generativos en tareas de redacción académica, aumenta el riesgo de incluir citas falsas que comprometan la integridad científica. En este escenario, herramientas como Bibliochecker no sustituyen el criterio profesional humano, pero sí actúan como filtros preliminares de enorme valor para fortalecer la calidad documental y reducir errores antes de la difusión pública del conocimiento.
La propia plataforma insiste en una advertencia metodológica fundamental: sus resultados constituyen un apoyo automatizado y nunca un dictamen definitivo. Incluso una referencia marcada como válida puede contener errores que escapan a la detección automática, mientras que referencias catalogadas como sospechosas pueden corresponder a simples inconsistencias de metadatos o documentos no indexados en las bases consultadas. En otras palabras, Bibliochecker representa un ejemplo significativo del nuevo paradigma de colaboración entre inteligencia artificial y revisión humana experta, particularmente relevante para bibliotecas académicas, editoriales científicas y profesionales de la gestión de información digital.
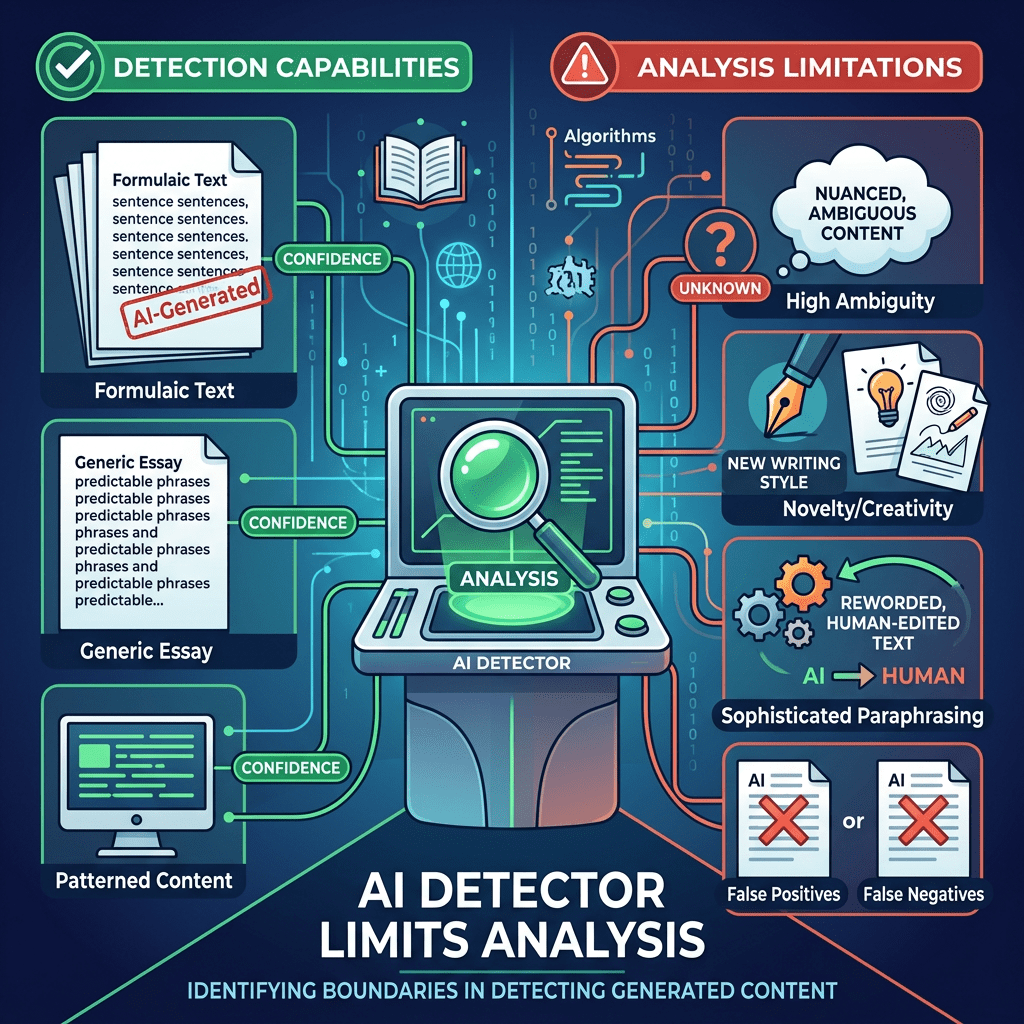
An infographic explaining what AI detectors can confidently identify and where their analysis falls short.
Atamhenwan, Lucky E. (2026). How are combinations of human-written words and LLM-generated words by ChatGPT, Copilot, Gemini and Grammarly detected by Turnitin? Education and Information Technologies. Springer Nature. DOI: 10.1007/s10639-026-14049-2
La rápida expansión de herramientas de inteligencia artificial está transformando profundamente la educación y la escritura académica. Ante este cambio, universidades e instituciones recurren cada vez más a detectores automáticos como Turnitin para identificar textos generados por IA. El estudio de Lucky E. Atamhenwan analiza hasta qué punto Turnitin puede distinguir con precisión entre escritura humana y contenido producido total o parcialmente por inteligencia artificial.
La expansión acelerada de la inteligencia artificial generativa en los últimos años ha transformado profundamente la educación superior y los procesos de producción textual. La aparición de modelos de lenguaje de gran escala como ChatGPT, Microsoft Copilot, Google Gemini y Grammarly ha permitido que estudiantes, investigadores y profesionales generen textos complejos con rapidez y una calidad lingüística cada vez más cercana a la escritura humana. Frente a este nuevo escenario, instituciones educativas de todo el mundo han comenzado a depender de sistemas automáticos de detección de contenido generado por IA, siendo Turnitin una de las herramientas más utilizadas. El estudio de Lucky E. Atamhenwan se propone analizar hasta qué punto Turnitin es realmente capaz de diferenciar entre textos escritos por humanos y textos producidos, parcial o totalmente, mediante modelos de lenguaje artificial.
La investigación parte de una cuestión central: aunque numerosas universidades están comenzando a utilizar detectores automáticos de IA para evaluar trabajos académicos, existe todavía una gran incertidumbre acerca de la precisión real de estas herramientas. El autor recuerda que la irrupción masiva de ChatGPT en noviembre de 2022 marcó un punto de inflexión sin precedentes en la relación entre inteligencia artificial y educación. En apenas unos meses aparecieron múltiples sistemas generativos capaces no solo de redactar textos completos, sino también de resumir documentos, corregir gramática, traducir contenidos, programar código y reformular ideas con notable coherencia. Este avance ha generado enormes beneficios pedagógicos, pero también ha abierto interrogantes sobre plagio, autoría y honestidad académica, especialmente cuando los estudiantes presentan como propio un contenido producido parcial o totalmente por IA.
Para estudiar la eficacia de Turnitin, el investigador diseñó un experimento de gran escala basado en 81 documentos diferentes, construidos a partir de combinaciones variables entre escritura humana y texto generado por modelos de lenguaje. Los documentos contenían mezclas progresivas que iban desde un 100% de texto humano hasta un 100% de texto generado por IA, utilizando cuatro sistemas distintos: ChatGPT, Copilot, Gemini y Grammarly. Se crearon textos de aproximadamente 4.000 palabras y se fueron introduciendo porcentajes crecientes de contenido generado artificialmente: 5%, 10%, 15%, 20%, 30%, 50%, 70%, hasta llegar al 100%. Cada documento fue sometido al detector de Turnitin para observar qué porcentaje del contenido era identificado como generado por inteligencia artificial. Este diseño experimental permitió estudiar no solamente si Turnitin detecta IA, sino también cómo cambia su comportamiento cuando el texto combina escritura humana y escritura algorítmica.
Uno de los resultados más relevantes del estudio es que Turnitin no detectó absolutamente ningún contenido generado por IA cuando este representaba solo el 5% o el 10% del texto total. Esto significa que si un estudiante escribe la mayor parte de un trabajo por sí mismo y utiliza un modelo de lenguaje únicamente para generar pequeños fragmentos, Turnitin puede no generar ninguna alerta. A partir de porcentajes cercanos al 15%, el sistema comienza a identificar contenido sospechoso, pero con un problema importante: las puntuaciones no son exactas. Cuando el porcentaje real de texto generado por IA es bajo, Turnitin suele sobreestimar la cantidad de contenido artificial, produciendo falsos incrementos. Paradójicamente, cuando el porcentaje real de IA es muy alto, el detector comienza a subestimar la presencia artificial, mostrando cifras inferiores a la realidad. Esta inconsistencia cuestiona seriamente la confianza absoluta en el sistema.
El comportamiento del detector varía además según el modelo de lenguaje utilizado. En el caso de ChatGPT, Turnitin mostró una tendencia sistemática a detectar porcentajes inferiores al contenido real generado por IA. Incluso cuando un texto estaba producido al 100% por ChatGPT, Turnitin solo identificó un 60% como artificial. Con Copilot y Gemini los resultados fueron algo más equilibrados, aunque igualmente inconsistentes: en algunos casos sobreestimaban la presencia de IA y en otros la reducían. Grammarly presentó un patrón diferente, con detecciones superiores al porcentaje real cuando la intervención de IA era baja, pero subestimaciones cuando aumentaba la proporción de texto generado automáticamente. Esto demuestra que no existe un criterio homogéneo y que el detector responde de manera distinta según las características lingüísticas propias de cada modelo de inteligencia artificial.
Un segundo bloque del estudio analiza un fenómeno cada vez más extendido: el uso de herramientas diseñadas específicamente para “humanizar” textos creados por IA con el objetivo de evitar ser detectados. Para ello se utilizaron plataformas como QuillBot, EasyEssayAI y RyneAI, muy conocidas en comunidades digitales por su capacidad para reformular textos y hacerlos parecer escritos por humanos. Los investigadores tomaron textos generados al 100% por ChatGPT, Copilot, Gemini y Grammarly, y posteriormente los pasaron por estas herramientas de reformulación antes de volver a analizarlos en Turnitin. Los resultados fueron especialmente reveladores: textos completamente generados por Copilot y posteriormente reformulados con QuillBot obtuvieron una puntuación del 0%, es decir, Turnitin los consideró completamente humanos. De manera similar, RyneAI consiguió que textos enteramente generados por Copilot, Gemini o Grammarly fueran clasificados también con 0% de contenido artificial.
Desde un punto de vista estadístico, el estudio confirma que existe una correlación muy fuerte entre la cantidad real de texto generado por IA y la puntuación otorgada por Turnitin. Sin embargo, esta relación no implica precisión. Los análisis de correlación y regresión muestran que el sistema detecta patrones asociados al texto artificial, pero no logra cuantificar de manera fiable cuánto contenido ha sido realmente producido por inteligencia artificial. El modelo estadístico utilizado revela que el 82,5% de la variabilidad observada en las puntuaciones depende efectivamente de la presencia de texto generado por IA, pero el margen de error sigue siendo considerable. En otras palabras: Turnitin reconoce señales asociadas al uso de IA, pero no constituye una herramienta exacta para determinar porcentajes reales de autoría algorítmica.
Las implicaciones educativas del trabajo son profundas. El autor sostiene que las universidades no deberían utilizar las puntuaciones de Turnitin como prueba concluyente para sancionar estudiantes, especialmente cuando los porcentajes detectados son bajos o moderados. Según el estudio, puntuaciones inferiores al 40% deben interpretarse con gran cautela, mientras que valores superiores al 60% pueden ser indicativos más sólidos, aunque nunca definitivos. Más allá de la detección, el artículo plantea que el verdadero desafío no consiste en prohibir la inteligencia artificial, sino en redefinir el modo en que se evalúa el aprendizaje. A medida que los modelos generativos evolucionen, será cada vez más difícil impedir su uso en tareas escritas tradicionales. Esto obliga a replantear metodologías de evaluación, incorporando sistemas supervisados, navegadores bloqueados, evaluaciones presenciales y nuevas formas de demostrar conocimiento que no dependan exclusivamente de la producción textual.
El estudio concluye que la educación necesita abandonar la visión puramente punitiva sobre la inteligencia artificial y avanzar hacia un modelo de integración ética y transparente. La IA debe entenderse como una herramienta legítima de aprendizaje, siempre que existan normas claras sobre su uso. El autor propone una cooperación entre universidades, empresas tecnológicas y plataformas como Turnitin para desarrollar sistemas que no solo detecten contenido generado por IA, sino que permitan rastrear el origen y el proceso de creación de los textos. En definitiva, esta investigación desmonta la idea de que los detectores actuales sean infalibles y muestra que, en el contexto actual, confiar ciegamente en estas herramientas para tomar decisiones académicas puede generar errores, injusticias y conflictos éticos considerables. Más que una solución definitiva, los detectores de IA representan apenas una tecnología en desarrollo dentro de un escenario educativo que está cambiando a una velocidad sin precedentes.
Datos clave:
Precisión con textos humanos: Turnitin no arrojó falsos positivos en el texto escrito completamente por humanos (0% de puntuación de IA).
Umbral mínimo de detección: Turnitin no detectó la presencia de IA cuando el porcentaje real de texto generado por los LLM era del 5% o 10% (marcando 0% en la puntuación).
Distorsión en porcentajes bajos (Inexactitud por exceso): Cuando la cantidad de IA era baja pero detectable (ej. 15% o 20%), Turnitin tendió a sobreestimar el puntaje, otorgando porcentajes de IA detectada más altos que la realidad (ej. detectó entre 21% y 24% para un 15% real).
Distorsión en porcentajes altos (Inexactitud por defecto): A medida que aumentaba el texto de IA en la combinación, el detector tendió a subestimar el puntaje real. Al llegar al 100% de contenido de IA en textos largos (4,000 palabras), Turnitin nunca puntuó 100%; las calificaciones máximas para textos puros de IA fueron de 87% (Copilot/Gemini), 82% (Grammarly) y apenas un 60% (ChatGPT).
Correlación: Existe una relación positiva muy fuerte ($R^2$ de Nagelkerke = 0.825): a mayor porcentaje real de IA, mayor es la puntuación de detección de Turnitin, confirmando que la detección se debe efectivamente a los fragmentos de IA
ChatGPT: Fue el modelo que más «burló» el detector en formato mixto. Turnitin puntuó por debajo de la realidad en el 65% de sus textos. Incluso al 25% de contenido real de ChatGPT, Turnitin marcó 0%.
Copilot y Gemini: Siguieron un comportamiento similar entre sí; Turnitin tendió a sobreestimar el porcentaje de IA en rangos bajos y medianos, pero empezó a reportar por debajo de la realidad a partir del 75% de contenido de IA.
Grammarly: Turnitin detectó niveles inflados (más altos que la realidad) entre el 15% y 40% de contenido, pero empezó a puntuar por debajo del porcentaje real a partir del 45% de texto generado por Grammarly.
RyneAI: Fue la herramienta de evasión más efectiva. Logró reducir la puntuación de Turnitin a 0% para Copilot, Grammarly y Gemini (haciendo que el detector los aceptara por completo como humanos). Para ChatGPT, la redujo al 26%.
QuillBot (AI Humanizer): Consiguió reducir la puntuación de Copilot a 0%. Sin embargo, fue menos efectivo con los demás: ChatGPT (33%), Grammarly (62%) y Gemini (83%).
EasyessayAI: Fue la menos efectiva. Turnitin siguió detectando altas tasas de IA en los textos procesados: Copilot (80%), ChatGPT (65%), Gemini (63%) y Grammarly (56%).
Efecto de la longitud del texto: El estudio demostró que Turnitin es mucho más preciso detectando textos puramente de IA cuando el documento es más corto (500-1000 palabras frente a las 4000 de la primera fase).
Vara, Vauhini. “How to Tell AI Writing.” The Atlantic, mayo de 2026. Disponible en: The Atlantic
Se analiza una cuestión cada vez más relevante: si realmente es posible identificar cuándo un texto ha sido escrito por inteligencia artificial. La autora parte de una constatación evidente: a medida que los modelos lingüísticos mejoran, los métodos tradicionales de detección resultan menos fiables. Los detectores automáticos producen numerosos falsos positivos y falsos negativos, lo que dificulta establecer con certeza el origen de un texto.
En las encuestas, la gente afirma de forma consistente que desconfía de los textos generados por IA. Sin embargo, eso no ha impedido que cada vez más personas la utilicen en la vida cotidiana: para redactar correos de trabajo y mensajes personales, elaborar listas de la compra o incluso escribir guiones para discutir con sus parejas. La escritura generada por IA también se está infiltrando en los espacios literarios más prestigiosos: secciones de opinión de periódicos, libros y revistas literarias. Estos textos son perfectamente limpios, sin una coma fuera de lugar; de extensión uniforme, con párrafos equilibrados y un tono característico que resulta al mismo tiempo desenfadado y grandilocuente.
La capacidad de la IA para producir textos fluidos y gramaticalmente correctos resulta irresistible, ya sea para redactar una frase ingeniosa en una solicitud de empleo o una ocurrencia para una aplicación de citas. Los textos generados por IA pueden engañar fácilmente a los lectores, especialmente cuando estos solo leen por encima. El resultado es una perfección prefabricada: textos que no pueden discutirse realmente porque carecen de un proceso deliberativo subyacente. Aunque parezcan plausibles a primera vista, un análisis más profundo revela que todo está ligeramente desajustado: el tono es plano, algunas palabras resultan extrañas, la estructura carece de lógica, faltan partes esenciales del argumento y abundan los errores fácticos. Incluso existen tutoriales para eliminar de la escritura las señales que delatan el uso de IA: evitar los guiones largos, los dos puntos o las ya sospechosas construcciones del tipo «No es X; es Y». Para la autora, ese es precisamente el problema fundamental de la escritura generada por IA: bajo una superficie pulida y convincente, a menudo no existe un razonamiento auténtico.
Un estudio realizado por investigadores de la Universidad de Stanford y la Universidad Carnegie Mellon encontró que los principales modelos de IA respaldan las ideas de sus usuarios un 49 % más que los seres humanos durante una conversación. Además, los participantes valoraban las respuestas más complacientes como de mayor calidad y afirmaban que esa actitud aumentaba la probabilidad de volver a utilizar la IA. Según la autora, este tipo de comunicación está empezando a rodearnos por todas partes. Su expansión parece inevitable. Incluso quienes no utilizan IA comenzarán a parecerse a ella en su manera de expresarse. Un estudio preliminar del Instituto Max Planck para el Desarrollo Humano encontró que, en conversaciones espontáneas como las de los pódcast, las personas ya muestran un aumento apreciable en el uso de palabras que ChatGPT genera con frecuencia, como delve («profundizar»), comprehend («comprender»), boast («presumir»), swift («rápido») o meticulous («meticuloso»).
Vara sostiene que muchas personas que utilizan habitualmente herramientas como ChatGPT desarrollan una especie de «instinto» para reconocer ciertos patrones característicos de la escritura generada por IA. No se trata de una prueba científica, sino de una percepción basada en la experiencia acumulada tras leer grandes cantidades de contenido producido por estos sistemas. Entre los indicios más frecuentes se encuentran una estructura excesivamente ordenada, transiciones demasiado fluidas entre párrafos y una tendencia a resumir constantemente las ideas ya expuestas.
También se cuestiona algunos de los supuestos signos distintivos que suelen mencionarse en internet. Elementos como el uso de determinados signos de puntuación, ciertas palabras de moda o expresiones recurrentes pueden aparecer igualmente en textos humanos. Por ello, la autora advierte contra la tentación de convertir cualquier rasgo estilístico en una prueba definitiva de autoría artificial. Lo relevante no es un único indicador, sino la acumulación simultánea de varios patrones.
Otro aspecto importante es la progresiva normalización de la escritura asistida por IA. Cada vez más autores emplean estas herramientas para revisar, reorganizar o mejorar borradores propios. Esta situación difumina la frontera entre texto humano y texto artificial, haciendo que la pregunta ya no sea únicamente quién escribió un texto, sino en qué medida intervino la inteligencia artificial en su elaboración.
El artículo también plantea una reflexión cultural más amplia. La proliferación de contenidos generados por IA está modificando nuestra percepción de la autenticidad y de la autoría. La sensación de que «algo suena a ChatGPT» se está convirtiendo en una nueva forma de alfabetización digital, basada más en la experiencia lectora que en herramientas tecnológicas. Sin embargo, la autora concluye que, conforme los modelos continúen evolucionando, incluso esa intuición humana podría perder eficacia, obligándonos a replantear cómo valoramos la originalidad y la creatividad en la era de la inteligencia artificial.