Archivo de la etiqueta: Legislación

Más de 120 proyectos de ley sobre IA están siendo discutidos en el Congreso de EE.UU.

«There Are More than 120 AI Bills in Congress Right Now», MIT Technology Review, accedido 19 de septiembre de 2024, https://www.technologyreview.com/2024/09/18/1104015/here-are-all-the-ai-bills-in-congress-right-now/.

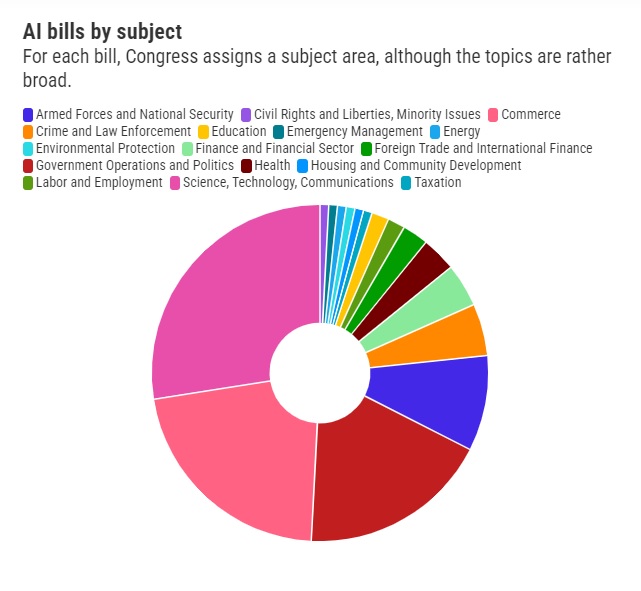
En 2024, más de 120 proyectos de ley relacionados con la inteligencia artificial (IA) están siendo discutidos en el Congreso de EE.UU. Estos proyectos son muy variados, abarcando desde mejorar la educación sobre IA en escuelas públicas hasta exigir que los desarrolladores revelen el uso de material con derechos de autor en el entrenamiento de modelos de IA. Algunos tratan de mitigar los riesgos biológicos de la IA o regular el uso de deepfakes en campañas políticas y pornografía no consensual. Incluso hay un proyecto que prohíbe que la IA lance armas nucleares sin intervención humana.

La gran cantidad de propuestas refleja la urgencia con la que el Congreso está intentando regular una tecnología que avanza rápidamente. Sin embargo, debido al proceso legislativo, la mayoría de estos proyectos no se convertirán en ley. Muchos ni siquiera serán votados, ya que algunos líderes políticos no los impulsan si consideran que no tienen suficientes apoyos. En un entorno político polarizado, lograr que los proyectos reciban apoyo bipartidista es una tarea monumental.

Algunos avances legislativos han sido hechos, como la creación del Instituto de Seguridad en IA de EE.UU. (AISI), que se encargará de establecer guías voluntarias para el desarrollo seguro de IA. Otros proyectos buscan expandir la educación en IA y aumentar los recursos públicos para la investigación en esta área. Sin embargo, muchos de los proyectos evitan imponer regulaciones estrictas, lo cual responde al temor de frenar la innovación tecnológica.
Un aspecto notable es el papel que juegan las grandes empresas tecnológicas en este debate. Aunque algunas han solicitado más regulación, sus grupos de presión (lobbies) intentan suavizar o eliminar las restricciones. Esto preocupa a expertos que creen que las compañías pueden aprovechar los compromisos voluntarios para definir sus propios estándares sin cumplir con regulaciones significativas.

La falta de atención a temas de equidad y minorías en estos proyectos es también destacable. Aunque algunos intentos de abordar los sesgos en los modelos de IA han sido discutidos, han encontrado resistencia, especialmente entre los legisladores republicanos. A pesar de ello, algunos proyectos bipartidistas, como los que regulan los deepfakes, están avanzando debido a la preocupación compartida sobre su impacto en elecciones y la privacidad de las personas.

Los proyectos de ley actuales reflejan un enfoque mixto: promover el desarrollo tecnológico sin imponer barreras regulatorias estrictas. Sin embargo, lograr una regulación efectiva que también aborde temas de equidad y responsabilidad sigue siendo un desafío en evolución.
Los editores científicos se ven amenazados por la expansión del acceso abierto

«Academic Publishers Threatened By Open-Access Expansion,» Inside Higher Ed, August 29, 2024. https://www.insidehighered.com/news/government/science-research-policy/2024/08/29/open-access-expansion-threatens-academic.

Se aborda las tensiones entre los editores académicos y la expansión del acceso abierto impulsada por el memorando Nelson de la Casa Blanca en 2022. Este memorando busca que la investigación financiada con fondos federales esté disponible al público de manera gratuita inmediatamente después de su publicación.

Mientras los organismos federales se esfuerzan por aplicar el memorándum Nelson -una directiva de la Casa Blanca de 2022 para que la investigación financiada con fondos federales se ponga a disposición del público de forma gratuita inmediatamente después de su publicación-, los congresistas se unen a las editoriales académicas para oponerse.

Miembros del Congreso, junto con editoriales académicas, han mostrado resistencia a esta iniciativa. Argumentan que los investigadores deberían tener el derecho a elegir cómo y dónde publican sus trabajos, sin estar obligados a usar licencias que podrían comprometer la integridad de sus investigaciones. El Congreso ha expresado su apoyo a esta postura, subrayando la necesidad de proteger los derechos de los autores.

El modelo de negocio de la industria editorial académica se basa en gran medida en que los autores envíen sus trabajos sin recibir compensación, o incluso pagando por publicarlos, para luego vender estos estudios a bibliotecas a través de suscripciones caras. Las bibliotecas universitarias, en particular, dedican alrededor del 80% de sus presupuestos de materiales a estas suscripciones.

Por otro lado, la Asociación de Bibliotecas de Investigación (ARL) apoya la expansión del acceso abierto y no cree que las nuevas políticas limiten los derechos de los autores, ya que las licencias no exclusivas permiten que los autores conserven sus derechos y elijan dónde publicar.

Las empresas de IA deben jugar limpio cuando utilizan datos académicos en el entrenamiento de sus modelos

«AI Firms Must Play Fair When They Use Academic Data in Training». Nature 632, n.o 8027 (27 de agosto de 2024): 953-953. https://doi.org/10.1038/d41586-024-02757-z.

Las empresas de inteligencia artificial (IA) deben actuar de manera justa cuando utilizan datos académicos en el entrenamiento de sus modelos. Los investigadores están preocupados por el uso sin restricciones de su propiedad intelectual en la formación de modelos de lenguaje como ChatGPT. Es crucial establecer reglas claras sobre el uso aceptable de estos datos.

Actualmente, no se sabe con precisión qué datos se usaron para entrenar modelos como ChatGPT, pero es probable que se hayan utilizado millones de artículos académicos, incluidos aquellos bajo acceso abierto y posiblemente también artículos protegidos por derechos de autor. Esto plantea preguntas sobre si los creadores de estos datos deberían recibir crédito y cómo.

El tema es complicado por las leyes de propiedad intelectual, que varían según la jurisdicción y no siempre son claras sobre si la recolección de datos o su uso para crear modelos de IA constituye una infracción de derechos de autor. Algunas empresas de IA, para evitar litigios, están comenzando a comprar licencias para los datos utilizados en el entrenamiento.

El uso de materiales bajo licencias como Creative Commons, que promueven la distribución y reutilización libre, también genera ambigüedades. Aunque no siempre se considera una infracción el uso de estos materiales para entrenar IA, hay preocupaciones sobre cómo las IA pueden afectar a los creadores, incluyendo a investigadores cuyo trabajo podría ser reutilizado sin la atribución adecuada.

La atribución es un principio fundamental en la ciencia, y algunos investigadores consideran que el uso de datos científicos por modelos comerciales de IA excede lo que las exenciones legales actuales estaban destinadas a permitir. Dado que es casi imposible atribuir correctamente las contribuciones cuando se usan millones de fuentes, se han sugerido soluciones como la generación aumentada por recuperación, que podría permitir a los modelos citar trabajos relevantes.

Dar a los investigadores la opción de excluir su trabajo del entrenamiento de IA podría aliviar sus preocupaciones, y algunas herramientas ya están emergiendo para facilitar esto. Además, leyes como la Ley de IA de la UE, que exige mayor transparencia sobre los datos utilizados en el entrenamiento, podrían fortalecer el control de los creadores sobre su trabajo.

Es necesario continuar investigando si se requieren soluciones más radicales, como nuevas licencias o cambios en la ley de derechos de autor. Las herramientas de IA, al aprovechar un ecosistema de datos construido por movimientos de código abierto, deben respetar las expectativas de reciprocidad y uso razonable, para evitar desincentivar la creación original y asegurar que los creadores mantengan cierto control sobre su obra.

Internet Archive se ve obligado a retirar 500.000 libros tras la victoria judicial de los editores

Belanger, A. (2024, junio 21). Internet Archive forced to remove 500,000 books after publishers’ court win. Ars Technica. https://arstechnica.com/tech-policy/2024/06/internet-archive-forced-to-remove-500000-books-after-publishers-court-win/

Internet Archive, una biblioteca en línea que proporciona acceso gratuito a una vasta colección de libros, ha tenido que retirar aproximadamente 500.000 títulos después de una victoria legal obtenida por los editores. Esta decisión judicial, tomada el año pasado, obligó a Internet Archive a reducir drásticamente su oferta, lo que ha causado una «pérdida devastadora» para los lectores que dependen de esta plataforma para acceder a libros difíciles de conseguir o inexistentes en sus bibliotecas locales.

Internet Archive está apelando la decisión ante el Tribunal de Apelaciones del Segundo Circuito de EE. UU., argumentando que su modelo de préstamo digital controlado debería considerarse un uso justo bajo la ley de derechos de autor. La organización sostiene que los editores no han presentado pruebas de que su mercado de libros electrónicos haya sufrido daños a causa del préstamo de Internet Archive. Además, afirma que sus prácticas están alineadas con la tecnología estándar de la industria para evitar la descarga y redistribución no autorizada de los libros.

Chris Freeland, director de servicios de biblioteca de Internet Archive, ha expresado que los editores que han demandado a Internet Archive han impuesto restricciones que limitan gravemente el acceso a los libros, afectando a académicos, estudiantes y lectores en comunidades desfavorecidas. En respuesta, muchos usuarios de Internet Archive han firmado una carta abierta pidiendo a los editores que reconsideren y restauren los libros eliminados, subrayando el impacto negativo en la educación y el acceso a la información.

Los editores, representados por la Asociación de Editores Americanos (AAP), defienden las retiradas alegando que IA violó los derechos de autor al ofrecer acceso global a obras sin licencias adecuadas. La AAP no ha respondido a las preocupaciones sociales expresadas por los usuarios de IA.

En el caso de que la apelación no tenga éxito, Internet Archive planea seguir luchando en los tribunales para restablecer el acceso a los títulos afectados. Mientras tanto, la biblioteca sigue creciendo en otros aspectos, como la digitalización de libros para preservación y la oferta de libros fuera de circulación y de dominio público.

El resultado del caso podría tardar meses en resolverse, y los usuarios del Internet Archive, incluidos aquellos en comunidades rurales o con discapacidades, temen perder uno de los pocos recursos confiables para acceder a libros raros o difíciles de encontrar.

Código de buenas prácticas en derechos de autor para bibliotecas

«Navigating Copyright for Crown-Published Works: A Code of Best Practices for Libraries» The Canadian Association of Research Libraries (CARL), 2024

Texto completo

CARL ha publicado el documento «Navigating Copyright for Crown-Published Works: A Code of Best Practices for Libraries» que está disponible en los sitios web de CARL y CFLA, junto con un resumen breve.

Este código de derechos de autor fue desarrollado para bibliotecas por un equipo de redacción comunitario, en colaboración con empleados del gobierno federal y revisores legales y académicos. Proporciona una exploración legal y práctica del uso justo en el contexto de las actividades de conservación de bibliotecas para publicaciones gubernamentales en Canadá.

Aunque el código no es un consejo legal, ofrece un modelo legalmente defendible para la aplicación de la excepción de uso justo al copiar, preservar y compartir publicaciones gubernamentales. Detalla las secciones relevantes de la Ley de Derechos de Autor de Canadá y jurisprudencia, y proporciona estudios de caso que describen proyectos relacionados realizados por bibliotecas académicas.

Internet Archive forzado a eliminar 500.000 libros tras la victoria de los editores en los tribunales

Belanger, Ashley. «Internet Archive Forced to Remove 500,000 Books after Publishers’ Court Win». Ars Technica, 21 de junio de 2024. https://arstechnica.com/tech-policy/2024/06/internet-archive-forced-to-remove-500000-books-after-publishers-court-win/.

Debido a una demanda exitosa de los editores de libros contra Internet Archive , la biblioteca en línea gratuita ha tenido que eliminar aproximadamente 500.000 títulos. Internet Archive informó que esta medida provocó una «pérdida devastadora» para los lectores que dependen de su acceso.

Internet Archive está apelando la decisión del tribunal, esperando revertirla al argumentar que el préstamo digital controlado de sus libros físicos debería considerarse uso justo bajo la ley de derechos de autor. Chris Freeland, director de servicios bibliotecarios de Internet Archive, defendió que utilizan tecnología estándar de la industria para evitar la redistribución de los libros prestados y que los editores no han demostrado daño al mercado de libros electrónicos.

Los seguidores de Internet Archive han pedido a los editores que reconsideren y restauren el acceso a los libros eliminados. Argumentan que esta acción afecta negativamente a comunidades educativas y marginadas, limitando su acceso a materiales esenciales para el aprendizaje y la investigación.

Por su parte, la Asociación de Editores Americanos (AAP) defendió las solicitudes de eliminación, afirmando que Internet Archive estaba transmitiendo obras literarias a nivel mundial sin licenciar los derechos necesarios. Internet Archive continúa su lucha legal, destacando que su préstamo digital no comercial sirve a misiones bibliotecarias importantes y no perjudica el mercado.

La resolución del caso podría tardar meses o más de un año, mientras tanto, IA sigue ofreciendo otros servicios bibliotecarios y prestando libros fuera de impresión y de dominio público.

La ley de Inteligencia Artificial de la Unión Europea garantiza el respeto de los derechos fundamentales de los ciudadanos y estimula la inversión y la innovación

Regulation laying down harmonised rules on artificial intelligence (artificial intelligence act), 21 May 2024 European Union, may 2024

Ver la ley

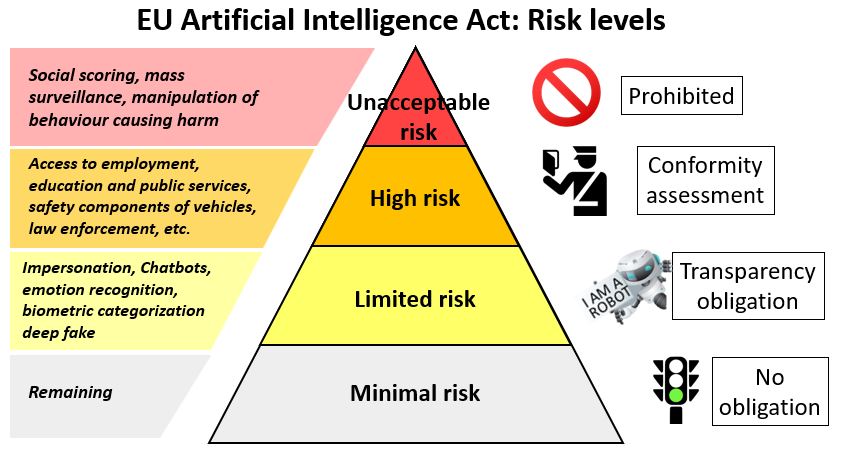
El Consejo aprobó una ley pionera que busca armonizar las normas sobre inteligencia artificial (IA), conocida como la Ley de Inteligencia Artificial. Esta legislación emblemática sigue un enfoque «basado en el riesgo», lo que significa que cuanto mayor sea el riesgo de causar daño a la sociedad, más estrictas serán las reglas. Es la primera de su tipo en el mundo y puede establecer un estándar global para la regulación de la IA.

La nueva ley tiene como objetivo fomentar el desarrollo y la adopción de sistemas de IA seguros y confiables en el mercado único de la UE, tanto por actores privados como públicos. Al mismo tiempo, busca garantizar el respeto de los derechos fundamentales de los ciudadanos de la UE y estimular la inversión y la innovación en inteligencia artificial en Europa. La Ley de IA se aplica solo a áreas dentro del derecho de la UE y prevé exenciones para sistemas utilizados exclusivamente con fines militares y de defensa, así como para fines de investigación.

La adopción de la Ley de IA es un hito significativo para la Unión Europea. Esta ley histórica, la primera de su tipo en el mundo, aborda un desafío tecnológico global que también crea oportunidades para nuestras sociedades y economías. Con la Ley de IA, Europa enfatiza la importancia de la confianza, la transparencia y la responsabilidad al tratar con nuevas tecnologías, al tiempo que asegura que esta tecnología en rápida evolución pueda florecer y estimular la innovación europea.

Clasificación de sistemas de IA como de alto riesgo y prácticas prohibidas de IA

La nueva ley clasifica diferentes tipos de inteligencia artificial según su riesgo. Los sistemas de IA que presenten un riesgo limitado estarán sujetos a obligaciones de transparencia muy ligeras, mientras que los sistemas de IA de alto riesgo serán autorizados, pero sujetos a una serie de requisitos y obligaciones para acceder al mercado de la UE. Los sistemas de IA como la manipulación cognitivo-conductual y la puntuación social serán prohibidos en la UE debido a que su riesgo se considera inaceptable. La ley también prohíbe el uso de IA para la vigilancia predictiva basada en perfiles y sistemas que utilizan datos biométricos para categorizar a las personas según categorías específicas como raza, religión u orientación sexual.

Modelos de IA de propósito general

La Ley de IA también aborda el uso de modelos de IA de propósito general (GPAI). Los modelos GPAI que no presenten riesgos sistémicos estarán sujetos a algunos requisitos limitados, por ejemplo, en cuanto a la transparencia, pero aquellos con riesgos sistémicos deberán cumplir con reglas más estrictas.

Nueva arquitectura de gobernanza

Para asegurar una adecuada aplicación, se establecen varios órganos de gobierno:

  • Una Oficina de IA dentro de la Comisión para hacer cumplir las reglas comunes en toda la UE.
  • Un panel científico de expertos independientes para apoyar las actividades de aplicación.
  • Un Consejo de IA con representantes de los estados miembros para asesorar y ayudar a la Comisión y a los estados miembros en la aplicación coherente y efectiva de la Ley de IA.
  • Un foro consultivo para las partes interesadas que proporcione experiencia técnica al Consejo de IA y a la Comisión.

Sanciones

Las multas por infracciones a la Ley de IA se establecen como un porcentaje del volumen de negocios anual global de la empresa infractora en el ejercicio financiero anterior o una cantidad predeterminada, lo que sea mayor. Las PYMEs y las start-ups estarán sujetas a multas administrativas proporcionales.

Transparencia y protección de los derechos fundamentales

Antes de que un sistema de IA de alto riesgo sea desplegado por algunas entidades que brindan servicios públicos, se deberá evaluar el impacto en los derechos fundamentales. La regulación también prevé una mayor transparencia respecto al desarrollo y uso de sistemas de IA de alto riesgo. Los sistemas de IA de alto riesgo, así como ciertos usuarios de un sistema de IA de alto riesgo que sean entidades públicas, deberán registrarse en la base de datos de la UE para sistemas de IA de alto riesgo, y los usuarios de un sistema de reconocimiento de emociones deberán informar a las personas naturales cuando estén siendo expuestas a dicho sistema.

Medidas en apoyo de la innovación

La Ley de IA prevé un marco legal favorable a la innovación y tiene como objetivo promover el aprendizaje regulatorio basado en evidencias. La nueva ley contempla que los entornos regulatorios de prueba para la IA, que permiten un entorno controlado para el desarrollo, prueba y validación de sistemas de IA innovadores, también permitan la prueba de sistemas de IA innovadores en condiciones del mundo real.

Próximos pasos

Después de ser firmada por los presidentes del Parlamento Europeo y del Consejo, la ley se publicará en el Diario Oficial de la UE en los próximos días y entrará en vigor veinte días después de esta publicación. La nueva regulación se aplicará dos años después de su entrada en vigor, con algunas excepciones para disposiciones específicas.

Antecedentes

La Ley de IA es un elemento clave de la política de la UE para fomentar el desarrollo y la adopción de IA segura y legal que respete los derechos fundamentales en todo el mercado único. La Comisión (Thierry Breton, comisario de mercado interior) presentó la propuesta de la Ley de IA en abril de 2021. Brando Benifei (S&D / IT) y Dragoş Tudorache (Renew Europe / RO) fueron los ponentes del Parlamento Europeo en este expediente y se alcanzó un acuerdo provisional entre los colegisladores el 8 de diciembre de 2023.

Los generadores de imágenes de Inteligencia Artificial Midjourney y DeviantArt afirman que nunca han utilizado imágenes de artistas para entrenar sus modelos de IA


«AI Image Generators Say They Never Used Artists’ Images to Train AI Models». Accedido 10 de mayo de 2024. https://www.courthousenews.com/ai-image-generators-say-they-never-used-artists-images-to-train-ai-models/.

Empresas que ofrecen software de inteligencia artificial generativa de imágenes argumentaron para desestimar una demanda por infracción directa de derechos de autor de artistas que afirman que las empresas utilizaron su trabajo sin permiso para entrenar un modelo de IA de texto a imagen.

Según la demanda colectiva de los artistas, la empresa de software de IA Midjourney y la plataforma de arte en línea DeviantArt utilizaron sus obras para entrenar la herramienta de IA de texto a imagen Stable Diffusion sin pagar a los artistas ni obtener su consentimiento para utilizar sus obras como imágenes de entrenamiento, y las imágenes resultantes siguen compitiendo con las obras de los artistas humanos en el mercado.

Los artistas demandaron por primera vez a DeviantArt, Midjourney y Stability AI, creador de Stable Diffusion, el año pasado, pero el juez superior de distrito de EE.UU. William Orrick desestimó la mayoría de las demandas de los artistas en octubre de 2023, permitiendo que sólo sobreviviera una demanda directa de derechos de autor contra Stability AI.

El juez William Orrick permitió que una única demanda de infracción directa de derechos de autor sobreviviera contra Stability AI, pero desestimó la mayoría de las otras reclamaciones de los artistas.

Los abogados de DeviantArt argumentaron que la plataforma de arte debería ser excluida de la acción porque solo utilizó Stable Diffusion para producir imágenes para su herramienta DreamUp AI y nunca utilizó directamente las imágenes de los artistas para entrenar un modelo de IA o crear imágenes que se parecieran a las de los artistas.

Los abogados de Midjourney ofrecieron una defensa similar. El juez Orrick tomó el asunto bajo consideración.

Las alucinaciones de ChatGPT provocan una queja de privacidad de la UE

«ChatGPT’s Hallucinations Draw EU Privacy Complaint», POLITICO 29 de abril de 2024. https://www.politico.eu/article/chatgpts-hallucinations-get-eu-privacy-complaint/.

El «alucinar» de ChatGPT y la invención de información vulneran las normas de privacidad de la Unión Europea, según una queja presentada por el grupo de privacidad noyb ante la autoridad de protección de datos de Austria. El grupo de privacidad noyb exige que los reguladores inicien una investigación sobre la conjetura salvaje de ChatGPT sobre la fecha de nacimiento de uno de sus activistas.

Noyb, una organización sin fines de lucro con sede en Viena fundada por el activista Max Schrems, afirmó que su queja fue desencadenada por el fracaso de ChatGPT en proporcionar la fecha de nacimiento correcta de Schrems, haciendo una conjetura en su lugar. El chatbot no informa a los usuarios que no tiene los datos correctos para responder a una solicitud.

La fecha de nacimiento de una persona es un dato personal según el GDPR, que establece varios requisitos sobre cómo se debe manejar la información personal.

Noyb afirma que el comportamiento del chatbot viola el Reglamento General de Protección de Datos (GDPR) en cuanto a privacidad, exactitud de la información, así como el derecho a corregir información inexacta. También argumenta que la empresa de inteligencia artificial se negó a corregir o eliminar respuestas incorrectas, y no revelará ninguna información sobre los datos procesados, sus fuentes o destinatarios.

«Está claro que las empresas actualmente no pueden hacer que los chatbots como ChatGPT cumplan con la ley de la UE, cuando procesan datos sobre individuos», dijo Maartje de Graaf, abogada de protección de datos de noyb.

«Si un sistema no puede producir resultados precisos y transparentes, no puede utilizarse para generar datos sobre individuos. La tecnología debe cumplir con los requisitos legales, no al revés», dijo.

El New York Times informó anteriormente que «los chatbots inventan información al menos el 3 por ciento de las veces, y hasta el 27 por ciento».

POLITICO también preguntó a ChatGPT sobre la fecha de nacimiento de Schrems y obtuvo tres respuestas diferentes: 24 de junio, 17 de septiembre y 17 de octubre. El cumpleaños de Schrems es en realidad el 1 de octubre, según noyb.

Noyb ahora está pidiendo a la autoridad austriaca que investigue a OpenAI para verificar la exactitud de los datos personales que maneja para alimentar sus grandes modelos de lenguaje. También solicitan a la autoridad que garantice que la empresa cumpla con la solicitud del demandante de acceder a sus propios datos personales.

El grupo de privacidad también pide una «multa administrativa efectiva, proporcionada y disuasiva». «Por ahora, OpenAI parece ni siquiera pretender que puede cumplir con el GDPR de la UE», dijo. Violaciones del GDPR de la UE pueden resultar en una multa de hasta el 4 por ciento de los ingresos globales de una empresa.

Noyb dijo que cualquier investigación regulatoria probablemente se manejaría «a través de la cooperación de la UE». La base de OpenAI en la UE está en Irlanda y los reguladores de privacidad irlandeses pueden ser sus supervisores principales.

La autoridad austriaca confirmó que recibió la queja y dijo que evaluará si necesita ser remitida a otra autoridad nacional. OpenAI no estuvo disponible de inmediato para hacer comentarios.

El pionero de la IA está enfrentando presiones de otros reguladores europeos. La autoridad de protección de datos de Italia prohibió temporalmente a ChatGPT el año pasado operar en el país debido a la presunta violación de las normas de la UE para el manejo de datos personales.

La Junta Europea de Protección de Datos (EDPB), que reúne a los reguladores nacionales de privacidad, luego estableció un grupo de trabajo sobre ChatGPT para coordinar los esfuerzos nacionales.

Regulación de la inteligencia artificial en bibliotecas: desarrollo de políticas y cumplimiento legal

Tanzi, Nick. «AI & the Library: Looking for Rules!» The Digital Librarian, 21 de agosto de 2023. https://the-digital-librarian.com/2023/08/21/ai-the-library-looking-for-rules/.

En la era de la inteligencia artificial, las bibliotecas deben establecer políticas que regulen su uso, considerando tanto las leyes existentes como los términos de servicio de los desarrolladores. Aunque la regulación específica sobre IA es incipiente, las normativas bibliotecarias sobre confidencialidad de registros de usuarios son relevantes. Es esencial garantizar la privacidad de los usuarios y cumplir con la ley al interactuar con sistemas de IA. Además, se destacan eventos y recursos para bibliotecarios interesados en esta área.


En la era de la inteligencia artificial, es crucial que las bibliotecas desarrollen políticas y procedimientos que regulen el uso de esta tecnología en nuestras instituciones. Dos pilares fundamentales al escribir estas políticas son las leyes federales/estatales/locales y los términos de servicio de los fabricantes o desarrolladores. Aunque la regulación legal específica sobre IA aún está en sus primeras etapas en Estados Unidos, existen leyes y regulaciones bibliotecarias que debemos considerar, como las relacionadas con la confidencialidad de los registros de los usuarios. Es esencial garantizar que nuestras interacciones con sistemas de IA no comprometan la privacidad de los usuarios ni contravengan la ley existente.

Al considerar los términos de servicio de una plataforma de IA, es crucial tener en cuenta las restricciones de edad y el consentimiento parental que pueden afectar a los servicios ofrecidos por la biblioteca. Aunque la regulación de la IA puede ser incipiente, hay reglas y regulaciones establecidas en el ámbito bibliotecario que podemos aplicar a esta tecnología emergente. Es importante desarrollar políticas y procedimientos adecuados y luego experimentar de manera segura con la IA en nuestras bibliotecas. Por ejemplo, en Nueva York, la Ley y Reglas de Práctica Civil del Estado de Nueva York (CPLR) 4509 establece que los registros de la biblioteca deben ser confidenciales y no deben divulgarse, excepto en circunstancias específicas.


Es importante tener en cuenta los términos de servicio (ToS) de una plataforma de inteligencia artificial al tomar decisiones en su biblioteca. Por ejemplo, la regulación de la plataforma ChatGPT de OpenAI en relación con la ley estatal existente indica que los usuarios deben tener al menos 13 años para utilizar el servicio, y que aquellos menores de 18 años necesitan el consentimiento de un padre o tutor legal.

Aunque estemos operando en un vacío regulatorio de IA, está claro que existen reglas y regulaciones establecidas en las bibliotecas que podemos aplicar a esta tecnología emergente. Así que salgan y hagan el importante y necesario trabajo de desarrollo de políticas y procedimientos, luego experimenten de manera segura.