Archivo de la etiqueta: Investigación

Adopción y barreras en la puesta en común de datos abiertos entre comunidades de investigación física

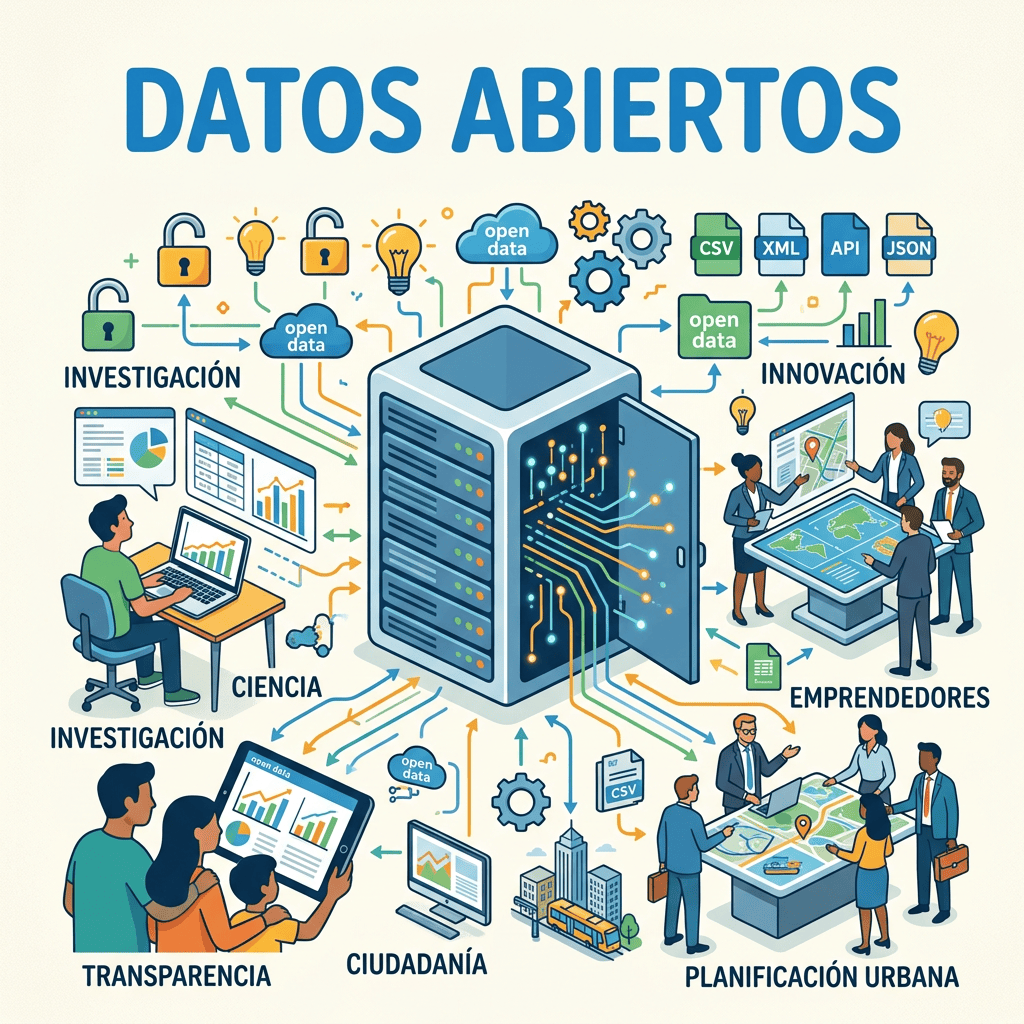
Infografía titulada “DATOS ABIERTOS” con investigación, innovación, ciencia, emprendedores, transparencia, ciudadanía y planificación urbana; incluye open data, CSV, XML, API y JSON.
Una ilustración muestra cómo los datos abiertos conectan investigación, innovación, emprendimiento y planificación urbana.

Holst, Faye. «IOP Publishing Study Reveals Varied Adoption and Barriers in Open Data Sharing among Physical Research Communities». IOP Publishing, 21 de octubre de 2024. https://ioppublishing.org/news/iop-publishing-study-reveals-varied-adoption-and-barriers-in-open-data-sharing-among-physical-research-communities-copy/.

Un estudio realizado por IOP Publishing (IOPP) ha puesto de manifiesto las diferencias en la adopción de la compartición de datos abiertos en las comunidades de investigación en ciencias físicas y las diversas barreras que enfrentan.

El acceso a los datos permite la replicación de la investigación y fortalece la confianza en los resultados. Los principios FAIR se introdujeron en 2016 para estandarizar los metadatos, asignar identificadores persistentes y proporcionar licencias de uso claras, asegurando que los datos de investigación sean fácilmente localizables, accesibles, combinables y reutilizables con la debida atribución.

Desde 2022, IOPP exige a todos los autores que incluyan una declaración de disponibilidad de datos en sus artículos, especificando si y cómo se pueden acceder a los datos que respaldan su investigación. Esta política se amplió en 2023, exigiendo a los autores que no puedan o no deseen compartir sus datos públicamente que expliquen las razones.

El análisis incluyó más de 30,000 artículos de investigación, cuyos hallazgos fueron publicados en el documento de IOPP titulado “Bringing researchers on board: Navigating the barriers to sharing data publicly”.

Hallazgos clave:

  1. Científicos ambientales:
    • Más del 80% comparte sus datos de investigación abiertamente.
    • Casi el 60% sigue los principios de Findability, Accessibility, Interoperability, and Reusability (FAIR).
    • Mayor barrera: restricciones legales relacionadas con la propiedad de datos de terceros.
  2. Físicos:
    • Más del 70% comparte datos de investigación abiertamente.
    • Solo el 18% adhiere a los principios FAIR.
    • Mayor barrera: los formatos de datos son considerados inaccesibles, incluso si están disponibles.
  3. Ingenieros:
    • Solo el 55% comparte sus datos abiertamente.
    • Menos del 8% sigue los principios FAIR.
    • Mayor barrera: falta de un repositorio conocido para enviar datos.
  4. Científicos de materiales:
    • Más del 70% comparte sus datos abiertamente.
    • Solo cerca del 5% sigue los principios FAIR.
    • Mayor barrera: datos confidenciales o sensibles.

El número de artículos indexados ha aumentado un 47% mientras que el número de científicos no ha crecido

Mark A. Hanson, Pablo Gómez Barreiro, Paolo Crosetto, Dan Brockington; The strain on scientific publishing. Quantitative Science Studies 2024; doi: https://doi.org/10.1162/qss_a_00327

Se analiza el creciente volumen de publicaciones científicas, un fenómeno que ha generado una sobrecarga en la comunidad científica. Desde 2016, el número de artículos indexados ha aumentado aproximadamente un 47%, mientras que el número de científicos no ha crecido a la misma velocidad, lo que ha incrementado significativamente la carga de trabajo por investigador.


La publicación académica enfrenta un problema: el número de artículos revisados por pares ha crecido exponencialmente en los últimos años, mientras que el número de investigadores capacitados para evaluarlos no ha aumentado al mismo ritmo. Esto ha generado dificultades para encontrar revisores cualificados y ha sobrecargado a los científicos con la cantidad de artículos publicados. Parte de este crecimiento se debe a iniciativas inclusivas que fomentan la participación de investigadores de regiones como el Sur Global. Si bien estas iniciativas son positivas, el crecimiento excesivo amenaza con comprometer la rigurosidad científica.

Los autores presentan cinco métricas basadas en datos que muestran el crecimiento de las editoriales, los tiempos de procesamiento y las conductas de citación. Observan que algunas editoriales han impulsado este crecimiento mediante la publicación de «números especiales» con tiempos de revisión más cortos, lo que responde a la presión de «publicar o perecer» a la que se enfrentan los investigadores para obtener financiamiento. Además, han notado una inflación de los factores de impacto de las revistas, lo cual distorsiona las señales de calidad científica. Los autores concluyen que este crecimiento exponencial no es sostenible.

Algunos hallazgos importantes incluyen:

Inflación del factor de impacto: Se ha observado una inflación en el factor de impacto, particularmente en las revistas de MDPI y Hindawi, debido a una alta tasa de autocitación y citación entre revistas del mismo editor. MDPI muestra una tasa de autocitación significativamente mayor que otras editoriales, lo que ha contribuido al aumento de su factor de impacto.

Contribución desigual de las editoriales al crecimiento: Entre 2016 y 2022, MDPI, Elsevier, Frontiers, Springer y Wiley han sido responsables de más del 70% del aumento en la cantidad de artículos publicados. Mientras Elsevier y Springer distribuyen sus publicaciones a través de un gran número de revistas, MDPI y Frontiers concentran el aumento en un número más pequeño de revistas, resultando en una mayor cantidad de artículos por revista.

Aumento en el uso de «special issues»: Editoriales como Hindawi, Frontiers y MDPI han incrementado drásticamente la proporción de artículos publicados a través de «special issues» desde 2016. Este modelo ha generado preocupación por la posibilidad de que se priorice la cantidad sobre la calidad, ya que los artículos en estas ediciones suelen ser revisados por editores invitados, en lugar del cuerpo editorial regular.

Disminución en los tiempos de procesamiento: MDPI, Frontiers y Hindawi han reducido significativamente los tiempos de procesamiento de artículos, con MDPI registrando tiempos mucho menores en comparación con otros editores (37 días en promedio). Además, estos editores han mostrado una homogeneización en los tiempos de revisión, lo que podría indicar una revisión menos rigurosa.

Tasas de rechazo dependientes del editor: Los datos sugieren que las tasas de rechazo varían significativamente según el editor, sin una correlación clara con el crecimiento en el número de artículos o el tamaño de las revistas. En particular, MDPI ha mostrado una disminución en sus tasas de rechazo a medida que ha aumentado el uso de «special issues».

Penguin Random House prohíbe expresamente que sus libros sean usados para entrenar tecnologías de IA.


Battersby, Matilda. «Penguin Random House Underscores Copyright Protection in AI Rebuff.» The Bookseller, October 18, 2024. https://www.thebookseller.com/news/penguin-random-house-underscores-copyright-protection-in-ai-rebuff.

Penguin Random House (PRH), el mayor editor comercial del mundo, ha modificado el texto en sus páginas de derechos de autor para proteger la propiedad intelectual de sus autores frente al uso no autorizado de sus obras para entrenar modelos de inteligencia artificial (IA). El nuevo texto, que se aplicará globalmente en todas las nuevas publicaciones y reimpresiones, prohíbe expresamente que sus libros sean usados para entrenar tecnologías de IA. Esto responde a casos de infracción de derechos de autor en los EE.UU., donde se han utilizado libros pirateados para entrenar IA sin autorización.

El CEO de PRH UK, Tom Weldon, afirmó que la empresa «defenderá vigorosamente» los derechos de propiedad intelectual de sus autores, mientras que elogiaron la actualización de PRH desde la Sociedad de Autores y otras organizaciones. Sin embargo, pidieron que también se modifiquen los contratos de los autores para asegurar que su consentimiento sea requerido antes de utilizar IA en la creación o producción de sus obras.

Expertos legales indicaron que el verdadero riesgo está en el entrenamiento de los modelos de IA, y no tanto en los resultados que estos generan. La industria editorial busca establecer mejores prácticas en medio de un panorama de IA en rápida evolución, donde el uso no autorizado de contenido afecta los ingresos de autores y editores.

Adopción de la IA Generativa por investigadores de Biomedicina

“Adoption of Generative AI by Academic Biomedical Researchers”. Ithaka S+R, 2024

Texto completo

El informe «Adopción de la IA Generativa por Investigadores Biomédicos Académicos» fue publicado por Ithaka S+R el 17 de octubre de 2024. Este estudio analiza cómo los investigadores en el campo biomédico están utilizando la IA generativa, así como las percepciones y barreras que enfrentan en su adopción.

Desde el lanzamiento de ChatGPT en noviembre de 2022, ha surgido un debate nacional sobre el papel de la IA generativa en diversos sectores del trabajo intelectual, aunque la atención se ha centrado principalmente en su impacto en la enseñanza. El ámbito de la investigación biomédica presenta casos prometedores de uso, pero también riesgos significativos asociados a esta tecnología.

Los hallazgos del informe revelan que la adopción de la IA generativa es mixta. Muchos investigadores han experimentado con su uso, pero este es limitado en alcance y frecuencia. Las principales barreras para su adopción incluyen preocupaciones sobre la precisión de los resultados y cuestiones éticas. Debido a la calidad actual de las salidas de la IA generativa y la falta de mejores prácticas, es posible que su adopción se estabilice.

Ithaka S+R realizó una encuesta a investigadores biomédicos académicos sobre sus actitudes y uso de la IA generativa en contextos de investigación, que se llevó a cabo entre el 20 de febrero y el 29 de marzo de 2024, con 770 participantes.

Aunque la mayoría de los investigadores biomédicos han utilizado la IA generativa en el pasado, pocos la usan actualmente y casi ninguno lo hace de manera regular. De los investigadores que han utilizado la IA generativa:

  • 6 de cada 10 han empleado esta tecnología en su investigación.
  • El 31% la ha utilizado para revisar o editar gramática.
  • El 25% la ha usado para extraer información de la literatura científica.
  • El 22% la ha aplicado en tareas administrativas.
  • El 22% la ha usado para escribir código.

Sin embargo, solo el 40% de los investigadores biomédicos la utiliza actualmente. Las principales barreras para la adopción son:

  • El 55% reportó que los resultados no son suficientemente precisos o confiables.
  • Menos de 1 de cada 10 investigadores la utiliza regularmente.
  • El 47% señaló que hay falta de claridad sobre las mejores prácticas para la integridad de la investigación y el uso de la IA generativa.
  • El 56% expresó un gran interés en productos de IA generativa específicos para biomedicina.
  • Solo el 14% había utilizado herramientas o modelos de lenguaje específicos para biomedicina existentes.

Este informe es una contribución importante a la comprensión de las implicaciones de la IA generativa, y se anticipa que se publicará un análisis cualitativo más profundo sobre su uso en la educación superior más adelante en el año.

¿Se deben citar los chatbots de Inteligencia Artificial en un trabajo de investigación?

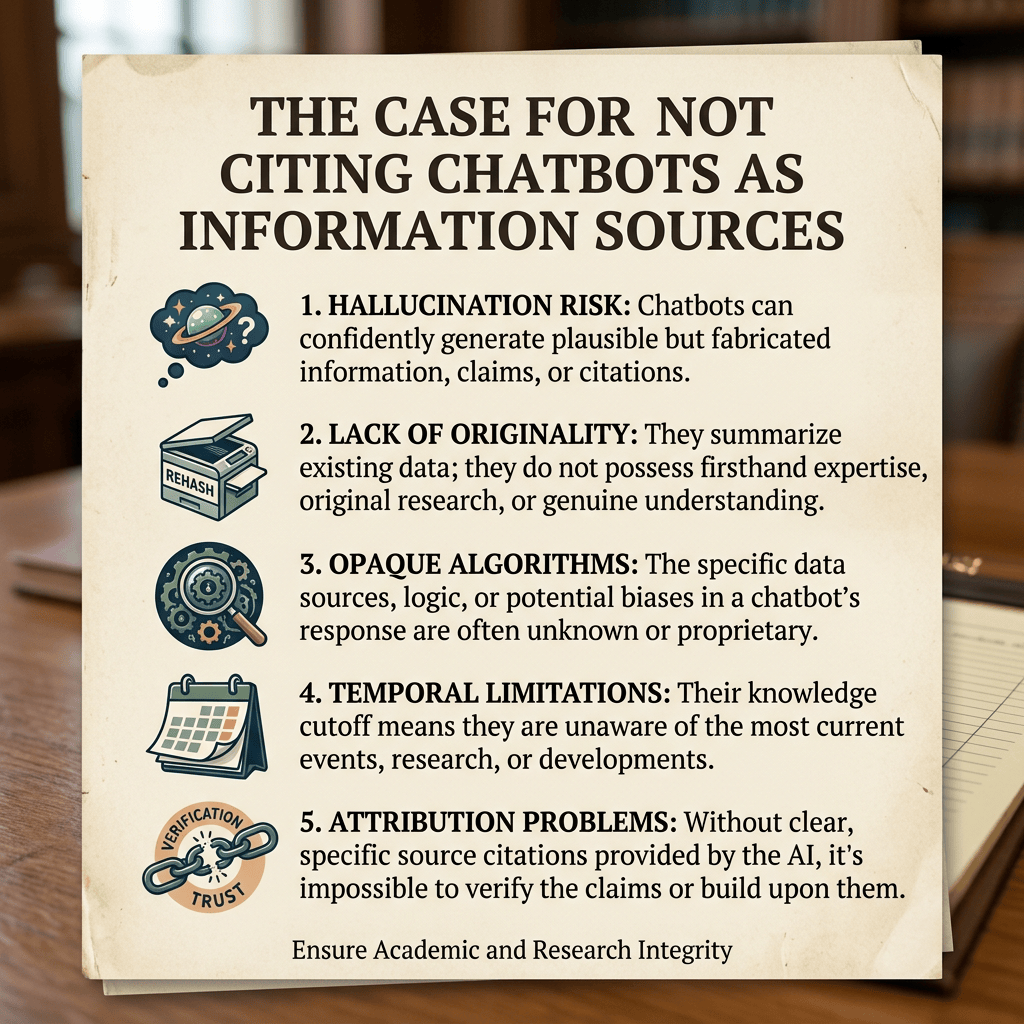
The Case for Not Citing Chatbots as Information Sources: 1. Hallucination Risk: Chatbots can confidently generate plausible but fabricated information, claims, or citations. 2. Lack of Originality: They summarize existing data; they do not possess firsthand expertise, original research, or genuine understanding. 3. Opaque Algorithms: The specific data sources, logic, or potential biases in a chatbot’s response are often unknown or proprietary. 4. Temporal Limitations: Their knowledge cutoff means they are unaware of the most current events, research, or developments. 5. Attribution Problems: Without clear, specific source citations provided by the AI, it’s impossible to verify the claims or build upon them. Ensure Academic and Research Integrity.
This infographic outlines five reasons chatbots should not be treated as authoritative information sources.

Antunes Nogueira, L.; Rein, Jan Ove. «Guest Post – The Case For Not Citing Chatbots As Information Sources (Part I) and (Part II)». The Scholarly Kitchen, 20 de junio de 2024. https://scholarlykitchen.sspnet.org/2024/06/19/chatbots-to-cite-or-not-to-cite-part-1/

Este artículo invita a reflexionar sobre las implicaciones éticas y prácticas del uso de IA generativa en la producción académica y la necesidad de normas más claras para su uso y citación.

Se revisan las políticas de 17 editores y organizaciones académicas, encontrando un consenso general sobre que los chatbots no cumplen los requisitos para ser considerados autores, ya que no pueden asumir la responsabilidad por los textos generados. Sin embargo, no existe una postura clara sobre si deben ser citados como fuentes.

Algunos, como International Committee of Medical Journal Editors (ICMJE) y Elsevier, son tajantes en su recomendación de no citarlos, mientras que la American Psychological Association (APA) ha ofrecido directrices sobre cómo citar chatbots como herramientas, sin admitirlos como fuentes de información.

El problema radica en que los textos generados por chatbots, aunque coherentes, no son rastreables ni verificables, lo que lleva a muchos a cuestionar su validez como fuentes. El caso de la retracción de un artículo por el uso de citas incorrectas generadas por ChatGPT ejemplifica los riesgos involucrados.

Citar es una norma sociocultural y ética en la academia, y sus razones incluyen:

  • Atribuir crédito a las ideas ajenas.
  • Proveer evidencia para respaldar un argumento.
  • Situar el trabajo dentro de un debate académico.
  • Facilitar que otros verifiquen las fuentes de información.

El uso de chatbots introduce un nuevo desafío, ya que sus respuestas, aunque parecen coherentes, no representan fuentes verificables de información, sino productos generados probabilísticamente por algoritmos.

El debate sobre si los chatbots deben ser citados como fuentes se divide en dos posturas:

  1. Pro-citación: Se argumenta que si el contenido no es propio, debe citarse para evitar el plagio, lo que implicaría tratar al chatbot como una fuente.
  2. Anti-citación: Quienes se oponen a citarlos como fuentes destacan que los textos generados por IA no pueden ser rastreados ni verificados, lo que los hace inadecuados para ser tratados como fuentes. Sugieren que los chatbots deben considerarse como herramientas, similares a otras usadas en la investigación, y que su uso debe ser explicado en las secciones metodológicas del trabajo.

Los autores concluyen que la irrupción de los chatbots obliga a reconsiderar las prácticas de citación y a discernir entre herramientas de asistencia y fuentes de información verificables.

Se proponen varias razones para no citar chatbots. Primero, citar chatbots entraría en conflicto con las políticas académicas, ya que citar a estos sistemas podría legitimar a las empresas detrás de la tecnología como autores, lo que comprometería la responsabilidad intelectual. Además, citar chatbots podría contaminar el ecosistema informativo al difundir datos generados por IA, lo que erosionaría la calidad de los modelos de lenguaje y promovería la desinformación.

Otro punto relevante es que los chatbots no fueron diseñados como máquinas de verdad. Su funcionamiento se basa en cálculos probabilísticos de secuencias de palabras, no en la verificación de hechos. Por ello, los resultados que generan pueden incluir falsedades (hallucinations). Sin embargo, los chatbots podrían ser útiles en tareas de extracción de información, siempre que se basen en bases de datos confiables.

El texto también plantea que crear reglas que obliguen a citar a los chatbots sería impráctico y enviaría un mensaje erróneo, ya que las herramientas actuales no pueden detectar de manera confiable el uso de textos generados por IA. Además, legitimar la práctica de citar chatbots como fuentes podría llevar al mal uso de estas herramientas, lo que resultaría contraproducente para la academia. En lugar de ello, se propone una inversión en alfabetización en IA y un enfoque normativo flexible, basado en normas socioculturales que evolucionen con el tiempo y que establezcan prácticas adecuadas para el uso de estas herramientas.

En conclusión, se sugiere que las instituciones académicas deben adoptar una postura clara que desincentive la citación de chatbots como fuentes de información, y que promueva su uso adecuado como herramientas de apoyo en el proceso de investigación. Las instituciones académicas, junto con editoriales y revistas, tienen el poder de guiar la normalización de las prácticas sobre la divulgación del uso de IA, lo cual sería crucial para mantener la integridad del ecosistema informativo.

El libro de divulgación científica en Chile 2015-2020

«El libro de divulgación científica en Chile 2015-2020». s. f. Cerlalc (blog). Accedido 9 de octubre de 2024. https://cerlalc.org/publicaciones/el-libro-de-divulgacion-cientifica-en-chile-2015-2020/.

Este documento presenta un diagnóstico del estado y características de los libros de divulgación científica publicados en Chile en el periodo 2015-2020. Para ello, se realizó una aproximación a partir de la base de datos de la Agencia ISBN Chile. A partir de una serie de criterios de selección, se rastrearon un total de 338 libros de divulgación científica con ISBN chileno. Estos libros fueron caracterizados, entre otras variables, por la disciplina científica más fuertemente asociada, utilizando como referencia las categorías disciplinares de la OCDE. Posteriormente, se generó una muestra intencionada de 102 libros, buscando mantener la diversidad y proporcionalidad de las diferentes disciplinas. Esta muestra fue analizada cualitativamente considerando cuatro dimensiones de análisis: los recursos editoriales desplegados, las herramientas lingüísticas utilizadas, las estrategias de inclusión, los modelos de comunicación de la ciencia y elementos científicos dentro de los libros.

Características de los artículos científicos fabricados con Inteligencia Artificial en Google Scholar

Haider, J., Söderström, K. R., Ekström, B., & Rödl, M. (2024). GPT-fabricated scientific papers on Google Scholar: Key features, spread, and implications for preempting evidence manipulation. Harvard Kennedy School (HKS) Misinformation Review. https://doi.org/10.37016/mr-2020-156

Descargar

El artículo analiza el creciente número de trabajos científicos cuestionables generados por inteligencia artificial (IA), como ChatGPT, que se están publicando en revistas académicas y repositorios. Estos trabajos, que imitan el estilo de la escritura científica, están siendo fácilmente localizados y listados por Google Scholar junto con investigaciones legítimas. El estudio se centró en un grupo de estos artículos y encontró que muchos tratan temas aplicados y a menudo controversiales, como el medio ambiente, la salud y la computación, áreas particularmente vulnerables a la desinformación. La preocupación radica en el aumento del potencial de manipulación malintencionada de la base de evidencia, especialmente en temas divisivos políticamente.

El estudio se centra en la producción y difusión de publicaciones cuestionables generadas con transformadores preentrenados (GPT) que son accesibles a través de Google Scholar, abordando varios aspectos clave: primero, se investiga dónde se publican o depositan estas publicaciones dudosas. Este análisis busca identificar los tipos de revistas y plataformas que albergan este contenido. En segundo lugar, se examinan las características principales de estas publicaciones en relación con las categorías temáticas predominantes, permitiendo una comprensión más profunda de los temas que son más susceptibles al uso indebido de la inteligencia artificial generativa. Además, se explora cómo se difunden estas publicaciones en la infraestructura de investigación para la comunicación académica, prestando atención a los canales y plataformas que facilitan su circulación. Esto incluye la identificación de dominios y repositorios donde se comparten estos trabajos. Finalmente, la investigación cuestiona el papel de la infraestructura de comunicación académica en la preservación de la confianza pública en la ciencia y la evidencia, considerando los desafíos que presenta el uso inapropiado de la inteligencia artificial generativa en este contexto. Este aspecto subraya la necesidad de una regulación más efectiva y la implementación de criterios de calidad en la publicación académica.

Para ello, se recuperó, descargó y analizó una muestra de artículos científicos con indicios de uso de GPT encontrados en Google Scholar, utilizando una combinación de codificación cualitativa y estadísticas descriptivas. Todos los artículos contenían al menos una de dos frases comunes generadas por agentes conversacionales que utilizan grandes modelos de lenguaje (LLM) como ChatGPT. Luego, se utilizó Google Search para determinar la extensión de las copias de estos artículos cuestionables en diversos repositorios, archivos, bases de datos de citas y plataformas de redes sociales.

Aproximadamente dos tercios de los artículos recuperados fueron producidos, al menos en parte, mediante el uso no divulgado y potencialmente engañoso de GPT. La mayoría de estos trabajos (57%) abordaban temas relevantes para políticas públicas, como el medio ambiente, la salud y la computación, los cuales son susceptibles a operaciones de influencia. La mayoría de estos artículos estaban disponibles en varias copias en diferentes dominios (redes sociales, archivos y repositorios).

La mayoría de los artículos sospechosos de uso fraudulento de ChatGPT se encontraron en revistas no indexadas o como trabajos en proceso, aunque algunos también aparecieron en revistas establecidas, conferencias y repositorios. En total, se identificaron 139 artículos, de los cuales 19 estaban en revistas indexadas, 89 en revistas no indexadas, 19 eran trabajos estudiantiles y 12 eran documentos de trabajo. La mayoría de los artículos trataban temas de relevancia política, como la salud y el medio ambiente, y se encontraban principalmente en revistas no indexadas.

Existen dos riesgos principales derivados del uso cada vez más común de GPT para producir de manera masiva publicaciones científicas falsas. Primero, la abundancia de “estudios” fabricados que se infiltran en todas las áreas de la infraestructura de investigación amenaza con sobrecargar el sistema de comunicación académica y poner en peligro la integridad del registro científico. El segundo riesgo es que el contenido, aunque parezca científicamente convincente, haya sido creado de manera engañosa con herramientas de IA y esté optimizado para ser recuperado por motores de búsqueda académicos públicos, especialmente Google Scholar. Aunque esta posibilidad sea pequeña, su conocimiento podría socavar la confianza en el conocimiento científico y representar graves riesgos para la sociedad.

El estudio subraya que el problema de las publicaciones científicas fraudulentas generadas por GPT es solo la punta del iceberg, con implicaciones profundas para la confianza en la ciencia y para la sociedad en general.
Las publicaciones en acceso abierto generan pocas visitas desde los resultados de búsqueda de Google a los repositorios institucionales

Orduña-Malea, E., Font-Julián, C.I. & Serrano-Cobos, J. Open access publications drive few visits from Google Search results to institutional repositories. Scientometrics (2024). https://doi.org/10.1007/s11192-024-05175-0

El estudio resalta la importancia de Google Search en la generación de visitas a los repositorios institucionales (IR). La falta de visibilidad en los resultados de los motores de búsqueda puede afectar negativamente la posibilidad de que las publicaciones depositadas en estos repositorios sean encontradas, leídas, descargadas y citadas. Para mejorar esta situación, las instituciones deben evaluar la visibilidad de sus repositorios y determinar las acciones necesarias para optimizarla. No obstante, medir la visibilidad en términos de optimización de motores de búsqueda (SEO) requiere un método preciso y técnicamente viable.

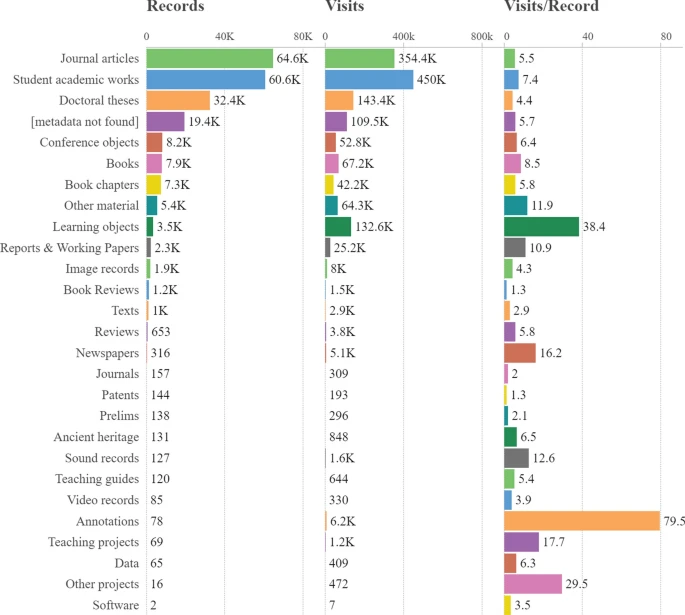
Este trabajo es el primer intento de diseñar un método de este tipo, aplicado específicamente a la medición de la visibilidad de los IR de las universidades nacionales de España en Google Search, utilizando métricas SEO derivadas de la herramienta Ubersuggest. Se analizó un extenso conjunto de datos durante tres meses, que incluyó 217,589 registros bibliográficos y 316,899 palabras clave orgánicas.

Los resultados revelan que muchos registros en estos repositorios no aparecen en los primeros puestos de los resultados de búsqueda de Google. Los registros más visibles suelen ser trabajos académicos (tesis y disertaciones) en español, particularmente en Humanidades y Ciencias Sociales. Sin embargo, la mayoría de las visitas provienen de un número reducido de registros. Estos hallazgos cuestionan el papel de los IR en atraer lectores a través de Google Search, destacando que su enfoque principal sigue siendo la preservación más que la difusión en línea.

El estudio sugiere que mejoras potenciales podrían lograrse mediante esquemas de metadatos mejorados y prácticas de descripción normalizadas, así como la adopción de otras estrategias que fortalezcan la visibilidad en línea de los IR. Este trabajo resulta relevante para defensores del acceso abierto, agencias de investigación, bibliotecarios, desarrolladores de repositorios y administradores de sitios web, ya que contribuye a una mejor comprensión del impacto web de los resultados de investigación depositados en los IR.

La inteligencia artificial y su impacto en la escritura académica

Julio Alonso Arévalo. La inteligencia artificial y su impacto en la escritura académica . BUCLE, 2024

La inteligencia artificial está teniendo un impacto significativo en la escritura académica al ofrecer herramientas y recursos que facilitan el proceso de investigación, redacción y edición de documentos. Mediante el uso de algoritmos avanzados, los sistemas de inteligencia artificial pueden analizar grandes cantidades de información, extraer patrones y generar ideas para el desarrollo de un texto académico. Estas herramientas pueden ayudar a los estudiantes y profesores a ahorrar tiempo y esfuerzo al proporcionar sugerencias de vocabulario, estructura de párrafos y citas bibliográficas adecuadas. Además, la inteligencia artificial también puede contribuir a mejorar la calidad de los escritos académicos, al detectar errores gramaticales y de estilo, así como proporcionar recomendaciones para una redacción más clara y coherente. Sin embargo, es importante tener en cuenta que la inteligencia artificial no debe reemplazar el pensamiento crítico y la creatividad inherentes a la escritura académica, sino que debe utilizarse como una herramienta complementaria para mejorar y enriquecer el proceso de escritura.

Cómo las bibliotecas universitarias gestionan sus servicios de descubrimiento de la investigación a gran escala

Wong, S. «Organizational Structure around Web-Scale Discovery Services in Canadian Academic Libraries», 3 de agosto de 2023, https://doi.org/10.20383/103.0786.

Descargar artículo

El artículo «Organizational Structure Around Web-Scale Discovery Services in Canadian Academic Libraries» de Sandra Wong (Universidad Simon Fraser) analiza cómo las bibliotecas universitarias canadienses gestionan y administran sus servicios de descubrimiento a gran escala en la web y cómo la adopción de estos servicios ha transformado las fronteras tradicionales de las funciones bibliotecarias.

A través de encuestas e entrevistas semiestructuradas, Wong investigó cómo estas bibliotecas han estructurado sus operaciones en torno a estos servicios. Se encontró que la gestión de los servicios de descubrimiento puede estar bajo la responsabilidad de unidades como Servicios Técnicos, Sistemas Bibliotecarios, Servicios Web o incluso de un comité. No obstante, existe un consenso sobre la necesidad de colaboración entre múltiples áreas funcionales para su éxito. Los líderes de estos servicios suelen tener la capacidad de desmantelar los silos tradicionales de funciones bibliotecarias y colaborar con diferentes equipos, con un enfoque centrado en el usuario.

El estudio resalta la flexibilidad y la cooperación necesarias para manejar los servicios de descubrimiento en bibliotecas universitarias, enfatizando un enfoque integrador y orientado hacia el usuario.