Archivo de la etiqueta: Integridad de datos

La investigación fraudulenta no desaparece cuando se publica, sigue siendo citada

Retraction Watch, “Paper mill studies get cited by clinical guidelines, policy docs and more, analysis finds”, 17 de septiembre de 2026. El artículo analiza un estudio de Federica Silvi y Leslie D. McIntosh, de Digital Science, publicado como preprint en arXiv el 31 de agosto de 2026 https://retractionwatch.com/2026/09/17/paper-mill-studies-get-cited-by-clinical-guidelines-policy-docs-and-more-analysis-finds/

Según un nuevo análisis, los estudios producidos por una presunta «fábrica de artículos» (paper mill) aparecen citados con frecuencia en patentes, guías clínicas y documentos de políticas públicas.

El estudio analiza qué ocurre con artículos científicos vinculados a una “paper mill”, es decir, una empresa o red que comercializa manuscritos científicos, autorías o servicios destinados a introducir trabajos de dudosa procedencia en el sistema de publicación académica. El caso estudiado procede de la Pharmakon Neuroscience Network (PNN), una supuesta red científica que, según investigaciones anteriores, funcionaba como un sistema de venta de autorías. Los primeros artículos que incluían PNN entre sus afiliaciones comenzaron a aparecer en 2019 y presentaban algunas características habituales de las publicaciones sospechosas: grupos de autores de diferentes países sin antecedentes claros de colaboración, investigadores de campos muy distintos y combinaciones de autorías difíciles de explicar por una trayectoria científica convencional. 

Silvi y McIntosh estudiaron 1.975 artículos asociados a autores que habían utilizado PNN como afiliación y utilizaron la base de datos Dimensions para seguir las citas que recibieron posteriormente. El objetivo no era simplemente contar cuántos de esos artículos habían sido retractados, sino determinar hasta dónde había llegado su influencia dentro del ecosistema científico y académico. El resultado resulta especialmente relevante: 480 artículos fueron citados en patentes, 57 aparecieron citados en documentos de política pública y 12 fueron citados en guías clínicas.

El principal hallazgo del estudio es que una investigación cuestionable puede seguir circulando y adquiriendo influencia mucho después de haber sido producida. Una vez que un artículo entra en una base de datos bibliográfica, recibe citas y forma parte del corpus de literatura científica disponible, puede ser utilizado por investigadores que desconocen completamente su procedencia.

Esto crea un problema especialmente importante porque las citas pueden actuar como una especie de mecanismo de legitimación acumulativa. Un artículo puede ser citado porque parece relevante, después aparecer en una revisión de literatura, posteriormente ser utilizado por otro investigador y finalmente llegar a un documento normativo o una guía. En cada paso puede perderse información sobre la calidad o procedencia original de la investigación.

El estudio demuestra precisamente que la contaminación del registro científico no se limita a llenar las revistas de artículos problemáticos. Puede alcanzar productos derivados de la ciencia: patentes, documentos de política científica y sanitaria, guías clínicas y eventualmente decisiones relacionadas con financiación.

El problema adquiere una dimensión adicional con la expansión de la IA generativa. Las paper mills ya pueden utilizar herramientas automatizadas para producir textos, modificar manuscritos, generar imágenes o acelerar procesos de publicación. Investigaciones recientes sobre el mercado de venta de autorías muestran precisamente que el modelo de negocio está evolucionando y que la IA puede facilitar algunas de estas operaciones.

Esto puede crear un escenario especialmente complejo: más producción científica aparente, más velocidad de publicación y más dificultad para distinguir entre investigación auténtica y contenido fabricado.

Por ello, la integridad científica futura probablemente dependerá cada vez más de una combinación de revisión humana, análisis bibliométrico, detección de patrones de autoría, verificación de datos, transparencia sobre contribuciones y sistemas capaces de rastrear cambios en el estado de una publicación.
La inteligencia artificial generativa y la integridad científica: guía de la Office of Research Integrity de Estados Unidos

U.S. Department of Health and Human Services (HHS), Office of Research Integrity (ORI). Public Health Service Policies on Research Misconduct: 42 CFR Part 93 Guidance on Generative Artificial Intelligence.

Texto completo

Office of Research Integrity (ORI) del Departamento de Salud y Servicios Humanos de Estados Unidos ha publicado en agosto de 2026 una guía específica sobre el uso de inteligencia artificial generativa en el contexto de la investigación científica y las posibles conductas de mala conducta investigadora.

El documento está dirigido especialmente a las instituciones y entidades que reciben financiación del Public Health Service (PHS) para investigación biomédica o conductual. Su propósito es orientar la evaluación de posibles casos de mala conducta científica en los que intervengan herramientas de IA generativa, dentro del marco establecido por la normativa 42 CFR Part 93. La guía es de carácter no vinculante y, en caso de conflicto, prevalece la regulación federal.

El documento parte de una idea importante: el uso de IA generativa no constituye por sí mismo una conducta de mala conducta científica. Los investigadores y las instituciones deben aplicar, en términos generales, las mismas buenas prácticas que utilizarían cuando no interviene la IA. Sin embargo, la utilización de estas herramientas puede generar situaciones de fabricación, falsificación o plagio, por lo que resulta fundamental evaluar si su empleo supone una desviación significativa de las prácticas aceptadas por la comunidad científica correspondiente. Para ello, los comités de investigación deben analizar todas las evidencias disponibles y contar con expertos científicos en el área de investigación afectada; además, ORI considera útil incorporar especialistas en IA cuando sea necesario comprender las herramientas utilizadas.

Uno de los principios centrales de la guía es la transparencia en el uso de IA. ORI recomienda que los investigadores identifiquen las herramientas de IA generativa empleadas durante la investigación, la preparación de manuscritos o la elaboración de propuestas de financiación y que expliquen cómo fueron utilizadas. Esta información puede contribuir a la reproducibilidad de la investigación y también servir como elemento de defensa frente a determinadas acusaciones de mala conducta. No obstante, declarar el uso de IA no garantiza que dicho uso sea considerado legítimo: si la utilización de la herramienta contradice las prácticas aceptadas por la comunidad científica, puede seguir constituyendo evidencia de mala conducta. Asimismo, el uso de IA para generar o procesar datos debe ser cuidadosamente verificado.

La guía presta especial atención a los problemas de fabricación y falsificación de datos. Un investigador debe comprobar los resultados obtenidos mediante procesos que incorporen IA, ya que la generación o modificación no declarada de datos puede constituir fabricación o falsificación. ORI incluso señala que algunas tecnologías aparentemente rutinarias pueden incorporar procesos automáticos de alteración de imágenes, como ocurre con determinadas cámaras de teléfonos inteligentes. En estos casos, corresponde al investigador demostrar, cuando proceda, que la alteración fue consecuencia de un error honesto y no de una conducta intencionada, consciente o imprudente.

Inteligencia artificial e integridad de la información. Perspectivas para un uso responsable

Hernández Pérez, J. (coord.), & Cox, A. (2025). Inteligencia artificial e integridad de la información. Perspectivas para un uso responsable. Serie Información y Sociedad. Ciudad de México: Universidad Nacional Autónoma de México. 204 p. ISBN: 978-607-642-424-7.

Texto completo

Inteligencia artificial e integridad de la información. Perspectivas para un uso responsable ofrece una reflexión multidisciplinar sobre uno de los mayores desafíos de la sociedad contemporánea: preservar la integridad de la información en un contexto profundamente transformado por la inteligencia artificial. Coordinada por Jonathan Hernández Pérez, con la participación de Andrew Cox y otros especialistas, la obra surge de las discusiones desarrolladas en el Seminario Inteligencia Artificial e Integridad de la Información, celebrado en el marco del Mexican Information Global Forum. El libro reúne diez capítulos que analizan desde distintas perspectivas las implicaciones sociales, éticas, tecnológicas y educativas derivadas del creciente protagonismo de la IA en la producción, distribución y consumo de información.

Gestión de publicaciones retractadas por parte de diferentes bases de datos

Salami, Malik Oyewale, Corinne McCumber, y Jodi Schneider. 2024. «Analyzing the Consistency of Retraction Indexing». OSF. https://doi.org/10.31222/osf.io/gvfk5.

El artículo aborda un problema crítico en el ámbito académico: la inconsistencia en la identificación y el manejo de publicaciones retractadas por parte de diferentes bases de datos. Se analiza cómo estas bases gestionan las retractaciones, evaluando la calidad de su indexación.

El propósito central es investigar por qué las publicaciones retractadas siguen siendo citadas incluso después de que se retiran oficialmente. Esto puede atribuirse, en parte, a las dificultades que enfrentan autores y editores para identificar sistemáticamente estas publicaciones en diferentes bases de datos académicas. Los investigadores buscan comprender el nivel de acuerdo entre estas bases de datos y señalar los errores más comunes en la indexación.

Para llevar a cabo el estudio se evaluaron 11 bases de datos científicas relevantes, utilizando una lista unificada de 85.392 publicaciones únicas retractadas como referencia. Se analizaron las publicaciones que cada base incluía, aquellas que identificaban como retractadas y las que no eran reconocidas en absoluto. Y finalmente se midió la concordancia entre las bases de datos en cuanto a la identificación de publicaciones retractadas.

Hallazgos principales:

  • Baja consistencia entre bases de datos: Los resultados muestran que las bases de datos tienen una baja concordancia en la indexación de publicaciones retractadas, incluso cuando cubren los mismos documentos. Esto genera discrepancias significativas sobre qué trabajos se identifican oficialmente como retractados.
  • Errores en la indexación: Se encontraron problemas recurrentes en cómo se manejan las retractaciones, tales como: Las publicaciones retractadas que no son marcadas adecuadamente en ciertas bases. Inconsistencias en el etiquetado de retractaciones entre diferentes plataformas.
  • Impacto en las citas posteriores a la retractación: Debido a estas inconsistencias, muchos trabajos retractados siguen siendo citados por error, lo que perpetúa información incorrecta y afecta la credibilidad de futuras investigaciones.

El estudio destaca varias implicaciones importantes para la comunidad académica debido a la falta de estándares claros en la gestión de publicaciones retractadas.

  • Primero, hay una confusión para los investigadores. Los autores pueden no estar al tanto de que una publicación ha sido retractada si buscan referencias en bases de datos que no la han actualizado adecuadamente. Esto puede llevar a la cita de trabajos que ya no son válidos, lo que afecta la calidad de la investigación.
  • En segundo lugar, hay un impacto en la calidad científica. Las citas erróneas de publicaciones retractadas pueden disminuir la precisión de nuevos estudios. Si otros investigadores basan su trabajo en artículos retractados, esto puede afectar la fiabilidad de sus propios resultados, lo que reduce la confianza en la ciencia.

El estudio también presenta varias recomendaciones para mejorar la situación. Una de las principales sugerencias es crear directrices claras sobre cómo las bases de datos deben manejar las publicaciones retractadas. Además, se debe mejorar la coordinación entre las plataformas para asegurarse de que todas las bases de datos identifiquen correctamente los trabajos retractados. Finalmente, se recomienda implementar mejores sistemas de notificación para alertar a los investigadores cuando un artículo haya sido retractado, asegurando que todos estén informados y puedan evitar usar referencias incorrectas.

El análisis pone de manifiesto un desafío crítico en el sistema académico global: la inconsistencia en el manejo de las retractaciones. Resolver este problema es fundamental para mejorar la transparencia y la confiabilidad de la investigación científica

La inteligencia artificial y su impacto en la escritura académica

Julio Alonso Arévalo. La inteligencia artificial y su impacto en la escritura académica . BUCLE, 2024

La inteligencia artificial está teniendo un impacto significativo en la escritura académica al ofrecer herramientas y recursos que facilitan el proceso de investigación, redacción y edición de documentos. Mediante el uso de algoritmos avanzados, los sistemas de inteligencia artificial pueden analizar grandes cantidades de información, extraer patrones y generar ideas para el desarrollo de un texto académico. Estas herramientas pueden ayudar a los estudiantes y profesores a ahorrar tiempo y esfuerzo al proporcionar sugerencias de vocabulario, estructura de párrafos y citas bibliográficas adecuadas. Además, la inteligencia artificial también puede contribuir a mejorar la calidad de los escritos académicos, al detectar errores gramaticales y de estilo, así como proporcionar recomendaciones para una redacción más clara y coherente. Sin embargo, es importante tener en cuenta que la inteligencia artificial no debe reemplazar el pensamiento crítico y la creatividad inherentes a la escritura académica, sino que debe utilizarse como una herramienta complementaria para mejorar y enriquecer el proceso de escritura.

Uno de cada siete artículos científicos podría ser al menos parcialmente falso

James Heathers, «How much science is fake? approximate 1 in 7 Scientific Papers Are Fake», 22 de septiembre de 2024, https://doi.org/10.17605/OSF.IO/5RF2M.


Un nuevo análisis realizado por James Heathers sugiere que uno de cada siete artículos científicos podría ser al menos parcialmente falso. Este estudio, publicado el 24 de septiembre en el Open Science Framework antes de la revisión por pares, se basó en datos de 12 estudios previos que analizaron aproximadamente 75.000 artículos. Heathers critica la cifra del 2% de fraude que se ha citado desde un estudio de 2009, argumentando que está desactualizada.

En 2009, un estudio ampliamente citado reveló que alrededor del 2% de los científicos admitían haber falsificado, fabricado o modificado datos en algún momento de su carrera. Esta cifra ha sido utilizada con frecuencia para ilustrar el problema del fraude en la ciencia. Sin embargo, 15 años después, James Heathers, investigador afiliado en psicología en la Universidad Linnaeus de Växjö, Suecia, decidió cuestionar esa cifra y ofrecer una estimación más actualizada y precisa. En su nuevo análisis, publicado el 24 de septiembre en el Open Science Framework antes de la revisión por pares, Heathers sugiere que uno de cada siete artículos científicos puede ser al menos parcialmente falso.

Heathers, conocido por su labor como «detective científico», llegó a esta conclusión al promediar datos de 12 estudios existentes. Estos estudios, que abarcan áreas como las ciencias sociales, la medicina y la biología, analizaron alrededor de 75.000 artículos para estimar el volumen de trabajos problemáticos. A través de una combinación de herramientas en línea que detectan irregularidades, Heathers encontró una «similitud persistente» entre las estimaciones de estos estudios y concluyó que, en promedio, uno de cada siete trabajos presenta errores o fraudes significativos.

Críticas a las estimaciones anteriores

Heathers explica que la cifra del 2% de fraude que proviene del estudio de 2009 está desactualizada, ya que el último conjunto de datos utilizado en ese estudio proviene de 2005. Durante los últimos 20 años, el entorno académico ha cambiado significativamente, y Heathers considera que esta cifra ya no refleja adecuadamente la magnitud del problema actual. Además, critica los enfoques anteriores que se centraban en preguntar directamente a los científicos si habían participado en prácticas deshonestas, calificando este método como ineficaz y poco fiable.

«Heathers señala que es ingenuo preguntar a los investigadores que cometen fraude si admitirán sus malas prácticas. En su lugar, propone utilizar herramientas más objetivas y datos indirectos para medir la magnitud del problema.»

Un enfoque «salvajemente no sistemático»

El propio Heathers reconoce que su estudio es «salvajemente no sistemático», ya que los datos que utilizó provienen de múltiples áreas y metodologías, y no existe un análisis homogéneo o riguroso que abarque todo el problema. Aun así, justifica su enfoque argumentando que esperar los recursos necesarios para realizar un análisis exhaustivo y sistemático tomaría demasiado tiempo, y que es importante comenzar a abordar el problema con los datos disponibles.

A pesar de sus limitaciones, Heathers decidió realizar un meta-análisis, ya que las cifras disponibles sobre la cantidad de ciencia fraudulenta son escasas. A su juicio, aunque se realice una revisión sistemática más formal, es probable que los resultados no difieran significativamente de su estimación preliminar de que uno de cada siete artículos es falso.

Críticas de otros expertos

El estudio ha recibido críticas de algunos expertos en la comunidad científica. Daniele Fanelli, un metacientífico de la Universidad Heriot-Watt en Edimburgo, Escocia, y autor del estudio de 2009, no está convencido de los resultados del nuevo análisis. Fanelli sostiene que el estudio de Heathers mezcla estudios que miden diferentes fenómenos y utiliza metodologías distintas, lo que puede llevar a conclusiones erróneas. Para Fanelli, etiquetar cualquier estudio con algún problema como «falso» no es un enfoque riguroso y podría llevar a una interpretación distorsionada del alcance real del fraude en la ciencia.

Fanelli también expresó su preocupación de que el estudio pueda atraer atención negativa e innecesaria de los medios, lo cual podría afectar la percepción pública de la ciencia sin un beneficio tangible para el campo.

Por su parte, Gowri Gopalakrishna, epidemióloga de la Universidad de Maastricht en los Países Bajos, también expresó reservas sobre las conclusiones de Heathers. Gopalakrishna coautorizó un estudio en 2021 que encontró que el 8% de los investigadores en una encuesta de casi 7.000 científicos en los Países Bajos admitieron haber falsificado o fabricado datos entre 2017 y 2020. Sin embargo, Gopalakrishna cree que la prevalencia del fraude puede variar significativamente entre diferentes campos de estudio, y agrupar todas las disciplinas bajo una misma cifra podría ser poco útil y conducir a interpretaciones erróneas.

Una amenaza existencial para la ciencia

A pesar de las críticas, Heathers sostiene que el problema del fraude en la ciencia representa una amenaza existencial para el campo y debe abordarse de inmediato. Argumenta que los científicos, las instituciones científicas y los organismos de financiación deben reconocer la gravedad del problema y actuar en consecuencia. El hecho de que un número significativo de publicaciones científicas pueda estar contaminado por fraudes o errores serios socava la confianza en el proceso científico y pone en riesgo el progreso del conocimiento.

Heathers también destaca que el fraude en la ciencia está «crucialmente subfinanciado» en términos de investigación y vigilancia, lo que agrava el problema. Aunque su estudio no es exhaustivo, espera que su trabajo sirva como un primer paso para abordar una cuestión que ha sido pasada por alto durante demasiado tiempo.

Principios Globales de las Naciones Unidas para la Integridad de la Información

United Nations Global Principles for Information Integrity. ONU, 2024

Texto completo

Los avances tecnológicos han revolucionado las comunicaciones, conectando a las personas a una escala antes inimaginable. Han apoyado a las comunidades en tiempos de crisis, elevado las voces marginadas y ayudado a movilizar movimientos globales por la justicia racial y la igualdad de género.

Sin embargo, estos mismos avances han permitido la propagación de desinformación, información errónea y discursos de odio a un volumen, velocidad y viralidad sin precedentes, poniendo en riesgo la integridad del ecosistema de la información.

Los nuevos y crecientes riesgos derivados de los avances en tecnologías de inteligencia artificial han hecho que fortalecer la integridad de la información sea una de las tareas más urgentes de nuestro tiempo.

Esta amenaza global clara y presente exige una acción internacional coordinada.

Los Principios Globales para la Integridad de la Información de las Naciones Unidas nos muestran que otro futuro es posible.

Recomendaciones

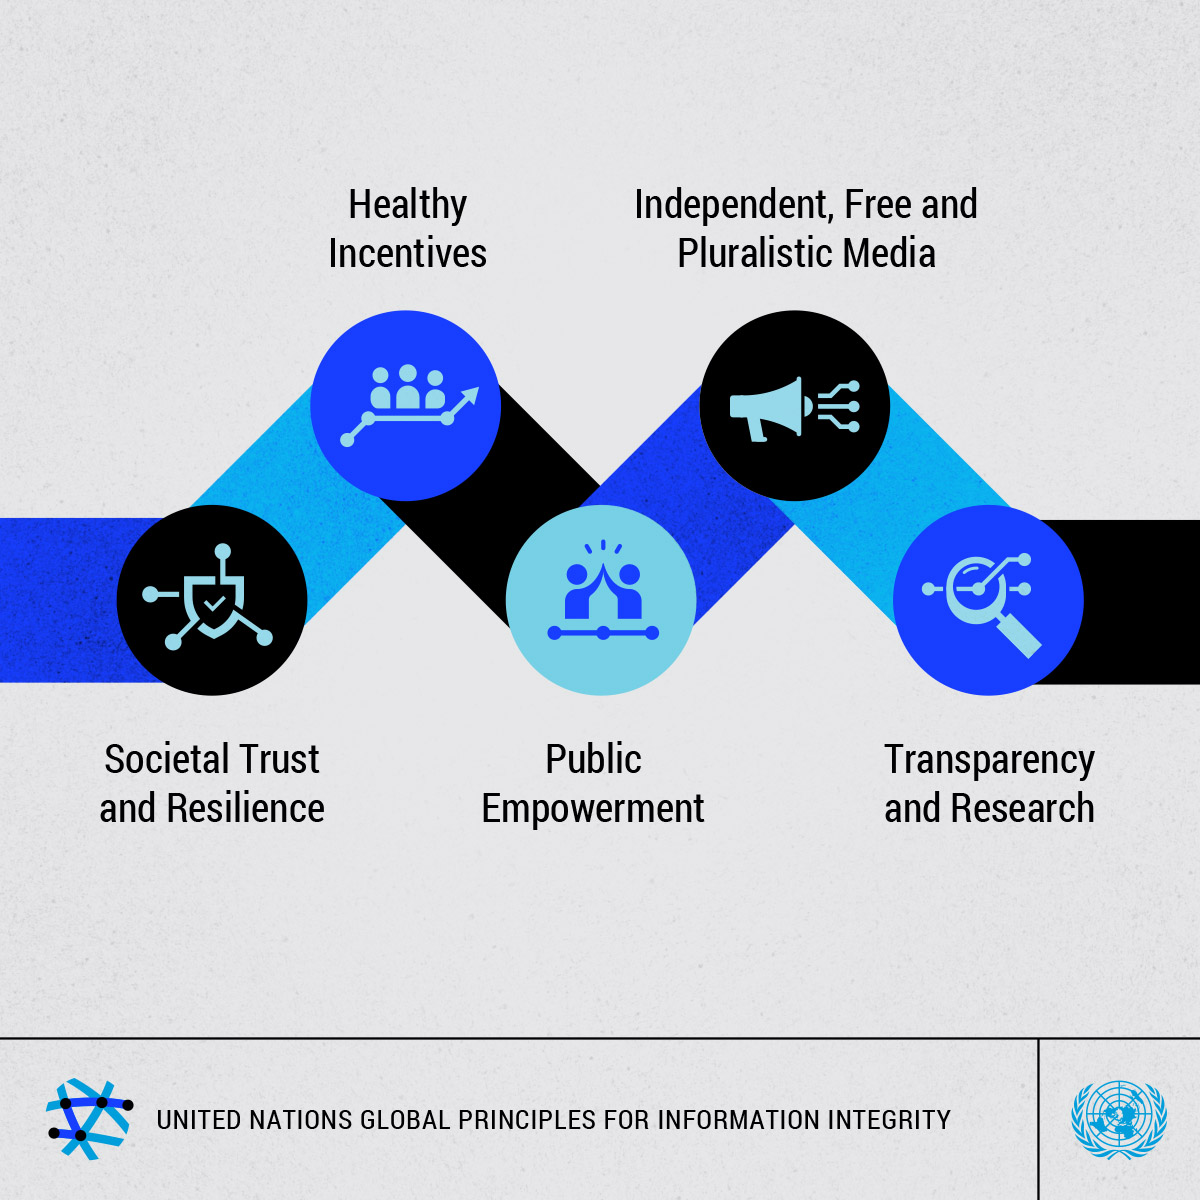
Las recomendaciones dentro de los Principios Globales están diseñadas para fomentar espacios de información más saludables y seguros que promuevan los derechos humanos, sociedades pacíficas y un futuro sostenible.

Las propuestas incluyen:

  • Evitar la desinformación y el discurso de odio: Los gobiernos, empresas tecnológicas, anunciantes, medios de comunicación y otros actores deben abstenerse de usar, apoyar o amplificar la desinformación y el discurso de odio para cualquier propósito.
  • Acceso a la información y libertad de prensa: Los gobiernos deben proporcionar acceso oportuno a la información, garantizar un panorama mediático libre, viable, independiente y plural, y asegurar fuertes protecciones para periodistas, investigadores y la sociedad civil.
  • Seguridad y privacidad por diseño: Las empresas tecnológicas deben asegurar la seguridad y privacidad desde el diseño en todos sus productos, junto con una aplicación consistente de políticas y recursos en todos los países e idiomas, prestando especial atención a los grupos que a menudo son atacados en línea. Deben mejorar la respuesta a crisis y tomar medidas para apoyar la integridad de la información durante las elecciones.
  • Desarrollo responsable de IA: Todos los involucrados en el desarrollo de tecnologías de inteligencia artificial deben tomar medidas urgentes, inclusivas y transparentes para garantizar que todas las aplicaciones de IA se diseñen, desplieguen y utilicen de manera segura, responsable y ética, y respeten los derechos humanos.
  • Modelos de negocio éticos: Las empresas tecnológicas deben explorar modelos de negocio que no dependan de la publicidad programática y que no prioricen el engagement por encima de los derechos humanos, la privacidad y la seguridad, permitiendo a los usuarios una mayor elección y control sobre su experiencia en línea y sus datos personales.
  • Transparencia en la publicidad digital: Los anunciantes deben exigir transparencia en los procesos de publicidad digital del sector tecnológico para garantizar que los presupuestos publicitarios no financien inadvertidamente la desinformación o el odio ni socaven los derechos humanos.
  • Transparencia y auditorías independientes: Las empresas tecnológicas y los desarrolladores de IA deben asegurar una transparencia significativa y permitir el acceso a datos a investigadores y académicos, respetando la privacidad de los usuarios, encargar auditorías independientes y co-desarrollar marcos de responsabilidad industrial.
  • Protección y empoderamiento de los niños: Gobiernos, empresas tecnológicas, desarrolladores de IA y anunciantes deben tomar medidas especiales para proteger y empoderar a los niños, proporcionando recursos para padres, tutores y educadores.

Informe sobre la integridad de la investigación


Federal Scientific Integrity: A Primer (New Congressional Research Service Report), 2020

Texto completo

Los resultados de la investigación y el desarrollo (I + D) ayudan a informar las decisiones que toman los formuladores de políticas y el público sobre una amplia gama de temas, incluida la salud y seguridad humanas, el medio ambiente, la agricultura, la energía y el transporte. Por ejemplo, la información científica es esencial para la revisión y aprobación de medicamentos y dispositivos médicos y el establecimiento de estándares de calidad del aire. 

Existe un amplio acuerdo entre los responsables de la formulación de políticas y la comunidad científica y de ingeniería acerca de garantizar la integridad de la conducta, la comunicación y la gestión de la I + D, y su uso en el desarrollo de políticas y la toma de decisiones. Sin embargo, recientemente, algunos legisladores y otros han alegado que las administraciones presidenciales de ambos partidos han violado los principios de integridad científica.

Una guía para mejorar la integridad y gestión de datos de investigación

cat

Roper, J. [e-Book] A Guide to Improving Data Integrity and Adoption: a Case Study in Verifying Usage Data. London, O’Really, 2016.

Texto completo

ePub

Mobi

PDF

Para la mayoría de entidades de investigación y empresas, los datos de calidad son fundamentales para medir el éxito y planificar los objetivos. Pero lograr la exactitud de los datos y la integridad puede ser una tarea desalentadora dada la naturaleza desordenada de los datos en bruto. ¿De qué manera se puede confiar en que los datos de origen son exactos? ¿Qué datos deben ser excluidos? ¿Qué pasos se deben tomar para asegurar que todos los datos se transforman correctamente?

Este informe presenta un estudio de caso de un proyecto de gestión de datos intensivos (Big Data) Spiceworks, la vibrante red, la comunidad línea y el mercado para profesionales de TICs. La autora Jessica Roper, desarrolladora senior en la división de análisis de datos de Spiceworks, demuestra formas de pensar en la verificación, procesamiento, análisis y automatización de datos. Además de ser una guía de herramientas para:

  • Determinar si los datos que recopila y utiliza son fiables y precisos.
  • Comprender lo que implica investigar los datos para verificar su fiabilidad.
  • Aprender estrategias y casos de prueba para verificar fuentes de datos sin procesar y trabajar con transformaciones de datos.
  • Familiarizarse con los datos de cada capa y crear pruebas entre cada transformación para garantizar la coherencia.
  • Entender qué casos , qué tendencias y valores esperamos obtener.
  • Monitorización de datos para identificar anomalías y problemas del sistema.
  • Automatizar las pruebas de proceso y aceptación para supervisar y garantizar la fiabilidad de los datos.
  • Trabajar con otros equipos y grupos para mejorar y validar la exactitud de los datos.
  • Aumentar la adopción mediante el uso de datos para medir el éxito.