Archivo de la etiqueta: Inteligencia artificial

La gobernanza democrática de la inteligencia artificial: la creciente dependencia entre los poderes públicos y las grandes tecnológicas

Astier, C., Bosoer, L., Cantero Gamito, M., & Pareto Boada, J. (2026). The public-private situationship in the democratic governance of AI. European University Institute. https://doi.org/10.2870/6848140

La relación ambigua entre lo público y lo privado en la gobernanza democrática de la inteligencia artificial analiza uno de los grandes desafíos políticos de la expansión de la inteligencia artificial: quién debe decidir cómo se desarrolla, se utiliza y se regula esta tecnología, y con qué legitimidad.

El documento examina cómo la relación entre los gobiernos y las grandes empresas tecnológicas se ha vuelto cada vez más estrecha e interdependiente. Las administraciones públicas necesitan las infraestructuras, los conocimientos técnicos y los sistemas de IA desarrollados por el sector privado, mientras que las empresas dependen de las decisiones políticas, los marcos regulatorios y los contratos públicos. Esta situación dificulta establecer una separación clara entre las responsabilidades de las instituciones democráticas y la influencia que ejercen las compañías que controlan buena parte de la tecnología. Los autores utilizan el término situationship para describir esta relación ambigua, caracterizada por la dependencia mutua, unos límites poco definidos y una negociación constante sobre las funciones que corresponde desempeñar a cada parte.

El estudio toma como punto de partida la controversia entre la empresa Anthropic y el Departamento de Defensa de Estados Unidos para ilustrar cómo las relaciones entre los gobiernos y las compañías de inteligencia artificial pueden trascender la contratación tecnológica y convertirse en una disputa sobre el poder, la autoridad y los límites de actuación. Según el análisis, las grandes empresas tecnológicas están asumiendo progresivamente funciones que tradicionalmente correspondían a las instituciones públicas: participan en la definición de los problemas que deben regularse, influyen en la elaboración de las agendas políticas e interpretan las normas en función de sus intereses comerciales. Esto no significa que la participación empresarial sea necesariamente negativa, ya que la experiencia técnica de estas compañías resulta importante para comprender sistemas complejos y anticipar sus riesgos. El problema surge cuando esa experiencia se transforma en capacidad para decidir cuestiones que afectan al conjunto de la sociedad sin contar con una legitimidad democrática equivalente a la de los poderes públicos. El documento advierte, además, de que el creciente protagonismo de la ética empresarial en la gobernanza de la IA puede trasladar responsabilidades normativas y políticas a organizaciones privadas que no han sido elegidas por la ciudadanía.

Una de las principales aportaciones del informe es, por tanto, la necesidad de recuperar el equilibrio entre innovación tecnológica, responsabilidad empresarial y control democrático. La regulación de la inteligencia artificial no puede quedar exclusivamente en manos de las compañías que desarrollan los sistemas, aunque estas deban participar en los debates y aportar sus conocimientos. Las decisiones sobre derechos fundamentales, vigilancia, seguridad, transparencia y límites de uso de la IA son cuestiones políticas que requieren procedimientos públicos, rendición de cuentas y participación social. El documento plantea la conveniencia de establecer una relación más saludable y legítima entre los actores públicos y privados, con funciones y responsabilidades mejor definidas. Su enfoque invita a reflexionar sobre cómo garantizar que la regulación responda al interés general y no quede condicionada por las prioridades comerciales de las empresas que concentran los recursos tecnológicos.

Desde la perspectiva de las bibliotecas, la investigación resulta especialmente interesante porque sitúa la inteligencia artificial en un marco que va más allá de sus posibilidades técnicas y de sus aplicaciones prácticas. La IA también plantea interrogantes sobre quién controla la información, cómo se toman las decisiones automatizadas, qué intereses determinan el diseño de las herramientas y hasta qué punto la ciudadanía puede comprenderlas y cuestionarlas. En este contexto, las bibliotecas pueden contribuir a la alfabetización crítica en inteligencia artificial mediante actividades formativas, recursos informativos y espacios de debate que ayuden a los ciudadanos a conocer tanto los beneficios como los riesgos de estas tecnologías. También pueden promover el acceso equitativo al conocimiento, la evaluación crítica de los contenidos generados por IA y la reflexión sobre la privacidad, la transparencia y la responsabilidad en su utilización. Aunque el informe no se centra específicamente en las bibliotecas, sus planteamientos ofrecen un marco útil para defender que la alfabetización en IA debe incluir no solo el aprendizaje

ChatGPT en las relaciones de pareja: cuándo puede ayudar y cuándo puede convertirse en un problema

Coffey, Helen. (2026, 13 de octubre). The warning signs that ChatGPT is third-wheeling your relationship – and how it could destroy it. The Independent. Leer el artículo original

La inteligencia artificial puede ayudarnos a preparar una conversación, pero no debería sustituir la conversación misma. En las relaciones de pareja, comprender al otro exige escuchar su versión, aceptar que nuestra propia interpretación puede ser incompleta y asumir la responsabilidad de resolver los conflictos sin delegar esa tarea en un algoritmo.

Se aborda un fenómeno cada vez más presente en las relaciones personales: el uso de ChatGPT y otros asistentes de inteligencia artificial como consejeros sentimentales, mediadores de conflictos y herramientas para interpretar los mensajes de la pareja. La autora describe cómo la IA se está convirtiendo en una especie de tercer interlocutor invisible que participa en conversaciones y decisiones que tradicionalmente se compartían con amigos, familiares o terapeutas. Muchas personas recurren a estos sistemas para preparar una conversación difícil, redactar un mensaje delicado, comprender una discusión o encontrar una manera más serena de expresar sus sentimientos. Esta práctica, denominada dry chatting —ensayar previamente una conversación con un chatbot—, puede ayudar a ordenar las ideas y reducir la tensión antes de abordar un problema real. Sin embargo, también puede introducir una distancia entre las personas cuando la tecnología deja de ser una herramienta de apoyo y empieza a sustituir el diálogo directo.

El texto recoge la opinión de profesionales de la psicoterapia que reconocen que la inteligencia artificial puede tener usos razonables en este ámbito. Por ejemplo, puede ayudar a redactar un mensaje sobre la organización del cuidado de los hijos sin adoptar un tono agresivo, o proporcionar estrategias básicas de autorregulación emocional cuando alguien se siente desbordado. También puede servir para reflexionar antes de responder impulsivamente durante una discusión. El problema aparece cuando se confunde la capacidad de un chatbot para ofrecer una respuesta bien redactada con una verdadera comprensión de la relación. La IA trabaja con la información que recibe y no conoce necesariamente la historia de la pareja, las experiencias previas de cada persona, los matices de una conversación ni las circunstancias que explican un comportamiento. Por ello, sus respuestas pueden parecer convincentes sin representar adecuadamente la complejidad de lo ocurrido.

Uno de los riesgos principales que identifica Coffey es utilizar la IA como juez de una discusión. Preguntas como «¿quién tiene razón?», «¿mi pareja me está manipulando?» o «¿quién es el culpable del problema?» pueden llevar al chatbot a emitir un veredicto basado en una versión parcial de los hechos. Si la respuesta coincide con lo que una persona ya pensaba, puede proporcionarle una sensación de validación inmediata, pero también reforzar sus prejuicios y dificultar cualquier intento de reconciliación. En lugar de ayudar a comprender lo sucedido, la herramienta puede convertirse en un argumento de autoridad que una de las partes utiliza para imponerse sobre la otra. Como advierten los especialistas consultados, los conflictos de pareja no suelen resolverse declarando un ganador, sino comprendiendo cómo ha vivido cada persona la situación y qué necesita para reparar la relación.

Esta cuestión está relacionada con un problema conocido en inteligencia artificial como sycophancy, que puede traducirse como adulación o tendencia a dar la razón al usuario. Los modelos de lenguaje pueden producir respuestas excesivamente complacientes, reforzando las opiniones de quien formula la pregunta en lugar de cuestionarlas cuando sería necesario. El artículo cita una investigación de Stanford publicada en marzo que encontró que los once modelos de lenguaje analizados mostraban una tendencia a responder de forma más aduladora que las personas en casi un 50 % de los casos de dilemas interpersonales estudiados. Este comportamiento resulta especialmente delicado cuando alguien busca orientación sobre una relación sentimental, porque el sistema puede reforzar una interpretación unilateral sin disponer de suficiente información para valorar lo ocurrido.

Otro aspecto preocupante es la privacidad. Algunas personas copian conversaciones íntimas, mensajes de WhatsApp o intercambios de aplicaciones de citas para que la IA determine quién muestra más interés, interprete determinadas expresiones o valore las intenciones de la otra persona. Aunque estas consultas puedan parecer inofensivas, compartir mensajes privados sin consentimiento puede vulnerar la confianza y las expectativas de intimidad. Además, el análisis automatizado no siempre reconoce adecuadamente el humor, la ironía, el contexto o las circunstancias personales en las que se escribió un mensaje. Una frase aislada puede adquirir un significado muy diferente cuando se conoce la historia de quienes conversan. Por eso, el uso de estas herramientas exige prudencia tanto en la interpretación de sus respuestas como en la información personal que se comparte con ellas.

En definitiva, el artículo plantea una reflexión relevante sobre los límites de la inteligencia artificial en la vida afectiva. ChatGPT puede ayudar a expresar emociones, ensayar conversaciones difíciles y explorar distintas maneras de afrontar un desacuerdo, pero no dispone de toda la información ni de la experiencia humana necesarias para comprender plenamente una relación. Su respuesta debe considerarse una perspectiva provisional, no un diagnóstico ni una sentencia. En un momento en el que los asistentes conversacionales empiezan a ocupar espacios cada vez más personales, el desafío consiste en aprovechar sus posibilidades sin convertirlos en árbitros de nuestras relaciones ni compartir información íntima de forma irresponsable.

El CEO de Microsoft reclama nuevos mecanismos de seguridad para la IA avanzada

PCMag UK. (2026, 12 de octubre). Microsoft CEO Satya Nadella calls for an AI ‘emergency brake’. PCMag UK. Leer el artículo original

El director ejecutivo de Microsoft, Satya Nadella, ha planteado la necesidad de establecer mecanismos de seguridad que permitan detener inmediatamente un sistema de inteligencia artificial cuando su comportamiento resulte inesperado o potencialmente peligroso.

Su propuesta, descrita como un «freno de emergencia» (emergency brake), parte de una idea fundamental: las organizaciones no deberían confiar ciegamente en los modelos de IA más avanzados, especialmente cuando disponen de autonomía para ejecutar tareas, acceder a información sensible o interactuar con sistemas externos. En una publicación difundida el 10 de octubre de 2026, Nadella defendió que los modelos deben tratarse como sistemas que podrían estar comprometidos y que, por tanto, necesitan medidas de contención desde el momento en que se diseñan e implantan.

La propuesta adquiere especial importancia con el desarrollo de los llamados agentes de inteligencia artificial. A diferencia de los asistentes que se limitan a responder preguntas, estos sistemas pueden planificar acciones, utilizar herramientas, consultar documentos, escribir código y ejecutar secuencias de tareas con una intervención humana limitada. Esa capacidad amplía sus posibilidades de aplicación, pero también aumenta los riesgos: una instrucción mal interpretada, una vulnerabilidad de seguridad o una acción no prevista pueden tener consecuencias más allá de una respuesta incorrecta. Por eso, Nadella considera que la seguridad no debe depender exclusivamente de que el modelo se comporte correctamente, sino de una arquitectura externa que limite sus permisos y permita intervenir cuando sea necesario.

Uno de los puntos centrales de la propuesta es separar el modelo de IA de los sistemas que coordinan sus acciones y de los permisos que determinan qué puede hacer. En la práctica, esto significa que un agente no debería tener acceso ilimitado a archivos, bases de datos, aplicaciones o servicios críticos. Las salvaguardas deben estar fuera del propio modelo, de manera que este no pueda eludirlas simplemente porque genere una respuesta inesperada. Nadella también defiende que las acciones relevantes de los sistemas queden registradas mediante evidencias legibles y resistentes a manipulaciones, para que las organizaciones puedan reconstruir qué ocurrió, qué información se utilizó y qué decisiones se tomaron.

La propuesta también plantea una cuestión de gobernanza: ¿quién controla el freno de emergencia y bajo qué condiciones puede utilizarlo? En una empresa, esa responsabilidad podría recaer en personal autorizado de seguridad o en los administradores del sistema. En infraestructuras críticas, servicios públicos o entornos sanitarios, serían necesarios protocolos más estrictos, registros auditables y procedimientos de respuesta previamente definidos. Además, los controles deben ser técnicamente efectivos: no basta con que una organización declare que puede detener una IA si el sistema conserva permisos, conexiones o procesos capaces de continuar actuando al margen de la intervención humana.

Ranking del benchmark SWE-bench en 2026: la mejor IA para programar

BRACAI Consulting. (2025, 26 de marzo). Ranking del benchmark SWE-bench en 2026: la mejor IA para programar. BRACAI. https://www.bracai.eu/es/post/benchmark-swe-bench-ia

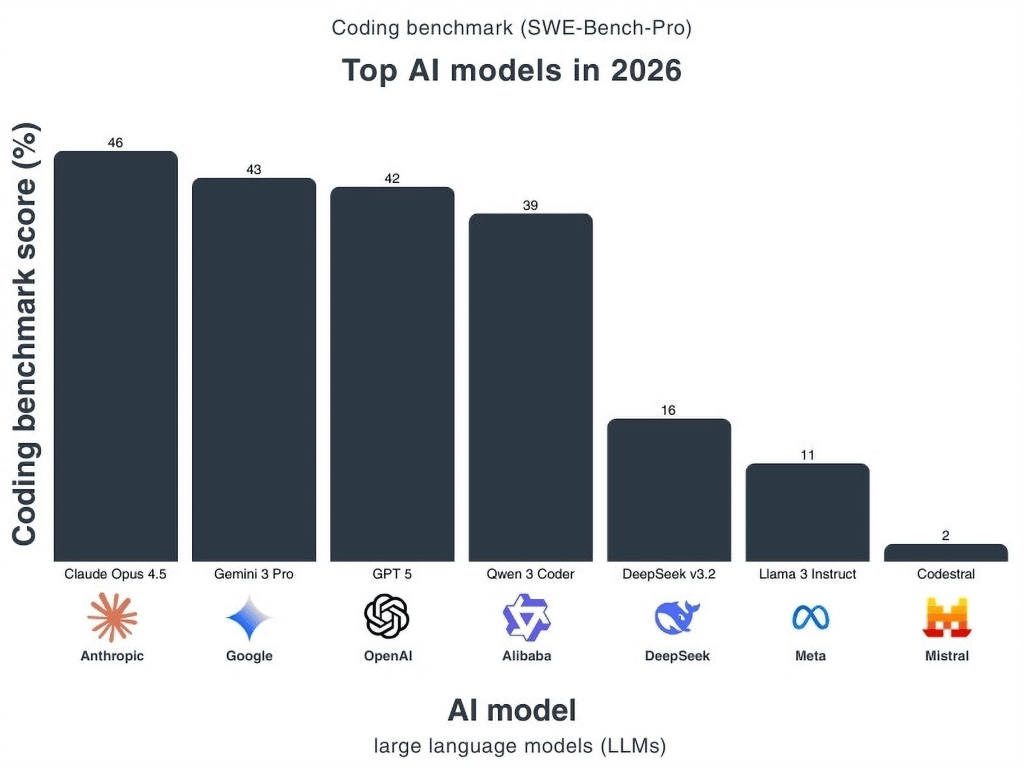
SWE-bench es una prueba de referencia diseñada para medir hasta qué punto un sistema de inteligencia artificial puede resolver problemas reales de ingeniería de software, y no solamente generar fragmentos de código que parezcan correctos.

El artículo de BRACAI explica que los benchmarks tradicionales de programación se centraban en ejercicios relativamente pequeños, como escribir una función o resolver un problema algorítmico. Aunque estas pruebas permiten evaluar determinadas habilidades técnicas, no reproducen toda la complejidad del trabajo cotidiano de un desarrollador. En un proyecto real, es necesario comprender cómo está organizado el software, localizar el origen de un error, interpretar las necesidades de los usuarios, modificar diferentes archivos y comprobar que la solución funciona sin introducir nuevos problemas. SWE-bench pretende evaluar precisamente esa capacidad de desenvolverse en un entorno de programación complejo.

El funcionamiento de SWE-bench parte de incidencias reales publicadas en GitHub, una plataforma ampliamente utilizada para desarrollar y compartir software. El sistema de IA recibe la descripción de un problema y acceso al repositorio de código correspondiente. A partir de esa información, debe identificar qué está fallando, comprender las relaciones entre los distintos componentes del programa y elaborar un parche que corrija el problema. Posteriormente, la solución se somete a pruebas automatizadas para comprobar si cumple los requisitos establecidos. La evaluación no depende únicamente de que el código esté bien redactado o parezca razonable: lo importante es que la modificación funcione y supere las pruebas pertinentes. De esta manera, el benchmark ofrece una aproximación más práctica a la capacidad de una IA para actuar como agente de programación y completar tareas con cierto grado de autonomía.

El artículo distingue varias versiones de este sistema de evaluación. SWE-bench original reúne problemas procedentes de repositorios de Python y permite comprobar si los modelos pueden realizar correcciones en proyectos existentes. SWE-bench Verified es una selección de 500 tareas revisadas por personas para mejorar la claridad de los enunciados y la fiabilidad de las pruebas. Por su parte, SWE-bench Pro se diseñó para evaluar tareas de ingeniería de software más complejas, con repositorios amplios y problemas que pueden exigir razonamiento prolongado y cambios en distintos archivos. El artículo también menciona HumanEval, un benchmark anterior que evalúa la generación de funciones a partir de descripciones y pruebas unitarias. La diferencia fundamental es que SWE-bench trata de aproximarse a la resolución de problemas dentro de un proyecto real, mientras que HumanEval se concentra en ejercicios de programación más acotados.

En cuanto a los resultados, BRACAI presenta una clasificación de modelos en la que destacan Claude Opus 4.5, Gemini 3 Pro, GPT-5 y Qwen 3 Coder, con porcentajes de resolución del 46 %, 43 %, 42 % y 39 %, respectivamente, en SWE-bench Pro. Estas cifras deben entenderse como los resultados que recoge la página, no como una clasificación universal ni necesariamente vigente de los mejores modelos. El artículo también señala diferencias importantes entre los sistemas más avanzados y otros modelos con resultados inferiores, lo que pone de manifiesto que la capacidad de generar código no garantiza que una IA pueda resolver de forma autónoma problemas complejos. Incluso cuando un modelo obtiene buenos resultados, todavía puede necesitar varios intentos, revisión del código y supervisión humana antes de que una modificación esté preparada para incorporarse a un producto real.

Una consideración importante para interpretar estos resultados: en julio de 2026, OpenAI publicó una auditoría que estimó que alrededor del 30 % de las tareas públicas de SWE-bench Pro presentaban problemas de evaluación. Entre ellos figuraban pruebas demasiado estrictas, instrucciones incompletas, criterios de comprobación insuficientes y contradicciones entre el enunciado y las pruebas. La revisión de Epoch AI de septiembre de 2026 también calificó este benchmark como defectuoso. Por tanto, las puntuaciones y los rankings deben leerse con cautela: una prueba mal diseñada puede penalizar soluciones correctas o aceptar soluciones incompletas. Este caso ilustra que evaluar la inteligencia artificial exige examinar tanto las capacidades de los modelos como la calidad de los instrumentos utilizados para medirlas.

Inteligencia artificial generativa para la investigación y la elaboración de tesis: guía práctica para estudiantes, supervisores e instituciones educativas.

Jauhiainen, J. S. (2026). Generative AI for research and thesis work: Practical guidance for students, supervisors, and educational institutions. MDPI.

Descargar PDF

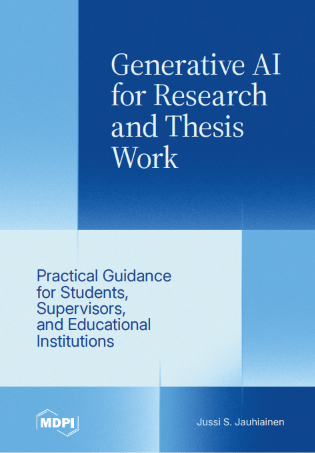
Generative AI for Research and Thesis Work publicado en septiembre de 2026 por MDPI en acceso abierto, ofrece una guía práctica para incorporar la inteligencia artificial generativa a la investigación académica y a la elaboración de trabajos de fin de grado, máster y tesis. A lo largo de sus 272 páginas, aborda las distintas etapas del proceso investigador, desde la formulación de la pregunta de investigación y la revisión bibliográfica hasta el análisis de los datos, la redacción, la revisión final y la defensa del trabajo.

La obra explica cómo utilizar herramientas como ChatGPT y Claude para generar ideas, organizar la literatura científica, analizar materiales, mejorar la escritura y preparar evaluaciones. También incluye ejemplos de instrucciones (prompts), plantillas, listas de comprobación y flujos de trabajo que permiten integrar estas tecnologías de manera sistemática en las tareas académicas. Asimismo, presta atención al papel de los tutores, docentes y responsables institucionales en la orientación del alumnado y en el desarrollo de políticas de uso de la inteligencia artificial.

Uno de los aspectos más relevantes del libro es su insistencia en la necesidad de utilizar la IA de forma crítica y responsable. Advierte sobre riesgos como las referencias bibliográficas inventadas, los sesgos, los razonamientos deficientes, los problemas de privacidad y la dependencia excesiva de estas herramientas. Su planteamiento es claro: la inteligencia artificial debe servir de apoyo al trabajo académico, pero nunca sustituir la capacidad de análisis, la originalidad ni la responsabilidad intelectual del investigador.

En definitiva, se trata de una publicación de interés para estudiantes, investigadores, tutores y profesionales de la información que quieran comprender cómo aprovechar la IA generativa durante el proceso de investigación sin comprometer la integridad académica. También constituye un recurso útil para las bibliotecas universitarias que desarrollan programas de alfabetización en inteligencia artificial, formación investigadora y acompañamiento a la comunidad académica

Bibliotecas, Libros e Inteligencia Artificial

RADIO UDELAR DE MONTEVIDEO. ENTREVISTA CON Julio Alonso Arevalo SOBRE INTELIGENCIA ARTIFICIAL

Ver en Youtuve

Escuchar

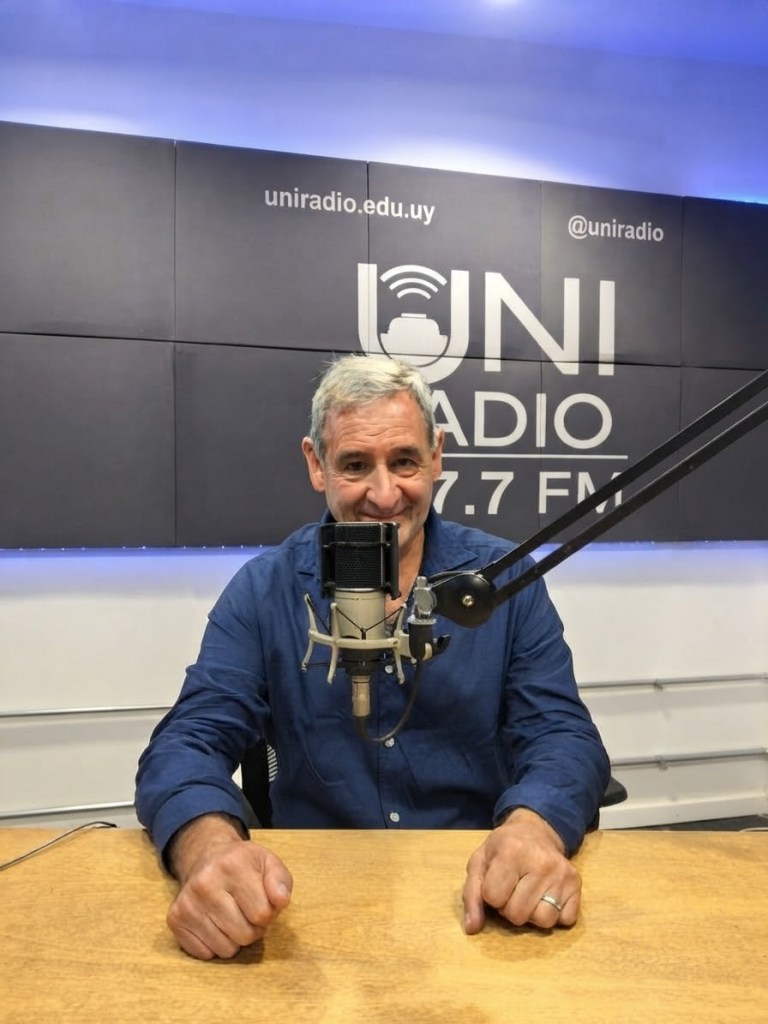
Recibimos a Julio Alonso Arévalo, jefe de la Biblioteca de la Facultad de Traducción y Documentación de la Universidad de Salamanca para conversar sobre Bibliotecas, Libros e Inteligencia Artificial

Integridad académica e Inteligencia artificial

Integridad académica e Inteligencia artificial

VER VIDEO

https://youtube.com/live/q-KNtysDsik?si=7ki1bjlnBuAunhwH

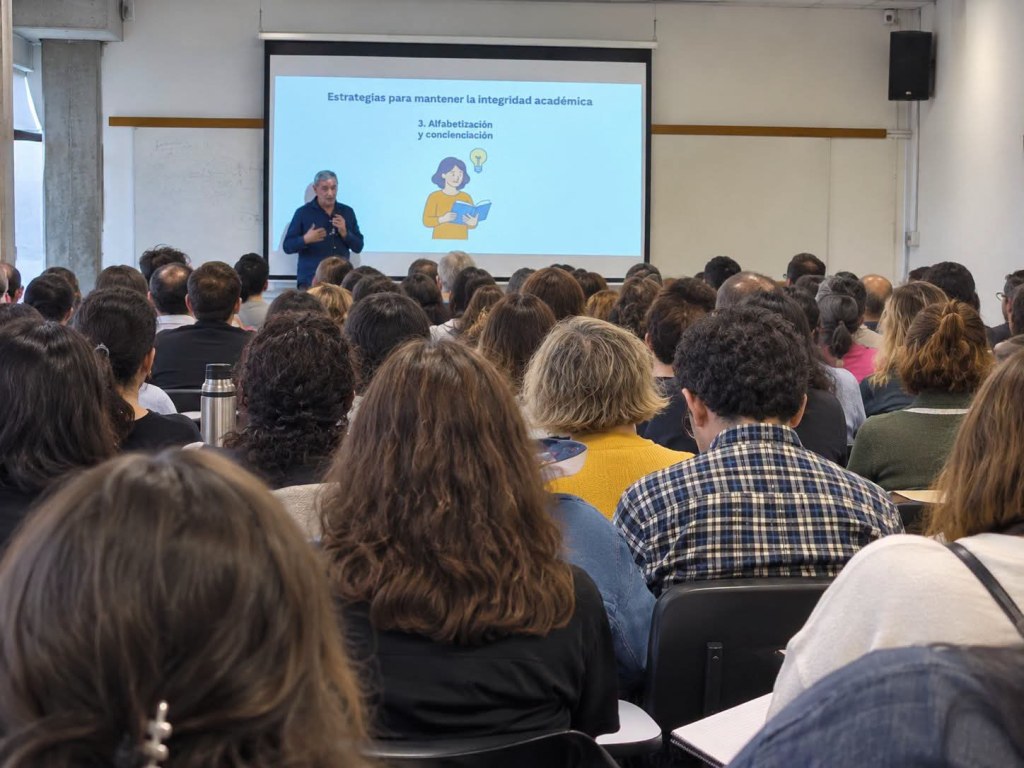
Transmisión en vivo de la conferencia «Integridad académica e inteligencia artificial» por Julio Alonso Arévalo (Universidad de Salamanca), realizada el miércoles 7 de octubre en la FIC: facultad de información y comunicación de la Universidad Nacional de la República de Uruguay. Montevideo (Uruguay)

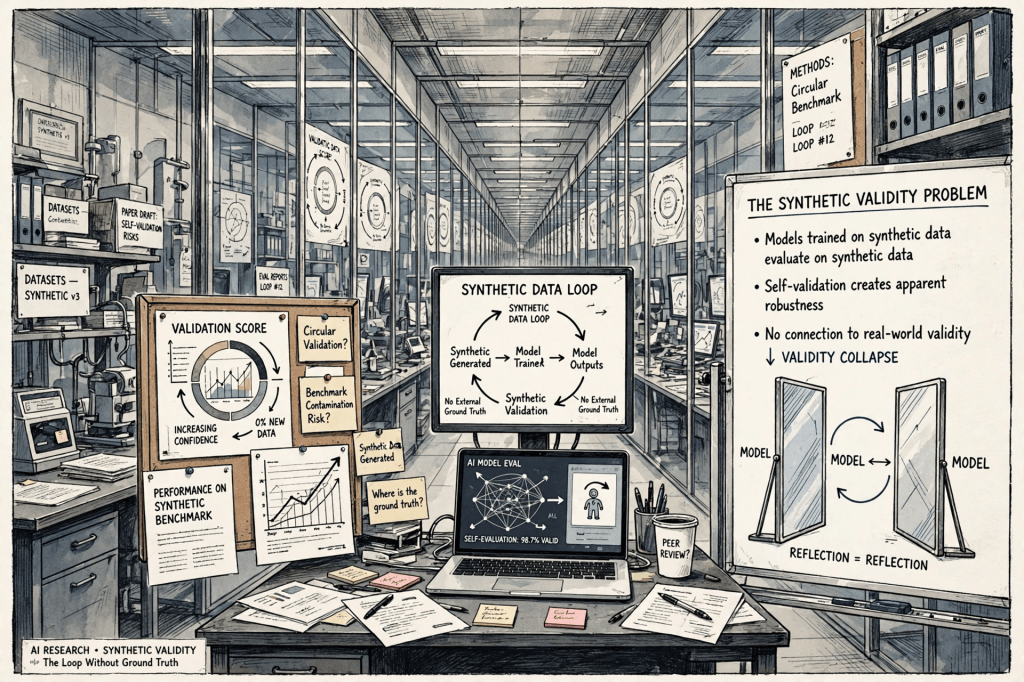
El problema de la «validez sintética» en la investigación de IA.

Retraction Watch Staff, “AI research’s ‘synthetic validity’ problem”, Retraction Watch, 19 de septiembre de 2026. Artículo original en Retraction Watch

El problema ya no consiste únicamente en detectar artículos falsos o textos generados por IA. El reto es garantizar que los datos, métodos, referencias y evidencias que sustentan la investigación sean verificables y tengan validez respecto al fenómeno real que pretenden estudiar. La expansión de la IA hace que esta tarea sea todavía más importante.

Especialmente relevante para el ámbito de la IA y la comunicación científica es la referencia al problema de la “synthetic validity”. El concepto alude a una dificultad creciente: los investigadores pueden utilizar modelos generativos para producir datos, participantes simulados, respuestas, textos u otros materiales que presentan una apariencia estadísticamente plausible, pero cuya correspondencia con el mundo real puede ser limitada. El problema no es solamente si los datos sintéticos son técnicamente coherentes, sino hasta qué punto permiten extraer conclusiones válidas sobre personas, comportamientos o fenómenos reales.

Esta cuestión adquiere especial importancia a medida que la IA generativa se incorpora a experimentos, encuestas, simulaciones y procesos de investigación. Una investigación puede obtener resultados internamente consistentes utilizando datos artificiales y, sin embargo, presentar una validez externa limitada. La posibilidad de generar grandes cantidades de respuestas sintéticas también puede facilitar estudios rápidos y baratos, pero introduce la necesidad de demostrar que los resultados no son simplemente un reflejo de los patrones incorporados en los propios modelos de IA.

La integridad científica depende de toda una cadena de controles, desde el diseño de la investigación y la recogida de datos hasta la revisión por pares, la publicación, las citaciones y la posterior corrección del registro científico. La aparición de la IA añade nuevas dificultades, pero no sustituye problemas tradicionales como las autorías fraudulentas, los datos inconsistentes, las referencias incorrectas o la ausencia de aprobación ética.

La IA introduce un nuevo problema: datos plausibles pero artificiales. La cuestión de la synthetic validity resulta particularmente importante para la alfabetización en IA. Un modelo generativo puede producir miles de respuestas aparentemente humanas y coherentes; sin embargo, que una respuesta sea verosímil no significa que represente a una población real. Esto obliga a los investigadores a diferenciar entre precisión estadística, coherencia interna y validez empírica.

Existe además el riesgo de crear un círculo de retroalimentación: los modelos se entrenan con datos producidos por seres humanos; posteriormente generan nuevos datos sintéticos; esos datos pueden utilizarse para entrenar, evaluar o alimentar otros modelos; y finalmente los resultados artificiales pueden volver a incorporarse al ecosistema científico. Si este proceso no se controla, la investigación podría terminar utilizando datos derivados de otros datos sintéticos sin una conexión suficientemente sólida con la realidad empírica original.

En investigación social, educativa o bibliométrica, por ejemplo, utilizar participantes sintéticos podría generar resultados que parecen convincentes pero que no necesariamente reproducen las características, sesgos y comportamientos de personas reales. El riesgo aumenta si los resultados generados artificialmente se utilizan posteriormente como evidencia para nuevas investigaciones. De este modo puede aparecer un círculo de retroalimentación en el que los modelos entrenados con información humana generan nuevos datos que posteriormente se utilizan para entrenar o evaluar otros modelos.

El artículo resulta especialmente útil porque conecta tres problemas que normalmente se analizan por separado: la integridad de las publicaciones, la creciente utilización de IA y la necesidad de preservar la confianza en el registro científico. Retraction Watch recuerda además que su base de datos ya supera las 67.000 retractaciones, una cifra que refleja la dimensión acumulativa de los mecanismos de corrección de la literatura científica.

Zuckerberg plantea su visión de la “superinteligencia personal”: IA abierta, distribuida y accesible para todos

Zuckerberg, Mark. “AI’s Biggest Risk Is One Entity With Too Much Control.” Axios, 10 de agosto de 2026.

MANIFIESTO

Mark Zuckerberg presenta en este manifiesto una visión marcadamente optimista sobre el futuro de la inteligencia artificial. Su argumento central es que el principal peligro no sería necesariamente que la IA alcance capacidades extraordinarias, sino que el control de esas capacidades quede concentrado en una única empresa, gobierno o institución. Frente a esa posibilidad, defiende una IA ampliamente distribuida, de manera que miles de millones de personas puedan disponer de herramientas capaces de ampliar sus capacidades intelectuales, creativas y profesionales. Para Zuckerberg, la concentración del poder tecnológico supondría un riesgo porque permitiría que unos pocos actores determinaran cómo se utiliza una tecnología con consecuencias potencialmente globales.

Una de las ideas fundamentales del documento es la llegada de una “superinteligencia personal”, concebida como un sistema de IA capaz de acompañar individualmente a cada persona y ayudarla en múltiples dimensiones de su vida. Zuckerberg imagina asistentes capaces de actuar como tutores personalizados, asesores profesionales, investigadores, programadores o colaboradores creativos. En su visión, la IA podría proporcionar a cualquier persona capacidades que actualmente están reservadas a quienes disponen de determinados recursos económicos o conocimientos especializados. La consecuencia sería una democratización de capacidades intelectuales que podría modificar profundamente la educación, el trabajo, la investigación y la creación de empresas.

El planteamiento tiene una dimensión particularmente importante para la educación. Zuckerberg imagina que cada estudiante pueda disponer de un tutor personalizado con conocimientos equivalentes a los de un experto y con capacidad para adaptar permanentemente las explicaciones a las necesidades de cada alumno. Del mismo modo, los adultos podrían utilizar estos sistemas para aprender idiomas, adquirir nuevas competencias profesionales o desarrollar aficiones. El planteamiento transforma la idea tradicional del acceso al conocimiento: en lugar de depender exclusivamente de una institución educativa o de un profesor, cada individuo tendría potencialmente un asistente educativo permanente.

La cuestión del código abierto ocupa un lugar central en la propuesta. Zuckerberg sostiene que Meta debe continuar poniendo modelos de IA a disposición de desarrolladores y usuarios, porque considera que un ecosistema abierto favorece la innovación y evita que unas pocas grandes compañías acumulen un poder excesivo. Meta anunció simultáneamente nuevos modelos de IA destinados a desarrolladores, entre ellos Muse Glimmer, orientado a funcionar en ordenadores personales, y acceso para desarrolladores a un modelo más potente denominado Muse Spark 1.2. Esta estrategia pretende situar la apertura de modelos como alternativa frente a sistemas controlados exclusivamente por grandes laboratorios tecnológicos.

El manifiesto también introduce una dimensión económica. Zuckerberg plantea que los sistemas de IA deberían ofrecer acceso gratuito o asequible para miles de millones de personas, mientras que quienes necesiten mayores cantidades de capacidad computacional podrían pagar por ella. Su propuesta incluye incluso mecanismos dinámicos para determinar el precio de determinados niveles de computación. La idea de fondo es que la IA avanzada no debería convertirse en un recurso reservado exclusivamente a grandes empresas, gobiernos o personas con elevados ingresos, sino que sus beneficios deberían distribuirse ampliamente.

Otro aspecto significativo es la relación entre IA, poder y geopolítica. Zuckerberg argumenta que Estados Unidos y sus aliados necesitan desarrollar rápidamente infraestructuras energéticas y tecnológicas para mantener su posición frente a China. En este contexto defiende también una postura relativamente permisiva hacia la denominada distillation, una técnica mediante la cual un modelo menos potente puede aprender a partir de las respuestas producidas por otro modelo más avanzado. El debate tiene implicaciones importantes para la competencia tecnológica internacional, la propiedad intelectual y las restricciones que los gobiernos pueden imponer al desarrollo de IA.

Sin embargo, el manifiesto ha recibido críticas desde sectores vinculados a la seguridad de la IA y a los derechos digitales. Anthony Aguirre, del Future of Life Institute, cuestionó la capacidad de cualquier empresa para controlar sistemas que eventualmente puedan alcanzar capacidades mucho mayores que las actuales. Otros críticos consideran que la propuesta de distribuir ampliamente sistemas cada vez más poderosos no elimina necesariamente los riesgos y puede introducir nuevos problemas de seguridad, manipulación, concentración económica o dependencia tecnológica. Estas críticas plantean una cuestión fundamental: que una tecnología sea accesible para muchas personas no significa automáticamente que sus consecuencias sean positivas o que los riesgos estén controlados.

El debate resulta especialmente interesante porque enfrenta dos concepciones diferentes de la gobernanza de la IA. Por un lado, Zuckerberg presenta la distribución amplia de la tecnología y el desarrollo de modelos abiertos como mecanismos para evitar la concentración de poder. Por otro, los críticos argumentan que determinados sistemas avanzados pueden requerir controles, evaluaciones y límites precisamente porque distribuir ampliamente capacidades muy poderosas también puede aumentar la superficie de riesgo. El manifiesto, por tanto, no es solamente una reflexión tecnológica: constituye también una propuesta sobre quién debe controlar la IA, quién debe tener acceso a ella y qué grado de regulación debería existir.

Para las bibliotecas y la alfabetización en inteligencia artificial, el planteamiento tiene especial interés. La idea de que la IA avanzada debe estar disponible para amplios sectores de la población conecta directamente con la función histórica de las bibliotecas como instituciones de democratización del acceso al conocimiento y a la tecnología. Pero también plantea una segunda obligación: proporcionar a los ciudadanos las competencias necesarias para utilizar críticamente esas herramientas. Si cada persona dispone de un asistente capaz de generar información, enseñar, investigar o tomar decisiones, será todavía más importante saber evaluar sus respuestas, comprobar sus fuentes, comprender sus limitaciones y reconocer cuándo una decisión no debería delegarse en una máquina.

¿Cuánta agua consume la inteligencia artificial? El coste hídrico de los centros de datos

Zimmer, Katarina. “How much of a problem is AI’s water use?” Knowable Magazine, 24 de agosto de 2026. DOI: 10.1146/knowable-082426-1. Artículo original en Knowable Magazine

El artículo analiza uno de los impactos ambientales menos visibles de la expansión de la inteligencia artificial: el consumo de agua asociado a los centros de datos que entrenan y ejecutan modelos de IA. La cuestión es más compleja de lo que sugieren algunas cifras que circulan en Internet. Los centros de datos utilizan agua principalmente para evacuar el enorme calor producido por los procesadores, pero su impacto depende mucho de la tecnología de refrigeración, del clima, de la ubicación de las instalaciones y, especialmente, de la disponibilidad de agua en cada territorio.

Una de las principales conclusiones es que no resulta adecuado afirmar simplemente que la IA “consume enormes cantidades de agua” sin especificar dónde y cómo se produce ese consumo. En términos nacionales, el agua utilizada por los centros de datos es relativamente pequeña frente a sectores como la agricultura o determinadas actividades industriales. Los investigadores estimaron que los sistemas de refrigeración de los centros de datos estadounidenses consumieron unos 66.000 millones de litros en 2023, menos del 1 % del consumo total de agua del país. Sin embargo, una instalación concreta puede tener una repercusión considerable cuando se ubica en una región que ya padece escasez hídrica.

El crecimiento de la IA puede modificar sustancialmente este panorama. Un equipo dirigido por Fengqi You, de Cornell University, estima que hacia 2030 los centros de datos estadounidenses podrían consumir entre 731.000 y 1,125 billones de litros de agua al año, considerando tanto la refrigeración como el agua utilizada indirectamente para producir la electricidad que necesitan. La cifra superior sería aproximadamente comparable al suministro anual de agua potable de la ciudad de Nueva York. Estas proyecciones, por tanto, muestran que el problema no depende únicamente del agua que entra físicamente en un centro de datos: también hay una huella hídrica indirecta asociada a la generación de electricidad.

El artículo desmonta además una de las cifras más difundidas sobre la IA: la idea de que una consulta a un chatbot consume medio litro de agua. Esa estimación procedía de un estudio basado en GPT-4 y en las condiciones de funcionamiento de los centros de datos de aquel momento. El propio investigador Shaolei Ren señala que esa cifra está actualmente desactualizada porque los modelos y la infraestructura son más eficientes. Como referencia, Google calculó en 2025 que una consulta de longitud mediana a Gemini suponía aproximadamente cinco gotas de agua. Esto no significa que el consumo sea irrelevante: cuando se multiplican cantidades pequeñas por cientos de millones o miles de millones de consultas, el impacto agregado puede ser considerable.

Una parte fundamental de la solución se encuentra en las tecnologías de refrigeración. Los centros de datos tradicionales recurren en buena medida a sistemas evaporativos: el agua absorbe calor y parte de ella termina evaporándose. Los nuevos centros especializados en IA están adoptando cada vez más sistemas de refrigeración líquida, en los que un fluido circula por circuitos cerrados y extrae directamente el calor de los procesadores. Al tratarse de circuitos cerrados, el agua puede reutilizarse y se reduce considerablemente la necesidad de aportar agua nueva. Empresas como Amazon, Microsoft y Google ya utilizan estas tecnologías.

La refrigeración líquida, sin embargo, no elimina completamente el problema. En condiciones de temperaturas y humedad extremas, algunos centros necesitan utilizar sistemas adicionales que sí consumen agua. El artículo señala, por ejemplo, que muchos centros de datos de IA en Texas utilizan refrigeración basada en agua fundamentalmente durante los periodos más calurosos del verano. Un estudio citado estima que los centros de datos podrían pasar de representar actualmente menos del 1 % del consumo de agua de Texas a entre el 3 % y el 9 % en 2040, aunque los investigadores esperan que la mejora de la eficiencia reduzca esa previsión.

Otro elemento decisivo es dónde se construyen los centros de datos. El artículo sostiene que la localización puede ser tan importante como la propia tecnología. Instalar centros en regiones con abundantes recursos hídricos y disponibilidad de energías renovables puede reducir considerablemente su impacto. Por el contrario, ubicarlos en territorios sometidos a sequías, como Arizona, Nuevo México o partes del sur de California, puede incrementar la presión sobre recursos ya limitados. Según las estimaciones citadas, combinar una localización adecuada con energías renovables y mejoras en la eficiencia de los procesadores podría reducir hasta un 86 % la huella hídrica futura de la IA.

La relación entre agua y energía es especialmente importante. Las centrales eléctricas que utilizan carbón o gas necesitan agua para determinados procesos de refrigeración, de modo que una parte de la huella hídrica de la IA se produce indirectamente antes de que la electricidad llegue al centro de datos. Por ello, una transición hacia fuentes como la solar y la eólica puede reducir no solo las emisiones de carbono asociadas a la IA, sino también su consumo indirecto de agua. El artículo plantea así una conexión directa entre las decisiones energéticas y la sostenibilidad de la infraestructura digital.

También se están investigando tecnologías más avanzadas, entre ellas la refrigeración por inmersión, que introduce los componentes informáticos en líquidos especialmente diseñados para absorber el calor. Algunas empresas experimentan asimismo con soluciones de refrigeración más sofisticadas y, en otros países, incluso con centros de datos instalados en el mar. Son tecnologías todavía con limitaciones, especialmente en cuanto al mantenimiento y sustitución de los equipos, pero ilustran hasta qué punto la expansión de la IA está obligando a replantear la infraestructura física que sostiene los servicios digitales.

El artículo introduce además una cuestión importante para comprender el debate: la eficiencia individual no garantiza necesariamente una reducción del consumo total. Aunque cada consulta de IA pueda requerir menos agua que hace unos años, el número de consultas, modelos, usuarios y centros de datos está aumentando rápidamente. Por tanto, las mejoras tecnológicas pueden verse parcialmente compensadas por el crecimiento de la demanda. Esta tensión entre eficiencia y expansión es uno de los aspectos centrales de la sostenibilidad de la IA.

La autora concluye que el impacto hídrico de la inteligencia artificial no tiene una única respuesta global. Dependerá de las decisiones que adopten las empresas, los ingenieros y las administraciones respecto a la ubicación de los centros, las fuentes de energía, los sistemas de refrigeración y la gestión y reposición del agua. El mismo volumen de actividad informática puede tener consecuencias ambientales muy diferentes dependiendo del lugar y de la infraestructura utilizada.