Archivo de la etiqueta: Inteligencia artificial

Guía sobre el uso de licencias CC en un ecosistema de IA: orientaciones para compartir y reutilizar contenidos

Creative Commons. (2026). Guidance on CC Licensing in the Age of AI. Zenodo. https://doi.org/10.5281/zenodo.22261032

Descargar

El documento hace una reflexión sobre la gobernanza del conocimiento en la era de la IA a través de las licencias Creative Commons, que siguen siendo una infraestructura fundamental para compartir información, pero deben complementarse con políticas de atribución, transparencia y responsabilidad institucional. Para las bibliotecas universitarias, esta perspectiva resulta especialmente pertinente: su función no es solo facilitar el acceso a los contenidos, sino también ayudar a comprender los derechos, las condiciones de reutilización y las implicaciones éticas de las tecnologías que transforman la circulación del conocimiento.

La Guía analiza la vigencia de las licencias abiertas en un contexto marcado por el desarrollo de la inteligencia artificial generativa y el uso masivo de contenidos digitales para entrenar modelos, generar respuestas y producir nuevos materiales. El documento examina cómo estas tecnologías plantean nuevos desafíos para los derechos de autor, la atribución de las obras y el control sobre su reutilización. Su principal conclusión es que las licencias Creative Commons siguen siendo herramientas válidas y necesarias, aunque es importante comprender sus posibilidades y limitaciones en el ecosistema actual de la inteligencia artificial.

Creative Commons mantiene su recomendación de utilizar la licencia más flexible que se ajuste a los objetivos de cada autor o institución. Estas licencias permiten establecer condiciones para compartir y reutilizar obras, como reconocer la autoría, limitar determinados usos comerciales o exigir que las obras derivadas se distribuyan bajo condiciones equivalentes. Sin embargo, no garantizan un control absoluto sobre todos los usos de los contenidos. En función de la legislación aplicable, algunas actividades de análisis automatizado o entrenamiento de sistemas de inteligencia artificial pueden estar amparadas por excepciones y limitaciones al derecho de autor. Por ello, utilizar una licencia más restrictiva no implica necesariamente que una obra quede excluida de todos los procesos de entrenamiento de modelos de IA.

El documento destaca que la expansión de la inteligencia artificial no debería conducir a un retroceso generalizado del conocimiento abierto. Las licencias Creative Commons han facilitado durante años la circulación de publicaciones científicas, recursos educativos, materiales culturales y otros contenidos que favorecen la investigación, la enseñanza y la innovación. Restringir indiscriminadamente estos recursos por temor a su utilización por sistemas de IA podría perjudicar también a investigadores, docentes, estudiantes, bibliotecas y ciudadanos. El verdadero desafío consiste en encontrar un equilibrio entre la apertura del conocimiento, los derechos de los creadores y la necesidad de promover un uso transparente y responsable de los contenidos por parte de las empresas tecnológicas.

En este contexto, Creative Commons impulsa iniciativas complementarias como CC Signals, orientadas a ofrecer nuevas formas de comunicar preferencias y expectativas sobre la utilización de contenidos y datos en sistemas de inteligencia artificial. Esta propuesta pretende ampliar las posibilidades de decisión de autores e instituciones sin sustituir automáticamente las licencias tradicionales. La iniciativa responde a la necesidad de abordar cuestiones que las licencias de derechos de autor no resuelven por sí solas, como la falta de transparencia en el entrenamiento de modelos, las dificultades para garantizar la atribución de las fuentes y la distribución del valor económico generado mediante la reutilización de contenidos.

Para las bibliotecas, universidades y centros de investigación, estas orientaciones tienen importantes implicaciones prácticas. Las instituciones deben revisar sus políticas de publicación y depósito en repositorios, comprobar que disponen de los derechos necesarios para licenciar los materiales y explicar claramente las condiciones de reutilización de sus colecciones. También resulta fundamental formar a investigadores y usuarios en materia de propiedad intelectual, licencias abiertas y uso responsable de la inteligencia artificial. En el ámbito de la ciencia abierta, la disponibilidad de publicaciones y datos puede favorecer nuevas formas de análisis e investigación, siempre que se respeten los derechos aplicables y se promuevan prácticas adecuadas de atribución y transparencia.

Creative Commons defiende que el futuro del conocimiento abierto no pasa necesariamente por restringir el acceso a los contenidos, sino por mejorar las condiciones en las que estos se comparten y reutilizan. Las licencias existentes siguen siendo esenciales, pero deben complementarse con nuevas herramientas, políticas institucionales y principios de responsabilidad que respondan a los desafíos de la inteligencia artificial. Para las bibliotecas universitarias, esto supone reforzar su papel como garantes del acceso a la información y como agentes de alfabetización jurídica y digital, ayudando a la comunidad a comprender no solo cómo acceder al conocimiento, sino también qué derechos existen sobre él, cómo puede reutilizarse y qué implicaciones éticas plantea su incorporación a sistemas de IA.

Reducir la brecha en inteligencia artificial: un marco colaborativo para la alfabetización crítica en IA en las bibliotecas públicas

Kim, Minseo, y Shelby Kruger. (2026, 12 de octubre). Bridging the AI Divide: A Collaborative Framework for Critical AI Literacy in Public Libraries Póster presentado en el World Library and Information Congress (WLIC) de la International Federation of Library Associations and Institutions (IFLA). Colección WLIC Posters.

Ver

Bridging the AI Divide presenta una propuesta de interés para avanzar hacia una alfabetización crítica en inteligencia artificial desde las bibliotecas públicas. Su principal aportación consiste en vincular la formación tecnológica con la equidad digital, la colaboración institucional y la evaluación sistemática de las necesidades de los usuarios. El proyecto subraya que reducir la brecha en IA exige algo más que proporcionar dispositivos o acceso a herramientas: requiere crear oportunidades de aprendizaje que permitan comprender estas tecnologías, utilizarlas de forma responsable y valorar sus efectos sobre la sociedad

La expansión de la inteligencia artificial generativa está transformando profundamente el entorno informativo y plantea nuevos desafíos para la alfabetización digital, la inclusión social y el acceso equitativo al conocimiento. En este contexto, las bibliotecas públicas pueden desempeñar un papel esencial para garantizar que todas las personas tengan oportunidades de comprender y utilizar estas tecnologías, independientemente de su edad, formación académica, nivel de competencia digital o situación socioeconómica. El trabajo de Minseo Kim y Shelby Kruger presenta un marco de colaboración entre instituciones académicas y bibliotecas públicas destinado a desarrollar un programa básico de alfabetización en inteligencia artificial dirigido a personas adultas. La propuesta parte de una premisa fundamental: la democratización de la IA no consiste únicamente en facilitar el acceso a las herramientas tecnológicas, sino también en proporcionar los conocimientos necesarios para comprender su funcionamiento, evaluar críticamente sus resultados y reconocer sus implicaciones sociales, éticas y culturales.

La iniciativa se desarrolla mediante una colaboración entre la Community Workshop Series (CWS) de la Escuela de Ciencias de Datos e Información de la Universidad de Carolina del Norte en Chapel Hill (UNC SDIS) y dos bibliotecas públicas de su entorno. Esta cooperación permite combinar la experiencia académica en inteligencia artificial y ciencias de la información con la proximidad, la capacidad de mediación y el conocimiento de las necesidades de la comunidad que caracterizan a las bibliotecas públicas. El objetivo es diseñar una propuesta formativa accesible que acerque la inteligencia artificial a personas que pueden no tener experiencia previa con estas tecnologías. En lugar de abordar la IA exclusivamente desde una perspectiva técnica, el programa pretende hacerla comprensible, relacionarla con situaciones cotidianas y ofrecer herramientas para que los participantes puedan utilizarla con mayor autonomía y criterio. El modelo reconoce así a la biblioteca pública como un espacio de aprendizaje permanente, participación ciudadana e inclusión digital.

El programa formativo se centra en dos dimensiones complementarias: la familiarización práctica con la inteligencia artificial y el desarrollo de una conciencia crítica sobre sus posibilidades y limitaciones. La primera busca reducir las barreras de entrada, favorecer la confianza de los participantes y ayudarles a comprender cómo pueden utilizar estas herramientas en diferentes actividades. La segunda pretende que las personas no se limiten a aceptar las respuestas generadas por los sistemas de IA, sino que aprendan a cuestionarlas, comprobar la información, identificar posibles errores y reflexionar sobre las consecuencias de su utilización. Esta perspectiva crítica resulta especialmente importante ante problemas como la desinformación, los sesgos algorítmicos, la privacidad, la transparencia y las desigualdades en el acceso a los beneficios de la tecnología. La alfabetización en IA se plantea, por tanto, como una competencia ciudadana que combina conocimientos prácticos, pensamiento crítico y comprensión de las repercusiones sociales de los sistemas automatizados.

Un aspecto destacado del proyecto es la evaluación de sus resultados mediante una encuesta posterior a los talleres realizados en la primavera de 2026. El instrumento utiliza una escala de Likert de cinco puntos para comparar la confianza que los participantes manifiestan respecto a la inteligencia artificial antes y después de la formación. Además de medir los cambios en la percepción de sus propias capacidades y en su autoeficacia, la evaluación examina su comprensión de las cuestiones éticas relacionadas con estas tecnologías y su valoración de la accesibilidad del apoyo educativo recibido. La investigación incorpora también comentarios cualitativos que permiten identificar los contenidos en los que los participantes se sienten más capacitados, las dificultades que persisten y las necesidades formativas que van surgiendo en la comunidad. La combinación de indicadores cuantitativos y testimonios cualitativos ofrece una perspectiva más completa que la mera contabilización de asistentes, ya que permite explorar tanto la evolución de la confianza como la experiencia de aprendizaje y las expectativas de los usuarios. No obstante, el resumen disponible describe el diseño de evaluación, pero no proporciona cifras concretas sobre la participación ni resultados estadísticos que permitan cuantificar el impacto del programa.

La evaluación se integra en una concepción dinámica de la formación. Los autores no consideran el currículo como un material cerrado que deba reproducirse de manera idéntica en todos los contextos, sino como un recurso educativo que puede revisarse y adaptarse continuamente. Las respuestas de los participantes permiten reconocer qué contenidos requieren mayor explicación, qué cuestiones éticas generan más dudas y qué apoyos necesitan las personas para utilizar las herramientas con seguridad y autonomía. Este enfoque favorece una formación sensible a la diversidad de experiencias, expectativas y niveles de competencia digital de la población adulta. Asimismo, permite que las bibliotecas adapten los talleres a las necesidades reales de sus comunidades y que la cooperación con las instituciones académicas se mantenga más allá de una actividad puntual. El proyecto propone así un proceso de mejora continua basado en la evaluación, la escucha activa y la actualización de los contenidos educativos.

Desde una perspectiva institucional, la colaboración entre universidades y bibliotecas públicas constituye uno de los elementos más relevantes de la experiencia. Las universidades pueden aportar conocimientos especializados, recursos didácticos y capacidad de evaluación, mientras que las bibliotecas proporcionan espacios accesibles, contacto directo con los ciudadanos y experiencia en programas de alfabetización informacional y digital. Esta relación permite acercar conocimientos especializados a sectores de la población que podrían encontrar mayores dificultades para acceder a cursos tecnológicos convencionales. También refuerza la función social de las bibliotecas públicas como agentes que contribuyen a reducir las brechas digitales y a promover una participación más informada en una sociedad cada vez más condicionada por los sistemas de inteligencia artificial. Para que este modelo pueda consolidarse, resulta importante mantener la formación del personal bibliotecario, disponer de materiales actualizados, garantizar recursos suficientes y evaluar periódicamente tanto los aprendizajes como la capacidad de llegar a colectivos diversos.

Las grandes editoriales incorporan la inteligencia artificial en secreto mientras crece la resistencia de sus trabajadores

Morgan, Adam. (9 de octubre de 2026). “Book Publishers Are Quietly Using More AI. Staff Are Revolting”. WIRED. https://www.wired.com/story/book-publishers-are-quietly-using-more-ai-staff-are-revolting/

Se plantea una contradicción creciente en la industria editorial estadounidense: mientras algunas grandes editoriales adoptan públicamente una postura crítica frente al uso de la inteligencia artificial generativa en la creación de libros, internamente están incorporando herramientas de IA en numerosas tareas de producción, comunicación y comercialización.

Según la investigación de WIRED, basada en entrevistas con más de dos docenas de trabajadores del sector que hablaron bajo condición de anonimato, tres grandes grupos editoriales —HarperCollins, Simon & Schuster y Hachette— están utilizando modelos de lenguaje como ChatGPT y Claude en distintos procesos de trabajo, en ocasiones sin informar suficientemente a los autores ni contar con su consentimiento explícito. La cuestión no se limita, por tanto, a si un escritor emplea IA para redactar una novela, sino que afecta también a la forma en que las propias empresas editoriales producen, promocionan y distribuyen los libros.

Uno de los usos más extendidos de estas herramientas es la generación de textos promocionales. Los modelos de IA se emplean para redactar materiales publicitarios, descripciones de libros, textos de contraportada y mensajes dirigidos a agentes literarios, libreros, periodistas y otros profesionales. También se han utilizado para preparar correos electrónicos de rechazo de manuscritos, elaborar materiales de marketing, producir vídeos promocionales e intervenir en el diseño de cubiertas. Estas aplicaciones muestran que la IA está penetrando en tareas que, aunque no siempre forman parte de la escritura literaria propiamente dicha, requieren conocimiento del contexto cultural, sensibilidad editorial y capacidad para establecer relaciones profesionales. Algunos trabajadores consideran que automatizar estas comunicaciones puede deteriorar la calidad de las relaciones con autores y agentes, además de generar textos impersonales, repetitivos y fácilmente reconocibles como producidos por una máquina.

La situación resulta especialmente significativa porque las editoriales mantienen una relación ambivalente con la creación asistida por IA. Por un lado, algunas han cancelado publicaciones de obras cuyos autores fueron acusados de utilizar modelos de lenguaje, mientras que, por otro, recurren a tecnologías similares para optimizar sus propios procesos. El artículo recuerda que varios casos de libros cuestionados por un posible uso de IA han provocado controversias públicas, pero sostiene que la utilización de estas herramientas dentro de las empresas constituye una transformación menos visible. Esta asimetría plantea interrogantes sobre la coherencia de las políticas editoriales: ¿con qué criterios se juzga el uso de la inteligencia artificial por parte de un autor si las propias editoriales la emplean en actividades relacionadas con la producción y difusión de sus obras? La cuestión central es la necesidad de establecer normas transparentes y aplicables tanto a los escritores como a las organizaciones que publican sus trabajos.

Una de las principales preocupaciones es el impacto de la automatización sobre el empleo. El artículo describe plantillas reducidas por sucesivas rondas de despidos y profesionales que deben asumir el doble o el triple de publicaciones con menos recursos. En este contexto, la IA puede presentarse como una solución para aumentar la productividad, pero también puede consolidar una dinámica en la que las empresas sustituyan puestos de trabajo, intensifiquen las cargas laborales y conviertan la automatización en una exigencia organizativa. La oposición de los trabajadores no responde únicamente al rechazo de una tecnología nueva: también expresa el temor a perder autonomía profesional, control sobre los procesos editoriales y oportunidades de empleo. El conflicto se hizo especialmente visible en Simon & Schuster, donde empleados promovieron una carta abierta contra la posible incorporación de Skan AI, una plataforma destinada a analizar flujos de trabajo y detectar oportunidades de automatización. La plantilla temía que estas herramientas sirvieran para vigilar su actividad y facilitar futuras sustituciones de trabajadores.

Otro de los aspectos más delicados es la protección de los manuscritos inéditos. Los agentes literarios entrevistados manifiestan su preocupación por la posibilidad de que las editoriales introduzcan textos completos o fragmentos de obras todavía no publicadas en modelos de lenguaje para generar resúmenes, materiales promocionales o comunicaciones editoriales. Si se utilizan servicios externos sin garantías adecuadas, pueden surgir dudas sobre la confidencialidad de los documentos, su tratamiento por parte de los proveedores tecnológicos y el control de los autores sobre sus creaciones. Algunos agentes han empezado a incluir cláusulas contractuales que prohíben procesar determinados materiales mediante modelos de lenguaje. El artículo distingue, además, entre sistemas que funcionan en entornos cerrados y herramientas conectadas a servicios externos, una diferencia relevante para evaluar los riesgos de privacidad y seguridad. La cuestión resulta especialmente importante en el sector editorial, donde los manuscritos inéditos constituyen activos intelectuales cuyo valor depende, entre otros factores, de mantener el control sobre su circulación.

La traducción literaria constituye otro ámbito de transformación. El artículo señala que algunos profesionales han observado manuscritos traducidos mediante modelos de lenguaje y presentados en ferias internacionales del libro con indicaciones sobre el uso de IA. Para las editoriales, estas herramientas podrían reducir costes y facilitar la publicación de más títulos en diferentes idiomas, ampliando la circulación internacional de las obras. Sin embargo, la traducción literaria no consiste únicamente en trasladar palabras de una lengua a otra: exige interpretar referencias culturales, reproducir voces narrativas, resolver ambigüedades y tomar decisiones estilísticas. La expansión de la traducción automatizada plantea, por ello, preguntas sobre la calidad de los textos, el reconocimiento de los traductores y la remuneración de su trabajo. El debate enfrenta dos prioridades: la búsqueda empresarial de eficiencia y la defensa del conocimiento especializado que aportan los profesionales humanos.

El artículo presenta una industria editorial sometida a una tensión entre la búsqueda de eficiencia económica y la defensa del trabajo creativo y profesional. La inteligencia artificial puede modificar profundamente la producción, la promoción y la distribución de libros, pero su incorporación sin transparencia ni participación de los afectados amenaza con debilitar la confianza que sostiene las relaciones entre editoriales, autores y lectores. La cuestión de fondo es si la IA se utilizará para complementar las capacidades humanas y mejorar el trabajo editorial o, por el contrario, para reducir costes a expensas de la calidad, la autonomía profesional y los derechos de quienes hacen posible la publicación de un libro.

TRACE: una iniciativa para mejorar la interoperabilidad y la confianza en la inteligencia artificial aplicada a la comunicación científica

Carpenter, Todd A. (2026, 7 de octubre). “TRACE Project Launches to Advance AI Interoperability”. The Scholarly Kitchen. Society for Scholarly Publishing. Enlace al artículo original: https://scholarlykitchen.sspnet.org/2026/10/07/trace-project-launches-to-advance-ai-interoperability/

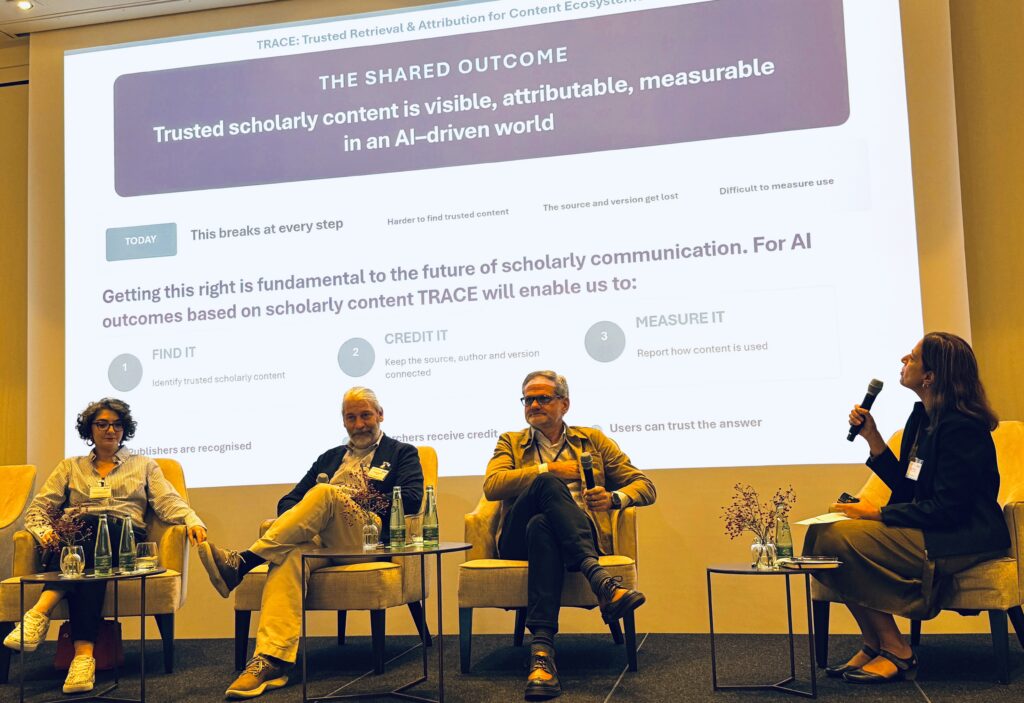
TRACE representa un paso hacia una infraestructura científica preparada para la inteligencia artificial. Su éxito dependerá de que los estándares desarrollados sean interoperables, suficientemente flexibles para funcionar con diferentes arquitecturas tecnológicas y adoptados por los principales actores del ecosistema. Aunque la iniciativa no pretende resolver por sí sola todos los problemas relacionados con los derechos de autor, el control de acceso o la atribución dentro de los modelos de IA, sí busca establecer una base común para que la recuperación y reutilización de información científica sean más transparentes, medibles y fiables.

TRACE (Trusted Retrieval & Attribution for Content Ecosystems), una iniciativa internacional impulsada por diferentes organizaciones del ámbito de la comunicación científica para mejorar la interoperabilidad, la transparencia y la fiabilidad de los sistemas de inteligencia artificial que utilizan publicaciones académicas. Su objetivo es desarrollar una infraestructura técnica compartida que permita identificar las fuentes utilizadas por la IA, preservar la atribución de los contenidos y medir de forma coherente cómo los sistemas automatizados acceden a la información científica y la reutilizan. La iniciativa responde a una transformación profunda de la comunicación académica: los investigadores recurren cada vez más a asistentes inteligentes capaces de recuperar, resumir, comparar y sintetizar documentos, sin necesidad de consultar directamente las publicaciones originales.

TRACE comienza con tres líneas de trabajo complementarias. La primera, vinculada a COUNTER, busca mejorar las métricas de uso de los contenidos científicos en entornos de inteligencia artificial, incluyendo las consultas y recuperaciones realizadas por agentes automatizados. La segunda, coordinada por NISO (National Information Standards Organization), se centra en desarrollar un modelo mínimo de metadatos que permita conservar la procedencia de los documentos y fragmentos utilizados por los sistemas de IA. La tercera, impulsada por STM e Ithaka S+R, estudia cómo los agentes de inteligencia artificial descubren las publicaciones científicas, acceden a ellas mediante los permisos correspondientes y registran su utilización de manera verificable.

Uno de los principales problemas que aborda la iniciativa es la dificultad de comprobar el origen de las afirmaciones generadas por la IA. Los modelos pueden producir referencias inexistentes, atribuir información a fuentes equivocadas o elaborar respuestas sin establecer una conexión verificable entre sus afirmaciones y los documentos originales. Para afrontar esta situación, TRACE pretende favorecer el desarrollo de estándares que mantengan vinculados los contenidos recuperados con sus fuentes, sus metadatos y las condiciones de utilización. No se trata únicamente de reducir errores, sino también de reforzar la integridad científica, facilitar la verificación de los resultados y garantizar el reconocimiento del trabajo de autores y editores.

El proyecto también plantea la necesidad de adaptar los sistemas tradicionales de evaluación y gestión de recursos electrónicos a un escenario en el que parte del consumo de información se produce a través de agentes automatizados. Las bibliotecas universitarias y los editores necesitan conocer cómo se utilizan sus colecciones, qué contenidos recuperan los asistentes inteligentes y qué repercusiones tiene este uso en los modelos de suscripción, acceso abierto y financiación de la comunicación científica. Para ello, TRACE promueve una mayor coordinación entre editoriales, repositorios, proveedores tecnológicos, desarrolladores de IA y organizaciones responsables de los estándares de información.

Inteligencia Humana en tiempos de Inteligencia Artificial con Claudia Vaca- Planeta Biblioteca 2026/10/16

Inteligencia Humana en tiempos de Inteligencia Artificial con Claudia Vaca-

Planeta Biblioteca 2026/10/16

Youtube

Escuchar en Ivoox

Descargar audio

En este programa de Radio USAL, Planeta Biblioteca, conversamos con Claudia Vaca sobre su libro Inteligencia humana en tiempos de la inteligencia artificial, una invitación a reflexionar sobre el pensamiento, el lenguaje y el aprendizaje en la era digital. A través de sus páginas, exploramos los riesgos del sedentarismo cognitivo, la pérdida de la lectura profunda y la dependencia de los algoritmos, reivindicando la importancia de la conciencia, la creatividad y el pensamiento crítico. La autora nos propone entender la inteligencia artificial como una herramienta de apoyo, nunca como un sustituto de nuestra capacidad para comprender, decidir y crear. También abordamos los desafíos educativos y culturales de Bolivia, la diversidad lingüística y el papel de docentes, universidades y bibliotecas en la democratización del conocimiento. Una conversación para preguntarnos qué nos hace verdaderamente humanos y cómo preservar nuestra autonomía intelectual en un mundo que ofrece respuestas inmediatas. Porque, más allá de lo que las máquinas puedan generar, el desafío sigue siendo aprender a pensar, comprender y actuar con responsabilidad.

Trabajar con Alma en lenguaje natural: asistente de IA para fondos de adquisiciones

Ex Libris. «Working with Alma in Natural Language: AI Assistant for Acquisitions Funds & Ledgers». 24 de septiembre de 2026. https://exlibrisgroup.com/blog/working-with-alma-in-natural-language-ai-assistant-for-acquisitions-funds-ledgers/

El artículo presenta una nueva forma de interactuar con Alma, el sistema de gestión bibliotecaria desarrollado por Ex Libris, mediante un asistente de inteligencia artificial que permite consultar información y realizar determinadas operaciones utilizando lenguaje natural.

La propuesta supone un avance en la incorporación de la IA a las tareas técnicas y administrativas de las bibliotecas universitarias, ya que traslada la interacción conversacional —habitual en los asistentes de IA generativa— a un entorno profesional donde se gestionan presupuestos, adquisiciones, registros y recursos bibliográficos.

Tradicionalmente, para responder preguntas sobre la disponibilidad presupuestaria de una biblioteca, el personal debe navegar por diferentes pantallas, localizar registros, consultar informes y relacionar datos procedentes de distintas áreas del sistema. Con el nuevo asistente, estas consultas pueden formularse directamente mediante preguntas escritas en lenguaje cotidiano. El objetivo es reducir la complejidad de las operaciones rutinarias, facilitar el acceso a la información y agilizar la toma de decisiones sin obligar al personal a conocer todos los recorridos y procedimientos de la interfaz.

La novedad fundamental no consiste únicamente en incorporar un chatbot, sino en integrar la conversación con los datos operativos de la biblioteca y con determinados flujos de trabajo. De esta manera, el sistema no se limita a proporcionar explicaciones generales, sino que puede recuperar información de la instalación de Alma de cada institución y, cuando la funcionalidad está disponible, ayudar a preparar acciones concretas sobre sus fondos y registros contables.

La primera área de aplicación del asistente se centra en la gestión de los fondos de adquisiciones y sus correspondientes libros contables (Acquisitions Funds & Ledgers). Se trata de un ámbito especialmente importante en las bibliotecas universitarias, donde el presupuesto debe distribuirse entre diferentes departamentos, colecciones, tipos de materiales, proveedores y necesidades de investigación y docencia.

En lugar de preparar manualmente consultas o navegar por múltiples pantallas, el profesional puede plantear la pregunta directamente. El sistema interpreta la solicitud y devuelve una respuesta basada en los datos operativos disponibles en Alma. Cuando necesita más información para comprender la petición, puede solicitar una aclaración antes de responder.

Otro aspecto relevante es que las respuestas incluyen enlaces a los registros correspondientes de Alma. Esto permite al bibliotecario consultar la información original, comprobar los datos y verificar que la respuesta se ajusta a las necesidades de su institución. La utilidad de este mecanismo reside en combinar la rapidez de la interacción conversacional con la posibilidad de contrastar los resultados en el sistema de gestión.

Uno de los elementos más interesantes de esta herramienta es que la conversación puede continuar después de obtener una respuesta. El asistente puede proponer preguntas complementarias o sugerir una operación relacionada con la consulta inicial, de modo que el usuario no tenga que empezar de nuevo cada vez que necesita realizar una tarea.

Compilatio: software antiplagio y detección de Inteligencia Artificial con Pilar Torres. Planeta Biblioteca 2026/10/01

Compilatio: software antiplagio y detección de Inteligencia Artificial con Pilar Torres.

Planeta Biblioteca 2026/10/01

ESCUCHAR

Descargar

En esta entrevista, Pilar Torres (ITMS Group) presenta Compilatio (Magister+), un software web diseñado para analizar la similitud de textos y detectar contenidos generados por inteligencia artificial. Con una fiabilidad del 70% al 90%, el sistema identifica frases típicas, faltas de cohesión y referencias bibliográficas falsas. Más allá de un enfoque punitivo, la herramienta busca ser un aliado pedagógico que apoya la curaduría del docente y fomenta la integridad académica en el alumnado. Se integra fácilmente en entornos como Moodle o Canvas y destaca por ser una alternativa eficaz y sustancialmente más económica frente a opciones como Turnitin.

Las universidades británicas abandonan Turnitin ante las dudas sobre la privacidad de los datos y la eficacia de sus detectores de IA

Luckhurst, G. (2026, 9 de octubre). More universities end Turnitin contracts as concerns mount. Times Higher Education. https://www.timeshighereducation.com/news/more-universities-end-turnitin-contracts-concerns-mount

Se analiza el creciente distanciamiento de varias universidades británicas respecto a Turnitin, una de las plataformas más extendidas para la detección de similitudes textuales y el apoyo a la integridad académica. Las universidades de Newcastle y Westminster han anunciado que no renovarán sus contratos cuando finalicen sus acuerdos actuales, sumándose a la Universidad de Southampton, que ya había comunicado una decisión similar. Estas medidas reflejan un cambio de actitud hacia herramientas que durante años han ocupado un lugar central en los procedimientos universitarios para detectar el plagio, pero cuya utilidad, coste y condiciones de tratamiento de los datos están siendo objeto de un examen más crítico.

Una de las principales razones de esta controversia son los cambios propuestos por Turnitin en su acuerdo de licencia de usuario final. Las modificaciones suscitaron preocupación porque podían abrir la posibilidad de utilizar trabajos y datos de estudiantes y personal universitario con fines relacionados con la inteligencia artificial. La Universidad de Newcastle ha señalado expresamente sus dudas sobre el posible uso de estos datos, mientras que Southampton decidió iniciar la retirada progresiva del servicio. Tras las críticas de distintas instituciones y organizaciones del sector, Turnitin aplazó la aplicación de los cambios hasta septiembre de 2027 y aceptó dialogar con representantes universitarios para abordar las inquietudes planteadas. La empresa sostiene que actualmente no utiliza los trabajos de los estudiantes para entrenar modelos de inteligencia artificial generativa o grandes modelos de lenguaje (LLM), aunque distingue este supuesto del entrenamiento de clasificadores destinados a identificar textos que probablemente hayan sido generados por IA.

El caso de la Universidad de Westminster introduce una segunda cuestión fundamental: la eficacia real de estas tecnologías frente a las nuevas formas de producción textual. La institución considera que el detector de similitudes tradicional resulta poco eficaz ante uno de los principales desafíos actuales para la integridad académica: los trabajos elaborados mediante inteligencia artificial generativa. Asimismo, cuestiona la fiabilidad de los detectores de IA, puesto que sus resultados son probabilísticos y pueden producir falsos positivos. Esto significa que un texto redactado por una persona podría ser señalado erróneamente como generado por IA. La controversia pone de manifiesto una limitación esencial de estos sistemas: la detección automática no constituye una prueba concluyente de fraude académico y sus resultados deben interpretarse con prudencia, atendiendo al contexto y a otras evidencias disponibles.

El factor económico también desempeña un papel importante en las decisiones de las universidades. Según los datos recogidos por el artículo, la Universidad de Southampton pagó 87.621 libras esterlinas por los servicios de Turnitin entre septiembre de 2024 y septiembre de 2025, mientras que la Universidad de East Anglia desembolsó 50.892 libras durante el periodo comprendido entre abril de 2024 y marzo de 2025. Aunque estos importes corresponden a instituciones de distinto tamaño y no permiten establecer una comparación directa de costes por estudiante, ilustran la dimensión presupuestaria de estos contratos. Algunos especialistas consideran que la preocupación por la privacidad y la inteligencia artificial es legítima, pero que también puede estar favoreciendo una revisión más amplia del gasto en plataformas educativas. Las universidades se preguntan si necesitan contratar un paquete completo de servicios cuando sus entornos virtuales de aprendizaje ya permiten gestionar entregas, calificaciones y comentarios, y pueden complementarse con herramientas alternativas de comprobación de originalidad.

La situación, sin embargo, no representa todavía un abandono generalizado de Turnitin. Algunas instituciones continúan utilizando la plataforma mientras revisan sus condiciones contractuales y estudian otras soluciones. La Universidad de Cambridge, por ejemplo, ha manifestado que no aceptará cambios en el acuerdo que afecten a la privacidad de los datos o a la propiedad intelectual, aunque mantiene el servicio por el momento. Aberdeen está revisando su utilización, mientras que otras universidades exploran alternativas para gestionar la entrega y evaluación de trabajos académicos. El debate se extiende así más allá de la elección de un programa concreto y alcanza cuestiones estratégicas relacionadas con la contratación tecnológica, la protección de la información y la autonomía institucional.

La expansión de la inteligencia artificial generativa está obligando a las universidades a reconsiderar sus mecanismos tradicionales de control de la integridad académica. La decisión de abandonar Turnitin no responde exclusivamente a las dudas sobre el uso de los datos estudiantiles: también intervienen el precio de las licencias, las limitaciones de los detectores y la necesidad de revisar los métodos de evaluación. Algunos especialistas proponen replantear el diseño de las actividades académicas, en lugar de confiar principalmente en herramientas automáticas para identificar posibles irregularidades. Desde esta perspectiva, resulta más adecuado combinar normas transparentes sobre el uso de la IA, evaluación crítica de los trabajos, seguimiento del proceso de aprendizaje y conversaciones pedagógicas con el alumnado. La cuestión central ya no es solamente cómo detectar textos generados por inteligencia artificial, sino cómo garantizar una evaluación justa, proteger los derechos de los estudiantes y promover una cultura de integridad académica adaptada a las nuevas tecnologías.

«Bibliotecas, Libros e IA» entrevista a Julio Alonso Arévalo por Radio UDELAR de Uruguay

Julio Alonso Arévalo en UNI Radio (Comunidad Udelar) bajo el título «Bibliotecas, Libros e IA»:

Recibimos a Julio Alonso Arévalo, jefe de la Biblioteca de la Facultad de Traducción y Documentación de la Universidad de Salamanca, para conversar sobre Bibliotecas, Libros e Inteligencia Artificial. 📻 Comunidad Udelar, lunes y miércoles de 11:30 a 13 hs, por UNI Radio 107.7 FM | En vivo: https://radios.com.uy/uni-montevideo/ UNI Radio, la primera radio universitaria del Uruguay Instagram | uniradioudelar X | uniradioudelar

El núcleo de la presentación aborda la profunda transformación que experimentan el sector editorial, las bibliotecas y el ecosistema del libro tras la irrupción masiva de la Inteligencia Artificial (IA) y la inteligencia artificial generativa. Alonso Arévalo analiza cómo los modelos lingüísticos y las tecnologías de automatización no solo están alterando los procesos técnicos de catalogación, búsqueda y recuperación de información en las bibliotecas, sino que también están redefiniendo el propio concepto de autoría, creación literaria y producción de contenidos académicos y culturales.

En relación con el ámbito bibliotecario y de la información, el diálogo enfatiza el rol renovado que deben asumir los profesionales del sector (bibliotecarios y gestores de la información). En lugar de ver a la inteligencia artificial como una amenaza que sustituye las tareas tradicionales, se plantea como una herramienta indispensable que potencia la curaduría de contenidos, el acceso abierto, la personalización de servicios de referencia para investigadores y usuarios, y la gestión de grandes volúmenes de datos académicos. No obstante, se subraya la urgente necesidad de alfabetización algorítmica y formación continua para capacitar a la comunidad en el uso crítico y ético de estas tecnologías.

Finalmente, la conversación profundiza en las implicaciones éticas, legales y culturales del uso de la IA en la creación de libros y documentos. Se abordan debates clave como los derechos de autor de las obras utilizadas para entrenar grandes modelos de lenguaje, el riesgo de plagio, los sesgos en los datos de entrenamiento y la preservación de la integridad del conocimiento bibliográfico. La conclusión general destaca que, aunque las máquinas pueden optimizar y procesar información a un nivel sin precedentes, el criterio humano, el pensamiento crítico y la dimensión comunitaria y social de las bibliotecas siguen siendo insustituibles en la era digital.

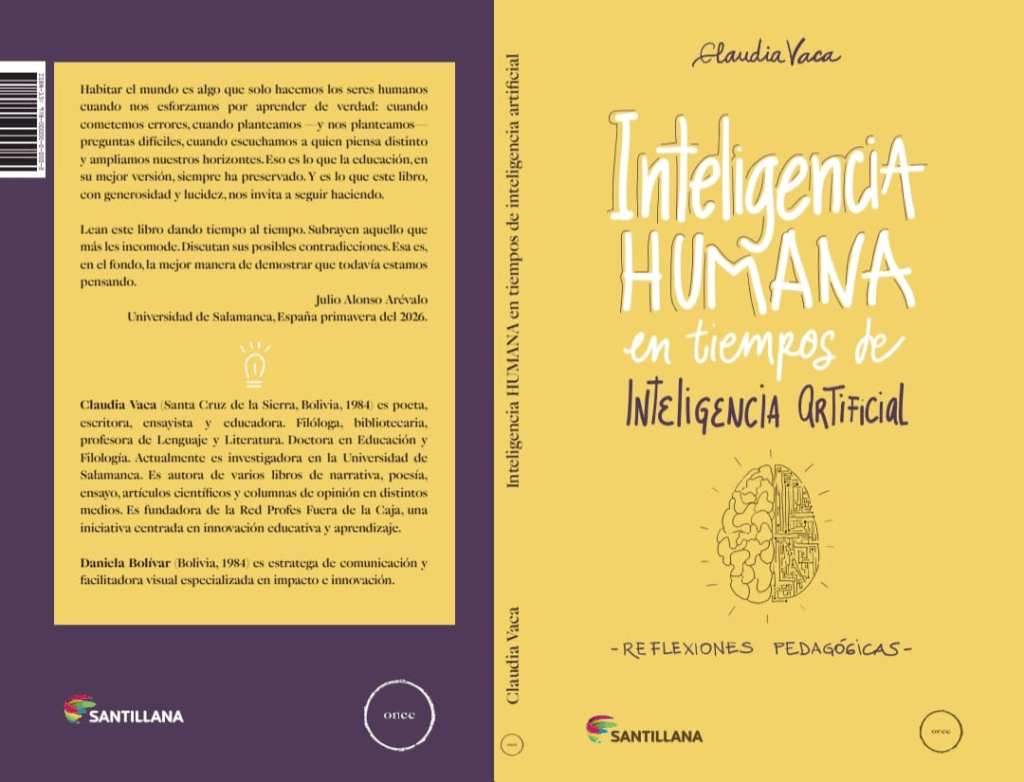
Inteligencia humana en tiempos de inteligencia artificial: Reflexiones pedagógicas

Vaca, Claudia. Inteligencia humana en tiempos de inteligencia artificial: Reflexiones pedagógicas. Madrid: Santillana, 2026.

Adquirir en Amazon

PRÓLOGO Pensar todavía por Julio Alonso Arévalo

Este libro surgió de una incomodidad. No de la incomodidad fácil, la que se puede resolver con una búsqueda en Internet que da con un texto generado en décimas de segundo, sino de la otra incomodidad, la que se instala cuando uno tiene la percepción de que algo importante está cambiando y no sabe del todo bien cómo poder nombrarlo. Claudia Vaca lo nombra. Y al nombrarlo, nos devuelve algo que es probable que habíamos comenzado a perder, sin percibirlo: la posibilidad de pararse a pensar lo que nos está sucediendo.

Vivimos en momentos de respuestas instantáneas; se enuncian preguntas y casi con inmediatez asoman respuestas -porque la apariencia es prácticamente eso-, respuestas fluidas, que pueden dar la impresión de ser respuestas eficaces, coherentes y bien escritas. Y sin embargo, es en eso mismo en donde algo está el problema. Pero contra esa misma respuesta existe un recorrido de la que no puede decirse que hubo un recorrido en este caso, no hay respuesta a esta pregunta e incluso puede llegarse a la conclusión de que se puede hacer algo que no se ha hecho, es como leer el final de un relato sin haberse dejado llevar por la magia de la construcción de la propia historia. La forma está, pero la experiencia -lo que llena, lo que deja huella- ha desaparecido.

La cuestión que plantea este libro no es si la inteligencia artificial es buena o mala. Esa pregunta, aunque legítima, nos desvía de una más urgente: ¿Qué le pasa al pensamiento humano cuando se encuentra en un entorno donde pensar no es necesario? No, no es una cuestión técnica. Es una pregunta profundamente humana, ya que tiene que ver con la educación, con el lenguaje, con la manera que tenemos de relacionarnos con el conocimiento y con los demás.

En cierta ocasión, en algún momento de esta lectura, uno tiene la impresión de que Claudia habla de los estudiantes, de las aulas, pero también, y sobre todo, de todos nosotros. De la manera que consultamos antes de preguntar, de cómo evitamos el esfuerzo de buscar algo porque ya hay algo que ha buscado por nosotros, de cómo leer un texto largo se ha convertido, para muchos, en un acto casi heroico en el contexto de una cultura que «premia» la brevedad y la velocidad. El sedentarismo cognitivo no es un tema exclusivamente de los más jóvenes: es el aire que casi todos respiramos.

* * *

Uno de los valores más apreciados y sinceros de este libro es que no propone una solución simple. No dice “Deja ya de utilizar la IA; para que las cosas empiecen a funcionar”; tampoco dice lo contrario “Usa la tecnología conscientemente”, como si eso fuera la solución única. Lo que propone es más sencillo, aunque también más real: replantéate el significado de aprender, en que consiste entender y qué es lo que desaprovechamos y perdemos cuando delegamos en una herramienta la creación de un texto.

Esta es precisamente una de las claves que encontramos a lo largo del libro —la distinción entre un texto escrito en función del entrenamiento de una herramienta con millones de textos basado en probabilidades estadísticas y crear un contenido a través del lenguaje y el pensamiento-. Esta distinción es bien tenida en cuenta por los que se dedican a la docencia: ellos saben que algunos alumnos presentan trabajos impecables sin haber comprendido nada, y otros alumnos que presentan trabajos que aunque contengan errores provienen de personas que han realizado un proceso de aprendizaje, reflexión. La diferencia entre uno y otro no está en el resultado final del texto, si no en el propio proceso. Y el problema que estamos enfrentado con la IA, es en gran medida este mismo: que el proceso creativo con la llegada de esta tecnología se ha vuelto se ha vuelto invisible.

Claudia escribe desde América Latina, y ello importa. No porque los problemas que expone sean exclusivos de esta parte del mundo, sino porque aquí adquieren texturas específicas. La brecha digital no es solo una brecha de acceso: es una brecha de relación con el conocimiento. Y la pregunta en torno a la autonomía intelectual no se puede separar la pregunta sobre la definición de qué es lo que cuenta como “inteligencia”: qué lenguas son importantes, qué saberes tienen cabida en el currículo. En ese horizonte de confluencia entre lo epistémico y lo político, este libro encuentra su propia voz.

En el texto encontramos una determinación razonada que la autora asume como una verdadera convicción: a diferencia de la inteligencia artificial la inteligencia humana no se define por la cantidad de información que utiliza, sino por la capacidad de establecer un sentido. Este proceso no se basa en lo que determina un algoritmo, si no en que el razonamiento proviene de la experiencia adquirida por la propia memoria humana, de la memoria biográfica y bibliográfica, de la posibilidad de cometer y asumir un posible error, y de la responsabilidad ante los demás. Y lamentablemente ninguna de esas cosas puede externalizarse sin que algo se pierda en el camino.

* * *

En el texto un concepto que aparece con importante frecuencia en varios capítulos es “criterio”, término que podríamos calificar como uno de los conceptos claves del libro, y es que, tener criterio es otra cosa muy diferente que tener conocimiento, hay personas que pueden saber muchas cosas, pueden saberlo todo, pero que no tienen criterio, podemos tener todo el conocimiento que existe en el mundo y no saber qué hacer con él, lo que es característico de tener un verdadero criterio es tener capacidad de discernir respecto a lo que se va haciendo; esto es lo que nos convierte en su más profundo sentido en sujetos y no en meros receptores de información.

El libro deja claro que el criterio, no se consuma simplemente proporcionando respuestas. Se enseña formulando las preguntas adecuadas, permitiendo que el posible error se convierta en una parte esencial del aprendizaje y no en una amenaza. Y esto forma parte del proceso de enseñanza y se aprende con estudio, con lectura, con esfuerzo y también con entusiasmo, y lo más importante no es llegar a la meta antes, si no llegar, y en ese proceso aprender y sobre todo llegar comprendiendo. Pero en la llamada actual sociedad del conocimiento y de la satisfacción inmediata la economía de atención parece cada vez más irrelevante.

Claudia cita una frase de Neil Postman que es especialmente pertinente: «La cuestión no es si las máquinas pueden pensar; la cuestión es si las personas aún lo hacemos». No forma parte de una simple cuestión retórica. Es una pregunta pertinente, que no tiene únicamente la intención de alarmar, si no de concienciar sobre algo que es ineludible: saber que pensar es un acto que necesita esfuerzo, y de que renunciar a ese esfuerzo, aunque sea a cambio de la comodidad tiene consecuencias negativas.

Lo que ella denomina llama “sedentarismo cognitivo” es, una de las definiciones más precisas de algo que muchos intuimos y que no habíamos alcanzado a nombrar con precisión. Así como cuidar nuestro cuerpo implica la necesidad de ejercitarse para mantenerse vivo y ágil, nuestra mente necesita esa gimnasia mental, es decir esforzarnos, aunque ello no suponga que vayamos a obtener una respuesta inmediata como sucede con la inteligencia artificial. Y será este proceso el que nos ayudará a crecer. Esto no supone renunciar a la tecnología, que puede ser una herramienta útil de ayuda, sino para utilizarla sin renunciar al sentido común y a la creatividad, que sólo es patrimonio de las personas.

El libro va dirigido a docentes, estudiantes, y a todas aquellas personas que reflexionan sobre el valor de la educación. Pero también está escrito para cualquiera que percibe, que algo de su relación con el conocimiento está cambiado en los últimos tiempos y no es capaz de determinar bien si este cambio supone una ganancia o una pérdida. Como apuntamos al inicio de este prólogo, la respuesta que Claudia propone no es simple, ni sencilla: es ambas cosas, y eso depende en buena medida de las decisiones que tomemos, individual y colectivamente.

En esencia el libro aboga por un hecho que parece lógico que la conciencia humana no es sustituible. No porque sea perfecta, que claramente no lo es, o precisamente por eso  mismo, sino porque es el único espacio en el que podemos asumir nuestras responsabilidades de lo que expresamos a través del pensamiento y de la creación. Es innegable que la inteligencia artificial tiene una enorme capacidad para escribir textos, reorganizar información y casi siempre lo hace de manera impecable, no obstante se ha entrenado con casi toda la información que ha producido la humanidad a lo largo de los siglos, pero no puede asumir ninguna  responsabilidad por sí misma. Tampoco puede hacerse cargo de los daños que pueda causar y no puede, en el sentido más profundo, habitar el mundo.

Ya que habitar el mundo únicamente lo hacemos los seres humanos cuando nos esforzamos por aprender de verdad: cuando cometemos errores, cuando plateamos y nos plateamos una pregunta difícil, cuando escuchamos a alguien que piensa diferente y eso nos abre nuevos horizontes. Precisamente esto es lo que la educación, en su mejor versión, ha preservado siempre. Y es lo que este libro, con generosidad y lucidez, nos invita a seguir haciendo.

Lean este libro dando tiempo al tiempo. Subrayen aquello que más les incomode. Discutan sobre sus posibles contradicciones. Esa es, en el fondo, la mejor manera de demostrar que todavía estamos pensando.

 Julio Alonso Arévalo

 Salamanca, primavera de 2026