Archivo de la etiqueta: Datos

El NIST identifica tipos de ciberataques que manipulan el comportamiento de los sistemas de inteligencia artificial (IA)

«NIST Identifies Types of Cyberattacks That Manipulate Behavior of AI Systems». 2024. NIST, enero. https://www.nist.gov/news-events/news/2024/01/nist-identifies-types-cyberattacks-manipulate-behavior-ai-systems.

La publicación, una colaboración entre el gobierno, la academia y la industria, tiene la intención de ayudar a los desarrolladores y usuarios de IA a comprender los tipos de ataques que podrían esperar, junto con enfoques para mitigarlos, con la comprensión de que no hay una solución única.

Los sistemas de IA han permeado la sociedad moderna, trabajando en capacidades que van desde conducir vehículos hasta ayudar a los médicos a diagnosticar enfermedades o interactuar con clientes como chatbots en línea. Para aprender a realizar estas tareas, se entrenan con vastas cantidades de datos: un vehículo autónomo podría mostrar imágenes de carreteras con señales de tráfico, por ejemplo, mientras que un chatbot basado en un modelo de lenguaje grande (LLM) podría exponerse a registros de conversaciones en línea. Estos datos ayudan a la IA a predecir cómo responder en una situación dada.

Un problema importante es que los datos en sí mismos pueden no ser confiables. Sus fuentes pueden ser sitios web e interacciones con el público. Hay muchas oportunidades para que actores malintencionados corrompan estos datos, tanto durante el período de entrenamiento de un sistema de IA como después, mientras la IA continúa refinando sus comportamientos al interactuar con el mundo físico. Esto puede hacer que la IA se comporte de manera indeseable. Por ejemplo, los chatbots pueden aprender a responder con lenguaje abusivo o racista cuando se sortean cuidadosamente las protecciones mediante indicaciones maliciosas.

«En su mayor parte, los desarrolladores de software necesitan que más personas usen su producto para que pueda mejorar con la exposición», dijo Vassilev. «Pero no hay garantía de que la exposición sea buena. Un chatbot puede generar información negativa o tóxica cuando se le indica con un lenguaje cuidadosamente diseñado».

En parte porque los conjuntos de datos utilizados para entrenar una IA son demasiado grandes para que las personas los supervisen y filtren con éxito, todavía no hay una forma infalible de proteger la IA contra el desvío. Para ayudar a la comunidad de desarrolladores, el nuevo informe ofrece una visión de los tipos de ataques que podrían sufrir sus productos de IA y enfoques correspondientes para reducir el daño.

El informe considera los cuatro principales tipos de ataques: evasión, envenenamiento, privacidad y ataques de abuso. También los clasifica según múltiples criterios, como los objetivos y metas del atacante, las capacidades y el conocimiento.

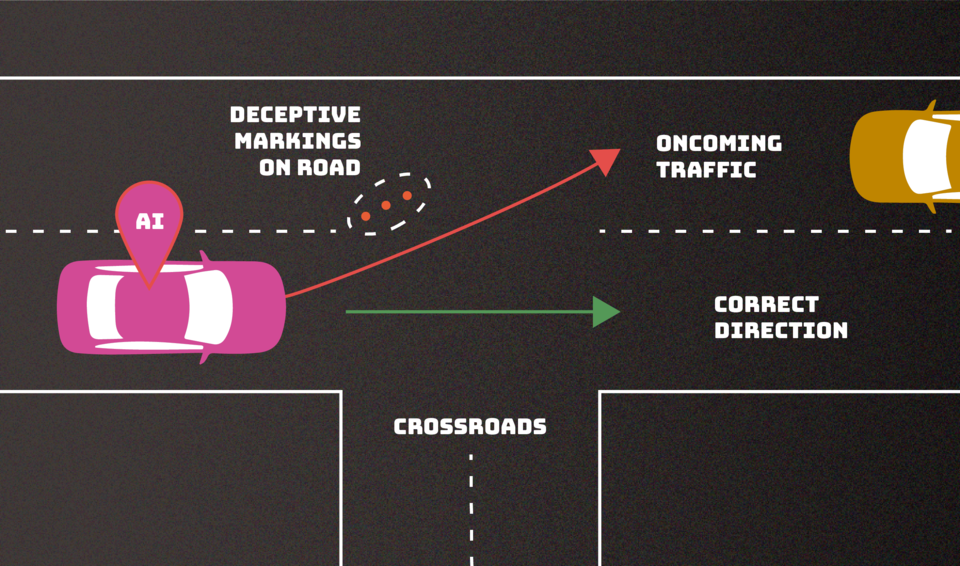
  • Los ataques de evasión, que ocurren después de que se implementa un sistema de IA, intentan alterar una entrada para cambiar cómo el sistema responde a ella. Ejemplos incluirían agregar marcas a señales de alto para hacer que un vehículo autónomo las interprete como señales de límite de velocidad o crear marcas de carril confusas para hacer que el vehículo se desvíe de la carretera.
  • Los ataques de envenenamiento ocurren en la fase de entrenamiento al introducir datos corruptos. Un ejemplo sería deslizar numerosas instancias de lenguaje inapropiado en registros de conversaciones, para que un chatbot interprete estas instancias como parloteo lo suficientemente común como para usarlo en sus propias interacciones con clientes.

Los ataques de privacidad, que ocurren durante la implementación, son intentos de aprender información sensible sobre la IA o los datos en los que se entrenó para mal usarla. Un adversario puede hacerle numerosas preguntas legítimas a un chatbot y luego utilizar las respuestas para ingeniería inversa del modelo para encontrar sus puntos débiles o adivinar sus fuentes. Agregar ejemplos indeseados a esas fuentes en línea podría hacer que la IA se comporte de manera inapropiada, y hacer que la IA olvide esos ejemplos específicos no deseados después del hecho puede ser difícil.

Los ataques de abuso implican la inserción de información incorrecta en una fuente, como una página web o un documento en línea, que una IA luego absorbe. A diferencia de los ataques de envenenamiento mencionados anteriormente, los ataques de abuso intentan darle a la IA piezas incorrectas de información de una fuente legítima pero comprometida para cambiar el uso previsto del sistema de IA.

«La mayoría de estos ataques son bastante fáciles de llevar a cabo y requieren un conocimiento mínimo del sistema de IA y capacidades adversarias limitadas», dijo la coautora Alina Oprea, profesora en la Universidad Northeastern. «Los ataques de envenenamiento, por ejemplo, pueden llevarse a cabo controlando unas pocas docenas de muestras de entrenamiento, lo que sería un porcentaje muy pequeño de todo el conjunto de entrenamiento».

Los autores, que también incluyeron a los investigadores de Robust Intelligence Inc., Alie Fordyce e Hyrum Anderson, desglosan cada una de estas clases de ataques en subcategorías y agregan enfoques para mitigarlos, aunque la publicación reconoce que las defensas que los expertos en IA han ideado contra ataques adversarios hasta ahora son incompletas.

Los datos de los usuarios de la British Library robados en el ciberataque se ofrecen en un sitio de subastas en la dark web por 600.000 libras esterlinas

Lyon, J. (2023, noviembre 21). Data stolen from the British Library is being auctioned for bitcoin on the dark web. Protos. https://protos.com/data-stolen-from-the-british-library-is-being-auctioned-for-bitcoin-on-the-dark-web/

La British Library, se enfrenta a una crisis cibernética tras un ataque de ransomware. Aunque el edificio y los libros físicos permanecen, el acceso a la información y la conexión entre lectores y materiales se ha visto comprometida. Este incidente destaca la fragilidad de las instituciones que nos conectan y protegen, subrayando la importancia del trabajo que hacen posible.

En Halloween de 2023, la Biblioteca Británica (BL) de Londres sufrió un ciberataque masivo, que dejó su presencia en la web inexistente, su acceso a las colecciones desactivado e incluso su wifi colapsó. El ciberataque también puso en manos de un tercero los datos personales de los usuarios y del personal de la BL. Durante la última semana de noviembre, se presentaron imágenes de los datos robados para su subasta en la web oscura, a la venta a quien estuviera dispuesto a pagar 20 bitcoin, o unas 600.000 libras esterlinas. Al convertir la infraestructura digital de la biblioteca en una mercancía (en un mercado abierto, aunque oscuro), una «banda de ransomware» autodenominada Rhysida espera presionar a la Biblioteca Británica para que pague primero. Los datos privados, que incluyen detalles de pasaportes y documentos de empleo de HMRC. Según The Register, el grupo de ransomware detrás del ataque, Rhysida, ya ha recibido una oferta inicial de 20 bitcoins, con un valor aproximado de $745,000. TechCrunch también afirma que Rhysida amenazó con publicar los datos a menos que se pagara un rescate por parte de la Biblioteca Británica. Un asesor de ciberseguridad global de ESET le dijo a The Register que Rhysida probablemente «no ha recibido el rescate» y «ahora está llevando a cabo la siguiente fase del ataque amenazando con liberar los datos».

«Con solo 7 días en el reloj, aprovecha la oportunidad para ofertar por datos exclusivos, únicos e impresionantes», dice el anuncio de Rhysida. «Abre tus billeteras y prepárate para comprar datos exclusivos. Vendemos solo a una mano, sin revender, serás el único propietario».

La Biblioteca Británica reveló por primera vez las interrupciones a fines de octubre antes de confirmar que fue víctima de un ataque de ransomware el 14 de noviembre. El ataque causó varias interrupciones técnicas importantes, incluida la inutilización del sitio web de la biblioteca. Actualmente, el sitio aún está fuera de servicio, y la biblioteca está publicando actualizaciones en X (anteriormente Twitter).

Esta semana, afirmó: «No tenemos evidencia de que los datos de nuestros usuarios hayan sido comprometidos». Dijo que cualquier persona con una cuenta de la Biblioteca Británica que use una contraseña compartida con otras cuentas debería cambiar esa contraseña en todas partes.

El ataque de ransomware ha expuesto la vulnerabilidad de la institución y sus personas, quienes están dedicadas a proporcionar el derecho humano básico a la información. En última instancia, el incidente destaca que cualquier intento de cuantificar el valor del conocimiento en cualquier moneda, ya sea bitcoin u otra, fracasará. La historia sirve como recordatorio de la fragilidad de las instituciones que nos conectan y protegen, así como de la importancia del trabajo que hacen posible.

Prácticas de recopilación y análisis de datos en bibliotecas universitarias

Library Analytics Survey Among Academic Libraries 2021 Report

Texto completo

Encuesta de análisis de bibliotecas entre bibliotecas universitarias Informe 2021 Conozca las prácticas de recopilación y análisis de datos de 196 bibliotecas universitarias y universitarias. Este informe destaca las prácticas de gestión de datos actualmente vigentes y su impacto en el servicio bibliotecario. También se exploran las barreras para una gestión eficaz de los datos y el futuro del análisis bibliotecario.

Satisfacción con las Soluciones Existentes de Gestión de Datos

  • Del total de la muestra, casi el mismo porcentaje de encuestados se encuentran satisfechos con sus soluciones de gestión de datos que insatisfechos (satisfechos netos 29.1% frente a insatisfechos netos 28.1%). Un gran porcentaje, el 43%, no se encuentra ni satisfecho ni insatisfecho.
  • Los encuestados de escuelas más grandes son menos propensos a estar satisfechos, pero esto puede ser resultado de llegar a personal con menos familiaridad con la analítica de datos y que optaron por permanecer neutrales.
  • Los administradores tienen el grado más alto de insatisfacción neta con sus soluciones analíticas actuales (36%). El personal de servicios de apoyo en general tiene la mayor satisfacción neta, pero también tiene el mayor porcentaje de «muy insatisfechos» (6%).

Barreras para la Recopilación y Análisis de Datos

  • Las tres barreras más comunes para la recopilación de datos son la falta de tiempo (seleccionada por el 53%), la falta de personal (51%) y la falta de herramientas sólidas (46%). Justo por debajo del diez por ciento informa no tener barreras para la recopilación de datos.
  • Las barreras para el análisis de datos son ligeramente más prevalentes. Más de la mitad de las bibliotecas en la muestra nombraron estas tres como barreras para el análisis de datos en su institución: falta de tiempo (61%), falta de experiencia (54%) y falta de personal (52%).

Impacto de Recursos Adicionales en la Recopilación y Análisis de Datos

  • Al preguntar qué recursos adicionales podrían ayudarles a superar las barreras de gestión de datos, el tiempo y los recursos de personal surgieron como los dos que tendrían el impacto más significativo.


Dificultades Específicas en la Gestión de Datos

  • Los principales obstáculos para una gestión efectiva de datos son la recopilación de datos, la limpieza de datos y el aislamiento de datos.
  • Los administradores son los más propensos a seleccionar «Es difícil obtener datos», mientras que el personal de servicios de apoyo (que probablemente trabaje directamente con los datos) selecciona «es difícil limpiar los datos» con mayor frecuencia.
  • Para escuelas más grandes (con una matrícula de 10,000 o más), las dificultades para limpiar los datos y los datos aislados son obstáculos más grandes que la obtención de datos.

Otras Causas de Dificultades en la Realización de Análisis de Bibliotecas

  • La pérdida de conocimiento institucional debido a la rotación de personal ha sido un obstáculo significativo para la mitad de los encuestados (52%). Los cambios en los estándares (49%) y la falta de estudios longitudinales (42%) también han causado problemas significativos para las bibliotecas académicas.

Observaciones sobre las Herramientas Necesarias para una Gestión Efectiva de Datos

  • Dos tercios de los encuestados consideran que las herramientas necesarias para una gestión efectiva de datos son costosas.
  • Aunque se cree ampliamente que hay herramientas de gestión de datos disponibles en el mercado, el 58 por ciento de los encuestados siente que hay muy pocas herramientas disponibles para su uso en su biblioteca (y un porcentaje considerablemente mayor de administradores, el 73%).
  • El personal de servicios de apoyo tiende menos a sentir que no tienen la experiencia para usar las herramientas necesarias, en comparación con el 56% de la muestra total.

Valor y crecimiento del mercado de las revistas académicas de Acceso Abierto (OA) en 2023

Michael, Dan Pollock and Ann. «News & Views: Market Sizing Update 2023». Delta Think, 24 de octubre de 2023. https://deltathink.com/news-views-market-sizing-update-2023/.

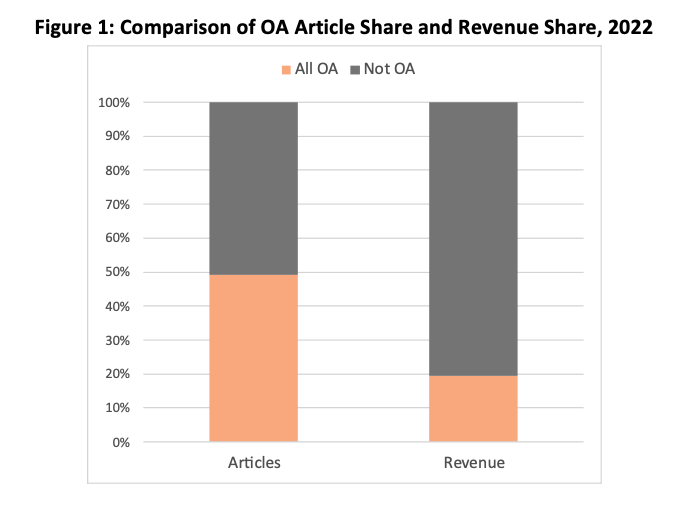
Cada año, el Market Sizing de Delta Think analiza el valor del mercado de las revistas académicas de OA. Se trata de los ingresos generados por los proveedores o los costes incurridos por los compradores de contenidos.

Según estima la agencia el segmento de OA del mercado habrá crecido hasta algo más de 2.000 millones de dólares en 2022. Se trata de un fuerte crecimiento con respecto al año anterior, aunque es significativamente inferior al del año anterior. El mercado general de las revistas académicas apenas creció durante el mismo periodo.

Conclusiones principales

  • El mercado del OA creció hasta algo más de 2.000 millones de dólares en 2022.
    un crecimiento de algo más del 24% desde 2021. Esto supone aproximadamente dos tercios del crecimiento registrado en 2021.
  • El mercado total de revistas académicas creció un 0,4% en 2022, en comparación con su crecimiento a largo plazo de un solo dígito, entre el 2% y el 4%.
  • Dado el crecimiento excepcionalmente alto en 2020 y 2021, se esperaba una corrección en 2022.; sin embargo, el crecimiento de OA fue significativamente menor de lo que había sido anteriormente.

Tendencias

  • Se observa una ralentización del crecimiento en 2022, aunque los motores subyacentes del mercado siguen siendo fuertes.
  • El COVID-19 provocó un aumento significativo de la actividad editorial, mostrando volúmenes y tasas de crecimiento superiores a la media en 2020 y 2021.
  • El año pasado, los resultados de nuestra encuesta y los comentarios anecdóticos arrojaron mensajes contradictorios sobre las perspectivas para 2022. Muchos esperaban un crecimiento bajo en 2022, a medida que las cosas se corrigieran hacia las tendencias subyacentes. En efecto, 2022 registró un crecimiento notablemente inferior al del año anterior. Sin embargo, como el crecimiento subyacente de OA sigue siendo fuerte, las cifras de menor crecimiento de 2022 parecen elevadas si se toman de forma aislada.

Datos y metadatos, sus debates teóricos y prácticos del ayer, del hoy y sus discusiones futuras

Rodríguez García, Ariel Alejandro (coord.). «Datos y metadatos, sus debates teóricos y prácticos del ayer, del hoy y sus discusiones futuras», México: IBI, 2023.

Texto completo

En la historia de la organización de la información, referirse a lo que son los datos y metadatos para los bibliotecólogos y estudiosos de la información tiene múltiples propósitos en su estudio, así como significados. Ambos términos hacen que nuestros pensamientos y saberes se vayan a muchos siglos atrás, porque discutir sobre su gestación, crecimiento y desarrollo ha sido, es y será un asunto en constante evolución.

La mayoría de las iniciativas que se han documentado sobre los metadatos regularmente ofrecen una solución técnica para representar y describir un recurso. Otras proposiciones tienen una carga excesiva de instrucciones reglamentadas para la estructuración de los datos.

El término metadato fue acuñado en la década de los sesenta del siglo pasado, con el propósito de nombrar la descripción de un conjunto de datos. Pero en la actualidad, referirse a los metadatos es hacerlo con el fin de señalar que existe un esquema formal de información acerca de cualquier tipo de recurso que está codificado digitalmente. Además, es posible afirmar que los metadatos se pueden usar para organizar, controlar, transferir, establecer acuerdos y transmitir información de unos recursos con otros para ayudar eficientemente en el descubrimiento y la recuperación de información.

Directrices de privacidad de la biblioteca para proveedores

Library Privacy Guidelines for Vendors. ALA, 2021

Texto original

La protección de la privacidad y la confidencialidad de los usuarios ha sido durante mucho tiempo una parte integral de la misión de libertad intelectual de las bibliotecas. El derecho a la libre indagación garantizado por la Primera Enmienda depende de la capacidad de leer y acceder a la información libre del escrutinio del gobierno o de terceros. En su prestación de servicios a los usuarios de las bibliotecas, los bibliotecarios tienen la obligación ética, expresada en el Código de Ética de la Asociación Americana de Bibliotecas y en la Declaración de Derechos de las Bibliotecas, de preservar el derecho a la privacidad de los usuarios y de impedir cualquier uso no autorizado de los datos de los usuarios. Los bibliotecarios y las bibliotecas también pueden tener la obligación legal de proteger los datos de los usuarios de la biblioteca contra la divulgación no autorizada.

Las bibliotecas celebran licencias o acuerdos con terceros proveedores para prestar servicios bibliotecarios a los usuarios y satisfacer las necesidades operativas de la biblioteca. Entre los proveedores externos se encuentran los proveedores de contenidos digitales, los facilitadores de programas e incluso otras bibliotecas, como un consorcio. En el transcurso de la provisión de software, hardware o servicios, la mayoría de los proveedores externos recopilan y utilizan los datos de los usuarios de las bibliotecas por diversas razones, como el análisis y la segmentación de los consumidores, la personalización, la gestión de derechos digitales y el desarrollo de colecciones digitales. Las bibliotecas y los proveedores deben trabajar juntos para garantizar que los contratos y las licencias que rigen la recopilación, el procesamiento, la divulgación y la retención de los datos de los usuarios de la biblioteca reflejen la ética, las políticas y las obligaciones legales de la biblioteca en relación con la privacidad y la confidencialidad de los usuarios.

Elección de un proveedor de terceros

Cuando las bibliotecas inician la búsqueda de un producto o servicio, hay varias formas en las que las bibliotecas se dirigen a los proveedores sobre sus prácticas de privacidad. Las bibliotecas deben incluir requisitos y preguntas sobre privacidad para el proveedor en su solicitud de propuesta (RFP) o proceso de licitación similar. Los requisitos y las preguntas pueden incluir qué datos se recopilan, cómo se recopilan y almacenan los datos, cuánto tiempo se almacenan los datos con el proveedor, y si los datos se comparten con otros terceros y cómo.

Las bibliotecas que solicitan ofertas a los proveedores también deben hacer preguntas a lo largo del proceso de búsqueda relacionadas tanto con el servicio/producto como con las políticas y prácticas del proveedor en torno a la privacidad y seguridad de los datos. Si el servicio o producto no cumple con un requisito de privacidad indicado en la solicitud de propuestas, las bibliotecas deben preguntar a los proveedores sus planes para cumplir con ese requisito. Las bibliotecas deben preguntar cómo cuida el proveedor las violaciones de datos, así como los informes de las bibliotecas o de los usuarios sobre la posible vulnerabilidad del servicio o del producto.

Acuerdos, propiedad de los datos del usuario y requisitos legales

Los acuerdos entre las bibliotecas y los proveedores deben abordar las restricciones apropiadas sobre el uso, la agregación, la retención y la divulgación de los datos de los usuarios, en particular la información sobre los menores. Los acuerdos entre las bibliotecas y los proveedores también deben especificar que las bibliotecas conservan la propiedad de todos los datos de los usuarios y que el proveedor se compromete a respetar las políticas de privacidad y de retención y seguridad de datos de la biblioteca.

Se recomienda encarecidamente a los proveedores que apliquen los principios de privacidad por diseño, es decir, que los productos y servicios deben tener las cuestiones de privacidad «incorporadas, no atornilladas». Si los productos que se comercializan actualmente no tienen en cuenta estas directrices de privacidad, los vendedores deberían incorporarlas en futuras actualizaciones. Además, los acuerdos entre las bibliotecas y los proveedores deberían reflejar e incorporar las restricciones sobre la posible difusión y uso de los registros y datos de los usuarios de la biblioteca impuestas por la legislación local, estatal y federal.

Menores de edad

Los derechos de los menores varían de un estado a otro, y las responsabilidades legales y la posición del personal de la biblioteca con respecto a los usuarios menores difieren sustancialmente en las bibliotecas escolares, universitarias y públicas. Por lo general, el derecho de un menor a mantener la privacidad de sus registros en la biblioteca se regirá por el estatuto de confidencialidad de la biblioteca de un estado; sin embargo, en las instituciones educativas públicas, la Ley de Derechos Educativos y Privacidad de la Familia (FERPA) también determina la confidencialidad y la divulgación de los registros de la biblioteca de los menores.

Los proveedores que permiten a los menores de 13 años acceder a sus plataformas deben cumplir la Ley federal de protección de la privacidad de los niños en línea (COPPA) y cualquier otra legislación estatal o federal relativa a la recopilación y el intercambio de datos de los menores. Las bibliotecas deben establecer políticas de privacidad claras junto con las agencias locales, estatales y federales que detallen cómo y qué datos sobre los menores se recopilan y comparten con los proveedores y las escuelas.

Políticas de privacidad claras

Las políticas de privacidad deben ser fácilmente accesibles y comprensibles para los usuarios. Para salvaguardar la privacidad de los usuarios es necesario que éstos sepan qué información se recoge sobre ellos, durante cuánto tiempo se almacena, quién tiene acceso a ella y en qué condiciones, y cómo se utiliza. Debe haber una forma de notificar activamente a los usuarios en curso cualquier cambio en las políticas de privacidad del proveedor.

Consentimiento del usuario

El proveedor debe ofrecer a los usuarios opciones sobre la cantidad de información personal que se recopila de ellos y cómo se puede utilizar. Los usuarios deben tener la opción de optar por cualquier recopilación de datos que no sea esencial para las operaciones de la biblioteca y la oportunidad de optar de nuevo en cualquier momento futuro. Toda recopilación de datos no esenciales debería estar desactivada por defecto. En todas las áreas de la biblioteconomía, las mejores prácticas dejan a los usuarios el control de tantas opciones como sea posible en relación con su privacidad.

Acceso a los datos personales

Los usuarios deben tener derecho a acceder a su propia información personal y a corregir la información incorrecta. La verificación de la exactitud ayuda a garantizar que los servicios del proveedor que dependen de la información personal del usuario puedan funcionar correctamente. La orientación sobre cómo el usuario puede acceder a sus datos personales debe ser clara y fácil de encontrar. Los usuarios también deben tener la posibilidad de descargar sus datos personales en un formato de archivo abierto, como CSV, para su propio uso.

El acceso a la información personal debe estar restringido al usuario, al proveedor y a los trabajadores de la biblioteca, según sea necesario para la prestación de servicios y la administración de la biblioteca, y debe ajustarse a las leyes estatales aplicables que abordan la confidencialidad de los registros de la biblioteca, así como a otras leyes locales, estatales y federales aplicables.

Los proveedores deben tener la práctica de borrar los datos de los usuarios cuando se les solicite. Los datos deben ser purgados de los discos duros y servidores, no sólo ocultados a la vista.

Integridad y seguridad de los datos

Siempre que se recojan datos de usuarios, las bibliotecas, los proveedores y cualquier subcontratista deben tomar medidas razonables para garantizar la integridad y la seguridad, incluido el cumplimiento de los requisitos legales aplicables.

  • Seguridad: La seguridad implica medidas de gestión y técnicas para proteger contra la pérdida y el acceso no autorizado, la destrucción, el uso o la divulgación de los datos. Las medidas de seguridad deben integrarse en el diseño, la implementación y las prácticas cotidianas de todo el entorno operativo del proveedor como parte de su compromiso continuo con la gestión de riesgos. El proveedor debe buscar el cumplimiento de las normas de ciberseguridad publicadas por organizaciones como el Instituto Nacional de Normas y Tecnología (NIST).
  • Encriptación: El uso de la encriptación de datos ayuda a mejorar la seguridad. Todas las transacciones en línea entre las aplicaciones de los clientes (navegadores web, aplicaciones móviles, etc.) y las aplicaciones de los servidores deben estar cifradas. Además, cualquier dato del usuario alojado por el proveedor fuera de las instalaciones (infraestructura basada en la nube, copias de seguridad en cinta, etc.) debe utilizar un almacenamiento cifrado.
  • Minimización de datos: Los proveedores y las bibliotecas sólo deben recopilar, procesar, retener o divulgar los datos de los usuarios que sean necesarios para un proceso o tarea específicos. La recopilación y/o retención excesiva de datos pone a los usuarios en mayor riesgo en caso de una violación de datos.
  • Anonimización: Los datos utilizados para el análisis de usuarios y otros tipos de análisis deben ser anónimos, eliminando o encriptando la información de identificación personal. Aunque la anonimización de datos es una buena práctica, no es infalible.
  • Conservación: Los datos de los usuarios no deben conservarse a perpetuidad. Los proveedores y las bibliotecas deben establecer políticas sobre el tiempo de conservación de los diferentes tipos de datos y los métodos para destruir de forma segura los datos que ya no son necesarios. Por ejemplo, las cuentas que hayan caducado o estén inactivas durante un tiempo determinado deberían ser purgadas. Las políticas de retención también deben abarcar las copias de archivo y las copias de seguridad. Las bibliotecas deben remitirse a las leyes de retención de registros y a las políticas de los órganos de gobierno.
  • Intercambio de datos: Los datos de los usuarios no deben compartirse con otros proveedores u otros asociados comerciales sin el consentimiento del usuario. La mayoría de las leyes estatales sobre la confidencialidad de los registros de la biblioteca no permiten la divulgación de la información personal identificable de los usuarios de la biblioteca o de los datos sobre su uso de los recursos y servicios de la biblioteca sin el consentimiento del usuario o una orden judicial.
  • Solicitudes gubernamentales: Los proveedores y las bibliotecas deben desarrollar y aplicar procedimientos para atender las solicitudes gubernamentales y de las fuerzas del orden de información personal identificable y datos de uso de los usuarios de la biblioteca. Los proveedores y las bibliotecas deben tener en cuenta una solicitud gubernamental o de las fuerzas del orden sólo si es emitida por un tribunal de la jurisdicción competente que demuestre una buena causa y esté en la forma adecuada. Los proveedores deben informar y consultar a la biblioteca cuando crean que están obligados a divulgar la información de los usuarios de la biblioteca, a menos que la ley se lo impida. El proveedor también debe informar a los usuarios, a través de sus políticas de privacidad, sobre las condiciones legales en las que podría estar obligado a divulgar información personal identificable.
  • Venta, fusión o quiebra de la empresa: En el caso de que un proveedor se venda a otra empresa, se fusione con otra empresa o se disuelva por quiebra, toda la información de identificación personal debe mantenerse bajo la misma política de privacidad o destruirse de forma segura. Las bibliotecas y sus usuarios deben ser notificados y se les debe proporcionar un método para solicitar que sus datos sean destruidos o exportados de forma segura.

Dispositivos de los usuarios

La protección de la privacidad de la información personal identificable de los usuarios de la biblioteca y de los datos de uso debe extenderse al dispositivo del usuario, incluido el navegador web o cualquier aplicación proporcionada por el proveedor. Todas las comunicaciones entre el dispositivo del usuario y los servicios del proveedor deben estar cifradas. Si el proveedor desea emplear tecnología de personalización, como las cookies persistentes en su sitio web, o permite el seguimiento de la web por parte de terceros, debe notificarlo al usuario y darle la oportunidad de aceptarlo antes de iniciar estas funciones para el usuario. Los usuarios deben ser conscientes de que las experiencias mejoradas de los proveedores pueden requerir la divulgación de datos personales adicionales.

Si una aplicación proporcionada por un proveedor almacena información personal identificable o datos de uso en el dispositivo del usuario, debería estar cifrada. El usuario debe poder eliminar una aplicación proporcionada por un proveedor y borrar cualquier dato almacenado en el dispositivo.

Relación continua de la biblioteca con un tercero

Auditoría y notificación Los proveedores deben establecer y mantener mecanismos eficaces para hacer cumplir sus políticas de privacidad. Deben llevar a cabo auditorías de privacidad periódicas para garantizar que todas las operaciones y servicios cumplen con estas políticas. Los resultados de estas auditorías deben ponerse a disposición de las bibliotecas que sean clientes o posibles clientes, si así lo solicitan.

Respuesta a incidentes Un proveedor que experimenta una violación de datos en sus políticas de seguridad debe notificar a las bibliotecas y usuarios afectados sobre este asunto tan pronto como el proveedor tenga conocimiento de la violación de datos. El plazo de notificación, junto con lo que debe incluirse en la notificación a las bibliotecas y a los usuarios de la biblioteca, difiere de un estado a otro, y es responsabilidad de los proveedores cumplir con la normativa estatal de notificación de violaciones de datos. Las bibliotecas y los proveedores deben planificar el procedimiento de respuesta a incidentes y este plan debe incluirse en el contrato con el proveedor.

Finalización de la relación entre la biblioteca y el proveedor

Las bibliotecas que decidan no renovar un servicio o producto de un proveedor deben trabajar con él para asegurarse de que los datos de los usuarios de la biblioteca que sean personalmente identificables se eliminen de los sistemas del proveedor, incluidos los datos de las copias de seguridad, las copias archivadas y los registros del sistema.

Los proveedores que tienen servicios o productos que permiten el contenido generado por el usuario deben permitir que los usuarios de la biblioteca exporten sus datos en un formato portátil.
Cómo triunfar en los hackatones de ciencia de datos

Amit Raja Naik – How To Ace Data Science Hackathons
OIM, 08/08/2021

Texto completo

Un hackathon, es un termino de la informática que describe un evento social de codificación que reúne a programadores informáticos y otras personas interesadas para mejorar o construir un nuevo programa de software. La palabra hackathon es una contracción de las palabras hacker, que significa programador inteligente, y maratón, un evento marcado por la resistencia, que también se utiliza para la reunión competitiva de cualquiera de otros expertos en un campo para resolver problemas de investigación que de otro modo podrían llevar meses o años. En este caso interesados y expertos en ciencia de los datos.

Los hackathones son una forma estupenda de perfeccionar las habilidades en la ciencia de los datos, aunque pueden ser difíciles de resolver, especialmente para los principiantes. Plataformas como  Kaggle, MachineHack están ayudando a las empresas a contratar a los mejores talentos de la ciencia de datos utilizando el modelo de los hackathones. El mes pasado,  MATHCO.thon concluyó su reto de «predicción del precio de los coches».

En esta experiencia participaron 2.383 profesionales de la ciencia de datos, de los cuales 50 pasaron el corte. Los tres primeros de la clasificación se llevaron premios en metálico. El profesor del IIT Madras, Chandrasekharan Rajendra, dijo que los candidatos deben actualizar continuamente sus conocimientos y diferenciarse participando activamente en hackathones internacionales.

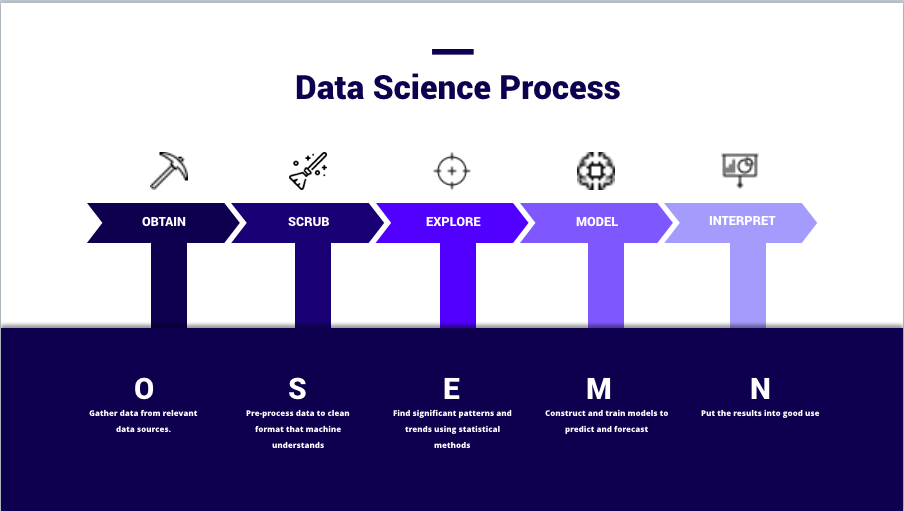
A menudo, cuando hablamos de proyectos de ciencia de datos, nadie parece ser capaz de dar una explicación sólida de cómo se desarrolla todo el proceso. Desde la recopilación de los datos, hasta el análisis y la presentación de los resultados. El marco OSEMN cubre cada paso del ciclo de vida del proyecto de ciencia de datos, desde la obtención, la depuración, la exploración, el modelado y la interpretación de los datos.

Normas federales de cumplimiento de la información sensible en los Estados Unidos

New US Federal Compliance Rules for Sensitive Information ACRL, 2021

Texto completo

Varias agencias federales de los Estados Unidos, en particular el Departamento de Defensa, están avanzando hacia la exigencia de certificaciones o evaluaciones de ciberseguridad, con implicaciones potencialmente significativas para la empresa de investigación de la educación superior. La Asociación de Bibliotecas de Investigación (ARL) ha publicado hoy este Issue Brief: New US Federal Compliance Rules for Sensitive Information que incluye detalles sobre las normas actuales y la actividad en la política de información y las prácticas de ciberseguridad relacionadas en las instituciones de investigación de Estados Unidos y las agencias federales.

Una gran cantidad de información sensible y valiosa es creada, gestionada y almacenada por los investigadores de las universidades de Estados Unidos. Cada vez más esta información es digital, lo que significa que las prácticas eficaces de ciberseguridad han crecido en importancia y visibilidad.

En el caso de los datos y la información producidos como parte de una actividad de investigación de investigación financiada por el gobierno federal, la salvaguarda de la información controlada, clasificada y información no clasificada controlada (CUI) está sujeta a normas y reglamentos federales específicos. Tanto las propias normas y reglamentos como las decisiones que toman los financiadores federales sobre su aplicabilidad, han cambiado sustancialmente en los últimos años. Sin embargo, estas cuestiones no son nuevas. Las instituciones ya están familiarizadas con las normativas gubernamentales que rigen los trabajos que entran en el ámbito del de armas (ITAR), la investigación clasificada a varios niveles y la de la Ley de Portabilidad y Responsabilidad de los Seguros Médicos (HIPAA) (HIPAA) relativa a los datos biomédicos de los pacientes, aunque algunas instituciones han optado por no albergar investigaciones sujetas a algunos de estos controles. La ciberseguridad efectiva también desempeña un papel vital en cumplimiento institucional de los requisitos de privacidad federales y estatales, así como las mejores prácticas más amplías.

Privacidad de datos para la Red Inteligente


41zapxmtf4l._sx313_bo1204203200_

Herold, R. and C. Hertzog. [e-Book] Data Privacy for the Smart Grid, Taylor & Francis, 2015.

Texto completo

Muchos libros de Smart Grid incluyen «privacidad» en su título, pero sólo tocan la privacidad, con la mayoría de la discusión centrada en la seguridad cibernética. Llenando este vacío de conocimiento, Data Privacy for the Smart Grid proporciona una clara descripción del ecosistema de la Smart Grid, presenta una guía práctica sobre sus riesgos de privacidad y detalla las acciones necesarias para proteger los datos generados por las tecnologías de la Smart Grid.


Evaluaciones de impacto de privacidad para repositorios digitales


qtq80-72ll76


Abraham Mhaidli, Libby Hemphill, Florian Schaub. Privacy Impact Assessments for Digital Repositories. International Journal Of Digital Curation
Vol 15 No 1 (2020)
DOI: 10.2218/ijdc.v15i1.692

Texto completo


Los repositorios de datos confiables garantizan la seguridad de sus colecciones. Argumentamos que también deben garantizar la seguridad de los datos del investigador y del sujeto humano. Aquí se demuestra el uso de una evaluación del impacto de la privacidad (PIA) para evaluar los posibles riesgos de privacidad para los investigadores que utilizan el Sistema de credenciales de investigación Open Badges de ICPSR como estudio de caso. Se presenta el flujo de trabajo y se discuten posibles riesgos de privacidad y mitigaciones para esos riesgos.