Archivo de la etiqueta: Gestión de datos de investigación

Convirtiendo la FAIR en realidad: Informe final y plan de acción del grupo de expertos de la Comisión Europea sobre datos de FAIR


dsniq_bvsaarlkw


Turning FAIR into reality: Final Report and Action Plan from the European Commission Expert Group on FAIR Data [e-Book] . Brussels, Directorate-General for Research and Innovation, 2018.

Texto completo


Al abordar el cometido asignado, el Grupo de Expertos en Datos de la FAIR optó por adoptar un enfoque holístico y sistémico para describir la amplia gama de cambios necesarios para «convertir los datos de la FAIR en realidad». Las nociones de posibilidad de localización, accesibilidad, interoperabilidad y reutilización -y las medidas necesarias para hacerlas posibles- están tan profundamente entrelazadas que no tiene sentido abordarlas individualmente.

En cambio, este informe se centra en las medidas necesarias en términos de cultura de investigación y tecnología para garantizar que los datos, los códigos y otros productos de la investigación se conviertan en FAIR. La cultura de investigación y la tecnología son dos caras de un todo. Se necesitan intervenciones coordinadas y simultáneas en cada una de ellas para hacer posible el FAIR en este sentido amplio. La implementación de FAIR será apoyada a través de la Nube Abierta de Ciencia Europea (EOSC). La federación de la infraestructura de datos y la aplicación de normas permitirá el descubrimiento y la interoperabilidad de los datos.

Los Estados miembros deben apoyar este movimiento alineando sus políticas e inversiones en relación con los datos de FAIR y la Ciencia Abierta. En un contexto mundial más amplio, las iniciativas paralelas como el Data Commons de los NIH, el Data Commons de la investigación australiana y también la propuesta Plataforma Africana de Ciencia Abierta son importantes para la aplicación del FAIR. Los avances en la EOSC deberían estar en consonancia con estos movimientos internacionales y garantizar que los datos sean FAIR en todas las disciplinas y fronteras geográficas más allá de Europa.

Las secciones centrales del presente informe se centran en la práctica existente en determinados campos para determinar lo que puede aprenderse de las áreas de investigación que ya han elaborado normas, acuerdos internacionales e infraestructura para hacer posible el FAIR. Estos ejemplos han ayudado a definir los modelos de los objetos digitales FAIR y los componentes esenciales de un ecosistema FAIR. Naturalmente, los principales componentes del ecosistema son los servicios basados en la tecnología. Sin embargo, también se abordan los aspectos sociales que impulsan el sistema y permiten el cambio de cultura, a saber, las aptitudes, la métrica, los incentivos y la inversión sostenible. En el informe se formulan varias recomendaciones detalladas y se especifican medidas para los diferentes grupos de interesados a fin de permitir los cambios necesarios. La puesta en práctica de FAIR es una empresa importante y requiere cambios en cuanto a la cultura de investigación y la provisión de infraestructura.

Esos cambios son importantes en el contexto de la Nube Europea de Ciencia Abierta y la orientación de la política de la Comisión Europea y los Estados miembros, pero van más allá: FAIR requiere acuerdos mundiales para garantizar la más amplia interoperabilidad y reutilización de los datos, más allá de los límites disciplinarios y geográficos. Se formulan 27 recomendaciones, que se agrupan en recomendaciones «prioritarias» y «de apoyo». Las quince recomendaciones prioritarias deben considerarse como el conjunto inicial de cambios o medidas a adoptar para aplicar el FAIR. Las recomendaciones complementarias pueden considerarse como una continuación de las recomendaciones prioritarias, añadiendo detalles específicos o más detallados para su aplicación. Cada recomendación individual va seguida de un conjunto de medidas. Cada Recomendación y cada Acción están numeradas para que su referencia sea inequívoca. El conjunto completo de Recomendaciones y Medidas se presenta en el Plan de Acción FAIR al final de este informe

 

Adquisición y procesamiento de datos en el patrimonio cultural


data_acquisition_and_processing_in_cultural_heritage


Gonzalez-Aguilera, D., G. Bitelli, et al. (2020). [e-Book] Data Acquisition and Processing in Cultural Heritage, MDPI. Texto completo: https://www.mdpi.com/books/pdfdownload/book/2098


Los avances en el conocimiento de los componentes tangibles (posición, tamaño, forma) e intangibles (identidad, hábitos) de un edificio o sitio histórico implica tareas fundamentales y complejas en cualquier proyecto relacionado con la conservación del patrimonio cultural (CH). En los últimos años, las nuevas geotecnologías han demostrado su utilidad y valor añadido al campo del patrimonio cultural (CH) en las tareas de registro, modelización, conservación y visualización. Además, los actuales avances en el modelado de información de edificios (HBIM), permiten la integración y simulación de diferentes fuentes de información, generando un gemelo digital de cualquier construcción compleja de CH.

Como resultado, los expertos en la materia han aumentado el número de sensores y metodologías disponibles. Sin embargo, la rápida evolución de las tecnologías geoespaciales hace necesario revisar su uso, integración y aplicación en el CH. Este proceso es difícil de adoptar, debido a las nuevas opciones que se abren para el estudio, análisis, gestión y valorización del CH. Por consiguiente, el objetivo del presente número especial es abarcar los últimos temas pertinentes, tendencias y prácticas óptimas en materia de tecnologías geoespaciales y metodologías de procesamiento para los emplazamientos y escenarios de CH, así como presentar las nuevas tendencias. Este libro se origina en el Número Especial «Adquisición y Procesamiento de Datos en el Patrimonio Cultural», y se centra principalmente en la integración de datos y sensores para CH; documentación/restauración en CH; documentación y modelado en 3D del patrimonio de sitios complejos de CH; inspecciones de drones en CH; desarrollo de software en CH; y realidad aumentada en CH. Se espera que este libro proporcione el asesoramiento y la orientación necesarios para cualquier profesional del CH, haciendo el mejor uso posible de estos sensores y métodos en el CH.


¿Por qué no se citan los datos y qué hacer al respecto?


data-citation-image


Peter Buneman, Greig Christie, Jamie A Davies, Roza Dimitrellou, Simon D Harding, Adam J Pawson, Joanna L Sharman, Yinjun Wu, Why data citation isn’t working, and what to do about it, Database, Volume 2020, 2020, baaa022, https://doi.org/10.1093/databa/baaa022


Se describe un sistema que genera automáticamente a partir de una base de datos seleccionada una colección de publicaciones breves convencionales (resúmenes de citas) que describen el contenido de varios componentes de la base de datos. El propósito de estos resúmenes es garantizar que los contribuyentes a la base de datos reciban el crédito apropiado a través de las medidas utilizadas actualmente, como los índices h. Además, estos resúmenes también sirven para dar crédito a publicaciones y personas que son citadas por la base de datos. Al hacer esto, tenemos contar con la granularidad: ¿cuántos resúmenes se deben generar para representar efectivamente las contribuciones a una base de datos? También tenemos que lidiar con la evolución: ¿por cuánto tiempo puede servir un resumen dado como referencia apropiada cuando la base de datos está evolucionando? Describimos una revista específicamente diseñada para contener estos resúmenes de citas.

¿Es la privacidad de los datos el precio que debemos pagar para sobrevivir a una pandemia?

10257


Cabrol, Marcelo; Baeza-Yates, Ricardo; González Alarcón, Natalia; Pombo, Cristina. ¿Es la privacidad de los datos el precio que debemos pagar para sobrevivir a una pandemia? Banco Interamericano de Datos (BID), 2020

Texto completo


En la lucha contra el COVID19, miles de millones de datos personales geo-localizados están siendo utilizados por diferentes países alrededor del mundo con el fin de “aplanar la curva” de contagio, para restablecer la circulación de las personas y gestionar mejor el distanciamiento físico entre personas. varios gobiernos han empezado a utilizar herramientas tecnológicas y sistemas de vigilancia para rastrear personas y sus contactos (contact-tracing) y así controlar el contagio. Este tipo de tecnologías es polémico dadas las implicaciones que tiene en cuanto a riesgos en privacidad y las decisiones que están tomando algunos países al respecto. Si entendemos los datos como un bien público (no rival y no excluyente) necesario para mejorar y acelerar la respuesta en medio de una pandemia, ¿se justifica entonces la flexibilización de los estándares de privacidad? ¿justifica el fin último de rastreo y control del contagio como medida de asegurar la salud de todos y reestablecer cierta normalidad social una posible vigilancia intrusiva de los gobiernos?

Nube de Ciencia Abierta Europea (EOSC)


osc


 ‘Realising the European Open Science Cloud’ Report. European Commision, 2016

Texto completo

Portal ESOC

Esta es una nube de datos de investigación en Europa. Antecedentes, información sobre políticas, eventos y publicaciones relacionados con la EOSC. En octubre de 2016, la Comisión Europea publicó el primer informe del Grupo de Expertos de Alto Nivel de la Comisión sobre la Nube Europea de Ciencia Abierta (HLEG EOSC). En el informe se recomienda enmarcar la EOSC como la contribución de la Unión Europea a una futura Internet mundial de datos y servicios de la Nube Científica Abierta (FAIR) sustentada en protocolos abiertos.


«Imagina un entorno federado y accesible a nivel mundial en el que los investigadores, los innovadores, las empresas y los ciudadanos puedan publicar, encontrar y reutilizar los datos y herramientas de cada uno para fines de investigación, innovación y educación. Imagina que todo esto funciona bajo condiciones bien definidas y confiables, apoyado por un modelo sostenible y justo de valor por el dinero… Esto creemos que encapsula el concepto de la Nube Europea de Ciencia Abierta (EOSC)», –

La EOSC es una nueva iniciativa emblemática de la Comisión Europea que tiene por objeto establecer una guía viva para acelerar y apoyar la actual transición hacia una ciencia abierta y una innovación abierta más eficaces en el mercado único digital. La EOSC fomentará las prácticas óptimas de localización y accesibilidad de datos a nivel mundial (datos FAIR), así como el acceso fiable a servicios, sistemas y la reutilización de datos científicos compartidos a través de las fronteras disciplinarias, sociales y geográficas.

El modelo de financiación de los datos de investigación (desde la generación de datos hasta la preservación) debe modificarse radicalmente, pasando de los tradicionales y rígidos planes de financiación del pasado a un plan general de financiación cofinanciado por la CE.

En el informe se recomienda cerrar los debates sobre la «necesidad percibida» de una nube científica y adoptar medidas inmediatas sobre la EOSC en estrecha colaboración con los Estados Miembros, aprovechando la capacidad y los conocimientos especializados existentes. También recomiendan que se redacten normas de compromiso claras para el acceso a la EOSC y para la prestación de servicios basados en datos de investigación (por ejemplo, TDM, análisis de datos, etc.). Pero las repercusiones del informe se extienden más allá en varios aspectos de la política de ciencia abierta en general. Recomiendan que se enmarque a la EOSC como la contribución de la UE a una futura Internet mundial de datos y servicios FAIR respaldada por protocolos abiertos. Recomiendan que se establezca y financie un esfuerzo concertado para desarrollar los conocimientos básicos de datos en Europa. Calculan que se necesita medio millón de «científicos de datos básicos» para aprovechar al máximo los datos de investigación abiertos en Europa. Por último, recomiendan cambiar radicalmente el modelo de financiación de los datos de investigación, pasando de los tradicionales y rígidos planes de financiación del pasado -por ejemplo, la parte pequeña y no contabilizada de una subvención limitada en el tiempo y en el espacio- a un plan general de financiación cofinanciado por los Estados y la Comunidad Europea. Estiman que, en promedio, alrededor del 5% de los gastos totales de investigación debería dedicarse a la gestión adecuada y a la «administración» de los datos de manera integrada.

Las recomendaciones del Grupo de expertos de alto nivel sobre la ciencia y la tecnología constituyen un sólido punto de partida para una mayor reflexión y participación de las comunidades de usuarios científicos, los financiadores de la investigación y los Estados Miembros en la elaboración de la iniciativa


Data sharing: qué son y cómo se pueden compartir los datos de investigación


captura


Andrea Sixto-Costoya, Rafael Aleixandre-Benavent, Antonio Vidal-Infer, Rut Lucas-Domínguez, Lourdes Castelló-Cogollos. Data sharing: qué son y cómo se pueden compartir los datos de investigación. Manual de recomendación para gestores de la información. Documento de trabajo nº 7, 2019 /

Texto completo


El uso compartido de datos es la acción de compartir con el resto de la comunidad científica el material sin procesar generado durante el curso de la investigación que sirve para extraer y validar resultados. Actualmente, el data sharing se engloba dentro de la filosofía de acceso abierto, entendiéndose el compartir datos como una práctica que favorece que la ciencia sea más abierta y accesible.

Desde esta perspectiva de open access, el data sharing promueve que los datos sin procesar puedan tener una “segunda vida” y se puedan utilizar más allá del fin para el que fueron generados en un principio. Estos usos pueden ir desde la reutilización de los datos para producir nuevos estudios, a servir como verificadores de resultados de investigación.

El manejo de datos. Aproximación desde los estudios de la información


e4eda25fca23de1ea2906f91d3d2fc00


Torres Vargas, Georgina Araceli. El manejo de datos. Aproximación desde los estudios de la información. Universidad Nacional Autónoma de México. Coordinación General de Estudios de Posgrado, 2020

Texto completo

ePub


En los estudios de la información, se ha vuelto necesario abordar cómo aprovechar las tecnologías y métodos que existen para efectuar el análisis de datos con el fin de derivar servicios y productos de información acordes con los requerimientos que se tienen en el ámbito de la investigación, de la empresa o de cualquier otro ámbito. Frente a la amplitud de temas que circundan el estudio de los datos, la presente obra tiene por objetivo ofrecer algunas reflexiones en torno al tema del manejo de datos, que por lo general consta de la obtención de datos, su almacenamiento y su tratamiento. Este libro conjunta varias voces de especialistas que nos ayudan a pensar en problemáticas y resoluciones actuales al respecto.

Mapeo del panorama actual del compromiso de la biblioteca de investigación con las tecnologías emergentes en investigación y aprendizaje


technologies-for-industry-40


Lippincott, Sarah. Mapping the Current Landscape of Research Library Engagement with Emerging Technologies in Research and Learning: Executive Summary. Edited by Mary Lee Kennedy, Clifford Lynch, and Scout Calvert. Association of Research Libraries, Born-Digital, Coalition for Networked Information, and EDUCAUSE, March 2020. https://doi.org/10.29242/report.emergingtech2020.landscape.summa.

Texto completo


Parte de la iniciativa conjunta ARL-CNI-EDUCAUSE para avanzar en el impacto de las bibliotecas de investigación en un mundo conformado por tecnologías emergentes , este informe es un resumen ejecutivo de recursos secundarios y discusiones con los líderes de bibliotecas de investigación sobre la adopción de tecnologías emergentes por parte de sus organizaciones.

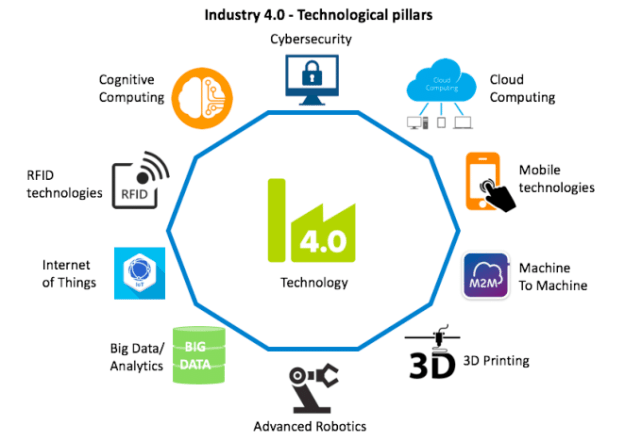
La generación, difusión y análisis de la información digital es un importante motor y consecuencia del cambio tecnológico. Como administradores de datos e información en el espacio físico y virtual, las bibliotecas de investigación están profundamente comprometidas en los desafíos que presenta la Cuarta Revolución Industrial: Industria 4.0, un cambio social impulsado no por el vapor o la electricidad, sino por los datos, y caracterizado por una fusión de los mundos físico y digital. Organizar, estructurar, preservar y proporcionar acceso a volúmenes cada vez mayores de los datos digitales generados y requeridos por la investigación y la industria se convertirá en una función de importancia crítica. En su calidad de asociados de la comunidad de investigadores y estudiosos, las bibliotecas de investigación también están reconociendo y adaptándose a las consecuencias del cambio tecnológico en las prácticas de la erudición y la comunicación académica.


Covid-19: cómo el intercambio de datos sin precedentes ha llevado a una investigación de brotes más rápida que nunca


Virology Lab Work As Europe On Coronavirus High Alert


Covid-19: How unprecedented data sharing has led to faster-than-ever outbreak research Horizon, 23 March 2020 by Ian Le Guillou

Ver completo.

«El impulso hacia la ciencia abierta, los datos abiertos y los preprints realmente ha cambiado la forma en que experimentamos el discurso científico en este brote en comparación con los anteriores», dijo el profesor Richard Neher, de la Universidad de Basilea, Suiza.

Los avances en la secuenciación de genes han permitido a los científicos rastrear y monitorear la pandemia de COVID-19 más rápido que cualquier brote anterior. Sin embargo, las lagunas en nuestro conocimiento de cómo funcionan los coronavirus ha dificultado la comprensión de lo que hace especial al nuevo coronavirus.


Cuando se identificó el nuevo coronavirus (conocido formalmente como SARS-CoV-2) en China en enero, los científicos de todo el mundo estaban listos para responder. Toda la composición genética del virus, o genoma, se publicó en línea en cuestión de días. En comparación, durante el brote de coronavirus del SARS en 2003, esto tomó casi tres meses, después de que la enfermedad se atribuyera originalmente a la clamidia

Los avances en la tecnología han reducido significativamente el costo de la secuenciación de genes y las máquinas ahora son lo suficientemente pequeñas como para caber en la palma de su mano. Esto ha facilitado la secuenciación de una gran cantidad de muestras en todo el mundo.

‘Puede ver en las secuencias cómo se propaga el virus, la velocidad a la que se propaga y estimar la cantidad de personas infectadas. A medida que tenemos más y más secuencias, los números son cada vez más precisos », dijo la profesora Anne-Mieke Vandamme de KU Leuven, Bélgica.

La secuenciación de próxima generación, o NGS, puede generar enormes cantidades de datos, y el desafío es encontrar formas de analizarlos adecuadamente.

Una de las herramientas desarrolladas, llamada Genome Detective, puede tomar los datos sin procesar de la máquina de secuenciación, filtrar los resultados de los no virus, juntar el genoma y usarlo para identificar el virus. No se basa en conjeturas o hipótesis anteriores, por lo que incluso puede identificar virus que no se han visto antes. Esto se utilizó para confirmar el primer caso de COVID-19 en Bélgica, identificándolo como un coronavirus relacionado con el SARS.

El poder de la secuenciación de genes proviene de comparar los resultados en diferentes casos. El profesor Vandamme dice que ha sido ‘fantástico’ ver el nivel de colaboración internacional: ‘Hay mucho más intercambio de datos y secuencias en línea … en comparación con el pasado porque tenemos muchas más herramientas de intercambio en línea disponibles’.

Una de estas herramientas es NextStrain, un recurso en línea que utiliza datos del genoma para monitorear la evolución de los organismos que causan enfermedades como los virus en tiempo real. Ha rastreado varios brotes, incluidos el zika, el ébola y el dengue, e incluso se ha utilizado para informar la política de la Organización Mundial de la Salud sobre la gripe estacional.

Los trabajos de investigación generalmente tardan meses en publicarse, un eón en la carrera actual para enfrentar la pandemia. La necesidad de compartir información rápidamente ha alentado un mayor intercambio de ‘preprints, borradores de documentos que aún no han sido revisados ​​por pares.

«El impulso hacia la ciencia abierta, los datos abiertos y los preprints realmente ha cambiado la forma en que experimentamos el discurso científico en este brote en comparación con los anteriores», dijo el profesor Richard Neher, de la Universidad de Basilea, Suiza, que lidera el proyecto NextStrain.

El no conocimiento y las culturas digitales


5c92ad90a6a5124211c040472bff03cd


Andreas, B., K. Matthias, et al.. [e-Book]  Non-Knowledge and Digital Cultures. Meson Press, 2018

Texto completo


Al poner a disposición cantidades masivas de datos que se generan, distribuyen y modelan, los medios digitales nos ofrecen la posibilidad de disponer de abundante información y conocimiento. Esta posibilidad ha ido atrayendo varios escenarios en los que la tecnología o bien elimina el no conocimiento o bien lo sitúa en lo profundo de las culturas contemporáneas a través del poder universal y la opacidad de los algoritmos.