Archivo de la etiqueta: Inteligencia artificial

Libros de texto inteligentes: Pasado, presente y futuro

Brusilovsky, Peter, y Sergey Sosnovsky. 2024. «Intelligent Textbooks: Past, Present, and Future.» International Journal of Artificial Intelligence in Education. https://link.springer.com/article/10.1007/s40593-024-00451-9.

Los libros de texto siguen siendo una herramienta clave en la educación, pero han evolucionado significativamente en las últimas décadas en términos de creación, publicación, formato, acceso y mantenimiento. Actualmente, la mayoría tiene versiones digitales y se pueden consultar en línea, con un número creciente de recursos educativos abiertos. Además, muchos incluyen bibliotecas de materiales complementarios e incluso se integran en plataformas educativas digitales.

El paso de los libros impresos a los digitales ha impulsado la incorporación de funciones interactivas como búsquedas avanzadas, anotaciones, contenido interactivo, evaluaciones automatizadas y chatbots. Estas mejoras han generado nuevos desafíos y oportunidades para aplicar inteligencia artificial (IA) en el desarrollo y uso de los libros de texto digitales.

Algunas cuestiones clave en este ámbito incluyen cómo mejorar el acceso y la lectura, extraer conocimiento implícito en los textos para optimizar el aprendizaje, analizar los registros de interacción de los estudiantes, enriquecer el contenido con información externa y utilizar tecnologías de lenguaje avanzado para personalizar la experiencia educativa.

En este contexto, el campo de los Libros de Texto Inteligentes ha pasado por distintas generaciones de desarrollo. La primera generación, basada en sistemas de tutoría inteligente e hipertexto educativo, ofrecía personalización a través de estructuras predefinidas por expertos en el dominio. Con el avance de la web, estos libros adoptaron formatos tradicionales con tablas de contenido y glosarios, incorporando técnicas como navegación adaptativa, recomendación de contenido y personalización del aprendizaje. Sin embargo, operaban en entornos cerrados con materiales cuidadosamente seleccionados y estructurados.

Este desarrollo ha generado diversas generaciones de «libros de texto inteligentes»:

Primera Generación: Inteligencia Diseñada

Esta fase inicial surgió de la intersección entre los sistemas de tutoría inteligentes y los hipermedios educativos adaptativos. Los primeros prototipos no presentaban el formato tradicional de los libros de texto; en su lugar, proporcionaban a los estudiantes acceso adaptativo a elementos de información o «hiper-tarjetas» en respuesta al rendimiento en ejercicios asociados. Con la popularización de la web, estos libros adoptaron una estructura más convencional, incorporando técnicas de personalización como soporte de navegación, manipulación adaptativa de páginas, recomendación de contenido y secuenciación de contenidos. Estos sistemas eran entornos de corpus cerrado, ofreciendo colecciones limitadas de textos y ejercicios diseñados meticulosamente.

Segunda Generación: Inteligencia Integrada

En esta etapa, la atención se centró en aspectos prácticos como arquitecturas abiertas, integración con recursos educativos externos y estandarización de modelos semánticos. El desarrollo de tecnologías de la Web Semántica permitió la representación de conocimientos compartibles y soluciones arquitectónicas para software inteligente. Esto facilitó la implementación de modelos de conocimiento como ontologías y la integración de materiales educativos interconectados, permitiendo a los libros de texto «comprender» su contenido y participar en interacciones más significativas con los estudiantes, como responder preguntas y crear mapas conceptuales.

Tercera Generación: Inteligencia Extraída

Con el avance de técnicas de Procesamiento de Lenguaje Natural (PLN) y Aprendizaje Automático (AA), los investigadores comenzaron a ver los libros de texto no solo como herramientas educativas, sino también como fuentes ricas de contenido de alta calidad. Se aplicaron métodos para extraer automáticamente temas, conceptos, relaciones e incluso modelos completos de conocimiento de los textos digitales. Esta capacidad permitió transformar automáticamente libros de texto en versiones inteligentes, enlazándolos con contenido interactivo externo y conectándolos entre sí.

Cuarta Generación: Inteligencia Minada de Datos

La adopción creciente de libros de texto digitales generó una abundancia de datos sobre la interacción de los estudiantes. Se emplearon métodos de minería de datos para analizar estos registros, permitiendo comprender mejor los comportamientos de lectura y su relación con el progreso académico. Los patrones de navegación y las actividades de anotación se utilizaron para predecir el éxito o fracaso de los estudiantes, facilitando intervenciones oportunas. Además, estos datos ayudaron a modelar el conocimiento de los estudiantes sobre conceptos específicos y mejorar la organización y presentación de los contenidos.

Quinta Generación: Inteligencia Generada

Recientemente, la incorporación de modelos de lenguaje de gran escala (LLMs) ha revolucionado los libros de texto inteligentes. Estos modelos, entrenados con vastas cantidades de datos textuales, pueden extraer y sintetizar información de los libros de texto, ofreciendo respuestas automáticas a preguntas y reduciendo problemas como las «alucinaciones» en las respuestas generadas. Además, se han utilizado para crear experiencias interactivas, como chatbots que simulan conversaciones tutor-estudiante, mejorando la interacción y personalización del aprendizaje.

Conclusiones

A pesar de su larga historia, los libros de texto inteligentes siguen siendo un campo de innovaciones en el que se introducen y exploran nuevos enfoques en diversos estudios. Los investigadores de libros de texto inteligentes adoptan con entusiasmo tecnologías desarrolladas fuera de este campo y plantean casos de uso y escenarios de aplicación que amplían las capacidades y la eficacia potencial de los prototipos de libros de texto. Los libros de texto siguen siendo una de las principales fuentes de conocimiento para los estudiantes, a pesar de que los contenidos más interactivos y no textuales están ganando popularidad en muchas otras tareas y contextos.

Ha llegado el momento de que los libros de texto aumenten su funcionalidad con características interactivas que mejoren la eficacia general de los libros de texto como herramientas de aprendizaje. Las interfaces adaptables de los libros de texto, los contenidos inteligentes, los servicios inteligentes y las herramientas centradas en la comunidad para interactuar con otros usuarios transformarán el estudio de los alumnos con libros de texto en una experiencia de aprendizaje más interactiva y social. La nueva ola de IA generativa que ya alimenta la actual generación de libros de texto inteligentes abre un amplio abanico de posibilidades para hacer que el aprendizaje con libros de texto sea aún más interactivo y atractivo. Los LLM son muy capaces de transferir eficazmente lo que aprenden del preentrenamiento en textos a escala web a diferentes contextos, lo que se traduce en altos niveles de fluidez y coherencia del texto generado. Actualmente, la dirección más popular de estos trabajos es utilizar los LLM para producir automáticamente preguntas de evaluación para libros de texto inteligentes, con resultados iniciales prometedores. Además, se están construyendo nuevos prototipos de libros de texto inteligentes que emplean IA generativa para apoyar nuevas formas significativas de interacción. Esperamos más trabajos interesantes que utilicen el potencial de estos modelos en diversas formas de apoyo al alumno en torno a los libros de texto inteligentes, especialmente si se basan en el éxito de la investigación anterior.
Educase 2025: impacto de la inteligencia artificial (IA) en la educación superior

Robert, Jenay, y Mark McCormack. 2025 EDUCAUSE AI Landscape Study: Into the Digital AI Divide. EDUCAUSE, 17 de febrero de 2025. https://www.educause.edu/content/2025/2025-educause-ai-landscape-study/introduction-and-key-findings

Este estudio examina el impacto de la inteligencia artificial (IA) en la educación superior, abordando estrategias institucionales, normativas, casos de uso, el impacto en la fuerza laboral y la brecha digital entre instituciones. La investigación se basó en una encuesta realizada entre el 4 y el 18 de noviembre de 2024.

Los hallazgos clave incluyen el aumento en la percepción de la IA como una prioridad estratégica, la expansión de políticas de uso aceptable, la predominancia de la enseñanza y el aprendizaje como áreas de aplicación y la diferencia de recursos entre instituciones grandes y pequeñas. Además, el estudio destaca la necesidad de alfabetización en IA y el desafío de financiar su implementación.

Hallazgos clave

  1. Estrategia y liderazgo
    • El 57% de los encuestados considera que la IA es una prioridad estratégica, un aumento respecto al 49% del año anterior.
    • La formación en IA para el profesorado (63%) y el personal administrativo (56%) es un enfoque clave en la planificación estratégica.
    • Solo el 2% de las instituciones financia los costos adicionales de la IA con nuevas fuentes de financiación, y el 34% de los líderes ejecutivos considera que se han subestimado estos costos.
  2. Políticas y normativas
    • El número de instituciones con políticas de uso aceptable de IA aumentó del 23% al 39% en un año.
    • Solo el 9% considera que sus políticas de ciberseguridad y privacidad son adecuadas para gestionar los riesgos asociados con la IA.
  3. Casos de uso
    • La enseñanza y el aprendizaje son los principales ámbitos de aplicación de la IA, con énfasis en la integridad académica (74%), la realización de trabajos (65%), las evaluaciones (54%) y el diseño curricular (54%).
    • El 68% de los encuestados indica que los estudiantes usan IA más que los docentes, aunque la formación está más centrada en el profesorado.
  4. Fuerza laboral
    • El 37% de las instituciones están enfocadas en mejorar las habilidades de IA del personal existente en lugar de contratar nuevos empleados (1%).
    • Se destaca la importancia de la «alfabetización en IA» para todos los trabajadores y el uso de IA para aumentar la productividad.
  5. Brecha digital en IA entre instituciones
    • Instituciones pequeñas y grandes tienen percepciones similares sobre el uso personal y futuro de la IA.
    • Sin embargo, las instituciones más grandes cuentan con más recursos y capacidades para adoptar la IA de manera efectiva.

Este informe resalta la creciente importancia de la IA en la educación superior, la necesidad de políticas claras y formación especializada, y la persistente desigualdad en el acceso a los beneficios de la IA entre instituciones de distintos tamaños.

Sam Altman, CEO de OpenAI, admite que los beneficios de la IA podrían no distribuirse ampliamente

Wiggers, Kyle. «OpenAI CEO Sam Altman Admits That AI’s Benefits May Not Be Widely Distributed.» TechCrunch, 9 de febrero de 2025. https://techcrunch.com/2025/02/09/openai-ceo-sam-altman-admits-that-ais-benefits-may-not-be-widely-distributed/

En un ensayo reciente en su blog personal, Sam Altman, CEO de OpenAI, expresó que la compañía está abierta a ideas inusuales, como el concepto de un «presupuesto de cómputo», para permitir que todos en el mundo utilicen IA y garantizar que sus beneficios sean distribuidos de manera más equitativa. Altman destacó que, aunque los avances tecnológicos mejoran indicadores como la salud y la prosperidad económica, la igualdad no está garantizada por la tecnología y puede requerir intervenciones tempranas.

El concepto del «presupuesto de cómputo» de Altman podría ser difícil de ejecutar, ya que la IA ya está impactando el mercado laboral con recortes de empleos. Expertos advierten que el desempleo masivo podría ser una consecuencia si no se implementan políticas gubernamentales adecuadas y programas de reentrenamiento.

Altman también habló sobre la inteligencia artificial general (AGI), que define como un sistema de IA capaz de resolver problemas complejos a nivel humano en diversas áreas. Aunque la AGI está cerca, según Altman, no será perfecta y necesitará supervisión humana. La verdadera utilidad de la AGI, según él, provendrá de su escala masiva, con miles o millones de sistemas de IA trabajando en diversas tareas.

A pesar de los altos costos asociados al desarrollo de IA, Altman mencionó que el costo de usar un nivel determinado de IA disminuye cada 12 meses. OpenAI está trabajando en la creación de una red de datos masiva y buscando inversiones de hasta 40 mil millones de dólares.

En cuanto a la seguridad de la AGI, Altman indicó que OpenAI tomará decisiones y limitaciones impopulares para asegurar que la tecnología no sea mal utilizada, especialmente por gobiernos autoritarios. Además, subrayó que OpenAI tiene como objetivo empoderar a los individuos, sin perder de vista la necesidad de equilibrar la seguridad con la autonomía personal.

OpenAI podría marcar con una «marca de agua» el texto generado por ChatGPT, pero aún no lo ha hecho

Beschizza, Rob. «OpenAI Could Watermark the Text ChatGPT Generates, but Hasn’t.» Boing Boing, 5 de agosto de 2024. https://boingboing.net/2024/08/05/openai-could-watermark-the-text-chatgpt-generates-but-hasnt.html

OpenAI ha desarrollado un sistema de «marca de agua» para detectar cuando ChatGPT genera texto, pero ha decidido no implementarlo, según informes de The Wall Street Journal. El sistema, que podría detectar con precisión si un estudiante usó ChatGPT para escribir un ensayo, ha estado listo durante un año, pero ha sido objeto de debates internos dentro de la compañía.

OpenAI afirma que aunque el sistema es 99.9% fiable en textos sin editar, es «fácil de evadir». La marca de agua funciona bien contra alteraciones locales, como la paráfrasis, pero es menos efectiva contra ediciones más globales, como la traducción o el uso de otros modelos generativos. Además, la compañía ha señalado que este método podría tener efectos negativos, como estigmatizar a los no hablantes nativos de inglés que usan la IA como herramienta de escritura.

De modo que aunque la tecnología de marca de agua de OpenAI es precisa en situaciones controladas, se puede eludir fácilmente con modificaciones más profundas, lo que hace que su uso sea poco confiable para detectar textos generados por IA en la práctica.

Thomson Reuters gana una sentencia de «uso justo» de los derechos de autor de IA contra Ross Intelligence

Reuters. «Thomson Reuters Wins AI Copyright Fair Use Ruling Against One-Time Competitor.» Reuters, 11 de febrero de 2025. https://www.reuters.com/legal/thomson-reuters-wins-ai-copyright-fair-use-ruling-against-one-time-competitor-2025-02-11/

Sentencia

El fallo reciente de un juez federal en Delaware a favor de Thomson Reuters en un caso de derechos de autor contra Ross Intelligence ha generado un importante precedente legal en el ámbito de la inteligencia artificial (IA) y el uso de contenido protegido. Este veredicto, emitido por el juez Stephanos Bibas, es el primero en los Estados Unidos que aborda específicamente la doctrina de uso justo (fair use) en el contexto de litigios relacionados con la IA.

Ross Intelligence, una firma de investigación legal que ya no está operativa, fue acusada de utilizar contenido protegido por derechos de autor de Thomson Reuters para desarrollar una plataforma de investigación legal basada en IA que competía directamente con Westlaw, el reconocido servicio de investigación legal de Thomson Reuters. En su decisión, Bibas reconsideró un fallo anterior en el que había sugerido que la determinación sobre el uso justo debería ser realizada por un jurado. Tras un análisis más detallado de los materiales del caso, el juez concluyó que Ross había infringido los derechos de autor al desarrollar un sustituto de mercado utilizando contenido de Thomson Reuters.

La doctrina de uso justo permite, bajo ciertas condiciones, el uso de obras protegidas sin permiso expreso, como en parodias, investigación no comercial o producción de noticias. Sin embargo, los tribunales evalúan el uso justo mediante un test de cuatro factores: el propósito del uso, la naturaleza de la obra original, la cantidad utilizada y el impacto en el valor de mercado de la obra original. Thomson Reuters prevaleció en dos de estos cuatro factores, y el juez Bibas enfatizó que el cuarto factor, el impacto en el mercado, era el más crucial, ya que Ross buscaba competir directamente con Westlaw.

Este fallo ha generado preocupación entre las empresas de IA, ya que podría influir en otros casos similares en curso contra gigantes tecnológicos como OpenAI y Microsoft. James Grimmelmann, profesor de derecho digital e internet en la Universidad de Cornell, señaló que si esta decisión se adopta en otros tribunales, representaría un obstáculo significativo para las empresas de IA generativa, ya que muchos de los argumentos legales que utilizan para defenderse podrían considerarse irrelevantes.

Es importante destacar que este caso involucra una IA no generativa, a diferencia de las herramientas de IA generativa como los modelos de lenguaje de gran tamaño (LLM). Ross Intelligence cerró en 2021, alegando que la demanda de Thomson Reuters era infundada, pero que no podía recaudar suficientes fondos para continuar operando mientras se enfrentaba al litigio.

Este precedente podría afectar profundamente el desarrollo y uso de la IA, especialmente en el contexto de la utilización de contenido protegido, y plantea interrogantes sobre cómo las empresas de tecnología podrán entrenar sus modelos sin infringir derechos de autor. A medida que otros casos similares avanzan en los tribunales, la industria de la IA está atenta a las posibles implicaciones legales de este fallo.

Microsoft ofrece a los autores 5.000 dólares por entrenar la IA con sus libros

Bastian, Matthias. «Microsoft Offers Authors $5,000 to Train AI on Their Books.» THE DECODER, February 9, 2025. https://the-decoder.com/microsoft-offers-authors-5000-to-train-ai-on-their-books/

Microsoft ha adoptado un enfoque innovador para utilizar libros con derechos de autor en el entrenamiento de inteligencia artificial (IA) al ofrecer pagos a los autores de HarperCollins. Este acuerdo pone de relieve cómo la industria valora el trabajo creativo en la era de la IA.

Microsoft ha propuesto un acuerdo de licencias con el editor HarperCollins para utilizar libros con derechos de autor en el entrenamiento de inteligencia artificial (IA), ofreciendo 5.000 dólares por cada libro. Los autores recibirían la mitad de esa cantidad, es decir, 2.500 dólares por libro. Esta oferta ha generado dudas entre los autores, quienes deben decidir si aceptan o no, ya que es difícil determinar si la compensación es justa. La autora Alice Robb, que recibió esta oferta para su libro Why We Dream, comenta que su obra ya se había utilizado sin permiso para entrenar sistemas de IA, probablemente por Microsoft o OpenAI.

El acuerdo refleja un intento de Microsoft por establecer un valor monetario para los derechos de entrenamiento de IA sobre libros, dirigiéndose especialmente a libros antiguos cuyos autores no reciben regalías. Mientras tanto, algunas empresas de IA defienden que el «uso justo» les permite entrenar IA con obras protegidas por derechos de autor sin compensación, lo que ha llevado a múltiples demandas.

Este enfoque de Microsoft sugiere que las grandes compañías de IA podrían estar retrocediendo en su postura de que usar contenido protegido por derechos de autor sin permiso es legal, adoptando un enfoque más reflexivo sobre la compensación a los creadores.

La Comisión Europea publica unas directrices sobre la definición de sistemas de inteligencia artificial (IA)

European Commission. (2025, February 2). The Commission publishes guidelines on prohibited artificial intelligence (AI) practices as defined by the AI Act. Digital Strategy. https://digital-strategy.ec.europa.eu/en/library/commission-publishes-guidelines-prohibited-artificial-intelligence-ai-practices-defined-ai-act

La Comisión Europea ha publicado unas directrices sobre la definición de sistemas de inteligencia artificial (IA) para facilitar la aplicación de las primeras normas del Acta de Inteligencia Artificial (AI Act).

Estas directrices tienen como objetivo ayudar a los proveedores y otras partes relevantes a determinar si un sistema de software califica como un sistema de IA, promoviendo así una aplicación efectiva de las reglas establecidas. Aunque no son vinculantes, las directrices se actualizarán conforme surjan nuevas experiencias, cuestiones o casos de uso.

El AI Act clasifica los sistemas de IA en diversas categorías de riesgo, como prohibidos, de alto riesgo y aquellos sujetos a obligaciones de transparencia. Desde el 2 de febrero, han comenzado a aplicarse las primeras reglas bajo este acta, que incluyen la definición de sistemas de IA, la alfabetización en IA y un número limitado de casos de uso de IA prohibidos debido a los riesgos inaceptables que representan en la Unión Europea.

Varias bibliotecas universitarias estadounidenses trabajan en un proyecto cooperativo de definición e Implementación de Alfabetización en IA

MacDougall, R., McBride, M., & Ruediger, D. (2025). Defining and implementing AI literacy: Announcing a new cohort project. Ithaka S+R. https://www.ithaka.org/defining-implementing-ai-literacy

Ante la expansión de la inteligencia artificial generativa, las universidades están reconociendo la necesidad de que los estudiantes aprendan a utilizar la IA de manera responsable y piensen críticamente sobre su rol en la sociedad. Sin embargo, definir e implementar la alfabetización en IA es un desafío debido a la rápida evolución de las tecnologías y la dificultad de predecir el impacto que la IA tendrá en la enseñanza, el aprendizaje, la preparación profesional y la vida cívica.

Crear marcos institucionales específicos para la alfabetización en IA y desarrollar los programas y recursos necesarios para integrarla en la educación universitaria requerirá la colaboración de diversos sectores dentro de la universidad. Las bibliotecas están en una posición privilegiada para liderar estos esfuerzos, tanto a nivel campus como nacional. Emplean expertos en ciencias de la información y, en muchas instituciones, tienen una larga tradición como proveedores clave de enseñanza sobre otras literacidades modernas esenciales, como la alfabetización en datos o la alfabetización digital. Ithaka S+R está ha anunciado un nuevo proyecto de cohorte, patrocinado parcialmente por JSTOR, que se centra en ayudar a las bibliotecas a enfrentar el desafío de la alfabetización en IA.

Ithaka S+R organizará un grupo de 15 universidades comprometidas con promover la alfabetización en IA como un resultado clave del aprendizaje. Durante la fase de exploración, las instituciones participantes se reunirán para conversaciones estructuradas e intercambio de información, con el objetivo de situar sus metas de alfabetización en IA en relación con los marcos existentes de alfabetización en IA e información. Los participantes colaborarán con Ithaka S+R para crear y personalizar una guía de entrevistas diseñada para comprender mejor las expectativas, experiencias y necesidades de estudiantes y profesores.

En la fase de investigación del proyecto, los equipos de investigación locales realizarán entrevistas con las comunidades del campus. Ithaka S+R trabajará con cada institución para finalizar los instrumentos, ayudar a desarrollar una estrategia de muestreo y reclutamiento para las entrevistas con estudiantes e instructores, y proporcionar apoyo durante todo el proceso. En la fase de difusión, los participantes compartirán los resultados de sus entrevistas y trabajarán en colaboración para idear nuevos servicios o revisiones de servicios existentes en un simposio interno. Ithaka S+R publicará un informe final basado en el análisis agregado de las entrevistas realizadas durante el proyecto.

Las instituciones que han confirmado su participación en el proyecto de alfabetización en IA son Alfred University, Buffalo State University, Chapman University, Montana State University, Santa Clara University, SUNY-Empire State y Virginia Tech. Estas universidades se han comprometido a promover la alfabetización en IA como un objetivo clave de aprendizaje, contribuyendo al desarrollo de marcos específicos que integren esta competencia en la educación universitaria.

Confianza y conocimiento de la IA en Estados Unidos

Ognyanova, Katherine, y Vivek Singh. «National AI Opinion Monitor: AI Trust and Knowledge in America.» USA, febrero de 2025. Rutgers University.

Texto completo

Un estudio dirigido por la Universidad de Rutgers ha identificado una creciente brecha en la confianza y el uso de la inteligencia artificial (IA) en Estados Unidos. Según los resultados de la encuesta, las personas con mayores ingresos y niveles educativos son más propensas a utilizar, confiar y conocer la tecnología de IA.

La encuesta, parte del National AI Opinion Monitor (NAIOM), se realizó entre el 25 de octubre y el 8 de noviembre de 2024, con la participación de casi 4.800 personas de distintos grupos demográficos y niveles socioeconómicos. Se evaluó la confianza en los sistemas de IA, en las empresas que los desarrollan y en el contenido generado por IA.

Principales hallazgos:

  • Confianza en la IA: El 47% de los encuestados expresó “bastante” o “mucha” confianza en que la IA actúe en beneficio del público, un porcentaje superior al de la confianza en las redes sociales (39%) o el Congreso (42%).
  • Grupos con mayor confianza: La confianza en la IA es mayor entre los jóvenes de 18 a 24 años (60%), quienes ganan más de 100,000 dólares al año (62%) y quienes poseen estudios de posgrado (60%).
  • Desigualdad en el acceso: Según la profesora Katherine Ognyanova, coautora del estudio, la brecha de confianza en la IA aún no es insalvable, pero si la tecnología sigue siendo más accesible para los grupos de ingresos altos, podría acentuar las desigualdades económicas y limitar oportunidades para otros sectores.

El 62% de los encuestados confía en las noticias producidas por periodistas, mientras que solo el 48% confía en contenido generado por inteligencia artificial (IA). Esto refleja una mayor confianza en el periodismo tradicional frente a la automatización en la producción de noticias.

A pesar de ello, muchas personas tienen dificultades para identificar contenido generado por IA. Solo el 43% de los participantes se siente “algo” o “muy” seguro de poder diferenciar entre noticias creadas por humanos y aquellas generadas por IA. Sin embargo, menos de la mitad tiene certeza de poder hacerlo con precisión, lo que sugiere la necesidad de mayor educación en alfabetización digital.

Aunque la desconfianza hacia el contenido generado por IA es alta, muchas organizaciones de noticias ya utilizan herramientas automatizadas para agilizar la producción de información. Un ejemplo de ello es Lynx Insight de Reuters, que permite generar reportes breves que luego son revisados y editados por periodistas antes de su publicación.

El estudio también evaluó el nivel de conocimiento sobre IA mediante una serie de preguntas a los participantes, dividiéndolos en tres grupos según sus respuestas correctas. El 27% mostró un bajo conocimiento (0-2 respuestas correctas), el 51% tuvo un conocimiento medio (3-4 respuestas correctas) y solo el 23% demostró un alto conocimiento (5-8 respuestas correctas).

El nivel de conocimiento en IA está directamente relacionado con la educación y los ingresos. Entre quienes tienen estudios de posgrado, el 29% mostró un alto nivel de conocimiento, frente al 20% de aquellos sin estudios universitarios. De manera similar, el 27% de quienes ganan más de 100,000 dólares al año demostraron altos conocimientos de IA, comparado con solo el 19% de quienes ganan menos de 25,000 dólares.

Los investigadores enfatizan la importancia de integrar la educación en IA en los planes de estudio desde la educación básica (K-12). La profesora Ognyanova destaca que la alfabetización informativa debe evolucionar al ritmo de los avances tecnológicos, ya que actualmente solo un tercio de la población tiene un conocimiento básico sobre IA.

La BBC denuncia imprecisiones en los resúmenes de noticias generados por IA

Rahman-Jones, Imran. «AI Chatbots Unable to Accurately Summarise News, BBC Finds.» BBC News, February 11, 2025. https://www.bbc.com/news/articles/c0m17d8827ko.

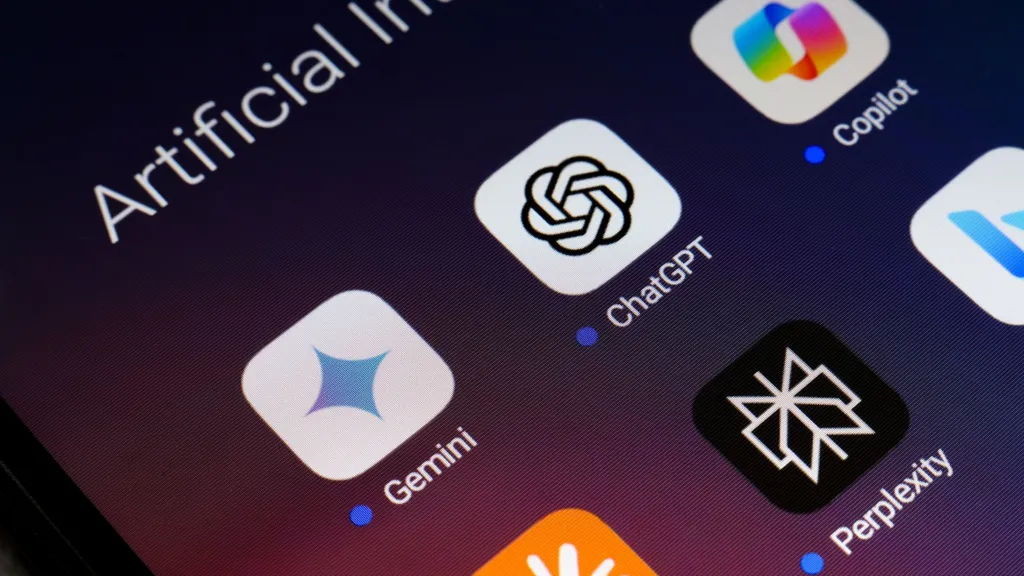
Un estudio de la BBC encontró que cuatro chatbots de inteligencia artificial—ChatGPT (OpenAI), Copilot (Microsoft), Gemini (Google) y Perplexity—fallan al resumir con precisión noticias, presentando distorsiones y errores significativos.

En el experimento, la BBC les pidió a estos modelos que resumieran 100 noticias de su sitio web y expertos evaluaron sus respuestas. Se detectó que el 51 % de las respuestas tenía problemas importantes y que el 19 % de aquellas que citaban contenido de la BBC contenían errores factuales, como datos y fechas incorrectas.

Algunos ejemplos de inexactitudes incluyen: Gemini afirmando erróneamente que el NHS no recomienda el vapeo para dejar de fumar, ChatGPT y Copilot diciendo que Rishi Sunak y Nicola Sturgeon aún estaban en el cargo tras haberlo dejado, y Perplexity tergiversando una noticia sobre Medio Oriente.

La directora de BBC News, Deborah Turness, advirtió que las empresas de IA están «jugando con fuego» y pidió que las compañías tecnológicas «retiren» estos resúmenes, como ya hizo Apple tras quejas previas de la BBC.

El informe también señala que los chatbots no solo presentan errores fácticos, sino que tienen dificultades para diferenciar entre opinión y hechos, editorializan y omiten contexto esencial. La BBC busca dialogar con las empresas de IA para encontrar soluciones y garantizar que los editores tengan control sobre el uso de su contenido.

El informe, además señala que, en general, Copilot y Gemini fueron los chatbots con mayores problemas, mientras que ChatGPT y Perplexity mostraron un desempeño algo mejor, aunque también presentaron errores significativos.