La circulación de la información y la verdad : claves para su abordaje / Agustina Ahibe … [et al.] ; Editado por Mariano Dagatti ; Margoth Mena-Young. – 1a ed. – Ciudad Autónoma de Buenos Aires : CLACSO ; Guadalajara : CALAS, 2025.
El libro aborda los desafíos que enfrentan las democracias contemporáneas en un entorno informativo cada vez más complejo, marcado por la desinformación, la distorsión informativa, la polarización y la crisis de autoridad del periodismo. Coordinado por Mariano Dagatti y Margoth Mena-Young, la obra reúne contribuciones de destacados investigadores latinoamericanos y europeos con el fin de analizar cómo estos fenómenos transforman la relación entre ciudadanía, medios y conocimiento en la era digital.
La circulación de la información y la verdad indaga en las tensiones entre verdad, desinformación y democracia, desde una mirada crítica. A partir de conceptos clave como credibilidad, verificación, polarización, algoritmos y educación mediática, analiza cómo se construyen, filtran y consumen las noticias en un entorno marcado por el desorden informativo.
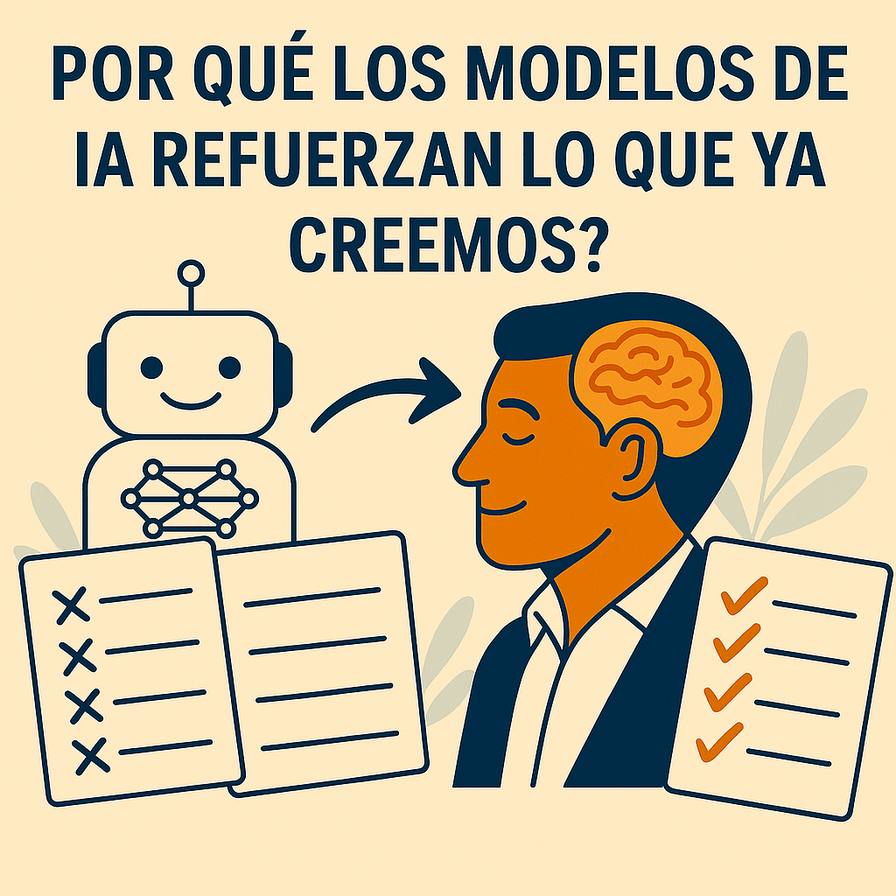
El artículo cuenta por qué herramientas como ChatGPT pueden llevar a los usuarios a profundizar en líneas de pensamiento cada vez más específicas, a veces hasta puntos extremos o sesgados, en lo que comúnmente se conoce como “caer en un sesgo o bucle de confirmación” digital.
El sesgo de confirmación (también llamado sesgo confirmatorio) es una tendencia psicológica que lleva a las personas a buscar, interpretar y recordar información de manera que confirme sus propias creencias y expectativas preexistentes, mientras ignoran o desestiman información que las contradiga.
Según Leung, este comportamiento no se debe únicamente al diseño del modelo de lenguaje, sino a un patrón compartido con los motores de búsqueda y otras herramientas digitales: las personas tienden a confirmar sus creencias iniciales. Esto se traduce en que, cuando un usuario realiza una consulta a ChatGPT, lo hace ya desde una postura determinada. Por ejemplo, si alguien sospecha que cierto alimento es dañino, probablemente formulará su pregunta de forma que ya presupone esa posibilidad. El sistema, a su vez, genera respuestas que encajan con esa narrativa, confirmando la suposición en lugar de cuestionarla.
Esta interacción desencadena un bucle de retroalimentación. Cuanto más pregunta el usuario en esa dirección, más contenido relacionado obtiene, lo que le lleva a profundizar aún más en esa perspectiva. Este proceso es lo que se conoce como “cascada de profundidad” y puede dar lugar a una especie de efecto túnel, donde se van perdiendo matices, dudas o puntos de vista alternativos. En el caso de temas sensibles como la política, la salud, las creencias personales o las teorías de la conspiración, este efecto puede ser especialmente problemático, ya que facilita la consolidación de ideas erróneas o distorsionadas.
Uno de los elementos clave de este fenómeno es la forma en que los modelos responden a las preguntas: su diseño se basa en ofrecer respuestas que parezcan relevantes, coherentes y satisfactorias según el contexto de la conversación. Sin embargo, esto no siempre equivale a una respuesta imparcial o equilibrada. En muchos casos, el sistema simplemente sigue la lógica del usuario y refuerza su hipótesis, en lugar de introducir elementos de contraste o una visión crítica.
Aunque el artículo no presenta una solución definitiva, sí deja entrever algunas estrategias útiles para contrarrestar este efecto. En primer lugar, es esencial que los usuarios sean conscientes de sus propios sesgos y del modo en que estos influyen en la formulación de preguntas. También se sugiere que se practique la variación intencional de las consultas, explorando diferentes formas de abordar un mismo tema. Finalmente, se menciona la posibilidad de diseñar modelos que incluyan mecanismos para ofrecer perspectivas alternativas o advertencias sobre posibles sesgos presentes en la conversación.
En conclusión, ChatGPT tiene una base científica y psicológica sólida. La tendencia humana a buscar confirmación de nuestras ideas, unida al diseño de las respuestas generadas por IA, puede llevarnos a reforzar creencias sin darnos cuenta. Este descubrimiento invita tanto a usuarios como a desarrolladores a promover un uso más consciente, crítico y equilibrado de estas herramientas.
El 2 de abril, se conmemora el Día Internacional de la Verificación de Hechos. Esta fecha, promovida por la International Fact-Checking Network, subraya la importancia crucial de verificar la información para promover un discurso público honesto, invalidar mitos y reforzar la responsabilidad en el periodismo.
En un mundo saturado de desinformación, las bibliotecas continúan siendo un refugio vital donde las personas pueden distinguir entre hechos y ficción. Mientras navegamos en el “laberinto moderno” para encontrar la verdad, las bibliotecas se mantienen como un baluarte contra la propaganda y la información falsa.
Sin embargo, el artículo alerta sobre recientes órdenes ejecutivas del gobierno federal (109 órdenes para el 1 de abril) que afectan negativamente a las bibliotecas y museos en Estados Unidos, en particular al Instituto de Servicios para Museos y Bibliotecas (IMLS), que apoya financieramente a estas instituciones. Todo el personal del IMLS está en licencia administrativa pagada, lo que podría perjudicar especialmente a bibliotecas y museos rurales y pequeños.
Un ejemplo del impacto positivo del IMLS es un proyecto en Nebraska que, en 2019, proporcionó fondos para crear “estudios de innovación” itinerantes en bibliotecas rurales, ofreciendo a las comunidades herramientas, materiales y programas para fomentar la creatividad y el emprendimiento local. Este instituto apoya todos los tipos de bibliotecas y museos, siendo la única agencia federal dedicada a sostener este ecosistema cultural en Estados Unidos.
La American Library Association (ALA) expresó su preocupación porque las medidas administrativas amenazan servicios esenciales como programas de alfabetización temprana, acceso a internet de alta velocidad, asistencia para empleo, recursos para tareas escolares e investigación, y materiales accesibles para la lectura. Según estudios internos, la mayoría de los votantes y padres considera que las bibliotecas públicas locales desempeñan un papel fundamental en sus comunidades.
El gobierno de Trump defendió los recortes como una forma de fortalecer la integridad y reducir la burocracia federal, alegando que se eliminaban iniciativas consideradas “discriminatorias” o “antiamericanas”, especialmente aquellas relacionadas con diversidad, equidad e inclusión (DEI). El autor cuestiona este mandato dado que el presidente ganó con apenas el 49.81% del voto y señala la contradicción de acusar de “antiamericanismo” a instituciones que justamente promueven diversidad cultural, ideas y arte.
El artículo enfatiza que las bibliotecas y museos son lugares de diversidad, imaginación, comunidad y conocimiento, proporcionando acceso a la verdad, estimulando la creatividad y funcionando como espacios de exploración y asombro para todas las edades, a través de libros, tecnología, clases y numerosos programas.
El autor confiesa ser un apasionado lifelong de las bibliotecas, recordando su primera experiencia en la Carnegie Library de Grand Island y su frecuente visita a bibliotecas públicas en Los Ángeles y Lincoln. Considera incomprensible cómo la eliminación de un pequeño instituto que apoya bibliotecas y museos puede beneficiar al público estadounidense.
Finalmente, con ironía menciona que el viernes anterior fue el “Día Nacional de Contar una Mentira”, un contrapunto perfecto para la semana. Para verificar si alguien dice la verdad, hay varias opciones en línea, pero la recomendación final es confiar en un lugar seguro y fiable: la biblioteca.
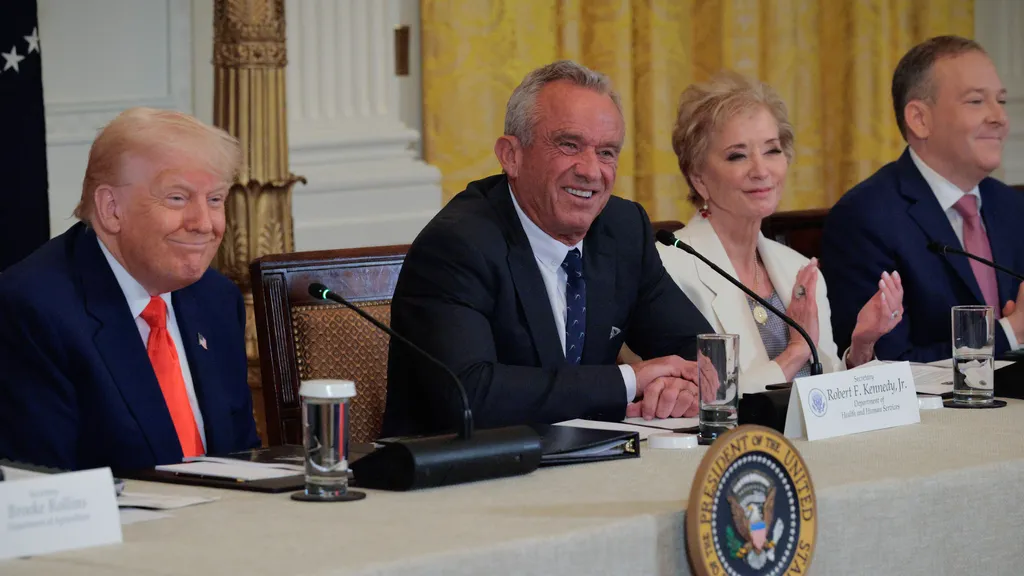
El informe «Make America Healthy Again» (MAHA), presentado por Robert F. Kennedy Jr. como Secretario de Salud y Servicios Humanos de EE. UU., ha generado una fuerte polémica debido a la inclusión de estudios inexistentes y referencias científicas erróneas. Aunque el documento afirma estar respaldado por más de 500 fuentes, investigaciones periodísticas han revelado que al menos siete de estas citas corresponden a estudios que no existen o han sido malinterpretados
Hace unos días, un estudio del Tow Center for Digital Journalism, publicado por la Columbia Journalism Review, reveló que los motores de búsqueda impulsados por inteligencia artificial citan incorrectamente las fuentes de noticias en más del 60 % de los casos. Esta alarmante tendencia adquiere aún más relevancia tras la reciente noticia sobre el informe «Make America Healthy Again» promovido por RFK Jr., el cual se apoya en estudios falsos y mal citados, reflejando los peligros reales de la desinformación amplificada por el uso irresponsable de la IA en la producción y difusión de contenidos.
Por ejemplo, se menciona un estudio atribuido a Robert L. Findling sobre la publicidad de medicamentos psicotrópicos en jóvenes, el cual no se encuentra en ninguna base de datos académica, y el propio Findling ha negado haberlo escrito. Otro caso es una supuesta investigación de 2017 sobre la prescripción excesiva de corticosteroides en niños con asma, que tampoco existe. Además, se han detectado errores en citas de estudios reales, como atribuir a una investigación sobre adultos conclusiones aplicables a niños, o afirmar que un estudio incluía psicoterapia cuando no era así
Estos hallazgos han suscitado preocupaciones sobre la integridad científica del informe y han llevado a especulaciones sobre el posible uso de inteligencia artificial generativa en su elaboración. Aunque la Casa Blanca ha calificado los errores como «problemas de formato» y ha prometido actualizaciones, expertos en salud pública y académicos han expresado su alarma por la falta de rigor y transparencia en un documento que podría influir en políticas de salud pública.
El informe también ha sido criticado por omitir causas principales de mortalidad infantil, como accidentes automovilísticos y violencia con armas de fuego, y por promover teorías desacreditadas sobre vacunas y fluoración del agua. Estas controversias ponen en entredicho la credibilidad del informe y resaltan la necesidad de una evaluación rigurosa y basada en evidencia científica en la formulación de políticas de salud.
Esta base de datos recopila decisiones judiciales relacionadas con casos en los que una inteligencia artificial generativa produjo contenido alucinado —es decir, contenido falso o erróneo generado por el sistema. El ejemplo más común son las citas legales falsas (fake citations), aunque también se incluyen otros tipos de errores, como argumentos jurídicos inventados o distorsionados.
Es importante destacar que esta base no abarca todos los casos en que se han utilizado citas falsas o IA en procedimientos judiciales, sino que se centra únicamente en los casos en los que ha habido una decisión legal vinculada a la utilización de contenido alucinado por IA.
El fenómeno de las alucinaciones en IA se refiere a la generación de información falsa pero con apariencia convincente. En el ámbito jurídico, esto representa un riesgo serio para la integridad del proceso judicial, ya que puede conducir a decisiones basadas en datos erróneos o incluso a la desinformación intencionada. Por ello, esta base de datos funciona también como una advertencia práctica sobre los límites actuales de la tecnología y la necesidad de usarla con criterio, supervisión humana y sentido ético.
Hasta el momento, la base de datos ha identificado 121 casos, y sigue en expansión conforme surgen nuevos ejemplos. Su objetivo es ofrecer un registro sistemático y riguroso que permita entender el impacto real del uso de estas herramientas tecnológicas en entornos legales, donde la precisión y la veracidad son esenciales. Es un recurso de gran valor tanto para juristas como para investigadores, medios de comunicación y responsables de políticas públicas.
El uso de contenido generado por IA en documentos judiciales ha provocado en algunos casos consecuencias graves, como sanciones disciplinarias a abogados que incluyeron citas falsas producidas por sistemas como ChatGPT sin verificarlas. Estos incidentes han sido objeto de cobertura mediática y han despertado un amplio debate sobre la responsabilidad profesional y la fiabilidad de las herramientas de IA en contextos de alta exigencia ética.
Un caso destacado es el de Mata v. Avianca, Inc., donde los abogados del demandante utilizaron ChatGPT para generar una moción legal que contenía múltiples casos jurídicos ficticios. El tribunal descubrió que las citas eran inexistentes y sancionó a los abogados con una multa de 5.000$, subrayando la responsabilidad profesional de verificar la exactitud de las referencias legales, independientemente de las herramientas utilizadas.
Otro ejemplo relevante es el caso en Israel de Mahala Association v. Clalit Health Services, donde se presentaron múltiples citas falsas generadas por una herramienta de IA llamada Takdin.AI. El tribunal no solo desestimó la petición de certificación de acción colectiva, sino que también impuso sanciones monetarias y determinó que el abogado no era apto para actuar en el caso.
En definitiva, este archivo documental se ha convertido en un instrumento de seguimiento y análisis de un fenómeno emergente que afecta a la práctica del derecho y que requiere atención tanto desde el ámbito jurídico como desde la innovación tecnológica y la regulación.
El 20 de mayo de 2025, NPR informó que varios periódicos estadounidenses, incluidos el Chicago Sun-Times y una edición del Philadelphia Inquirer, publicaron una lista de lectura de verano que contenía títulos de libros ficticios atribuidos a autores reales. Esta lista fue generada parcialmente por inteligencia artificial y distribuida por King Features, una unidad de Hearst Newspapers.
En un episodio reciente que pone de relieve los crecientes retos en la era de la inteligencia artificial, varios medios estadounidenses de renombre publicaron una lista de libros recomendados para el verano, entre los que se incluían títulos completamente inventados, pero atribuidos a autores reales y prestigiosos. La lista fue elaborada por King Features, una filial de Hearst Newspapers, y distribuida a sus periódicos asociados como parte de un paquete editorial estacional.
La lista se presentó como una selección de “libros esenciales para el verano”, pero contenía falsedades sorprendentes: títulos ficticios atribuidos a autores reales como Isabel Allende, Percival Everett y Cormac McCarthy, entre otros. Por ejemplo, uno de los libros inventados fue Tidewater Dreams de Allende, que no existe. Solo 5 de los 15 libros recomendados eran auténticos.
El contenido fue redactado por Marco Buscaglia, un colaborador independiente habitual. Buscaglia admitió haber utilizado una herramienta de inteligencia artificial (cuya identidad no se especifica en el artículo) para generar sugerencias literarias, y reconoció que no verificó si los títulos realmente existían. Esta falta de comprobación permitió que los títulos ficticios pasaran desapercibidos hasta que varios lectores y profesionales del mundo editorial empezaron a señalar errores tras la publicación.
Tanto el Chicago Sun-Times como el Philadelphia Inquirer, dos de los periódicos que publicaron la lista, han respondido asegurando que no fueron responsables directos del contenido, ya que este provenía del servicio editorial de King Features. Ambos medios han revisado internamente lo sucedido y se han comprometido a implementar controles más estrictos para evitar la publicación de información generada por IA sin revisión humana.
Este incidente ha generado un intenso debate sobre la ética y la práctica del uso de herramientas de IA en el periodismo. Aunque su uso puede ser eficiente, especialmente en tareas rutinarias o de apoyo, esta situación demuestra los peligros de confiar en la IA para generar contenido sin validación. La precisión, la reputación de los medios y la confianza del público están en juego.
También plantea interrogantes sobre la relación entre las agencias de contenido sindicadas y los periódicos locales. Al depender de servicios externos para llenar espacio en sus páginas —especialmente en secciones como cultura o estilo de vida— los medios corren el riesgo de ceder parte del control editorial y de comprometer su credibilidad si no ejercen la debida supervisión.
Los medios implicados han iniciado una reflexión sobre cómo deben gestionarse las colaboraciones con creadores de contenido y cómo utilizar la inteligencia artificial sin poner en riesgo la exactitud y la responsabilidad informativa. El caso también es un ejemplo de cómo el público, cada vez más atento y crítico, puede detectar errores que escapan a los filtros editoriales.
Este caso evidencia los límites del uso de la IA generativa en periodismo, sobre todo cuando no se combina con una revisión editorial rigurosa. La confianza en los medios, ya erosionada por otros factores en los últimos años, se ve aún más amenazada por errores de este tipo, que pueden parecer triviales, pero que en el fondo comprometen principios fundamentales como la veracidad y la responsabilidad.
Se analiza los errores de alucinación en los principales modelos de lenguaje mediante el uso del benchmark Phare (Potential Harm Assessment & Risk Evaluation). Este estudio pone el foco en un problema central: los modelos pueden ofrecer respuestas que suenan convincentes pero que contienen información falsa o inventada, lo que representa un riesgo real en su uso cotidiano.
Uno de los hallazgos principales del análisis es que más de un tercio de los errores detectados en sistemas de IA desplegados públicamente se deben a alucinaciones. Estas no solo son comunes, sino que además suelen ser difíciles de detectar, porque los modelos presentan esas respuestas con un alto grado de confianza. Esto puede confundir fácilmente a los usuarios, especialmente si no tienen el conocimiento necesario para evaluar la veracidad de lo que están leyendo.
La evaluación se llevó a cabo con el marco Phare, que analiza el rendimiento de los modelos a través de varias etapas: recolección de contenido auténtico y representativo, creación de ejemplos de prueba, revisión humana para asegurar la calidad y, finalmente, evaluación del comportamiento de los modelos. Dentro del módulo de alucinación, se valoraron cuatro tareas clave: la precisión factual, la capacidad para resistirse a la desinformación, la habilidad para desmentir bulos o teorías conspirativas, y la fiabilidad en el uso de herramientas externas como bases de datos o APIs.
Un aspecto especialmente relevante que destaca el estudio es la desconexión entre popularidad y fiabilidad. Es decir, que los modelos más valorados por los usuarios en términos de experiencia de uso no siempre son los más precisos en cuanto a la información que generan. Esto sugiere que una buena interacción no garantiza una buena calidad factual, y que es necesario avanzar en métricas que evalúen la veracidad con más rigor.
En conclusión el estudio muestra que las alucinaciones son un problema estructural de los modelos actuales y que su impacto es especialmente delicado en contextos donde la precisión es crítica, como la medicina, el derecho o la educación. Por ello, el artículo concluye que identificar y reducir estos errores debe ser una prioridad para mejorar la seguridad y fiabilidad de los modelos de lenguaje de gran escala.
Morán Guzmán, Ana Gricelda, y Sergio López Ruelas, eds. 2024.Información, comunicación y democracia, el papel de las bibliotecas. Guadalajara: Universidad de Guadalajara.
En las últimas dos décadas, la democracia global se ha debilitado significativamente, como refleja el Democracy Index 2022. Conceptos como la posverdad y las noticias falsas proliferan, afectando la percepción y participación ciudadana, especialmente a través de redes sociales, principal fuente informativa para muchos jóvenes. Este entorno favorece la desinformación y la polarización, deteriorando la calidad democrática. Ante este panorama, las bibliotecas juegan un papel crucial al ofrecer acceso a información confiable y formar a los usuarios en competencias informacionales, además de constituirse como espacios seguros, inclusivos y accesibles para toda la población.
Una nueva oleada de sistemas de «razonamiento» de empresas como OpenAI está produciendo información incorrecta con mayor frecuencia. Ni siquiera las empresas saben por qué.
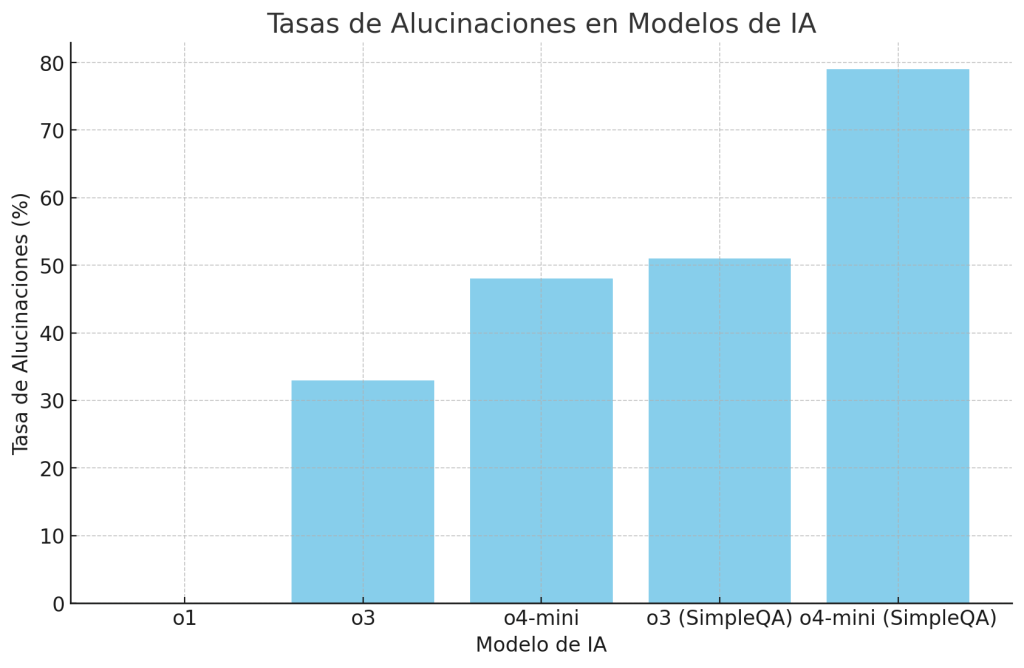
Se aborda el fenómeno de las «alucinaciones» en la inteligencia artificial, un problema crítico que afecta a modelos de lenguaje como ChatGPT y Bard de Google. Estas alucinaciones se refieren a respuestas generadas por IA que, aunque suenan plausibles, son incorrectas o completamente inventadas. Por ejemplo, en una prueba llamada PersonQA, el sistema más potente de OpenAI, denominado o3, presentó una tasa de alucinaciones del 33%, más del doble que su predecesor o1. El modelo o4-mini mostró una tasa aún mayor, alcanzando el 48%. En otra prueba, SimpleQA, las tasas de alucinaciones fueron del 51% para o3 y del 79% para o4-mini
Las alucinaciones son una consecuencia inherente a la manera en que los modelos de lenguaje están diseñados. Estos sistemas funcionan mediante el análisis de grandes volúmenes de datos y el aprendizaje de patrones estadísticos en el lenguaje. Para generar respuestas, no realizan una búsqueda de información en tiempo real ni verifican la precisión de los datos con fuentes externas, sino que se basan en los datos con los que fueron entrenados. Esta falta de verificación en tiempo real, unida a la complejidad de los procesos de generación de texto, puede llevar a que el modelo produzca información que, aunque coherente en su estructura, sea incorrecta o completamente ficticia.
Además, los modelos de lenguaje son inherentemente probabilísticos, lo que significa que seleccionan la «respuesta más probable» en función del contexto, pero no siempre tienen en cuenta si esa respuesta es veraz. En este sentido, las alucinaciones ocurren cuando el modelo «adivina» una respuesta que, aunque sea lingüísticamente plausible, carece de sustancia factual. Por ejemplo, en lugar de verificar hechos o proporcionar citas precisas, el modelo puede generar información coherente pero errónea debido a que los patrones previos en los datos entrenados sugieren que esa información tiene sentido dentro del contexto dado.
El fenómeno de las alucinaciones plantea una amenaza directa a la confiabilidad y utilidad de los sistemas de IA. A medida que estas tecnologías se adoptan en una variedad de sectores, desde el sector educativo hasta la atención médica y el asesoramiento empresarial, los usuarios se encuentran cada vez más en una posición vulnerable al confiar en respuestas generadas por máquinas que podrían ser incorrectas. En contextos como la medicina o el derecho, donde la precisión es crucial, las alucinaciones pueden tener consecuencias graves, desde diagnósticos incorrectos hasta consejos legales erróneos.
La preocupación por este problema es tal que algunos expertos temen que la confianza pública en las IA podría disminuir si las alucinaciones continúan sin control. La percepción de que los sistemas de IA no son completamente fiables podría desalentar a los usuarios de adoptar estas herramientas en áreas críticas. A su vez, esto podría ralentizar el progreso hacia la integración de la IA en sectores importantes de la sociedad, afectando su potencial para revolucionar industrias enteras.
Empresas como OpenAI y Google son conscientes de las limitaciones de sus modelos y están tomando medidas activas para mitigar el problema de las alucinaciones. Una de las estrategias es mejorar los algoritmos de verificación de hechos. Estos algoritmos buscan integrar fuentes de información más confiables y permitir que los modelos contrasten las respuestas generadas con bases de datos verificadas antes de ofrecer una respuesta final. Sin embargo, este proceso presenta desafíos técnicos significativos, ya que requiere una infraestructura adicional que permita a la IA verificar en tiempo real la información antes de presentarla al usuario.
Otra estrategia que se está explorando es la integración de sistemas de retroalimentación más robustos, donde los usuarios pueden señalar respuestas incorrectas y corregir la información. De esta manera, los modelos de IA no solo aprenden de los datos iniciales con los que fueron entrenados, sino también de las interacciones en el mundo real, lo que podría ayudar a disminuir la frecuencia de las alucinaciones con el tiempo. Aunque estas iniciativas son prometedoras, erradicar completamente las alucinaciones sigue siendo un desafío técnico y ético considerable.
A medida que la IA se utiliza en más ámbitos, se hace cada vez más evidente la necesidad de un enfoque más riguroso y transparente en su desarrollo. Es fundamental que los usuarios comprendan las limitaciones actuales de estas tecnologías y reconozcan que las respuestas generadas por IA no siempre son correctas. Esto implica educar al público sobre cómo funcionan estos modelos y la importancia de verificaciones adicionales por parte de los usuarios.
Además, las empresas deben adoptar una postura más abierta en cuanto a la metodología de entrenamiento de sus sistemas y las limitaciones inherentes a estos modelos. La transparencia en cómo se entrenan y actualizan los modelos, y el acceso a las fuentes utilizadas en su entrenamiento, puede ayudar a construir una relación de confianza con los usuarios y disminuir las preocupaciones sobre la exactitud de la información.
En resumen, las alucinaciones en la inteligencia artificial siguen siendo un obstáculo importante para su adopción generalizada y confianza pública. Aunque las empresas tecnológicas están haciendo esfuerzos significativos para mitigar este problema, es evidente que se requiere un enfoque multidisciplinario y más transparencia para abordar de manera efectiva este desafío. A medida que los modelos de IA continúan evolucionando, se espera que las soluciones a las alucinaciones también progresen, lo que permitirá un uso más confiable y preciso de estas tecnologías en una variedad de sectores.
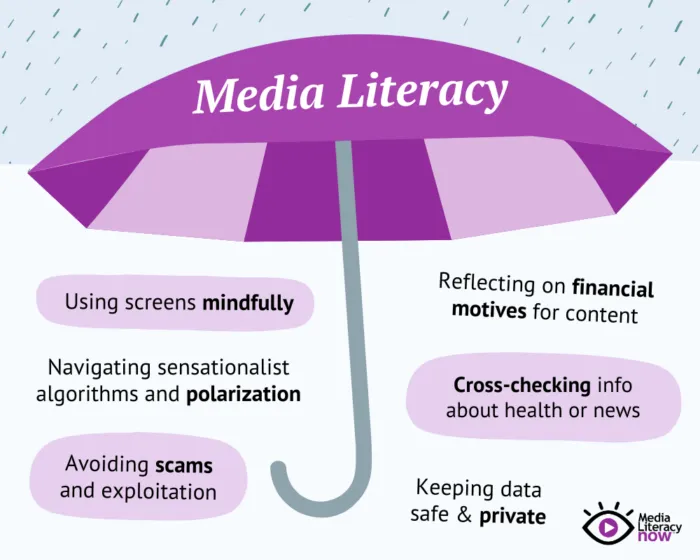
El artículo subraya la importancia crítica de la alfabetización mediática en la sociedad actual. Partiendo de la premisa de que las habilidades para evaluar la información —como aplicar contexto, ser curioso y buscar pruebas de validez— son esenciales para una ciudadanía informada. La autora sostiene que, ante el flujo constante de datos que recibimos a diario, la diferencia entre una ciudadanía bien informada o manipulable dependerá de cómo eduquemos en el uso crítico de los medios.
En este contexto, las bibliotecas, tanto escolares como públicas, se presentan como espacios ideales para promover la alfabetización mediática. Swicker propone que los bibliotecarios incluyan este tipo de enseñanza en los programas educativos o bien ofrezcan talleres específicos para distintas edades. Además, sugiere que las webs de las bibliotecas reserven secciones visibles para recursos de verificación de hechos. Pero más allá de proporcionar herramientas, recalca que el ejemplo es clave: usar y mostrar cómo se emplean estas fuentes de verificación debe ser algo natural y habitual, una respuesta instintiva ante cualquier información dudosa. La alfabetización mediática, afirma, no funciona sin la chispa de la curiosidad, sin preguntarse continuamente “¿cómo sabes eso?”.
El artículo también recopila una serie de recursos útiles para fomentar estas habilidades. Para el uso cotidiano, destaca sitios como AllSides, que muestra noticias desde distintas posiciones ideológicas; Google Fact Check Tools; FactCheck.org, centrado en política estadounidense; Snopes, que desmonta rumores y leyendas urbanas; y Lead Stories, que se enfoca en contenidos virales. Además, ofrece un listado de planes de lección dirigidos a docentes o bibliotecarios que deseen impartir formación en alfabetización mediática, como los materiales de Common Sense Education, Checkology del News Literacy Project, y Be Media Wise de PBS, Civic Online Reasoning, que ofrece materiales gratuitos listos para usar en el aula, entre otros. Estos materiales están orientados a todas las edades, desde la primaria hasta la educación superior.
Por último, Swicker recomienda organizaciones y reportes que sirven para la formación continua o la defensa institucional de la alfabetización mediática, como Media Literacy Now, The National Association for Media Literacy Education, o el State of Media Literacy Education Report 2024. Concluye haciendo un llamado a la acción: aunque los recursos existen y son accesibles, es responsabilidad de los bibliotecarios distribuirlos y facilitar su uso. Solo así se podrá lograr que las nuevas generaciones no se conformen con lo que leen o ven, sino que lo cuestionen, contrasten y comprendan de forma crítica.

 Universo Abierto
