Archivo de la etiqueta: Investigación

Evaluación de las ventajas del acceso abierto para las citas y las altmetrías

Taylor, Michael. Evaluating Open Access Advantages for Citations and Altmetrics (2011–2021): A Dynamic and Evolving Relationship. Quantitative Science Studies. MIT Press, 2024. https://doi.org/10.1162/QSS.a.470

El artículo analiza de manera exhaustiva el denominado “Open Access Advantage” (OAA), es decir, la supuesta ventaja en términos de citas y visibilidad que obtienen los artículos científicos publicados en acceso abierto frente a aquellos restringidos por suscripción. A diferencia de estudios anteriores más limitados, este trabajo se basa en un análisis a gran escala que abarca 38,7 millones de artículos publicados entre 2011 y 2021, incorporando tanto indicadores tradicionales de citación como diversas métricas alternativas (altmetrics), lo que permite una visión más amplia y matizada del impacto científico.

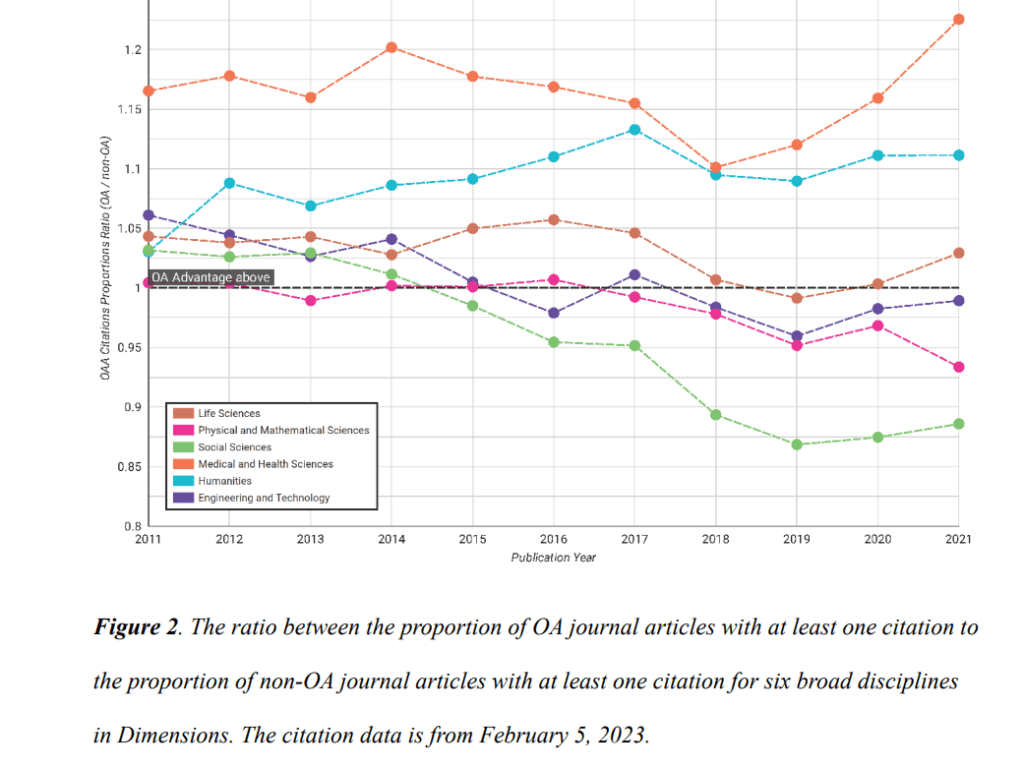
Uno de los hallazgos principales es que no existe una ventaja universal del acceso abierto. Aunque en ciertos campos —especialmente en las ciencias de la salud, las ciencias de la vida y algunas áreas de humanidades— los artículos en acceso abierto tienden a recibir más citas, esta ventaja no es constante ni homogénea entre disciplinas. De hecho, el estudio demuestra que el impacto del acceso abierto varía considerablemente según el área del conocimiento, lo que cuestiona la idea simplista de que publicar en abierto garantiza automáticamente mayor visibilidad o reconocimiento académico.

El estudio analiza más de 33 millones de artículos (2011–2021) y muestra que el acceso abierto crece del 32% al 55%, consolidándose como modelo dominante. La ventaja en citas disminuye claramente: pasa de 1,62 a 1,08, prácticamente desapareciendo en los trabajos recientes. En cambio, las altmetrics presentan ventajas fuertes y estables, especialmente en noticias. En conjunto, el OA ya no garantiza más citas, pero sí una mayor visibilidad y alcance social sostenido

Además, el análisis longitudinal revela un aspecto especialmente relevante: la ventaja en citas del acceso abierto tiende a disminuir en los trabajos más recientes. Este fenómeno puede interpretarse como un efecto de normalización del acceso abierto dentro del sistema científico, donde su creciente adopción reduce las diferencias respecto a la literatura tradicional. En otras palabras, a medida que el acceso abierto se convierte en una práctica más extendida, su capacidad diferencial para generar impacto en citas se atenúa.

En contraste, el estudio sí identifica una ventaja más consistente en términos de altmetrics, especialmente en indicadores como menciones en redes sociales, blogs o medios de comunicación. Estos resultados sugieren que el acceso abierto facilita la difusión y el alcance social del conocimiento científico, incluso cuando su impacto en citas académicas no es uniforme. Sin embargo, otros indicadores —como citas en patentes, documentos políticos o Wikipedia— presentan patrones más complejos y variables, lo que indica que el impacto del acceso abierto depende también del tipo de uso del conocimiento.


Otro aspecto clave del trabajo es su énfasis en la naturaleza multifactorial del impacto científico. El artículo subraya que las diferencias observadas entre publicaciones en acceso abierto y no abierto no pueden atribuirse exclusivamente al modelo de acceso. Factores como la disciplina, el año de publicación, las prácticas de difusión, la financiación o la visibilidad previa de los autores influyen significativamente en los resultados. Esto implica que el OAA no es un fenómeno causal simple, sino el resultado de múltiples variables interrelacionadas.


En conclusión, el estudio ofrece una visión crítica y matizada del acceso abierto, alejándose de posturas deterministas. Si bien confirma que el acceso abierto puede favorecer la visibilidad y, en ciertos contextos, las citas, también demuestra que su impacto es dinámico, desigual y dependiente del contexto. Por tanto, las políticas científicas y editoriales deben considerar esta complejidad, evitando asumir beneficios universales y promoviendo análisis más específicos por disciplinas y tipos de impacto.
La IA en la revisión por pares

Christensen, Neil Blair y Angela Cochran. “AI in Peer Review: Revisiting an 8‑Year‑Old Debate.” The Scholarly Kitchen (Society for Scholarly Publishing), 16 de marzo de 2026. https://scholarlykitchen.sspnet.org/2026/03/16/ai-in-peer-review-revisiting-an-8-year-old-debate/

En septiembre de 2018 se celebró en Oxford un debate organizado por SSP (Society for Scholarly Publishing) sobre el uso de la inteligencia artificial (IA) en el proceso de revisión por pares, con Angela Cochran defendiendo una postura escéptica y Neil Blair Christensen una más optimista. Ocho años después, ambos revisitan ese debate inicial para reflexionar sobre cómo han evolucionado sus posiciones y la presencia de la IA en la revisión académica, y para explorar hacia dónde podría dirigirse este campo en el futuro.

Angela Cochran, que en 2018 expresaba preocupaciones sobre la incapacidad de la IA para realizar análisis profundos y originales, reconoce que su comprensión del tema ha evolucionado con el avance tecnológico, pero mantiene la idea de que la IA por sí sola no resolverá los problemas fundamentales del sistema de revisión por pares. Señala que la mayoría de las herramientas actuales de IA se centran en tareas relacionadas con la integridad (detección de plagio, comprobaciones automáticas, etc.) en lugar de mejorar realmente la calidad global del proceso de revisión o aliviar la carga de trabajo de los revisores humanos. Aboga por que la IA se utilice para apoyar las tareas que sí pueden automatizarse, como ayudar a redactar la retroalimentación o liberar barreras lingüísticas para los revisores, más que para reemplazar el juicio humano.

Por su parte, Neil Blair Christensen reconoce que en 2018 subestimó la fuerza de las estructuras y culturas académicas existentes que determinan cómo se adopta la tecnología. Christensen subraya que, aunque la IA ha avanzado enormemente (con sistemas de lenguaje avanzado alimentando herramientas sofisticadas), los mismos retos que existían en 2018 persisten hoy: una enorme carga de trabajo para revisores voluntarios, un sistema de incentivos que valora publicaciones sobre evaluación crítica y una cultura editorial que apenas ha cambiado. Según él, la IA puede ayudar a “ejecutar” procesos (automatizando tareas repetitivas o analíticas), pero no puede por sí sola transformar los factores sistémicos que generan los problemas de revisión por pares, como los incentivos académicos y la escala de publicaciones.

Ambos autores coinciden en que la integración de la IA en la revisión por pares no debería ser una cuestión de “a favor o en contra”, sino de cómo implementar herramientas que efectivamente alivien la carga humana sin sacrificar rigor, creatividad o equidad. A pesar de los avances tecnológicos, múltiples desafíos éticos, culturales y prácticos permanecen, y tanto Cochran como Christensen creen que la IA debe utilizarse para facilitar el trabajo humano, ampliar la participación (por ejemplo, eliminando barreras lingüísticas) y ayudar a construir procesos más eficientes, no para sustituir las funciones centrales de evaluación crítica que solo los expertos humanos pueden hacer con confianza.

SocArXiv establece una política para regular el uso de inteligencia artificial en su repositorio

Cohen, Philip N. “SocArXiv Releases AI Policy.” SocOpen: Home of SocArXiv, 9 de marzo de 2026. https://socopen.org/2026/03/09/socarxiv-releases-ai-policy/

SocArXiv releases AI policy

El repositorio abierto SocArXiv, dedicado a la difusión de preprints en ciencias sociales, ha publicado una nueva política sobre el uso de inteligencia artificial (IA) con el objetivo de preservar la calidad del conocimiento académico y garantizar la fiabilidad del ecosistema de investigación. La iniciativa surge en un contexto marcado por el rápido crecimiento de herramientas generativas y por el aumento de envíos de artículos que incorporan contenido producido por modelos de lenguaje. La política pretende establecer criterios claros que permitan diferenciar entre el uso legítimo de herramientas de asistencia automatizada y la producción de trabajos generados mayoritariamente por IA que no cumplen estándares académicos.

El documento parte de una preocupación central: proteger lo que sus responsables denominan el “bien común epistémico” de la investigación científica. Según el repositorio, la proliferación de textos generados automáticamente —muchos de ellos de baja calidad o incluso fraudulentos— amenaza con diluir el valor de las publicaciones académicas. En un entorno como el de los servidores de preprints, donde los artículos se difunden sin revisión por pares formal, el riesgo es mayor, ya que estos documentos pueden adquirir apariencia de legitimidad académica al recibir identificadores persistentes o integrarse en sistemas de citación. Por ello, SocArXiv considera necesario introducir reglas que ayuden a filtrar contenidos problemáticos sin comprometer el carácter abierto de la plataforma.

La política también responde a problemas operativos derivados del aumento de envíos. El repositorio experimentó un crecimiento significativo en el número de artículos depositados, acompañado de un incremento de trabajos generados parcial o totalmente mediante sistemas de inteligencia artificial. Esta situación provocó un aumento de la carga de trabajo para los moderadores voluntarios encargados de revisar las propuestas antes de su publicación. Como medida previa a la política definitiva, en noviembre de 2025 se decidió suspender temporalmente la recepción de artículos centrados en modelos de IA o en el desarrollo técnico de estas tecnologías, con el fin de aliviar la presión sobre el sistema y elaborar una normativa clara.

El nuevo marco normativo establece que el uso de herramientas de inteligencia artificial puede ser aceptable en determinadas circunstancias, siempre que se declare de forma transparente y exista supervisión humana. Entre los usos considerados legítimos se encuentran tareas como la traducción automática, la ayuda en búsquedas bibliográficas, la organización de ideas, la corrección lingüística, el formateo de textos o ciertos procesos de análisis asistido por máquinas. En estos casos, los autores deben documentar claramente cómo se ha utilizado la herramienta y garantizar que el contenido final ha sido revisado críticamente por investigadores humanos. La transparencia en la declaración del uso de IA se convierte así en un requisito fundamental para la aceptación de los trabajos.

En contraste, la política define también usos explícitamente prohibidos. Entre ellos se incluye la generación automática de párrafos completos o secciones enteras del artículo sin supervisión adecuada, la creación de datos ficticios mediante modelos generativos, la invención de fuentes o referencias inexistentes, y la presentación de sistemas de IA como si fueran coautores humanos o interlocutores en procesos de investigación. Igualmente se rechazan los trabajos producidos íntegramente por sistemas generativos sin aportación sustancial de investigación humana. Estas prácticas son consideradas incompatibles con los estándares de integridad académica y constituyen motivo de rechazo inmediato.

Otro aspecto relevante de la política es que no pretende prohibir la inteligencia artificial en la investigación, sino establecer límites razonables para su uso. Los responsables del repositorio reconocen que los modelos de lenguaje y otras herramientas automatizadas están cada vez más integrados en los procesos de investigación, desde la traducción hasta el análisis de datos. Por ello, el objetivo no es iniciar una “carrera armamentística” para detectar automáticamente contenidos generados por IA, algo que consideran difícil de sostener técnicamente, sino crear normas simples y aplicables que fomenten comportamientos responsables por parte de los investigadores.

La política también pretende ofrecer orientación a los autores sobre dónde publicar determinados tipos de trabajos. SocArXiv se concibe principalmente como un repositorio para investigación en ciencias sociales, no como un espacio dedicado al desarrollo técnico de sistemas de inteligencia artificial. Por ello, algunos trabajos centrados en la creación o experimentación con modelos de IA pueden encontrar un encaje más adecuado en otros repositorios especializados. Esta delimitación temática busca mantener la coherencia disciplinar del repositorio y evitar que se convierta

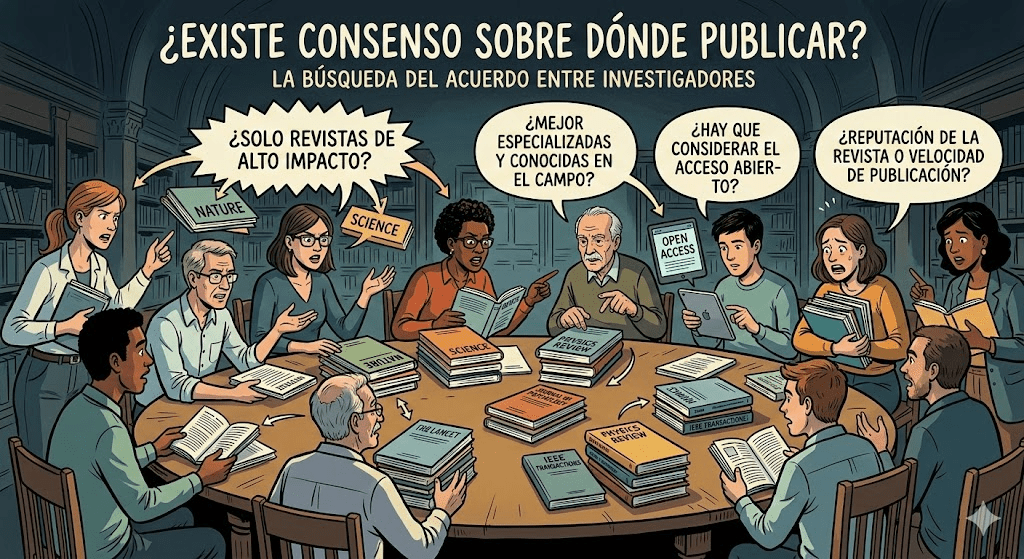
¿Existe consenso entre los investigadores sobre en que revistas publicar sus trabajos?

Van Buskirk, Ian, Marilena Hohmann, Ekaterina Landgren, Johan Ugander, Aaron Clauset y Daniel B. Larremore. Consensus and Fragmentation in Academic Publication Preferences. arXiv:2603.00807v1 [cs.DL], 28 de febrero de 2026

Este trabajo analiza cómo los investigadores toman decisiones sobre dónde publicar sus trabajos científicos y hasta qué punto existen patrones de consenso o, por el contrario, fragmentación dentro de las comunidades académicas.

Los autores parten de la premisa de que la elección de la revista o del canal de publicación no es un proceso puramente individual, sino que refleja dinámicas colectivas dentro de cada disciplina científica. Estas decisiones están influenciadas por múltiples factores —prestigio de las revistas, redes académicas, incentivos institucionales o visibilidad— y, en conjunto, configuran un sistema complejo de preferencias compartidas que puede ser estudiado mediante herramientas de análisis de redes y ciencia de datos. El objetivo central del artículo es identificar si las comunidades científicas muestran patrones claros de acuerdo sobre qué revistas son más relevantes o si, por el contrario, el sistema editorial está caracterizado por una pluralidad de preferencias que fragmenta el espacio de publicación.

Para abordar esta cuestión, los autores desarrollan un enfoque cuantitativo que combina datos de publicaciones académicas con modelos de redes y análisis estadístico. A partir de estos datos reconstruyen un mapa de las preferencias de publicación de los investigadores, observando cómo los científicos de distintas áreas tienden a concentrar sus envíos en determinados grupos de revistas. Este enfoque permite detectar estructuras emergentes en el sistema editorial: por un lado, núcleos de consenso donde muchos investigadores convergen en un pequeño conjunto de revistas consideradas centrales; y por otro, regiones de fragmentación en las que las preferencias se dispersan entre múltiples opciones. El análisis muestra que estas estructuras no son uniformes en todas las disciplinas: algunas comunidades presentan jerarquías editoriales muy claras, mientras que otras exhiben una distribución más diversificada de canales de publicación.

Uno de los hallazgos más relevantes del estudio es que el sistema de publicación científica funciona como una red de coordinación social. Las decisiones individuales de los investigadores están influidas por lo que hacen sus pares, lo que genera dinámicas colectivas de imitación, reputación y señalización. Publicar en determinadas revistas actúa como una señal de calidad y legitimidad dentro de la comunidad científica, lo que refuerza la concentración de envíos en ciertos títulos. Sin embargo, esta dinámica también puede producir fragmentación cuando diferentes subcomunidades científicas desarrollan sus propios circuitos editoriales o cuando emergen nuevas revistas y plataformas que compiten con las tradicionales. De este modo, el sistema editorial no es completamente centralizado ni completamente disperso, sino que presenta una estructura híbrida caracterizada por clusters o comunidades de publicación.

El artículo también examina las implicaciones de estos patrones para la evaluación científica y la difusión del conocimiento. Cuando existe un fuerte consenso en torno a unas pocas revistas, estas adquieren un poder simbólico considerable, lo que puede reforzar desigualdades en la visibilidad de la investigación y consolidar jerarquías académicas. Por el contrario, una mayor fragmentación puede favorecer la diversidad de enfoques y la aparición de nuevos espacios de comunicación científica, aunque también puede dificultar la identificación de estándares comunes de calidad. En este sentido, el estudio sugiere que comprender la estructura de preferencias de publicación es fundamental para analizar fenómenos como la concentración editorial, la influencia de los rankings de revistas o el impacto de políticas de ciencia abierta.

Finalmente, los autores destacan que su enfoque ofrece una nueva perspectiva cuantitativa para estudiar el ecosistema de la publicación científica, integrando métodos de análisis de redes, ciencia computacional y sociología de la ciencia. Este tipo de análisis permite comprender mejor cómo se forman los consensos en torno a determinadas revistas, cómo surgen nichos editoriales especializados y cómo evolucionan las comunidades científicas a lo largo del tiempo. En última instancia, el estudio aporta evidencia empírica sobre las dinámicas colectivas que subyacen a la comunicación académica y abre nuevas líneas de investigación sobre la gobernanza del sistema de publicación científica, especialmente en un contexto marcado por la expansión del acceso abierto, la proliferación de nuevas revistas y los cambios en los mecanismos de evaluación de la investigación.

La persistente influencia del factor de impacto en la evaluación científica

Grove, Jack. “Journal Impact Factors Still Exert ‘Undue Influence’, Finds PLOS Study.” Times Higher Education, 2 de febrero de 2026.

Leer artículo original

El artículo analiza el papel que sigue desempeñando el factor de impacto de las revistas en los procesos de evaluación académica, a pesar de las numerosas críticas que ha recibido en los últimos años.

Un estudio reciente basado en una encuesta a casi quinientos investigadores del ámbito de la biología —todos ellos participantes recientes en comités de evaluación de proyectos o en procesos de contratación y promoción académica— revela que los evaluadores continúan recurriendo de forma habitual a indicadores externos como la reputación de la revista o el propio factor de impacto para valorar la calidad y credibilidad de la investigación. En concreto, el 57 % de los encuestados afirmó utilizar al menos uno de estos indicadores para juzgar si un trabajo científico es fiable, lo que evidencia que la reputación editorial sigue funcionando como un atajo cognitivo en la toma de decisiones académicas.

Entre los distintos indicadores considerados, la reputación de la revista aparece como el criterio más utilizado para evaluar la credibilidad de los resultados científicos, seguido por la reputación del laboratorio o del grupo de investigación. El factor de impacto, aunque menos empleado directamente, continúa desempeñando un papel significativo: alrededor del 19 % de los investigadores lo utiliza para valorar la credibilidad de un artículo y un 15 % para juzgar su fiabilidad. Sin embargo, diversos estudios han demostrado que este indicador es un predictor pobre de la calidad real de un artículo individual, ya que mide el promedio de citas de una revista y no el valor específico de cada trabajo publicado en ella.

Dado que el 90 % de los encuestados afirmó que la evaluación de los resultados de investigación es importante para las decisiones de los comités, pero menos de la mitad dijo estar satisfecha con el conjunto de métricas disponibles, el estudio sostiene que existe “un amplio margen de oportunidad para proporcionar nuevas señales de credibilidad y fiabilidad”

El artículo recuerda que desde hace más de una década existen iniciativas internacionales que buscan limitar el uso del factor de impacto en la evaluación científica. Un ejemplo destacado es la Declaración de San Francisco sobre Evaluación de la Investigación (DORA), que recomienda explícitamente no emplear el JIF en decisiones relacionadas con financiación, contratación o promoción académica. A pesar de estas recomendaciones, el estudio sugiere que la persistencia de este indicador se debe en gran medida a la falta de alternativas claras y aceptadas para evaluar la calidad intrínseca de los trabajos científicos.

Así, los autores del estudio sostienen que existe una demanda creciente entre los evaluadores de nuevos indicadores que reflejen mejor la integridad, la transparencia y el rigor metodológico de la investigación. Entre las posibles señales de calidad se mencionan prácticas de ciencia abierta como la disponibilidad de datos, código o protocolos, así como mecanismos que permitan evaluar la reproducibilidad y la integridad de los resultados. La investigación concluye que mejorar estos “indicadores de credibilidad” podría contribuir a reducir la dependencia de métricas simplificadoras como el factor de impacto y favorecer evaluaciones más justas y rigurosas de la producción científica.

Gestión de la comunicación científica: 25 ideas para mejorar tu investigación

Noguera-Vivo, J.M. [José Manuel]. (2022). Gestión de la comunicación científica: 25 ideas para mejorar tu investigación. Editorial UOC.

Texto completo

Comunicar con éxito no es un talento reservado para unos pocos, sino una destreza que se aprende. Y la comunicación es una parte inherente a cualquier investigación, sea cual sea la fase en la que se encuentre el autor (grado, máster, doctorando o investigador consolidado). Comunicar correctamente un trabajo científico influye en su credibilidad, su alcance o sus posibilidades de obtener financiación, ya que determinará el grado de percepción de su utilidad. En este libro, el autor comparte consejos prácticos para que lleves a otro nivel tu investigación gracias a una comunicación óptima.

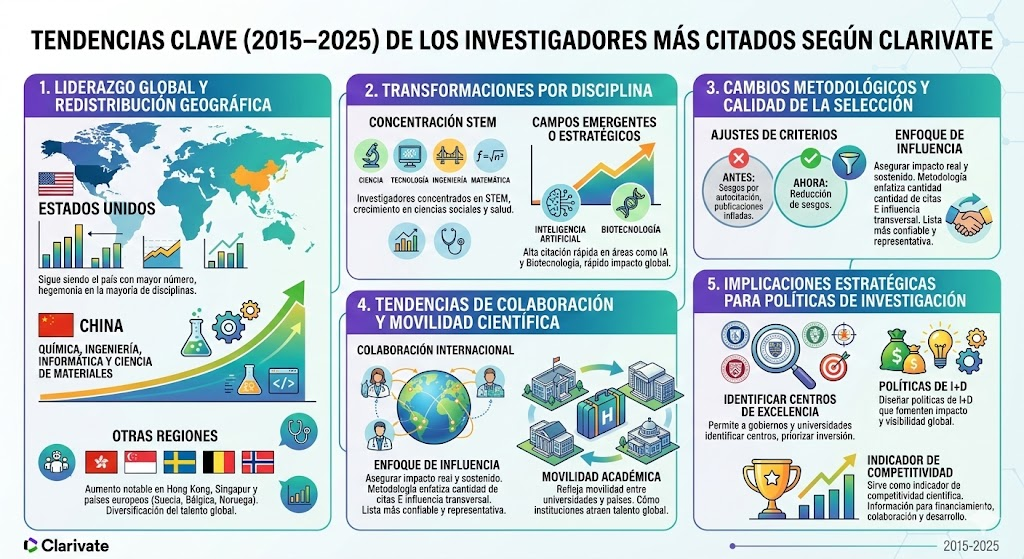
Tendencias clave (2015–2025) de los investigadores más citados según Clarivate: evolución global de la excelencia científica

Fry, Ryan. “Highly Cited Researchers: Key Trends 2015–2025.” Clarivate – The Institute for Scientific Information. Accedido el 27 de febrero de 2026. https://clarivate.com/academia-government/the-institute-for-scientific-information/highly-cited-researchers-key-trends-2015-2025

Entre 2015 y 2025, el programa de Highly Cited Researchers (Investigadores Altamente Citados) de Clarivate Analytics, gestionado por el Institute for Scientific Information (ISI), ha registrado una década de transformaciones y patrones significativos en la producción científica global.

Esta iniciativa, que identifica a investigadores con impacto excepcional al seleccionar a las voces científicas más citadas en la base de datos de Web of Science, ha generado datos que permiten analizar cómo se redistribuye la influencia científica entre países, regiones y ámbitos disciplinarios. La información se presenta en un panel interactivo de datos que refleja tanto cambios cuantitativos —número de investigadores altamente citados por país y por campo— como cualitativos, con una evolución metodológica de la propia selección y depuración de la lista durante el período 2015–2025.

Un hallazgo central de este análisis es la persistente preeminencia de Estados Unidos como líder en número y participación de investigadores altamente citados, aunque esta hegemonía muestra matices cuando se observan campos específicos y el crecimiento de otras regiones. Mientras Estados Unidos mantiene su dominio global, China continental ha experimentado un crecimiento explosivo en reconocimiento científico, alcanzando liderazgo en disciplinas como Química, Informática, Ingeniería y Ciencia de Materiales, áreas que anteriormente estaban dominadas por EE. UU. El aumento de China en estas categorías refleja no solo un repunte en producción científica, sino también una estrategia sostenida de inversión en investigación y desarrollo que ha alterado la distribución tradicional del impacto académico. A su vez, otras regiones como Hong Kong, Singapur y varios países europeos (por ejemplo, Suecia, Bélgica, Noruega) han triplicado el número de investigadores en estas listas, lo que indica una diversificación geográfica del reconocimiento científico global.

Además de estos patrones cuantitativos, el análisis de Clarivate pone en contexto cambios metodológicos y criterios de selección que afectan cómo se construye la lista de investigadores altamente citados. A lo largo de la última década, el ISI ha ido introduciendo filtros y ajustes para mejorar la integridad del proceso, respondiendo a preocupaciones sobre prácticas como la autocitación excesiva o la proliferación de publicaciones con un número atípico de artículos por autor. La versión renovada de 2025 recoge estos ajustes, que buscan asegurar que los investigadores incluidos reflejen un impacto amplio y sostenible en sus campos. Este enfoque no solo fortalece la credibilidad de la lista, sino que también ofrece una mirada más matizada sobre qué constituye una contribución científica significativa en el contexto contemporáneo.

En síntesis, el análisis de Clarivate para 2015–2025 no solo traza la trayectoria de investigadores de alto impacto, sino que también funciona como un barómetro de la evolución del paisaje científico global: revela cómo se reconfigura la distribución geográfica del talento investigativo, la importancia de disciplinas emergentes y la necesidad de metodologías más rigurosas que consideren tanto métricas bibliométricas como evaluaciones cualitativas. Este conjunto de tendencias proporciona a universidades, gobiernos y organismos académicos un recurso informativo para comprender mejor los centros de excelencia científica y para orientar políticas de investigación e innovación a gran escala.

Aspectos clave:

  1. Liderazgo global y redistribución geográfica

Estados Unidos sigue siendo el país con mayor número de investigadores altamente citados, manteniendo su hegemonía en la mayoría de disciplinas.

China ha experimentado un crecimiento sostenido, convirtiéndose en líder en áreas como Química, Ingeniería, Informática y Ciencia de Materiales.

Otras regiones con aumento notable incluyen Hong Kong, Singapur y varios países europeos (Suecia, Bélgica, Noruega), mostrando una diversificación del talento científico a nivel global.

  1. Transformaciones por disciplina

Los investigadores altamente citados se concentran en disciplinas STEM (Ciencia, Tecnología, Ingeniería y Matemáticas), pero también se observa crecimiento en áreas de ciencias sociales y salud.

Campos emergentes o estratégicos (por ejemplo, inteligencia artificial y biotecnología) muestran alta citación rápida, reflejando la rapidez con que ciertas áreas pueden impactar la comunidad científica global.

  1. Cambios metodológicos y calidad de la selección

Clarivate ha ajustado sus criterios para reducir sesgos por autocitación y publicaciones infladas, asegurando que la lista refleje un impacto real y sostenido.

La metodología ahora enfatiza tanto la cantidad de citas como la influencia transversal en la disciplina, haciendo la lista más confiable y representativa.

  1. Tendencias de colaboración y movilidad científica

Se observa un incremento en la colaboración internacional, lo que amplifica la visibilidad de ciertos investigadores.

La movilidad académica (entre universidades y países) se refleja en la distribución de investigadores citados, señalando cómo las instituciones pueden atraer talento global.

  1. Implicaciones estratégicas para políticas de investigación

Los datos permiten a gobiernos y universidades identificar centros de excelencia científica, priorizar áreas de inversión y diseñar políticas de I+D que fomenten impacto y visibilidad global.

La lista sirve como indicador de competitividad científica, ofreciendo información útil para decisiones sobre financiamiento, colaboración y desarrollo de infraestructuras de investigación.

La IA es buena para los científicos, pero empequeñece la ciencia misma

Hao, Qianyue, Fengli Xu, Yong Li, James Evans, et al. 2026. “Artificial intelligence tools expand scientists’ impact but contract science’s focus.” Nature 649: 1237–1243. https://doi.org/10.1038/s41586-025-09922-y

Reflexión crítica sobre cómo la adopción de herramientas de inteligencia artificial en la investigación científica puede estar generando efectos contrapuestos en el avance del conocimiento.

Por un lado, Worlock reconoce que la IA aporta beneficios claros a los investigadores individuales: automatiza tareas rutinarias, acelera la escritura de manuscritos y permite manejar grandes volúmenes de datos con una rapidez que ningún humano podría igualar. Estas ventajas, que están siendo reportadas y cuantificadas en estudios recientes, como el análisis de millones de publicaciones académicas que muestra que los científicos que usan IA publican más trabajos, reciben más citas y alcanzan posiciones de liderazgo más rápido, parecen confirmar de manera empírica que la productividad individual se incrementa significativamente cuando se integra IA en el flujo de trabajo científico.

Sin embargo, Worlock advierte que estos beneficios pueden tener un coste importante para la ciencia en su conjunto. A partir de debates surgidos en foros especializados —como The Coalition of the Curious que él menciona— y de evidencias recientes, el autor sugiere que la IA podría estar “encogiendo” el campo científico al concentrar esfuerzos en áreas de investigación consolidadas y ricas en datos, donde las herramientas pueden operar con mayor eficacia, en detrimento de exploraciones más fundamentales o arriesgadas. Esta crítica coincide con hallazgos académicos que documentan cómo la adopción generalizada de IA tiende a estrechar la diversidad temática de la ciencia y reduce la colaboración entre investigadores, ya que los incentivos se orientan hacia proyectos que son más fácilmente automatizables y citables. La preocupación central de Worlock es que, si la IA sirve sobre todo para acelerar trabajos ya en marcha o bien definidos, podría reforzar tendencias de homogeneización y disminuir la variedad de preguntas científicas que se formulan y se investigan.

Más allá de la productividad y la diversidad temática, Worlock también subraya que la discusión sobre el impacto de la IA en la ciencia no puede limitarse a métricas cuantitativas como número de publicaciones o citas, sino que debe incluir consideraciones más profundas sobre la verdadera naturaleza del descubrimiento científico. Es decir, ¿hasta qué punto una tecnología puede reclamar méritos de invención o comprensión cuando opera como una herramienta que sintetiza y acelera trabajos humanos sin necesariamente generar nuevas perspectivas teóricas? Esta inquietud se conecta con debates emergentes en la comunidad investigadora acerca de la necesidad de mantener el juicio, la creatividad y la colaboración humana como componentes esenciales de la práctica científica, incluso cuando se integran sistemas automatizados en la generación de hipótesis o en el diseño experimental. En este sentido, Worlock invita a sus lectores a “discutir” y reflexionar colectivamente sobre cómo estructurar incentivos, gestionar la integración de la IA y preservar la diversidad intelectual en un momento en que la ciencia y la tecnología están cada vez más entrelazadas.

¿Quién posee el conocimiento? Copyright, IA Generativa y el futuro de la publicación académica

Kochetkov, Dmitry. 2025. “Who Owns the Knowledge? Copyright, GenAI, and the Future of Academic Publishing.” arXiv, noviembre 24, 2025. https://doi.org/10.48550/arXiv.2511.21755

El documento aborda el impacto profundo y multifacético de la inteligencia artificial generativa (GenAI) y los grandes modelos de lenguaje (LLMs) en la investigación científica y el sistema de publicación académica. Las capacidades de estas tecnologías, señala el autor, representan un cambio de paradigma que ofrece oportunidades revolucionarias para acelerar descubrimiento, análisis y difusión del conocimiento, pero al mismo tiempo plantea desafíos éticos, legales y regulatorios significativos que no han sido adecuadamente resueltos por los marcos jurídicos existentes en las principales jurisdicciones del mundo.

Un foco central del análisis es el reto que GenAI plantea para las leyes de copyright tradicionales y para los principios de la ciencia abierta. Kochetkov argumenta que las normativas actuales en países como Estados Unidos, China, la Unión Europea y el Reino Unido, aunque pretenden fomentar la innovación, dejan vacíos importantes específicamente en relación con el uso de obras protegidas por derechos de autor y de resultados de ciencia abierta para entrenar modelos de IA. Es decir, las normas pensadas para regular la reutilización humana de contenidos no cubren adecuadamente la ingestión masiva de textos científicos por parte de algoritmos de aprendizaje automático.

El autor también discute las limitaciones de los mecanismos de licencia existentes, incluyendo las licencias de acceso abierto como las de Creative Commons. Aunque estas licencias han sido útiles para permitir la reutilización y difusión entre personas, no están diseñadas para regular el entrenamiento de GenAI, que implica procesamiento de datos a gran escala y sin intervención humana directa. Esto se traduce, según el artículo, en una falta de atribución y reconocimiento de la autoría real de los contenidos, lo cual socava nociones académicas fundamentales de originalidad, crédito y responsabilidad intelectual.

Frente a esto, Kochetkov propone una crítica al uso automático de figuras legales como la “excepción de uso justo” (“fair use”) en Estados Unidos para justificar el entrenamiento de modelos de IA con textos académicos. En su análisis, depender de este enfoque es problemático porque no respeta suficientemente los derechos de los creadores originales —especialmente cuando los modelos son desarrollados o explotados comercialmente o cuando producen derivados opacos sin atribución clara— y podría favorecer la consolidación de mercados oligopólicos donde prevalecen intereses comerciales sobre la integridad científica y la equidad en la producción de conocimiento.

Como alternativa, el autor aboga por que los autores mantengan derechos explícitos para rechazar el uso de sus obras en procesos de entrenamiento de IA, independientemente de la doctrina de uso justo, y que las universidades jueguen un papel más activo en la gobernanza responsable de IA. Las instituciones académicas, sostiene, están en una posición única para desarrollar políticas internas que reflejen los valores de integridad científica, transparencia y justicia epistémica, negociando derechos que incluyan cláusulas específicas sobre IA.

Finalmente, Kochetkov llama a un esfuerzo legislativo internacional armonizado que pueda integrar coherentemente derechos de autor, ciencia abierta y el uso de GenAI en la investigación académica. Una regulación coordinada a nivel global ayudaría a proteger la propiedad intelectual, garantizar transparencia en los datos de entrenamiento, y evitar que la infraestructura de conocimiento científico quede dominada por intereses comerciales en detrimento del acceso equitativo y la integridad de la producción académica.

En conjunto, el artículo plantea que la revolución de la IA en la ciencia requiere no solo innovación tecnológica, sino también reformas profundas en las políticas de derechos de autor, licencias abiertas y gobernanza institucional, para asegurar que la transformación digital refuerce —y no erosione— los principios fundamentales de la investigación científica y la difusión del saber.

Alfabetización de datos: cómo navegar la transición de la publicidad exagerada a la realidad

Data Literacy: Navigating the Shift from Hype to Reality. Library Trends, Vol. 74, Núm. 3 (febrero de 2026) https://muse.jhu.edu/issue/56412

El número 3 del volumen 74 de la revista Library Trends explora el concepto de alfabetización de datos más allá del entusiasmo tecnológico, enfocándose en cómo las bibliotecas y los profesionales de la información están integrando esta competencia en sus prácticas educativas y de servicio. La edición parte de la premisa de que la creciente complejidad de los ecosistemas de información —lo que algunos investigadores describen como la “sobrecarga de datos”— desafía a las bibliotecas a redefinir su papel formativo más allá de la alfabetización informacional tradicional. El propósito es comprender hasta qué punto las bibliotecas han desarrollado estrategias críticas y efectivas para preparar a sus usuarios a interpretar, evaluar y usar datos de forma ética en contextos diversos.

El contenido incluye artículos que analizan tanto perspectivas teóricas como experiencias prácticas: desde enfoques críticos sobre la enseñanza de la alfabetización de datos en entornos de desconfianza hasta iniciativas comunitarias dirigidas a poblaciones específicas, como inmigrantes o estudiantes universitarios. Se presentan estudios de caso sobre programas de formación interdisciplinaria, pedagogías inclusivas y proyectos que vinculan la alfabetización de datos con necesidades sociales, como la comprensión de la inseguridad alimentaria. Además, se examina cómo los planes de estudio en biblioteconomía y ciencias de la información están evolucionando para incorporar competencias de datos de manera más sistemática.