Archivo de la etiqueta: Investigación

La ciencia se está ahogando en la basura de la IA

Andersen, Ross. 2026. “Science Is Drowning in AI Slop.” The Atlantic, 22 de enero de 2026. https://www.msn.com/en-us/news/us/science-is-drowning-in-ai-slop/ar-AA1UK0tV

Ross Andersen aborda una crisis creciente en el mundo académico: el aluvión de investigaciones generadas con apoyo de inteligencia artificial que están saturando la producción científica con contenidos de baja calidad, irrelevantes o incluso falsos, lo que él denomina “AI slop” —una especie de desecho digital académico– que la comunidad científica aún no ha aprendido a gestionar eficazmente.

Cada día, en Bluesky y LinkedIn, Quintana veía a académicos publicar mensajes sobre el hallazgo de estas “citas fantasma” en artículos científicos. (La versión inicial del “Informe MAHA” de la administración Trump sobre la salud infantil, publicada la pasada primavera, contenía más de media docena de ellas). Pero hasta que Quintana encontró un falso artículo firmado por un “Quintana” citado en una revista para la que actuaba como revisor, había pensado que el problema se limitaba a publicaciones con estándares más bajos. “Cuando ocurre en una revista que respetas, te das cuenta de lo extendido que está el problema”.

Casi inmediatamente después de que los grandes modelos de lenguaje se popularizaran, los manuscritos comenzaron a llegar a las bandejas de entrada de las revistas en cantidades nunca vistas. Parte de este fenómeno puede atribuirse a la capacidad de la IA para aumentar la productividad, especialmente entre científicos no angloparlantes que necesitan ayuda para presentar su investigación. Pero ChatGPT y herramientas similares también se están utilizando para dar una nueva apariencia de plausibilidad a trabajos fraudulentos o chapuceros, según Mandy Hill, directora general de publicación académica en Cambridge University Press & Assessment. Esto hace que la tarea de separar el grano de la paja sea mucho más lenta para editores y revisores, y también más compleja desde el punto de vista técnico.

Andersen explica que la presión por publicar, combinada con la facilidad de generación de texto e incluso figuras mediante modelos de lenguaje avanzados, ha hecho que conferencias y revistas reciban enormes cantidades de trabajos que no aportan hallazgos verificables ni replicables, y que rara vez se someten a una revisión crítica profunda.

Este problema se agrava por la propia mecánica de la revisión por pares: muchos revisores están recurriendo también a herramientas de IA para evaluar artículos, y al mismo tiempo algunos autores insertan mensajes ocultos que incitan a estas IA a elogiar sus textos, lo que distorsiona aún más el proceso. Andersen describe casos concretos, como ilustraciones generadas que parecen plausibles pero son absurdas o científicamente incorrectas, y un incremento sin precedente en las presentaciones a conferencias de alto impacto en campos como el aprendizaje automático y la robótica. La IA también puede generar las imágenes de un artículo falso. Un artículo de revisión de 2024, ya retractado, publicado en Frontiers in Cell and Developmental Biology, incluía una ilustración generada por IA de una rata con unos testículos desproporcionadamente grandes y ridículos, que no solo superó la revisión por pares, sino que se publicó antes de que nadie lo advirtiera. Por embarazoso que fuera para la revista, el daño fue escaso. Mucho más preocupante es la capacidad de la IA generativa para crear imágenes convincentes de tejidos cortados en láminas finísimas, campos microscópicos o geles de electroforesis, que se usan habitualmente como pruebas en la investigación biomédica.

Las actas de congresos son el principal canal de publicación de artículos en IA y otras ciencias de la computación, y en los últimos años se han visto desbordadas por los envíos. NeurIPS, una de las principales conferencias de IA, ha visto duplicarse las presentaciones en cinco años. ICLR, la conferencia líder en aprendizaje profundo, también ha experimentado un aumento y parece incluir una cantidad considerable de slop: una startup de detección de LLM analizó los envíos para su próxima reunión en Brasil y encontró más de 50 que incluían citas alucinadas. La mayoría no se había detectado durante la revisión por pares. Eso podría deberse a que muchas de las revisiones por pares se realizaron con ayuda de la IA. Pangram Labs analizó recientemente miles de informes de revisión enviados a ICLR y descubrió que más de la mitad habían sido redactados con ayuda de un LLM, y alrededor de una quinta parte eran completamente generados por IA. En todas las ciencias académicas, los autores de artículos incluso han empezado a usar fuentes blancas diminutas para incrustar mensajes secretos dirigidos a los LLM revisores. Instan a las IA a elogiar el artículo que están leyendo, a describirlo como “revolucionario” y “transformador”, y a ahorrarles la molestia de una revisión exigente sugiriendo solo correcciones fáciles.

Este volumen ha superado la capacidad de revisión crítica de la comunidad, de modo que la investigación real y valiosa queda sepultada por un ruido cuya proporción crece constantemente. Además, el autor extiende el análisis a los servidores de preprints (sitios donde los científicos comparten borradores de sus trabajos antes de la revisión formal), donde la llegada masiva de textos asistidos por IA ha catalizado un incremento de publicaciones superficiales. Esto plantea un riesgo no solo para la credibilidad de estos repositorios, sino para todo el sistema de comunicación científica, que depende de un equilibrio entre cantidad y calidad para que los hallazgos genuinos puedan ser detectados, replicados y aprovechados. Expertos citados señalan que si este flujo no se frena, podría convertirse en una “crisis existencial” para ciertos campos del conocimiento, al difuminarse la distinción entre trabajo bien fundamentado y “slop” generado por algoritmos que simplemente repiten patrones sin entendimiento real. Hasta el punto de que ya se está hablando de una teoría conspirativa denominada “internet muerto”. Sus defensores creen que, en las redes sociales y otros espacios en línea, solo unas pocas personas reales crean publicaciones, comentarios e imágenes, y que el resto son generados y amplificados por redes de bots en competencia. Las IA escribirían la mayoría de los artículos y revisarían la mayoría de ellos. Este intercambio vacío serviría para entrenar nuevos modelos de IA. Imágenes fraudulentas y citas fantasma se incrustarían cada vez más profundamente en nuestros sistemas de conocimiento. Se convertirían en una contaminación epistemológica permanente que nunca podría filtrarse.

Las ‘Big Three’ de la información científica: revisión bibliométrica comparativa de Web of Science, Scopus y OpenAlex

Torres-Salinas, D., & Arroyo-Machado, W. (2026). Las ‘Big Three’ de la información científica: Revisión bibliométrica comparativa de Web of Science, Scopus y OpenAlex (1.2.). InfluScience Ediciones. https://doi.org/10.5281/zenodo.18336510

El informe realiza un análisis exhaustivo de las tres principales bases de datos bibliográficas multidisciplinares que se utilizan en la evaluación de la investigación científica. Su objetivo central es ofrecer evidencia actualizada y crítica sobre cómo estas plataformas difieren en cobertura, calidad de metadatos, funcionalidades y utilidad estratégica para distintos tipos de análisis científico y de evaluación.

Este trabajo combina una revisión sistemática de la literatura reciente con un análisis bibliométrico original, lo que permite ofrecer tanto un marco teórico como datos empíricos recientes sobre estas bases de datos. En la primera parte, los autores presentan una revisión sistemática de estudios previos que comparan Web of Science, Scopus y OpenAlex. Se analizan aspectos como el volumen de registros, la cobertura de acceso abierto, la diversidad lingüística, la cobertura de referencias y la calidad de los metadatos. Esta revisión permite contextualizar la investigación actual y destacar las fortalezas y limitaciones de cada plataforma según la literatura existente. Además, se subraya la importancia de entender estos factores para tomar decisiones informadas en evaluaciones de producción científica y proyectos de bibliometría.

La segunda parte del informe desarrolla un análisis bibliométrico original, abarcando el período 2015–2024. Se examina la distribución longitudinal de los registros, los tipos documentales, los perfiles temáticos, las diferencias idiomáticas y los solapamientos entre las tres bases de datos. Los resultados muestran que OpenAlex tiene una cobertura total más amplia, incluyendo una mayor diversidad lingüística y un porcentaje mayor de contenido en acceso abierto, mientras que Web of Science y Scopus mantienen niveles más altos de consistencia y calidad de los metadatos. También se identifican diferencias en la proporción de tipos documentales y la granularidad en la clasificación temática.

Entre los hallazgos más relevantes, el informe destaca que las bases comerciales tradicionales operan con modelos de suscripción y curación estricta, lo que garantiza la fiabilidad de los datos, mientras que OpenAlex adopta un enfoque de acceso abierto y escalable, con ventajas en cobertura y representatividad geográfica. Asimismo, se observa que, aunque OpenAlex ofrece mayor amplitud, esto también implica mayores desafíos para la limpieza y consistencia de los registros. Estas diferencias son especialmente importantes para investigadores, bibliotecarios y gestores de ciencia que buscan equilibrar calidad y cobertura en estudios bibliométricos o evaluaciones institucionales.

Finalmente, los autores presentan un conjunto de recomendaciones estratégicas destinadas a optimizar la selección y el uso de estas bases de datos. Se sugiere combinar fuentes cuando se busque un balance entre calidad y amplitud, interpretar cuidadosamente los sesgos lingüísticos y geográficos, y elegir la plataforma según los objetivos específicos de cada análisis. El informe concluye resaltando que el conocimiento detallado de las características y limitaciones de Web of Science, Scopus y OpenAlex es esencial para garantizar evaluaciones científicas precisas, inclusivas y estratégicas.

Miles de citas invisibles se infiltran en artículos y generan métricas falsas

Joelving, Frederik. “How Thousands of Invisible Citations Sneak into Papers and Make for Fake Metrics.” Retraction Watch, 9 de octubre de 2023. https://retractionwatch.com/2023/10/09/how-thousands-of-invisible-citations-sneak-into-papers-and-make-for-fake-metrics/

El artículo de Retraction Watch expone un fenómeno descubierto en 2022 por el científico informático Guillaume Cabanac: ciertos trabajos científicos acumulaban un número inusualmente alto de citas en poco tiempo a pesar de haber sido descargados muy pocas veces, una discrepancia que no cuadraba con el impacto real del artículo.

Tras una investigación, Cabanac y sus colegas identificaron la causa en los metadatos enviados a Crossref, donde se incluían referencias que no aparecían ni en el PDF ni en la versión HTML del artículo, sino únicamente en los archivos técnicos que utilizan las bases de datos para indexar publicaciones.

El buscador marcó este artículo en particular —que ya ha sido retractado— por contener las llamadas frases manipuladas, giros extraños en términos establecidos que probablemente fueron introducidos por software de traducción o por personas que buscaban evadir los detectores de plagio.

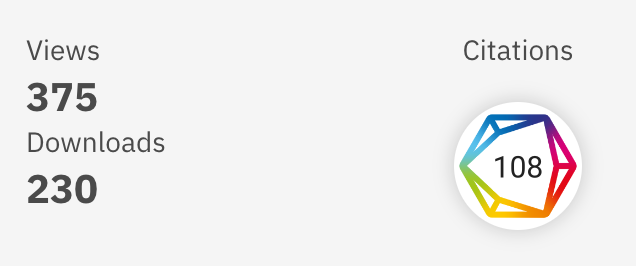
Cabanac notó algo extraño: el estudio había sido citado 107 veces según el «donut de Altmetrics», un indicador del impacto potencial de un artículo, pero solo se había descargado 62 veces.

Además, según Google Académico, este artículo solo había sido citado una vez. “Había una clara discrepancia entre los recuentos de Google Académico y los de Altmetrics/Dimensions”, afirma Cabanac. Esta diferencia es especialmente significativa, ya que “sabemos que Google Académico suele sobreestimar el número de citas”, añade.

Este tipo de “citas invisibles” —citas añadidas en los metadatos pero no visibles para los lectores— acaba siendo procesado por servicios de métricas como Altmetrics o Dimensions, inflando artificialmente los contadores de citas y otras métricas de impacto académico. El artículo señala que esta manipulación perjudica la integridad de los sistemas de evaluación científica, pues métricas como el número de citas o índices derivadas de ellas se emplean a menudo para medir el rendimiento de investigadores y asignar financiación, lo que podría dar una imagen errónea del impacto real de ciertos autores o publicaciones.

Además, el reporte aclara que estas falsas referencias parecían proceder especialmente de ciertas revistas producidas por un editor específico, y que ni siquiera está claro si se trata de una manipulación deliberada o un fallo técnico de procesos de envío de metadatos. La situación pone de relieve la necesidad de mejorar los mecanismos de control de calidad en la producción de metadatos académicos y de desarrollar herramientas que comparen sistemáticamente las referencias visibles en el texto con las incluidas en los registros técnicos, para evitar que tales citaciones ocultas distorsionen las métricas científicas.

Cómo integrar el Consensus con los gestores de referencias: EndNote, Zotero, Paperpile

Elechko, A. 2024. How to Integrate Consensus With Reference Managers – EndNote, Zotero, Paperpile. Help Center. Accedido el 16 de enero de 2026. https://help.consensus.app/en/articles/9922811-how-to-integrate-consensus-with-reference-managers-endnote-zotero-paperpile

Consensus, una herramienta de búsqueda académica basada en inteligencia artificial, puede integrarse de forma sencilla con distintos gestores de referencias bibliográficas como EndNote, Zotero o Paperpile.

El objetivo principal de esta integración es facilitar el trabajo investigador, permitiendo que las referencias encontradas en Consensus se incorporen directamente a los sistemas habituales de gestión bibliográfica, evitando así la introducción manual de datos y reduciendo errores en la citación.

Consensus permite exportar los resultados de búsqueda y las listas de artículos guardados en formatos estándar ampliamente aceptados en el ámbito académico, principalmente RIS y CSV. Estos formatos son compatibles no solo con EndNote, Zotero y Paperpile, sino también con otros gestores como Mendeley, RefWorks, Citavi o Papers. De este modo, el investigador puede transferir rápidamente la información bibliográfica —autores, títulos, revistas, fechas y otros metadatos— a su gestor de referencias preferido y continuar allí el proceso de organización, anotación y citación.

El proceso de exportación es sencillo: tras realizar una búsqueda en Consensus o acceder a una lista previamente guardada, basta con utilizar la opción de descarga y seleccionar el formato deseado. En el caso de Zotero, además, se destaca la utilidad del Zotero Connector, una extensión de navegador que permite guardar directamente los artículos desde la página de resultados o desde la ficha individual de cada trabajo, integrando así Consensus en el flujo de trabajo habitual del investigador de forma casi inmediata.

La IA ya está muy presente en los flujos de trabajo de la publicación académica

Dolechek, Melanie. “AI in Scholarly Publishing — SSP Pulse Check Report.” The Scholarly Kitchen (blog), 9 de enero de 2026. https://scholarlykitchen.sspnet.org/2026/01/09/ai-in-scholarly-publishing-ssp-pulse-check-report/

Texto completo

El objetivo del informe es explorar cómo las organizaciones del ámbito de la publicación académica están adoptando y respondiendo a la inteligencia artificial (IA). La encuesta, realizada entre el 1 y el 12 de diciembre de 2025 entre 563 profesionales de distintas organizaciones, revela que la IA ya está muy presente en los flujos de trabajo de la publicación académica, aplicándose principalmente en tareas relacionadas con la creación y resumen de contenidos, revisión de integridad y detección de plagio, así como en herramientas de accesibilidad y descubrimiento de contenidos.

A pesar de esta adopción generalizada, el informe subraya que la preparación institucional para gestionar el impacto de la IA sigue rezagada respecto al uso tecnológico. La mayoría de las organizaciones se encuentran en un estado de preparación parcial, con políticas, capacidades y conocimientos aún en desarrollo, lo que refleja que el entusiasmo por la IA va acompañado de incertidumbre y retos organizativos. Entre los principales obstáculos se encuentran preocupaciones éticas y legales, problemas de privacidad y seguridad de datos, y una insuficiente capacidad especializada dentro de los equipos.

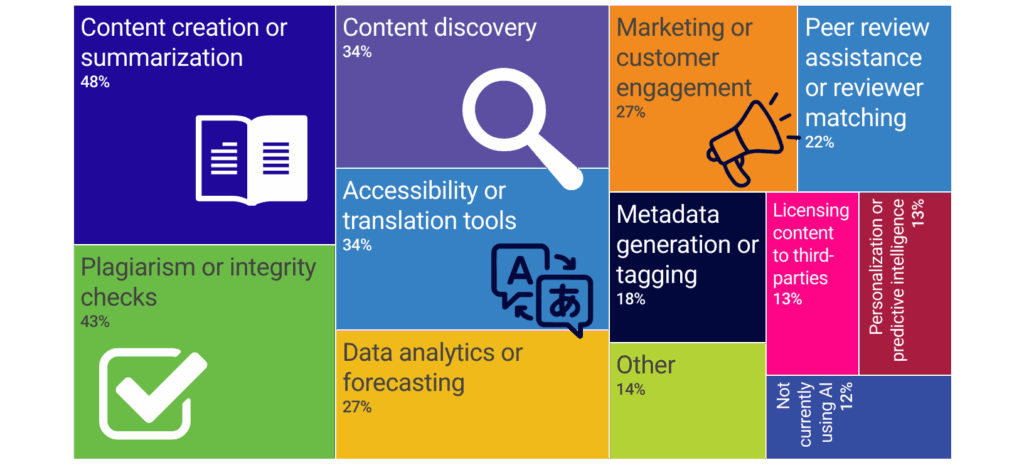
Las respuestas a la encuesta muestran que la adopción de IA ya está en marcha en las organizaciones de publicación académica, y la gran mayoría reporta al menos un caso de uso activo. Las aplicaciones más comunes se centran en los flujos de trabajo relacionados con el contenido, particularmente la creación o resumen de contenido (48%) y la verificación de plagio o integridad de la investigación (43%). Estos usos reflejan áreas donde la IA puede ofrecer ganancias inmediatas de eficiencia y ampliar el soporte a los procesos editoriales existentes sin alterar fundamentalmente la autoridad en la toma de decisiones.

Las herramientas de accesibilidad y traducción (34%) y el descubrimiento de contenido (34%) también son muy relevantes, subrayando el papel creciente de la IA en mejorar el alcance, la usabilidad y la encontrabilidad del contenido académico.

Más allá de las funciones editoriales principales, las organizaciones aplican cada vez más la IA a actividades empresariales y operativas. Más de una cuarta parte de los encuestados informa que utiliza IA para marketing o interacción con clientes (27%) y para análisis de datos o previsiones (27%), lo que indica una mayor comodidad con los conocimientos generados por IA para informar estrategias y alcance de la audiencia. La asistencia en la revisión por pares o la asignación de revisores (22%) y la generación o etiquetado de metadatos (18%) aparecen como aplicaciones emergentes, pero aún no universales, lo que sugiere tanto oportunidad como cautela en áreas que interfieren más directamente con el juicio académico y el control de calidad.

De acuerdo con los datos mostrados, las categorías con mayor peso son:

  • Creación o resumen de contenido: Es la aplicación más destacada con un 48%.
  • Controles de plagio o integridad: Ocupa el segundo lugar con un 43%.
  • Descubrimiento de contenido: Representa un 34%.
  • Herramientas de accesibilidad o traducción: Empata con el descubrimiento de contenido con un 34%.
  • Marketing o compromiso del cliente: 27%.
  • Análisis de datos o pronósticos: 27%.
  • Asistencia en revisión por pares o emparejamiento de revisores: 22%.
  • Generación de metadatos o etiquetado: 18%.
  • Licencia de contenido a terceros: 13%.
  • Personalización o inteligencia predictiva: 13%.
  • Finalmente, la imagen indica que un 14% corresponde a otros usos y un 12% de los consultados no utiliza IA actualmente.

Actitudes hacia la IA

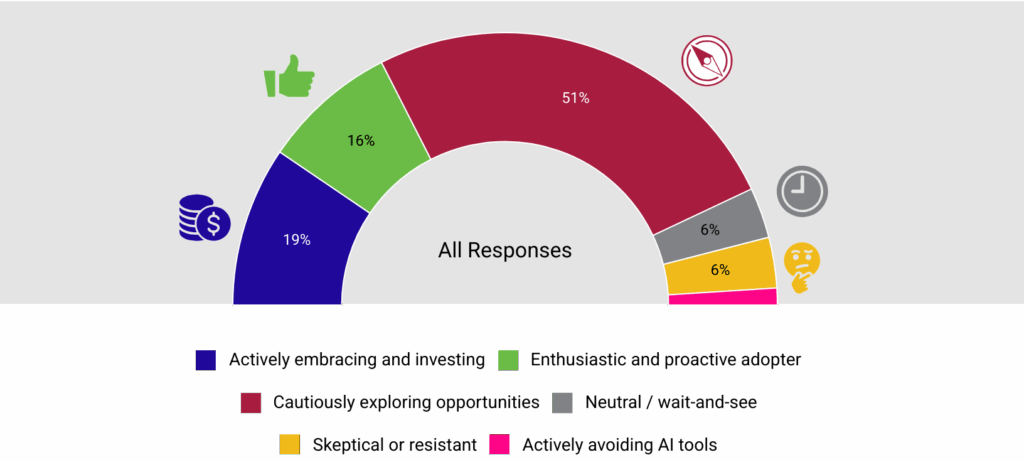
Las respuestas indican que la mayoría de las organizaciones abordan la IA con interés medido, más que con entusiasmo incondicional. La mayoría (51%) describe su postura como exploración cautelosa de oportunidades, lo que sugiere experimentación activa junto con consideración cuidadosa de riesgos, gobernanza y adecuación. Al mismo tiempo, más de un tercio de los encuestados muestra una postura fuertemente positiva hacia la IA: 19% adopta activamente e invierte en IA y 16% se identifica como adoptante entusiasta y proactivo — juntos indican un impulso significativo hacia una integración más profunda.

Solo una pequeña minoría permanece al margen o en contra. Solo el 6% reporta una postura neutral de esperar y ver, otro 6% se declara escéptico o resistente, y solo 2% evita activamente las herramientas de IA. En conjunto, estos resultados sugieren que, aunque la cautela sigue siendo dominante, la resistencia a la IA en la publicación académica es limitada y la trayectoria general apunta hacia una adopción más amplia con el tiempo.

Preparación ante la IA

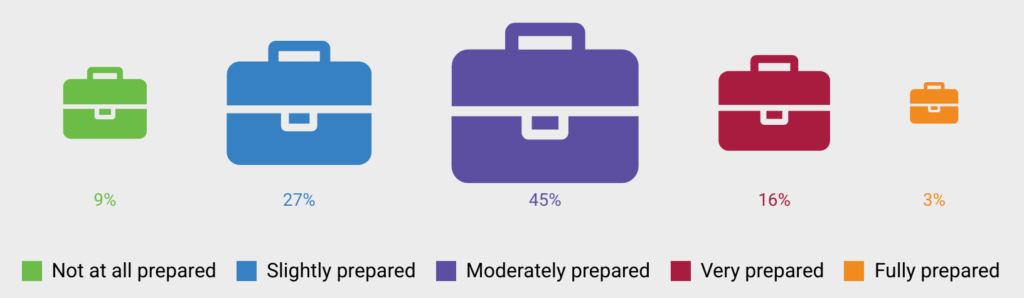
Las respuestas sugieren que la mayoría de las organizaciones se sienten parcialmente preparadas para enfrentar el impacto de la IA en el próximo año. Casi la mitad (45%) reporta estar moderadamente preparada, mientras otro 27% se siente solo ligeramente preparada, lo que indica que muchas organizaciones todavía están construyendo habilidades, políticas y confianza interna. Un porcentaje menor se siente altamente preparado: 16% se describe como muy preparado y solo 3% como completamente preparado, lo que subraya lo rara que sigue siendo la sensación de preparación total. Al mismo tiempo, 9% reporta no estar preparado en absoluto, destacando la necesidad de orientación, buenas prácticas compartidas y desarrollo de capacidades en toda la comunidad.

El sondeo también identifica oportunidades importantes asociadas con la IA, entre ellas la eficiencia de los flujos de trabajo —que puede liberar tiempo para tareas de mayor valor añadido—, el fortalecimiento de la revisión por pares mediante herramientas de apoyo o asignación de revisores, y el uso de IA para reforzar la integridad y calidad de la investigación a través de la detección de plagio o de prácticas poco éticas. Asimismo, la IA se percibe como una herramienta valiosa para mejorar la descubribilidad del contenido científico y para apoyar a autores de distintas lenguas mediante traducción y servicios lingüísticos.

Barreras para la adopción de IA

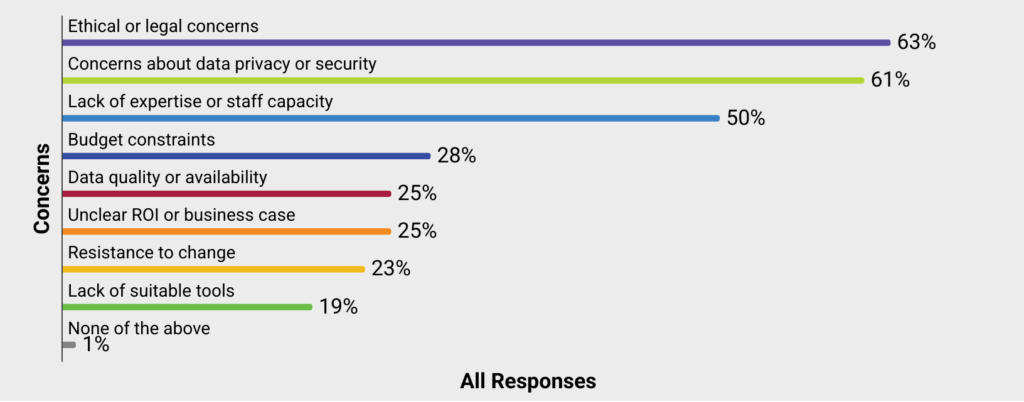
Los encuestados identificaron preocupaciones legales/éticas, privacidad/seguridad y falta de experiencia/capacidad como las principales barreras para la adopción de IA.

A pesar de los altos niveles de adopción e interés en IA, las organizaciones de publicación académica todavía albergan serias preocupaciones sobre su uso en el sector. Las preocupaciones éticas o legales (63%) y los problemas de privacidad o seguridad de los datos (61%) encabezan la lista, reflejando cautela generalizada respecto a cumplimiento, propiedad intelectual y uso responsable — preocupaciones especialmente agudas en la publicación académica. La preparación organizacional también emerge como un desafío significativo, con la mitad de los encuestados (50%) citando la falta de experiencia o capacidad del personal, lo que subraya que las capacidades humanas e institucionales a menudo quedan detrás del interés tecnológico.

Consideraciones prácticas y financieras forman un segundo nivel de barreras. Restricciones presupuestarias (28%), calidad o disponibilidad de datos (25%) y un ROI o caso de negocio poco claros (25%) sugieren que muchas organizaciones todavía evalúan costos frente a beneficios inciertos. Los problemas culturales y de herramientas —como la resistencia al cambio (23%) y la falta de herramientas adecuadas (19%)— son menos dominantes pero todavía significativos. Casi todas las organizaciones reportan algún tipo de fricción al adoptar IA.

No obstante, las preocupaciones sobre los riesgos son profundas y existenciales. Muchos encuestados expresan inquietudes sobre la posibilidad de que la IA degrade la calidad y la integridad de la literatura académica, dificultando la detección de contenidos generados por IA sin rigor científico, y erosionando la confianza en el proceso de revisión por pares tradicional. También existe ansiedad sobre la falta de transparencia en el uso de IA y la autenticidad de las contribuciones cuando las herramientas automatizadas participan en la producción o evaluación de trabajos. En conjunto, estas respuestas reflejan una comunidad editorial que navega entre la oportunidad de mejorar procesos y la necesidad de proteger los valores fundamentales de la comunicación científica.

El impacto de la IA en la comunicación académica, informes sobre la aparición de «revistas imaginarias» hasta el punto de crear revistas y citas fantásticas

Linacre, Simon. 2026. “Land of Make Believe.” Cabells Blog, 7 de enero de 2026. https://blog.cabells.com/2026/01/07/land-of-make-believe/

A finales de 2025 empezaron a surgir informes sobre algo que han llamado revistas imaginarias. La IA generativa puede “alucinar”, es decir, inventar hechos o datos presentándolos como reales, pero que llegue al punto de generar títulos de revistas y citas que no existen en absoluto ha sorprendido a muchos.

Se han detectado referencias a publicaciones que nunca han existido en trabajos académicos. Estamos acostumbrados a las revistas falsas o depredadoras, pero estos nuevos títulos sólo aparecen en bibliografías generadas por IA, sin rastro real de su existencia.

Además, también se han encontrado artículos atribuidos a autores que no existen. Incluso algunos de estos textos se han presentado a revistas legítimas. Esto podría formar parte de pruebas para evaluar sistemas de revisión o detección de plagio, aunque también podría responder a fines más oscuros.

Aunque suene sorprendente, la aparición de artículos completamente generados por IA está alterando las normas tradicionales de la investigación y la publicación académica. Muchos repositorios de preprints han tenido que restringir envíos ante el aumento de trabajos de baja calidad generados por IA.

El impacto podría ser serio: si se difunden investigaciones inventadas y otros investigadores las citan o usan como referencia, el daño se propaga rápidamente. Incluso se han visto casos en los que artículos falsos han sido citados decenas de veces, sin que los autores supieran que su nombre aparecía en esos documentos.

Frente a esta situación, las fuentes verificadas de publicaciones científicas se vuelven más importantes a medida que el uso de IA se expande. Las fronteras entre investigación humana, híbrida o generada exclusivamente por IA se están desdibujando, con implicaciones profundas para editores, autores, instituciones y financiadores.

Prioridades de la comunidad global para la IA agencial en la investigación

Research Data Alliance, “Global community priorities for agentic AI in research: Consultation results available,” Research Data Alliance, Jan. 8, 2026. [Online]. Available:

Texto completo

Research Data Alliance (RDA) ha publicado los resultados de una consulta global dirigida a identificar las prioridades de la comunidad investigadora respecto al uso de la IA agente —es decir, sistemas de inteligencia artificial capaces de operar con un alto grado de autonomía y mínima supervisión humana— a lo largo del ciclo de la investigación científica.

Esta consulta, abierta desde noviembre de 2025 y sin requerir experiencia previa en IA, combinó cuatro sesiones informativas online con una encuesta anónima de 15 minutos en la que participaron 83 personas de diversos perfiles y regiones. La iniciativa buscaba comprender cómo se está utilizando actualmente la IA agente en la investigación y qué herramientas autónomas podrían aportar más valor en tareas como planificación, búsqueda de información, gestión de datos, financiación, publicación e impacto.

De los 11 posibles agentes inteligentes propuestos, tres herramientas surgieron como prioridades claras para la comunidad global de investigación.

  1. Literature Librarian, se plantea como un asistente capaz de buscar literatura científica mediante consultas en lenguaje natural integradas con suscripciones de bibliotecas, facilitando y acelerando la revisión de antecedentes y la exploración bibliográfica.
  2. Data Director obtuvo alta valoración por su potencial para apoyar la preparación y el intercambio de datos de investigación conforme a los principios FAIR (Findable, Accessible, Interoperable, Reusable), lo que podría mejorar la calidad, disponibilidad y reutilización de los datos científicos.
  3. Funding Finder, propone una herramienta que identifique oportunidades de financiación relevantes y apoye la preparación de solicitudes, ayudando a investigadores y equipos a acceder a recursos financieros con mayor eficiencia.

Estos tres agentes se destacaron de manera consistente tanto en análisis por región como por tipo de participante.. Más allá de las prioridades concretas, los participantes expresaron una visión matizada y ambivalente sobre el futuro de la IA agente en la investigación, reconociendo tanto sus beneficios potenciales como los retos éticos, organizativos y técnicos que supone su adopción generalizada. Los resultados de la consulta serán utilizados por la RDA como base para avanzar en 2026 en el desarrollo colaborativo de un marco de referencia abierto y tecnológicamente agnóstico para al menos una herramienta prioritaria de IA agente, asegurando que este trabajo futuro se alinee con los principios y el marco de actuación de la organización y refleje las necesidades de la comunidad investigadora global.

La administración Trump cierra la biblioteca de investigación más grande del Goddard Space and Flight Center de la NASA

Niiler, Eric. “Research Library at NASA’s Goddard Space and Flight Center to Close Friday.” The New York Times, December 31, 2025. https://www.nytimes.com/2025/12/31/climate/nasa-goddard-library-closing.html

La biblioteca de investigación más grande del Goddard Space and Flight Center de la NASA, en Greenbelt, Maryland, se cerrará permanentemente el viernes 2 de enero de 2026 como parte de un proceso de reorganización de las instalaciones de la agencia espacial.

La colección contiene decenas de miles de libros, documentos y revistas, muchos de ellos no digitalizados ni disponibles en ningún otro lugar, lo que ha generado preocupación por la pérdida de acceso a material histórico y científico único.

Los fondos de la biblioteca serán revisados en un período de 60 días: una parte podría trasladarse a un almacén gubernamental y otra descartarse, siguiendo procedimientos estándar de eliminación de propiedad federal. La NASA describe el cierre como parte de una consolidación con el objetivo de ahorrar dinero y reducir costes de mantenimiento en el campus.

Este cierre forma parte de un plan más amplio que incluye la clausura de varios edificios y laboratorios de ciencia e ingeniería antes de marzo de 2026, en medio de reducciones de personal y recortes presupuestarios. Algunos investigadores han expresado su consternación, argumentando que la biblioteca ha sido un recurso crucial para planificar misiones espaciales y acceder a material histórico que no está disponible digitalmente, y que su desaparición podría dificultar investigaciones futuras.

Desde 2022, siete bibliotecas de la NASA han sido cerradas en distintos centros del país, dejando pocas instalaciones similares operativas. La pérdida de acceso físico a estas colecciones plantea preguntas sobre cómo se conservará y seguirá utilizándose el acervo científico a largo plazo.

La IA y el problema de la retractación de artículos científicos

Worlock, David. 2026. “AI and the Issue of Science Article Retraction.” DavidWorlock.com, 6 de enero de 2026. https://www.davidworlock.com/2026/01/ai-and-the-issue-of-science-article-retraction/

Se ofrece una reflexión crítica sobre los desafíos que la inteligencia artificial (IA) plantea al sistema de publicación científica, especialmente en lo referente a la integridad del registro científico y el proceso de retractación de artículos académicos.

Worlock parte de una observación fundamental: aunque la IA está transformando profundamente la creación, difusión y análisis de conocimiento, muchos de los problemas estructurales que afectan a la ciencia —como la proliferación de artículos defectuosos, revisiones por pares ineficaces o la falta de mecanismos eficaces para gestionar retractaciones— no se resolverán simplemente mediante la automatización o la adopción de nuevas herramientas tecnológicas.

El autor contextualiza el tema en un contexto más amplio de crisis de confianza en las publicaciones científicas. Señala que la incapacidad del sistema para proporcionar estándares claros y verificables de calidad y autenticidad ha permitido que proliferan trabajos de mala calidad o incluso fraudulentos, muchos de los cuales permanecen en la literatura científica sin una retractación adecuada. Este problema no se limita a casos aislados, sino que forma parte de un sistema que continúa replicando y amplificando errores debido a la presión por publicar y a la ausencia de una infraestructura de retractación centralizada y transparente.

Worlock también examina el rol de la IA en este contexto. Aunque los sistemas de IA tienen la capacidad de procesar grandes volúmenes de información, Worlock advierte que la IA no sustituye la evaluación crítica humana y que los algoritmos pueden incluso exacerbar algunos de los problemas existentes si se utilizan sin criterio. Por ejemplo, las IA pueden integrar contenido repleto de errores metodológicos o datos falsos como si fuera válido, ya que carecen de un juicio epistemológico real para discernir la calidad científica, un reto que otros expertos han también identificado recientemente como un riesgo serio para la confianza en la literatura científica automatizada.

Además, el artículo subraya la importancia de reforzar los mecanismos de retractación. Worlock plantea que la mera existencia de retractaciones no basta si estas no son accesibles, claras y eficientemente comunicadas, algo que muchos investigadores experimentan cuando intentan rastrear qué artículos han sido retirados y por qué. El problema, según él y otros especialistas, radica en que las retractaciones a menudo no están bien etiquetadas ni se integran en los flujos de datos primarios que usan los motores de búsqueda, las bases de datos académicas y los propios sistemas de entrenamiento de modelos de IA.

Una vez que se introducen datos en el modelo de formación de un LLM, no se pueden eliminar. No quiero escribir aquí sobre los actos de piratería cometidos por los actores de la IA de Silicon Valley al retirar masivamente artículos académicos de sitios web a menudo pirateados e ilegales. Sin duda, esos datos incluían artículos retractados que nunca se habían eliminado ni etiquetado como retractados en línea. De hecho, en el mundo anterior a la IA, una de las quejas sobre la búsqueda de artículos académicos era que los artículos retractados rara vez eran evidentes. Solo en épocas más recientes, Retraction Watch y Open Alex comenzaron a señalar qué datos no eran confiables en las bases de datos académicas. En otras palabras, fue la comunidad académica y sin fines de lucro la que acudió al rescate, no el sector editorial con fines de lucro. Se podría considerar cómo podríamos construir modelos más efectivos y precisos en el futuro y cómo podríamos asegurarnos de que el material retractado no se incluya en ellos.

En esencia, Worlock llama a una reforma profunda del ecosistema de publicación científica, donde la IA se utilice no como sustituto de la evaluación humana, sino como complemento que apoye una mayor transparencia, responsabilidad y calidad en la ciencia publicada. Su análisis enfatiza que los avances tecnológicos deben ir acompañados de estructuras éticas y metodológicas que preserven la integridad del registro científico y protejan la confianza pública en la investigación académica.

Desafiando la cultura de la rapidez en la universidad

Berg, Maggie, y Barbara K. Seeber. The Slow Professor: Desafiando la cultura de la rapidez en la academia. Acompañado de Slow humanities: un manifiesto. Traducido por Beltrán Jiménez Villar. Granada: Editorial Universidad de Granada, 2022

Muestra

Una obra que surge como respuesta crítica a las transformaciones que han experimentado las universidades contemporáneas, especialmente en lo que respecta a la corporativización y la cultura de la rapidez.

Las autoras Maggie Berg y Barbara K. Seeber argumentan que en las últimas décadas las instituciones de educación superior han adoptado modelos organizativos y criterios de evaluación inspirados en la lógica empresarial, centrados en la productividad, la eficiencia y la competitividad. Este enfoque, importado desde la economía de mercado, ha impuesto a las y los académicos una presión constante por producir resultados medibles y rápidos —científicos, publicaciones, proyectos— dejando poco espacio para la reflexión profunda y el pensamiento riguroso que caracteriza a la labor académica.

En su crítica, las autoras reclaman una reconfiguración del tiempo académico que permita al profesorado recuperar prácticas profesionales más pausadas, deliberadas y humanas. Para ello, se inspiran en los ideales del movimiento Slow, originalmente surgido en ámbitos como la gastronomía (Slow Food) y extendido a diversas facetas de la vida social y cultural. Aplicados al contexto universitario, estos principios promueven una forma de trabajo menos alienada por la urgencia de “hacer más en menos tiempo” y más orientada hacia la calidad de la enseñanza, la investigación profunda y la construcción de comunidades académicas solidarias y reflexivas. Berg y Seeber proponen estrategias personales y colaborativas para que las y los profesores puedan tomar el control de su tiempo profesional y, con ello, potenciar una universidad más centrada en el sentido y la consciencia que en la productividad inmediata.

Además, esta edición española incluye el texto Slow Humanities: un manifiesto, que extiende la llamada a una transformación más amplia de las humanidades y de la vida académica en general. El manifiesto articula propuestas para que la comunidad universitaria adopte de forma activa la ética de la “lentitud” como modo de resistencia al aceleracionismo institucional, fomentando así una cultura académica que valore la profundidad, la creatividad y la colaboración por encima de los logros cuantificables. En conjunto, el libro y el manifiesto aportan una reflexión crítica y a la vez práctica sobre cómo repensar el ritmo —y con ello la calidad— del trabajo académico contemporáneo.