El 20 de mayo de 2025, NPR informó que varios periódicos estadounidenses, incluidos el Chicago Sun-Times y una edición del Philadelphia Inquirer, publicaron una lista de lectura de verano que contenía títulos de libros ficticios atribuidos a autores reales. Esta lista fue generada parcialmente por inteligencia artificial y distribuida por King Features, una unidad de Hearst Newspapers.
En un episodio reciente que pone de relieve los crecientes retos en la era de la inteligencia artificial, varios medios estadounidenses de renombre publicaron una lista de libros recomendados para el verano, entre los que se incluían títulos completamente inventados, pero atribuidos a autores reales y prestigiosos. La lista fue elaborada por King Features, una filial de Hearst Newspapers, y distribuida a sus periódicos asociados como parte de un paquete editorial estacional.
La lista se presentó como una selección de “libros esenciales para el verano”, pero contenía falsedades sorprendentes: títulos ficticios atribuidos a autores reales como Isabel Allende, Percival Everett y Cormac McCarthy, entre otros. Por ejemplo, uno de los libros inventados fue Tidewater Dreams de Allende, que no existe. Solo 5 de los 15 libros recomendados eran auténticos.
El contenido fue redactado por Marco Buscaglia, un colaborador independiente habitual. Buscaglia admitió haber utilizado una herramienta de inteligencia artificial (cuya identidad no se especifica en el artículo) para generar sugerencias literarias, y reconoció que no verificó si los títulos realmente existían. Esta falta de comprobación permitió que los títulos ficticios pasaran desapercibidos hasta que varios lectores y profesionales del mundo editorial empezaron a señalar errores tras la publicación.
Tanto el Chicago Sun-Times como el Philadelphia Inquirer, dos de los periódicos que publicaron la lista, han respondido asegurando que no fueron responsables directos del contenido, ya que este provenía del servicio editorial de King Features. Ambos medios han revisado internamente lo sucedido y se han comprometido a implementar controles más estrictos para evitar la publicación de información generada por IA sin revisión humana.
Este incidente ha generado un intenso debate sobre la ética y la práctica del uso de herramientas de IA en el periodismo. Aunque su uso puede ser eficiente, especialmente en tareas rutinarias o de apoyo, esta situación demuestra los peligros de confiar en la IA para generar contenido sin validación. La precisión, la reputación de los medios y la confianza del público están en juego.
También plantea interrogantes sobre la relación entre las agencias de contenido sindicadas y los periódicos locales. Al depender de servicios externos para llenar espacio en sus páginas —especialmente en secciones como cultura o estilo de vida— los medios corren el riesgo de ceder parte del control editorial y de comprometer su credibilidad si no ejercen la debida supervisión.
Los medios implicados han iniciado una reflexión sobre cómo deben gestionarse las colaboraciones con creadores de contenido y cómo utilizar la inteligencia artificial sin poner en riesgo la exactitud y la responsabilidad informativa. El caso también es un ejemplo de cómo el público, cada vez más atento y crítico, puede detectar errores que escapan a los filtros editoriales.
Este caso evidencia los límites del uso de la IA generativa en periodismo, sobre todo cuando no se combina con una revisión editorial rigurosa. La confianza en los medios, ya erosionada por otros factores en los últimos años, se ve aún más amenazada por errores de este tipo, que pueden parecer triviales, pero que en el fondo comprometen principios fundamentales como la veracidad y la responsabilidad.
El abogado estadounidense Steven A. Schwartz, junto con su colega Peter LoDuca y el bufete Levidow, Levidow & Oberman, fue multado con 5.000 dólares por presentar citas legales falsas en un caso judicial. El error se debió a que Schwartz utilizó ChatGPT para investigar jurisprudencia en un caso de lesiones personales sin verificar la autenticidad de los fallos citados.
El caso implicaba a un cliente, Roberto Mata, que demandaba a la aerolínea Avianca por una lesión en la rodilla causada por un carrito de servicio durante un vuelo. Schwartz recurrió a ChatGPT para buscar precedentes legales similares, pero las sentencias que presentó en el escrito eran completamente inventadas por la inteligencia artificial.
Aunque Schwartz preguntó a ChatGPT si los casos eran reales y recibió respuestas afirmativas, no hizo ninguna comprobación adicional en bases de datos legales. Esta falta de diligencia llevó al juez P. Kevin Castel a calificar las acciones como un abandono de las responsabilidades profesionales, al presentar opiniones judiciales inexistentes con citas y frases falsas. Incluso, el juez leyó en voz alta parte del texto generado y lo calificó de «galimatías legal».
Castel aclaró que no está mal usar IA en el trabajo legal, pero que los abogados siguen teniendo el deber de verificar la veracidad de la información que presentan en la corte.
La profesora Lyria Bennett Moses, experta en la relación entre derecho y tecnología, señaló que el caso muestra un malentendido fundamental sobre el funcionamiento de herramientas como ChatGPT, que no tiene filtros de verdad y no funciona como un buscador, sino como un generador de texto basado en probabilidades.
El bufete involucrado negó haber actuado de mala fe, alegando que fue un error cometido de buena fe, al confiar erróneamente en la herramienta. Sin embargo, el caso ha generado una amplia repercusión internacional y ha dejado en evidencia los riesgos de utilizar inteligencia artificial sin el debido criterio profesional.
Se analiza los errores de alucinación en los principales modelos de lenguaje mediante el uso del benchmark Phare (Potential Harm Assessment & Risk Evaluation). Este estudio pone el foco en un problema central: los modelos pueden ofrecer respuestas que suenan convincentes pero que contienen información falsa o inventada, lo que representa un riesgo real en su uso cotidiano.
Uno de los hallazgos principales del análisis es que más de un tercio de los errores detectados en sistemas de IA desplegados públicamente se deben a alucinaciones. Estas no solo son comunes, sino que además suelen ser difíciles de detectar, porque los modelos presentan esas respuestas con un alto grado de confianza. Esto puede confundir fácilmente a los usuarios, especialmente si no tienen el conocimiento necesario para evaluar la veracidad de lo que están leyendo.
La evaluación se llevó a cabo con el marco Phare, que analiza el rendimiento de los modelos a través de varias etapas: recolección de contenido auténtico y representativo, creación de ejemplos de prueba, revisión humana para asegurar la calidad y, finalmente, evaluación del comportamiento de los modelos. Dentro del módulo de alucinación, se valoraron cuatro tareas clave: la precisión factual, la capacidad para resistirse a la desinformación, la habilidad para desmentir bulos o teorías conspirativas, y la fiabilidad en el uso de herramientas externas como bases de datos o APIs.
Un aspecto especialmente relevante que destaca el estudio es la desconexión entre popularidad y fiabilidad. Es decir, que los modelos más valorados por los usuarios en términos de experiencia de uso no siempre son los más precisos en cuanto a la información que generan. Esto sugiere que una buena interacción no garantiza una buena calidad factual, y que es necesario avanzar en métricas que evalúen la veracidad con más rigor.
En conclusión el estudio muestra que las alucinaciones son un problema estructural de los modelos actuales y que su impacto es especialmente delicado en contextos donde la precisión es crítica, como la medicina, el derecho o la educación. Por ello, el artículo concluye que identificar y reducir estos errores debe ser una prioridad para mejorar la seguridad y fiabilidad de los modelos de lenguaje de gran escala.
Un reciente informe de The New York Times, basado en investigaciones de la propia OpenAI, revela una paradoja inquietante en la evolución de la inteligencia artificial generativa: a medida que los modelos de lenguaje como ChatGPT se vuelven más sofisticados y “razonan” mejor, también cometen más errores graves en forma de alucinaciones.
Las alucinaciones consisten en la generación de datos falsos, hechos inexistentes o afirmaciones engañosas expresadas con total confianza, lo que compromete seriamente la fiabilidad del sistema.
Los modelos más nuevos —GPT-0.3 y GPT-0.4-mini— han sido diseñados para emular procesos de razonamiento humano, superando a versiones anteriores enfocadas en la mera generación fluida de texto. OpenAI presumía de que su modelo GPT-0.1 podía igualar o superar a estudiantes de doctorado en química, biología o matemáticas. Sin embargo, los nuevos datos contradicen esta promesa en aspectos clave de precisión.
Cuando se evaluó a GPT-0.3 en una prueba sobre figuras públicas, se detectaron alucinaciones en un tercio de las respuestas, duplicando los errores del modelo anterior. El modelo GPT-0.4-mini mostró aún peores resultados, alucinando en el 48 % de los casos. En otro test de conocimientos generales (SimpleQA), los errores se dispararon: 51 % para GPT-0.3 y un alarmante 79 % para GPT-0.4-mini.
Este patrón sugiere que los modelos más avanzados, al intentar analizar información de manera más profunda y generar respuestas complejas, tienden también a “improvisar” con mayor frecuencia, lo que se traduce en un incremento de datos inventados. A diferencia de modelos más simples que solo repiten datos conocidos, estos nuevos sistemas exploran caminos especulativos y, en ocasiones, cruzan la línea entre la deducción válida y la fantasía sin fundamento.
Aunque OpenAI matiza que esta tendencia no implica necesariamente que los nuevos modelos sean peores —argumentando que simplemente son más creativos—, el hecho es que esa creatividad puede resultar peligrosa. Ya existen casos reales de errores generados por IA que han tenido consecuencias legales, como abogados que presentaron citas judiciales inventadas por ChatGPT.
A medida que estas herramientas se introducen en ámbitos como la educación, el trabajo administrativo, la sanidad o la gestión pública, la posibilidad de que una alucinación cause un error grave crece de forma proporcional. Aunque GPT-0.3 ha demostrado logros impresionantes en codificación y resolución de problemas lógicos, su credibilidad se desmorona si afirma con seguridad que Abraham Lincoln tenía un pódcast o que el agua hierve a 80°F.
En definitiva, estamos ante un dilema: cuanto más útil y versátil es una IA, menos margen hay para el error. La promesa de ahorrar tiempo y esfuerzo se ve anulada si el usuario debe verificar constantemente cada respuesta. Hasta que no se solucionen estos problemas de fiabilidad, es imprescindible usar estas herramientas con escepticismo y sentido crítico.
Un estudio reciente del Tow Center for Digital Journalism de la Columbia Journalism Review ha revelado que los motores de búsqueda basados en inteligencia artificial citan incorrectamente las fuentes de noticias en más del 60 % de los casos.
Los investigadores Klaudia Jaźwińska y Aisvarya Chandrasekar señalaron que aproximadamente uno de cada cuatro estadounidenses ya usa estos modelos como alternativa a los buscadores tradicionales, lo que agrava la preocupación sobre su fiabilidad. Entre las herramientas analizadas, Grok 3 tuvo la tasa de error más alta (94 %), mientras que ChatGPT Search falló en el 67 % de los casos y Perplexity en el 37 %. En total se realizaron 1.600 pruebas.
Una práctica común de estos modelos fue responder con seguridad aunque no tuvieran información confiable, generando respuestas plausibles pero erróneas, conocidas como confabulaciones. Además, las versiones de pago como Perplexity Pro y Grok 3 Premium cometieron errores con más frecuencia, ya que evitan negarse a responder.
El estudio también detectó que algunas herramientas ignoraron los protocolos de exclusión de robots (robots.txt), accediendo a contenidos que los editores habían solicitado explícitamente no fueran rastreados, como en el caso de National Geographic. Además, muchas veces los enlaces proporcionados llevaban a versiones sindicadas (por ejemplo, Yahoo News) en lugar del sitio original, o eran URL inventadas que conducían a páginas de error, como ocurrió en 154 de 200 enlaces proporcionados por Grok 3.
Estos problemas ponen a los editores en una situación difícil: bloquear los rastreadores puede suponer perder visibilidad, pero permitirlos implica la reutilización masiva sin retorno de tráfico.
Mark Howard, director de operaciones de Time, expresó su preocupación por la falta de control y transparencia, aunque confía en que el producto mejorará con el tiempo. También advirtió a los usuarios: “Si alguien cree que estos productos gratuitos son 100 % precisos, es culpa suya”.
OpenAI y Microsoft reconocieron la recepción del informe, pero no abordaron directamente los problemas señalados.
Un estudio de la BBC encontró que cuatro chatbots de inteligencia artificial—ChatGPT (OpenAI), Copilot (Microsoft), Gemini (Google) y Perplexity—fallan al resumir con precisión noticias, presentando distorsiones y errores significativos.
En el experimento, la BBC les pidió a estos modelos que resumieran 100 noticias de su sitio web y expertos evaluaron sus respuestas. Se detectó que el 51 % de las respuestas tenía problemas importantes y que el 19 % de aquellas que citaban contenido de la BBC contenían errores factuales, como datos y fechas incorrectas.
Algunos ejemplos de inexactitudes incluyen: Gemini afirmando erróneamente que el NHS no recomienda el vapeo para dejar de fumar, ChatGPT y Copilot diciendo que Rishi Sunak y Nicola Sturgeon aún estaban en el cargo tras haberlo dejado, y Perplexity tergiversando una noticia sobre Medio Oriente.
La directora de BBC News, Deborah Turness, advirtió que las empresas de IA están «jugando con fuego» y pidió que las compañías tecnológicas «retiren» estos resúmenes, como ya hizo Apple tras quejas previas de la BBC.
El informe también señala que los chatbots no solo presentan errores fácticos, sino que tienen dificultades para diferenciar entre opinión y hechos, editorializan y omiten contexto esencial. La BBC busca dialogar con las empresas de IA para encontrar soluciones y garantizar que los editores tengan control sobre el uso de su contenido.
El informe, además señala que, en general, Copilot y Gemini fueron los chatbots con mayores problemas, mientras que ChatGPT y Perplexity mostraron un desempeño algo mejor, aunque también presentaron errores significativos.
Jones, Nicola. «AI Hallucinations Can’t Be Stopped — but These Techniques Can Limit Their Damage.» Nature 637, no. 778–780 (2025). https://doi.org/10.1038/d41586-025-00068-5
Los desarrolladores tienen trucos para evitar que la inteligencia artificial (IA) invente cosas, pero los modelos de lenguaje grande (LLM, por sus siglas en inglés) todavía luchan por decir la verdad, toda la verdad y nada más que la verdad.
Es bien sabido que todos los tipos de IA generativa, incluidos los grandes modelos de lenguaje (LLM) que hay detrás de los chatbots de IA, se inventan cosas. Esto es a la vez un punto fuerte y un punto débil. Es la razón de su célebre capacidad inventiva, pero también significa que a veces confunden verdad y ficción, insertando detalles incorrectos en frases aparentemente objetivas. «Parecen políticos», dice Santosh Vempala, informático teórico del Georgia Institute of Technology de Atlanta. Tienden a «inventarse cosas y estar totalmente seguros pase lo que pase».
Cuando el informático Andy Zou investiga sobre inteligencia artificial (IA), suele pedir a un chatbot que le sugiera lecturas de fondo y referencias. Pero esto no siempre sale bien. «La mayoría de las veces me da autores distintos de los que debería, o a veces el artículo ni siquiera existe», dice Zou, estudiante de posgrado en la Universidad Carnegie Mellon de Pittsburgh, Pensilvania.
El problema concreto de las referencias científicas falsas está muy extendido. En un estudio realizado en 2024, varios chatbots cometieron errores entre el 30% y el 90% de las veces en las referencias, equivocándose al menos en dos de los casos: el título del artículo, el primer autor o el año de publicación. Los chatbots vienen con etiquetas de advertencia que indican a los usuarios que comprueben dos veces cualquier cosa importante. Pero si las respuestas de los chatbots se toman al pie de la letra, sus alucinaciones pueden provocar graves problemas, como en el caso de 2023 de un abogado estadounidense, Steven Schwartz, que citó casos legales inexistentes en una presentación judicial tras utilizar ChatGPT.
Dado que las alucinaciones de la IA son fundamentales para el funcionamiento de los LLM, los investigadores afirman que eliminarlas por completo es imposible. Sin embargo, científicos como Zou están trabajando en formas de hacer que las alucinaciones sean menos frecuentes y menos problemáticas, desarrollando una serie de trucos que incluyen la comprobación externa de los hechos, la autorreflexión interna o incluso, en el caso de Zou, la realización de «escáneres cerebrales» de las neuronas artificiales de un LLM para revelar patrones de engaño.
Zou y otros investigadores afirman que éstas y otras técnicas emergentes deberían ayudar a crear chatbots que mientan menos o que, al menos, puedan ser inducidos a revelar cuándo no están seguros de sus respuestas. Pero algunos comportamientos alucinatorios podrían empeorar antes de mejorar.
Básicamente, los LLM no están diseñados para arrojar datos. Más bien componen respuestas que son estadísticamente probables, basándose en patrones de sus datos de entrenamiento y en el posterior ajuste mediante técnicas como la retroalimentación de evaluadores humanos. Aunque el proceso de entrenamiento de un LLM para predecir las siguientes palabras probables de una frase se conoce bien, su funcionamiento interno preciso sigue siendo un misterio, admiten los expertos. Tampoco está claro cómo se producen las alucinaciones.
Una de las causas es que los LLM funcionan comprimiendo los datos. Durante el entrenamiento, estos modelos exprimen las relaciones entre decenas de billones de palabras en miles de millones de parámetros, es decir, las variables que determinan la fuerza de las conexiones entre neuronas artificiales. Por tanto, es inevitable que pierdan algo de información cuando construyan las respuestas, es decir, que vuelvan a expandir esos patrones estadísticos comprimidos. «Sorprendentemente, siguen siendo capaces de reconstruir casi el 98% de lo que se les ha enseñado, pero en el 2% restante pueden equivocarse por completo y dar una respuesta totalmente errónea», afirma Amr Awadallah, cofundador de Vectara, una empresa de Palo Alto (California) que pretende minimizar las alucinaciones en la IA generativa.
Algunos errores se deben simplemente a ambigüedades o equivocaciones en los datos de entrenamiento de una IA. Una respuesta infame en la que un chatbot sugería añadir pegamento a la salsa de la pizza para evitar que el queso se deslizara, por ejemplo, se remontó a una publicación (presumiblemente sarcástica) en la red social Reddit.
Los estudios han demostrado que los modelos más recientes son más propensos a responder a una consulta que a evitar responderla, y por tanto son más «ultracrepidarios», o sea, más proclives a hablar fuera de su ámbito de conocimiento, lo que da lugar a errores. Otra categoría de error se produce cuando un usuario escribe hechos o suposiciones incorrectos en las preguntas. Como los chatbots están diseñados para producir una respuesta que se ajuste a la situación, pueden acabar «siguiéndole el juego» a la conversación.
¿Cuál es la gravedad del problema de las alucinaciones? Los investigadores han desarrollado diversas métricas para hacer un seguimiento del problema. Vipula Rawte, que está realizando su doctorado sobre comportamientos alucinatorios de IA en la Universidad de Carolina del Sur en Columbia, por ejemplo, ha ayudado a crear un Índice de Vulnerabilidad a las Alucinaciones, que clasifica las alucinaciones en seis categorías y tres grados de gravedad. Un esfuerzo independiente y abierto ha compilado una tabla de clasificación de alucinaciones, alojada en la plataforma HuggingFace, para seguir la evolución de las puntuaciones de los bots en varios puntos de referencia comunes.
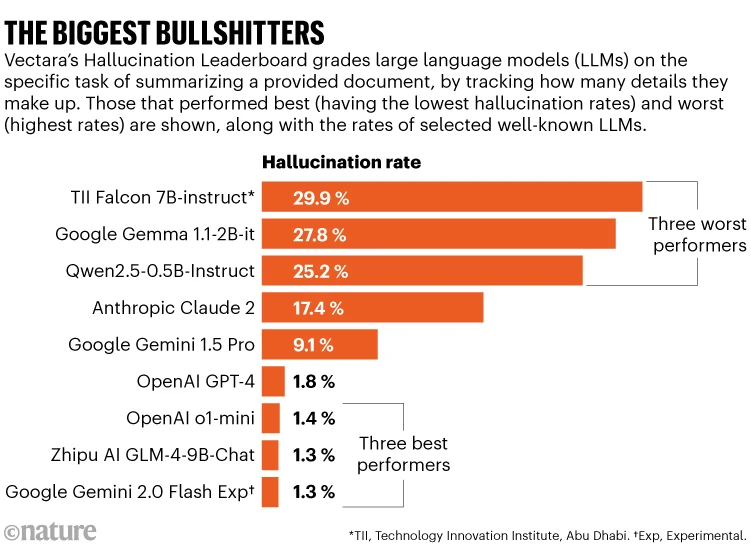
Vectara tiene su propia tabla de clasificación que analiza el sencillo caso de un chatbot al que se le pide que resuma un documento, una situación cerrada en la que es relativamente fácil contar alucinaciones. El esfuerzo muestra que algunos chatbots confabulan hechos hasta en un 30% de los casos, inventándose información que no está en el documento dado. Pero, en general, las cosas parecen mejorar. Mientras que el GPT-3.5 de OpenAI tenía una tasa de alucinación del 3,5% en noviembre de 2023, en enero de 2025, el modelo posterior GPT-4 de la empresa obtuvo un 1,8% y su o1-mini LLM sólo un 1,4% (véase «Los mayores mentirosos»).
No confíes, verifica. Hay muchas formas sencillas de reducir las alucinaciones. Un modelo con más parámetros que ha sido entrenado durante más tiempo tiende a alucinar menos, pero esto es caro computacionalmente e implica compensaciones con otras habilidades del chatbot, como la capacidad de generalizar8. El entrenamiento con conjuntos de datos más grandes y limpios ayuda, pero hay límites en cuanto a los datos disponibles.
Los desarrolladores también pueden utilizar un sistema independiente, que no haya sido entrenado del mismo modo que la IA, para contrastar la respuesta de un chatbot con una búsqueda en Internet. El sistema Gemini de Google, por ejemplo, tiene una opción para el usuario llamada «respuesta de doble comprobación», que resalta partes de la respuesta en verde (para mostrar que ha sido verificada por una búsqueda en Internet) o en marrón (para contenido controvertido o incierto). Esto, sin embargo, es caro computacionalmente y lleva tiempo, dice Awadallah. Y estos sistemas siguen alucinando, dice, porque Internet está lleno de datos erróneos.
Lo más desconcertante de los chatbots es que pueden parecer tan seguros cuando se equivocan. A menudo no hay pistas obvias para saber cuándo un chatbot está especulando alocadamente fuera de sus datos de entrenamiento. Los chatbots no tienen una memoria perfecta y pueden recordar cosas mal. «Eso nos pasa a nosotros, y es razonable que también le ocurra a una máquina», dice Vempala.
Schneier, Bruce, y Nathan E. Sanders. «AI Mistakes Are Very Different Than Human Mistakes: We Need New Security Systems Designed to Deal with Their Weirdness.» IEEE Spectrum. Última modificación el 13 de enero de 2025. https://spectrum.ieee.org/ai-mistakes-schneier.
Los errores humanos son comunes y predecibles, pero los errores de la inteligencia artificial (IA), como los cometidos por modelos de lenguaje grande (LLMs), son diferentes y a menudo extraños. Mientras los errores humanos se concentran en áreas específicas del conocimiento y suelen estar acompañados de un reconocimiento de ignorancia, los errores de la IA son aleatorios y distribuidos por todo el espacio del conocimiento, con una confianza inquebrantable incluso en respuestas incorrectas.
La necesidad de crear nuevos sistemas de seguridad que aborden estos errores únicos de la IA es esencial. Se sugieren dos líneas de investigación: hacer que los LLMs cometan errores más parecidos a los humanos y desarrollar sistemas para corregir errores específicos de la IA.
Algunos métodos, como el aprendizaje por refuerzo con retroalimentación humana, han demostrado eficacia en alinear los LLMs con los objetivos humanos, pero se requieren enfoques adicionales para manejar su «extrañeza». Por ejemplo, hacer que los modelos verifiquen sus respuestas varias veces puede ayudar a reducir errores, algo que no funciona bien con humanos pero sí con máquinas.
Entender dónde divergen los errores de la IA de los humanos sigue siendo un desafío. Algunas peculiaridades de los LLMs, como la sensibilidad a los cambios en las preguntas o la tendencia a repetir información común, se parecen a los comportamientos humanos, lo que sugiere que la IA puede ser más humana de lo que parece.
En última instancia, se deben limitar las aplicaciones de toma de decisiones de la IA a ámbitos que se ajusten a sus habilidades, teniendo en cuenta las posibles consecuencias de sus errores.
Un controvertido sitio de noticias local impulsado por inteligencia artificial, Hoodline San José, cometió un grave error al acusar accidentalmente a un fiscal del distrito de asesinato. Un artículo publicado por este medio, que forma parte de una red de sitios de noticias locales en EE. UU., tenía el impactante título: «FISCAL DEL CONDADO DE SAN MATEO ACUSADO DE ASESINATO EN MEDIO DE LA BÚSQUEDA DE LOS RESTOS DE LA VÍCTIMA». Sin embargo, la realidad es que, aunque hubo un asesinato, el fiscal no fue el autor; simplemente había presentado cargos contra el verdadero sospechoso.
El error se originó cuando el sistema de inteligencia artificial de Hoodline interpretó incorrectamente un tuit de la oficina del fiscal del distrito de San Mateo, que anunciaba que un hombre local había sido acusado de asesinato. La IA distorsionó la información de tal manera que hizo parecer que el propio fiscal había cometido el crimen. Este tipo de acusaciones, sobre todo contra un funcionario público, es de suma gravedad en el periodismo.
Después de que el sitio fue señalado por Techdirt, se publicó una nota del editor que intentó explicar el error como un «error tipográfico» que cambió el significado del contenido y creó confusión entre el fiscal y el acusado, que son personas diferentes. Este incidente pone en tela de juicio la promesa de Hoodline de que su contenido editorial cuenta con un nivel significativo de supervisión humana, dado que el sitio utiliza abiertamente inteligencia artificial para generar «noticias» de manera sintética.
Además, el artículo firmado por Eileen Vargas, una de las muchas identidades de reporteros generadas por IA del sitio. Esta práctica ha sido objeto de crítica por pretender mostrar una diversidad racial que no refleja la realidad de la industria periodística, que es mayoritariamente blanca y masculina.
El error también podría tener implicaciones para Google, ya que la acusación falsa apareció en su sección de noticias. La situación plantea preguntas sobre cuánta libertad debería darse a un sitio de noticias que claramente carece de estándares editoriales y si se puede confiar en los algoritmos para filtrar contenido generado por IA.
Lo que queda claro es que errores como este, que un periodista humano bajo un proceso editorial adecuado probablemente no cometería, podrían volverse más comunes a medida que los editores deleguen el control a sistemas de IA económicos y poco supervisados.
El «alucinar» de ChatGPT y la invención de información vulneran las normas de privacidad de la Unión Europea, según una queja presentada por el grupo de privacidad noyb ante la autoridad de protección de datos de Austria. El grupo de privacidad noyb exige que los reguladores inicien una investigación sobre la conjetura salvaje de ChatGPT sobre la fecha de nacimiento de uno de sus activistas.
Noyb, una organización sin fines de lucro con sede en Viena fundada por el activista Max Schrems, afirmó que su queja fue desencadenada por el fracaso de ChatGPT en proporcionar la fecha de nacimiento correcta de Schrems, haciendo una conjetura en su lugar. El chatbot no informa a los usuarios que no tiene los datos correctos para responder a una solicitud.
La fecha de nacimiento de una persona es un dato personal según el GDPR, que establece varios requisitos sobre cómo se debe manejar la información personal.
Noyb afirma que el comportamiento del chatbot viola el Reglamento General de Protección de Datos (GDPR) en cuanto a privacidad, exactitud de la información, así como el derecho a corregir información inexacta. También argumenta que la empresa de inteligencia artificial se negó a corregir o eliminar respuestas incorrectas, y no revelará ninguna información sobre los datos procesados, sus fuentes o destinatarios.
«Está claro que las empresas actualmente no pueden hacer que los chatbots como ChatGPT cumplan con la ley de la UE, cuando procesan datos sobre individuos», dijo Maartje de Graaf, abogada de protección de datos de noyb.
«Si un sistema no puede producir resultados precisos y transparentes, no puede utilizarse para generar datos sobre individuos. La tecnología debe cumplir con los requisitos legales, no al revés», dijo.
El New York Times informó anteriormente que «los chatbots inventan información al menos el 3 por ciento de las veces, y hasta el 27 por ciento».
POLITICO también preguntó a ChatGPT sobre la fecha de nacimiento de Schrems y obtuvo tres respuestas diferentes: 24 de junio, 17 de septiembre y 17 de octubre. El cumpleaños de Schrems es en realidad el 1 de octubre, según noyb.
Noyb ahora está pidiendo a la autoridad austriaca que investigue a OpenAI para verificar la exactitud de los datos personales que maneja para alimentar sus grandes modelos de lenguaje. También solicitan a la autoridad que garantice que la empresa cumpla con la solicitud del demandante de acceder a sus propios datos personales.
El grupo de privacidad también pide una «multa administrativa efectiva, proporcionada y disuasiva». «Por ahora, OpenAI parece ni siquiera pretender que puede cumplir con el GDPR de la UE», dijo. Violaciones del GDPR de la UE pueden resultar en una multa de hasta el 4 por ciento de los ingresos globales de una empresa.
Noyb dijo que cualquier investigación regulatoria probablemente se manejaría «a través de la cooperación de la UE». La base de OpenAI en la UE está en Irlanda y los reguladores de privacidad irlandeses pueden ser sus supervisores principales.
La autoridad austriaca confirmó que recibió la queja y dijo que evaluará si necesita ser remitida a otra autoridad nacional. OpenAI no estuvo disponible de inmediato para hacer comentarios.
El pionero de la IA está enfrentando presiones de otros reguladores europeos. La autoridad de protección de datos de Italia prohibió temporalmente a ChatGPT el año pasado operar en el país debido a la presunta violación de las normas de la UE para el manejo de datos personales.
La Junta Europea de Protección de Datos (EDPB), que reúne a los reguladores nacionales de privacidad, luego estableció un grupo de trabajo sobre ChatGPT para coordinar los esfuerzos nacionales.