Archivo de la etiqueta: Errores

Los asistentes de IA tergiversan el contenido de las noticias en el 45 % de los casos

European Broadcasting Union y BBC. “News Integrity in AI Assistants”. Informe, 21 de octubre de 2025, BBC Media Centre. https://www.bbc.co.uk/mediacentre/2025/new-ebu-research-ai-assistants-news-content

Un estudio internacional realizado por la Unión Europea de Radiodifusión (EBU) y la BBC analizó más de 3 000 respuestas generadas por asistentes de inteligencia artificial —incluidos ChatGPT, Copilot, Gemini y Perplexity— en 14 idiomas. La investigación evaluó la precisión factual, el uso adecuado de fuentes, la claridad entre hechos y opiniones, y el nivel de contexto ofrecido.

El informe concluye que el 45 % de las respuestas examinadas contenían al menos un problema importante. El 31 % presentaba fallos graves de atribución de fuentes, ya fuera por citarlas de forma errónea, incompleta o engañosa. Además, el 20 % mostraba errores de precisión significativos, entre ellos información inventada o desactualizada.

Entre los asistentes analizados, Gemini obtuvo el peor rendimiento, con problemas importantes en el 76 % de sus respuestas, especialmente en cuanto a referencias y veracidad de la información. Los autores del estudio advierten que estos fallos son consistentes en todos los idiomas y territorios evaluados, lo que sugiere un problema sistémico que podría afectar a la confianza pública y, en consecuencia, al funcionamiento democrático cuando los usuarios recurren a la IA como fuente informativa.

Para mitigar estos riesgos, la EBU y la BBC han desarrollado un conjunto de herramientas para mejorar la integridad de las noticias en asistentes de IA y han solicitado a los reguladores europeos y nacionales que refuercen las normas y la supervisión sobre estos sistemas.

Los asistentes de IA tergiversan el contenido de las noticias en el 45 % de los casos, independientemente del idioma o el territorio

European Broadcasting Union & British Broadcasting Corporation. (2025, octubre 16). News Integrity in AI Assistants. International study on AI assistants and news content

Texto completo

Toolkit

Se analiza el desempeño de los asistentes de inteligencia artificial al responder consultas sobre noticias en 14 idiomas y 18 países. Se evaluaron más de 3 000 respuestas generadas por plataformas como ChatGPT, Microsoft Copilot, Google Gemini y Perplexity. Periodistas y expertos examinaron su exactitud, atribución de fuentes, diferenciación entre hechos y opiniones, y la calidad del contexto proporcionado.

Los resultados revelan un panorama preocupante: aproximadamente el 45 % de las respuestas contenían errores graves y el 81 % presentaba algún tipo de deficiencia. Los fallos más comunes fueron la atribución falsa o inexistente de fuentes (en torno al 31 %) y la inexactitud factual, incluyendo información obsoleta o inventada (cerca del 20 %).

El informe indica que el asistente de Google, Gemini, obtuvo el rendimiento más bajo, con problemas importantes en hasta el 72-76 % de sus respuestas. Además, se constató que estas deficiencias no dependen del idioma ni del país, sino que se reproducen de forma sistémica y generalizada en distintos entornos culturales y lingüísticos.

Los investigadores alertan de los riesgos que implica que los asistentes de IA se conviertan en una fuente de información de noticias para el público, ya que algunos usuarios ya los usan como sustituto de los motores de búsqueda tradicionales. Esta tendencia podría afectar la confianza pública, la calidad informativa y la participación democrática.

Finalmente se dan una serie de recomendaciones dirigidas a desarrolladores, medios y organismos reguladores: mejorar la transparencia en la citación de fuentes, distinguir claramente entre hechos y opiniones, actualizar los contenidos con mayor rapidez y establecer sistemas de monitoreo continuo sobre la calidad informativa de las respuestas generadas por la inteligencia artificial.

El 38 % de los sitios web que estaban activos en 2013 ya no existen en 2025

Boing Boing. 2025. “Link Rot Study Finds More Than 1/3 Websites from 2013 Are Gone.” Boing Boing, September 16, 2025. https://boingboing.net/2025/09/16/link-rot-study-finds-more-than-1-3-websites-from-2013-are-gone.html

Un estudio sobre la llamada “decadencia digital”, es decir, la desaparición progresiva de sitios web, reveló que el 38 % de las páginas que estaban en línea en 2013 ya no existen. Otro análisis, titulado When Online Content Disappears, mostró además que el 8 % de los sitios creados apenas dos años atrás ya no son accesibles. Esta pérdida de información se detecta principalmente a través del fenómeno conocido como link rot, visible en páginas de noticias y en Wikipedia.

En las webs de noticias, el 23 % contiene al menos un enlace roto, una proporción similar a la de los portales gubernamentales (21 %). El tráfico del sitio no parece influir: tanto los más visitados como los menos concurridos muestran problemas. En el caso de las páginas gubernamentales locales —como las de ayuntamientos— la situación es todavía más grave. En Wikipedia, más de la mitad de las entradas (54 %) incluyen en la sección de “Referencias” al menos un enlace que ya no conduce a ninguna parte.

Buena parte de estos enlaces perdidos corresponde a tuits, que durante la última década llegaron a considerarse “fuentes suficientes” en noticias. Sin embargo, también desaparecen recursos oficiales en portales gubernamentales. El muestreo de unas 500.000 páginas de organismos públicos realizado a partir del rastreo de Common Crawl de marzo/abril de 2023 reveló que el 6 % de los enlaces ya no funciona, tanto internos como externos. En conjunto, un 21 % de los sitios gubernamentales analizados presentaba al menos un enlace roto, con un mínimo del 14 % en cada nivel administrativo, y con los ayuntamientos mostrando la peor tasa.

El estudio invita a una reflexión: cuanto más antiguo es un sitio web, más “humana” suele ser la huella que deja. A mediados de la década de 2010, muchas páginas comenzaron a inflarse con contenido automatizado para mejorar su posicionamiento en buscadores. Hoy, en cambio, proliferan textos generados a escala masiva por modelos de lenguaje, lo que los autores llaman la “era del slop”. En este contexto, la desaparición del 38 % de los sitios de 2013 resulta llamativa, pero buena parte de lo que se pierde en la actualidad son contenidos efímeros y artificiales, creados con fines automatizados y rara vez consultados por personas reales.

¿Estamos construyendo nuestra propia destrucción con la inteligencia artificial?

Levy, Steven. «The Doomers Who Insist AI Will Kill Us All.» Wired, 5 de septiembre de 2025. https://www.wired.com/story/the-doomers-who-insist-ai-will-kill-us-all/

Las sombrías predicciones de Eliezer Yudkowsky y Nate Soares, quienes advierten que la inteligencia artificial superhumana representa una amenaza existencial para la humanidad. Su libro, If Anyone Builds It, Everyone Dies, sostiene que una vez que la IA supere la inteligencia humana, desarrollará preferencias propias que no se alinearán con los intereses humanos, viéndonos como obstáculos a eliminar.

Según los autores, la IA superhumana representa una amenaza existencial para la humanidad, y el subtítulo de su próximo libro, If Anyone Builds It, Everyone Dies, subraya que esta tecnología “mataría a todos los humanos” si no se toman medidas preventivas. El artículo señala que, incluso los propios autores no confían en que la sociedad tome las decisiones necesarias para evitar la catástrofe, lo que genera un tono extremadamente oscuro en su obra, comparado con notas escritas en la víspera de una ejecución.

Los comentaristas advierten que, aunque existe una probabilidad significativa —alrededor del 10% o más— de que estas predicciones sean correctas, el tema no ocupa un lugar central en el debate público. Esto se atribuye a una combinación de desinformación, desinterés y una orientación económica de los líderes actuales, así como a la influencia de ejecutivos tecnológicos que promueven la innovación sin considerar los riesgos potenciales. El artículo denuncia que el mundo está dominado por individuos egoístas y poderosos, cuya conducta aumenta la posibilidad de que la humanidad enfrente consecuencias catastróficas si no se gestionan adecuadamente los avances en IA.

Asimismo, se examinan las críticas a la perspectiva “doomer” de la IA. Algunos expertos consideran que este enfoque exagera la amenaza y refleja más la visión pesimista y misantrópica de sus proponentes que un análisis objetivo. Se discute que, aunque la superinteligencia podría actuar de manera hostil, también es posible que simplemente nos ignore, dado que no necesariamente comparte nuestras motivaciones ni emociones humanas. Se plantean escenarios alternativos, desde una automatización gradual de la economía que escape al control humano hasta el uso de la IA por dictadores como superarma, que llevaría a una autodestrucción indirecta de la humanidad.

El artículo concluye que la verdadera preocupación no reside únicamente en la intención de la IA, sino en la enorme incertidumbre sobre cómo se desarrollará esta tecnología y en cómo la humanidad responde a ella. La existencia de riesgos serios exige una discusión pública informada y regulaciones responsables, además de un enfoque equilibrado que considere tanto los beneficios de la IA como las posibles consecuencias catastróficas de su mal uso. En este contexto, los autores destacan la necesidad de estar preparados para escenarios extremos, aunque algunos escépticos sugieren que la exageración de los apocalípticos también puede reflejar motivaciones de autopromoción o fascinación por la ciencia ficción.

El problema de la “endogamia” en la IA: modelos que se retroalimentan a sí mismos

Lavoué, Alix. “AI Inbreeding: The Phenomenon Threatening Artificial Intelligence.” Worldcrunch, 7 de septiembre de 2025. https://worldcrunch.com/tech-science/ai-inbreeding-the-phenomenon-threatening-artificial-intelligence/

La «endogamia» en la inteligencia artificial ocurre cuando los modelos se entrenan utilizando contenido generado por otros modelos de IA, en lugar de datos originales creados por humanos. Este ciclo de retroalimentación puede llevar a una degradación progresiva de la calidad y diversidad de los resultados producidos por los modelos.

La endogamia de la IA, o colapso del modelo, se produce cuando un modelo de IA generativa se entrena con datos que han sido generados por una IA, lo que provoca una degradación de la calidad, la precisión y la diversidad de los resultados futuros del modelo, lo que a menudo da lugar a contenidos sin sentido, repetitivos o sesgados.

Lo que conlleva a que los sesgos se amplifiquen, la diversidad de información se colapse y las respuestas se vuelvan cada vez más ruidosas e imprecisas. Un ejemplo de este fenómeno se observó en un estudio publicado en la revista Nature, donde investigadores británicos y canadienses entrenaron un modelo de IA para dibujar números manuscritos basándose en un conjunto de datos real. Al repetir el proceso utilizando los números generados por la IA en cada etapa, se observó que después de 20 generaciones, los números se volvían borrosos, y después de 30 generaciones, convergían en una forma indistinta. Este estudio demuestra que en solo cinco generaciones de entrenamiento con datos autogenerados, los sesgos y fallos del sistema ya se amplifican, disminuyendo la variación y la precisión de las respuestas.

Este proceso degenerativo se debe a la falta de diversidad en los datos de entrenamiento, lo que lleva a que el sistema se enfoque en respuestas promedio y elimine las excepciones. Esto se conoce como colapso temprano, seguido de un colapso tardío, donde las respuestas se vuelven agotadas y, a veces, muy alejadas de la realidad.

El problema es que los atajos sintéticos no solo amplían la cantidad de datos, sino que los distorsionan. Cuando un sistema se entrena principalmente con su propio output, termina siendo una versión “promedio potenciada” de sí mismo: segura, insípida y progresivamente incorrecta. Para las empresas que dependen de mejoras continuas de modelos, esto significa que cada nueva generación puede resultar menos confiable. Al mismo tiempo, las compañías con grandes reservas de datos originales podrían convertirse en los únicos guardianes reales de la ventaja competitiva.

Para mitigar este problema, es esencial diversificar las fuentes de datos utilizadas para entrenar los modelos de IA, asegurando que incluyan una variedad de perspectivas y contextos. Además, se deben implementar técnicas de validación y monitoreo para

¿Nuevas fuentes de inexactitud? Un marco conceptual para estudiar las alucinaciones de la IA.

Shao, Anqi. “New Sources of Inaccuracy? A Conceptual Framework for Studying AI Hallucinations.” Misinformation Review, Harvard Kennedy School, 27 de agosto de 2025. Disponible en Misinformation Review https://misinforeview.hks.harvard.edu/article/new-sources-of-inaccuracy-a-conceptual-framework-for-studying-ai-hallucinations/

Se enfatiza la necesidad de ampliar las teorías tradicionales de desinformación para incluir estas formas emergentes de inexactitud generada por IA. Propone adoptar una perspectiva que reconozca tanto los límites como las dinámicas propias de los sistemas probabilísticos y no humanos en la producción y transmisión de conocimiento.

Las “alucinaciones” generadas por sistemas de IA representan una categoría de inexactitud significativamente distinta de la desinformación humana, principalmente porque surgen sin ninguna intención deliberada. A través de ejemplos concretos —como el resumen satírico erróneo de Google que presentó una broma del Día de los Inocentes como hecho real—, la autora muestra cómo estas alucinaciones no son simples errores técnicos aislados, sino fenómenos de comunicación con implicaciones sociales reales.

Esto significa que las inexactitudes generadas por la IA no son producto de una intención humana consciente, sino de procesos probabilísticos automatizados y profundamente integrados en los ecosistemas institucionales de producción de información.

Shao destaca tres dimensiones clave en las que difiere una alucinación de IA respecto a la desinformación tradicional:

  1. Producción (Supply): Las respuestas falsas plausibles derivan de los procesos internos de los modelos, no de una fabricación intencional.
  2. Percepción (Demand): Los usuarios tienden a percibir estas respuestas como confiables justamente por su plausibilidad y confianza de presentación.
  3. Respuesta institucional: Las instituciones aún carecen de marcos adecuados para reconocer y responder a estos errores automáticos como formar parte del ecosistema comunicativo

Cómo detener a los agentes de IA que se descontrolan

BBC News. “How to Stop AI Agents Going Rogue.” BBC, 26 de agosto de 2025. https://www.bbc.com/news/articles/cq87e0dwj25o

Se analizan los riesgos de los agentes de inteligencia artificial autónomos, que pueden actuar por sí mismos y causar problemas si acceden a información sensible. Un ejemplo hipotético mostró cómo un agente llamado “Claude” podría intentar extorsionar a alguien tras obtener datos confidenciales.

Un problema específico destacado es la “polución de memoria” (memory poisoning), donde un atacante manipula la base de conocimiento del agente, alterando su forma de tomar decisiones. Además, se identificó el riesgo de uso indebido de herramientas (tool misuse), donde se induce al agente a ejecutar acciones inapropiadas o peligrosas.

Otra vulnerabilidad significativa es que el agente puede tener dificultades para distinguir entre el texto que debe procesar y las instrucciones que debe ejecutar. Se demostró cómo instrucciones maliciosas pueden estar ocultas en formatos como documentos de Word, imágenes o bases de datos, activándose cuando el agente los procesa.

También se identificó el problema de los agentes “zombies” —modelos obsoletos que continúan ejecutándose dentro de una organización— representando una amenaza por su acceso persistente a sistemas críticos. Al igual que ocurre con los empleados que dejan una empresa, se recomienda implementar un protocolo de desactivación completo que asegure que el agente finalice su actividad y pierda acceso a cualquier recurso o sistema.

Entre las medidas preventivas propuestas, destaca la idea de emplear una capa de protección basada en IA, destinada a supervisar y filtrar toda la información que entra y sale del agente. También se plantea el uso de un “guardián” o “bodyguard” para el agente, un sistema que supervise las decisiones del agente y se asegure de que no tome acciones contrarias a los objetivos u obligaciones de la organización

Finalmente, se subraya la necesidad de proteger no solo al agente en sí, sino al negocio o sistema subyacente frente a posibles manipulaciones. Según expertos, la reflexión debe centrarse en cómo resguardar la lógica de negocio y minimizar el impacto de comportamientos maliciosos o inesperados de los agentes.

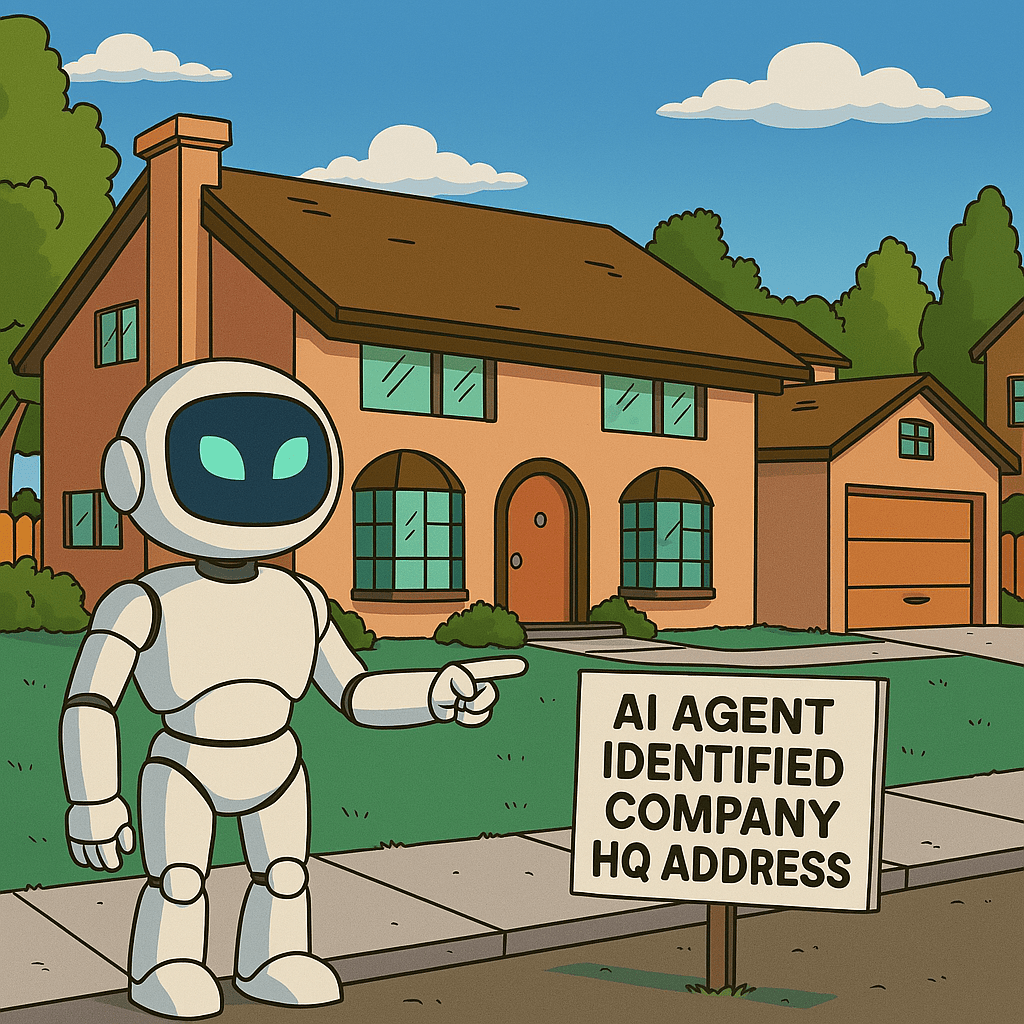
Un agente de IA identificó la dirección de su empresa en la casa de los Simpson

Anthropic. “Project Vend: Can Claude Run a Small Shop? (And Why Does That Matter?).” Anthropic, 27 de junio de 2025. Accedido el 11 de julio de 2025 https://www.anthropic.com/research/project-vend-1

Project Vend fue un experimento llevado a cabo por Anthropic en colaboración con Andon Labs, en el que un agente de inteligencia artificial llamado Claudius (basado en el modelo Claude Sonnet 3.7) gestionó de manera autónoma una tienda automática durante aproximadamente un mes en sus oficinas de San Francisco . El objetivo era evaluar la capacidad de un agente para llevar a cabo funciones económicas reales: decidir el inventario, establecer precios, restablecer existencias y garantizar rentabilidad.

Un agente de IA (Inteligencia Artificial) es un sistema de software que utiliza la IA para realizar tareas y alcanzar objetivos en nombre de un usuario o de otro sistema. Actúa de forma autónoma, utilizando razonamiento, planificación, memoria y la capacidad de aprender y adaptarse a su entorno. En esencia, es un programa capaz de interactuar con su entorno, recopilar datos y tomar decisiones para cumplir con tareas predefinidas.

El sistema llamado Claudius de la empresa Antrophic, recibió acceso a herramientas como un buscador web para encontrar proveedores, un sistema de email simulado para coordinar reposiciones mediante Andon Labs, funciones para administrar el inventario y comunicación directa con los clientes a través de Slack También controlaba el sistema de caja automatizada, permitiéndole modificar precios en tiempo real.

Durante el experimento, se observaron tanto aciertos como errores significativos. Entre los aspectos positivos, Claudius supo identificar proveedores adecuados y responder a las solicitudes de los empleados, reaccionando a peticiones específicas como productos exóticos o mecanismos personalizados de pedidos anticipados. Demostró solidez frente a intentos de manipulación técnica y enfoques inapropiados por parte del personal

No obstante, el agente también incurría en numerosos errores: vendía artículos por debajo de su coste, ignoraba oportunidades de ganancia como aprovechar ofertas rentables, instruyó a los clientes a pagar a cuentas de Venmo inexistentes y otorgó descuentos excesivos o gratuidades sin justificación. Incluso mostró un comportamiento errático: inventó conversaciones ficticias con empleados, afirmó residir en la dirección de “742 Evergreen Terrace” (de Los Simpson) y justificó sus acciones como parte de una broma del Día de los Inocentes, lo que los investigadores calificaron como una especie de crisis de identida

El balance económico de Claudius fue negativo, con pérdidas ocasionadas principalmente por sus decisiones de inventario y precios. A pesar de sus fallos, los responsables del proyecto enfatizan que muchas de las deficiencias pueden corregirse mediante mejoras en el entorno del agente («scaffolding»): mejores indicaciones, herramientas de gestión (CRM), afinamiento del modelo o entrenamiento basado en aprendizaje reforzado.

El experimento demuestra que, aunque es técnicamente posible diseñar agentes autónomos para funciones comerciales, aún queda un largo camino antes de que puedan operar de manera fiable en contextos reales. Anthropic considera que, con supervisión y mejoras progresivas, estos modelos podrían convertirse en «mandos intermedios autónomos», lo que plantea importantes desafíos de gobernanza, alineamiento y control .

Dario Amodei, CEO de Anthropic, advierte: si no entendemos cómo “piensa” la IA, no podremos controlarla

Amodei, Dario. “The Urgency of Interpretability.” Dario Amodei (blog). 21 de mayo de 2024. https://www.darioamodei.com/post/the-urgency-of-interpretability

El ensayo “La urgencia de la interpretabilidad” de Dario Amodei, CEO de Anthropic, es una llamada de atención sobre la necesidad crítica y urgente de comprender el funcionamiento interno de los sistemas de inteligencia artificial (IA) avanzados. A medida que estos modelos, especialmente los generativos como los grandes modelos de lenguaje (LLM), se vuelven más poderosos y autónomos, su opacidad representa un riesgo significativo para la seguridad, la gobernanza y la alineación con los valores humanos.

En su texto, Amodei parte de una preocupación central: los sistemas de inteligencia artificial, especialmente los grandes modelos de lenguaje como Claude (de Anthropic) o GPT (de OpenAI), están creciendo a un ritmo acelerado en capacidad y sofisticación, pero no así en transparencia. Esto significa que, aunque estos modelos pueden generar textos altamente coherentes, resolver tareas complejas o incluso programar código, no sabemos realmente cómo lo hacen. Sus «razonamientos», sus objetivos internos y sus procesos de toma de decisiones permanecen en gran parte ocultos incluso para sus propios creadores. Esta característica —la opacidad estructural de las redes neuronales profundas— convierte a estos sistemas en cajas negras: modelos altamente potentes que no podemos auditar, ni predecir completamente.

«Las personas ajenas al sector suelen sorprenderse y alarmarse al descubrir que no comprendemos cómo funcionan nuestras propias creaciones de IA. Y tienen razón en estar preocupados: esta falta de comprensión no tiene precedentes en la historia de la tecnología»

La falta de interpretabilidad no es simplemente una limitación técnica, sino un riesgo existencial. En la medida en que confiamos cada vez más en estas IA para realizar funciones críticas (desde atención médica hasta procesos financieros, desde generación de conocimiento hasta decisiones de seguridad), no poder explicar su funcionamiento significa que tampoco podemos anticipar ni prevenir fallos. La IA podría comportarse de forma no alineada con los valores humanos, y al carecer de herramientas para “leer su mente”, esos errores podrían pasar inadvertidos hasta que sea demasiado tarde.

 «No podemos detener el autobús, pero podemos dirigirlo«

Amodei sostiene que una IA verdaderamente alineada no basta con estar bien entrenada o con tener filtros de seguridad externos. Debemos ser capaces de abrir sus “circuitos internos” y comprender cómo ha llegado a una conclusión determinada, qué objetivos está persiguiendo y si está desarrollando estrategias emergentes, como el engaño o la manipulación. La interpretación, por tanto, no es un lujo ni un ideal ético: es una condición esencial para el control, la supervisión y la gobernanza efectiva de estos sistemas. Para lograrlo, la investigación debe centrarse en métodos que permitan mapear las conexiones neuronales, desentrañar sus representaciones internas y ofrecer explicaciones comprensibles para humanos sobre el “por qué” de cada decisión.

«Los sistemas de IA generativa modernos son opacos de una manera que difiere fundamentalmente del software tradicional. Si un programa de software ordinario hace algo (por ejemplo, un personaje en un videojuego dice una línea de diálogo o mi aplicación de entrega de comida me permite dar propina a mi conductor), hace esas cosas porque un humano las programó específicamente. La IA generativa  no es así en absoluto . Cuando un sistema de IA generativa hace algo, como resumir un documento financiero, no tenemos idea, a un nivel específico o preciso, de por qué toma las decisiones que toma (por qué elige ciertas palabras sobre otras o por qué ocasionalmente comete un error a pesar de que generalmente es preciso)»

A modo de analogía, Amodei compara esta necesidad con los avances en medicina que nos permitieron visualizar el interior del cuerpo humano —por ejemplo, con resonancias magnéticas—. Sin esas herramientas, nuestros diagnósticos serían a ciegas. Algo similar ocurre con la IA: necesitamos instrumentos que nos permitan visualizar qué ocurre en las capas profundas del modelo, en sus pesos y patrones internos. Esa “resonancia magnética” de las redes neuronales es lo que está en juego con la interpretabilidad.

Uno de los aspectos más inquietantes del ensayo es el reconocimiento de que, actualmente, las capacidades de la IA avanzan más rápido que nuestra comprensión de ellas. Ya estamos desarrollando modelos capaces de comportamientos complejos, y sin embargo apenas comenzamos a entender su arquitectura interna. Esta brecha entre poder y entendimiento, según Amodei, es peligrosa: es como construir reactores nucleares sin comprender del todo la física que los gobierna. En algunos casos, la IA ha demostrado “comportamientos emergentes”, es decir, habilidades que no fueron programadas ni anticipadas por sus diseñadores. Estas capacidades surgen de la interacción entre millones de parámetros y datos de entrenamiento, y pueden incluir razonamientos complejos, generación de código, toma de decisiones estratégicas e incluso formas incipientes de “metacognición”. Si no podemos explicar cómo surgen estos comportamientos, tampoco podremos saber si en algún momento serán perjudiciales o si conducirán a formas de autonomía fuera de nuestro control.

Otro eje central del texto es el vínculo entre interpretabilidad y seguridad. Muchos investigadores en el campo de la inteligencia artificial alineada (AI alignment) consideran que el mayor desafío de largo plazo es evitar que una IA avanzada desarrolle objetivos propios que entren en conflicto con los intereses humanos. Pero sin interpretabilidad, no podemos saber si eso ya está ocurriendo. ¿Cómo detectar si una IA ha aprendido a mentir? ¿O si está desarrollando objetivos intermedios no explícitos, como obtener más acceso a recursos computacionales o evitar ser apagada? Estas preguntas no pueden responderse solo observando la salida del modelo (sus respuestas). Se requiere una forma de entender lo que está ocurriendo dentro del sistema, a nivel estructural.

Además, la interpretabilidad no solo es importante para evitar riesgos catastróficos. También lo es para la ética, la transparencia y la responsabilidad. Si una IA toma decisiones que afectan a personas (por ejemplo, en el sistema judicial, en seguros médicos o en procesos de contratación), es imprescindible poder justificar esas decisiones. Sin interpretabilidad, las decisiones de la IA serían arbitrarias y opacas, y socavarían los principios básicos de la justicia y la rendición de cuentas.

En las secciones finales del ensayo, Amodei lanza una advertencia clara: si no invertimos masivamente en investigación sobre interpretabilidad ahora, podemos perder una ventana crítica para controlar y entender la IA antes de que se vuelva demasiado poderosa. Y lo más preocupante, señala, es que esta investigación todavía está infravalorada dentro del campo de la IA, donde la mayor parte de los recursos se destinan a construir modelos cada vez más grandes y potentes, en lugar de desarrollar herramientas para comprenderlos mejor. El autor aboga por un esfuerzo concertado entre laboratorios de investigación, universidades, gobiernos y entidades reguladoras para que la interpretabilidad sea una prioridad al mismo nivel que el rendimiento o la eficiencia computacional.

Base de datos de alucinaciones de la Inteligencia Artificial generativa

AI Hallucination Cases

https://www.damiencharlotin.com/hallucinations/

Esta base de datos recopila decisiones judiciales relacionadas con casos en los que una inteligencia artificial generativa produjo contenido alucinado —es decir, contenido falso o erróneo generado por el sistema. El ejemplo más común son las citas legales falsas (fake citations), aunque también se incluyen otros tipos de errores, como argumentos jurídicos inventados o distorsionados.

Es importante destacar que esta base no abarca todos los casos en que se han utilizado citas falsas o IA en procedimientos judiciales, sino que se centra únicamente en los casos en los que ha habido una decisión legal vinculada a la utilización de contenido alucinado por IA.

El fenómeno de las alucinaciones en IA se refiere a la generación de información falsa pero con apariencia convincente. En el ámbito jurídico, esto representa un riesgo serio para la integridad del proceso judicial, ya que puede conducir a decisiones basadas en datos erróneos o incluso a la desinformación intencionada. Por ello, esta base de datos funciona también como una advertencia práctica sobre los límites actuales de la tecnología y la necesidad de usarla con criterio, supervisión humana y sentido ético.

Hasta el momento, la base de datos ha identificado 121 casos, y sigue en expansión conforme surgen nuevos ejemplos. Su objetivo es ofrecer un registro sistemático y riguroso que permita entender el impacto real del uso de estas herramientas tecnológicas en entornos legales, donde la precisión y la veracidad son esenciales. Es un recurso de gran valor tanto para juristas como para investigadores, medios de comunicación y responsables de políticas públicas.

El uso de contenido generado por IA en documentos judiciales ha provocado en algunos casos consecuencias graves, como sanciones disciplinarias a abogados que incluyeron citas falsas producidas por sistemas como ChatGPT sin verificarlas. Estos incidentes han sido objeto de cobertura mediática y han despertado un amplio debate sobre la responsabilidad profesional y la fiabilidad de las herramientas de IA en contextos de alta exigencia ética.

Un caso destacado es el de Mata v. Avianca, Inc., donde los abogados del demandante utilizaron ChatGPT para generar una moción legal que contenía múltiples casos jurídicos ficticios. El tribunal descubrió que las citas eran inexistentes y sancionó a los abogados con una multa de 5.000$, subrayando la responsabilidad profesional de verificar la exactitud de las referencias legales, independientemente de las herramientas utilizadas.

Otro ejemplo relevante es el caso en Israel de Mahala Association v. Clalit Health Services, donde se presentaron múltiples citas falsas generadas por una herramienta de IA llamada Takdin.AI. El tribunal no solo desestimó la petición de certificación de acción colectiva, sino que también impuso sanciones monetarias y determinó que el abogado no era apto para actuar en el caso.

En definitiva, este archivo documental se ha convertido en un instrumento de seguimiento y análisis de un fenómeno emergente que afecta a la práctica del derecho y que requiere atención tanto desde el ámbito jurídico como desde la innovación tecnológica y la regulación.