Archivo de la etiqueta: Inteligencia artificial

En el Reino Unido se espera que la IA consuma un 500% más de energía en la próxima década

«AI’s Insatiable Need for Energy Is Straining Global Power Grids». Accedido 24 de junio de 2024. https://www.bloomberg.com/graphics/2024-ai-data-centers-power-grids/.


En el Reino Unido, se espera que la IA consuma un 500% más de energía en la próxima década. Y en los EE. UU., se proyecta que los centros de datos utilicen el 8% del total de energía para 2030, en comparación con el 3% en 2022, según Goldman Sachs, que lo describió como «el tipo de crecimiento en el consumo de electricidad que no se ha visto en una generación».

Loudoun County, en el norte de Virginia, anteriormente conocido por sus granjas de caballos y sitios de batallas de la Guerra Civil, ha sido transformado en los últimos 15 años. Sus campos y bosques se han despejado para construir centros de datos, esenciales para nuestras vidas digitales. El auge de la inteligencia artificial (IA) está acelerando la demanda de centros de datos más grandes, cambiando aún más el paisaje y sobrecargando las redes eléctricas de la región.

Esta primavera, una nueva instalación de 200,000 pies cuadrados estaba casi terminada. Una vez operativa, podría consumir tanta energía como 30,000 hogares en EE.UU. DataBank, el proveedor de centros de datos que posee la instalación, tiene un cliente «grande de tecnología» que ya ha instalado servidores antes de que DataBank tenga electricidad disponible para ellos.

James Mathes, quien administra algunas instalaciones de DataBank, comentó que la IA necesita mucha energía y la demanda es inmediata una vez disponible. El aumento repentino en la demanda eléctrica de los centros de datos supera la oferta en muchas partes del mundo, lo que genera largas esperas para acceder a la red, preocupaciones por cortes de energía y aumentos de precios en los mercados de centros de datos más densos.

El aumento dramático en la demanda de energía debido al enfoque de crecimiento a cualquier costo de Silicon Valley para la IA también amenaza los planes de transición energética de países enteros y los objetivos de energía limpia de las compañías tecnológicas multimillonarias. En algunos países, como Arabia Saudita, Irlanda y Malasia, la energía requerida para operar todos los centros de datos planificados excede la oferta disponible de energía renovable.

En Suecia, la demanda de energía de los centros de datos podría duplicarse en esta década y volver a duplicarse para 2040. En el Reino Unido, se espera que la IA consuma un 500% más de energía en la próxima década. En EE.UU., se proyecta que los centros de datos utilicen el 8% del total de energía para 2030, frente al 3% en 2022, según Goldman Sachs, que lo describió como “el tipo de crecimiento en el consumo de electricidad que no se ha visto en una generación”.

¿Por qué alucina la inteligencia artificial?


MIT Technology Review. «Why Does AI Hallucinate?» Accedido 19 de junio de 2024. https://www.technologyreview.com/2024/06/18/1093440/what-causes-ai-hallucinate-chatbots/.


El artículo «¿Por qué la inteligencia artificial alucina?» de Will Douglas Heaven, publicado en junio de 2024 por MIT Technology Review, profundiza en los desafíos que enfrentan los chatbots y los modelos de lenguaje como GPT-3.5 debido a su propensión a generar respuestas incorrectas, un fenómeno conocido como alucinación. Este problema no solo afecta la precisión de los chatbots, sino que también influye en la confianza que las personas depositan en ellos.

El artículo comienza ilustrando el problema con el caso del chatbot SARAH de la Organización Mundial de la Salud, diseñado para proporcionar consejos de salud en varios idiomas las 24 horas del día. SARAH, respaldado por el modelo GPT-3.5, fue lanzado con buenas intenciones pero rápidamente se descubrió que daba información incorrecta, incluyendo direcciones y nombres ficticios de clínicas en San Francisco. Este ejemplo subraya cómo incluso organizaciones prestigiosas pueden enfrentar desafíos con la precisión de los chatbots.

El efímero chatbot científico Galactica de Meta inventó artículos académicos y generó artículos wiki sobre la historia de los osos en el espacio. En febrero, Air Canada recibió la orden de cumplir una política de reembolso inventada por su chatbot de atención al cliente. El año pasado, un abogado fue multado por presentar documentos judiciales llenos de opiniones judiciales falsas y citas legales inventadas por ChatGPT. Estos ejemplos destacan cómo la alucinación puede llevar a errores significativos y potencialmente costosos.

El problema es que los grandes modelos lingüísticos son tan buenos en lo que hacen que lo que inventan parece correcto la mayoría de las veces. Y eso hace que sea difícil confiar en ellos. Esta tendencia a inventar -conocida como alucinación- es uno de los mayores obstáculos que impiden la adopción generalizada de los chatbots. ¿Por qué lo hacen? ¿Y por qué no podemos solucionarlo?

Para entender por qué los grandes modelos lingüísticos alucinan, tenemos que ver cómo funcionan. Lo primero que hay que tener en cuenta es que inventar cosas es exactamente para lo que están diseñados estos modelos. Cuando se hace una pregunta a un chatbot, éste extrae su respuesta del gran modelo lingüístico que lo sustenta. Pero no es como buscar información en una base de datos o utilizar un motor de búsqueda en Internet.

A diferencia de buscar información en una base de datos o en la web, estos modelos utilizan números para calcular respuestas desde cero. Cada modelo está compuesto por billones de parámetros que ajustan sus predicciones con base en patrones lingüísticos encontrados en grandes cantidades de datos textuales de internet. Cuando se les hace una pregunta, estos modelos generan secuencias de palabras nuevas basadas en probabilidades estadísticas, no en conocimiento específico almacenado.

Los grandes modelos lingüísticos generan texto prediciendo la siguiente palabra de una secuencia. Si un modelo ve «el gato se sentó», puede adivinar «en». Esa nueva secuencia se vuelve a introducir en el modelo, que ahora puede adivinar «el». Si da otra vuelta, puede adivinar «mat», y así sucesivamente. Este truco es suficiente para generar casi cualquier tipo de texto que se pueda imaginar, desde listados de Amazon hasta haiku, pasando por ficción de fans, código informático, artículos de revistas y mucho más. Como dice Andrej Karpathy, informático y cofundador de OpenAI: los grandes modelos lingüísticos aprenden a soñar con documentos de Internet.

Para adivinar una palabra, el modelo simplemente ejecuta sus números. Calcula una puntuación para cada palabra de su vocabulario que refleja la probabilidad de que esa palabra sea la siguiente en la secuencia en juego. La palabra con la mejor puntuación gana. En resumen, los grandes modelos lingüísticos son máquinas tragaperras estadísticas. Gire la palanca y saldrá una palabra.

¿Podemos controlar lo que generan los grandes modelos lingüísticos para que produzcan un texto cuya exactitud esté garantizada? Estos modelos son demasiado complicados para que sus números puedan manipularse a mano. Pero algunos investigadores creen que entrenarlos con aún más texto seguirá reduciendo su tasa de error. Es una tendencia que hemos observado a medida que los grandes modelos lingüísticos han ido creciendo y mejorando. Pero, ninguna técnica puede eliminar completamente la alucinación. Debido a su naturaleza probabilística, siempre existe un elemento de riesgo en lo que producen estos modelos.

El artículo concluye destacando la importancia de gestionar las expectativas sobre las capacidades de estos modelos. A medida que mejoren en precisión, será crucial mantener una vigilancia constante para identificar y corregir los errores que puedan surgir. Además, subraya la necesidad de una mayor investigación y desarrollo en métodos que mitiguen la alucinación en los modelos de lenguaje.

Otro método consiste en pedir a los modelos que comprueben su trabajo sobre la marcha, desglosando las respuestas paso a paso. Este método, conocido como «cadena de pensamiento», ha demostrado aumentar la precisión de los resultados de un chatbot. Todavía no es posible, pero en el futuro los grandes modelos lingüísticos podrán comprobar los hechos del texto que producen e incluso rebobinar cuando empiecen a descarrilar.

Declaración de Heredia: Principios sobre el uso de inteligencia artificial en la edición científica

Penabad Camacho, Liana, María Amalia Penabad Camacho, Andrea Mora Campos, Gerardo Cerdas Vega, Yuri Morales López, Mónica Ullate, Andrea Mendez Solano, Nidya Nova Bustos, María Fernanda Vega Solano, y María Milagro Castro Solano. «Declaración de Heredia: Principios sobre el uso de inteligencia artificial en la edición científica». Revista Electrónica Educare 28, n.o Extra 1 (2024): 1. https://dialnet.unirioja.es/servlet/articulo?codigo=9573390.

La Declaración de Heredia propone, desde la perspectiva de la edición científica, una serie de consideraciones para el uso responsable de la inteligencia artificial (IA) en los procesos de investigación que llevan a la publicación científica. Se reconoce a la IA como una herramienta cuyo uso se debe evidenciar y transparentar para un ejercicio claro, trazable y reproducible del conocimiento. Se llama la atención sobre los retos que supone la incorporación de la IA a la edición científica en cuanto a la diversidad de opciones, el evitar la propagación de sesgos y desinformación, y el respeto a la propiedad intelectual. Principios. Están organizados en cuatro grupos: general, para los roles de autoría, revisión por pares y edición. Resaltan la importancia de utilizar la IA como una herramienta cuyos resultados son filtrados por seres humanos que, desde una perspectiva ética y responsable, reportan, de forma transparente, a qué modelo, qué se consultó y cuándo se hizo la consulta. Reflexión final. Pone de manifiesto que se trata de un escenario en constante evolución cuyo fin último debe ser el bienestar humano y la calidad de vida.

La IA en la Educación: desafíos y oportunidades globales

Oxford University Press. «AI in education: where we are and what happens next». Accedido 18 de junio de 2024. https://corp.oup.com/feature/ai-in-education-where-we-are-and-what-happens-next/.

A lo largo de los 500 años de historia, Oxford University Press ha respondido a los avances del mundo para satisfacer las necesidades de estudiantes, profesores y la comunidad en general. En 2023, se ha observado un crecimiento notable en la adopción global de la inteligencia artificial (IA), impulsado por la disponibilidad y conocimiento de herramientas de IA generativa (GAI).

En el ámbito educativo, ya sea en la enseñanza tradicional o el aprendizaje de idiomas, el interés creciente en la Inteligencia Artificial Generativa plantea muchas consideraciones. Por un lado, se debate cómo educar a las futuras generaciones en el uso y desarrollo de tecnologías habilitadas por IA. Por otro, surge la pregunta urgente sobre cómo integrar positivamente estas tecnologías en los enfoques actuales de enseñanza y aprendizaje. Aunque ambos escenarios suelen ir de la mano, este informe se centra principalmente en el segundo. Queremos analizar nuestra situación actual y qué pasos debemos seguir.

Esta tecnología avanzada tiene un gran potencial en la educación, pero no es la primera tecnología digital que ha transformado la educación, ni la primera instancia de IA en el aula. Los recursos digitales, como aquellos que ofrecen aprendizaje adaptativo y personalizado, a veces respaldados por el aprendizaje automático, ya se utilizan en muchos entornos educativos.

Como editorial global, existe el compromiso de adoptar la tecnología de la manera correcta para mejorar la educación para todos. Se cree firmemente que la educación debe impulsar la tecnología, y no al revés. Con un profundo conocimiento de la pedagogía y la comprensión de las necesidades cambiantes de profesores y estudiantes, se busca desarrollar soluciones que realmente mejoren los resultados de aprendizaje y encontrar las mejores formas de avanzar juntos en este camino.

En el centro de este enfoque están los profesores y la necesidad de apoyarlos con recursos de calidad. El 88% de los profesores con los que hablamos dijeron que se beneficiarían de tener investigaciones e experiencias relevantes. Este informe se basa en una red global de expertos, investigaciones de fuentes confiables y perspectivas de comunidades de estudiantes, profesores escolares y de inglés.

El informe cubre:

  1. Una visión global: La IA ya juega un papel importante en la educación a nivel mundial, pero ¿cómo varía esto entre países?
  2. El impacto en los profesores: ¿Son optimistas los profesores sobre la IA? ¿Se sienten preparados o necesitan más apoyo?
  3. El impacto en el aprendizaje: Los estudiantes ya están utilizando IA; ¿cómo podemos aprovechar los beneficios, enseñar las habilidades adecuadas y protegernos contra los riesgos de la desinformación?
  4. Brecha digital: ¿La IA es un peligro o un nivelador? Muchos no tienen acceso a internet, mucho menos a la IA; ¿puede la nueva tecnología ayudar a cerrar las brechas existentes o las ampliará?
  5. ¿Qué sigue?: Presentamos cinco recomendaciones para líderes escolares, cuerpos educativos y gobiernos sobre cómo asegurar que la educación impulse la tecnología, y no al revés.

Un panorama global:

Los enfoques actuales hacia la IA en la educación varían considerablemente entre países. Algunos avanzan con cautela o prohíben nuevas herramientas de IA, mientras que otros las adoptan rápidamente. Esto refleja los desafíos y oportunidades únicos de cada país, así como su cultura, políticas y necesidades sociales. Los educadores han sido una fuerza impulsora en muchos países, mostrando optimismo, pero también precaución, respecto a la IA. Un porcentaje significativo de profesores en el Reino Unido y Europa ve beneficios en la IA para la educación, pero también riesgos como errores no detectados y plagio. La IA se utiliza tanto como tema de estudio como herramienta, siendo este último un tema más controvertido.

El impacto en los profesores:

Más del 70% de los profesores son optimistas sobre el papel de la IA en la educación. La IA puede resolver muchos desafíos educativos, permitiendo a los docentes dedicar más tiempo a la instrucción directa y la interacción en vivo. Actualmente, una parte considerable de los profesores utiliza herramientas basadas en IA, especialmente para la preparación de contenido, evaluación y personalización del aprendizaje. Sin embargo, la preparación de los profesores para manejar estas herramientas varía, siendo necesario un mayor apoyo y formación para garantizar un uso ético y beneficioso.

El impacto en el aprendizaje:

Una parte significativa de los estudiantes ya utiliza herramientas de IA para tareas escolares, aunque esto varía según la región. Los profesores están divididos sobre si la IA tiene un impacto positivo en los resultados educativos, reconociendo tanto beneficios como riesgos. La enseñanza de habilidades necesarias para el futuro, como el pensamiento crítico y la capacidad de identificar información fiable, es crucial, especialmente ante la creciente desinformación impulsada por la IA.

Conclusiones:

La IA es inevitable en la educación y la vida futura de los estudiantes. La educación debe apoyarlos para usarla eficazmente, asegurando que aprendan habilidades esenciales y reciban una educación basada en recursos e información de calidad. Aunque la adopción de la IA presenta desafíos, también ofrece oportunidades como la creación de nuevos roles laborales y el enfoque en habilidades fundamentales. Es esencial equipar a los jóvenes con las habilidades necesarias para usar estas herramientas de manera segura y ética, incluyendo la identificación de contenido confiable frente a la desinformación.

¿Cómo están respondiendo los investigadores a la Inteligencia Artificial (IA), que les entusiasma y preocupa?

Heaton, Benedict. «How are researchers responding to AI?» Oxford University Press, 23 de mayo de 2024. https://corp.oup.com/news/how-are-researchers-responding-to-ai/.

Oxford University Press recientemente llevó a cabo una encuesta entre más de 2,000 investigadores de diversas geografías, disciplinas académicas —incluyendo Humanidades, Ciencias STM (Science, Technology, Medicine), y Ciencias Sociales— y diferentes etapas de carrera, con el objetivo de conocer directamente de la comunidad investigadora cómo están reaccionando y utilizando la inteligencia artificial en su trabajo.

Encuesta a más de 2,000 investigadores de diversas geografías, disciplinas académicas —incluyendo Humanidades, Ciencias STM y Ciencias Sociales— y diferentes etapas de carrera, para conocer directamente de la comunidad de investigación cómo están reaccionando y utilizando la IA en su trabajo.

Los resultados revelan las consideraciones clave en las decisiones de los investigadores para involucrarse con la IA, incluyendo qué aspectos les entusiasman y les preocupan, y cómo están utilizando —o planean utilizar— las herramientas ya disponibles para ellos.

La mayoría de los investigadores académicos y autores de investigación afirman estar utilizando herramientas de inteligencia artificial (IA) en su práctica investigativa, a pesar de preocupaciones sobre la pérdida de habilidades críticas de pensamiento, el respeto por los derechos de propiedad intelectual (IP) y la desconfianza en los proveedores de IA.

Resumen de los hallazgos generales

  • Poco más de tres cuartas partes (76%) de los investigadores reportan utilizar alguna forma de herramienta de inteligencia artificial (IA) en su investigación actualmente. Las herramientas de traducción automática (49%) y los chatbots (43%) son las más populares, seguidas de los motores de búsqueda o herramientas de investigación impulsadas por IA (25%).
  • Un poco más de una cuarta parte (27%) indica tener un buen entendimiento general de las herramientas de IA.
  • Al considerar las etapas de la investigación, la IA se utiliza principalmente para descubrir investigaciones existentes, así como para la edición y resumen de investigaciones ya realizadas.
  • Aquellos que utilizan la IA en cualquier etapa de su investigación tienden a sentir que se han beneficiado al hacerlo, principalmente porque ayuda con la eficiencia.
  • La mitad (46%) de los investigadores informa que la institución donde trabajan no tiene una política de IA, y otro cuarto (26%) indica que no lo sabe.
  • En general, la confianza en las compañías de IA es muy baja, con solo un 8% confiando en que las compañías de IA no usarán sus datos sin permiso, y un 6% confiando en que cumplirán con los requisitos de privacidad y seguridad de datos.
  • También existen fuertes preocupaciones sobre las implicaciones para la propiedad intelectual y cómo la IA impactará la investigación académica en general, con una cuarta parte (25%) del grupo creyendo que la IA reduce la necesidad de pensamiento crítico.

En conclusión, la mayoría dice haber utilizado alguna forma de IA y más de dos tercios han sentido los beneficios de usar IA. También, la gran mayoría expresa desconfianza hacia las compañías de IA. Les preocupa cómo la IA podría afectar la calidad de la investigación, en concreto tienen temores sobre las cuestiones de propiedad intelectual, la posible reducción de habilidades críticas de pensamiento debido a la IA. También reconocen la importancia de considerar las implicaciones del uso de IA y más de la mitad dicen que buscaría orientación sobre IA en sociedades académicas.

    Potencial de la inteligencia artificial (IA) para las colecciones y las instituciones de patrimonio cultural

    Europeana PRO. «HAICu: Using AI to Access, Connect and Analyse Heritage Collections». Accedido 17 de junio de 2024. https://pro.europeana.eu/post/haicu-using-ai-to-access-connect-and-analyse-heritage-collections.

    El potencial de la inteligencia artificial (IA) para las colecciones y las instituciones de patrimonio cultural es enorme. La comunidad EuropeanaTech a través del proyecto HAICu ofrece colaboraciones entre investigadores e instituciones de patrimonio para explorar nuevas aplicaciones de la IA.

    HAICu, un proyecto para acceder, enlazar y analizar colecciones digitales de patrimonio utilizando IA, recibió una subvención de €10.3 millones del Consejo de Investigación de los Países Bajos en 2023 y comenzó en febrero de 2024.

    Un legado de ‘CATCH’

    Los orígenes de HAICu provienen del programa Continuous Access to Cultural Heritage, (CATCH), un programa de investigación de 15 años financiado por el Consejo de Investigación de los Países Bajos y el Ministerio de Educación, Cultura y Ciencia de los Países Bajos. Según Van der Veen-Oei, aunque HAICu no se basa directamente en CATCH, muchos de los mismos miembros de la comunidad están involucrados. CATCH hizo una importante contribución a la investigación en la intersección de TI y las instituciones de patrimonio, y más tarde se incluyeron las humanidades, con el objetivo de hacer accesibles las colecciones digitales.

    Construyendo sobre una colaboración única

    Los estudiantes de doctorado financiados por CATCH trabajaban en instituciones de patrimonio dos días a la semana, lo que resultó en doctorados y postdoctorados con experiencia tanto en el sector del patrimonio como en el ámbito académico. Esta colaboración permitió que las instituciones de patrimonio dieran sus primeros pasos creando una nueva clase de conocimientos y experiencia para ambas partes. Fue la primera vez que muchas instituciones de patrimonio cooperaron estrechamente con investigadores de TI, quienes a su vez tuvieron acceso a grandes cantidades de datos para entrenar sus herramientas y algoritmos.

    Un proyecto subsiguiente, CATCHPlus, buscó convertir prototipos o demostraciones en herramientas prácticas, aunque no todos los desarrollos fueron adoptados por las instituciones de patrimonio. Con HAICu, se busca ir un paso más allá, esta vez aplicando técnicas de IA.

    Introduciendo la inteligencia artificial

    Los investigadores y profesionales de las instituciones de patrimonio involucrados en CATCH querían continuar con la comunidad creada, incorporando nuevas técnicas de IA. Van der Veen-Oei señala que, aunque la IA ha estado en desarrollo durante décadas, hoy puede dar sentido a las colecciones de una manera responsable. Se busca utilizar estas innovaciones para acceder, enlazar y analizar colecciones.

    Instituciones como la Biblioteca Nacional de los Países Bajos (KB) enfrentan un aumento en los datos. Actualmente, KB tiene unos tres petabytes de datos digitales, y se espera que para 2027 tenga más de cinco petabytes. Para gestionar esto, se necesitan nuevas herramientas y técnicas, y ahí es donde entra el proyecto HAICu.

    Nuevas perspectivas

    La IA también aporta nuevas perspectivas a las colecciones. Lo que antes era normal, hoy puede no ser aceptable. La IA puede mostrar múltiples perspectivas, como en el caso del término Zwarte Piet (Pedro el Negro), sujeto a debate en la actualidad. La KB busca formas de detectar automáticamente este sesgo en los metadatos.

    Además, la IA proporciona contexto a los datos. El objetivo es usar los datos del patrimonio para ofrecer una reflexión transparente y confiable de la realidad, ayudando en las búsquedas con sugerencias contextuales y colocando las fuentes en contexto. Los laboratorios de innovación se utilizan para probar nuevos desarrollos dentro de HAICu.

    Enfoques multimodales

    En los últimos dos años, la IA generativa ha ganado prominencia con sistemas como ChatGPT. HAICu planea usar estos métodos de búsqueda para las colecciones de instituciones de patrimonio. La multimodalidad, utilizando diferentes fuentes, juega un papel importante. HAICu busca enlazar colecciones de texto, video, audio y más, como conectar escaneos de periódicos con material audiovisual del Instituto de Sonido y Visión de los Países Bajos, permitiendo reunir toda la información en una sola búsqueda.

    Más información

    HAICu va más allá de desarrollar y utilizar técnicas y herramientas de IA. El proyecto promueve la colaboración interdisciplinaria e institucional a través de laboratorios de innovación y proyectos de ciencia ciudadana, involucrando a aquellos que aún no participan activamente. HAICu espera proporcionar un terreno fértil para aportes y servicios curatoriales de todas las partes interesadas, asegurando la integración a largo plazo de los resultados en las organizaciones y sus redes.

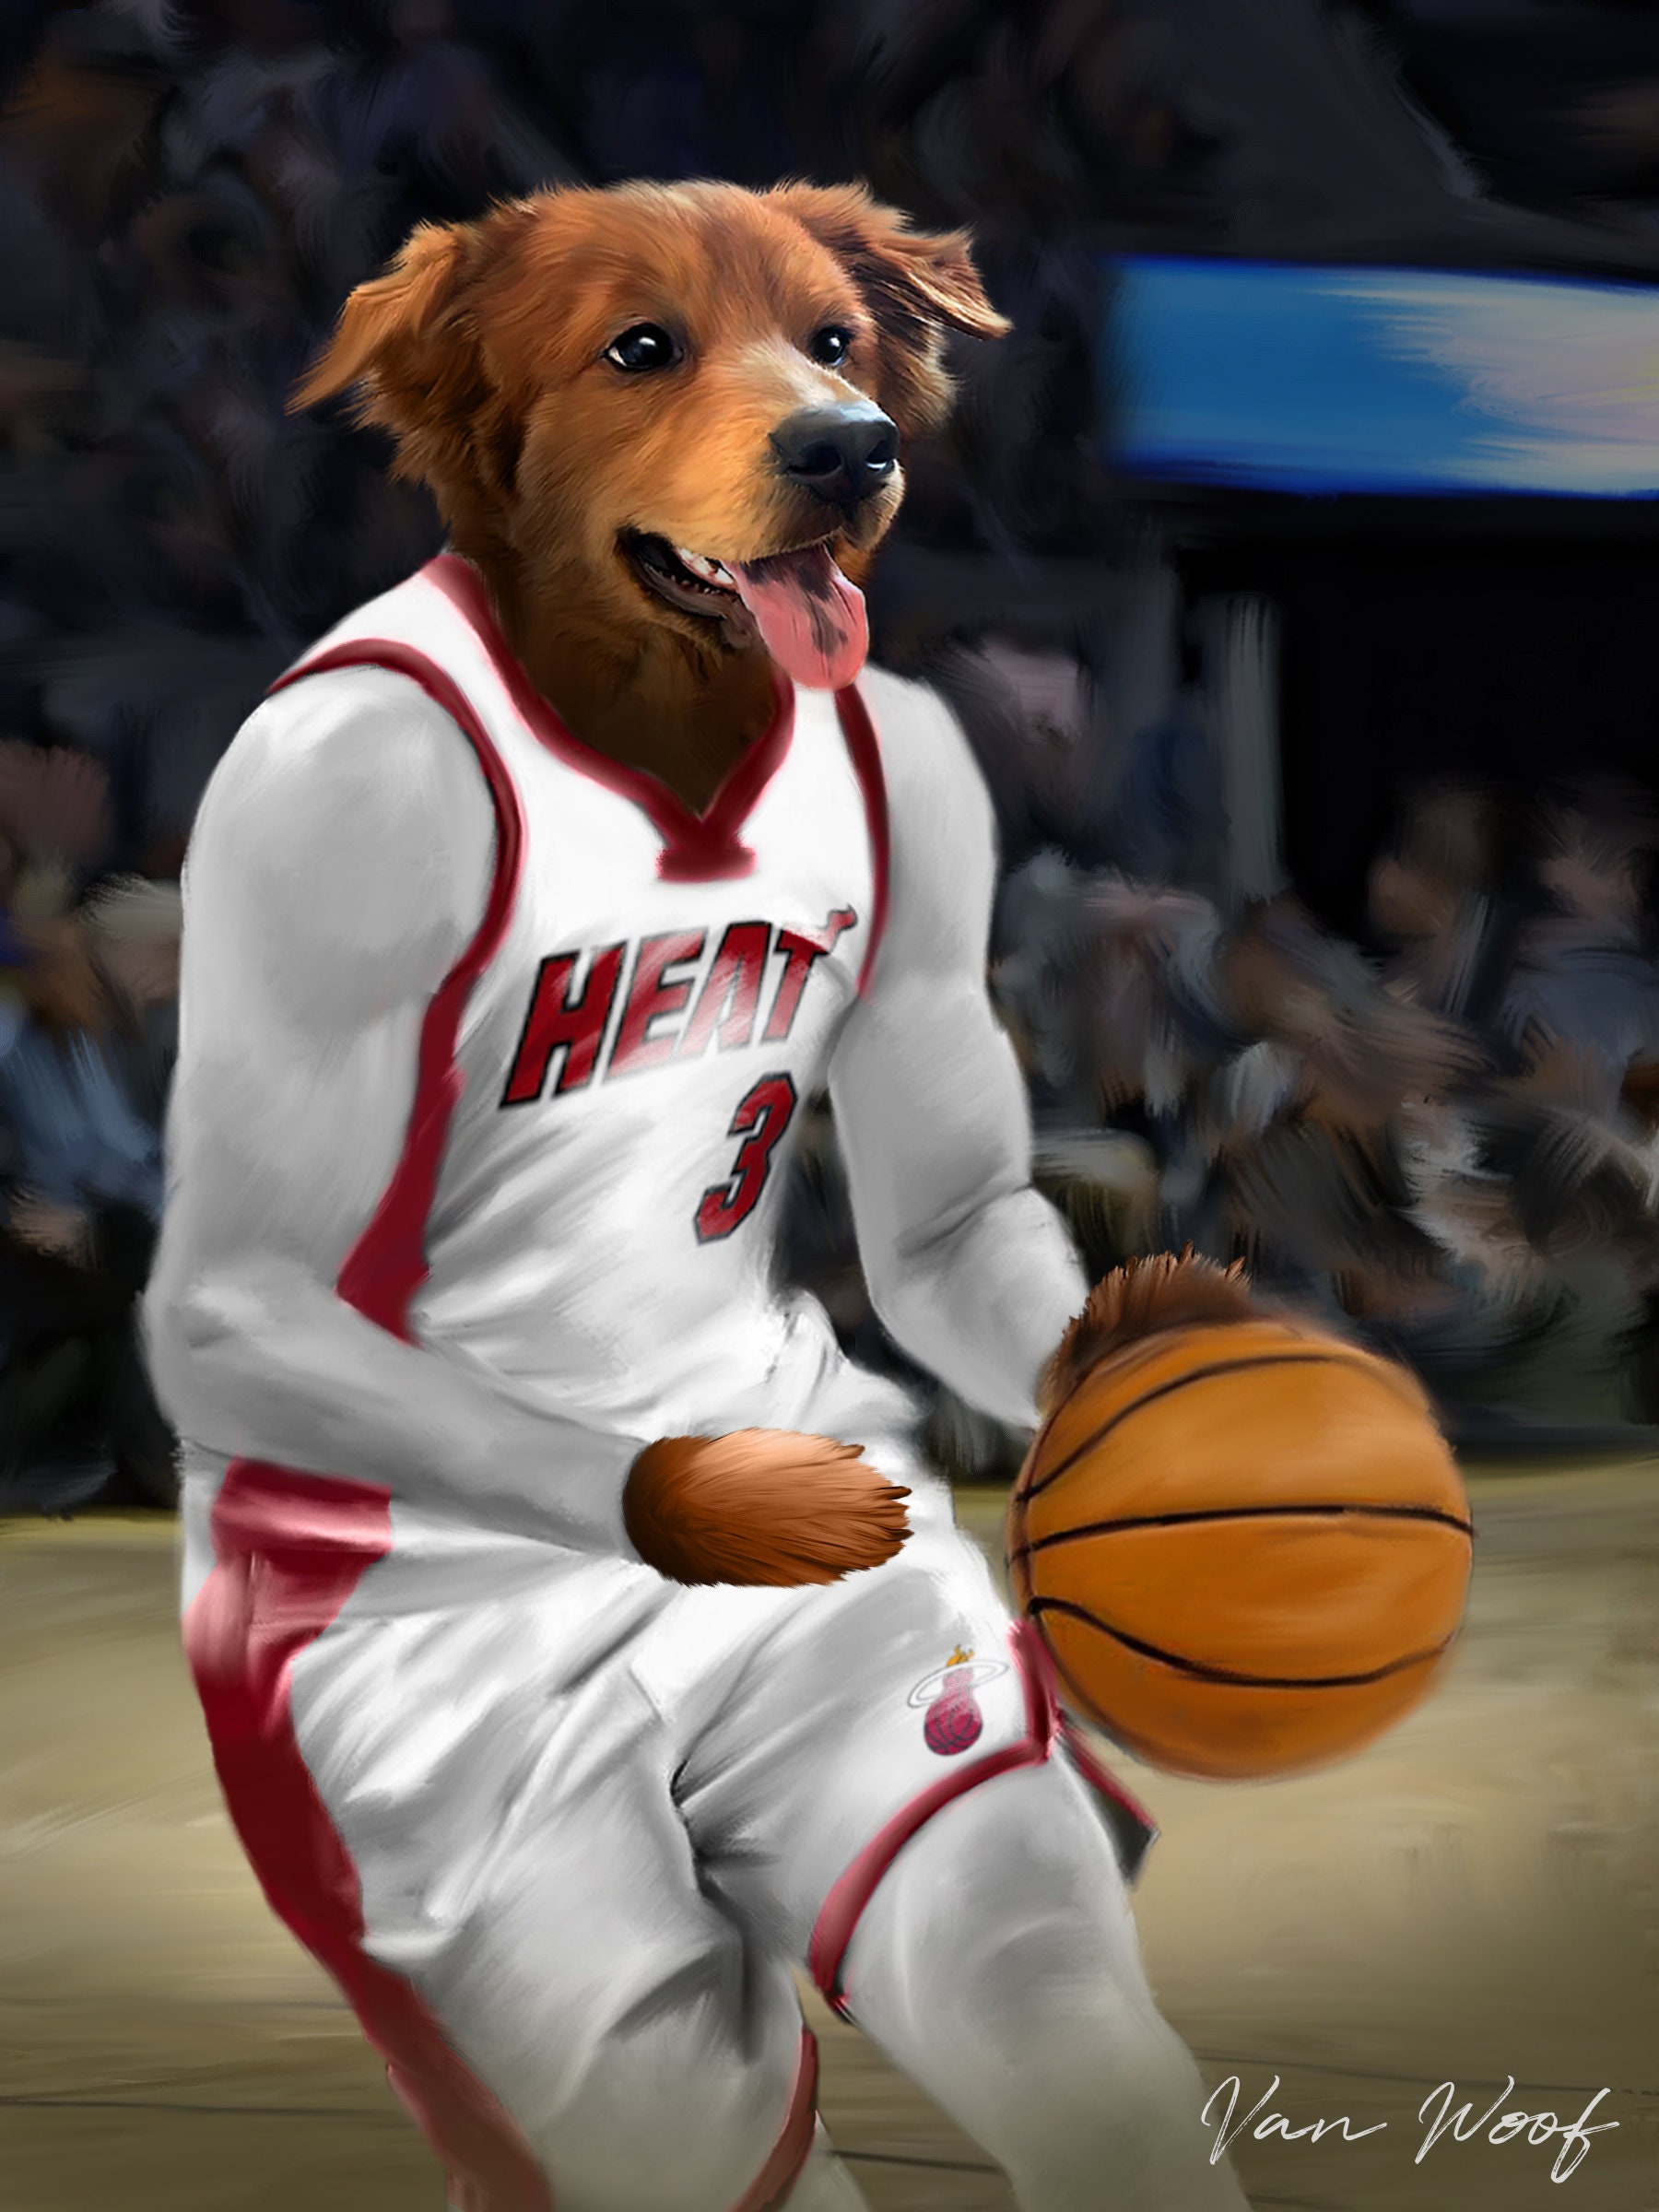
    AI Overviews: el nuevo sistema de búsquedas con respuesta de Google ofrece una receta de pizza que incluye pegamento o dice que un perro jugó en la NBA

    «Google AI Overviews Can Produce Medical Misinformation – IEEE Spectrum». Accedido 17 de junio de 2024. https://spectrum.ieee.org/google-ai-search.

    El mes pasado, Google lanzó AI Overviews, una herramienta de búsqueda con IA que genera respuestas basadas en diversas fuentes. Aunque Google aseguró haber probado extensamente la herramienta, los usuarios encontraron errores graves en las respuestas.

    El mes pasado, Google lanzó su nueva herramienta de búsqueda con IA llamada AI Overviews. La compañía aseguró que había probado la herramienta extensamente, mencionando que «las personas ya han utilizado AI Overviews miles de millones de veces a través de nuestro experimento en Search Labs». A diferencia de una búsqueda típica de Google que devuelve enlaces a páginas web, esta herramienta genera respuestas basadas en diversas fuentes, las cuales enlaza debajo de la respuesta generada.

    Inmediatamente después del lanzamiento, los usuarios comenzaron a publicar ejemplos de respuestas extremadamente erróneas, como una receta de pizza que incluía pegamento y el hecho curioso de que un perro había jugado en la NBA.

    Renée DiResta, gerente de investigación técnica en el Observatorio de Internet de Stanford, ha seguido la desinformación en línea durante muchos años y habló con IEEE Spectrum sobre el potencial de la herramienta AI Overviews para difundir consejos médicos erróneos. DiResta explicó que Google ha tenido políticas durante mucho tiempo que parecen estar en conflicto con los resultados generados por la búsqueda con IA. La rapidez en el despliegue de estas herramientas de IA en la capacidad de búsqueda ha sido apresurada y poco considerada, ya que los usuarios esperan obtener información autorizada de los motores de búsqueda.

    Google reconoció los problemas en una publicación de blog, afirmando que está al tanto de estos resultados pobres y que está intentando mejorar. Mencionaron «refinamientos de activación adicionales para mejorar nuestras protecciones de calidad» en temas de salud, aunque no está claro qué significa exactamente. Generalmente Google tiene una política llamada Your Money or Your Life que aplica altos estándares de cuidado para consultas relacionadas con finanzas y salud. Esta política tiene como objetivo devolver resultados de búsqueda de alta calidad para temas de gran impacto en la vida de las personas. Sin embargo, AI Overviews parece no seguir esta política, devolviendo información de baja calidad en algunas respuestas médicas.

    Encuesta sobre el uso de chatbots de IA generativa por parte de estudiantes para la investigación académica

    Deschenes, A., & McMahon, M. (2024). A Survey on Student Use of Generative AI Chatbots for Academic Research. Evidence Based Library and Information Practice, 19(2), 2–22. https://doi.org/10.18438/eblip30512

    El estudio de Amy Deschenes y Meg McMahon de la Universidad de Harvard revela que el 65% de los estudiantes utiliza o planea utilizar chatbots de IA generativa para trabajos académicos, aunque muchos desconfían de sus resultados. A pesar de su uso activo, los estudiantes buscan orientación para utilizarlos eficazmente. Los bibliotecarios deben aprender a usar estas herramientas para apoyar a los estudiantes en la evaluación crítica y la incorporación de resultados de IA en sus investigaciones.

    La investigación tiene como tiene como objetivo comprender el uso de la IA generativa entre estudiantes de pregrado y posgrado. Específicamente, se busca saber cuántos estudiantes utilizan estas herramientas, con qué frecuencia y para qué tareas. Además, se pretende identificar la confianza de los estudiantes en los resultados generados por la IA y sus opiniones sobre la posibilidad de una herramienta de IA generativa mantenida localmente. También se exploró el interés de los estudiantes en recibir capacitación sobre el uso de la IA generativa en el contexto académico. Este estudio tiene como finalidad ayudar a los bibliotecarios a entender la adopción de la IA generativa entre los estudiantes y la necesidad de incorporarla en sus labores de apoyo académico.

    Para llevar a cabo el estudio, un equipo compuesto por tres miembros del personal de la biblioteca y un pasante estudiante diseñó y ejecutó una encuesta que fue distribuida a 360 estudiantes de la Universidad de Harvard. La distribución se realizó a través de listas de correo electrónico y en lugares frecuentados por estudiantes como cafés y bibliotecas del campus. La recopilación y análisis de datos se llevó a cabo utilizando la plataforma Qualtrics.

    Los resultados revelaron que casi el 65% de los encuestados ha utilizado o planea utilizar chatbots de IA generativa para sus trabajos académicos. Sin embargo, a pesar de este uso, la mayoría de los estudiantes (65%) no considera que los resultados generados por la IA sean suficientemente confiables para fines académicos. Estos hallazgos indican que, aunque los estudiantes emplean activamente estas herramientas, existe una necesidad de orientación y formación sobre su uso eficaz.

    Se encontró que casi el 65% de los encuestados ha utilizado o planea utilizar chatbots de IA generativa para el trabajo académico, aunque la mayoría de los encuestados (65%) no encuentra sus resultados lo suficientemente confiables para el trabajo académico. Los hallazgos muestran que los estudiantes usan activamente estas herramientas, pero desean orientación sobre cómo usarlas eficazmente.

    En conclusión, la investigación muestra que los estudiantes están interactuando con la IA generativa en sus actividades académicas, pero no confían completamente en la información que esta produce. Es esencial que los bibliotecarios comprendan el impacto significativo de esta tecnología en los hábitos de búsqueda de información y de investigación de los estudiantes. Para brindar un apoyo adecuado, los bibliotecarios deben estar capacitados en el uso de estas herramientas, de manera que puedan asesorar a los estudiantes sobre cómo evaluar críticamente los resultados de la IA e incorporarlos de manera efectiva en sus investigaciones.

    Guía Ampliada sobre el uso de IA para autores, editores y revisores de Taylor & Francis

    Robinson, Mark. «Taylor & Francis Issues Expanded Guidance on AI Application for Authors, Editors and Reviewers». Taylor & Francis Newsroom, 12 de junio de 2024. https://newsroom.taylorandfrancisgroup.com/expanded-guidance-on-ai-application-for-authors-editors-and-reviewers/.

    A medida que el uso de inteligencia artificial (IA) generativa en la investigación y la escritura sigue evolucionando, Taylor & Francis ha emitido la última iteración de su política sobre la aplicación de herramientas de IA. La política tiene como objetivo promover el uso ético y transparente de la IA, al mismo tiempo que aborda los riesgos y desafíos que puede presentar para la publicación de investigaciones.

    Las herramientas de IA generativa están proporcionando un apoyo positivo a los investigadores en áreas como la generación de ideas, la codificación, la mejora del lenguaje y la difusión de la investigación. Sin embargo, su uso también puede plantear riesgos serios para los trabajos académicos, incluyendo la introducción de inexactitudes, sesgos o falta de atribución, así como comprometer la confidencialidad y los derechos de propiedad intelectual.

    Para apoyar la adopción responsable de las oportunidades de la IA y responder a preguntas comunes, Taylor & Francis ha lanzado una nueva política que describe las expectativas para autores, editores y revisores que utilizan herramientas de IA en su trabajo.

    La guía para autores se basa en el principio de que ellos siguen siendo responsables de la originalidad, validez e integridad del contenido que envían a los editores. Cubre áreas como la atribución de autoría, el reconocimiento del uso de IA y las actividades para las cuales no se permite el uso de IA.

    Se recuerda a los editores y revisores en la política sobre los riesgos que plantea el uso de IA para la precisión, la confidencialidad, los derechos de propiedad y los datos. Con esto en mente, la guía describe varias tareas para las cuales no se deben usar herramientas de IA, con el fin de mantener los estándares de calidad editorial y de revisión por pares.

    La política se basa en el estado actual de la IA generativa y la ética de la investigación, y se espera que siga evolucionando a medida que la tecnología y la práctica se desarrollen. Taylor & Francis acoge con satisfacción las nuevas posibilidades ofrecidas por las herramientas de IA y anima a los investigadores a usarlas de manera responsable y de acuerdo con la nueva guía.

    ¿Está ChatGPT más cerca de un bibliotecario humano que de Google?

    Brandom, David. ChatGPT: An AI OpenAI Like a Librarian, Search Google. [Gizmodo]. 2024-06-13. https://gizmodo.com/chatgpt-ai-openai-like-a-librarian-search-google-1850238908

    El modelo predominante de acceso y recuperación de información antes de que los motores de búsqueda se convirtieran en la norma -bibliotecarios y expertos en la materia o en la búsqueda que proporcionaban información relevante- era interactivo, personalizado, transparente y autorizado. Hoy en día, los motores de búsqueda son la principal forma de acceder a la información, pero introducir unas cuantas palabras clave y obtener una lista de resultados ordenados por alguna función desconocida no es lo ideal.

    Una nueva generación de sistemas de acceso a la información basados en inteligencia artificial, como Bing/ChatGPT de Microsoft, Google/Gemini y Meta/LLaMA, está cambiando el modo tradicional de entrada y salida de los motores de búsqueda. Estos sistemas son capaces de tomar frases completas e incluso párrafos como entrada y generar respuestas personalizadas en lenguaje natural.

    Casi 4.000 empleos se perdieron el mes pasado a causa de la IA, según un informe
    Nvidia afirma que su nuevo superordenador «cierra oficialmente la brecha digital». Las antiguas predicciones sobre IA demuestran que nuestras esperanzas y temores no son nuevos, aunque la tecnología sí lo sea

    A primera vista, esto podría parecer lo mejor de ambos mundos: respuestas personales y personalizadas combinadas con la amplitud y profundidad del conocimiento en Internet. Pero como investigador que estudia los sistemas de búsqueda y recomendación, creo que el panorama es, en el mejor de los casos, contradictorio.

    Los sistemas de IA como ChatGPT y Gemini se basan en grandes modelos lingüísticos. Un modelo lingüístico es una técnica de aprendizaje automático que utiliza una gran cantidad de textos disponibles, como artículos de Wikipedia y PubMed, para aprender patrones. En términos sencillos, estos modelos calculan qué palabra es probable que venga a continuación, dado un conjunto de palabras o una frase. De este modo, son capaces de generar frases, párrafos e incluso páginas que corresponden a una consulta de un usuario.

    Gracias al entrenamiento sobre grandes volúmenes de texto, el ajuste fino y otros métodos basados en el aprendizaje automático, este tipo de técnica de recuperación de información funciona con bastante eficacia. Los grandes sistemas basados en modelos lingüísticos generan respuestas personalizadas para satisfacer las consultas de información. Los resultados han sido tan impresionantes que ChatGPT alcanzó los 100 millones de usuarios en un tercio del tiempo que tardó TikTok en llegar a ese hito. La gente lo ha utilizado no sólo para encontrar respuestas, sino para generar diagnósticos, crear planes de dieta y hacer recomendaciones de inversión.

    Sin embargo, hay muchos inconvenientes. En primer lugar, consideremos lo que constituye el núcleo de un gran modelo lingüístico: un mecanismo mediante el cual conecta las palabras y, presumiblemente, sus significados. Esto produce un resultado que a menudo parece una respuesta inteligente, pero se sabe que los grandes sistemas de modelos lingüísticos producen declaraciones casi como loros sin una comprensión real. Así, aunque el resultado generado por estos sistemas pueda parecer inteligente, no es más que un reflejo de patrones subyacentes de palabras que la IA ha encontrado en un contexto apropiado.

    Esta limitación hace que los grandes sistemas de modelos lingüísticos sean susceptibles de inventar o «alucinar» respuestas. Los sistemas tampoco son lo suficientemente inteligentes como para entender la premisa incorrecta de una pregunta y responder de todos modos a preguntas erróneas. Por ejemplo, cuando se le pregunta qué cara de presidente de EE.UU. aparece en el billete de 100 dólares, ChatGPT responde Benjamin Franklin sin darse cuenta de que Franklin nunca fue presidente y de que la premisa de que el billete de 100 dólares tiene la foto de un presidente de EE.UU. es incorrecta.

    El problema es que, aunque estos sistemas se equivoquen sólo un 10% de las veces, no se sabe qué 10%. La gente tampoco tiene la capacidad de validar rápidamente las respuestas de los sistemas. Esto se debe a que estos sistemas carecen de transparencia: no revelan con qué datos se han entrenado, qué fuentes han utilizado para dar respuestas o cómo se generan esas respuestas.

    Por ejemplo, puedes pedirle a ChatGPT que escriba un informe técnico con citas. Pero a menudo se inventa estas citas, «alucinando» tanto con los títulos de los artículos académicos como con los autores. Los sistemas tampoco validan la exactitud de sus respuestas. Esto deja la validación en manos del usuario, y los usuarios pueden no tener la motivación o las habilidades para hacerlo o incluso reconocer la necesidad de comprobar las respuestas de una IA. ChatGPT no sabe cuándo una pregunta no tiene sentido, porque no conoce ningún dato.

    Aunque la falta de transparencia puede ser perjudicial para los usuarios, también es injusta para los autores, artistas y creadores de los contenidos originales de los que han aprendido los sistemas, ya que éstos no revelan sus fuentes ni proporcionan atribuciones suficientes. En la mayoría de los casos, los creadores no son compensados ni acreditados, ni se les da la oportunidad de dar su consentimiento.

    Esto también tiene un aspecto económico. En un motor de búsqueda típico, los resultados se muestran con los enlaces a las fuentes. Esto no sólo permite al usuario verificar las respuestas y proporciona las atribuciones a esas fuentes, sino que también genera tráfico para esos sitios. Muchas de estas fuentes dependen de este tráfico para sus ingresos. Dado que los grandes sistemas de modelos lingüísticos producen respuestas directas, pero no las fuentes de las que proceden, creo que es probable que esos sitios vean disminuir sus fuentes de ingresos.

    Por último, esta nueva forma de acceder a la información también puede restar poder a las personas y quitarles la oportunidad de aprender. Un proceso de búsqueda típico permite a los usuarios explorar el abanico de posibilidades para sus necesidades de información, lo que a menudo les lleva a ajustar lo que buscan. También les da la oportunidad de aprender qué hay ahí fuera y cómo se conectan las distintas piezas de información para realizar sus tareas. Y permite encuentros accidentales o serendipia.

    Son aspectos muy importantes de la búsqueda, pero cuando un sistema produce los resultados sin mostrar sus fuentes ni guiar al usuario a través de un proceso, le priva de estas posibilidades.

    Los grandes modelos lingüísticos suponen un gran avance en el acceso a la información, ya que ofrecen a las personas una forma de interactuar basada en el lenguaje natural, producir respuestas personalizadas y descubrir respuestas y patrones que a menudo resultan difíciles de imaginar para un usuario medio. Pero tienen graves limitaciones por la forma en que aprenden y construyen las respuestas. Sus respuestas pueden ser erróneas, tóxicas o sesgadas.

    Aunque otros sistemas de acceso a la información también pueden adolecer de estos problemas, los sistemas de IA con grandes modelos lingüísticos también carecen de transparencia. Y lo que es peor, sus respuestas en lenguaje natural pueden contribuir a alimentar una falsa sensación de confianza y autoridad que puede resultar peligrosa para los usuarios desinformados.