Archivo de la etiqueta: Ética de la información

Uno de cada siete artículos científicos podría ser al menos parcialmente falso

James Heathers, «How much science is fake? approximate 1 in 7 Scientific Papers Are Fake», 22 de septiembre de 2024, https://doi.org/10.17605/OSF.IO/5RF2M.


Un nuevo análisis realizado por James Heathers sugiere que uno de cada siete artículos científicos podría ser al menos parcialmente falso. Este estudio, publicado el 24 de septiembre en el Open Science Framework antes de la revisión por pares, se basó en datos de 12 estudios previos que analizaron aproximadamente 75.000 artículos. Heathers critica la cifra del 2% de fraude que se ha citado desde un estudio de 2009, argumentando que está desactualizada.

En 2009, un estudio ampliamente citado reveló que alrededor del 2% de los científicos admitían haber falsificado, fabricado o modificado datos en algún momento de su carrera. Esta cifra ha sido utilizada con frecuencia para ilustrar el problema del fraude en la ciencia. Sin embargo, 15 años después, James Heathers, investigador afiliado en psicología en la Universidad Linnaeus de Växjö, Suecia, decidió cuestionar esa cifra y ofrecer una estimación más actualizada y precisa. En su nuevo análisis, publicado el 24 de septiembre en el Open Science Framework antes de la revisión por pares, Heathers sugiere que uno de cada siete artículos científicos puede ser al menos parcialmente falso.

Heathers, conocido por su labor como «detective científico», llegó a esta conclusión al promediar datos de 12 estudios existentes. Estos estudios, que abarcan áreas como las ciencias sociales, la medicina y la biología, analizaron alrededor de 75.000 artículos para estimar el volumen de trabajos problemáticos. A través de una combinación de herramientas en línea que detectan irregularidades, Heathers encontró una «similitud persistente» entre las estimaciones de estos estudios y concluyó que, en promedio, uno de cada siete trabajos presenta errores o fraudes significativos.

Críticas a las estimaciones anteriores

Heathers explica que la cifra del 2% de fraude que proviene del estudio de 2009 está desactualizada, ya que el último conjunto de datos utilizado en ese estudio proviene de 2005. Durante los últimos 20 años, el entorno académico ha cambiado significativamente, y Heathers considera que esta cifra ya no refleja adecuadamente la magnitud del problema actual. Además, critica los enfoques anteriores que se centraban en preguntar directamente a los científicos si habían participado en prácticas deshonestas, calificando este método como ineficaz y poco fiable.

«Heathers señala que es ingenuo preguntar a los investigadores que cometen fraude si admitirán sus malas prácticas. En su lugar, propone utilizar herramientas más objetivas y datos indirectos para medir la magnitud del problema.»

Un enfoque «salvajemente no sistemático»

El propio Heathers reconoce que su estudio es «salvajemente no sistemático», ya que los datos que utilizó provienen de múltiples áreas y metodologías, y no existe un análisis homogéneo o riguroso que abarque todo el problema. Aun así, justifica su enfoque argumentando que esperar los recursos necesarios para realizar un análisis exhaustivo y sistemático tomaría demasiado tiempo, y que es importante comenzar a abordar el problema con los datos disponibles.

A pesar de sus limitaciones, Heathers decidió realizar un meta-análisis, ya que las cifras disponibles sobre la cantidad de ciencia fraudulenta son escasas. A su juicio, aunque se realice una revisión sistemática más formal, es probable que los resultados no difieran significativamente de su estimación preliminar de que uno de cada siete artículos es falso.

Críticas de otros expertos

El estudio ha recibido críticas de algunos expertos en la comunidad científica. Daniele Fanelli, un metacientífico de la Universidad Heriot-Watt en Edimburgo, Escocia, y autor del estudio de 2009, no está convencido de los resultados del nuevo análisis. Fanelli sostiene que el estudio de Heathers mezcla estudios que miden diferentes fenómenos y utiliza metodologías distintas, lo que puede llevar a conclusiones erróneas. Para Fanelli, etiquetar cualquier estudio con algún problema como «falso» no es un enfoque riguroso y podría llevar a una interpretación distorsionada del alcance real del fraude en la ciencia.

Fanelli también expresó su preocupación de que el estudio pueda atraer atención negativa e innecesaria de los medios, lo cual podría afectar la percepción pública de la ciencia sin un beneficio tangible para el campo.

Por su parte, Gowri Gopalakrishna, epidemióloga de la Universidad de Maastricht en los Países Bajos, también expresó reservas sobre las conclusiones de Heathers. Gopalakrishna coautorizó un estudio en 2021 que encontró que el 8% de los investigadores en una encuesta de casi 7.000 científicos en los Países Bajos admitieron haber falsificado o fabricado datos entre 2017 y 2020. Sin embargo, Gopalakrishna cree que la prevalencia del fraude puede variar significativamente entre diferentes campos de estudio, y agrupar todas las disciplinas bajo una misma cifra podría ser poco útil y conducir a interpretaciones erróneas.

Una amenaza existencial para la ciencia

A pesar de las críticas, Heathers sostiene que el problema del fraude en la ciencia representa una amenaza existencial para el campo y debe abordarse de inmediato. Argumenta que los científicos, las instituciones científicas y los organismos de financiación deben reconocer la gravedad del problema y actuar en consecuencia. El hecho de que un número significativo de publicaciones científicas pueda estar contaminado por fraudes o errores serios socava la confianza en el proceso científico y pone en riesgo el progreso del conocimiento.

Heathers también destaca que el fraude en la ciencia está «crucialmente subfinanciado» en términos de investigación y vigilancia, lo que agrava el problema. Aunque su estudio no es exhaustivo, espera que su trabajo sirva como un primer paso para abordar una cuestión que ha sido pasada por alto durante demasiado tiempo.
Un estudio descubre en Google Scholar artículos de investigación generados por IA

Researcher discussing Google Scholar results beside books, notes, and a laptop
A researcher discusses academic sources while reviewing Google Scholar results with a colleague.

«Study finds AI-generated research papers on Google Scholar – why it matters | ZDNET», accedido 16 de septiembre de 2024, https://www.zdnet.com/article/study-finds-ai-generated-research-papers-on-google-scholar-why-it-matters/#ftag=RSSbaffb68.

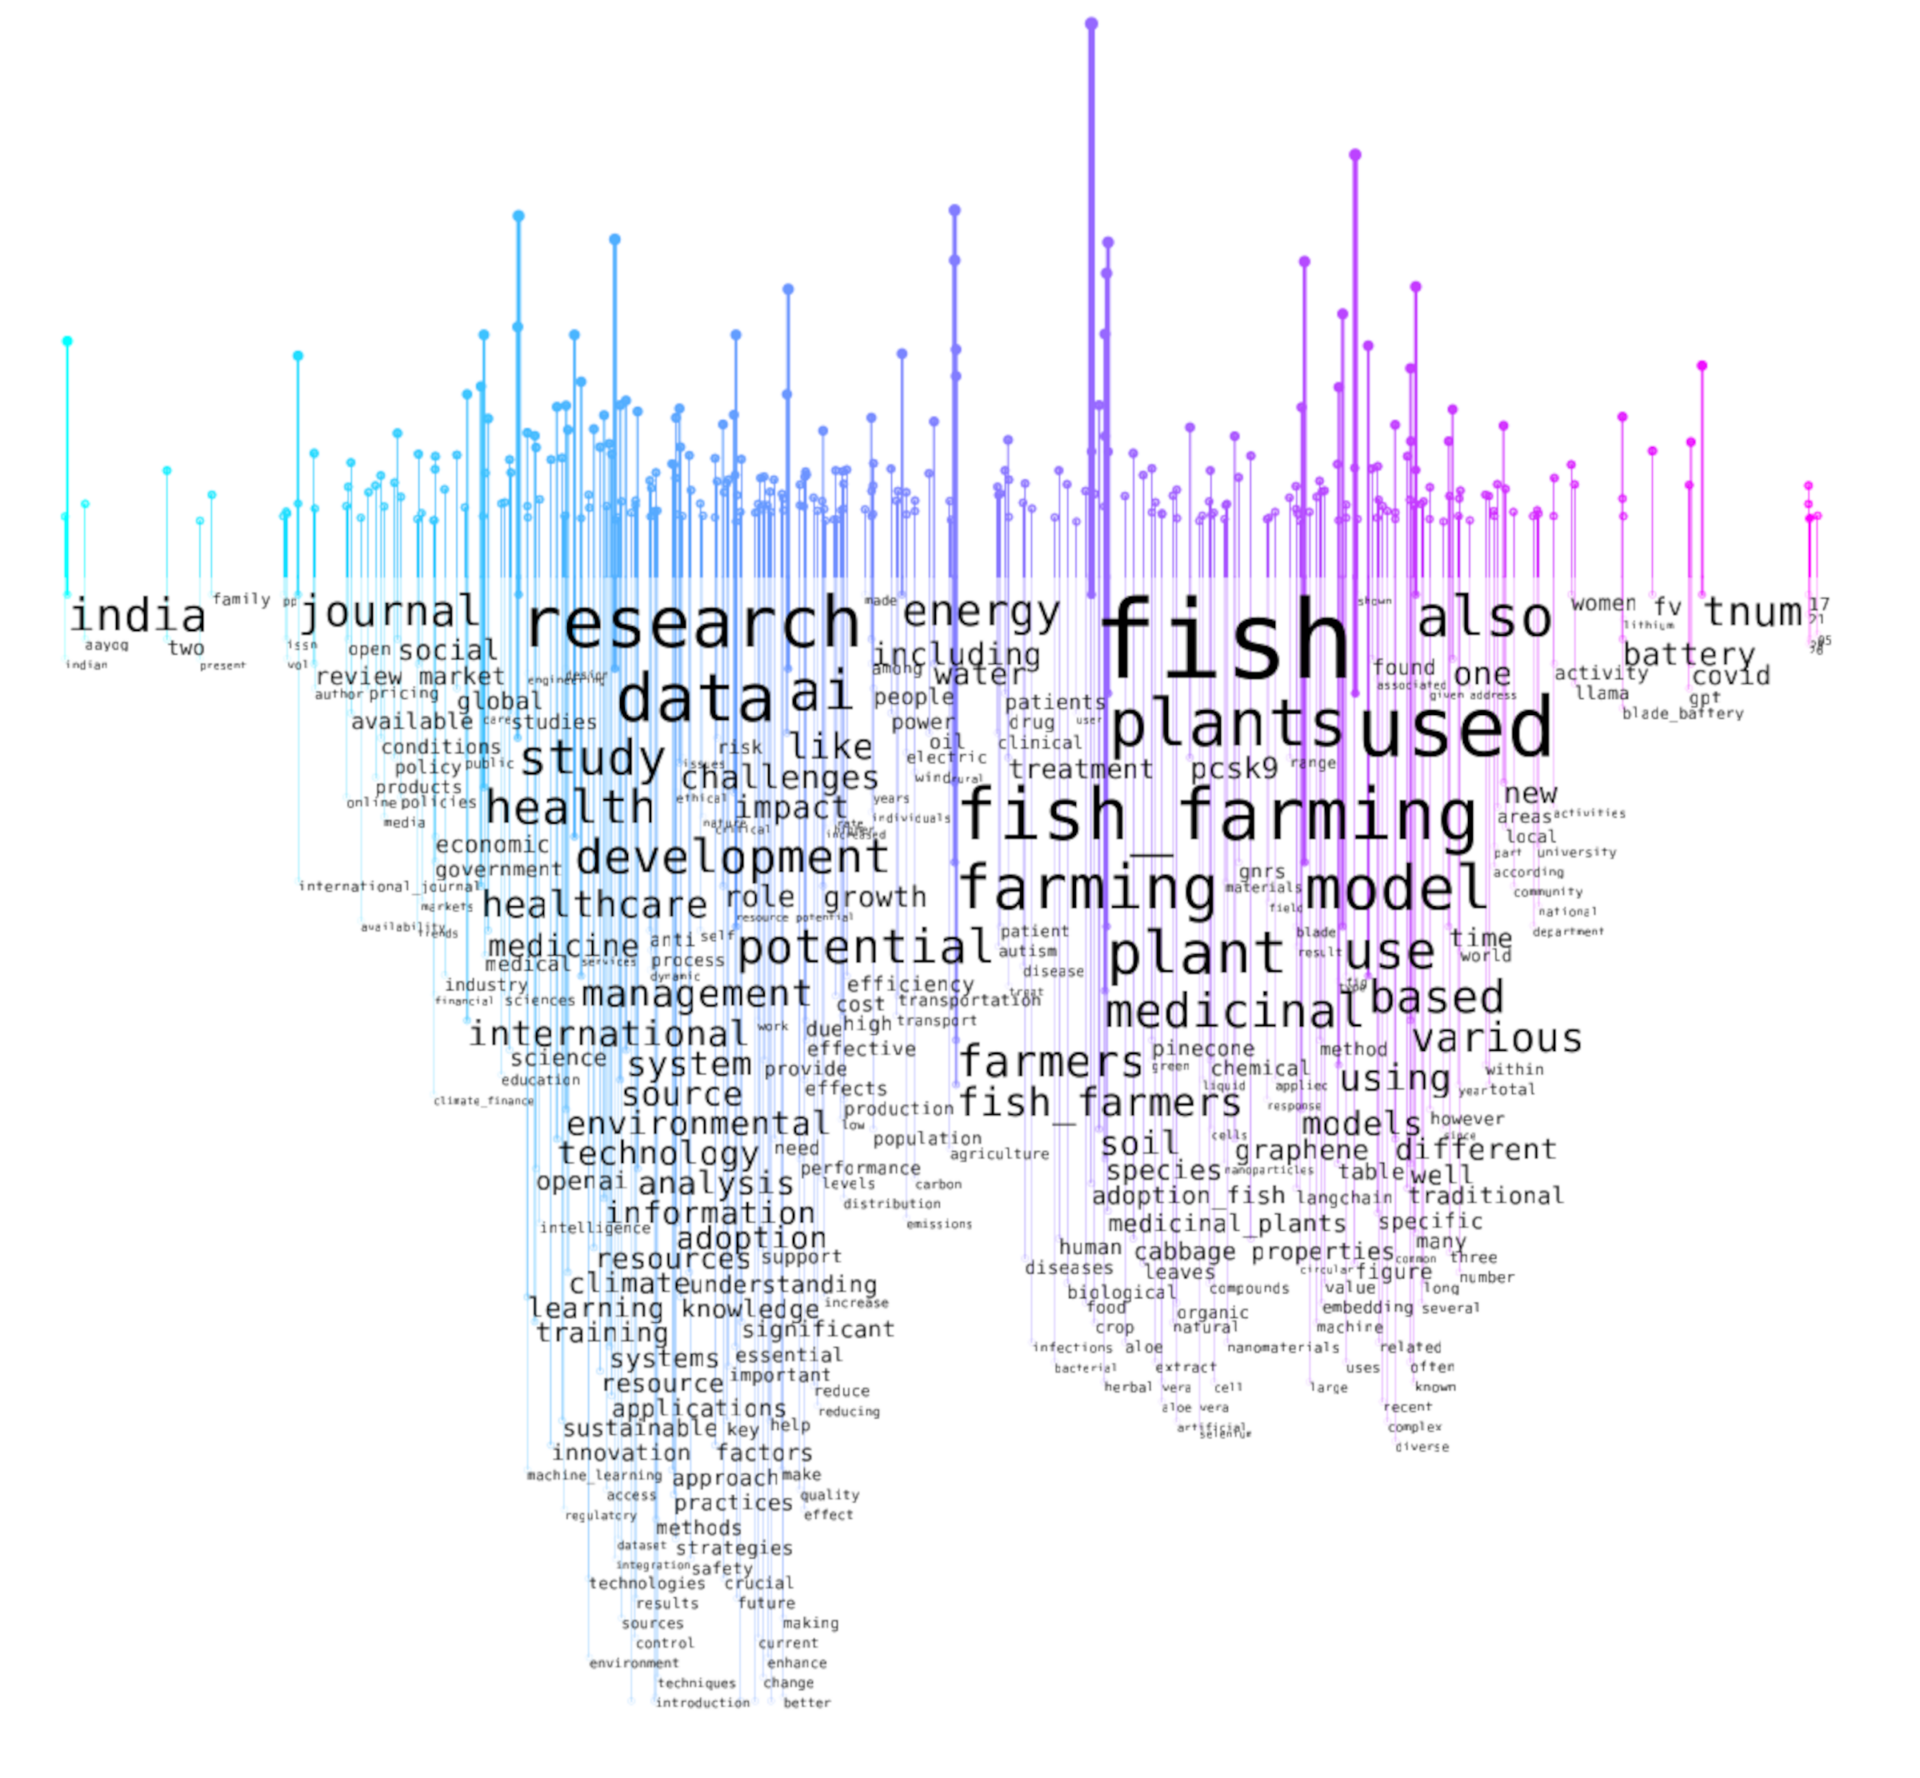
Un estudio reciente, publicado en la Harvard Kennedy School’s Misinformation Review, encontró que al menos 139 artículos disponibles en Google Scholar parecen haber sido generados por herramientas de inteligencia artificial (IA). De estos, la mayoría se encontró en revistas no indexadas, pero 19 aparecieron en revistas verificadas y otras 19 en bases de datos universitarias, presuntamente escritas por estudiantes. Esto subraya una creciente preocupación sobre la proliferación de investigaciones falsas, facilitada por herramientas generativas de IA como ChatGPT.

Los investigadores identificaron estos estudios sospechosos por la inclusión de frases típicas de los modelos de lenguaje, como las generadas por ChatGPT. Además, los estudios estaban ampliamente disponibles en varias bases de datos, archivos y redes sociales, aumentando su visibilidad. Temas sensibles como la salud, la tecnología computacional y el medio ambiente estaban entre los más comúnmente abordados por estos artículos falsos, lo que es alarmante dado que pueden influir en decisiones de políticas públicas y la percepción de temas clave.

El estudio destacó que la aparición de ChatGPT y otras IA en 2022, junto con el funcionamiento de Google Scholar, ha incrementado la posibilidad de que personas sin formación académica (como periodistas, políticos, pacientes y estudiantes) encuentren y citen estudios falsos. Esto es particularmente problemático porque, a diferencia de los sesgos o «alucinaciones» de los chatbots de IA, los estudios presentados en una plataforma académica como Google Scholar parecen auténticos y pueden llevar a una mayor confusión o desinformación.

Aunque Google Scholar contiene una amplia gama de literatura académica de calidad, el estudio critica su falta de transparencia y sus criterios automáticos de inclusión, lo que permite que cualquier autor, independientemente de su afiliación científica, pueda subir artículos. A diferencia de otras bases de datos académicas, Scholar no permite filtrar por tipo de material, estado de publicación o si los artículos han sido revisados por pares, lo que facilita que estudios falsos o generados por IA se cuelen en los resultados de búsqueda.

Otro punto preocupante es que, aunque herramientas de detección de contenido generado por IA están mejorando, aún no son lo suficientemente sofisticadas como para identificar de manera confiable estos estudios falsificados. El estudio también señala que, en el pasado, otros investigadores han encontrado libros y artículos falsos en Google Books y Google Scholar utilizando frases características de los chatbots como «Hasta mi última actualización de conocimiento», común en respuestas de ChatGPT.

Con millones de usuarios confiando en Google Scholar para sus investigaciones, la posibilidad de que se citen estos estudios falsos es cada vez mayor. Esto plantea un grave riesgo para la integridad del registro científico y del sistema de comunicación académica, ya que los estudios generados por IA pueden parecer convincentemente científicos, aunque sean completamente falsos. Los autores del estudio advierten que, a medida que la tecnología avanza, será más difícil detectar estos estudios, lo que amenaza con sobrecargar el ecosistema de investigación y desinformar tanto a académicos como al público en general.

En resumen, la creciente inclusión de estudios falsos generados por IA en Google Scholar plantea un peligro para la comunidad científica y el público, ya que estos trabajos pueden influir en decisiones importantes sin ser detectados. La falta de filtros y la facilidad con la que se puede subir contenido no revisado en plataformas académicas populares hace que sea crucial abordar este problema antes de que cause daños irreparables a la confianza en la ciencia y la academia.

Documentos científicos elaborados por Inteligencia Artificial en Google Scholar

Haider, Jutta, Kristofer Rolf Söderström, Björn Ekström, y Malte Rödl. «GPT-Fabricated Scientific Papers on Google Scholar: Key Features, Spread, and Implications for Preempting Evidence Manipulation». Harvard Kennedy School Misinformation Review, 3 de septiembre de 2024. https://doi.org/10.37016/mr-2020-156.


El estudio analiza la aparición de publicaciones científicas cuestionables, producidas con transformadores pre-entrenados generativos (GPT), en Google Scholar. Se investiga dónde se publican o depositan estos trabajos, sus características principales, cómo se difunden en la infraestructura de comunicación académica y cómo desafían el rol de esta infraestructura en mantener la confianza pública en la ciencia.

Para elaborar el estudio se realizó una búsqueda y extracción de datos en Google Scholar utilizando la biblioteca de Python Scholarly (Cholewiak et al., 2023) para identificar artículos que contenían frases comunes generadas por ChatGPT y aplicaciones similares basadas en el mismo modelo subyacente (GPT-3.5 o GPT-4): «a partir de mi última actualización de conocimiento» y/o «no tengo acceso a datos en tiempo real». Esto permitió identificar artículos que probablemente usaron inteligencia artificial generativa para producir texto, resultando en 227 artículos recuperados. La información bibliográfica de estos artículos se añadió automáticamente a una hoja de cálculo y se descargó en Zotero.

Todos los artículos contenían al menos una de las dos frases comunes devueltas por los agentes conversacionales que utilizan grandes modelos de lenguaje (LLM) como ChatGPT de OpenAI. A continuación, se utilizó la búsqueda de Google para determinar en qué medida existían copias de artículos cuestionables elaborados con GPT en diversos repositorios, archivos, bases de datos de citas y plataformas de redes sociales.

Para explorar la extensión del trabajo generado por ChatGPT en el índice de Google Scholar, se realizó un estudio que rastreó la plataforma en busca de publicaciones que contenían respuestas comunes de ChatGPT. El análisis reveló que alrededor del 62% de estos artículos no declaraban el uso de GPT, con la mayoría encontrados en revistas no indexadas y documentos de trabajo, aunque algunos aparecían en revistas y actas de conferencias de prestigio. Es notable que el 57% de estos artículos estaban relacionados con áreas de política susceptibles a operaciones de influencia. La mayoría de estos documentos estaban relacionados con temas relevantes para políticas públicas, como el medio ambiente, la salud y la informática, que son susceptibles de ser manipulados.

La presencia de texto generado por GPT se observó en diversas secciones de los artículos, incluyendo revisiones de literatura, métodos, marcos teóricos y discusiones. Esto sugiere un uso generalizado de GPT en la creación de artículos completos, lo que genera preocupaciones sobre la integridad de las publicaciones científicas y la posibilidad de lo que se denomina «piratería de evidencia»—la manipulación deliberada de la base de evidencia para influir en la opinión pública y en las políticas.

La proliferación de publicaciones fabricadas pone en riesgo la integridad del sistema de comunicación académica y socava la confianza en la ciencia. Además, la posibilidad de que estos textos falsos sean recuperados por motores de búsqueda académicos como Google Scholar aumenta el riesgo de manipulación maliciosa de la evidencia científica.

Para mitigar estos riesgos, el estudio recomienda un enfoque multifacético que incluya medidas técnicas, educativas y regulatorias. Estas podrían implicar opciones de filtrado en los motores de búsqueda académicos para distinguir entre literatura revisada por pares y literatura gris, así como el desarrollo de un motor de búsqueda académico no comercial para uso público. Las iniciativas educativas dirigidas a los responsables de la formulación de políticas, periodistas y otros profesionales de los medios también son cruciales para mejorar la alfabetización mediática e informativa y reducir el impacto de la desinformación.

Este problema no solo se deriva del uso de generadores de texto como ChatGPT, sino que también refleja preocupaciones más amplias sobre el sistema de publicaciones académicas y la monopolización de la información por parte de plataformas como Google Scholar. La proliferación de artículos fraudulentos puede erosionar la confianza en la ciencia, con consecuencias graves para la sociedad y la forma en que se manejan las «desórdenes de información».

El estudio concluye que el problema de los artículos fabricados por GPT probablemente se vuelva más generalizado, con implicaciones significativas para la credibilidad de la comunicación científica y la confianza pública en la ciencia. Para abordar este problema, es esencial entender las razones subyacentes a la proliferación de dicho contenido y desarrollar estrategias para prevenir su manipulación y difusión.

Los los chatbots de inteligencia artificial (IA) se pueden manipular mediante el uso de texto invisible en los sitios web.

Roose, Kevin. «A Conversation With Bing’s Chatbot Left Me Deeply Unsettled». The New York Times, 16 de febrero de 2023, sec. Technology. https://www.nytimes.com/2023/02/16/technology/bing-chatbot-microsoft-chatgpt.html.

Kevin Roose, periodista del New York Times, ha expuesto una técnica sorprendente para manipular a los chatbots de inteligencia artificial (IA) mediante el uso de texto invisible en los sitios web. Todo comenzó cuando Roose observó que su reputación en el entorno de los modelos de IA se había deteriorado. Este cambio negativo probablemente fue el resultado de un artículo que había escrito sobre una extraña y polémica interacción que tuvo con «Sydney», el chatbot de Bing de Microsoft. Roose sospechó que su nombre estaba siendo asociado con la caída en popularidad de dicho chatbot, lo que hizo que los modelos de IA comenzaran a considerarlo como una amenaza.

Para investigar esta situación, Roose consultó a expertos en IA, quienes le sugirieron una posible solución: introducir información positiva sobre sí mismo en páginas web que los sistemas de IA suelen usar como fuentes de datos. Siguiendo este consejo, Roose incorporó texto invisible—escrito en color blanco y, por tanto, imperceptible para los visitantes humanos—en su sitio web personal. Este texto estaba diseñado específicamente para ser captado por los modelos de IA, con el fin de mejorar la forma en que estos sistemas lo percibían y retrataban.

Este experimento de Roose no solo subraya la facilidad con la que se pueden influir los modelos de IA mediante tácticas relativamente sencillas, sino que también plantea serias preocupaciones sobre la integridad y la seguridad de estos sistemas. La posibilidad de manipulación a través de métodos como el uso de texto oculto es lo que Aravind Srinivas, CEO del motor de búsqueda de IA Perplexity, ha denominado «Optimización del Motor de Respuestas». Esta práctica podría abrir la puerta a nuevos desafíos éticos y técnicos en el ámbito de la inteligencia artificial, afectando la precisión y fiabilidad de los chatbots y otros sistemas basados en IA.

Recomendación sobre la ética de la inteligencia artificial

Recomendación sobre la ética de la inteligencia artificial. UNESCO, 2024

Texto completo


En la 41ª reunión de la Conferencia General de la UNESCO, celebrada en París en noviembre de 2021, se aprobó una Recomendación sobre la Ética de la Inteligencia Artificial (IA). Reconociendo tanto los beneficios como los riesgos de la IA en diversas áreas como la educación, la cultura y el medio ambiente, la UNESCO subraya la importancia de un enfoque ético y basado en derechos humanos para el desarrollo de estas tecnologías. La Recomendación insta a los Estados Miembros a adoptar medidas, en colaboración con todas las partes interesadas, para garantizar un uso responsable y ético de la IA, respetando la diversidad cultural y los valores locales.

Inteligencia artificial y democracia

Inteligencia artificial y democracia. UNESCO, 2024

Texto completo

El informe basado en la «Recomendación sobre la ética de la inteligencia artificial» de la UNESCO, aprobada en noviembre de 2021, analiza el impacto de la inteligencia artificial (IA) en la democracia. El documento se centra en cuatro áreas clave:

  1. Expectativas y decepciones democráticas de la digitalización: Se exploran las demandas sociales sobre el impacto de la digitalización en la democracia, así como las expectativas generadas en los últimos años.
  2. Nuevo espacio público digital y la conversación democrática: Se examina cómo la democracia depende de una conversación social de calidad y de un espacio público adecuado. Se identifican problemas en el entorno digital y se sugieren medidas para mejorar la conversación democrática.
  3. Democracia de los datos y la política del big data: Se discute el impacto de los sistemas automatizados, la tecnología interoperable y la cuantificación de la sociedad en la política. El informe cuestiona críticamente la dimensión política y democrática del big data.
  4. Democracia y gobernanza algorítmica: Se analiza la compatibilidad de los sistemas automáticos de decisión con los principios democráticos. Se abordan los desafíos que plantea la gobernanza algorítmica y se proponen condiciones para asegurar su compatibilidad con los valores democráticos.

Finalmente, se presentan recomendaciones para una gobernanza democrática de la inteligencia artificial, buscando mitigar impactos negativos y promover una gobernanza más democrática de la IA.

 “AI Scientist” de Sakana AI investiga de forma autónoma desafiando las normas científicas

AI, Sakana. «Sakana AI The AI Scientist: Towards Fully Automated Open-Ended Scientific Discovery», 13 de agosto de 2024. https://sakana.ai/.

AI Scientist” es el primer sistema integral para la investigación científica completamente automática. Este sistema permite que los Modelos de Lenguaje Grande (LLMs) realicen investigaciones de manera independiente.

Uno de los grandes desafíos de la inteligencia artificial es desarrollar agentes capaces de realizar investigaciones científicas y descubrir nuevo conocimiento. Aunque los modelos actuales ya ayudan a los científicos humanos en tareas como generar ideas o escribir código, aún requieren mucha supervisión y están limitados a tareas específicas.

Sakana AI, junto con científicos de las universidades de Oxford y British Columbia, ha desarrollado un sistema de inteligencia artificial llamado “AI Scientist”. Este innovador sistema es capaz de realizar investigaciones científicas de manera autónoma, cubriendo todo el proceso de investigación, desde la generación de ideas hasta la elaboración de manuscritos científicos completos.

“AI Scientist” automatiza diversas etapas, como la creación y evaluación de nuevas ideas, la ejecución de experimentos, la recopilación de datos y la redacción de informes científicos. Sin embargo, este avance también suscita preguntas importantes sobre el rol futuro de los científicos humanos. Aunque la IA es eficaz en el procesamiento de grandes cantidades de datos y en la identificación de patrones, la intuición, creatividad y juicio ético humanos continúan siendo indispensables.

Este proceso incluye:

  1. Generación de Ideas: El Científico de IA «brainstormea» nuevas direcciones de investigación, basándose en un código inicial y en búsquedas en Semantic Scholar para asegurar la novedad de las ideas.
  2. Iteración Experimental: Ejecuta los experimentos propuestos, produce gráficos y notas que se usan en la redacción del artículo.
  3. Redacción del Artículo: Redacta un informe conciso y claro en LaTeX, citando autonomamente artículos relevantes.
  4. Revisión Automatizada de Artículos: Desarrolla un revisor automático basado en LLM que evalúa los artículos con una precisión casi humana, mejorando continuamente la producción científica del sistema.

Pese a su potencial, “AI Scientist” tiene varias limitaciones. No es capaz de hacer preguntas a los autores ni de interpretar figuras, y frecuentemente genera propuestas similares en diferentes ejecuciones. Además, puede fallar en la implementación de ideas y presenta desafíos en aspectos visuales y de citación. Los resultados producidos deben considerarse como sugerencias para futuras investigaciones más que como ciencia definitiva.

“AI Scientist” abre una caja de Pandora de nuevos problemas, aunque el informe completo discute estos temas en mayor detalle. Entre los problemas clave se encuentran las consideraciones éticas y el impacto potencial en el proceso académico. Aunque “AI Scientist” puede ser una herramienta útil para los investigadores, su capacidad para crear y enviar automáticamente artículos puede aumentar significativamente la carga de trabajo de los revisores y tensar el proceso académico, afectando el control de calidad científica. Esto es similar a las preocupaciones en torno a la IA generativa en otras aplicaciones, como la generación de imágenes.

Además, el Revisor Automatizado, si se despliega en línea, podría reducir significativamente la calidad de las revisiones e imponer sesgos indeseables en los artículos. Por ello, es fundamental que los artículos y revisiones generados por IA sean identificados como tales para asegurar la transparencia total.

Como con muchas tecnologías anteriores, “AI Scientist” tiene el potencial de ser utilizado de manera poco ética. Por ejemplo, podría realizar investigaciones no éticas o peligrosas si se le da acceso a laboratorios virtuales para realizar experimentos biológicos. Esto podría dar lugar a la creación de virus o sustancias tóxicas antes de que se detecten los riesgos. Del mismo modo, podría desarrollar virus informáticos peligrosos si se le solicita crear software funcional. Estas capacidades en mejora subrayan la necesidad urgente de alinear estos sistemas con valores éticos y garantizar que exploren de manera segura.

En cuanto a los modelos utilizados, se emplearon modelos de frontera propietarios, como GPT-4o y Sonnet, pero también se exploraron modelos abiertos como DeepSeek y Llama-3. Aunque los modelos propietarios actuales producen los mejores artículos, no hay razón fundamental para que un solo modelo mantenga esta ventaja. Se espera que todos los LLMs, incluidos los modelos abiertos, continúen mejorando. La competencia entre LLMs ha llevado a su mayor disponibilidad y capacidades mejoradas, y el trabajo busca ser independiente del proveedor del modelo base. Los modelos abiertos ofrecen beneficios significativos, como menor costo, disponibilidad garantizada, mayor transparencia y flexibilidad. El objetivo es usar estos modelos en un sistema cerrado de investigación automejorado.

Finalmente, aunque se imagina un ecosistema científico completamente impulsado por IA que incluya investigadores, revisores y conferencias, no se cree que el papel del científico humano se vea disminuido. Más bien, este rol evolucionará y se adaptará a la nueva tecnología, moviéndose hacia tareas de mayor nivel.

El mercado negro de las citas: la venta de referencias falsas alarma a los científicos

Singh Chawla, D. (2024). The citation black market: Schemes selling fake references alarm scientists. Nature. https://doi.org/10.1038/d41586-024-01672-7

Un grupo de científicos ha revelado un mercado negro donde se venden citaciones falsas para inflar perfiles académicos, lo que plantea serias preocupaciones sobre la integridad en la investigación. Estos esquemas manipulan métricas cruciales para la evaluación académica, como el índice h. Expertos sugieren cambiar los incentivos en la academia para evitar que los investigadores se vean presionados a participar en estas prácticas fraudulentas.

Vigilantes de la integridad en la investigación están preocupados por las crecientes maneras en que los científicos pueden inflar artificialmente el número de citaciones de sus estudios. En los últimos meses, han surgido prácticas cada vez más audaces. Una de estas prácticas fue descubierta mediante una operación encubierta en la que un grupo de investigadores compró 50 citaciones por 300$ para mejorar el perfil de Google Scholar de un científico ficticio que crearon.

Este caso confirma la existencia de un mercado negro de referencias falsificadas, algo que los expertos en integridad habían sospechado durante mucho tiempo. Las citaciones compradas provienen de estudios en 22 revistas, de las cuales 14 están indexadas en Scopus.

Estas prácticas son preocupantes porque muchos aspectos de la carrera de un investigador dependen de la cantidad de citaciones que reciben sus trabajos. Instituciones y métricas como el índice h utilizan estos números para evaluar la productividad y el impacto de los científicos. En un caso reciente en España, el rector de la Universidad de Salamanca fue acusado de inflar artificialmente sus métricas de Google Scholar, lo que llevó a una investigación por parte del Comité de Ética en la Investigación.

La operación encubierta también descubrió que se venden citaciones en «paper mills», servicios que producen estudios de baja calidad y venden autorías en artículos ya aceptados. Además, se ha observado la creación de perfiles falsos, como el de un gato llamado Larry, que acumuló citaciones antes de que Google Scholar y ResearchGate eliminaran las publicaciones falsas.

El equipo de investigadores propone un nuevo índice de concentración de citaciones para detectar patrones sospechosos, como cuando un científico recibe muchas citaciones de pocas fuentes. Sin embargo, persiste el temor de que los estafadores desarrollen métodos más sutiles para evitar ser descubiertos. Según los expertos, para abordar este problema, es necesario cambiar los incentivos en la academia para que los científicos no se vean presionados a acumular citaciones para avanzar en sus carreras.

Integridad académica en la era de la Inteligencia Artificial Generativa (IAG)

Alonso-Arévalo, Julio. Integridad académica en la era de la Inteligencia Artificial Generativa (IAG). Desiderata, n. 24. (2024)

Texto completo

La Inteligencia Artificial Generativa (IAG) se refiere a sistemas de inteligencia artificial capaces de crear contenido original a partir de datos existentes mediante el aprendizaje automático. Estos sistemas, entrenados con vastos corpus de texto e imágenes, pueden generar textos coherentes, responder preguntas, redactar artículos y crear imágenes detalladas. Herramientas como ChatGPT permiten a los investigadores generar borradores de artículos, reducir el tiempo de escritura y mejorar la coherencia del texto. La IAG tiene usos legítimos, como la revisión y corrección de manuscritos, la visualización de tendencias que puede inspirar nuevas formas de pensar y enfoques creativos de investigación, o ayudar a los investigadores a analizar grandes cantidades de datos y extraer información relevante.

La IA complica el plagio. ¿Cómo deben responder los científicos?

Kwon, Diana. «AI Is Complicating Plagiarism. How Should Scientists Respond?» Nature, 30 de julio de 2024. https://doi.org/10.1038/d41586-024-02371-z.

El uso de herramientas de inteligencia artificial generativa (IA) en la escritura plantea preguntas difíciles sobre cuándo debería permitirse su uso. Estos sistemas, como ChatGPT, pueden ahorrar tiempo, mejorar la claridad y reducir barreras lingüísticas. Sin embargo, complican el debate sobre el uso indebido del trabajo ajeno, ya que la IA puede generar texto que se asemeja a contenidos existentes, lo que podría considerarse plagio.

La IA generativa plantea un desafío al distinguir entre la escritura completamente humana y la completamente generada por máquinas, creando una «zona gris» difícil de definir. Aunque el uso no autorizado de herramientas de IA puede no ser considerado plagio, podría verse como generación de contenido no autorizado. Este debate también incluye preocupaciones sobre la infracción de derechos de autor, ya que estas herramientas se entrenan con grandes cantidades de textos publicados sin permiso.

El uso de IA en la redacción académica ha aumentado rápidamente, con estimaciones que indican que al menos el 10% de los resúmenes en artículos biomédicos de 2024 han utilizado estas herramientas. La comunidad académica está dividida sobre cuándo el uso de IA es ético o constituye plagio. Algunas revistas han comenzado a exigir la divulgación completa del uso de IA, pero las políticas varían.

AI EN ARTÍCULOS ACADÉMICOS
Según un análisis de 14 millones de resúmenes de PubMed, el uso de palabras estilísticas (como «delves») aumentó de forma inusitada tras la generalización de los grandes modelos lingüísticos. Ello eclipsó el aumento de palabras relacionadas con el contenido de la pandemia (como «COVID»).

Además, los detectores de textos generados por IA aún no son completamente fiables, especialmente cuando los textos han sido ligeramente editados. Esto dificulta identificar y diferenciar entre contenido generado por IA y por humanos, especialmente para autores no nativos en inglés. La integración de herramientas de IA en plataformas comunes como Word y Google Docs complicará aún más la distinción entre contenido influenciado por IA y el que no lo es.

La respuesta de la comunidad científica incluye la necesidad de desarrollar guías claras sobre el uso de IA y reconocer que el avance tecnológico podría seguir superando la capacidad de regulación y detección.